智慧环卫人员定位怎么做?从技术原理到系统落地的完整拆解
原创
智慧环卫人员定位怎么做?从技术原理到系统落地的完整拆解
原创
AOVEE
发布于 2026-11-09 11:58:00
发布于 2026-11-09 11:58:00
封面:智慧环卫人员定位
封面:智慧环卫人员定位
题注:封面为示意性视觉图,非真实现场照片。
一、引言:两个说不清的数和一堆补不回的账
环卫作业管理的核心报表其实就两个数:里程和时长。一辆清扫车今天的作业里程对不对、一名保洁员在这个责任片区在岗多久、外包班组按面积结算的工作量该不该给——全靠这两个数撑着。但这两个数常年说不清:车辆绕路、借道、司机中途办私事混在轨迹里算不清;保洁员在树荫下歇了二十分钟,是偷懒还是这段本来就没活;最麻烦的是账对不上——月底结算时报表数字又变了,因为那几天有信号盲区,数据是后来补传的,早班的表被悄悄重算了。
这篇文章面向做这类系统的后端开发,把"卫星 + 基站辅助 + 航位推算的连续定位"从信号一路讲到统计表:断链数据怎么补传不冲账、乱序怎么对齐、漂移怎么清、里程与在岗怎么算得干净、上报频率怎么在续航与粒度间分档。读完你应该能设计出这样一套管线——每一段轨迹带着来源类型、每一个数字带着口径版本、每一次争议都能回到原始数据复现。
二、问题拆解:连续、干净、可复现
环卫定位系统的难点不在"定位",在"连续"和"算得对",拆成四件事。
其一是连续覆盖。作业面从大街到城中村小巷到桥下,卫星信号强度剧烈波动;一条完整的作业轨迹必然横跨实测段、兜底段、推算段、断链段四类数据。连续性的正确定义不是"每时每刻都有坐标",而是"每一刻都有类型明确的记录"——这一句是整个方案的地基。
其二是数据干净。城市峡谷与树冠下的漂移点围着一个真实点画圈,逐段求和就把噪声加成里程;静止作业时的坐标抖动会虚增停留次数。清洗不到位,后面所有统计都在污染数据上做优化。
其三是时序可信。补传是常态:地下通道、隧道口、信号盲区里的作业数据在恢复连接后批量涌回,时间戳是历史时刻、到达却是现在。不处理乱序,统计会随补传反复变动,报表就失去了作为结算依据的资格。
其四是口径透明。里程、时长、覆盖率这些数最终进考核和结算,它们必须由固定口径算出、可版本追溯——否则同一个片区两套算法算出两个数,谁都说服不了谁。
三、技术原理:三条链路的接力
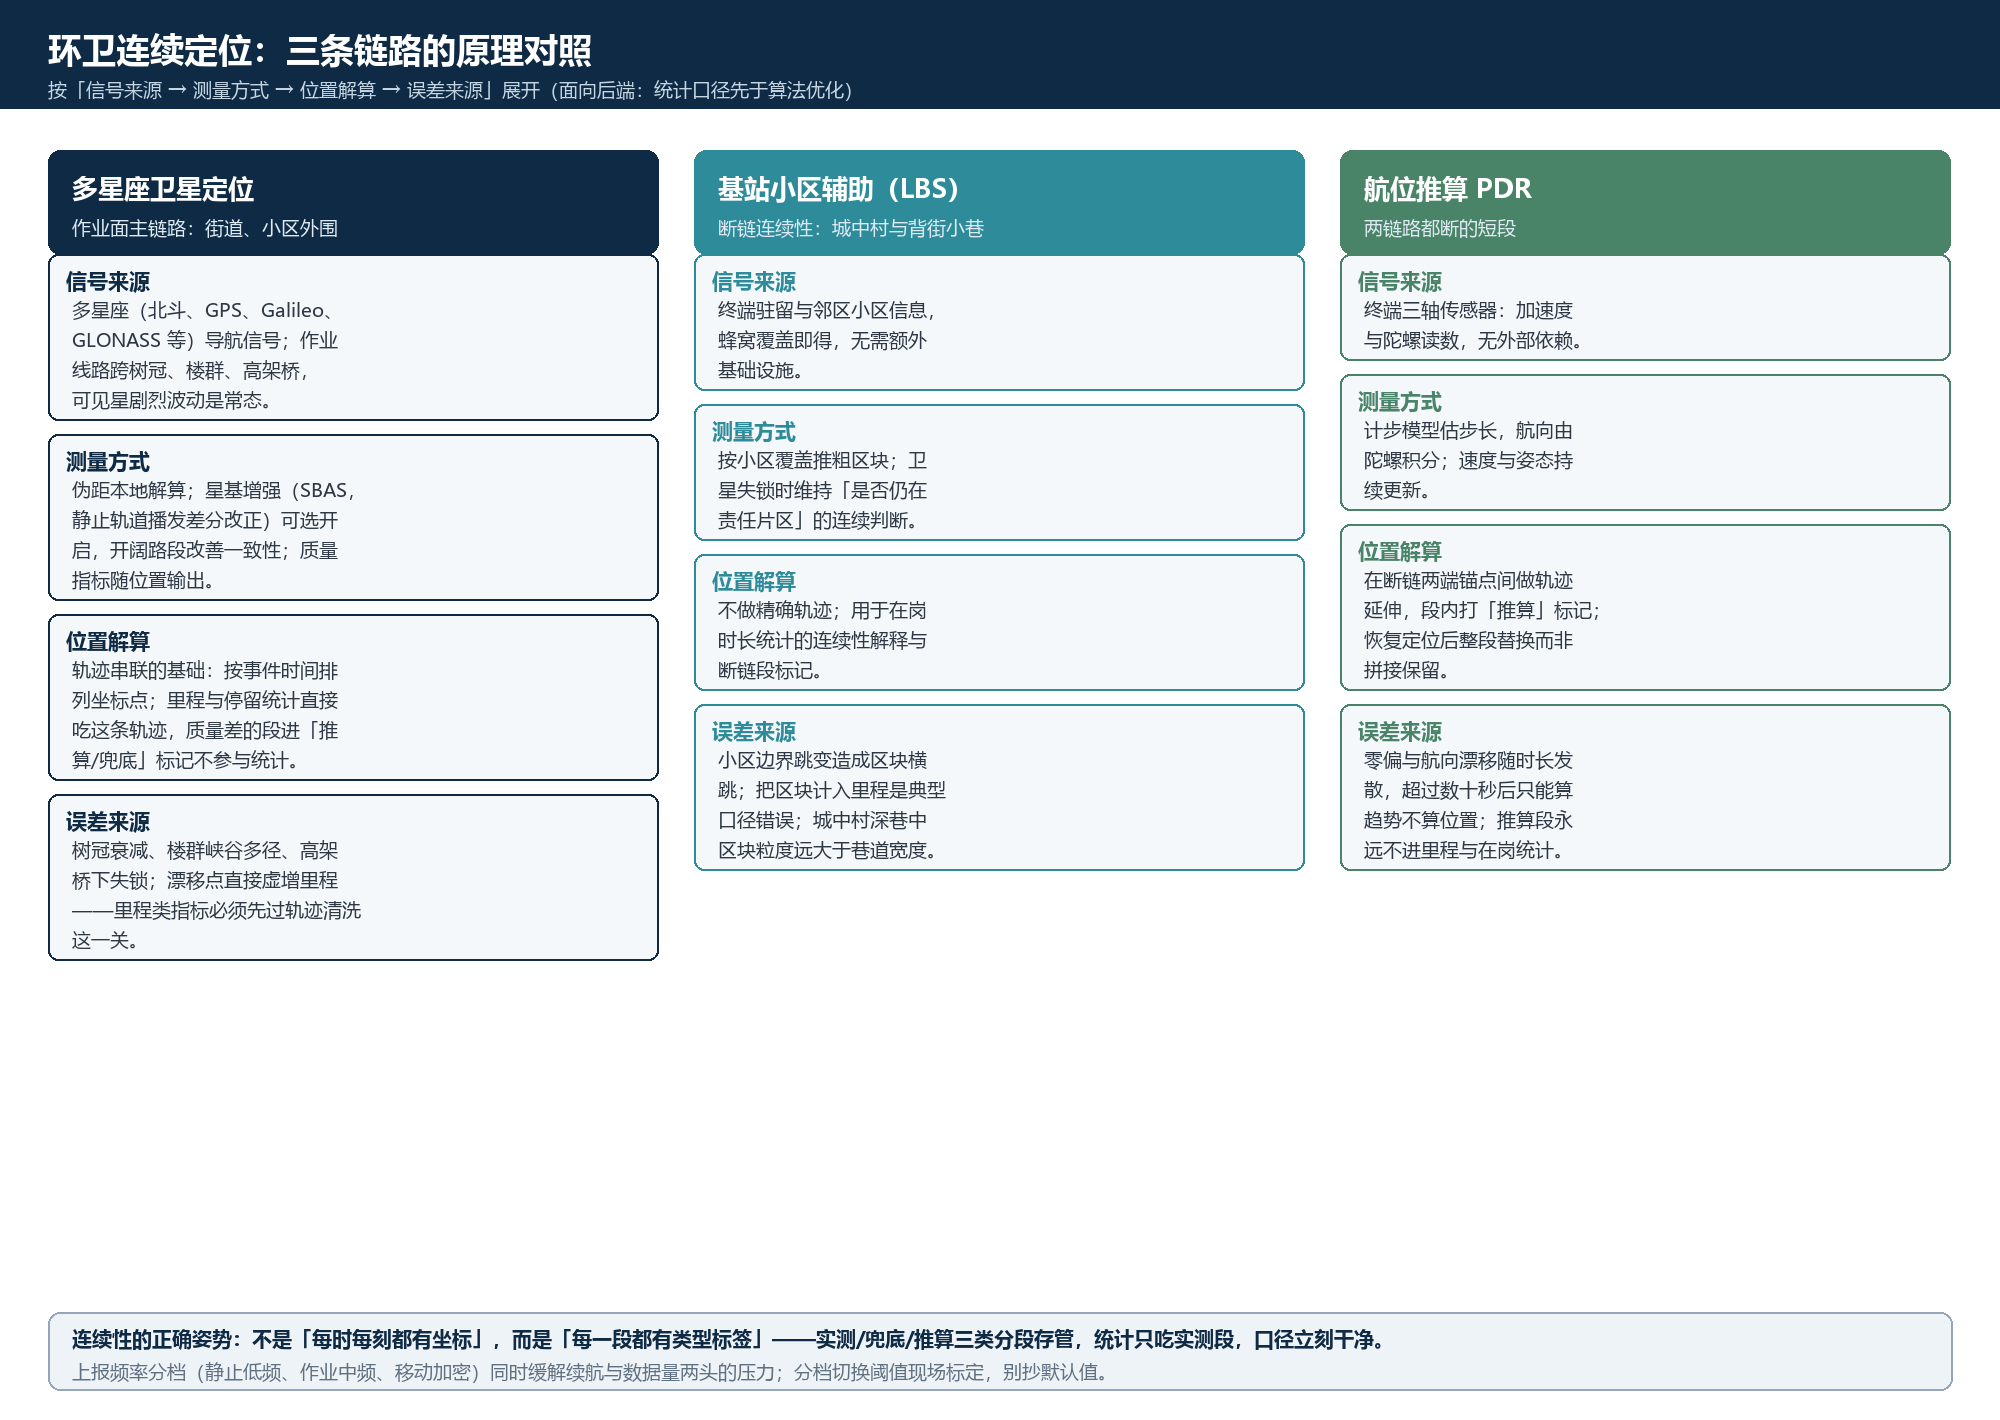
图1 三条链路的原理对照
图1 三条链路的原理对照
题注:图1 按信号来源、测量方式、位置解算与误差来源对照卫星、基站辅助与航位推算三条链路。
多星座卫星:作业轨迹的主干
信号来自北斗、GPS、Galileo、GLONASS 等多星座的下行导航信号,终端解调伪距观测量本地解算。星基增强(SBAS,由静止轨道卫星播发差分改正与完好性信息)在开阔路段可改善一致性与可用性,环卫线路开阔段占比高,这是它相对车载场景的天然适配;地基差分增强一般不用于这类大范围流动作业,链路覆盖与授权成本不划算。
解算输出坐标加质量指标:可见星数与位置精度因子(HDOP,衡量卫星几何分布对误差放大倍数的参数)。轨迹串联直接吃这条流,但只吃"质量达标"的部分——质量差的段打"兜底/推算"标签,不进里程与在岗统计。
误差集中在三类场景:行道树冠造成信号衰减,楼群街道产生峡谷多径漂移,高架桥下与隧道口短时失锁。它们决定了统计必须建立在"分段"之上而非"全天一条流"之上。
基站辅助(LBS):断链时的连续性解释
终端驻留与邻区小区信息,蜂窝覆盖即得,由小区覆盖范围推粗区块。它给的不是坐标而是"大方向还在不在片区"的判断。环卫线路跨街区时,密集城区区块细、郊区乡镇区块粗,粒度天然不均——这正是它只能当解释性证据、不能当结论性证据的原因。城中村深巷里,区块比巷道宽得多,用它判"离岗"会大面积冤枉人。
航位推算(PDR):双链路皆断的短段
终端三轴传感器读加速度与角速度,计步模型估步长、航向由陀螺积分,做位置外推。物理决定它误差随时长发散,数十秒后只能算趋势不能算位置。它在系统里的职责很窄很明确:卫星与基站都断的短段里维持"还在移动/已停下"的状态连续性,恢复定位后整段用实测替换,不保留推算点参与统计。
四、方案对比:接力分工表
维度 | 卫星+SBAS | 基站辅助 | 航位推算 | 车载持续上报 |
|---|---|---|---|---|
粒度 | 坐标级 | 区块级 | 段趋势 | 坐标级 |
覆盖 | 开阔优、遮挡弱 | 有蜂窝即在 | 无外部依赖 | 车行路段 |
进里程 | 是(实测段) | 否 | 否 | 是 |
进在岗时长 | 是 | 仅连续性解释 | 仅连续性解释 | 是 |
功耗代价 | 中 | 低 | 低 | 与车辆同供电 |
乱序风险 | 断链补传高 | 低 | 低 | 网络抖动中 |
判断有三条。第一,人车数据要分流建模:车辆载具供电持续上报、位置速度成对,是稳定的强数据源;步行保洁受频率与续航约束,两者统计口径不同属正常,系统按对象类型分轨,别用一套清洗规则硬套。第二,"进不进结论"是链路的分水岭——表中间两列(基站、推算)都只负责连续性,不参与里程时长,这个纪律越早起越好。第三,SBAS 的取舍看线路结构:郊区开阔线路收益明显,城区峡谷段无感,按线路画像决定是否启用,而非全局开关。
五、系统架构:统计后端视角的五层
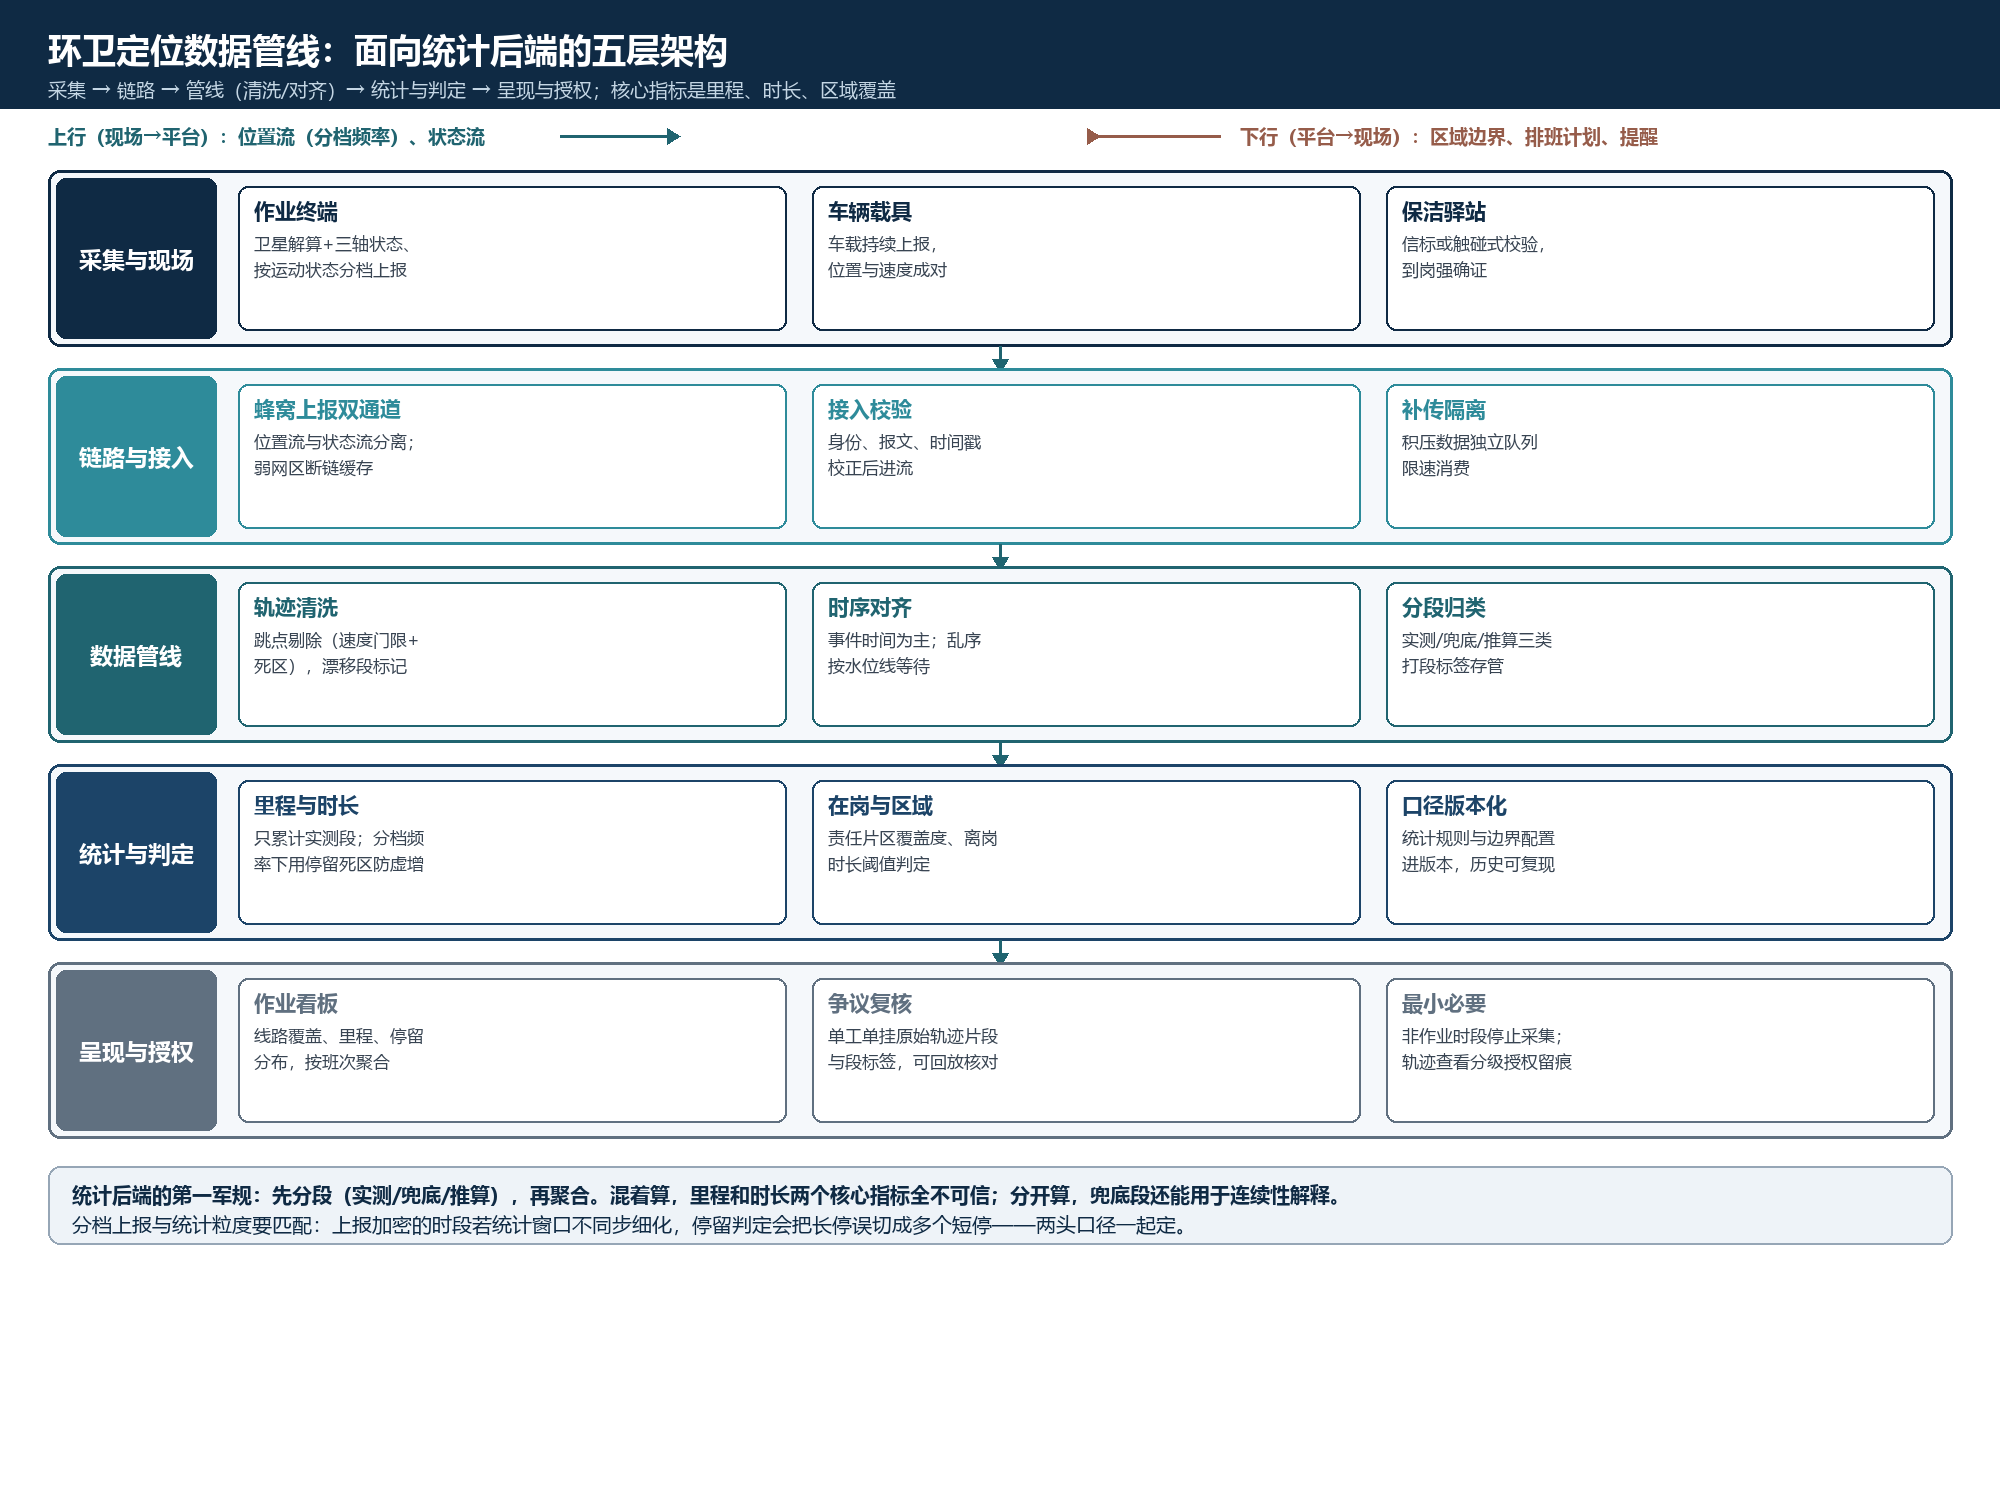
图2 五层架构与数据管线
图2 五层架构与数据管线
题注:图2 给出采集、链路、管线、统计判定、呈现授权五层,及分段存管与幂等统计设计。
采集层:作业终端按运动状态分档上报(静止低频、移动加密,续航与数据量两头兼顾),三轴模块给出走/停/乘车状态;车辆载具持续上报。上报走蜂窝双通道——位置流与状态流分离,避免互相阻塞。
链路层:断链时终端本地缓存、恢复后批量补传;接入网关做身份校验、报文校验与时间戳校正。补传数据在入口就分流进独立队列限速消费,与实时流物理隔离——这是保护实时管线的第一道闸。
管线层是后端的主战场,三段:轨迹清洗剔除物理上不可能的跳点(速度门限:相邻两点隐含速度超过步行/车速合理上限即标记;死区:低于阈值的位移不累计);时序对齐以事件时间为主轴,乱序样本按水位线等待,超时放行并打标;分段归类把每条流切成实测/兜底/推算三类标签存管。清洗参数用典型线路人工比对回归验证,不是调一次就锁死。
统计与判定层只吃实测段:里程按实测段逐段累计,静止作业时靠死区防漂移虚增;在岗时长按片区边界进出事件加停留分布推;覆盖率按责任片区网格统计实际踏勘比例。离岗判定要求"连续多周期在边界外且质量达标",兜底段的区块跳变绝不允许单独触发离岗。所有统计口径(窗口、网格、去重、门限)版本化入库。
呈现与授权层:作业看板按班次聚合;争议工单挂接原始轨迹片段与段标签供回放核对;个体轨迹查看按最小必要授权、操作留痕,非作业时段终端停止或降频采集并在员工端透明——环卫外包用工场景下,这一条直接决定班组配不配合佩戴终端。
六、关键实现:让统计可复现的四块基石
断链补传与乱序处理
工程上按"迟到数据"完整生命周期设计:终端侧缓存有容量与优先级策略(工单进行中的段优先),网络侧限速分批补传避免拥塞;服务端以事件时间为唯一入账轴,把"数据到达时间"与"事件发生时间"显式分为两个字段。统计任务设计成幂等:同一天的聚合可重跑、结果一致,补传后重算产出差异明细而非静默覆盖。这样早班报表被晚到数据修正时,修正本身是可见的、可解释的。
轨迹平滑与里程清洗
最容易被低估的口径细节是"静止时的里程从哪来"。方案组合:速度门限过滤 + 停留死区(一段时间内位移始终小于阈值即判停留,期间里程贡献记零)+ 质量门控(低质量段整段不参与)。反向验证也要建:挑几条人工已知里程的标准线路定期跑回归,清洗参数漂没漂,数字会告诉你。
平滑不等于插值美化——对结算系统,宁可留"断链空洞段"的诚实记录,也不要用插值编出一段没人走过的轨迹。空洞段影响覆盖率统计的,单独用"片区其他终端的聚合观测"补盲,而不是给个体轨迹打补丁。
停留、在岗与覆盖率三个指标的定义
停留 = 连续低速/静止且位置在某片区内的时段,最小持续时长配置化(区分等红绿灯与清理绿化带两种停);在岗 = 有效停留时段与作业移动时段之和,按班次聚合,不含非作业时段;覆盖 = 责任片区网格被实测轨迹踏勘的比例,兜底与推算段不计入。三个指标各自独立定义、独立版本化,接口文档里禁止互相"顺带计算"——很多系统的工时争议,根源就是时长偷偷等于了在线时长而非作业时长。
上报频率分档
续航约束下的最优解是分档而非单频:静止 5 分钟转低频、进入工单状态升频、移动中按步频动态调。切换阈值现场标定(比如"连续多少个上报周期无位移判静止"),并让员工端可解释——结算页显示"本单上报档位分布",把数据粒度透明化,很多"数据不准"的投诉其实是"数据不透明"。低温季节电池缩水,班次排班与设备轮换预留余量;充电与佩戴件损耗进日常点检清单。
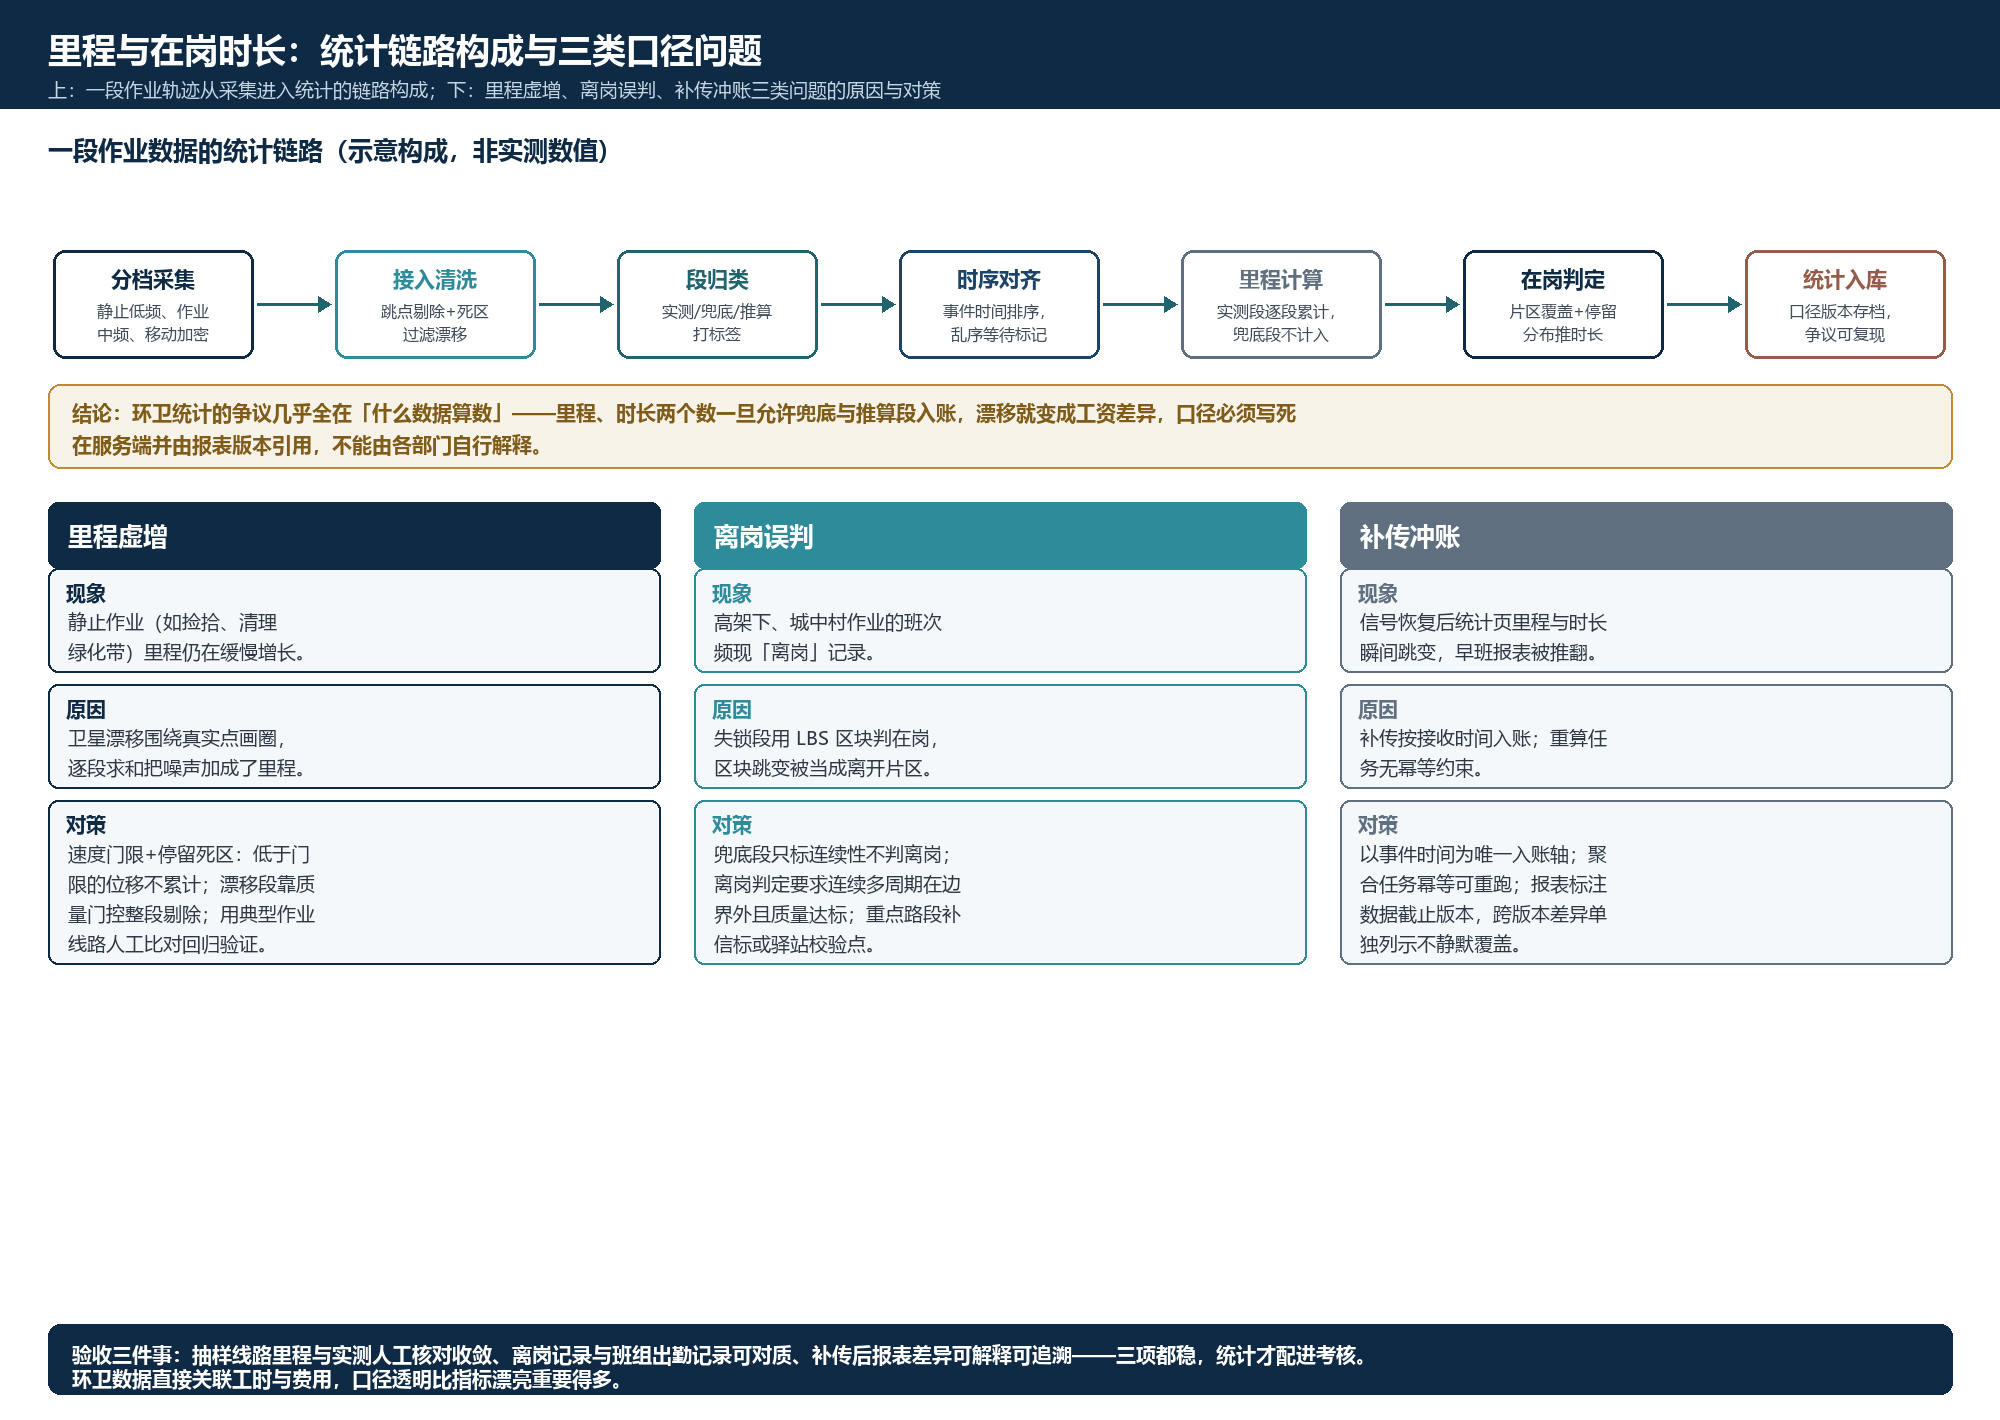
图3 统计链路构成与三类口径问题
图3 统计链路构成与三类口径问题
题注:图3 拆解一段作业数据从采集到入统计的链路,并汇总里程虚增、离岗误判、补传冲账三类问题。
七、典型问题:三类争议的根因与解法
里程虚增。 静止作业里程缓涨,月底数字比人工核算高出一截。根因是漂移画圈被逐段求和。解法见清洗三件套;补充一条:发现某片区系统性虚增,先怀疑那里是不是树冠密集或多径高发,把该段质量门限单独收紧,而不是全局调参——全局阈值是为最差环境服务的,代价是把好数据也砍粗了。
离岗误判。 高架下、城中村的班次频现离岗记录,班组申诉。根因是 LBS 区块跳变进了离岗判定。解法:兜底段只标连续性不判离岗,离岗要求连续多周期、边界外、质量达标三条件;争议高发路段补信标或驿站校验点——把强确证布在链路最弱的位置,这是覆盖投资的正确方向。
补传冲账。 报表随晚到数据反复变动。根因是按接收时间入账且聚合非幂等。解法:事件时间入桶 + 幂等重跑 + 截止版本标注;跨版本差异单独列示。财务口径对齐月结周期:每月给出一版"结算基线",之后晚到数据的修正走差异单,不动基线本身。
人车混算。 车辆里程与步行轨迹混在一个清洗管道里,参数互相打架。解法:接入层就按对象类型分轨,各自的门限与口径独立。
口径被现场解释。 片区主管用"经验"修正系统数字,报表失去公信力。解法:争议走"复核工单"机制——主管提交异议、系统附原始数据与口径版本、修正以叠加记录留痕,而不是直接改数。数据可改和数可解释是两回事。
八、选型建议
A:城区主干道机扫作业为主。 车辆载具数据为骨干,人员终端低频伴随即可;SBAS 按线路画像启用;统计重心在车。
B:步行保洁 + 责任片区考核。 人车分轨,片区边界双门限判定,驿站/重点点位布少量信标或触碰校验补强离岗争议区;覆盖率指标启用前先排查实测段在责任片区内的覆盖空洞。
C:城乡结合部与乡镇线路。 蜂窝覆盖是前提,弱网区把断链缓存容量与补传优先级当核心参数设计;这类区域里程与在岗口径建议从宽(少考核精细度、多保留原始段),避免弱基础设施上硬套城区口径。
D:外包用工、多班组结算。 优先级第一条是口径版本化与可复现报表,其次是防作弊,最后才是实时性;结算基线+差异单机制是这类场景能不能签下来的关键。
三条通用限制:里程与时长只能吃实测段,任何"把兜底段也算进去"的便利都会变成结算争议;3~5 米级的分区判定(若引入信标)是条件值;所有指标的可信度上限是清洗参数的现场标定质量,不是算法的名字。
九、总结
回到开头那两个数。这套管线给"里程"的答案是:只由质量达标的实测段逐段累计、漂移被死区和门限挡住、由标准线路回归验证——它不再随补传跳动,也不再被静止虚增。给"时长"的答案是:片区边界进出加停留分布、兜底段只做解释不做结论、非作业时段根本不采集。更根本的改变是账的形态:每个数字背后挂着口径版本、段标签和原始轨迹引用,谁质疑就能复现到谁那一单。
适用边界要讲透:它给的是"可复现的作业统计",不是"实时监控每个人";桥下巷内的空洞段它诚实留空,不编轨迹。风险仍是那三处:兜底数据混进结论、聚合非幂等、口径被现场自由解释。优化方向依次是回归验证常态化、结算基线机制、复核工单闭环。对后端团队,这套系统的职业成就感来自一件很朴素的事——月底那张表,改一次,就永远是那个数。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号