Super-agent 架构设计对比TRAE 宝 · DeepSeek · OoderAgent
原创
Super-agent 架构设计对比TRAE 宝 · DeepSeek · OoderAgent
原创
OneCode
发布于 2026-11-11 10:47:35
发布于 2026-11-11 10:47:35
Super-agent 架构设计对比TRAE 宝 · DeepSeek · OoderAgent
如果你用过 AI 编程助手,大概率遇到过这个悖论:Autonomous Coding Agent 很强,但你看不到它在干什么;IDE Assistant 很透明,但你得一步步喂 prompt。速度与控制,仿佛鱼与熊掌。
过去半年,业内开始出现一种新的回答方式:让 Agent 变成长期在线的"数字员工"。不是一次性执行 prompt,而是有常驻的调度者(Router)、有持久化的任务账本、有按事件触发的工作流,能同时跟进多个互不相关的任务——用户面对同一个 Agent,系统在底下维护多个 Worker。
这篇文章要对比的三套实现,代表了这条路线上的三个不同象限:
TRAE 宝
2026 年 11 月开放的独立个人助理平台,从 IDE 内 Agent 模式演进而来。核心能力:跨项目长期跟随、多任务并行统筹、全局记忆(做过的事不用反复讲)。PC + Web 双端。
DeepSeek Super-agent
提出 Router + Worker 双层架构与事件驱动执行,把 Agent Runtime 提升到"数字员工"系统层面。有开源原型验证调度效率。
OoderAgent(本地实践)
用 SQLite 做租户级四层上下文账本,实现 STEER 改向、Task Watchdog 恢复、项目进度自动聚合,是我们在企业级多租户场景下的落地实现。
第一章 · TRAE 宝
第一章 · TRAE 宝:从 IDE Agent 到独立个人助理平台
2026 年 11 月,TRAE 发布个人助理平台版——TRAE 宝1。这是一个关键的产品形态跃迁:从 IDE 内的编码 Agent 模式,演进为独立于 IDE 的"开发者个人助理平台"。TRAE 在更新日志里给出了三个核心定位2:
① 全局助理
跨项目梳理历史任务、对话和产物,形成你的"开发记忆账本"。做过的事,不用反复讲。
② 多任务并行
一句话多线开工。你说"先做 PRD,同时写个 Demo 跑通核心流程"——TRAE 宝在底下同时编排两个任务。
③ 智能记忆
长期跟随你的开发工作,越用越懂你的编码风格、技术选型偏好和项目结构。不是每次都从零开始。
这个定位转变的关键信号是:TRAE 宝不再是一个"IDE 插件里的功能模式",而是一个独立平台(PC + Web 双端)。它的核心价值主张也从"帮你写代码更快"转向"长期陪伴你的开发工作"。
1.1 @ 和 # 符号:用自然语言映射技术能力
TRAE 在 2025 年 4 月引入的 @Agent 和 #Context 符号系统3,到 TRAE 宝里依然是用户表达意图的核心接口。这两个符号的选择不是偶然——它把社交网络的 mention/hashtag 概念搬进了开发协作场景:
设计洞见
@Agent = 叫人。你在 Slack 里 @某同事 是在说"这件事你来做"。同理,@Builder 是在说"这个需求交给 Builder Agent"。它不是一个技术指令,而是一个社会协作语义。
#Context = 搭场景。#Web 把互联网拉进来,#Doc 把项目文档拉进来,#Rules 把编码偏好拉进来。它不指定"谁来做",而是指定"在什么知识背景下做"。
这两个符号的真正天才之处在于——它们把"选择执行体"和"准备上下文"这两个 Agent 系统中最核心的决策,变成了用户可直观表达的自然语言。你不需要配置复杂的 prompt template,也不需要理解什么是"Router 层"——你只要像在群聊里说话一样表达意图。
1.2 从 Chat-Builder 统一到"对话即协作"
TRAE 做了一个在当时看起来很激进的决定——把 Chat(对话式编程)和 Builder(AI 驱动的项目开发)合并成一个界面。理由很朴素:以前你在 Chat 里说"帮我写个函数",切换到 Builder 又要重说一遍需求,上下文直接丢失。
这个决定背后的洞察是:自然语言是下一代命令行。就像 bash 把各种工具统一在一个文本入口下,AI 时代的"终端"就是一个持续存在的对话流——你可以在里面闲聊、下命令、让 Agent 建项目、改代码、跑测试,中间切话题也不丢上下文。
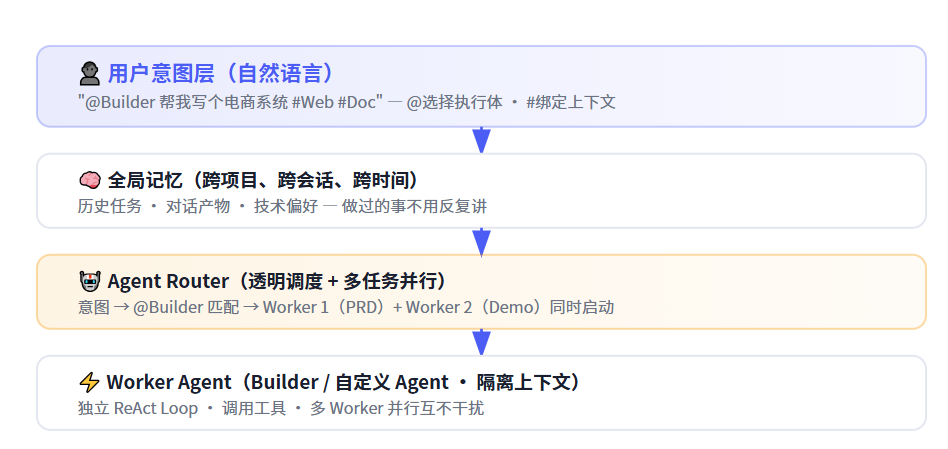
图 1 — TRAE 宝四层交互模型:从用户自然语言到多 Worker 并行执行
1.3 产品形态:独立平台与 IDE 的边界
TRAE 宝是独立个人助理平台,但它和 IDE 内的编码 Agent 并不互斥。TRAE 的策略是——TRAE 宝(独立平台)负责跨项目任务编排与记忆沉淀,IDE 内的 Agent 负责在当前项目里做深度编码与精细调试。两者可以互相接力:
- 你在 TRAE 宝里让 Builder 完成了 PRD 和技术方案,项目账本自动记录这个进度;
- 切换到 IDE 打开同一个项目,IDE 内的 Agent 自动读到项目账本里的进度,从"技术方案已确认"这个状态继续往下写代码;
- 写代码遇到 Bug,在 IDE 内修完后,进度同步回 TRAE 宝,项目账本更新为"编码阶段 80%"。
这种"双层协作"的关键设计约束是:TRAE 宝(独立平台层)负责记忆,IDE 内 Agent 负责执行。记忆跨实例持久化,执行在当前上下文内临时。这个边界和 DeepSeek Super-agent 的"Router 统一入口 + Worker 隔离执行"高度一致——都是把"全局状态"和"局部执行"在架构层面做物理分隔。
1.4 五个产品设计决策
TRAE 宝的产品设计里有五个值得关注的决策,它们共同构成了"让长期在线的数字助理既好用又能放心放权"的基础:
①
实时流式回显 + 可折叠的"思维链"
Agent 的每一步思考、每个工具调用都以实时流的形式展示,但自动折叠成可点击展开的卡片。已完成 → 折叠成摘要行,进行中 → 全展开流式显示。既保证透明度,又不淹没主要信息。
②
一键接管 / 继续执行
Agent 在需要确认时暂停,按钮文案不是"批准"而是"继续"或"我来"——前者让你继续让 Agent 跑,后者把控制权切换回 IDE 模式。
③
Diff 视图:不是"我改好了",而是"你看看改了啥"
Agent 完成修改后,在对话流里显示" 查看变更"按钮,点进去展示文件数量、变更行数、side-by-side diff。关键改动可点"解释这处改动"让 Agent 用自然语言解释。
④
多 Agent 并行,但在同一个对话流里
多个 Agent 同时干活时,它们的输出汇入同一个时间线,通过头像和标签区分"这句话是谁说的"。避免让用户在多个窗口间当项目经理。
⑤
跨项目记忆:做过的事不用反复讲
TRAE 宝维护一个"全局记忆账本"——跨项目、跨会话、跨时间的历史任务、对话产物、技术偏好。换个项目、换台设备,助理还是那个助理。
小结
TRAE 宝的核心贡献不是它发明了 Router/Worker 架构(这个思路在 LangGraph、AutoGen 里早已有之)。它的核心贡献是——把"Agent 系统"从一个工程问题,变成了一个可以被直观使用的产品。@符号的自然语言映射、跨项目长期记忆、多任务并行统筹——这些设计让"让 Agent 长期陪伴你的开发工作"从一个美好愿望变成日常可用的能力。
第二章 · DeepSeek Super-agent
第二章 · DeepSeek Super-agent:把 Agent Runtime 提升到系统层面
2026 年 11 月 1 日,DeepSeek Harness 团队发布《Super-agent 设计探索》4,并开源了原型项目。它提出了一个尖锐的观点:
"单任务的上限取决于模型能力,多任务的上限取决于人的注意力。"
你同时开 3 个 Coding Agent 窗口,并不意味着生产力 × 3——因为 Agent A 写一半要你确认方案,Agent B 找到 Bug 等你批准修改,Agent C 发现测试不过要你补充上下文。你成了这 3 个 AI 的项目经理。开 10 个呢?人的注意力根本不够用。
DeepSeek 的回答是——让 Agent 自己当项目经理。Super-agent 不是一个更强的 Agent,而是一个 Agent Runtime 系统:Router 常驻在线,维护全局状态、调度 Worker、只在真正需要人决策时打扰开发者。
2.1 核心架构:Router + Worker 双层 + 事件驱动
Super-agent 的架构可以用四个词概括:双层架构、事件驱动、直通订阅、Watchdog。
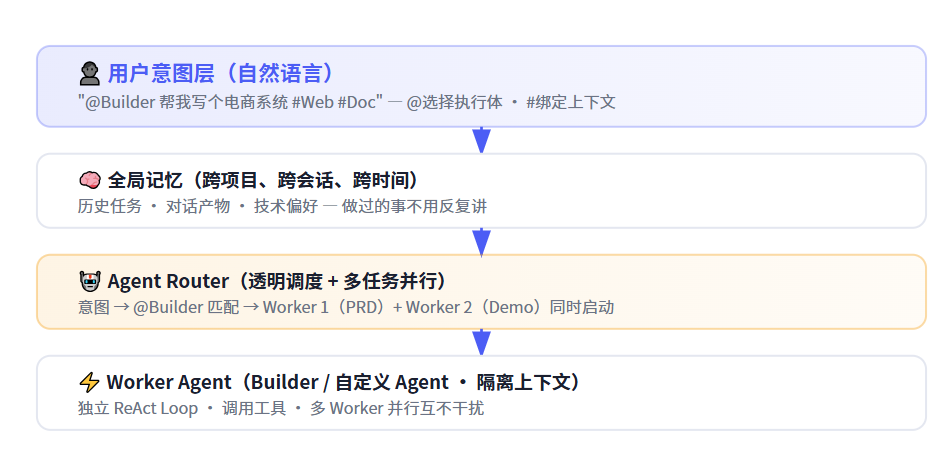
图 2 — DeepSeek Super-agent 双层架构:Router 统一入口,Worker 隔离并行
2.2 核心设计要素拆解
Source → Trigger → Eval → Ticket → Executor
这是 Super-agent 处理任务的完整流水线:
- Trigger(事件追踪):GitHub 新 Issue、PR 评论、CI 结果,系统创建 Trigger,通过 Thread 关联同一任务的相关事件,避免重复处理。
- Eval(任务评估):判断事件是否需要执行、是否已有 Worker 负责、是否具备执行权限。通过 Mandate 限制权限范围,防止 Agent 擅自扩大行动。
- Ticket(任务持久化):传统 Agent 以 Session 为中心,Session 结束任务就结束了。Super-agent 通过 Ticket 保存任务状态——即使 Worker 中断或重启,也能恢复并继续。
- Subscription(事件直通):最精妙的设计——当 Worker 接手某个 GitHub PR 后,后续评论、CI 失败、Review 意见等事件可以直接投递给该 Worker,无需 Router 重新判断。
Fast Path / Slow Path 两级过滤
不是所有事件都值得让 LLM 判断。Super-agent 采用两级过滤策略:
- Fast Path(代码规则):简单事件(Bot 回复、已处理的 dedup key、纯闲聊)用正则/规则过滤,完全不调用模型。
- Slow Path(LLM 判断):只有复杂事件才交给 Router 的 LLM 判断是否需要创建或更新 Ticket。
这个设计把 Token 消耗降到了传统方案的几分之一。
异步 ReAct Loop
传统 Agent 的 ReAct Loop 是阻塞的——它在跑测试时,外面的新消息只能排队等。Super-agent 的 Worker 采用 异步 ReAct Loop:在执行耗时操作的同时保持消息接收能力,新任务进来可以先入队,或者在资源空闲时立即并行。
2.3 实验数据:效率到底提升了多少?
DeepSeek 团队做了一个很扎实的实验5:群聊和 GitHub CI 消息流同时驱动四种方案,单次实验约 300 条消息(其中约 20 条是工作请求)。编码工作用"只消耗时间"的工具代替,聚焦调度效率。
方案 | P50 完成时间 | P95 完成时间 | 核心差异 |
|---|---|---|---|
Super-agent(带直通) | 12.4 min | 15.7 min | Router 分派 + Worker 直通订阅 |
Super-agent(无直通) | ~15 min | ~22 min | 每次事件都回 Router 重新判断 |
单 Session + Subagent(中性提示) | ~22 min | 29.5 min | 主 Agent 频繁被新消息打断 |
单 Session + Subagent(强提示) | ~18 min | ~26 min | 提示词能改善但不治本 |
结论很清楚——直通机制 + Router/Worker 双层的系统分工,带来 P95 从 29.5 min 降到 15.7 min(几乎减半)。核心原因不是模型更聪明了,而是"系统层面实现了任务分工与独立执行,减少了上下文干扰"。
Super-agent vs 传统 Multi-Agent
传统 Multi-Agent 主要解决:如何让多个 Agent 协作完成一个复杂任务?(比如"分析数据 → 生成图表 → 写报告")
Super-agent 想解决:如何让一个 Agent 系统长期运行、主动发现任务、同时管理多个互不相关的任务?(比如同时跟进 GitHub PR 修复、CI 监控、群聊 Bug 报告)
后者把 Multi-Agent 从"单次任务执行工具"提升到"持续运行的数字员工系统"。
第三章 · OoderAgent 本地实践
第三章 · OoderAgent:在企业级多租户场景下落地
前两章介绍了两个"理想形态"——TRAE 宝是产品设计最成熟的独立助理平台,DeepSeek 是架构思路最清晰的 Agent Runtime 系统。但企业级场景有它们都不需要面对的约束:多租户隔离、服务端多实例部署、审计合规、不可依赖本地文件、与现有业务系统集成。
OoderAgent 是我们在 OODER Studio 中落地的 Super-agent 实现。下面从三个维度拆解它的设计决策:
①
四层上下文账本
租户级 L1 + 用户会话 L2 + 线程 L3 + 单轮 L4,SQLite 持久化,避免"换人接手上下文归零"
②
STEER 改向机制
"改成方案 B"不是一句孤立的新指令,而是沿用上一 Worker、但按新方向重下任务的路由决策
③
Watchdog + 事实上行
任务超时自动推进终态;项目账本只记事实,不存语义总结;多实例通过 SkillCenter 合并
3.1 为什么是 SQLite,不是 Markdown 文件?
TRAE 宝(本地版)使用可编辑的 Markdown 文件做记忆——每个项目一个目录,里面存全局原则、项目规则、每日日志。这个设计对个人开发者很友好:直接打开文件就能看、能改、能带走。
但企业级多租户场景下,"可编辑"等于"任何人可改全局事实",治理风险极高。而且 OODER 是服务端多实例部署,本地 Markdown 文件根本无法跨实例同步。
所以 OoderAgent 选择了 SQLite 本地账本 + SkillCenter 事实上行 的双层存储策略:
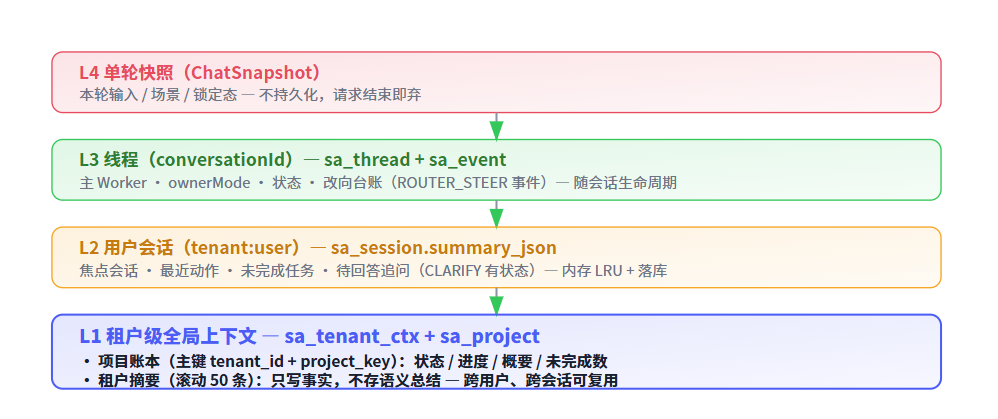
图 3 — OoderAgent 四层上下文模型(L1 是核心区别点:租户级而非用户级)
L1 为什么是租户级而不是用户级?
我们在审计文档里总结了改造前的问题6:原来 SessionKey = tenant:user,所有记忆都是用户级的。这意味着——换个人接手同一项目,上下文从零开始。这正是 TRAE 宝 Markdown 文件要解决的问题("做过的事不用反复讲"),但它的粒度是用户,不是租户。
OoderAgent 把 L1 做成 tenant_id 粒度:
- sa_project 表:主键 (tenant_id, project_key),存项目状态 / 进度 / 概要 / 未完成数。同租户内任何人接手同一项目都能读到。
- sa_tenant_ctx.summary_json:滚动 50 条最近任务摘要,只写事实(哪个 Agent、终态、耗时),不做语义总结。
"不引入模型写的总结,避免幻觉被制度化。" — 审计文档
3.2 STEER 改向:追问有状态,改向优先于直通
传统 Chat Agent 有个经典 bug:你说"帮我写个电商系统",Agent 开始干活。你说"改成 SaaS 版"——Agent 只会收到一句孤立的新指令,不知道这是"对上一任务的方向调整"还是一个全新的任务。它可能起一个新 Worker,和旧 Worker 并行跑,最后两个结果都给你。
OoderAgent 用 STEER_THREAD 决策解决这个问题。它在 Router 层做了两个关键改造:
① 追问从"一次性"改为"有状态"
原来 CLARIFY 只回一句话"我还需要知道 XXX",然后什么都不记录。下一轮用户开口时,Router 不知道是在回答追问还是在开新话题。
改造后:CLARIFY 被 Router 判定后,session.noteClarification(text) 只保留最新 1 条追问记录。下一轮用户开口时,Router 先检查"有没有待回答的追问"——如果有,先看用户的话是不是在回答追问;用户一开口就 clearClarification()。
② 改向优先于直通
判定顺序是:改向 → 直通 → 常规决策。改向的触发词(改成/换成/换个方案/方向不对/重做)加取消词优先排除(取消/停止/中断)——避免把"停止"误判为改向派给 Worker。
下发给 Worker 的正文是:
【方向调整】用户改变了上一任务的要求,请按下面的新要求继续,不要沿用旧方案:
<用户原话>
Router 不替用户编造新方案,只做"路由 + 记账"。改向事件会写入 sa_event(ROUTER_STEER),含 agentId / nodeId / directive / reason,可审计。
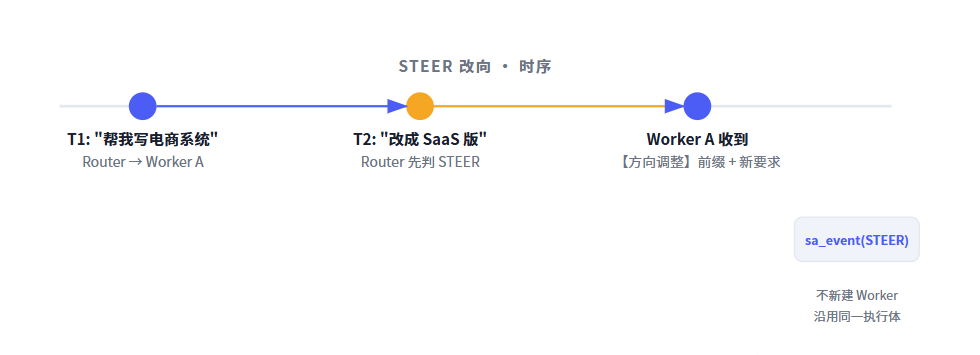
图 4 — STEER 改向时序:不新建 Worker,沿用同一执行体,改向事件落台账
3.3 SQLite 表结构:极简设计
OoderAgent 的 Store 里一共建了 8 张表7:
表名 | 主键 / 索引 | 粒度 | 写入时机 |
|---|---|---|---|
sa_session | session_key (tenant:user) | 用户级 | 首个聊天事件时 upsert |
sa_thread | conversation_id | 线程级 | ASSIGN_WORKER 时 bind |
sa_task | task_id (同时是 A2A requestId) | 单任务 | 派发时建,终态时推进 |
sa_event | event_id + dedup_key 唯一索引 | 事件 | 每轮消息、改向、终态都落 |
sa_bypass | message_id | 旁路观测 | 非 SA 出站的 A2A 派发只记账 |
sa_tenant_ctx | tenant_id | 租户级 | 任务终态时更新摘要 |
sa_project | (tenant_id, project_key) | 租户 × 项目 | 任务终态时重算状态/进度 |
几个设计细节:
- 旁路不阻断:任何持久化异常只 WARN,不抛穿调用方。Store 是观测者,不是主链的依赖。
- 关闭即零开销:ooder.superagent.enabled=false 时不建库、不建目录。
- 进度只算真实比例:progress = SUCCEEDED / (SUCCEEDED + FAILED + TIMEOUT + 未完成) × 100,无任务写 NULL。
- 租户隔离回填:老库没有 tenant_id 列的,从 session_key(tenant:user)解析回填。
- 事实上行队列:本地 SQLite 是执行视图,同时把项目事实入队、周期批量上行到 SkillCenter。队列有界(默认 1000)。
设计理念:账本 vs 执行体
OoderAgent 的 Route 层有个清晰的边界:Route = 账本 + 调度器,不是第二个执行体。它做的事是——判谁来做、记账、统一开口、维护上下文;但它不决定"怎么做"、不保存聊天正文、不做语义摘要。所有执行都交给 Worker Agent,Route 不替 Worker 编造结果。这个边界和 DeepSeek Super-agent 的 Router/Worker 分工高度一致。
第四章 · 三方对比
第四章 · 三方对比:架构 · 上下文 · 状态 · 适用场景
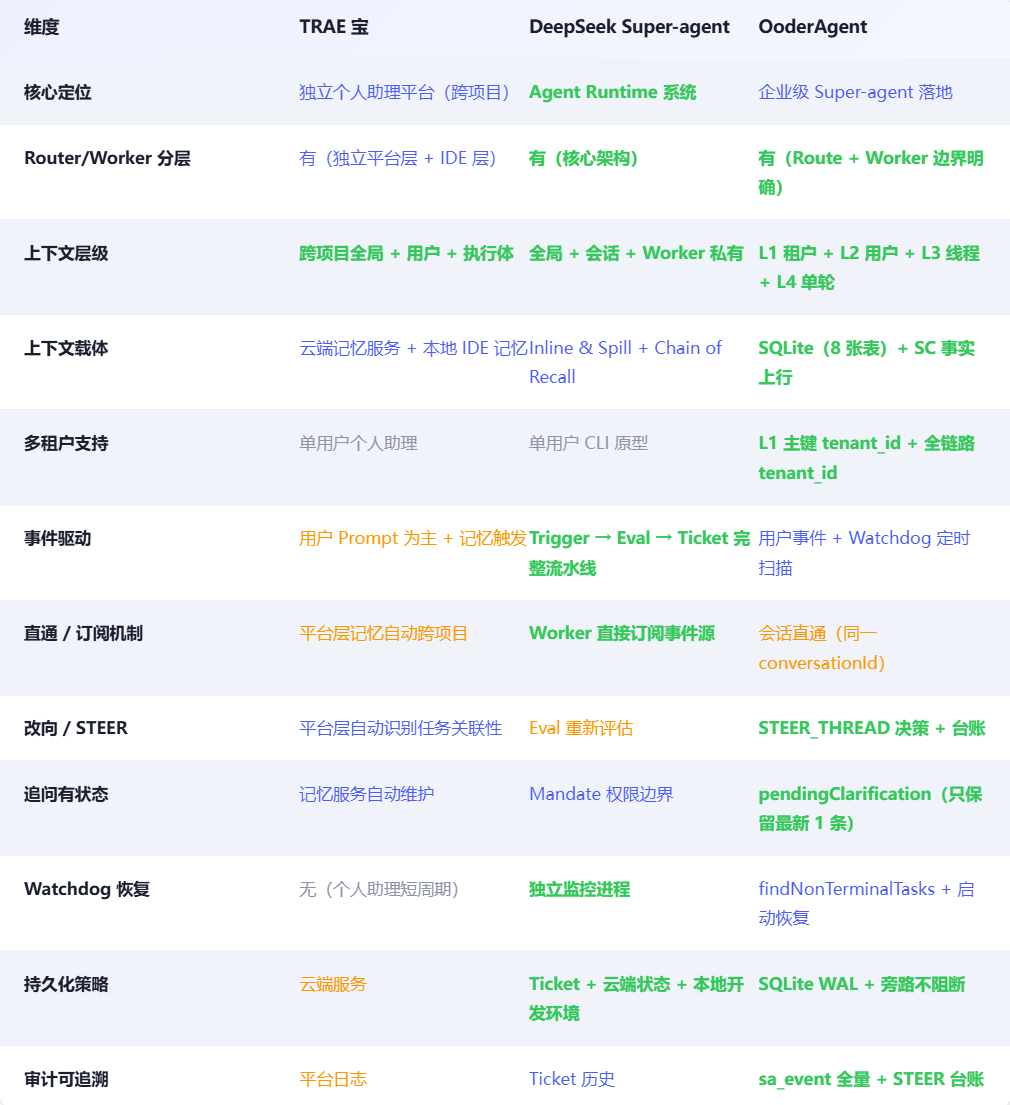
4.1 架构哲学的根本差异
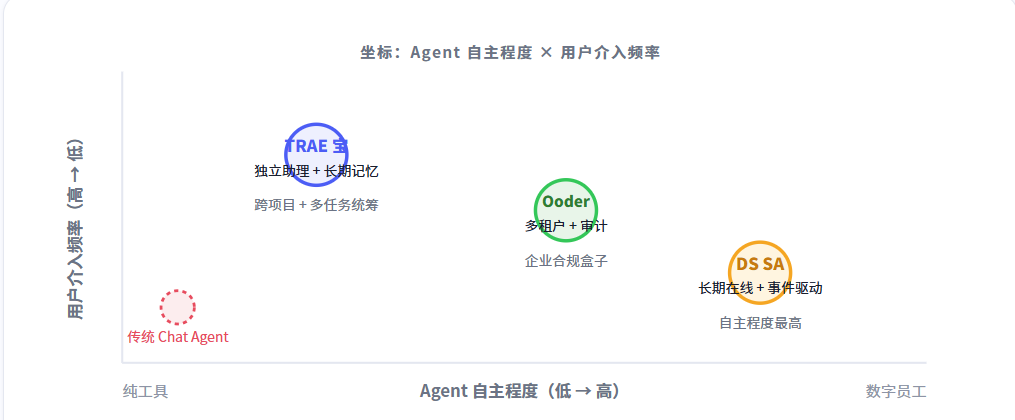
图 5 — 三方在"自主程度 × 介入频率"坐标上的位置
一句话总结
TRAE 宝是"让 Agent 跨项目长期跟随的个人助理"——跨项目记忆 + 多任务统筹 + 独立平台,产品形态最完整。
DeepSeek Super-agent是"让 Agent 自己当项目经理"——自主程度最高,事件驱动 + 直通订阅,让用户只在真正需要时介入。
OoderAgent是"把 Super-agent 装进企业合规盒子"——多租户隔离、全链路审计、SQLite 账本、Watchdog 恢复,是在 DeepSeek 架构基础上叠加企业级约束的落地形态。
第五章 · 产品设计启示
第五章 · 产品如何设计 Agent 系统?
5.1 UI/UE 设计的五个决策层级
① 符号先行:用自然语言映射技术能力
@Agent 选执行体、#Context 绑场景。用户不该学技术概念,而应该用社交语义表达意图。
② 透明度是信任的基础
实时流式回显 + 对话流折叠 = 既看到进度又不淹没主要信息。透明度 ≠ 微管理,透明度 = 安全感。
③ Diff 视图是交付物的必经环节
不是"我改好了",而是"你看看改了啥"。Side-by-side diff + 变更摘要 + "解释这处改动",让 Agent 的可交付性落到代码级。
④ 多 Agent 并行 ≠ 多窗口
多个 Agent 同时干活时,输出汇入同一个时间线,通过头像/标签区分。避免让用户在多个窗口间当项目经理。
⑤ 改向优先于新建
"改成方案 B"在用户脑中是同一任务的方向调整。路由系统必须识别这一点,沿用上一执行体但方向变了。
5.2 上下文管理的三个铁律
存储"事实",不存储"总结"
任务状态、耗时、参与 Agent — 这些是可验证的事实。不存模型生成的语义总结,避免"幻觉制度化"。
粒度要匹配协作单元
单用户工具 → 用户级足够。多人协作项目 → 至少要有租户级(跨用户可复用)。OoderAgent 的 L1 + L2 双层即为此。
存储是旁路,不是主链依赖
Store 挂了不应该导致 Router 无法决策。这个"旁路观测不阻断主链"的设计,在企业级场景下比理想持久化方案更重要。
5.3 Super-agent 的适用边界
什么时候不需要 Super-agent
如果你的业务是"分析一次对局、生成一份报告、翻译一段代码"——单次任务、一次性执行——传统 Multi-Agent(LangGraph、AutoGen)就足够了。Super-agent 的额外复杂度(Router/Worker 双层、Ticket 持久化、Watchdog、事实上行)带来的收益为零。
什么时候必须上 Super-agent
如果你的 Agent 要长期在线、主动发现任务、同时跟进多个互不相关的外部事件(GitHub PR、CI 监控、群聊 Bug 报告),或者需要在企业级多租户场景下合规审计——那就需要 Super-agent 的架构。
结语
结语
AI 编程助手发展到今天,一个新的瓶颈已经非常清晰:Agent 越来越强,但人的注意力没有变强。开 10 个 Agent 并行跑,不意味着生产力 × 10——因为你要在 10 个窗口间当项目经理。
TRAE 宝选择了一条路:把 IDE 内的编码 Agent 升级为跨项目长期跟随的个人助理平台。全局记忆、多任务统筹、独立平台双端——这些设计让"做过的事不用反复讲"从一个美好愿望变成日常可用的能力。
DeepSeek Super-agent 选择了另一条路:让 Agent 自己当项目经理。Router 常驻、Ticket 持久化、事件直通订阅——把"人管理 Agent"变成"Agent 管理 Agent"。
OoderAgent 走的是第三条路:把 Super-agent 装进企业合规的盒子。多租户隔离、SQLite 账本、全链路审计、Watchdog 恢复——不追求最极致的自主,不追求最精致的 UI,而是在"能跑"的基础上,解决"敢用"的问题。
三条路的终点是同一个方向——让 AI Agent 从"被动执行的工具",变成"长期在线的数字员工"。区别只是:你希望这个数字员工跨项目长期陪伴你(TRAE 宝),还是自己管自己只在需要时敲门(DeepSeek),还是在一个有门禁、有审计、有备份的开放办公区里工作(OoderAgent)。
技术选型的核心,从来不是"哪个架构最先进",而是"哪个架构最匹配你的约束条件"。
参考资料
- TRAE Team, TRAE 宝独立平台发布 (2026-11)。个人助理定位:全局助理 / 多任务并行 / 智能记忆。PC + Web 双端。docs.trae.cn / 更新日志
- TRAE Team, 会员续享个人助理 TRAE 宝限免一周。"长期跟随你的工作,跨项目理解方案与决策,统筹多任务并行执行"。docs.trae.cn / TRAE 宝介绍
- TRAE Team, @Agent: Reimaging the Future of Programming (2025-04-21)。@ 和 # 符号系统的设计哲学、Chat-Builder 统一。trae.ai / 产品博客
- DeepSeek Harness Team, Super-agent 设计探索:迈向更自主的 Agent 系统 (2026-11-01)。Router + Worker 双层、Trigger → Eval → Ticket → Executor、Subscription 直通。DeepSeek / 技术博客
- 算法一只狗, 从 Multi-Agent 到 Super-agent(2026-11-08)。四种方案效率对比实验、Fast/Slow Path、Watchdog 设计。技术社区 / 实验文章
- OoderAgent Route 界限与上下文生命周期审计文档 (2026-11-11)。四层上下文模型、STEER 改向、租户级 L1 vs 用户级 L2 的设计决策。本地文件:e:\gitee-ood\studio\docs\superagent-route-context-boundary-20261111.md
- SuperAgentStore.java 源码 (2026-11-11 P2 改造)。sa_session / sa_thread / sa_task / sa_event / sa_bypass / sa_tenant_ctx / sa_project 八张表。本地文件:e:\gitee-ood\studio\ooder-pro\src\main\java\net\ooder\studio\chat\superagent\SuperAgentStore.java
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号