语音前置诊断应用实践:WAV文件结构解析、RMS能量计算与本地ASR快速验证方案27.3
原创
语音前置诊断应用实践:WAV文件结构解析、RMS能量计算与本地ASR快速验证方案27.3
原创
未闻花名
发布于 2026-11-12 08:24:46
发布于 2026-11-12 08:24:46
一、前言
在前面我们做的语音转录过程中,客户端采集音频上传服务端后,经常遇到一类难以定位的线上问题:ASR识别结果为空、识别乱码、识别出噪声而非人声。很多时候ASR模型本身没有故障,问题根源藏在音频源头:采样率异常、通道错误、位深不匹配、全是底噪、音频片段为空、录音截断等。大模型语音识别ASR对输入音频格式、有效人声能量十分敏感,输入数据一旦不符合模型训练时的标准,再强大的大模型也会输出错误结果。
线上问题排查最大痛点是:拿到日志只能看到识别文本,看不到原始音频底层属性,无法区分是录音硬件、前端编码、传输丢包,还是ASR模型本身的问题。直接批量人工听音频效率极低,尤其并发上传场景,短时间会产生大量kid_*.wav录音文件。今天我们针对项目实践过程遇到的问题使用的排查过程,完整剖析一段临时排查Python脚本,它专门针对孩子端上传WAV音频,自动读取音频元信息、分段计算音频能量分布,再调用项目内部ASR接口做转录,一次性输出结构化诊断报告。这个脚本属于语音工程前置诊断工具,在大模型语音链路调试、数据质检、线上故障定位场景具备很高实用价值。
二、项目整体介绍
1. 脚本核心目标
我们所使用的这个诊断工具,核心目标就是批量读取最近上传的儿童端WAV录音文件,完成音频信息采集 + 音频能量质检 + ASR模型转录验证,输出JSON结构化报告,快速定位语音识别失败的根因。
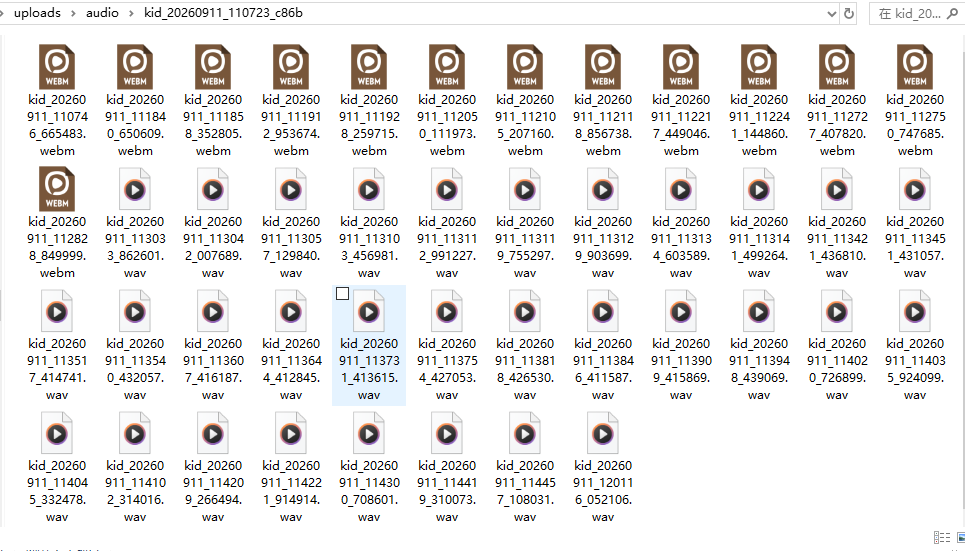
业务场景限定:端侧设备的录音,文件命名规则kid_*.wav,统一上传到uploads/audio/目录下,多子目录存储。脚本只取最近修改时间最新4条音频,优先处理最新上传录音,避免扫描海量历史文件拖慢速度。
首先我们需要明确几个关键疑问:
- 音频文件本身是否合法?文件大小是否为0字节,是不是损坏文件。
- WAV参数是否符合ASR模型输入规范:采样率、通道数、采样位深、音频时长。很多ASR大模型只支持16kHz、单通道、16bit PCM音频,参数不匹配会直接识别失效。
- 音频有没有有效人声,还是全程环境底噪、静音。通过每0.5秒分段RMS能量判断人声分布,区分静音段、噪声段、人声段。
- 直接调用项目内部ASR模型,拿到真实转录结果,确认模型在当前原始音频上的输出,对比音频能量,判断是没有声音,还是模型识别缺陷。
脚本定位是临时调试工具,注释也标注跑完可以删除,不需要部署长期在线服务。多用于开发联调、线上问题复现、数据集清洗阶段,不是业务主链路代码,不参与正式用户请求响应。
2. 整体执行流程
整个探测过程执行分为4个核心步骤,顺序执行:
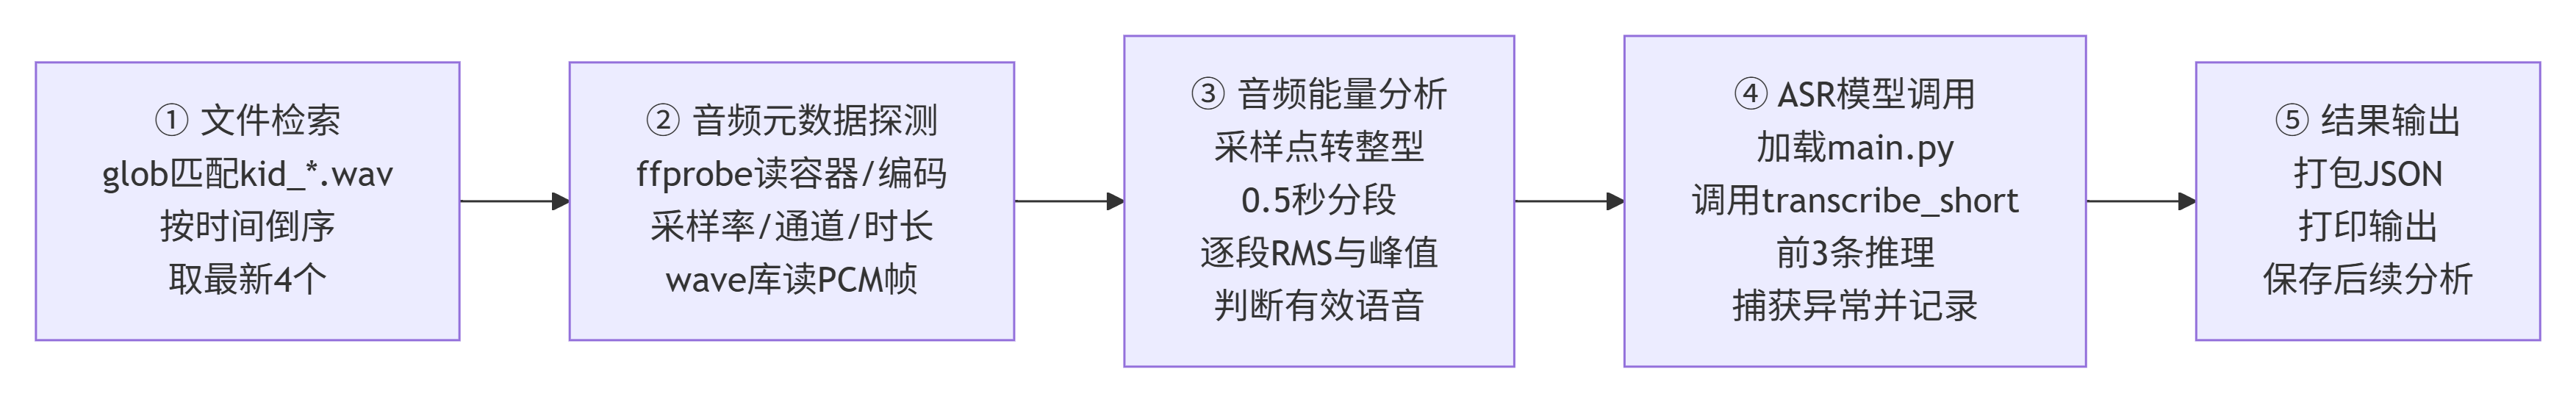
- 1. 文件检索:glob遍历上传目录,匹配kid_*.wav,按文件修改时间倒序,取最新4个音频文件。
- 2. 音频元数据探测:调用ffprobe工具,读取容器、编码、采样率、通道、时长信息;同时使用Python内置wave库读取PCM原始采样帧。
- 3. 音频能量分析:将原始音频采样点转为整型数组,按0.5秒分段,逐段计算RMS能量与峰值,记录每一段能量值,判断音频有没有有效语音。
- 4. ASR模型调用:动态加载项目内主模块main.py业务模块,调用transcribe_short短语音识别接口,对前3条音频做模型推理,捕获异常,记录识别文本或报错信息。
- 5. 结果输出:把所有文件信息、音频参数、分段RMS、ASR识别结果打包为JSON,打印输出,方便直接保存到文件,用于后续分析。
transcribe_short核心思路:
def transcribe_short(wav_path):
    """单个语音片段 → 文本(跳过句级说话人聚类,优先速度)"""
    model = get_asr_model()
    if model is None:
        return ""
    try:
        res = model.generate(input=wav_path, return_spk_res=False)
        if not res:
            return ""
        return clean_asr_text(res[0].get("text", ""))
    except Exception as e:
        print("[warn] 片段识别失败:", type(e).__name__, e)
        return ""
3. 在大模型语音体系中的定位
完整大模型语音交互链路分为多个环节:客户端录音 → 音频编码/封装 → 网络上传 → 服务端音频预处理 → ASR大模型推理 → 后处理输出文本。

通常我们的注意力集中在ASR大模型本身,优化模型参数、微调数据集、提升识别准确率。但工程实践中,超过半数识别异常问题,发生在模型之前的音频预处理、客户端采集环节。

今天我们探测的是模型输入侧的前置诊断工具,位于ASR模型上游,职责不是优化模型,而是校验送入模型的数据质量。它的作用类似大模型的数据质检单元:在数据进入大模型之前,校验数据合法性。
在大模型语音项目体系里,同类工具还有离线数据集清洗脚本、音频自动过滤工具、噪声检测模块。区别在于,这个工具方法面向线上实时上传文件,轻量、临时,直接读取原始上传文件,不需要额外存储数据库,一键运行即可拿到诊断信息,适合快速排查偶发问题。
三、音频文件检索模块
1. 文件检索实现原理
脚本第一部分是文件检索逻辑,使用Python内置glob模块做路径匹配,os模块获取文件修改时间。
wavs = sorted(glob.glob(os.path.join("uploads", "audio", "*", "kid_*.wav")),
              key=os.path.getmtime, reverse=True)[:4]
核心注解:
- glob是文件通配符工具,sorted排序函数;
- uploads/audio/*/kid_*.wav含义:uploads/audio下所有一级子目录,匹配文件名以kid_开头、后缀wav的音频文件。
- os.path.join用于跨平台拼接路径,避免Windows、Linux路径分隔符差异。
- key指定os.path.getmtime,getmtime获取文件最后修改时间戳,单位秒。
- reverse=True代表降序,最新修改的文件排在列表前面。
- 切片[:4]只保留前4条音频,控制单次诊断文件数量,防止目录有成千上万录音文件时,脚本执行时间过长,消耗大量CPU内存。
2. 基础示例代码
遍历uploads目录,按修改时间倒序筛选最新的3个kid_*.wav音频文件,并打印路径与大小。
import glob
import os

# 遍历目录,获取最新3个wav文件
audio_path_list = sorted(
    glob.glob(os.path.join("uploads", "audio", "*", "kid_*.wav")),
    key=os.path.getmtime,
    reverse=True
)[:3]
for file in audio_path_list:
    print("文件路径:", file)
    print("文件大小bytes:", os.path.getsize(file))
3. 应用设计考量
这里的设计有明确取舍,作为临时排查脚本,优先保证简单高效,牺牲部分扩展性。
- 优点:无需数据库,直接扫描磁盘文件,不需要日志检索,拿到服务器本地目录即可运行;代码极简,不需要额外第三方包。
- 局限性:只能扫描本地磁盘文件;如果音频存储在对象存储OSS,这个方案失效;文件修改时间会受服务器文件拷贝操作影响,存在极小概率时间戳不准。
- 业务适配:儿童端录音文件命名统一带kid前缀,很方便过滤其他业务音频,避免混入成人录音、测试音频干扰排查结果。
四、音频元信息读取模块
1. ffprobe外部探测原理
ffprobe是FFmpeg套件自带的音视频信息探测工具,广泛用于音视频工程。脚本使用subprocess调用ffprobe子进程,直接读取音频流信息。
r = subprocess.run(["ffprobe", "-v", "error", "-show_entries",
                    "stream=codec_name,sample_rate,channels,bits_per_sample",
                    "-show_entries", "format=duration",
                    "-of", "json", p], capture_output=True, text=True)
参数含义拆解:
- -v error:只输出错误日志,屏蔽冗余info日志,减少输出干扰。
- -show_entries:指定需要提取的字段,stream是音频流参数,format是封装容器参数。需要获取编码名称、采样率、通道数、位深、音频总时长。
- -of json:输出格式指定JSON,方便Python直接json.loads解析。 subprocess.run创建独立子进程运行ffprobe,capture_output=True捕获标准输出stdout、stderr;text=True让输出直接返回字符串,不是bytes二进制。
核心优点:
- ffprobe支持几乎所有wav变种格式,不仅PCM,也能读取压缩wav;比Python内置wave库兼容性更强。
- wave库只能读取标准PCM WAV,遇到非标准压缩wav会直接报错。
- 所以脚本同时使用两套方案:ffprobe做全面探测,wave读取原始PCM采样帧用于能量计算。
捕获异常逻辑:如果ffprobe执行失败、输出不是合法JSON,捕获异常,保存前200字符原始输出,方便看报错原因,不会让整个脚本直接崩溃退出。
2. Python wave库读取原始采样
wave是Python标准库,专门读取标准PCM WAV文件,读取音频原始采样帧数据,这是后面RMS能量计算的数据源。
with wave.open(p, "rb") as w:
    n, sr, ch, sw = w.getnframes(), w.getframerate(), w.getnchannels(), w.getsampwidth()
    raw = w.readframes(n)
import array
    a = array.array("h")
    a.frombytes(raw[:len(raw) // 2 * 2])
if sw != 2:
    info["note"] = "sampwidth=%s" % sw
wave.open以二进制只读rb打开wav。
- getnframes:总采样帧数;
- getframerate:采样率sr;
- getnchannels:通道ch,1单声道,2立体声;
- getsampwidth:每个采样字节宽度,1代表8bit,2代表16bit,3代表24bit。
readframes(n)读取全部采样帧,返回二进制bytes数据流。
- WAV文件存储PCM采样点,二进制原始数据,不能直接当成数字,需要array数组转换成short整型。
- array.array("h")代表short有符号整型,2字节,正好匹配16bit音频。
- raw[:len(raw) // 2 * 2]是边界保护,防止字节总数为奇数,array解析时报错,截断多余1字节。
- 当采样位深不是2字节,脚本记录note标记,提醒排查,因为业务ASR模型一般只接受16bit(sw=2)音频。
3. 基础示例代码
基于Python标准库的wave模块,封装了WAV音频文件的基础参数解析功能,可快速获取采样率、声道数、位宽及音频时长等关键信息。
import wave

def read_wav_info(wav_path):
    with wave.open(wav_path, "rb") as wf:
        frames = wf.getnframes()
        sr = wf.getframerate()
        channels = wf.getnchannels()
        sampwidth = wf.getsampwidth()
        duration = frames / sr
        print(f"采样率:{sr},通道:{channels},位宽:{sampwidth*8}bit,时长:{duration:.2f}s")

# 调用示例
# read_wav_info("test.wav")
五、RMS音频能量计算模块
1. 音频基础原理介绍
声音采集本质是模拟信号转数字信号,PCM采样把连续声波,按照固定采样率离散采样,保存成数字。采样数值代表某一瞬间声波振幅,有正负,中心0代表无声。
RMS全称Root Mean Square,均方根,是音频工程最常用的能量衡量指标,用来表征音量大小。单纯取采样点平均值会正负抵消,得到0,无法衡量音量。均方根计算逻辑:采样值平方 → 求平均值 → 开平方根。平方消除正负号,保留振幅大小。
脚本设定分段窗口0.5秒,每0.5s计算一段RMS。为什么选0.5秒?人声发音一般几百毫秒,0.5s窗口足够区分静音段、短语音片段,窗口太大,会把静音和人声平均,丢失细节;窗口太小,计算量增加,数据过多。公式:
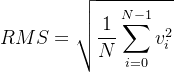
- Vi是单采样点的整型幅值;N是窗口内采样点数量。
16bit有符号PCM采样取值范围是[-32768, 32767],脚本最后除以32768归一化,RMS结果落在0~1之间。数值越接近1音量越大,接近0代表静音或者微弱底噪。peak记录窗口最大振幅,用来获取整段音频最大音量。
2. 脚本代码逐段解析
以下示例脚本将音频按半采样率分段,逐段计算RMS能量与峰值振幅,用于音频响度分析与静音检测。
step = sr // 2
rms, peak = [], 0
for i in range(0, len(a) - 1, step):
    seg = a[i:i + step]
    s = 0
    mx = 0
    for v in seg:
        s += v * v
        if v > mx:
            mx = v
        elif -v > mx:
            mx = -v
    rms.append(round((s / max(1, len(seg))) ** 0.5 / 32768.0, 4))
peak = max(peak, mx)- step = sr//2:采样率除以2,得到0.5秒对应的采样点数量。sr=16000,step=8000,刚好8000个采样点对应0.5s音频。
- 循环按step滑动切片,每次取出一段采样数组seg,遍历累加平方,同时计算当前片段最大绝对值mx。
- max(1, len(seg))是保护,防止切片为空除以0报错。
- 计算完RMS后保留4位小数存入rms_0.5s数组,最终写入JSON报告。
拿到rms数组后,我们可以直接观察:数组全部接近0:音频全程静音,录音失败;稳定在0.01~0.05:环境底噪,没有有效人声;部分片段突然升高到0.1~0.4:存在有效语音;RMS超过0.8:音量爆音、削波,会造成ASR识别失真。
3. 基础示例代码
以下示例封装了音频 RMS 计算函数,按指定窗口时长分段,计算每段的均方根能量并归一化,返回能量序列。
import wave
import array
import math

def calc_rms(wav_path, window_sec=0.5):
    with wave.open(wav_path, "rb") as wf:
        sr = wf.getframerate()
        raw = wf.readframes(wf.getnframes())
    a = array.array("h")
    a.frombytes(raw[:len(raw)//2*2])
    step = int(sr * window_sec)
    rms_list = []
    for i in range(0, len(a), step):
        seg = a[i:i+step]
        square_sum = sum(v*v for v in seg)
        rms = math.sqrt(square_sum / len(seg)) / 32768
        rms_list.append(round(rms,4))
    return rms_list

# rms_result = calc_rms("test.wav")
# print(rms_result)
4. 和大模型ASR的关联
大模型ASR训练数据里,有效语音都有合理能量区间。送入模型的音频如果全程RMS接近0,模型没有语音信息,大概率返回空文本;如果持续低能量噪声,模型会把噪声识别成乱码。
很多ASR模型内置VAD语音活动检测,VAD本质也是基于能量、频谱特征判断有没有人声。脚本里手动实现简化版能量VAD,不依赖模型,提前判断音频质量,区分“没有声音”和“模型识别错误”两种问题,这就是这个诊断脚本的核心价值:如果RMS显示音频有人声,但ASR识别错误,说明问题在模型或者预处理;如果RMS全0,则录音硬件/前端采集故障。
六、动态模块加载与ASR调用
1. importlib动态加载原理
Python常规import需要提前知道模块名称,这个项目主文件名称带有动态编号*271*main.py,文件名不是固定常量,无法直接import导入。脚本使用importlib标准库,动态根据文件路径加载Python模块。

spec = importlib.util.spec_from_file_location("kidmain", glob.glob("*271*main.py")[0])
m = importlib.util.module_from_spec(spec)
sys.modules["kidmain"] = m
spec.loader.exec_module(m)

for p in wavs[:3]:
    try:
        out.setdefault("asr", []).append({
            "name": os.path.basename(p),
            "text": m.transcribe_short(p),
        })
    except Exception as e:
        out.setdefault("asr", []).append({"name": os.path.basename(p),
"err": "%s: %s" % (type(e).__name__, str(e)[:100])})- spec_from_file_location:第一个参数是自定义模块名称kidmain,第二个是文件路径,生成模块规范spec。
- module_from_spec根据spec创建空模块对象m;注册到sys.modules,避免模块重复加载冲突;
- exec_module执行py文件,运行里面所有代码,模块内函数、类就被加载到m对象中。
- 加载完成后,直接调用m.transcribe_short(p),传入wav路径,调用项目内部ASR短语音转录函数。
- transcribe_short就是封装好的ASR推理接口,内部一般会调用大模型,加载模型权重,做音频预处理、推理,返回识别文本。
2. 异常捕获设计
try:
    out.setdefault("asr", []).append({
        "name": os.path.basename(p),
        "text": m.transcribe_short(p),
    })
except Exception as e:
    out.setdefault("asr", []).append({"name": os.path.basename(p),
"err": "%s: %s" % (type(e).__name__, str(e)[:100])})- 这里增加try except捕获所有异常,避免某一条音频ASR推理报错,直接让整个脚本终止。
- setdefault,如果out字典没有asr键,自动创建空列表。
- 异常信息记录异常类型+异常字符串,截断到100字符,防止报错信息过长,JSON体积爆炸。
3. 动态加载Python文件示例
通过importlib动态加载当前目录下首个main.py文件作为模块,实现 ASR 语音识别模块的运行时热加载与调用。
import importlib.util
import glob

py_path = glob.glob("*main.py")[0]
spec = importlib.util.spec_from_file_location("asr_mod", py_path)
mod = importlib.util.module_from_spec(spec)
spec.loader.exec_module(mod)
# res = mod.transcribe_short("test.wav")
# print(res)
4. ASR链路工程意义
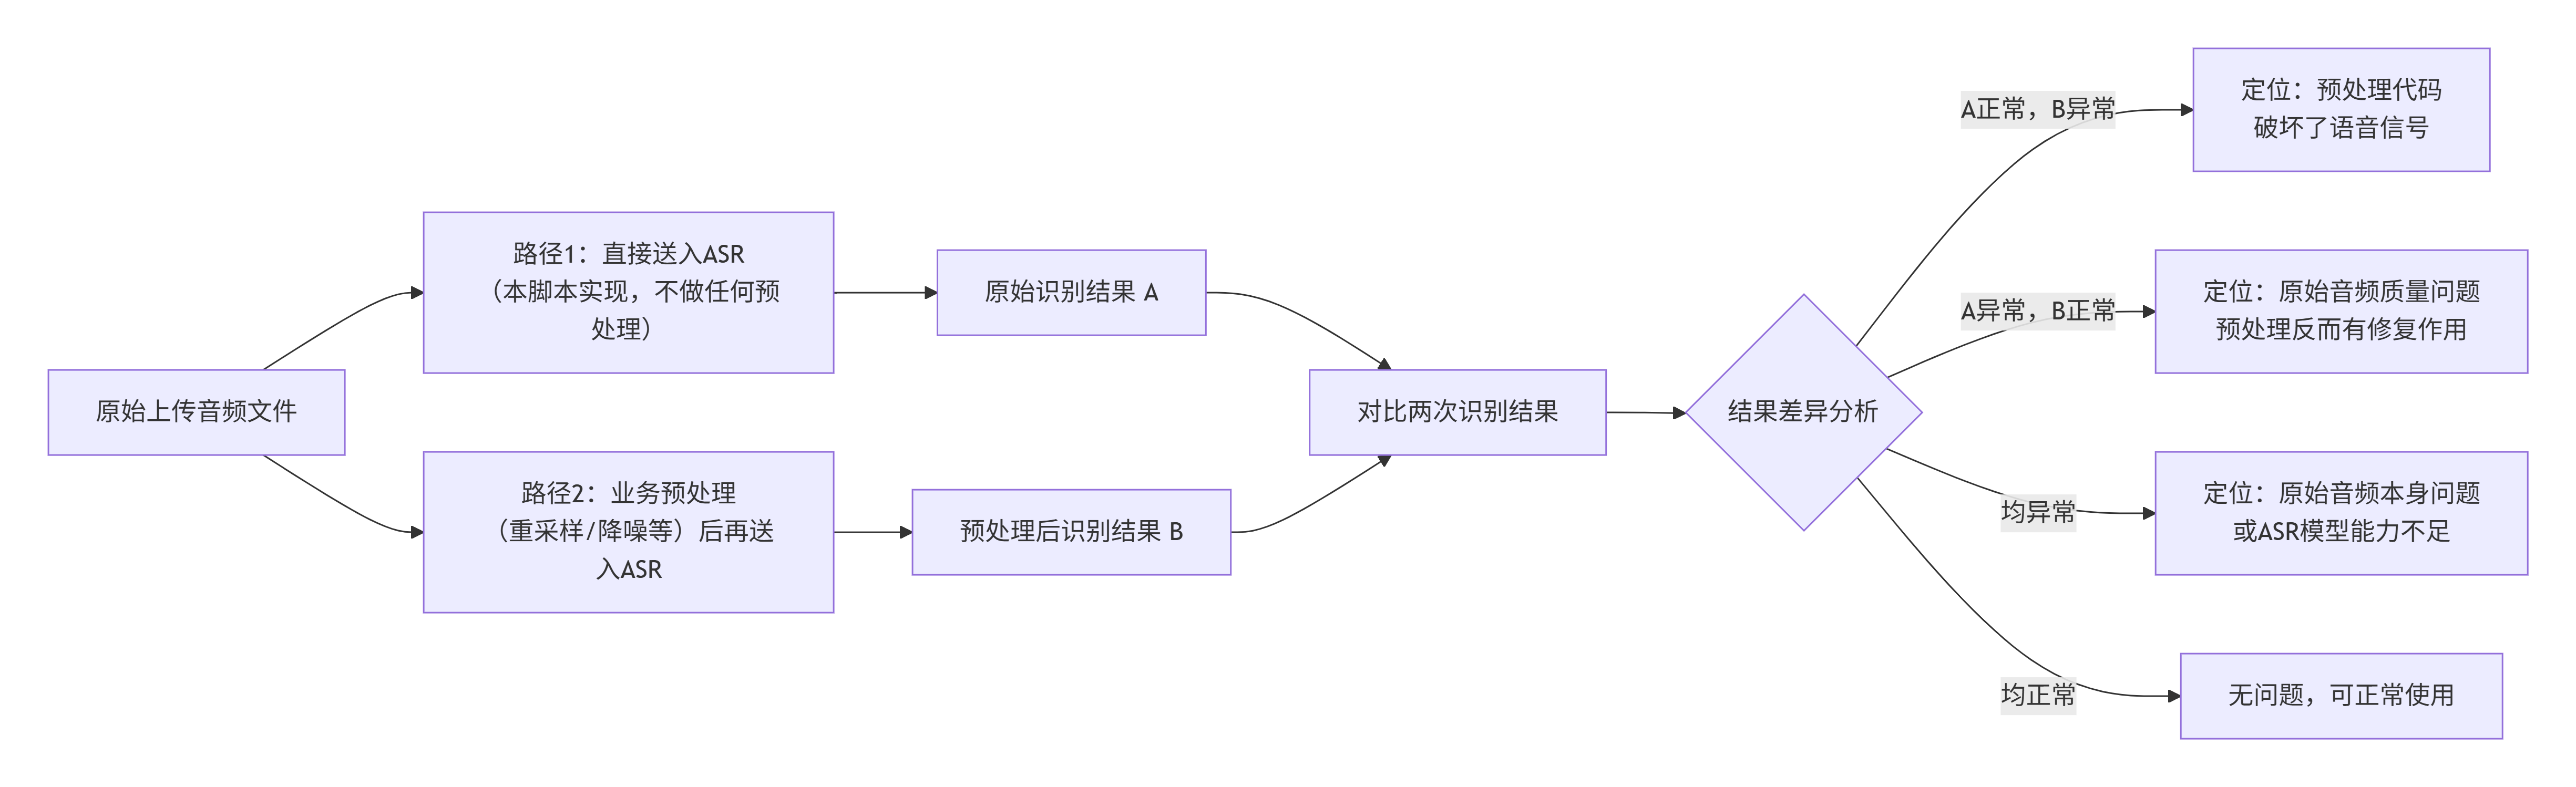
在大模型项目调试时,我们经常需要隔离变量。现在这套逻辑:拿到原始上传文件,不做任何转码预处理,直接送入ASR函数,得到原始识别结果。
对比测试思路:
- 原始音频直接推理:本脚本实现;
- 音频经过业务预处理(重采样、降噪)后再推理。 两次识别结果对比,就可以定位问题:是原始音频本身问题,还是预处理代码破坏语音,导致大模型识别失败。
临时脚本不修改业务代码,不侵入线上服务,独立运行,非常适合做对照实验。
七、结果输出与JSON报告
1. JSON结构化输出逻辑
print(json.dumps(out, ensure_ascii=True, indent=1))out字典是报告根对象,包含files数组,可选asr数组。json.dumps序列化Python字典到JSON字符串。
- ensure_ascii=True:中文转unicode编码,保证不同终端打印不会乱码;
- indent=1:换行缩进,格式化输出,方便阅读。
输出字段清单: files数组内单文件信息:
- name:文件名;
- bytes:文件字节大小;
- probe:ffprobe读取的音视频元信息;
- sr,ch,dur:采样率、通道、时长;
- peak:音频最大归一化振幅;
- rms_0.5s:每0.5秒RMS能量列表;
- note:异常标记,比如采样位宽不匹配。
asr数组:
- name:音频文件名;
- text:ASR识别文本,成功时;
- err:异常类型+报错信息,推理失败时。
输出直接打印控制台,使用者可以重定向保存文件python debug.py > report.json,方便后续用Python、前端工具可视化分析,绘制RMS能量曲线。
2. 构造JSON报告示例
构建了一个包含音频文件信息(文件名、时长、RMS能量序列)和ASR识别结果的JSON报告,并格式化输出。
import json
report = {
    "files": [
        {"name": "kid_01.wav", "dur": 2.4, "rms_0.5s":[0.001,0.23,0.18,0.002]}
    ],
    "asr": [{"name":"kid_01.wav","text":"你好"}]
}
print(json.dumps(report, indent=2, ensure_ascii=True))
八、完整执行脚本
完整用于排查孩子端上传音频问题的临时诊断脚本,整合了音频元信息提取、能量分布分析与ASR识别验证功能。
重点说明:
- 文件筛选:按修改时间倒序获取最新4个kid_*.wav音频文件
- 元信息提取:调用ffprobe获取编码、采样率、声道、位宽、时长等参数
- 能量分析:按0.5秒窗口计算RMS能量序列与峰值,判断是否有声音或底噪
- 识别验证:动态加载ASR模块,对前3个音频执行短语音识别并记录结果
- 结构化输出:将所有诊断信息整合为JSON格式打印,便于快速定位问题
# -*- coding: utf-8 -*-
"""临时排查:看孩子端刚上传的 wav 到底长什么样(能量分布 + 直接识别)
   跑完可删除
"""
import glob
import json
import os
import subprocess
import sys
import wave
import importlib.util

wavs = sorted(glob.glob(os.path.join("uploads", "audio", "*", "kid_*.wav")),
              key=os.path.getmtime, reverse=True)[:4]

out = {"files": []}
for p in wavs:
    info = {"name": os.path.basename(p), "bytes": os.path.getsize(p)}
    r = subprocess.run(["ffprobe", "-v", "error", "-show_entries",
                        "stream=codec_name,sample_rate,channels, bits_per_sample",
                        "-show_entries", "format=duration",
                        "-of", "json", p], capture_output=True, text=True)
    try:
        info["probe"] = json.loads(r.stdout)
    except Exception:
        info["probe"] = r.stdout[:200]
    # 逐 0.5s 算 RMS,看有没有声音 / 是不是一直有底噪
    with wave.open(p, "rb") as w:
        n, sr, ch, sw = w.getnframes(), w.getframerate(), w.getnchannels(), w.getsampwidth()
        raw = w.readframes(n)
    import array
    a = array.array("h")
    a.frombytes(raw[:len(raw) // 2 * 2])
    if sw != 2:
        info["note"] = "sampwidth=%s" % sw
    step = sr // 2
    rms, peak = [], 0
    for i in range(0, len(a) - 1, step):
        seg = a[i:i + step]
        s = 0
        mx = 0
        for v in seg:
            s += v * v
            if v > mx:
                mx = v
            elif -v > mx:
                mx = -v
        rms.append(round((s / max(1, len(seg))) ** 0.5 / 32768.0, 4))
        peak = max(peak, mx)
    info.update({"sr": sr, "ch": ch, "dur": round(n / sr, 2),
                 "peak": round(peak / 32768.0, 4), "rms_0.5s": rms})
    out["files"].append(info)

# 直接走后端识别,看看到底识别成了什么
spec = importlib.util.spec_from_file_location("kidmain", glob.glob("*271*main.py")[0])
m = importlib.util.module_from_spec(spec)
sys.modules["kidmain"] = m
spec.loader.exec_module(m)

for p in wavs[:3]:
    try:
        out.setdefault("asr", []).append({
            "name": os.path.basename(p),
            "text": m.transcribe_short(p),
        })
    except Exception as e:
        out.setdefault("asr", []).append({"name": os.path.basename(p),
                                          "err": "%s: %s" % (type(e).__name__, str(e)[:100])})

print(json.dumps(out, ensure_ascii=True, indent=1))
运行输出:
{ "files": [ { "name": "kid_20260912_233431_973846.wav", "bytes": 190230, "probe": { "programs": [], "stream_groups": [], "streams": [ { "codec_name": "pcm_s16le", "sample_rate": "16000", "channels": 1, "bits_per_sample": 16 } ], "format": { "duration": "5.943313" } }, "sr": 16000, "ch": 1, "dur": 5.94, "peak": 0.6472, "rms_0.5s": [ 0.0211, 0.0352, 0.0315, 0.0122, 0.0052, 0.0364, 0.0207, 0.0375, 0.0303, 0.0216, 0.0034, 0.003 ] }, { "name": "kid_20260912_225112_160177.wav", "bytes": 132886, "probe": { "programs": [], "stream_groups": [], "streams": [ { "codec_name": "pcm_s16le", "sample_rate": "16000", "channels": 1, "bits_per_sample": 16 } ], "format": { "duration": "4.151313" } }, "sr": 16000, "ch": 1, "dur": 4.15, "peak": 0.7801, "rms_0.5s": [ 0.005, 0.0238, 0.0598, 0.0362, 0.0486, 0.0402, 0.0191, 0.0048, 0.0051 ] }, { "name": "kid_20260912_200426_819679.wav", "bytes": 512448, "probe": { "programs": [], "stream_groups": [], "streams": [ { "codec_name": "pcm_s16le", "sample_rate": "16000", "channels": 1, "bits_per_sample": 16 } ], "format": { "duration": "16.012625" } }, "sr": 16000, "ch": 1, "dur": 16.01, "peak": 0.8159, "rms_0.5s": [ 0.0045, 0.0058, 0.0658, 0.0459, 0.0466, 0.007, 0.0199, 0.0346, 0.0281, 0.0411, 0.0388, 0.0481, 0.0354, 0.053, 0.0062, 0.0134, 0.0169, 0.0252, 0.0226, 0.029, 0.0192, 0.0607, 0.0418, 0.0094, 0.0668, 0.0357, 0.061, 0.0065, 0.0225, 0.0537, 0.0072, 0.0054, 0.0056 ] }, { "name": "kid_20260912_200407_266018.wav", "bytes": 201152, "probe": { "programs": [], "stream_groups": [], "streams": [ { "codec_name": "pcm_s16le", "sample_rate": "16000", "channels": 1, "bits_per_sample": 16 } ], "format": { "duration": "6.284625" } }, "sr": 16000, "ch": 1, "dur": 6.28, "peak": 0.8499, "rms_0.5s": [ 0.0045, 0.0062, 0.0597, 0.0417, 0.0173, 0.0142, 0.0663, 0.0179, 0.0662, 0.044, 0.0232, 0.0057, 0.0057 ] } ], "asr": [ { "name": "kid_20260912_233431_973846.wav", "text": "" }, { "name": "kid_20260912_225112_160177.wav", "text": "" }, { "name": "kid_20260912_200426_819679.wav", "text": "" } ] }
详细解读:
- 1. 音频基础信息(完全正常)
- 格式统一:4个文件均为标准的pcm_s16le编码,16kHz采样率,单声道,16bit位宽。这是语音识别最标准的输入格式,排除了编码不兼容的可能。
- 时长合理:时长分布在4秒到16秒之间,属于正常的短语音交互范围。
- 2. 能量分布分析(有真实语音)
- 峰值(Peak):所有文件的peak值都在0.64到0.85之间,说明音频信号幅度很大,没有削波失真,也没有因为录音距离过远导致信号微弱。
- RMS 能量序列:可以看到RMS值有明显的起伏波动,例如第三个文件在0.004到0.066之间跳动。这种“低-高-低”的交替变化,是典型的人类语音特征,包含停顿和发声段。如果是环境底噪,RMS 通常会是一条平直的直线;如果是纯静音,RMS会接近0。
- 结论:孩子确实说话了,且录音质量尚可。
- 3. ASR 识别结果(异常点)
- 全军覆没:前3个音频文件的识别结果text均为空字符串。
- 矛盾点:既然音频里有明显的语音能量,模型却识别不出任何内容。
九、总结
大模型的落地,绝不是只训练模型。落地可用的语音产品,模型只是链路一环,数据质量是决定线上效果的核心因素之一。这里很容易在模型微调投入大量算力,却忽略上游采集链路,线上大量低质量音频流入模型,识别效果差,模型微调也很难覆盖硬件、录音链路带来的噪声、静音问题。
实践的排查脚本就是一个轻量化数据诊断实践。它的核心思想是:在大模型推理前,做低成本的音频质检,把问题分层。故障分层:文件损坏、上传不完整;音频参数不匹配:采样率、通道、位深;录音静音/低信噪比噪声;音频本身正常,但ASR模型识别错误。分层之后,研发可以快速分配责任人:前3类问题属于前端、硬件、采集链路,第4类才属于ASR模型团队,极大降低定位时间,避免模型团队花费大量时间排查非模型类问题。
日常开发可以扩展脚本,保存诊断报告到日志系统,统计每日低质量音频占比,持续监控客户端录音质量。一旦突然出现大量静音音频,提前告警,在用户大规模反馈识别失效前,发现设备硬件或者前端录音BUG。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号