脏数据被包装成结论、建议、风险提示之后,错得更整齐,也更贵
原创
脏数据被包装成结论、建议、风险提示之后,错得更整齐,也更贵
原创
茗鹤APS和MES
发布于 2026-11-12 09:43:00
发布于 2026-11-12 09:43:00
周一早上八点半,这张工单第一次变得好看。
计划员把它发到工位,机加、热处理、装配排得清楚,报工栏当天填满:做了多少、谁做的、几点转到下道。早会上有人说,这张单没问题。
周二上午,它转到了热处理。流转卡上多了一行字,系统里那一栏没动。
周三下午,装配那边换了班组,手里压着另外两张急单。这张工单在系统里的状态栏空着——没人做,也没人写"不做"。
周四它被跳过两次。一次是设备让给了别的活,一次是"等上一道清完再叫我们"。等,在车间里合理;在数据里,它是空的。
周五临下班,这张工单突然被填满了。补录的人对着流转卡回忆:机加大概是周三做的,热处理哪天想不起来,装配是今天。三栏补齐,状态推到完工。
月底盘点,实盘数跟系统数对不上。对不上的是数量,没有人说得清它是从哪一天开始对不上的。
不是员工不负责
这种场面在月度会上常见,第一反应也总是同一句:车间不重视录入,要考核。考核发下去,头一周齐整,之后回到原样。
原因更朴素。操作工一天的动作是上料、看刀、量尺寸、换箱、交接。填一栏"实际开工时间",跟这些动作一个都扣不上。它不在他的动线上,只能靠额外的意志维持。
意志力有成本,而且没人给它付过。
数据质量靠自觉,这件事本身就不成立。
所以真正要问的不是"谁不负责",而是录入这件事,系统替他做掉了没有。多数工厂的答案是没有:采集通道没通到工位,录入嵌不进作业动作,不一致也没人当天知道。
这笔账其实一直在付,只是付在了别处:加一个统计员专门录数,加一本台账专门兜底,加一次周会专门核对不上账的数。这三样都补在漏的下游:桶还在漏,盆越摆越多。
数据没人负责,说的不是没人干活,是每一栏都没有主人。谁填、谁核、错了谁改,说不清的时候,最后就变成月底那几天大家一起熬夜。
要治的是上面这三处,不是态度。
能自动采的,绝不手填
第一道机制,是把人从录入里退出来。
设备出得了信号的先取设备,工位认得出来的先由工位认。开动与停止、这一件什么时候下线——这些事实本来就发生在机器和夹具上。让人凭记忆复述一遍,等于把发生过的数据改写一遍。
手填留下的是"大概几点",自动采留下的是"什么时候开始动、什么时候停"。前者给人看还行,后者才给系统用。
采不动的先明确不采,也比留一栏空着等人填要好。这条纪律不体面,省下来的是将来对不上的账。
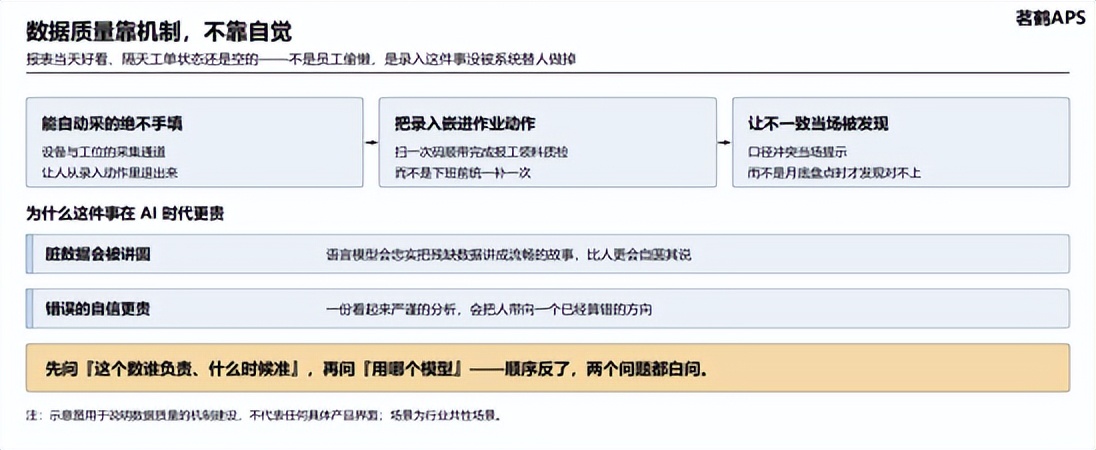
*图1:自动采集、嵌入动作、当场纠偏(示意)*
把录入嵌进作业动作
第二道机制,是让录入挂在动作上,而不是挂在下班前。
扫一次码,报工、领料、质检顺带就完成:扫工单,知道做什么;扫料箱,料扣掉了;扫完工,产量和检验结果留下了。动作本身就是记录,人不必为系统单独再做一次。
反面是所有录入都攒到班后统一补。补录时的记忆是压缩过的,先后顺序、谁做的、为什么停,都会糊。
糊掉的那部分不会显示成"不知道"。它会显示成一个填上的值。
周五那张工单就是这么填满的。栏位齐全,代价是整周的时间戳一起失去含义。
补录不是绝对不能有。异常停了半天、跨了车间借的人,当时确实录不了。区别在于补进来的要留痕、要写原因,而不是悄悄顶掉原本该发生的那一刻。
让不一致当场响
第三道机制最省钱,也最容易被省掉:把"月底才发现"改成"当场就知道"。
冲突发生在周三。领料单扣了料,工单状态没动;检验写着合格,产量还是零;同一道工序两个人填出两个时间。矛盾当天就存在,只是当天没人在看。
月底盘点做的事,是把它们攒一个月再一次性翻出来。翻出来的时候,能说明真相的人已经散到不同班组、不同产线上去了。
要改的是时机:口径冲突当场提示,当天有人认领;必填项没填,不让流程往下走;跨系统的数对不上,提交那一刻就拦下来。
发现成本从月底挪到当天,追溯成本跟着一起挪。
三道机制是同一件事的三个面:少让人填,填在动作里,填错立刻知道。做到什么程度,在一两个班组里按周看录入情况就行,不必先立全年目标。
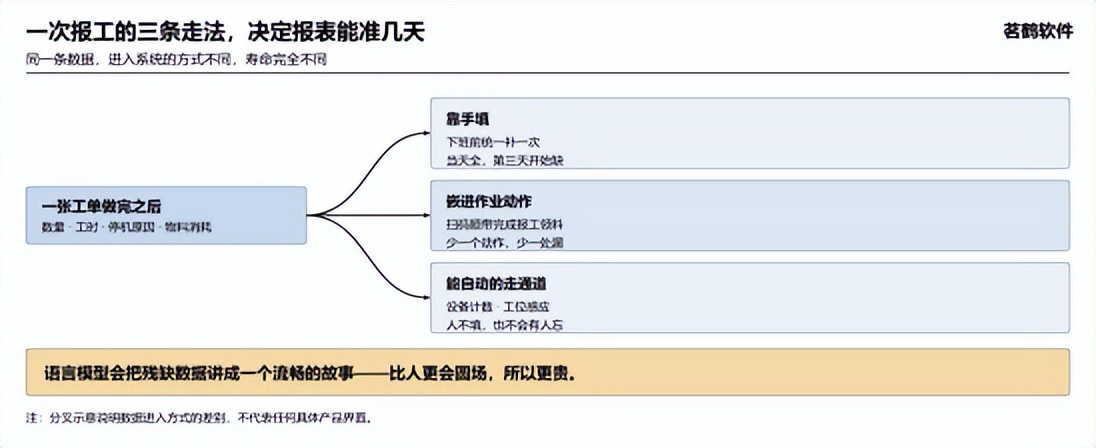
*图2:一次报工的三条走法(分叉示意)*
语言模型比人更会圆场
放到过去,脏数据主要骗的是人:报表难看,老计划员扫一眼就知道哪个数不能信,问一句就有人改口。
大模型把这层缓冲抽掉了。它不认识车间,也不会因为一个时间戳太整齐而起疑心。
语言模型会忠实地把脏数据讲成一个流畅的故事,比人更会圆场。
拿周五那张工单去问它,它会说这张单执行平稳、各工序衔接紧凑;再问瓶颈在哪,它会从那些填出来的时间里挑一段最像答案的,讲得有条有理。很难反驳,因为它引用的确实是系统里的数。
过去,数据差,代价是多开几次会、多打几个电话。现在,同一份脏数据被包装成结论、建议、风险提示,语气稳定地送到决策者面前。错得更整齐,也更贵。
同一批时间戳不止被语言模型读一遍。在制、工时、齐套缺口都要拿它们当依据,计划照着排,进度照着追。
所以采集与闭环要排在模型前面。模型能力能在项目里逐步长出来,事实只能一天一天攒。周五补进去的时间,变不回周三真正发生的那一刻。
月底盘完,差异还是那几笔。查差异的人翻了一天的记录,最后停在周五下午那一次提交上——那几条最晚的时间戳,都是那半小时里打进去的。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号