智叟云集检索读模型与稳定分页:让海量回答查得快、翻得稳、追溯得清楚
原创
智叟云集检索读模型与稳定分页:让海量回答查得快、翻得稳、追溯得清楚
原创
用户12821252
发布于 2026-11-13 10:31:47
发布于 2026-11-13 10:31:47
▣智叟云集检索读模型与稳定分页:让海量回答查得快、翻得稳、追溯得清楚
◆当智叟云集积累数十万条平台回答后,使用者最常见的动作不再是创建任务,而是寻找某个问题的历史变化、筛选某平台的负面回答、定位报告中的原始证据。检索体验决定了GEO优化监测系统是否真正可用于日常分析。本文集中讨论查询侧工程:如何建立可重建的读模型、怎样保证连续翻页的确定性、如何表达搜索延迟,以及如何让前端筛选、后端授权和数据存储保持同一口径。
◆范围说明:本文按生产环境要求组织工程设计与操作流程。AI功能配图用于说明目标设计;代码中的认证、数据库、出站网络与部署依赖需要按文中边界接入。未连接真实生产数据库的部分不声称已经通过线上验证。

编辑
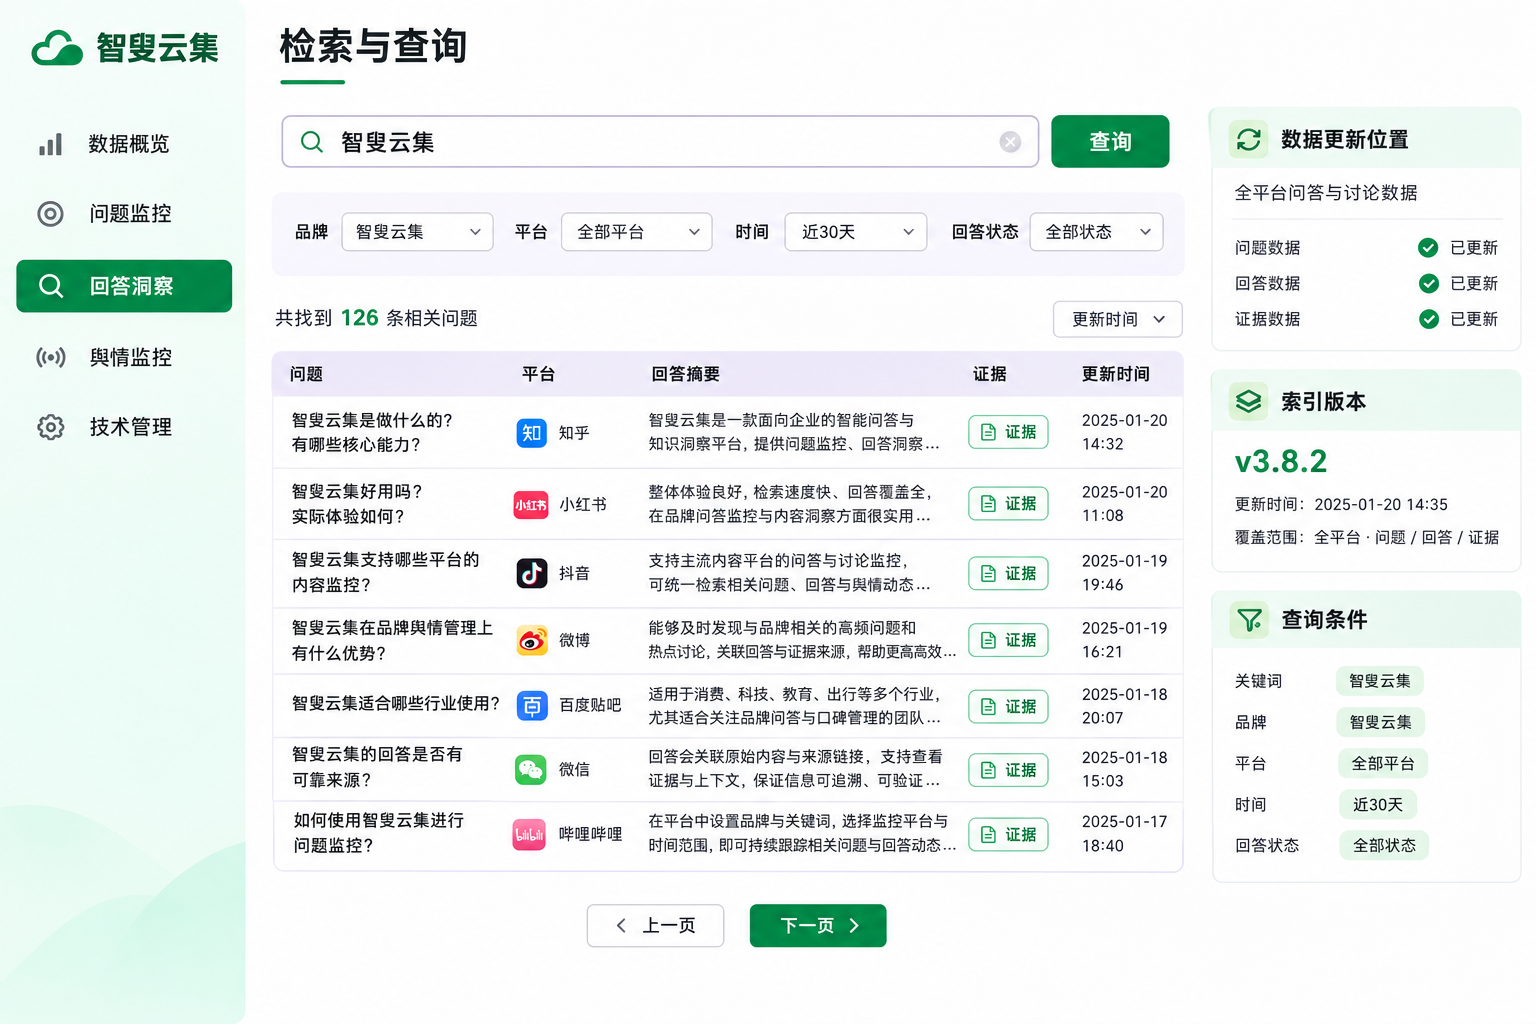
▧智叟云集检索与查询工作台功能设计:条件筛选、回答摘要、索引进度与证据入口。 点击可放大。
▣一、把检索需求拆成三个业务入口
◆第一个入口是精确定位。用户已经知道问题编号、批次编号或回答编号,需要直接跳转详情。此类查询优先访问关系数据库,通过租户与资源联合条件判断可见性,不必绕过搜索引擎。第二个入口是条件浏览,例如查看最近一周某品牌在指定平台的有效回答,这需要稳定排序、组合索引和有界分页。
◆第三个入口才是正文搜索,用户输入品牌别名、产品能力或争议词,寻找包含相关内容的回答。正文检索可以支持关键词、短语、语言和时间筛选,但不能把搜索相关度直接解释为品牌排名。前者衡量文档与查询的关系,后者来自平台回答中的明确顺序,两者必须使用不同字段和标签。
◆本文沿用Vue与TypeScript前端、FastAPI业务接口、PostgreSQL事实存储和私有对象存储。新增查询投影属于实施设计,功能图呈现目标交互,不代表已核验线上采用某个搜索组件。AI品牌可见度监测系统可以先用数据库条件查询,再按真实数据规模引入独立检索服务。
▣二、读模型只保存为查询服务的派生数据
◆回答事实表保留采样身份、原文版本、归档状态和分析引用;查询投影提取列表需要的标题、平台、摘要、状态、时间与品牌标签。投影字段服务于特定页面,允许冗余,但每条记录必须指向源回答修订。原文更正时新增修订,投影随明确事件更新,不能让搜索摘要反向覆盖原始证据。
◆一个生产可用的投影至少包含租户、项目、回答ID、源修订号、投影版本、索引时间与删除标记。源修订号阻止乱序事件把新版回退为旧版;投影版本表示字段处理逻辑,便于重新分词或调整摘要规则。两个版本作用不同,不能用一个更新时间同时表达数据变更和程序升级。
◆列表默认读取某个已发布查询代次。重建时另建代次并记录覆盖范围,完成追平和抽样对账后切换指针。旧代次为已签发的短期游标保留一段时间,随后明确过期。不能边清空索引边接收线上查询,否则用户会把重建期间的空列表误解为回答被删除。
▣三、同步过程必须识别乱序、删除与延迟
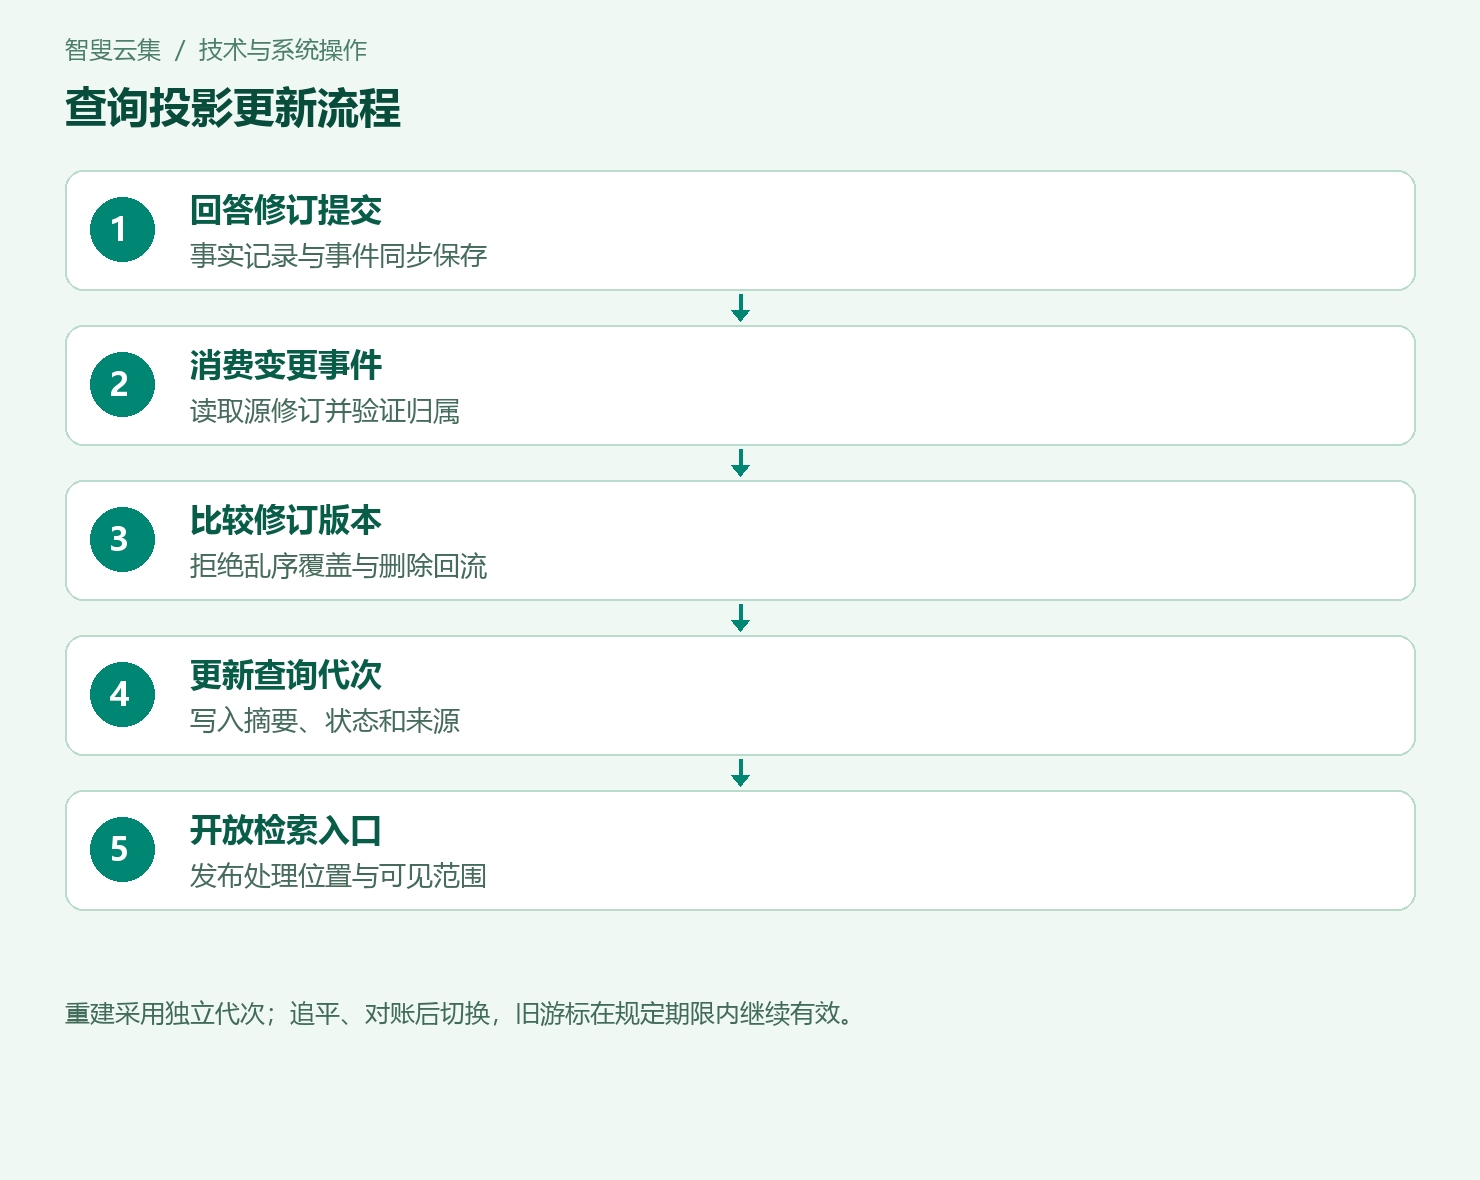
◆业务事务提交回答修订时同步写出事件,投影消费者根据事件重新读取授权范围内的源数据,而不是盲目信任事件中可能过期的全文。写入条件要求新修订高于已有修订,相同修订重放不改变结果。若采用批量重建,同样遵守版本比较,防止补历史覆盖实时更新。
◆删除或撤回需要具有版本的墓碑记录。物理删除投影后,如果一条更早的更新事件晚到,记录可能重新出现;保留删除修订便可拒绝这种回流。检索服务不能承担唯一权限判断,详情与下载仍由API复核。成员权限撤销应即时阻断访问,不能等待搜索同步完成才生效。
◆界面显示索引处理到的时间和队列积压,而不是把服务器当前时间当成数据新鲜度。事件序列若存在提交乱序,简单取最大编号不等于前面全部处理完成;需要消费者确认的连续位置,或各分区位置向量。只有能够解释的数据更新标记,才适合用于判断是否应该等待。

编辑
▧查询投影更新流程 点击可放大。
▣四、稳定分页的前提是稳定的结果集合
◆使用OFFSET分页时,新回答插入第一页会改变后续偏移,用户可能重复看到旧记录。键集分页改为记录上一页最后一条的排序键,再取严格小于该键的后续数据。排序必须包含唯一的次级键,例如创建时间与回答ID,且排序字段非空,才能明确处理同一时刻写入的多条记录。
◆键集分页本身不保证快照。若记录的排序字段或筛选字段正在改变,仍可能发生遗漏。因此本文的代码查询固定查询代次中的不可变记录,游标同时绑定代次、筛选摘要和最后位置。实时列表可显示新增提示,用户主动刷新后开启新会话;导出则冻结完整清单,不复用持续变化的浏览列表。
◆搜索按相关度排序时还要冻结索引视图或物化结果清单,因为新文档进入会改变分数。没有这类能力时,应明确结果随更新变化,并避免提供看似精确的跨页全选。对于大范围导出,服务端建立固定结果集比让浏览器循环翻页更可靠。
▣五、游标是查询契约,不是授权凭证
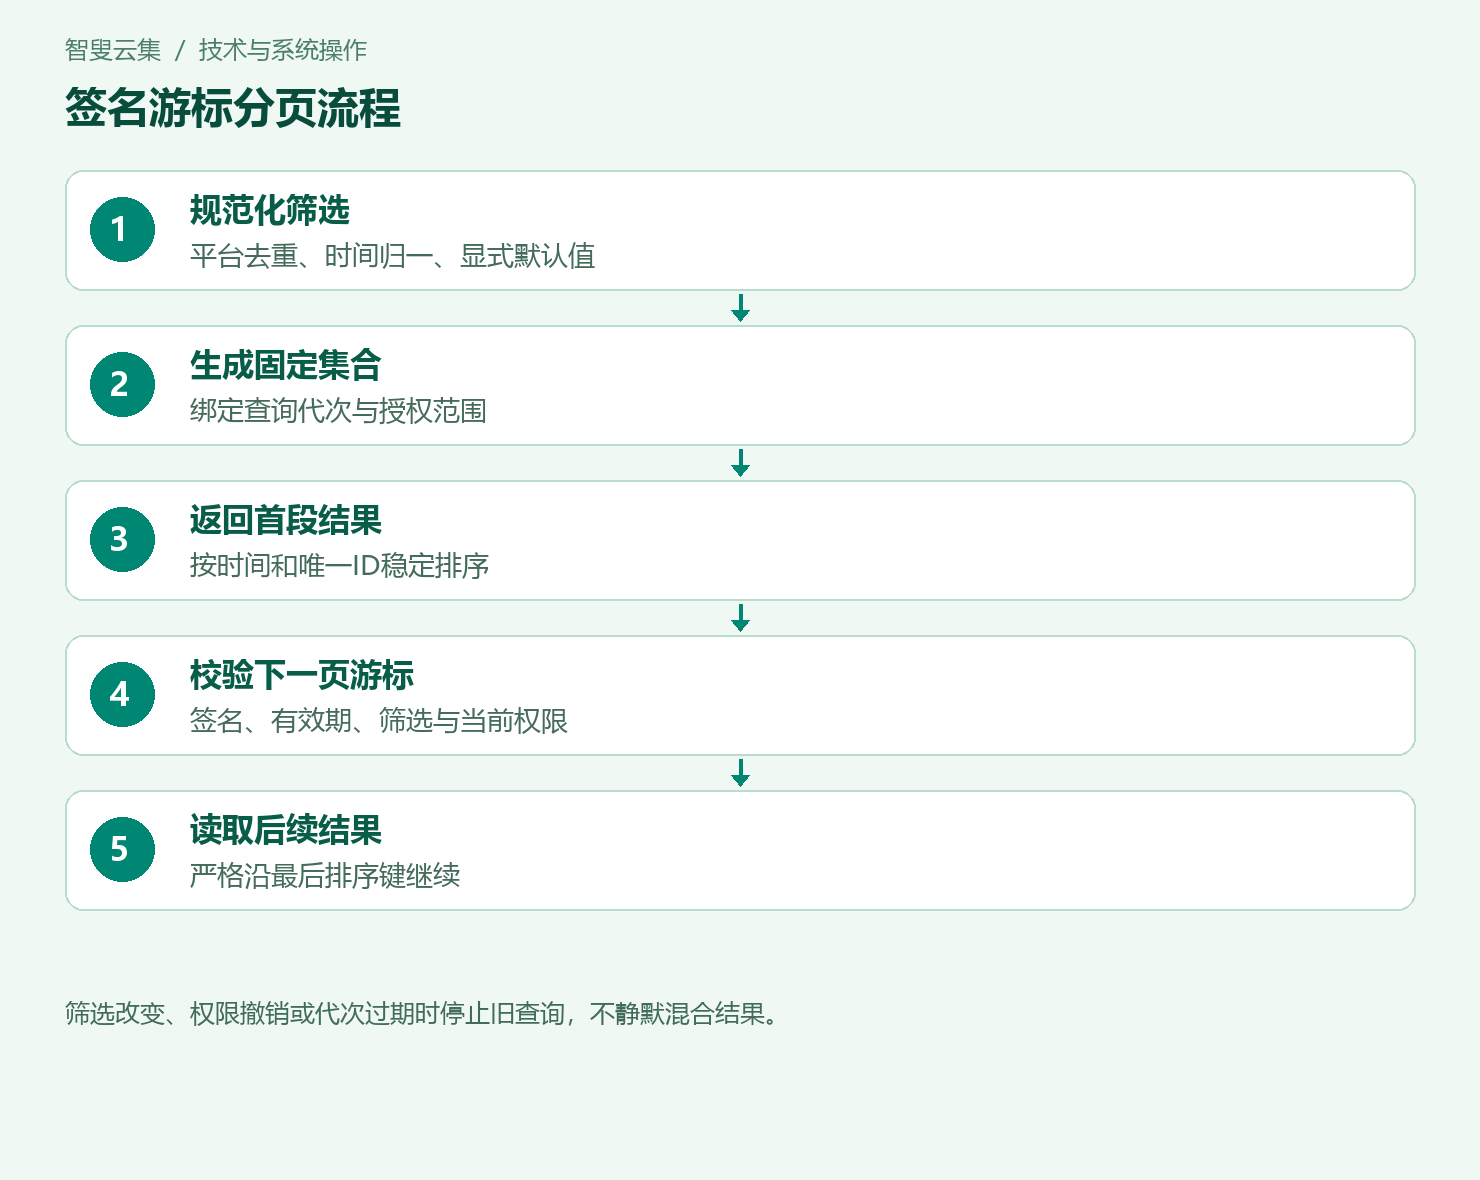
◆游标包含租户、项目、筛选摘要、排序模式、代次、到期时间与最后排序键,经服务端签名后返回。客户端不解析它来构造业务条件,只原样回传。签名保护完整性,不能代替当前成员和项目权限检查,也不负责隐藏内容;若字段敏感,使用服务端保存的随机会话令牌更合适。
◆筛选摘要来自规范化参数:平台列表去重排序,时间统一为UTC并采用左闭右开窗口,布尔值使用真实类型,默认条件显式补齐。若用户在第二页改变平台或品牌,服务端发现摘要不同就拒绝旧游标,前端清空分页历史并重新获取第一页,避免混合两个不同问题的结果。
◆游标还要限制长度、解码大小、签名版本和有效期。过期应提示刷新查询,不能悄悄退回第一页。生产密钥由密钥管理设施注入,轮换时短期兼容上一版本。日志只保留游标指纹与请求编号,避免把查询范围和内部资源身份长期暴露给日志查看者。
▣六、中文搜索要验证分词和别名处理
◆中文品牌名、产品缩写和中英混排会影响搜索召回。不能假定任意数据库默认全文配置已经适合中文,应以真实查询样本比较分词、字符片段、短语匹配和别名扩展。品牌别名配置版本要进入查询解释,用户才能理解为什么输入简称也能匹配正式名称。
◆查询扩展只能影响候选检索,不应直接写回分析标签。搜索命中“没有提到智叟云集”的句子,并不等于平台主动推荐品牌。舆情分析也需要分辨引用他人观点、否定表达和对象归属。列表可以高亮匹配词,但提及与情绪结果仍来自带版本的分析流程。
◆高亮片段属于外部内容。前端应把正文作为文本节点渲染,再用受控标记突出匹配范围,不把搜索引擎返回的任意HTML交给浏览器执行。超长正文限制展示长度,完整文本按权限单独读取。查询词同样限制长度与复杂度,防止极端表达式占满检索资源。
▣七、缓存要绑定身份范围和数据代次
◆缓存键至少包含租户、项目授权范围、规范化筛选、排序、分页位置和查询代次。不能只用关键词缓存,因为不同工作空间可能使用相同品牌词。权限撤销后即使缓存仍存在,API也必须先完成当前授权检查;需要按行过滤的场景还应绑定授权版本或直接避免共享结果缓存。
◆查询结果缓存与对象正文缓存可以使用不同保留策略。列表摘要失效可重算,原始证据对象则根据版本寻址。缓存击穿时采用有界合并请求,数据库不可用时不能返回伪装成最新的旧结果。若允许旧结果回退,响应必须标明生成时间、过期状态和不可执行的敏感动作。
◆前端保留筛选条件但不长期持久化敏感回答全文。切换工作空间立即清空结果、游标和详情抽屉;旧请求返回时检查请求序号和工作空间身份。这样才能避免网络乱序造成短暂串屏,也能让用户在多个品牌之间切换时保持可信的操作边界。

编辑
▧签名游标分页流程 点击可放大。
▣八、索引与查询性能从访问模式出发
◆索引设计先看最常见的过滤与排序组合。固定代次内按项目、时间和ID浏览,可以建立相应复合索引;平台是高频筛选时再评估附加索引。不要给所有字段机械建索引,索引也消耗写入、重建与存储成本。生产分析需要查看执行计划、扫描行数和返回行数的比例。
◆总数统计与列表查询可以分离。每次翻页都精确COUNT大集合可能比取几十条数据更昂贵,可提供已知下界、异步精确总数或快照总数,但标签必须明确。不能把估算总数写成精确结果,再让用户依据这个数字计算舆情占比。指标统计应走固定分析口径。
◆接口限制最大页长、查询时间窗口和复杂度,长耗时查询转为异步任务。超时返回可识别的错误与请求编号,而不是空数组。监控关注尾部延迟、授权失败、游标过期、投影积压和重建耗时,分别判断是数据库、检索服务还是页面请求方式造成问题。
◆数据库读副本可能落后于主库,保存查询后立即读取时可以短期走主库,或携带最低可见版本并等待副本追平。若达到等待上限,返回明确的暂未同步状态。不能用不断刷新页面掩盖复制延迟。对于跨区域读取,服务等级还应区分列表可用、证据可用与统计可用,三者依赖的同步链路未必相同。
▣九、检索页面的完整操作流程
◆操作人员进入回答洞察,先选择工作空间、品牌和观察时间,再决定按问题精确定位还是按正文搜索。点击查询后,页面展示实际采用的筛选条件与数据更新时间。只有看到这些条件,用户才能判断不同同事分享的结果是否具有可比性。
◆连续翻页期间保持筛选不变,页面以游标读取下一段结果。收到新增数据提示后,可继续查看当前集合,也可刷新到新集合。打开回答详情时展示采样平台、回答修订和证据状态;原文缺失或权限变化应明确提示,不拿摘要冒充完整证据。
◆保存查询只保存条件与命名,不默认保存当前结果。若需要用于报告,选择建立结果快照,并记录快照身份。删除保存查询不删除回答;删除回答也不等于撤销此前已下载的文件,这些操作范围需要在产品文案中区分清楚。
◆批量选择应说明是当前页、当前已加载记录还是整个固定结果集合。前两者可以传入明确ID列表,后者应引用查询快照并让服务端再次核对范围。删除或导出操作不能仅接收一个没有上下文的“全选”布尔值,否则筛选变化或延迟返回可能扩大实际操作对象。
▣十、上线验收围绕一致性而非只看速度
◆构造相同时间戳的多条回答,确认分页既不重复也不遗漏;在翻页时新增回答,确认旧代次稳定,新会话可见新内容;修改筛选后继续提交旧游标,应得到条件不匹配提示。随后撤销成员权限,验证旧游标与缓存均不能绕过访问控制。
◆再将同一源修订重复投递,把旧修订安排在新修订之后,并让删除事件先于历史更新到达。最终投影应与源状态一致。重建新代次时随机抽取记录核对正文版本和可见状态,故障后继续重建不能把未覆盖范围标成完整。
◆最后把典型中文别名、否定句、特殊字符和超长查询加入回归集。性能目标应按实际规模与部署资源制定,并记录冷缓存与热缓存条件。本文代码验证的是筛选摘要与签名游标规则,真实查询计划、租户隔离和并发重建还需要在目标数据库环境执行集成测试。
▣十一、系统操作速查
▣01|选择查询入口
◆先确定精确定位、条件浏览或正文搜索,再设置品牌、平台与时间窗口。不要用搜索命中数替代正式指标分母。
▣02|查看更新状态
◆核对查询代次、索引处理位置与结果生成时间。处理延迟时等待更新或查看已归档详情,不重复创建采集任务。
▣03|定位原始回答
◆从列表进入详情,检查源修订和证据可用性。搜索高亮只表示文本匹配,分析标签以已接受的分析版本为准。
▣04|保存与分享
◆保存条件用于以后重查,固定快照用于报告复核。分享资源时由接收方重新鉴权,不转发永久公开证据地址。
▣十二、代码展示与逐段解释
▣签名游标与筛选摘要
◆代码文件:01_cursor.py。下方代码对应本节核心逻辑,完整文件与测试说明在资料包的 code 目录。
import base64
import hashlib
import hmac
import json
import re

def filter_digest(filters: dict) -> str:
    # 调用前由API Schema校验时间、字段白名单与类型。
    value = dict(filters)
    value['platforms'] = sorted(set(value.get('platforms', [])))
    raw = json.dumps(value, sort_keys=True, ensure_ascii=False,
                     separators=(',', ':'), allow_nan=False).encode()
    return hashlib.sha256(raw).hexdigest()

def encode_cursor(payload: dict, secret: bytes) -> str:
    if len(secret) < 32:
        raise ValueError('key too short')
    raw = json.dumps(payload, sort_keys=True,
                     separators=(',', ':'), allow_nan=False).encode()
    body = base64.urlsafe_b64encode(raw).decode().rstrip('=')
    signature = hmac.new(secret, body.encode(), 'sha256').hexdigest()
    return body + '.' + signature

def decode_cursor(token: str, secret: bytes, *, now: int,
                  tenant: str, project: str, digest: str,
                  generation: str) -> dict:
    if len(secret) < 32 or not isinstance(token, str):
        raise ValueError('invalid input')
    if len(token) > 4096 or not re.fullmatch(r'[A-Za-z0-9_-]+\.[0-9a-f]{64}', token):
        raise ValueError('invalid token')
    body, signature = token.split('.')
    expected = hmac.new(secret, body.encode(), 'sha256').hexdigest()
    if not hmac.compare_digest(signature, expected):
        raise ValueError('invalid signature')
    try:
        raw = base64.b64decode(body + '=' * (-len(body) % 4),
                               altchars=b'-_', validate=True)
        value = json.loads(raw)
    except (ValueError, UnicodeError) as exc:
        raise ValueError('invalid payload') from exc
    if not isinstance(value, dict):
        raise ValueError('invalid payload')
    required = {'v': 1, 'tenant': tenant, 'project': project,
                'filter': digest, 'generation': generation}
    if any(value.get(k) != v for k, v in required.items()):
        raise ValueError('query context changed')
    if type(value.get('exp')) is not int or value['exp'] <= now:
        raise ValueError('expired cursor')
    last = value.get('last')
    if not (isinstance(last, list) and len(last) == 2
            and all(isinstance(x, str) and x for x in last)):
        raise ValueError('invalid ordering key')
    return value  # API继续校验时间/UUID类型,并执行当前资源授权。
◆代码解释 1:filter_digest先复制筛选对象,再对平台集合去重排序,避免同一平台列表因为排列不同生成不同摘要。其余字段必须先由API的Schema规范化,特别是时间、空值与默认项。函数不是完整请求校验器,未知字段、非法时区和超长查询应在进入核心函数前拒绝。
◆代码解释 2:encode_cursor对序列化后的载荷生成签名,decode_cursor先检查长度和字符格式,再验证签名与上下文。到期时间通过显式now参数判断,因此测试可固定时钟。生产环境应使用独立的随机密钥和密钥版本,并由外层转换成统一错误码,避免把内部异常直接展示给用户。
◆代码解释 3:返回的last只完成基本结构检查,API还需将时间与UUID解析为正确类型,并检查该代次仍可访问。即使所有签名检查通过,当前成员权限也要重新验证。这里的安全边界是游标不可被篡改或跨查询使用,不是保证原文加密,也不是替代租户行级策略。
▣固定代次中的键集查询
◆代码文件:01_query.sql。下方代码对应本节核心逻辑,完整文件与测试说明在资料包的 code 目录。
-- 参数化查询片段;generation内记录不可变且排序键非空。
-- 连接角色已设置可信租户RLS上下文,并完成项目授权。
-- $1 tenant_id, $2 project_id, $3 generation_id
-- $4 last_created_at (首段NULL), $5 last_id, $6 bounded_limit
SELECT answer_id, source_revision, created_at, platform, summary
FROM answer_query_generation
WHERE tenant_id = $1 AND project_id = $2 AND generation_id = $3
  AND ($4::timestamptz IS NULL
       OR (created_at, answer_id) < ($4::timestamptz, $5::uuid))
ORDER BY created_at DESC, answer_id DESC
LIMIT $6;
-- 配套索引由受控迁移创建:
-- (tenant_id, project_id, generation_id, created_at DESC, answer_id DESC)
◆代码解释 1:SQL按租户、项目和代次限定集合,排序使用创建时间与回答ID,后续页采用严格小于比较。首段把最后时间传为空,后续段同时提交两项排序键。页长在服务端限制后绑定参数,不把客户端文本拼入LIMIT表达式。取额外一条可用于判断是否还有下一页。
◆代码解释 2:answer_query_generation是业务服务建立的不可变查询投影契约,清单生成阶段已经应用品牌、平台与文本筛选。它不是直接查询不断变化的最新回答表。生产表需要复合主外键、非空排序列与租户策略,索引顺序与该访问模式一致,再根据真实执行计划调整。
◆代码解释 3:如果只保存最大创建时间而不固定筛选字段,修改状态仍可能让记录跨页移动。因此此处明确要求代次不可变。旧代次过期后应返回会话过期,不重新解释同一游标。上线集成测试还应验证相同时间戳、授权变化和新旧代次切换,不以单次查询耗时判断可靠性。
▣前端查询上下文契约
◆代码文件:frontend.ts。下方代码对应本节核心逻辑,完整文件与测试说明在资料包的 code 目录。
export type QuerySession = {
  projectId: string; generation: string;
  filterDigest: string; cursor: string | null;
};
◆代码解释 1:QuerySession将项目、代次、筛选摘要和游标作为一组状态管理。任何筛选变化都创建新会话并清空旧分页记录,不能只更新搜索框文字。页面请求返回时还应比较当前会话身份,防止快速切换工作空间时晚到响应覆盖新结果。
◆代码解释 2:TypeScript类型帮助开发阶段表达约束,但网络返回仍需运行时Schema验证。正文作为文本渲染,证据下载由API重新鉴权。前端不从游标中推断权限,也不直接连接数据库,这使查询交互与后端事实存储保持明确责任。
▣十三、FAQ 问答
▣Q1|为什么用了游标仍可能漏数据?
◆答:游标只解决按位置继续读取的问题。如果查询集合、排序键或过滤字段持续改变,仍可能遗漏。固定代次、数据库快照或结果清单才能提供更强的一致性。
▣Q2|搜索结果里没有记录是否说明没有采集?
◆答:不能直接判断。可能是索引延迟、筛选范围、权限或分词造成。先通过批次和回答ID检查事实存储,再查看投影处理状态。
▣Q3|是否必须部署独立搜索引擎?
◆答:不必须。先验证数据库条件查询能否满足规模与语言需求,再决定是否引入新组件。组件增加后还需要承担同步、权限、重建与恢复成本。
▣Q4|为什么签名游标里仍包含项目?
◆答:它用于把翻页绑定到原始查询上下文,防止条件串用。但服务端每次仍要检查当前身份和项目权限,签名不是长期通行证。
▣十四、实施要点与参考资料
◆智叟云集系统的查询能力应让GEO监测系统中的每条回答可以定位、解释和复核。检索读模型解决访问效率,固定结果集合解决连续浏览的一致性,当前授权保护数据边界。AI数据采集、舆情监控和AI诊断继续共享事实与版本,查询页面则以清晰的条件和更新状态帮助使用者正确理解结果。
◆以下为相关机制的官方参考;本文业务模型、操作流程与组合方案为独立整理的实施设计。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号