格局!刚刚 DeepSeek 正式开放全家桶 API,咱都能复刻 DeepSeek App 了?
原创
格局!刚刚 DeepSeek 正式开放全家桶 API,咱都能复刻 DeepSeek App 了?
原创
程序员鱼皮
发布于 2026-11-14 12:59:16
发布于 2026-11-14 12:59:16
大家好,我是程序员鱼皮。
昨晚 10 点多,DeepSeek 又更新了,他们怎么这么喜欢在周五下班后更新?
这次没有发布新模型,而是发布了一套「全家桶应用 API」。
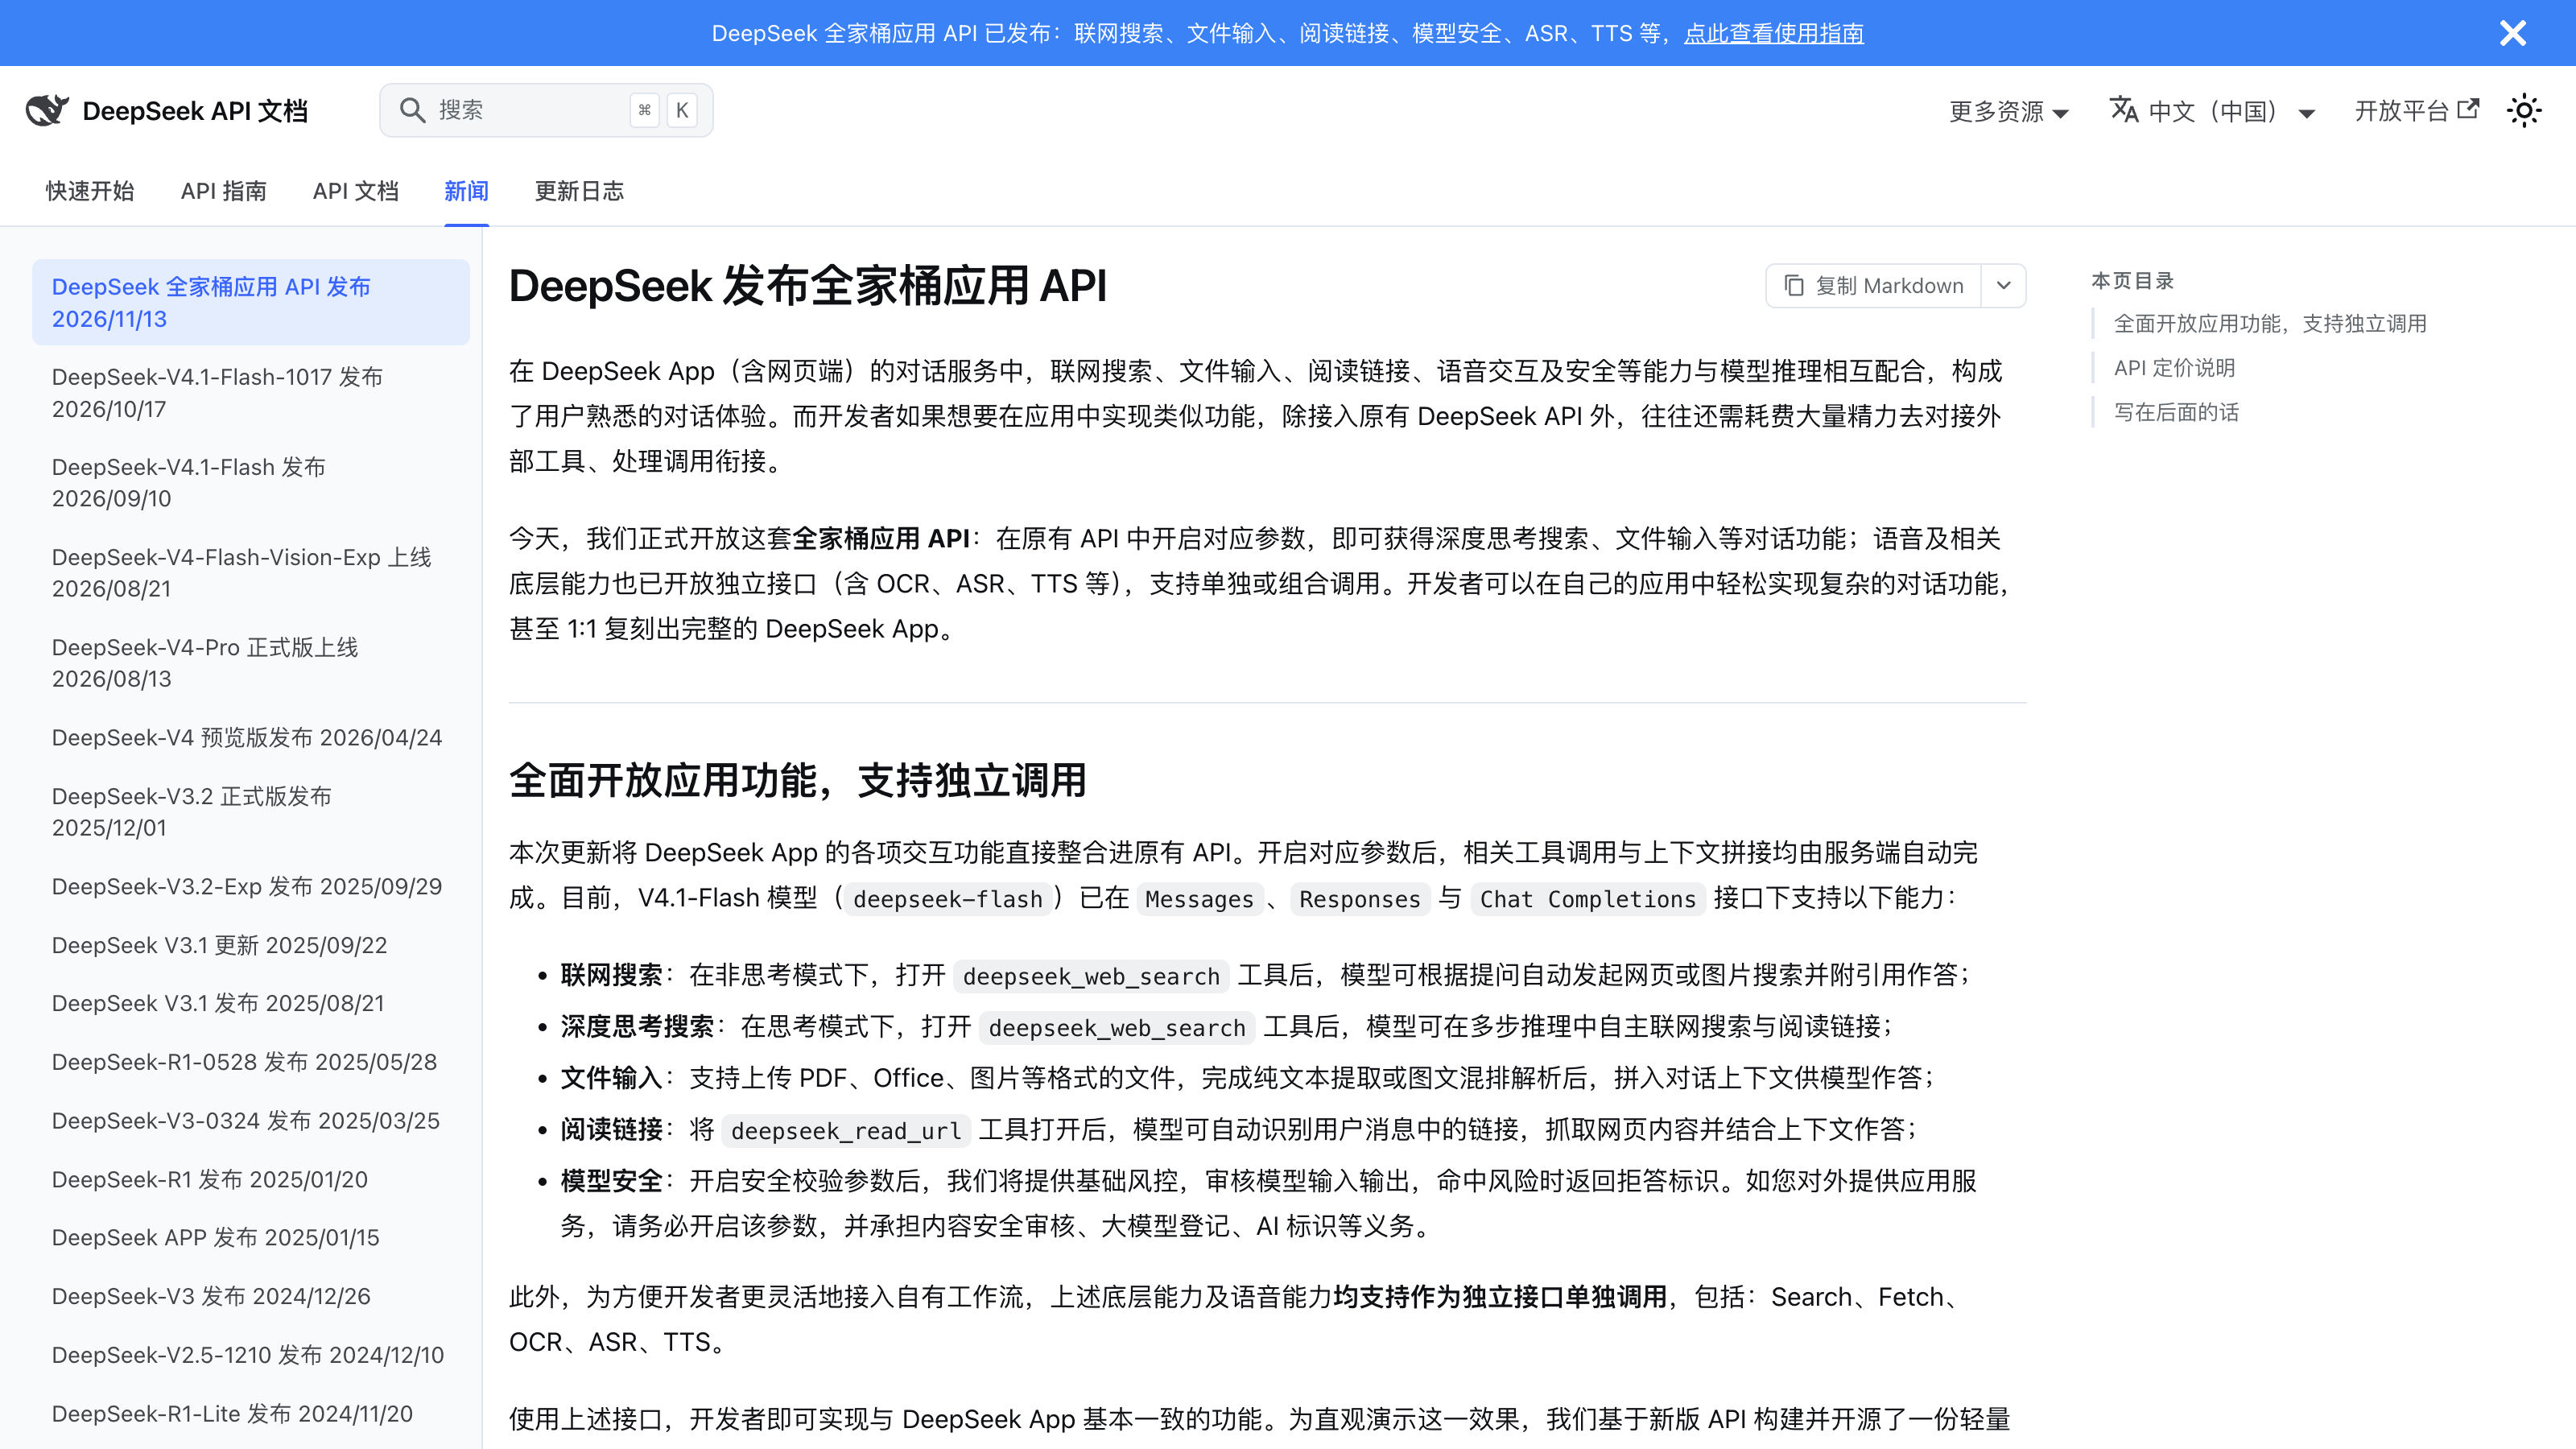
官方公告
简单来说,DeepSeek 把自家 App 里的联网搜索、深度思考搜索、阅读链接、上传文件、语音输入和朗读,全部开放成了 API。
你只要在原来的请求里多加一两个参数,服务端就会自己去搜索、读网页、把结果拼进上下文,不用再去对接一堆第三方工具了。
按照官方的说法,开发者可以 1:1 复刻出完整的 DeepSeek App!
不过 Search 和 Fetch 两个搜索接口上个月就开放过了,这次新增的是对话里的内置联网工具、文件输入、OCR、语音和安全审核。
其实在 DeepSeek 开放这些 API 之前,网上已经有类似的 API 了,那 DeepSeek 自家的这些能力到底怎么样呢?
我把这些能力全部对接了一遍,这篇文章带大家吃一波螃蟹~
价格怎么算
首先,模型本身的价格没变,用的还是 V4.1 Flash,工作日高峰时段每百万 tokens 输入 2 元、输出 8 元,其他时间半价。
新增的工具则是按次单独收费:
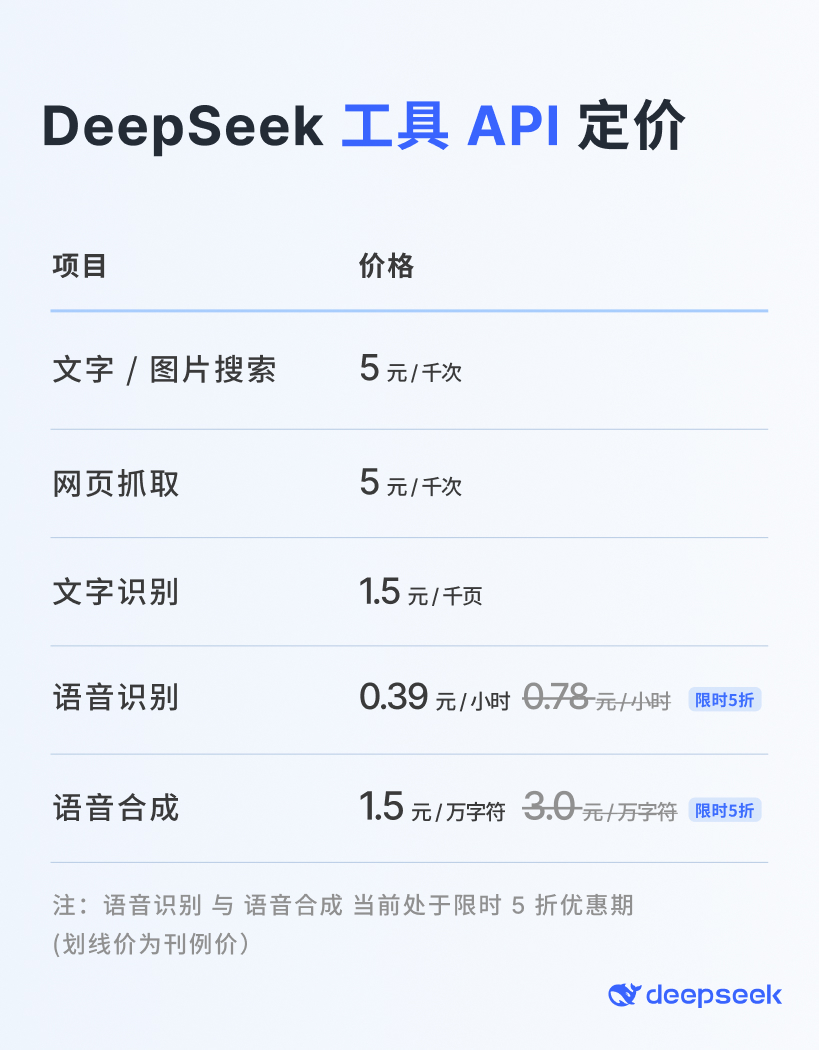
工具定价
搜索和网页抓取都是 5 元一千次,一小时的录音转文字只要 3 毛 9,而且语音识别和语音合成目前还在限时 5 折。
怎么接入
第一步,先到 DeepSeek 开放平台创建一个 API Key。
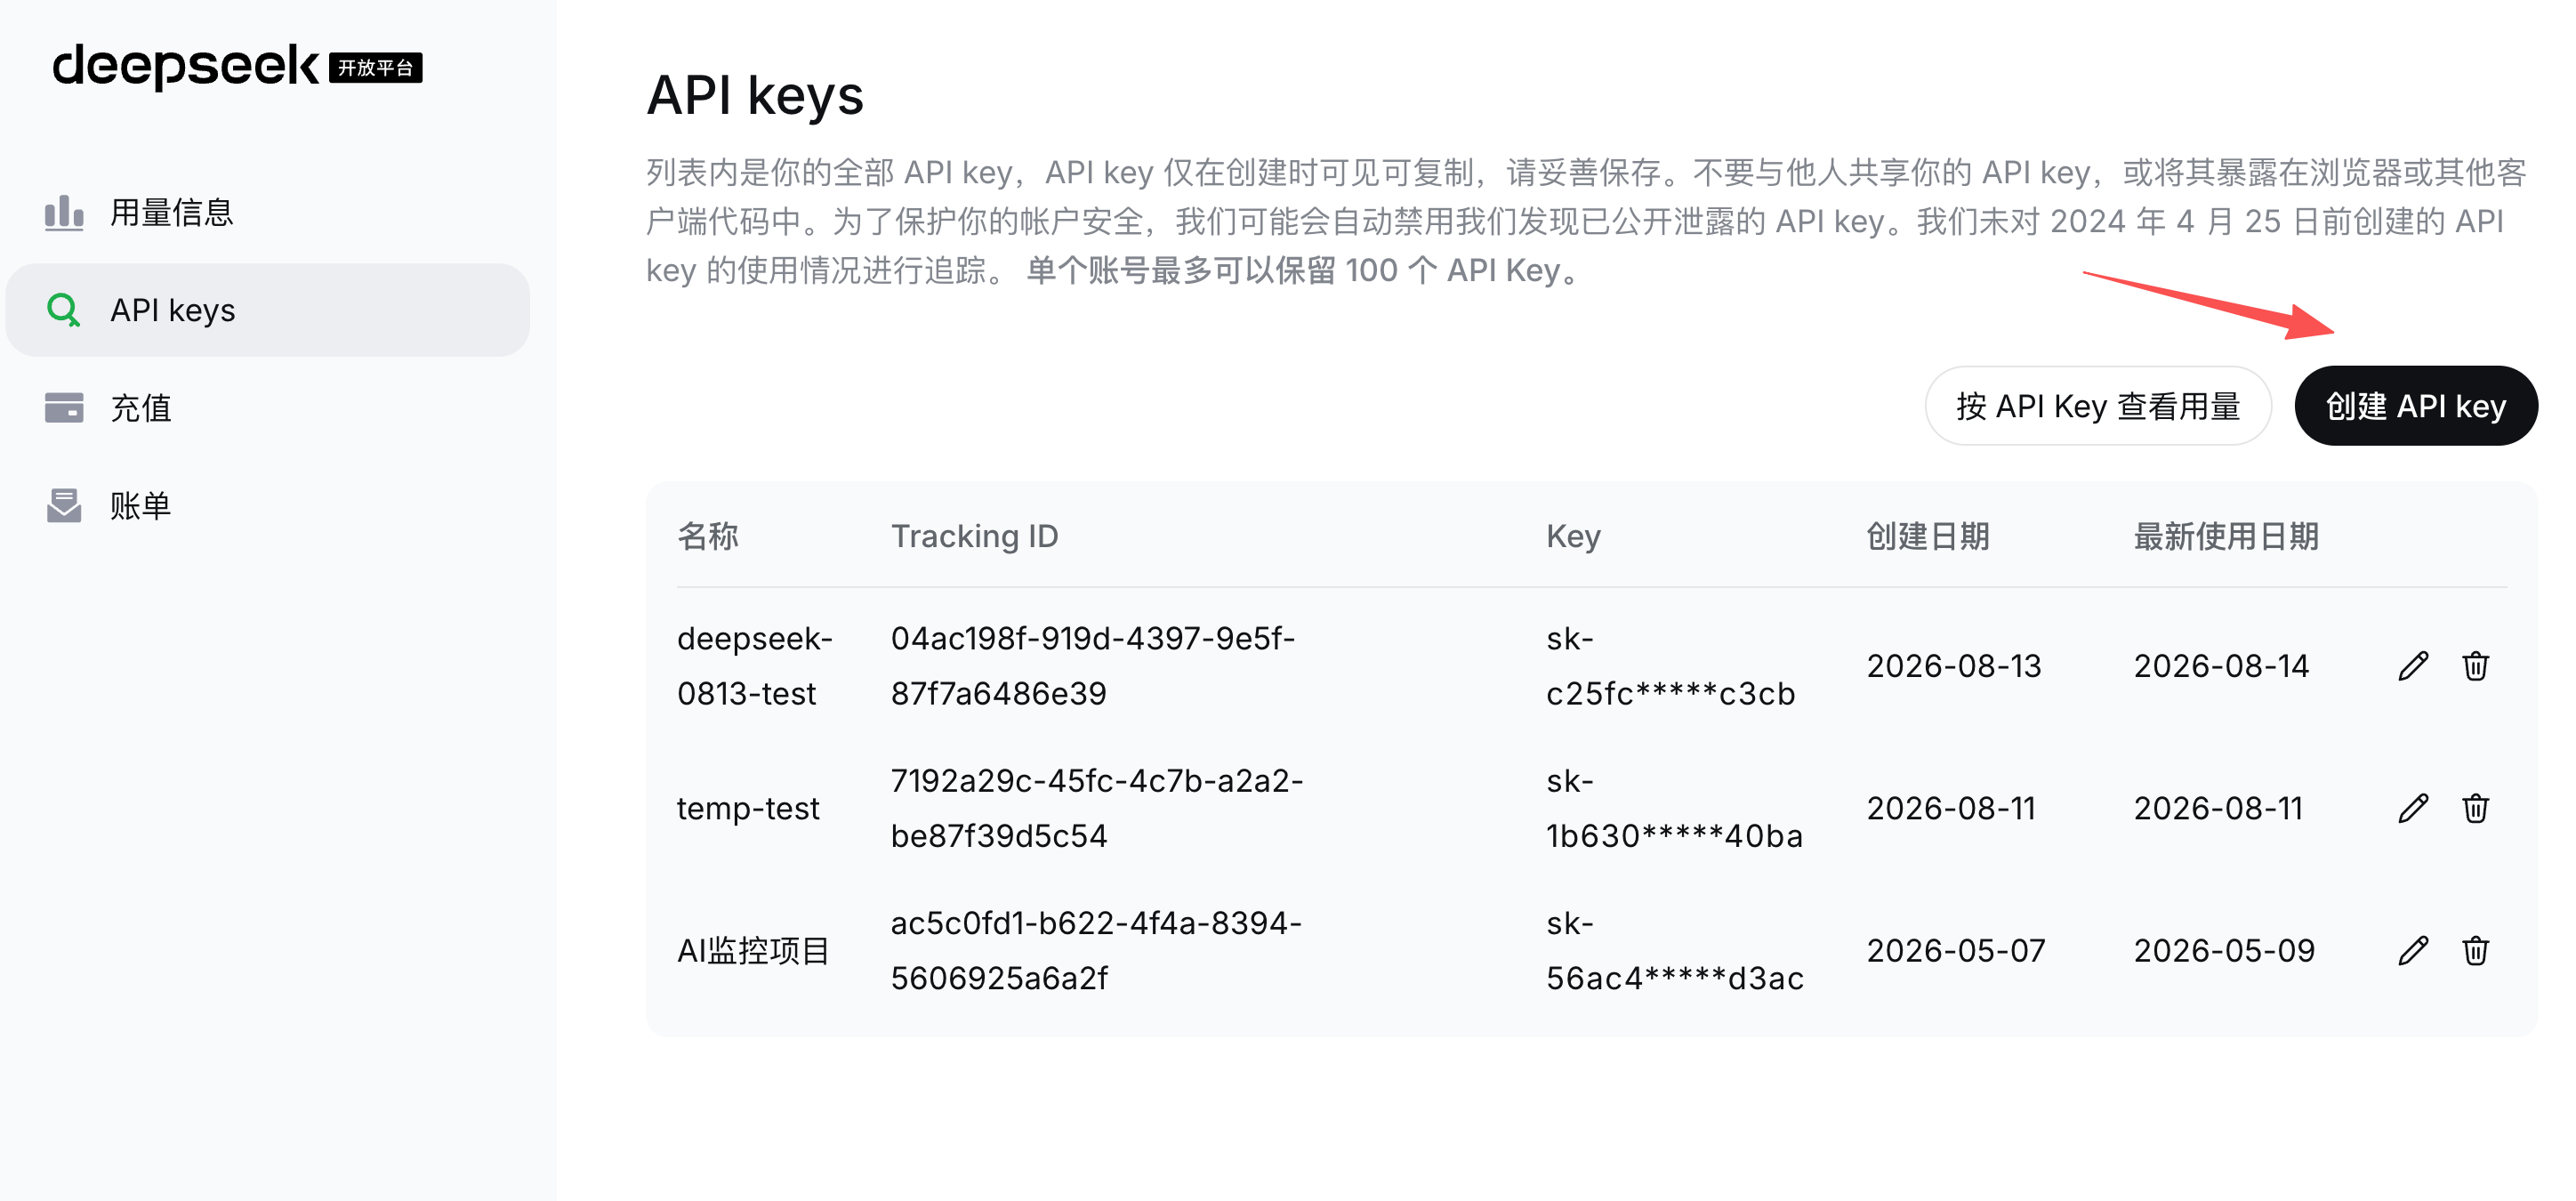
创建 Key
DeepSeek 同时兼容 OpenAI 和 Anthropic 两种协议,Chat Completions、Responses、Messages 三套接口都能用,模型名统一填 deepseek-flash。
我用的是最常见的 OpenAI Python SDK,先安装依赖:
pip install openai然后在请求里加一个 tools 参数,声明联网搜索 deepseek_web_search 和阅读链接 deepseek_read_url 两个工具。搜索和读网页都在服务端完成,客户端不用写工具调用逻辑:
import os
from openai import OpenAI

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"], base_url="https://api.deepseek.com")

resp = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "latest_reminder", "content": "2026-11-14,星期六,上海,Web,中文"},
        {"role": "user", "content": "今天上海天气怎么样?适合出门吗?简短回答"},
    ],
    tools=[{"type": "deepseek_web_search"}, {"type": "deepseek_read_url"}],
    extra_body={"thinking": {"type": "disabled"}},
)

msg = resp.choices[0].message
print(msg.content)
for step in msg.model_extra["server_tool_calls"]:
    for call in step["calls"]:
        print("🔍", call["kind"], call["action"].get("queries") or call["action"].get("url"))
print("计费次数:", resp.usage.model_extra["server_tool_use"])
运行一下,5 秒左右就拿到了答案,AI 自己搜了 3 个关键词:
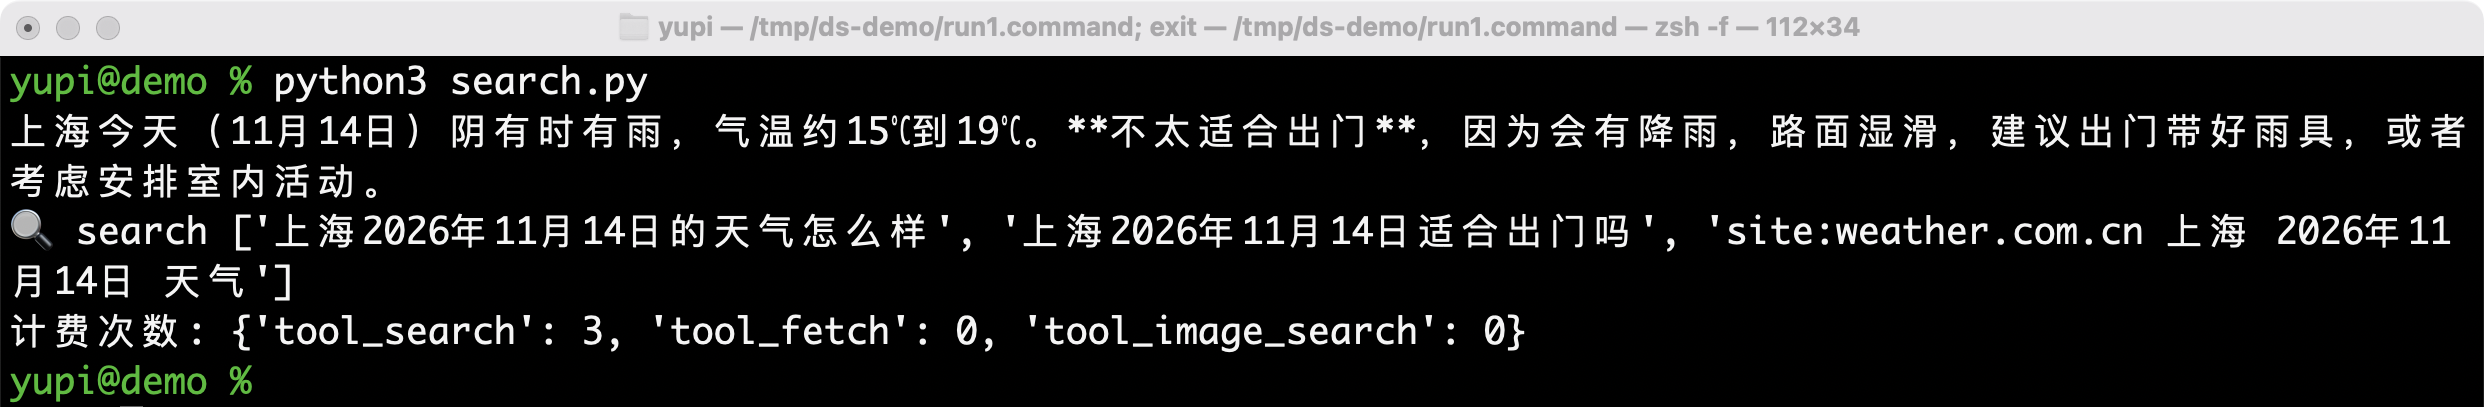
运行结果
代码里的那条 latest_reminder 消息,作用是告诉 AI 今天几号、用户在哪儿。这条消息一定要传,不传会发生什么,后面你就知道了。
如果你懒得写代码,官方还开源了一个演示客户端,填上 API Key 就能用,还能导入 DeepSeek 网页端导出的历史对话。
开源指路:https://github.com/deepseek-ai/chat-demo
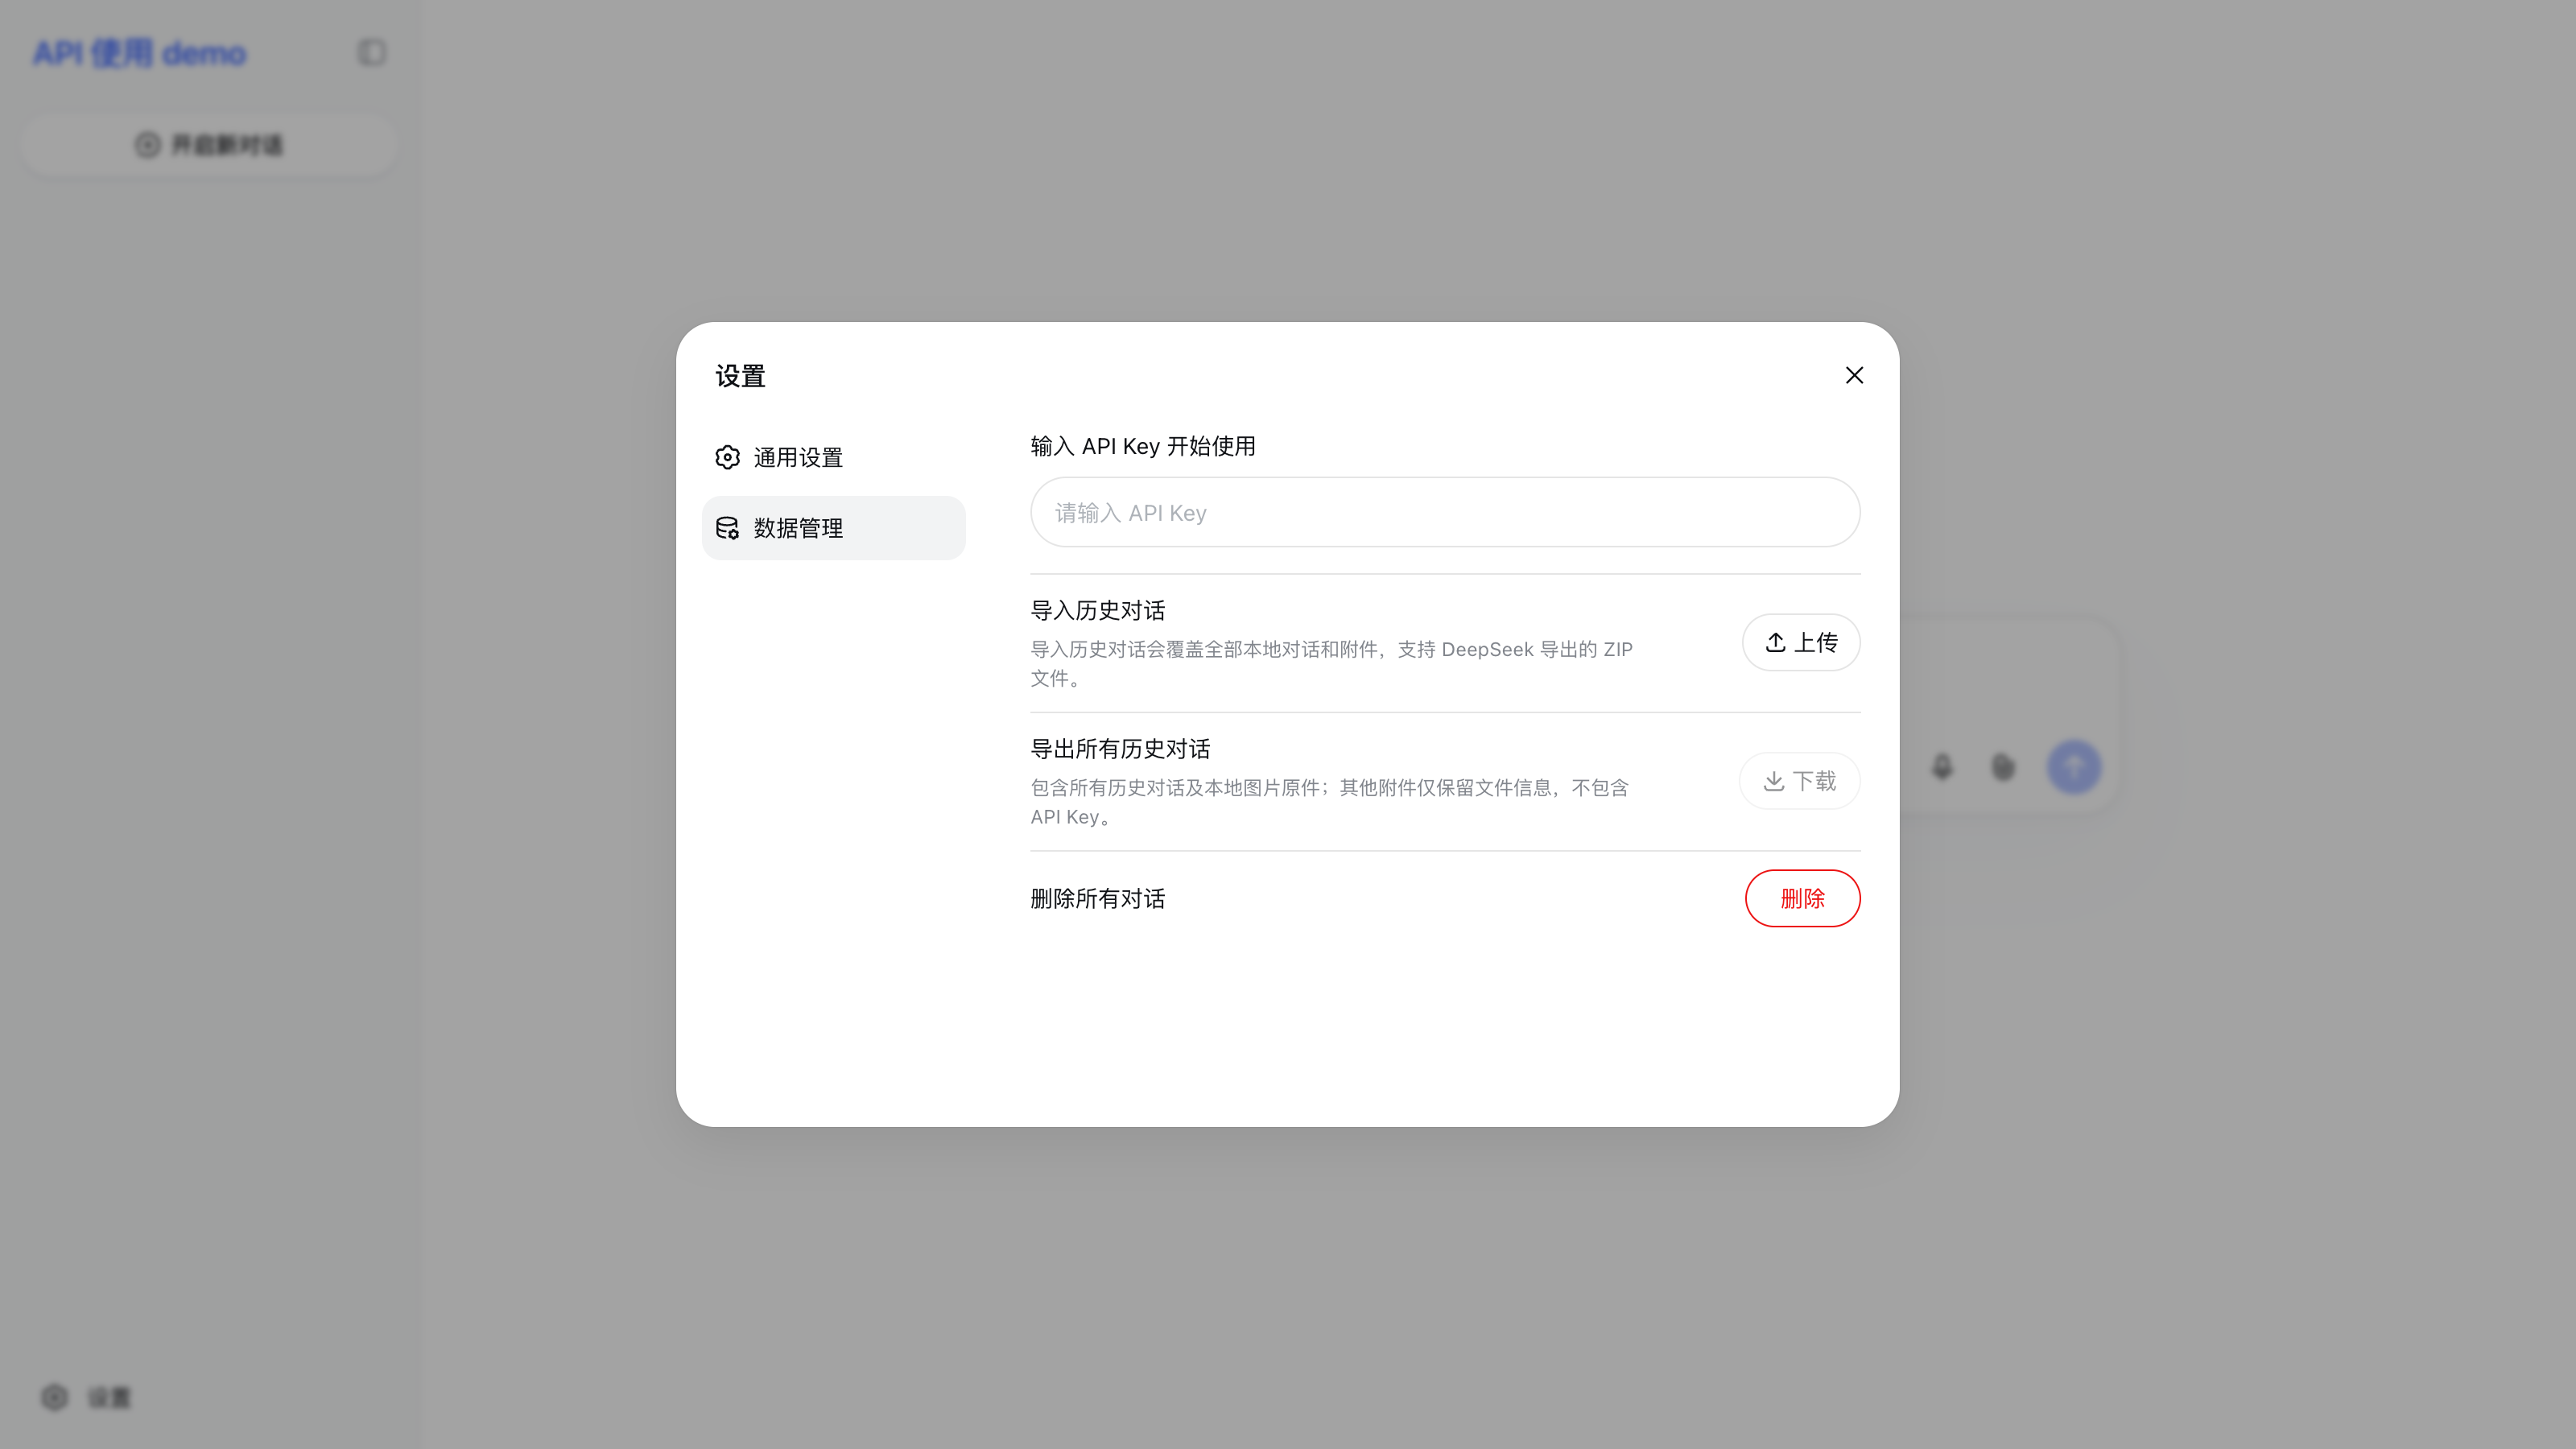
演示客户端
联网搜索实测
我先问了一个昨晚才发生的事,就是 DeepSeek 全家桶 API 有哪些能力、各项工具怎么收费?
第一次我没传日期,结果 AI 把搜索词写成了「2026 年 6 月」,还一本正经地纠正我「你提到的昨晚发布可能有些误会」,说发布时间是 11 月 12 号,显然日期搞错了。
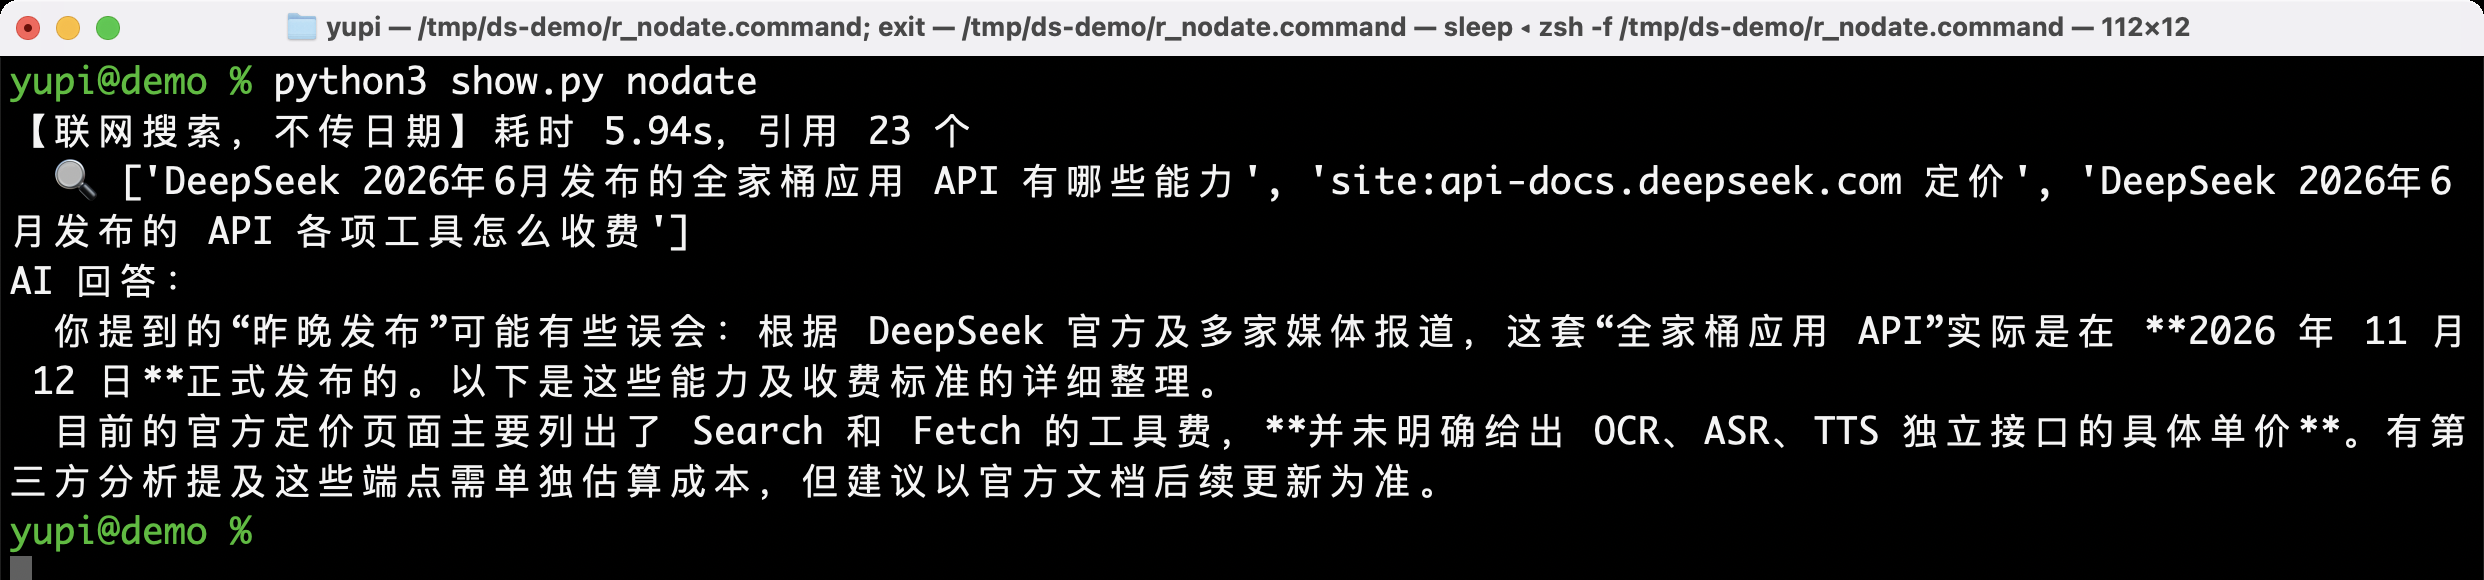
不传日期
加上 latest_reminder 之后,搜索词和日期都对了,5.2 秒出了结果,还附带了 13 个引用。
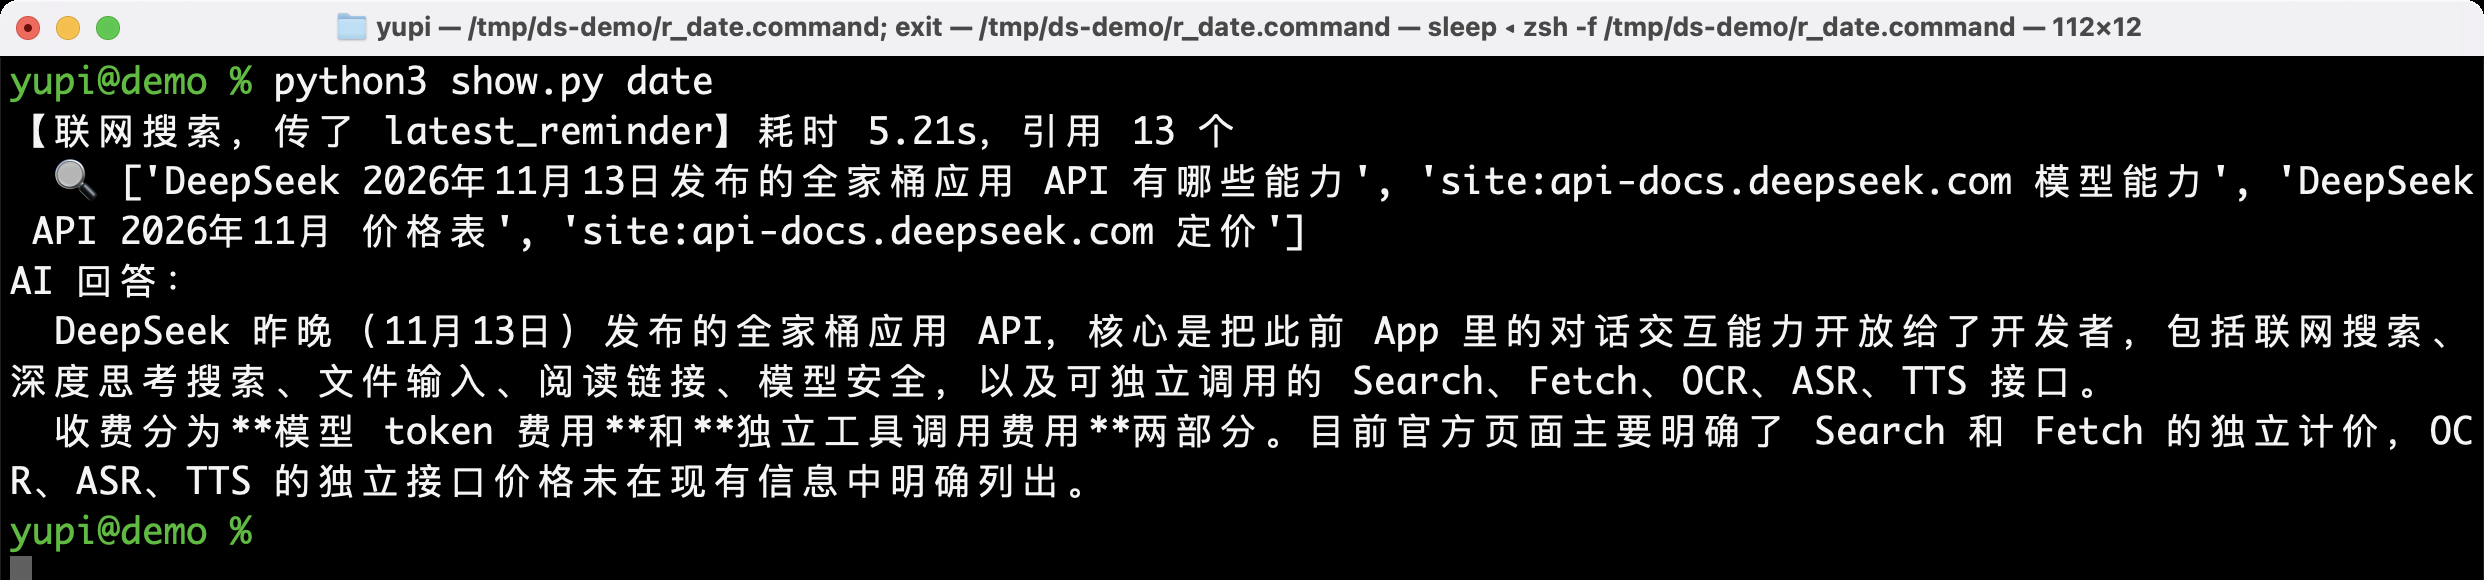
传入日期
但还剩一处错误,AI 说官方没有公布 OCR 和语音的价格。
因为普通联网搜索只看搜索摘要,不会点开网页,而价格表恰好是公告里的一张图片。
我把同一个问题换成深度思考搜索,也就是打开 thinking。这次 AI 搜了 3 个关键词,又打开了 5 个新闻网页,8.7 秒后交出了完整的价格表,没有遗漏任何细节。
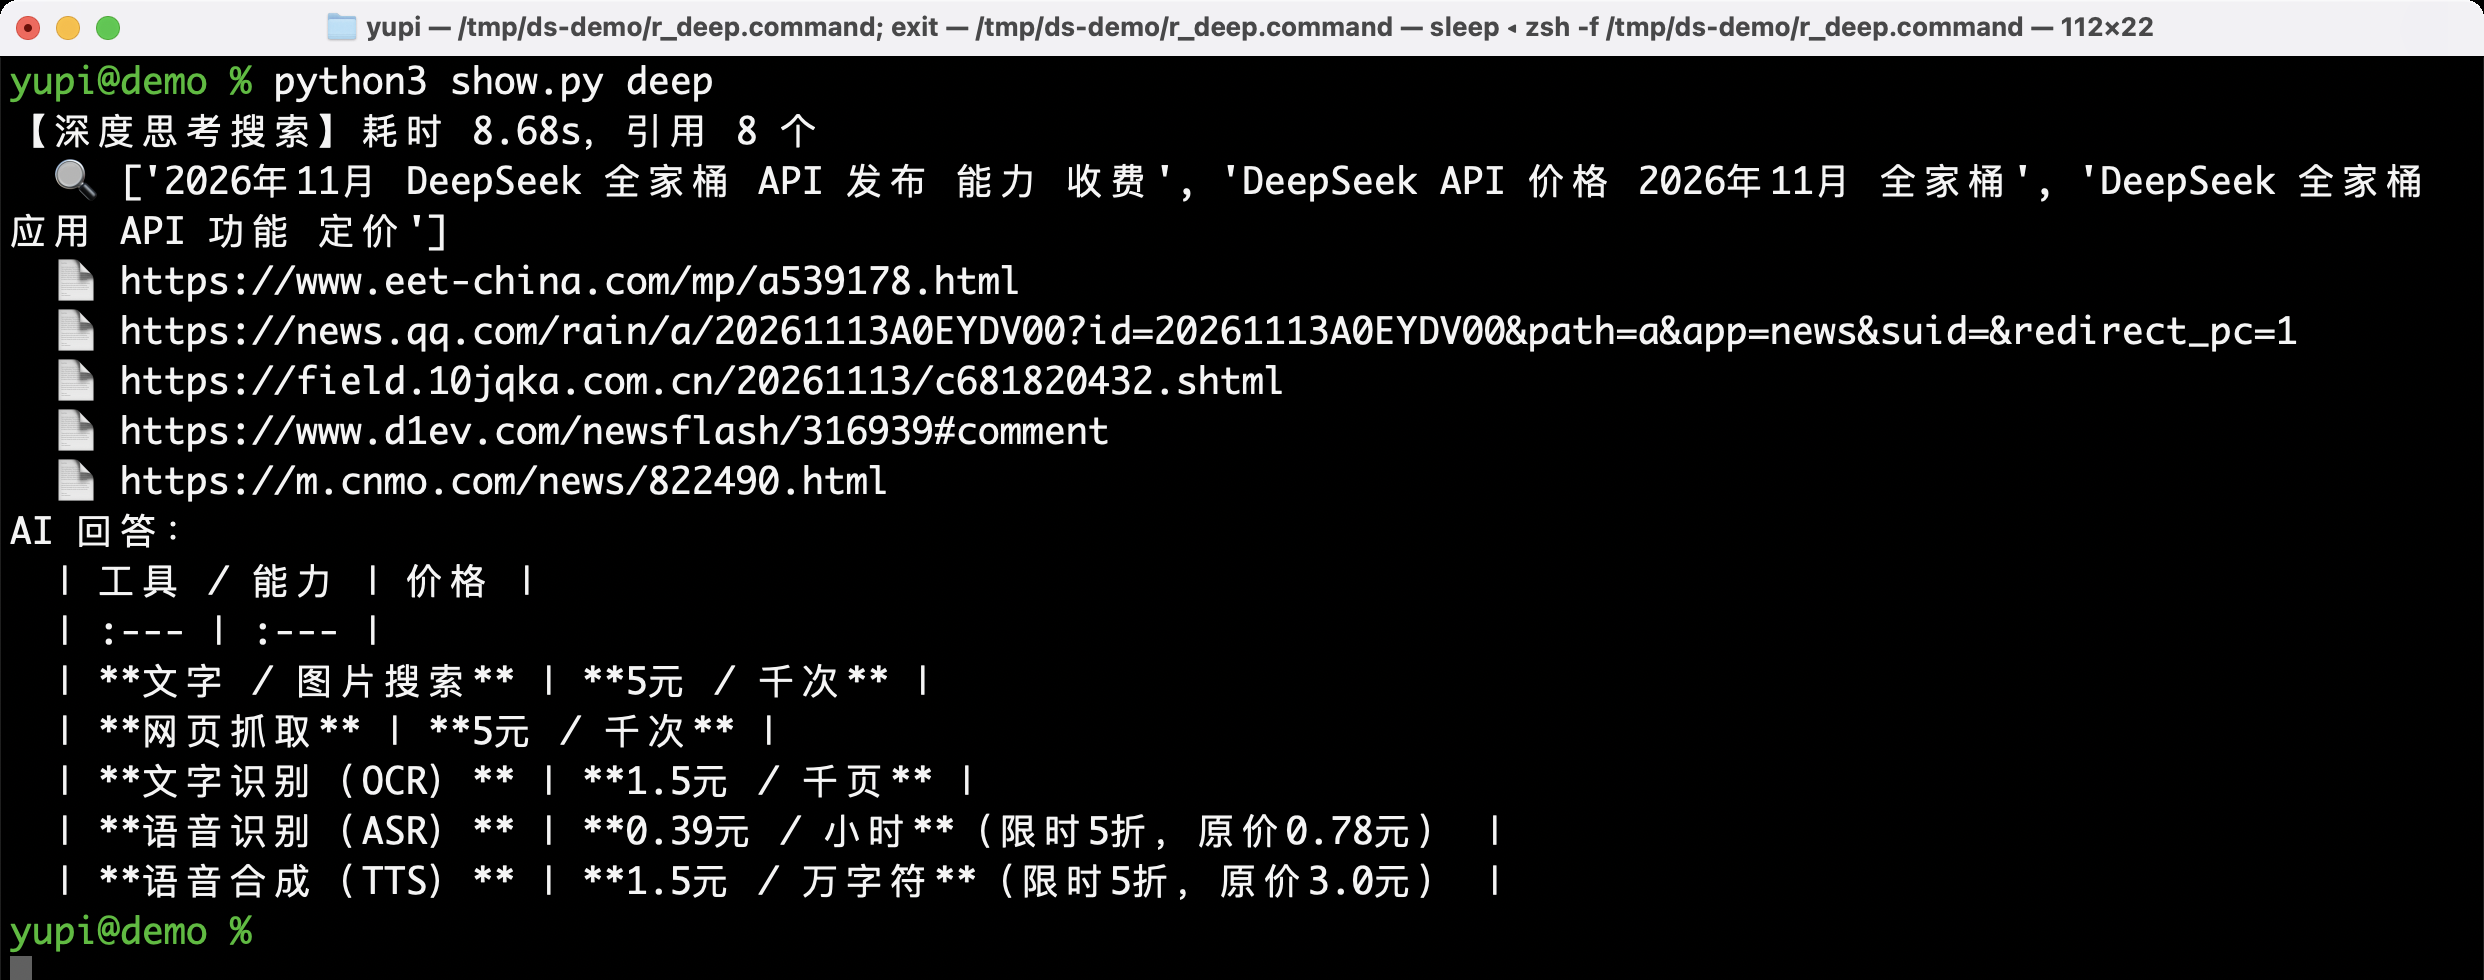
深度思考搜索
换成一个窄一点的问题,只问语音合成怎么收费,两种模式就都答对了,普通搜索只用了 2.4 秒。
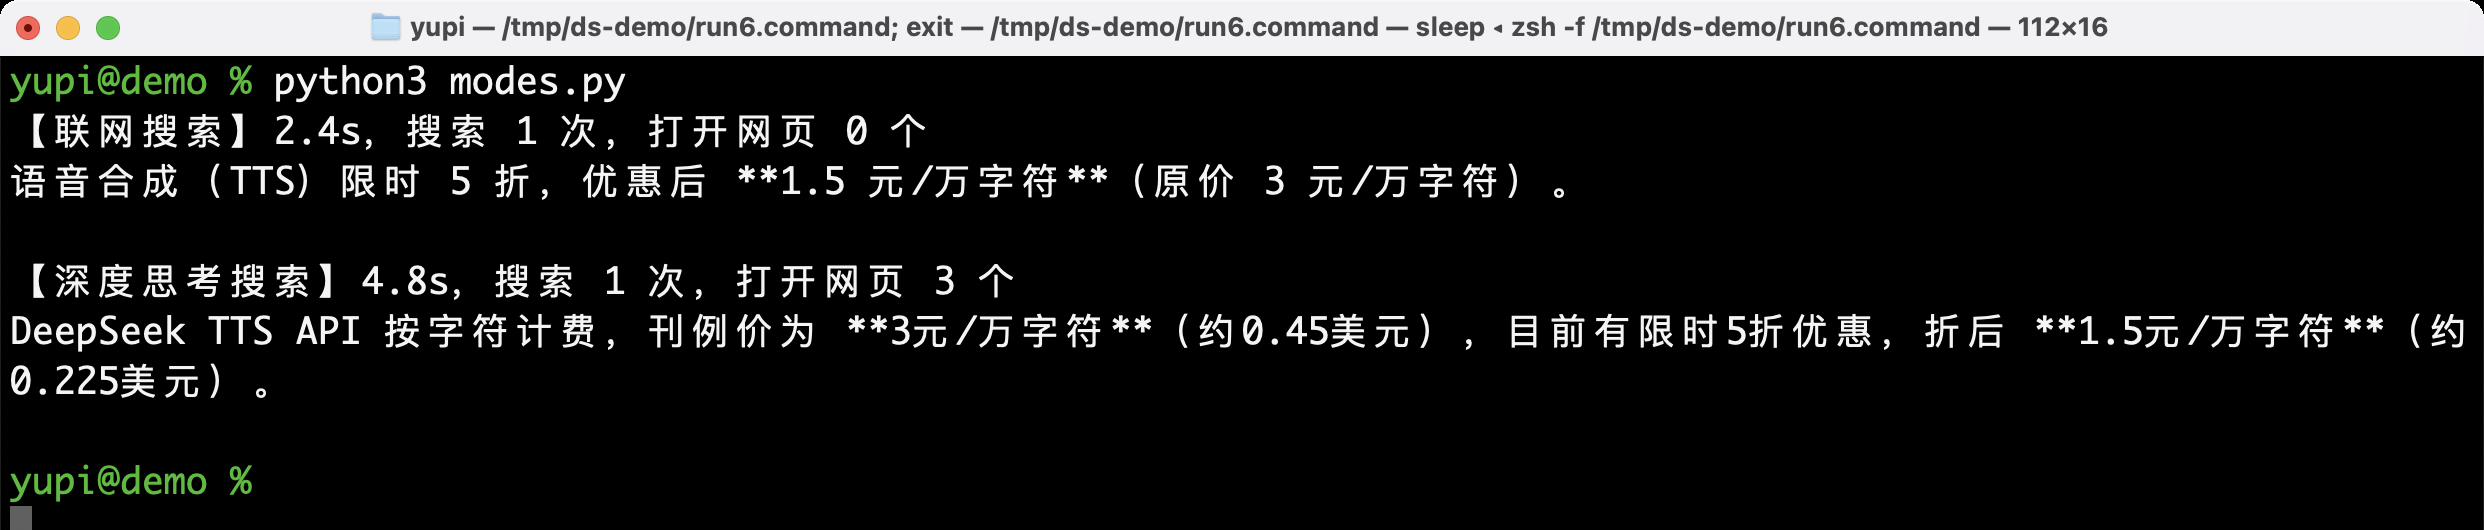
两种搜索
所以,简单的事实查询用普通搜索就够了,需要汇总好几条信息的问题再打开深度思考。
最后来个刁钻的测试,我在官方 Demo 里打开深度思考和智能搜索,问 AI:程序员鱼皮最近一个月在忙什么?
AI 一口气搜到了 26 个网页,又挑了 7 个打开阅读:
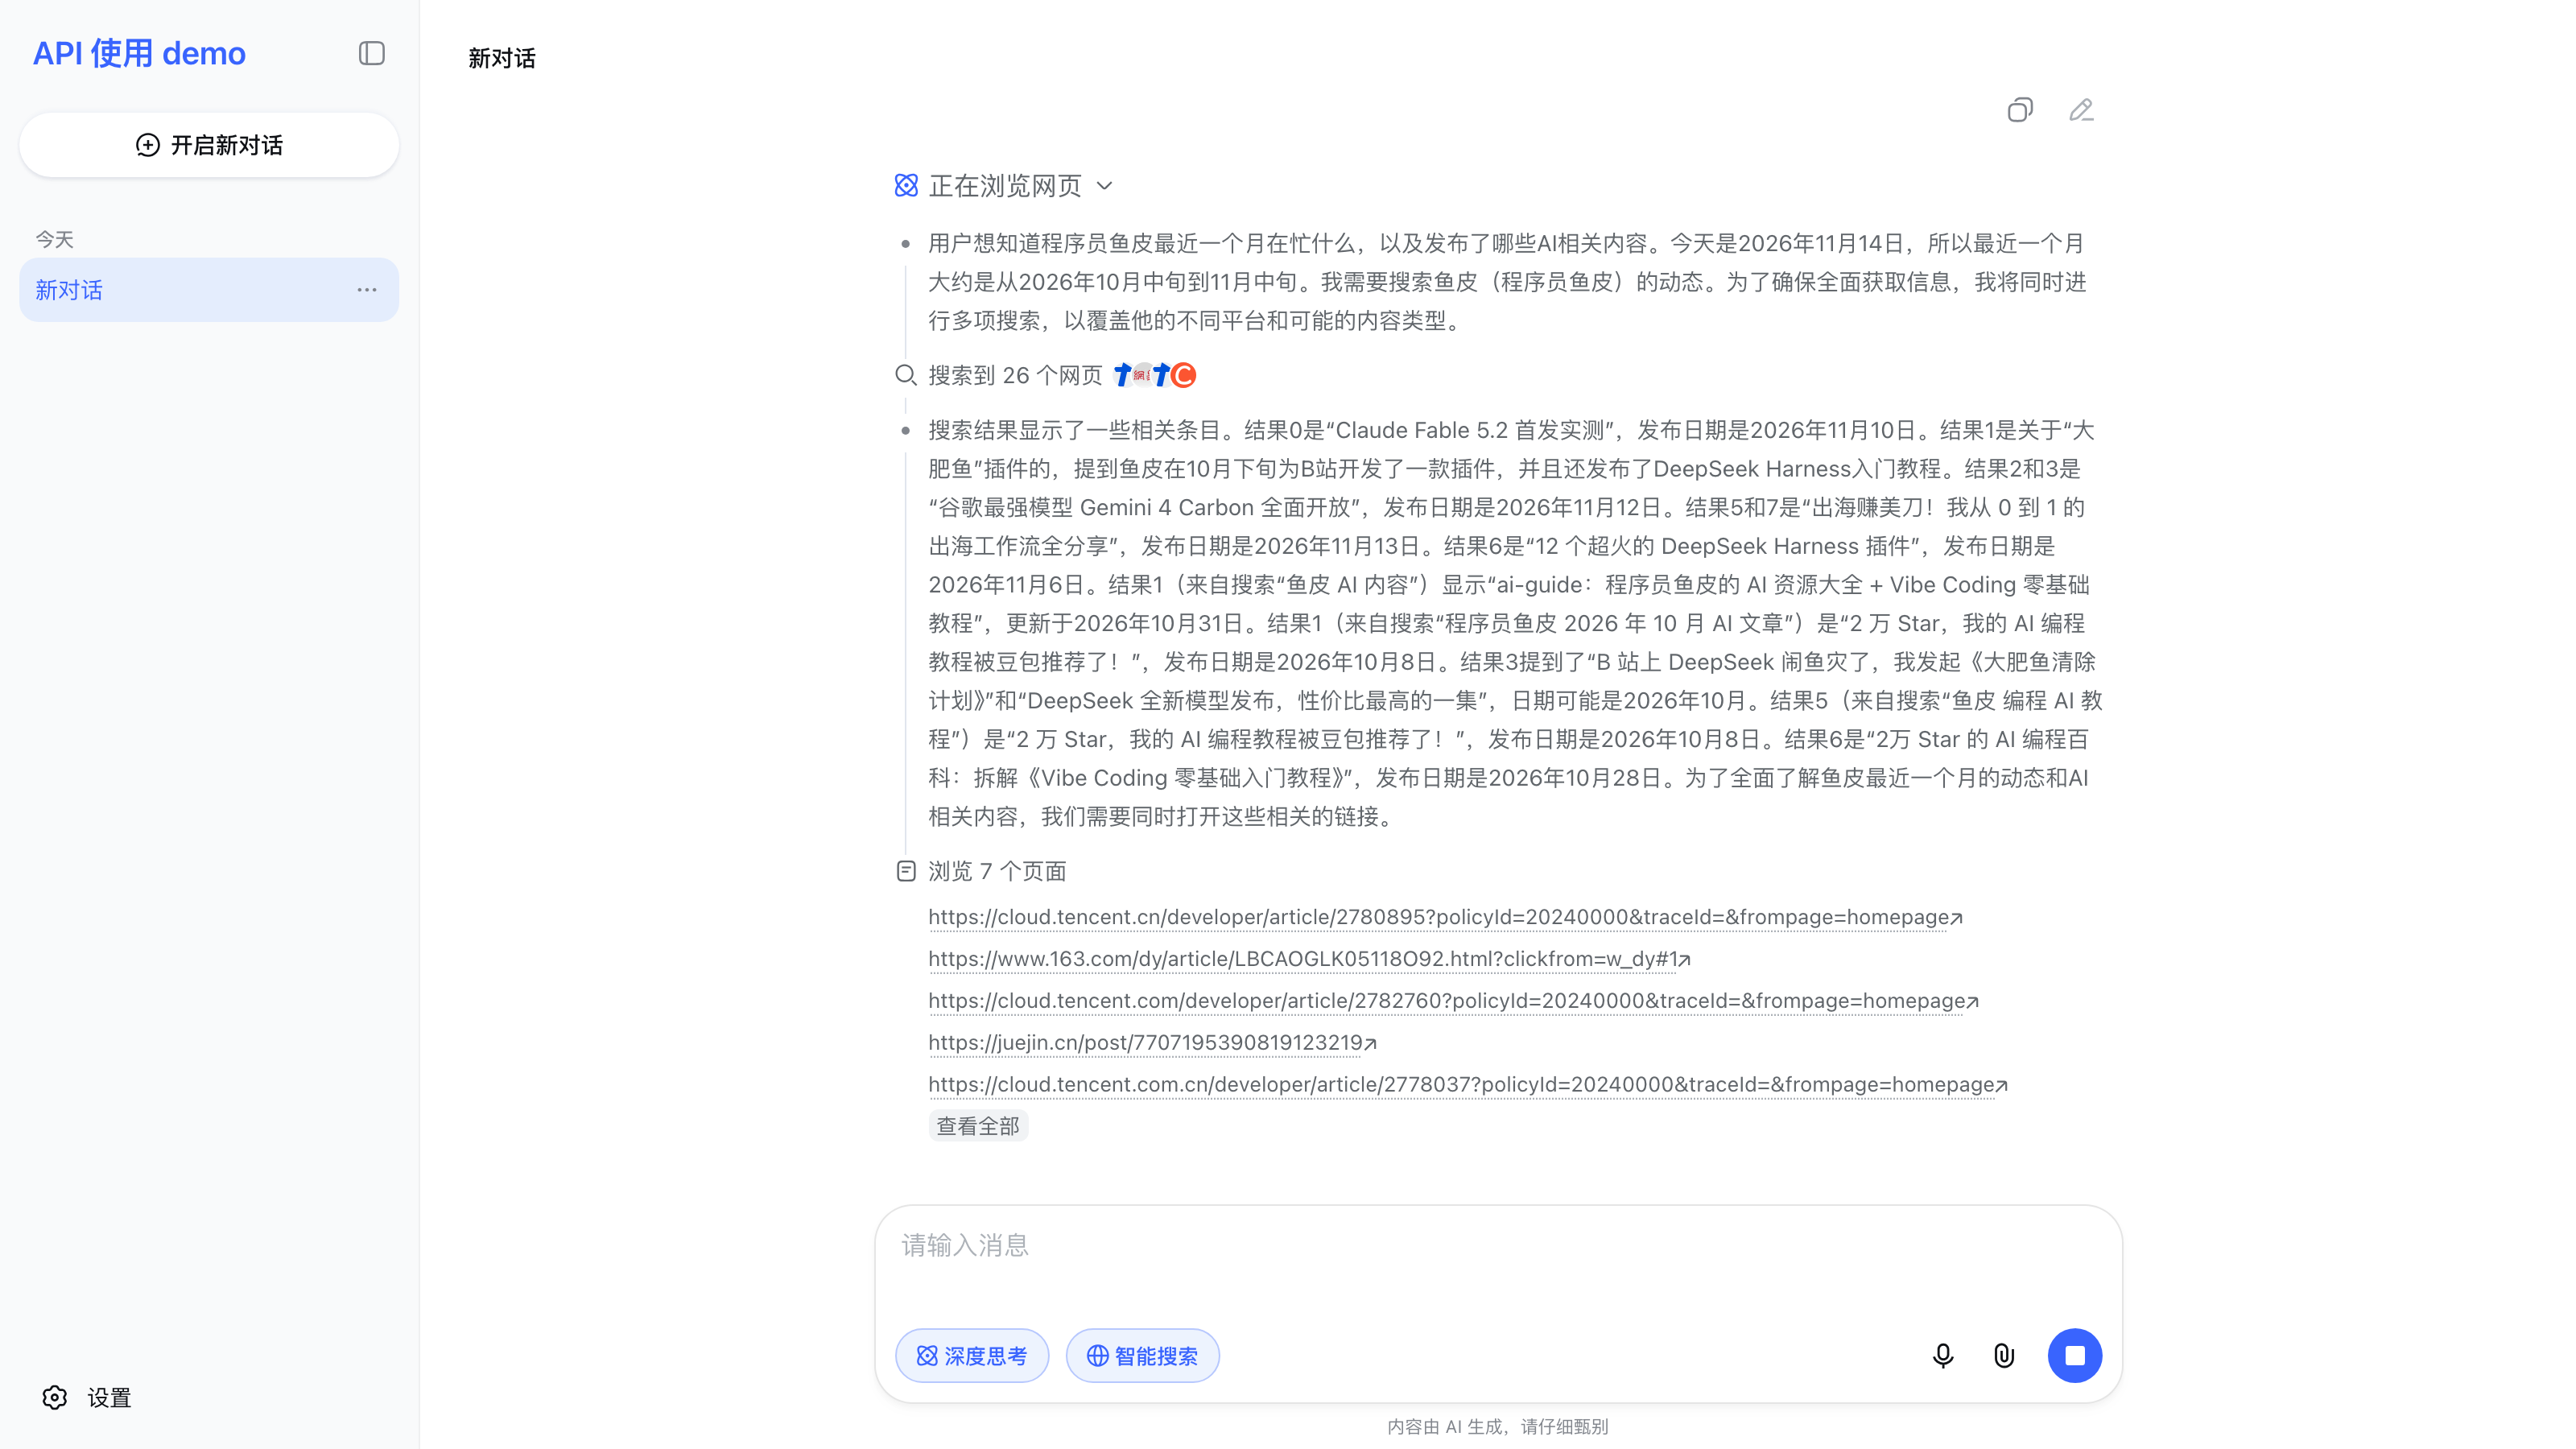
搜索过程
11 秒后,AI 按时间线列出了我最近发的 Gemini 4 Carbon、Claude Fable 5.2 测评和 DSH 插件推荐,日期全部对得上。
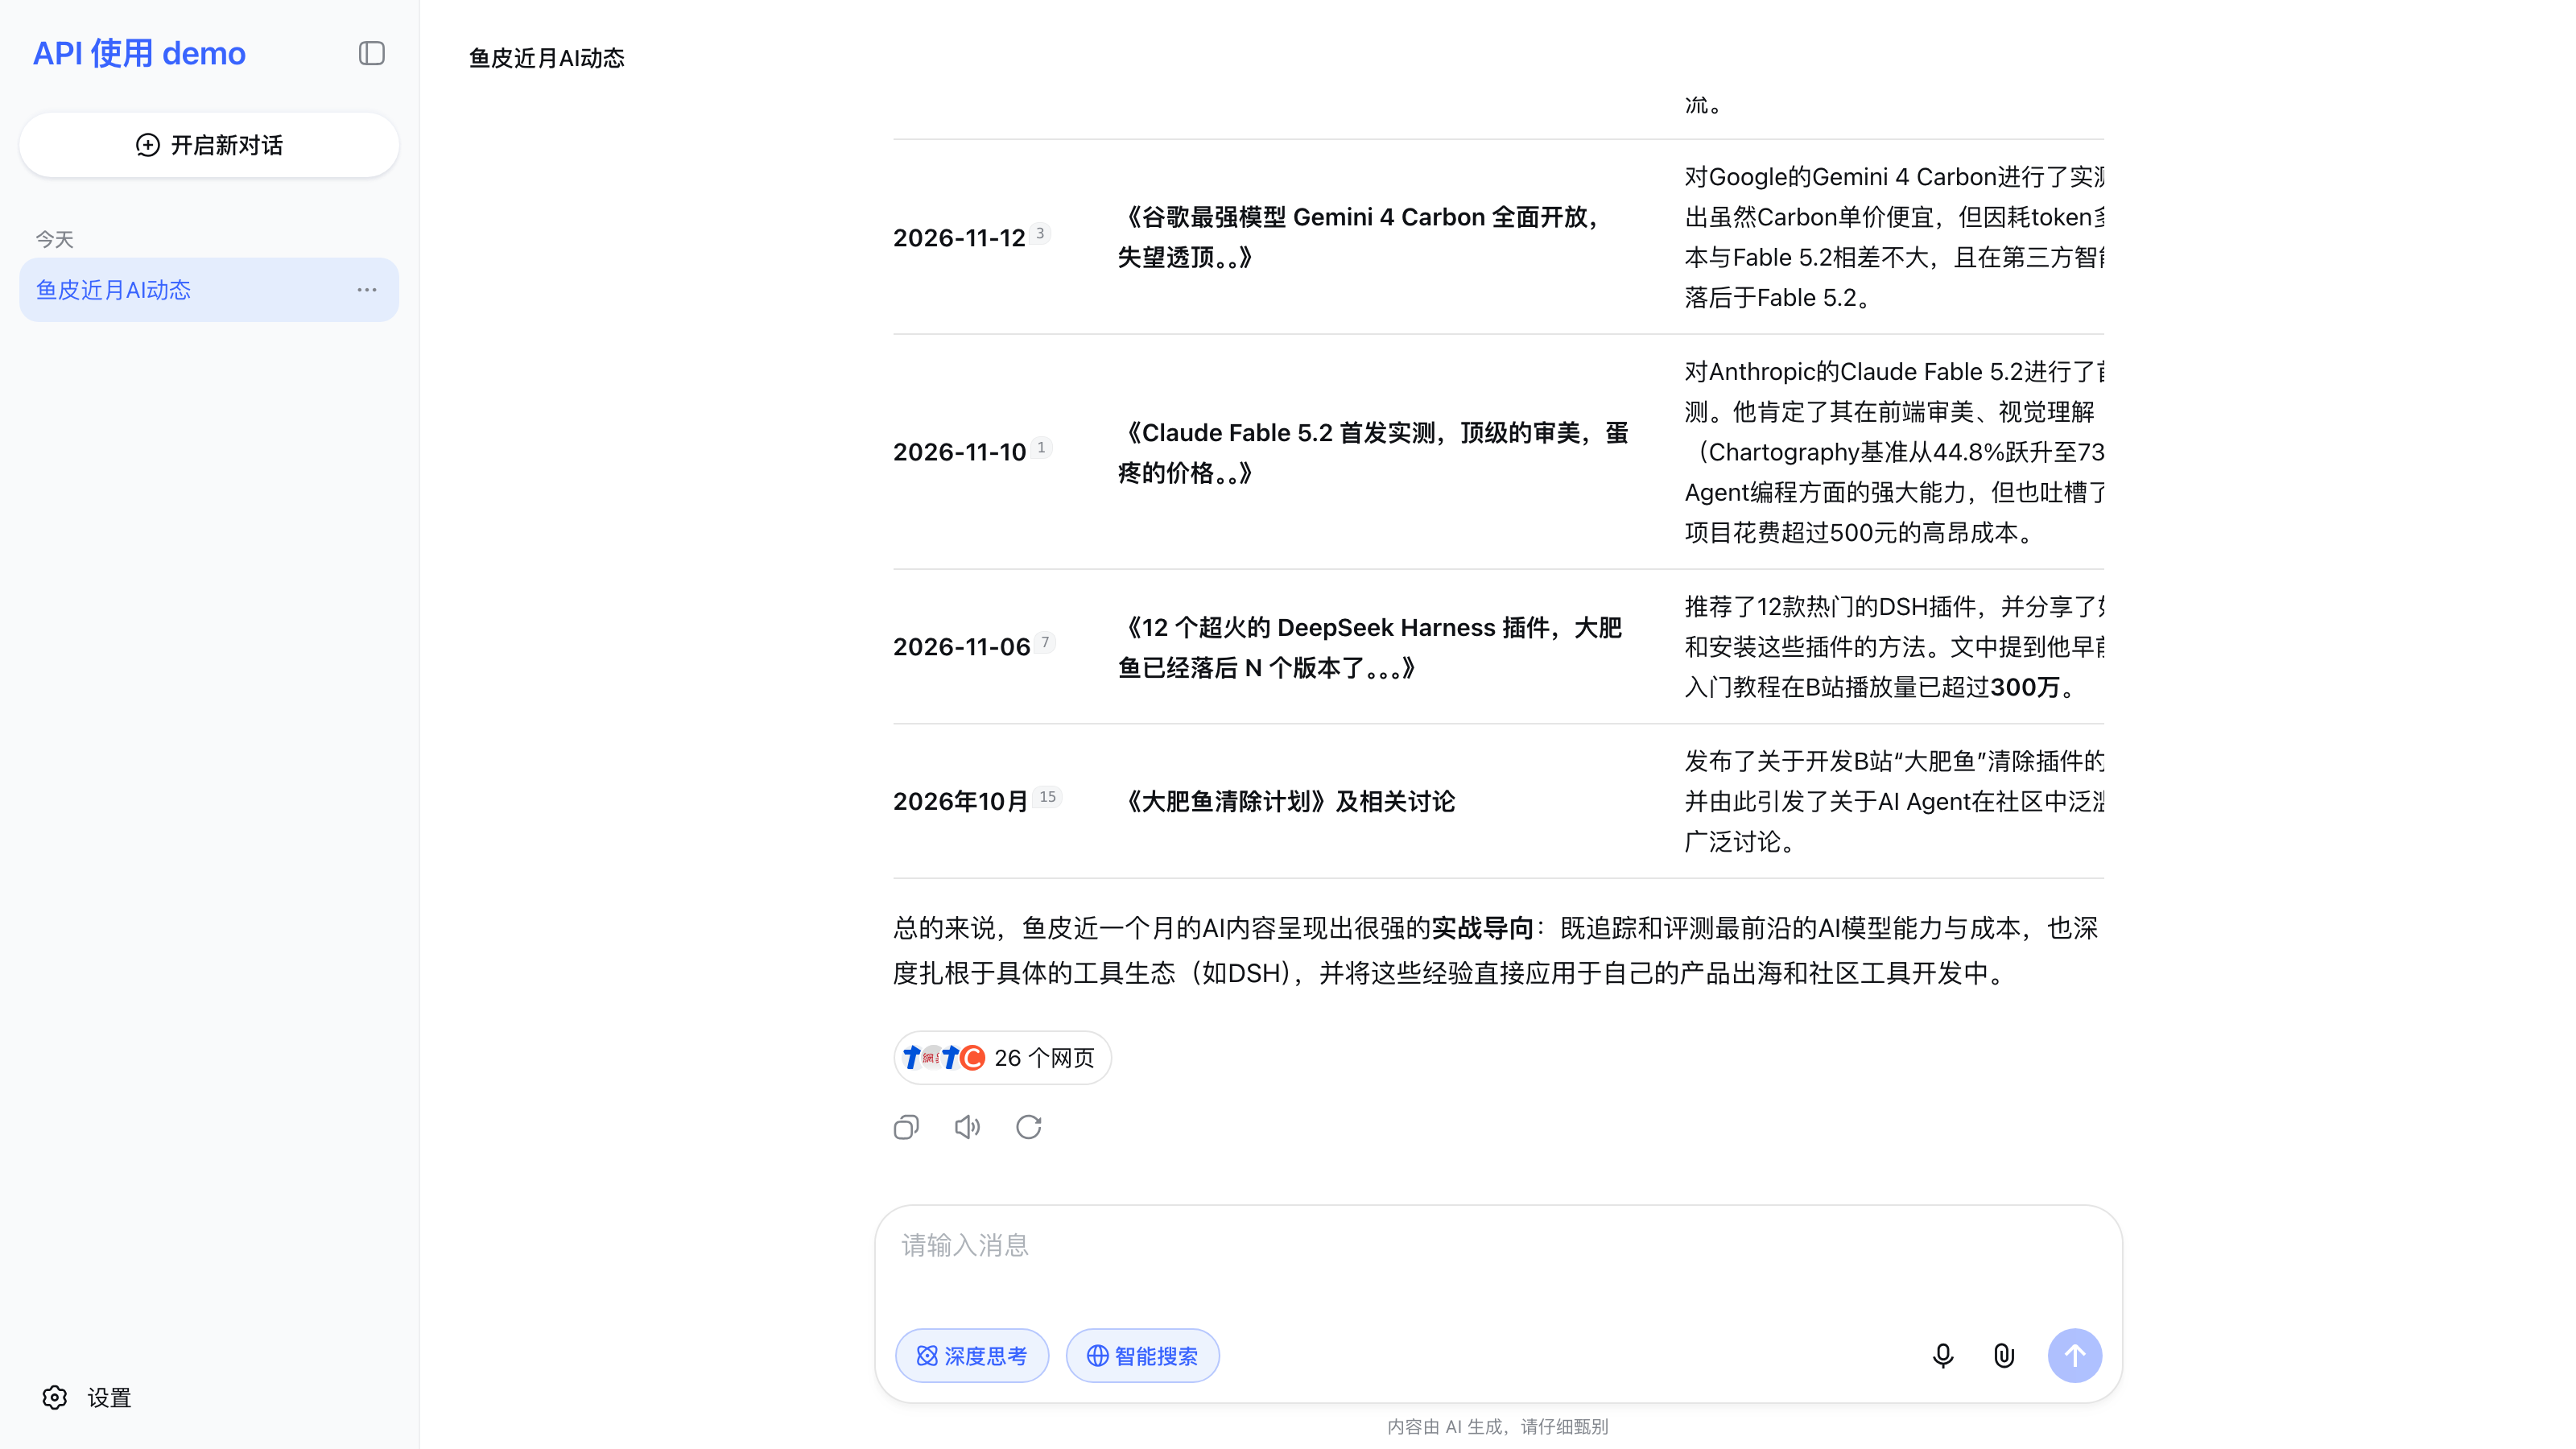
搜索结果
做自媒体竟然还有这个好处,啥事儿网上都能搜到,比我自己记得还清楚。
阅读链接实测
接下来测试 DeepSeek 阅读链接的能力,我把自己 《AI 编程教程》 的网址丢给 AI,让 AI 用 3 句话介绍一下。
6 秒后 AI 给出了回答,内容挑不出毛病。但从用量数据来看,AI 只读到了 495 个 token,也就是页面开头那一小段简介。
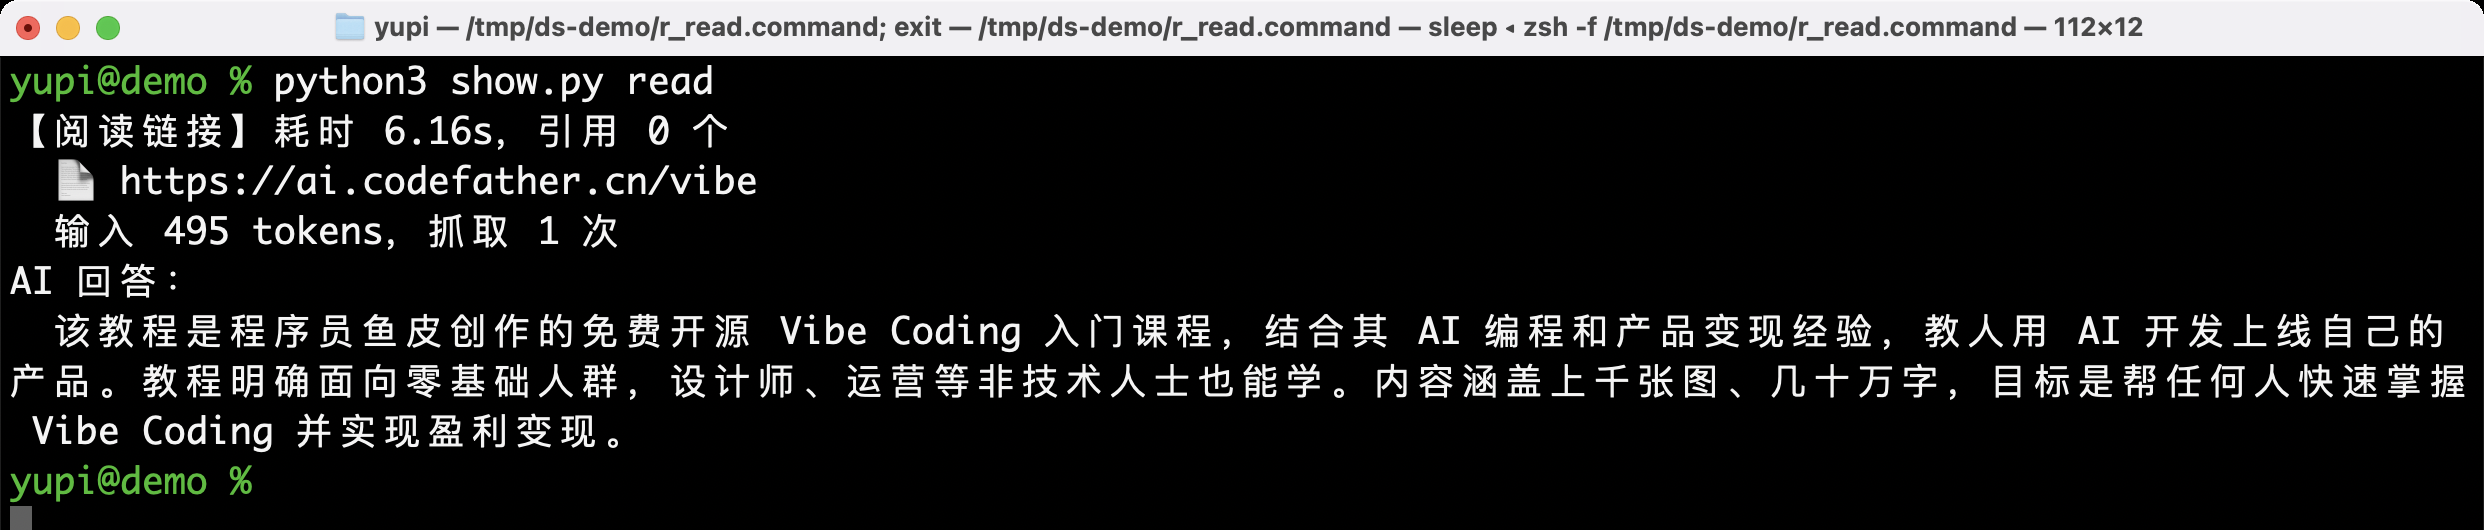
阅读链接
因为教程的章节目录是用 JS 渲染出来的,DeepSeek 抓取时不执行 JS,自然就看不到。
文件输入实测
测试 DeepSeek 文件输入能力的时候,我专门挖了个坑。
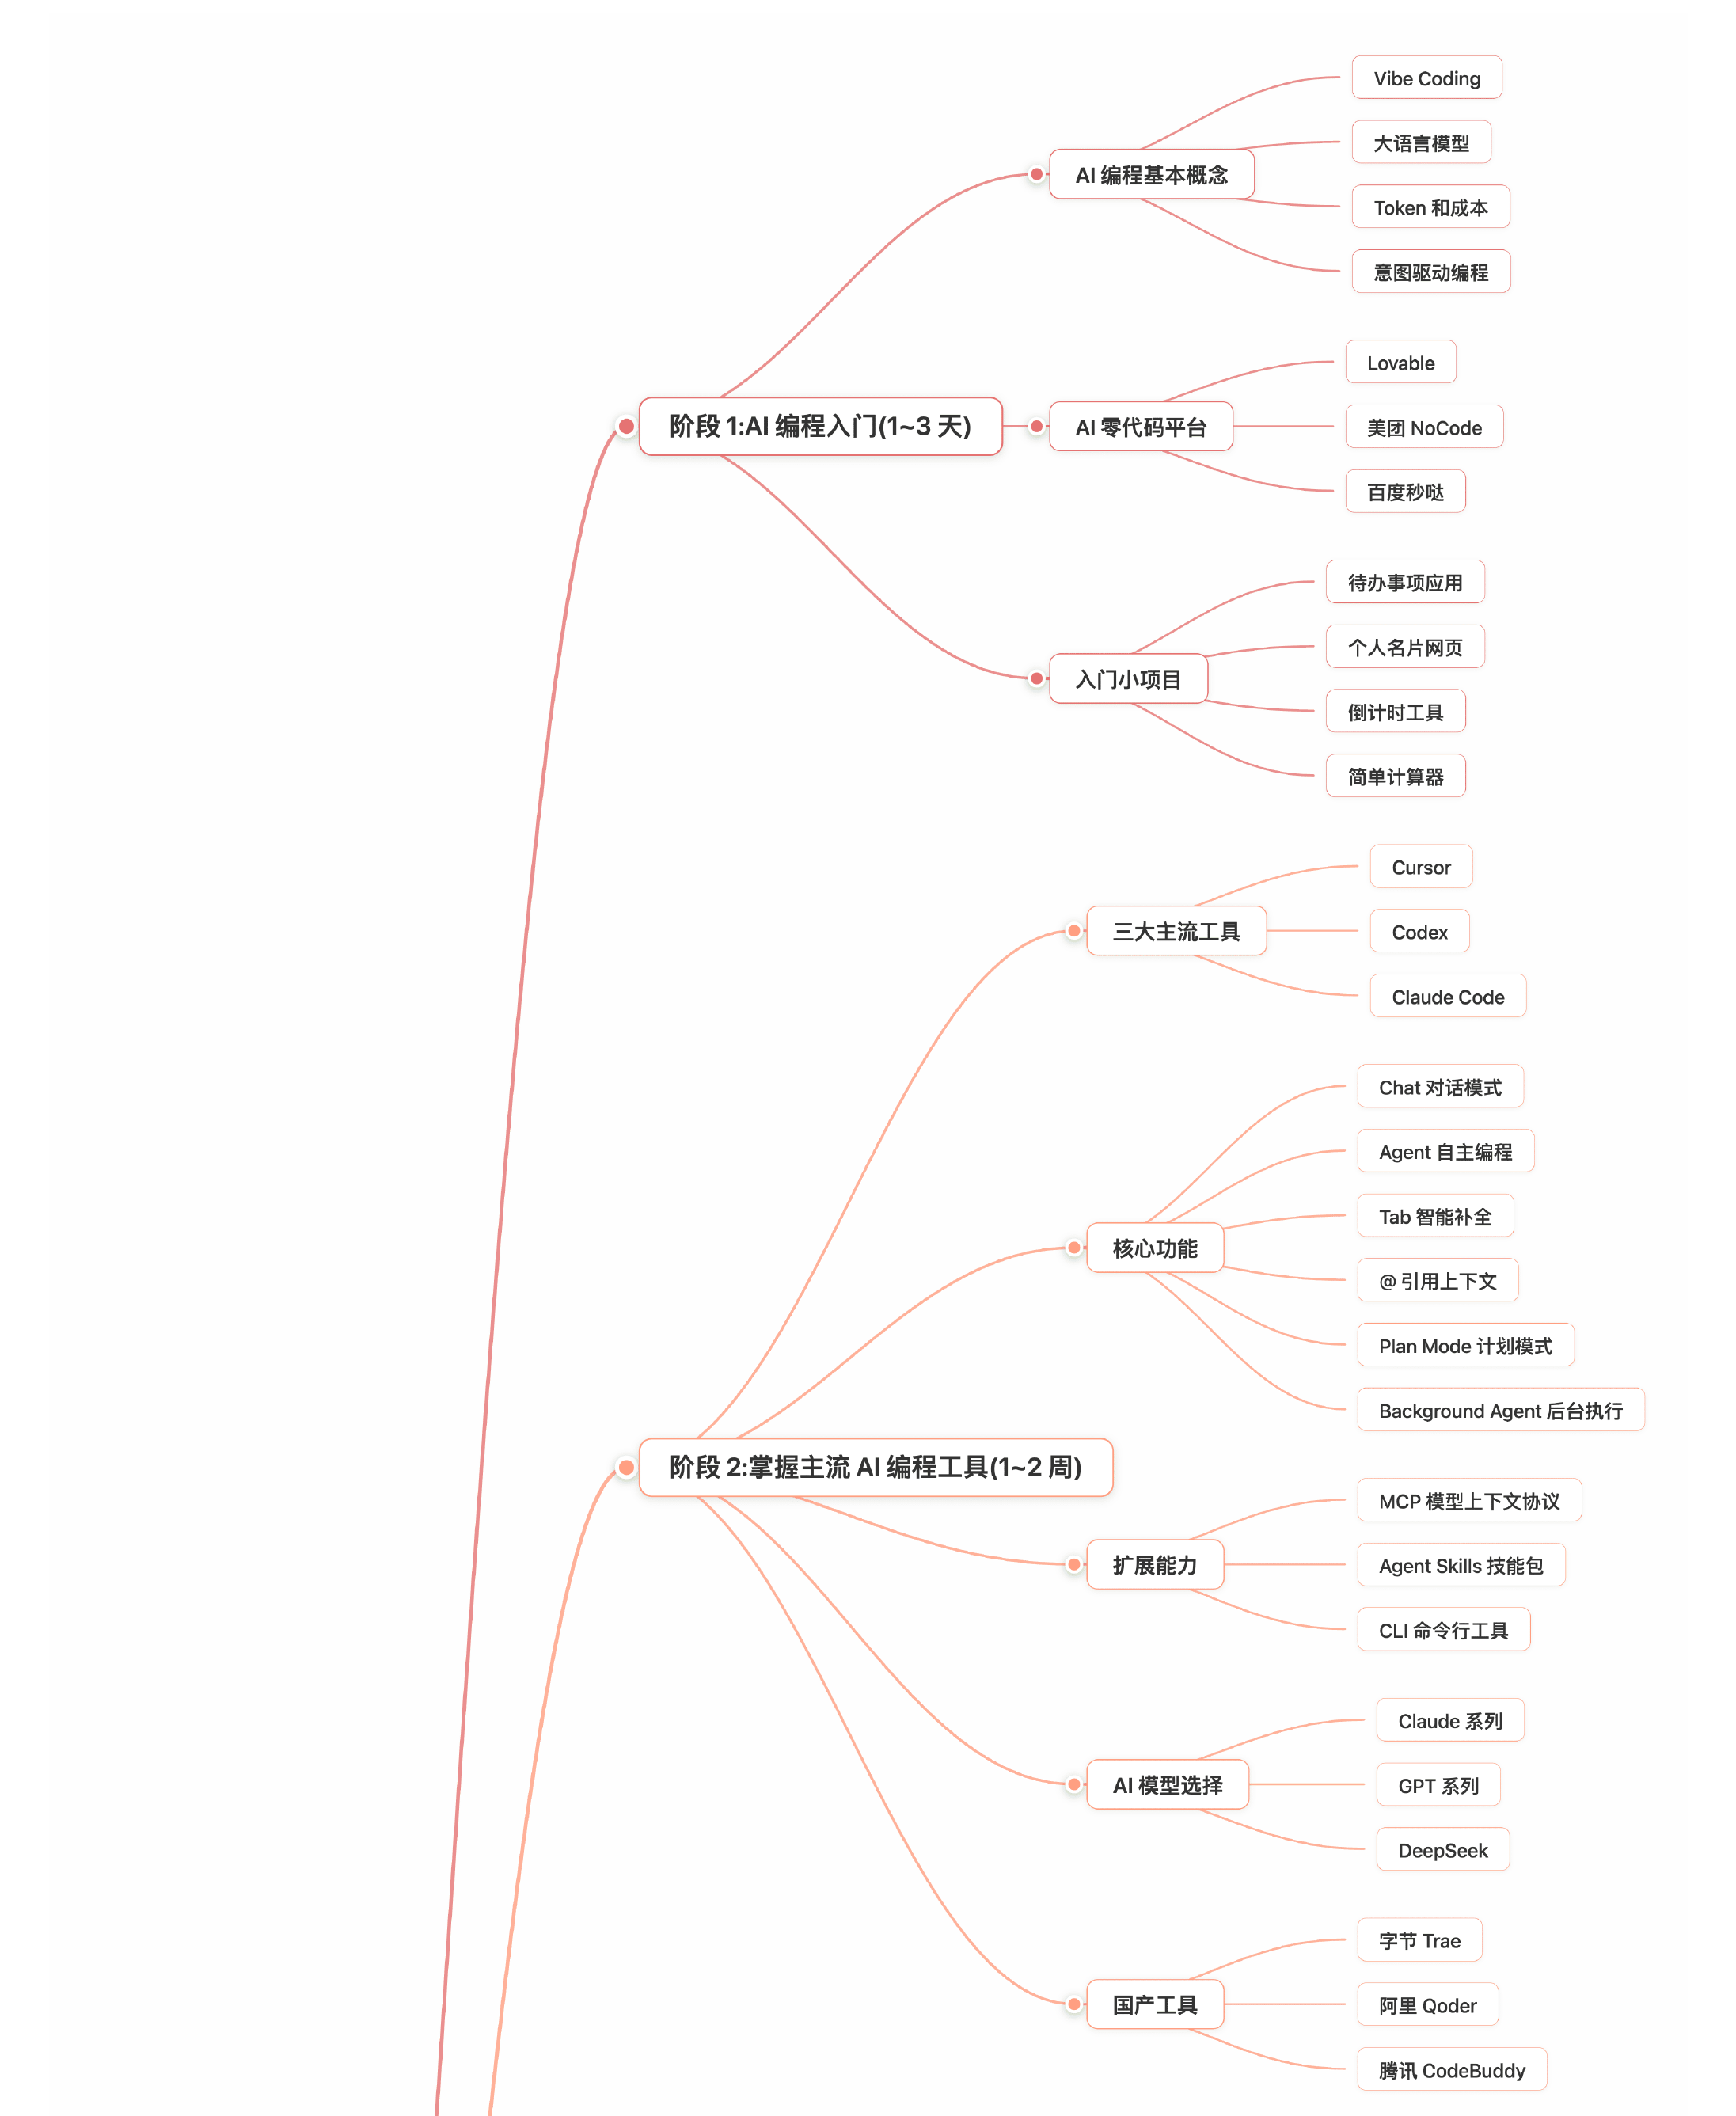
我把自己 《AI 编程零基础入门教程》 里的「AI 编程学习路线」这一章导出成 PDF,一共 35 页、36 MB,带了几十张图。
其中有一张思维导图标了每个阶段建议学多久,这些时长 只写在了图里:
上传解析花了 20 秒左右。我先问了一个正文里有答案的问题「作者建议新手先用哪个工具」,AI 只花 1 秒就答对了。而且再次引用这份文件时,1.6 万个 token 全部命中了缓存。
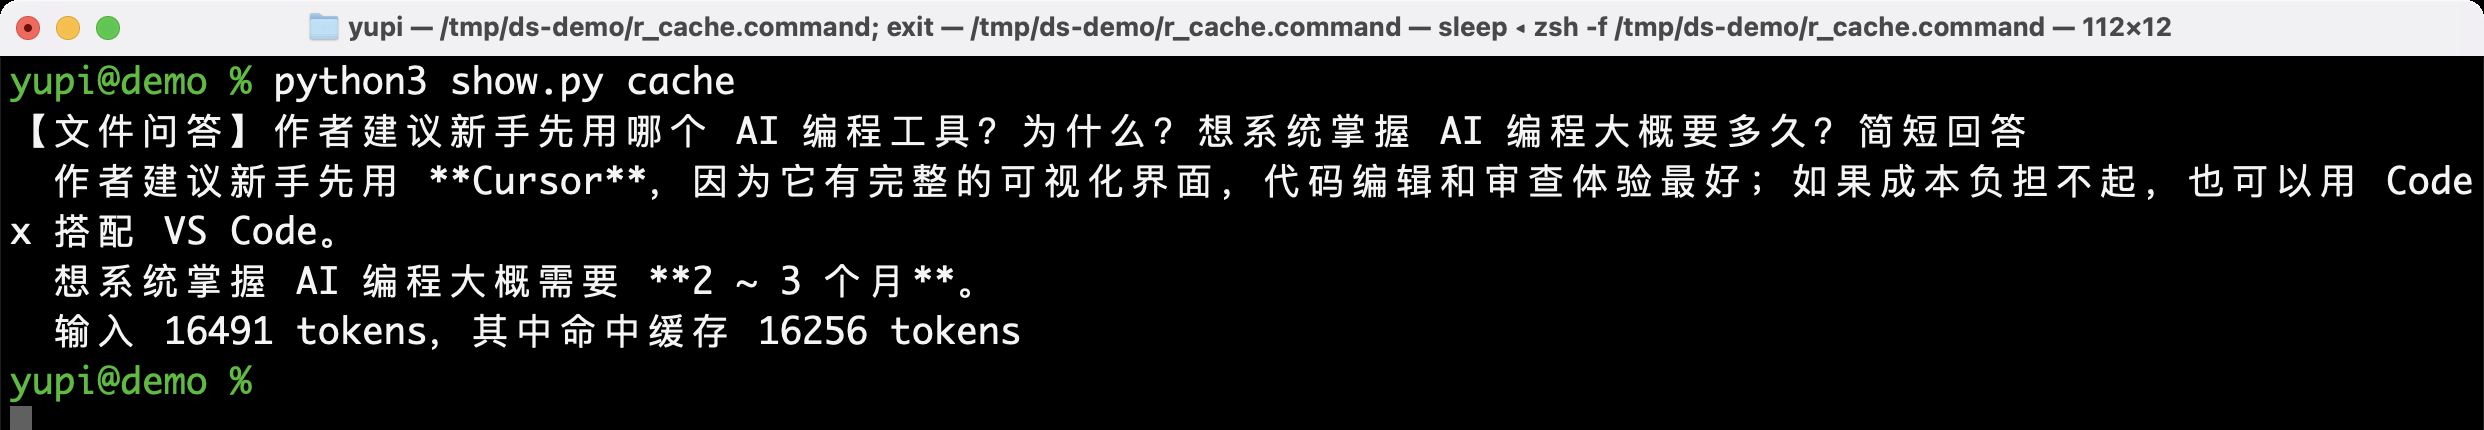
命中缓存
然后我问了图里的内容,阶段 1 和阶段 2 分别建议学多久,阶段 2 又列了哪几个国产 AI 编程工具。
结果翻车了。
纯文字解析和图文混排解析两种方式我都试了,AI 都说文档里找不到阶段 1 和阶段 2 的时长。。
可我把这一页单独截图交给 OCR 接口,只花了 2.3 秒,就把每个阶段的学习时长全认出来了。
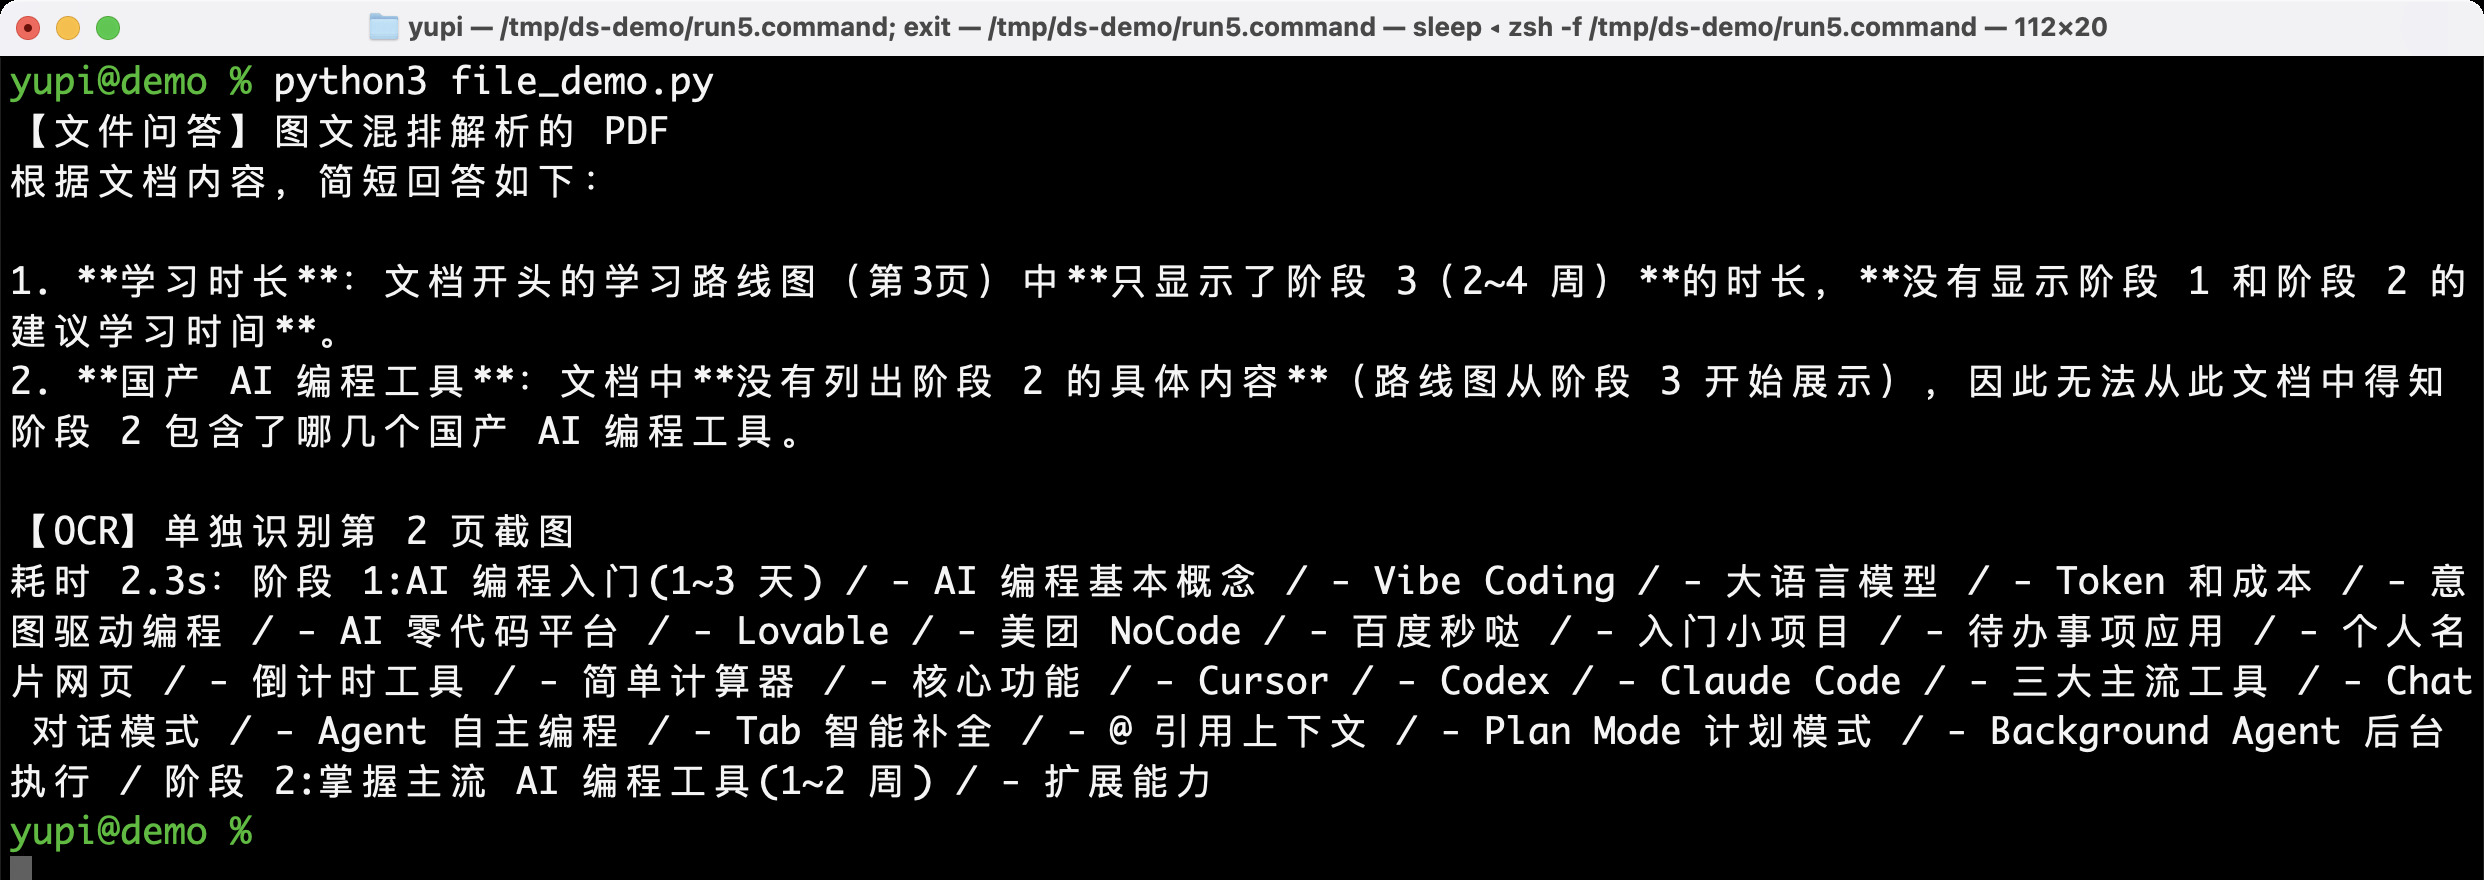
文件与 OCR
也就是说,OCR 本身认得出来这些信息,是对话里的文档解析把这一页弄丢了。不过 OCR 能力也并不完美,思维导图的层级关系被认乱了,Cursor 跑到了「核心功能」的下面。
所以如果你的文档里有些关键信息藏在图片中,要用 DeepSeek API 的话,建议先单独跑一遍 OCR,再把识别出的文字交给模型。
语音实测
测试语音识别能力时,我用的素材是自己 DeepSeek V4.1 Flash 测评视频的前 60 秒口播。
只花了 3.2 秒就识别完了,还自动加好了标点。我拿视频的字幕原稿逐字对比了一下,280 个字只错了 1 个,把「三个模式」认成了「三种模式」,准确度还是不错的。
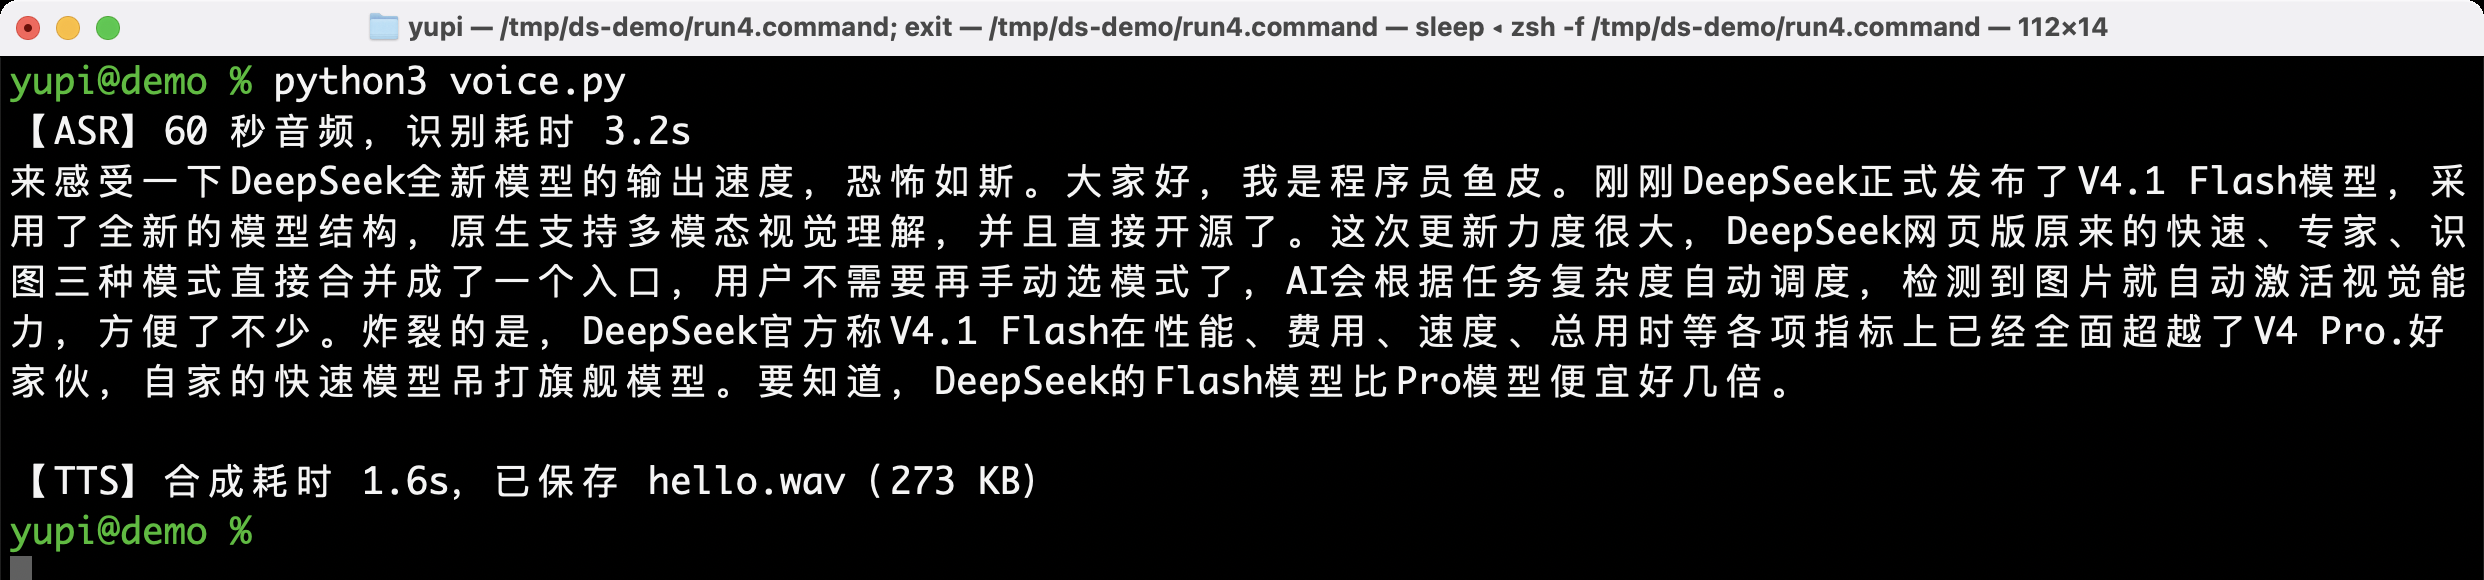
语音测试
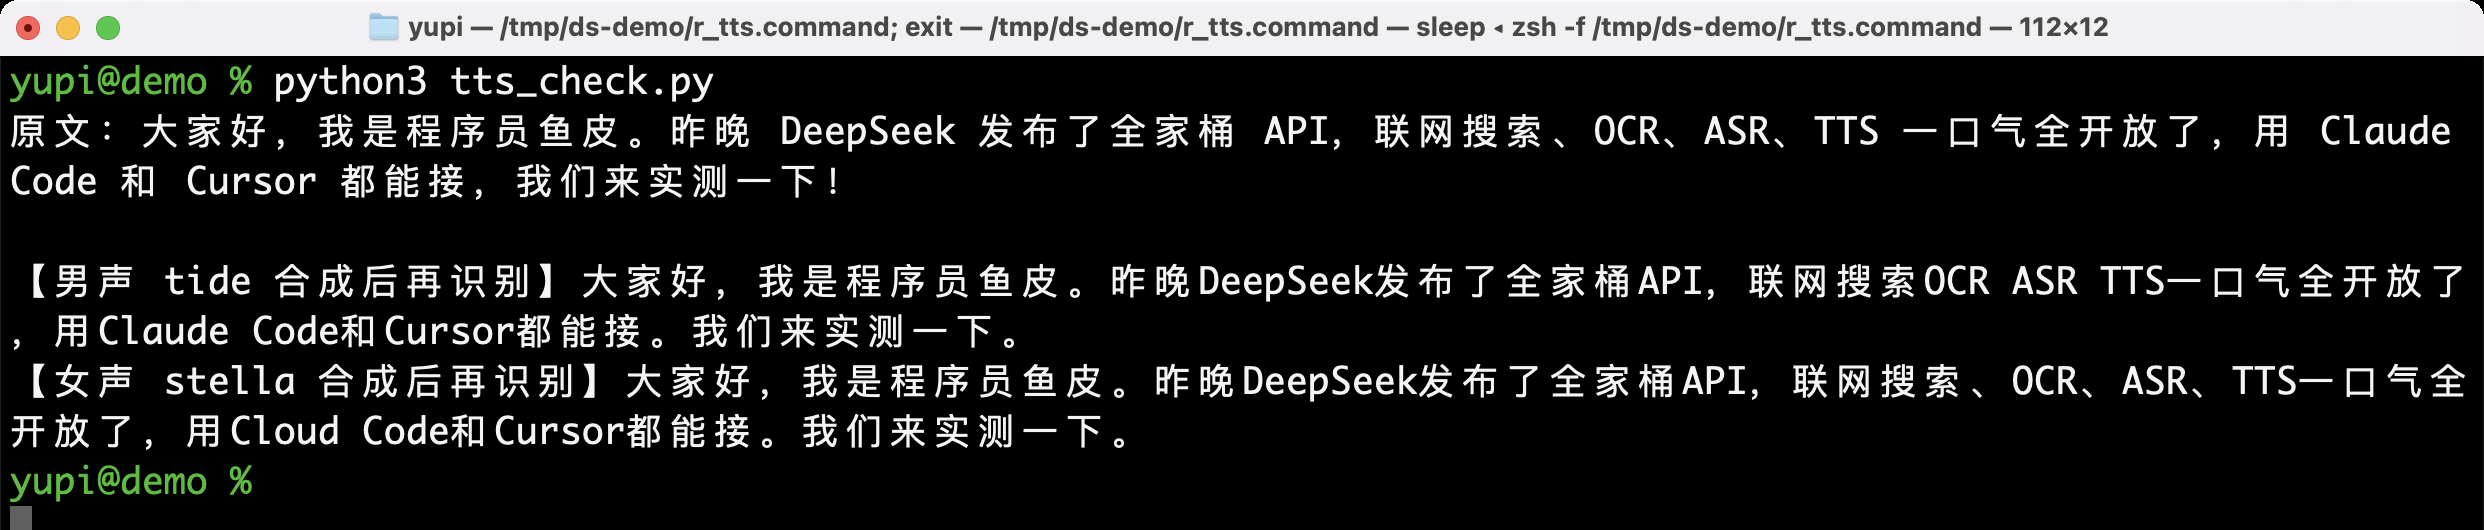
语音合成有一男一女两个音色,首字节大约 1 秒,14 秒的音频不到 3 秒就合成好了,Markdown 加粗符号等无效内容也会被自动过滤掉。
我把合成的音频再丢回语音识别做反向检查,男声版一字不差,女声版把「Claude Code」认成了「Cloud Code」。
反向检查
不过语音识别单次最长只支持 120 秒,语音合成也不能调语速,想制作长音频的话,得自己先切片。
对比其他 API
像我平时做 AI 应用,联网搜索和网页抓取用得最多的是 Firecrawl 插件,那 DeepSeek 的 Search 和 Fetch 接口能不能平替它呢?
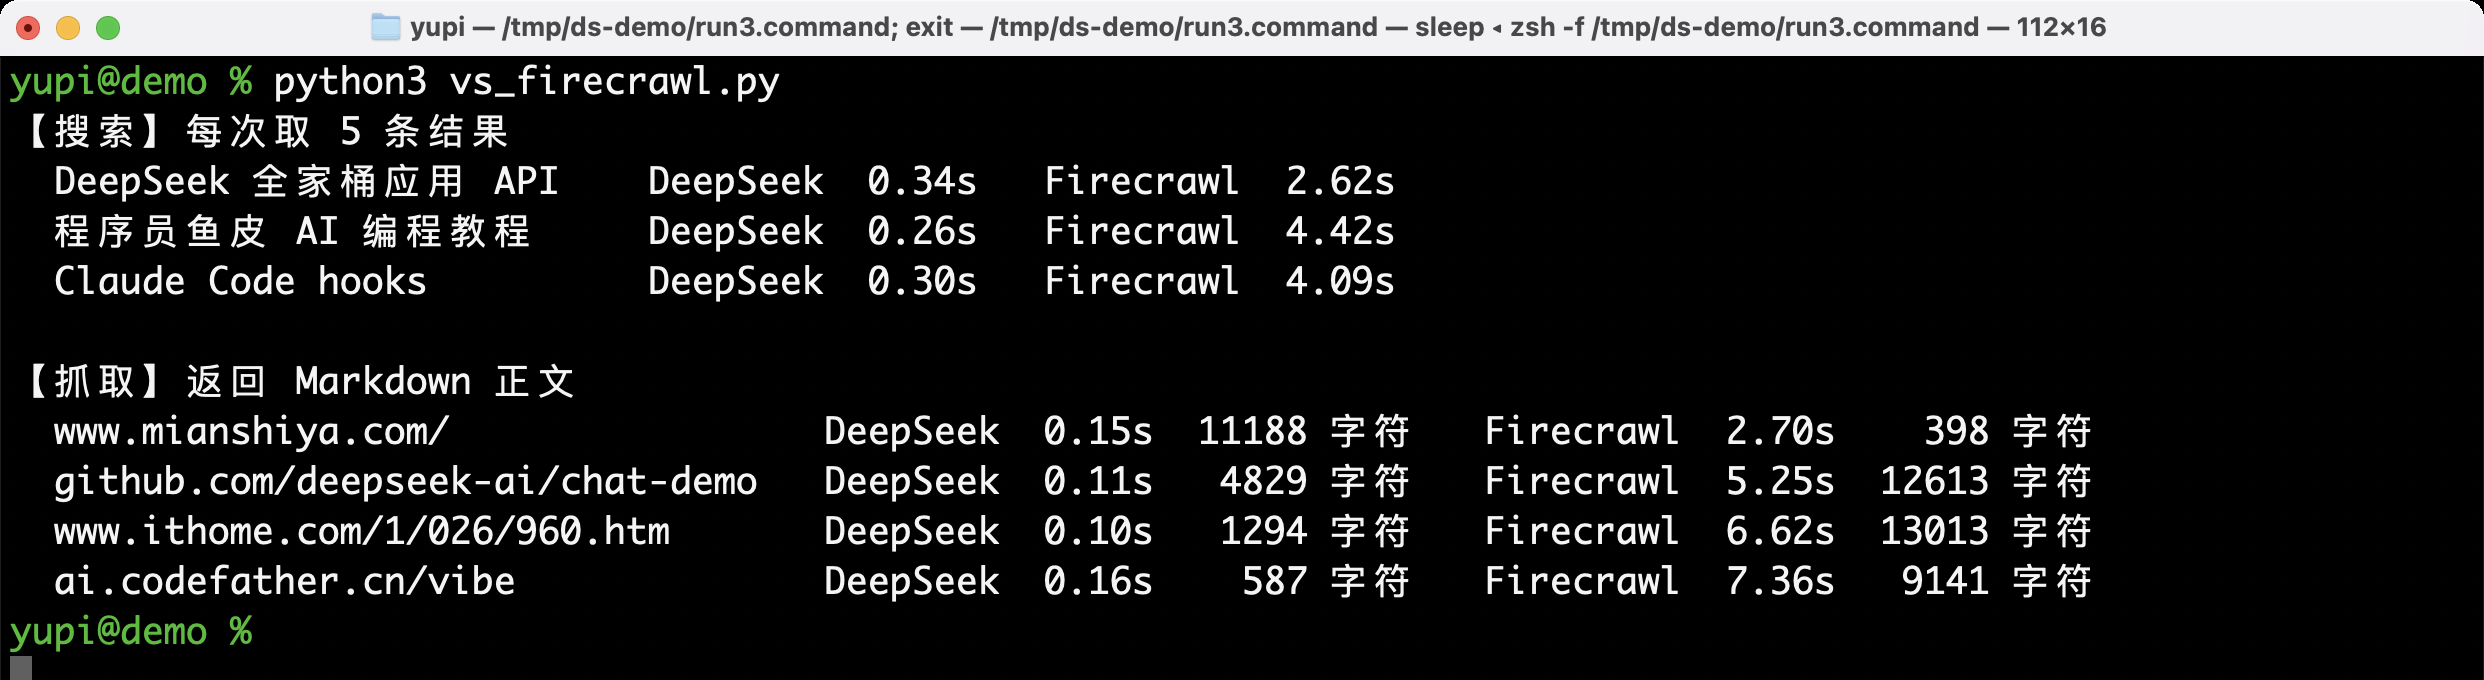
我用同样的 3 个搜索词和 4 个网址,分别调用了两家的接口:
对比结果
搜索速度的差距非常夸张,DeepSeek 每次 0.3 秒左右,Firecrawl 要 2.6 到 4.4 秒,快了 10 倍左右!
搜索质量两边差不多,DeepSeek 还会给每条结果打相关性分数和权威度等级,不过搜英文时会混进西班牙语和繁体版本的文档。
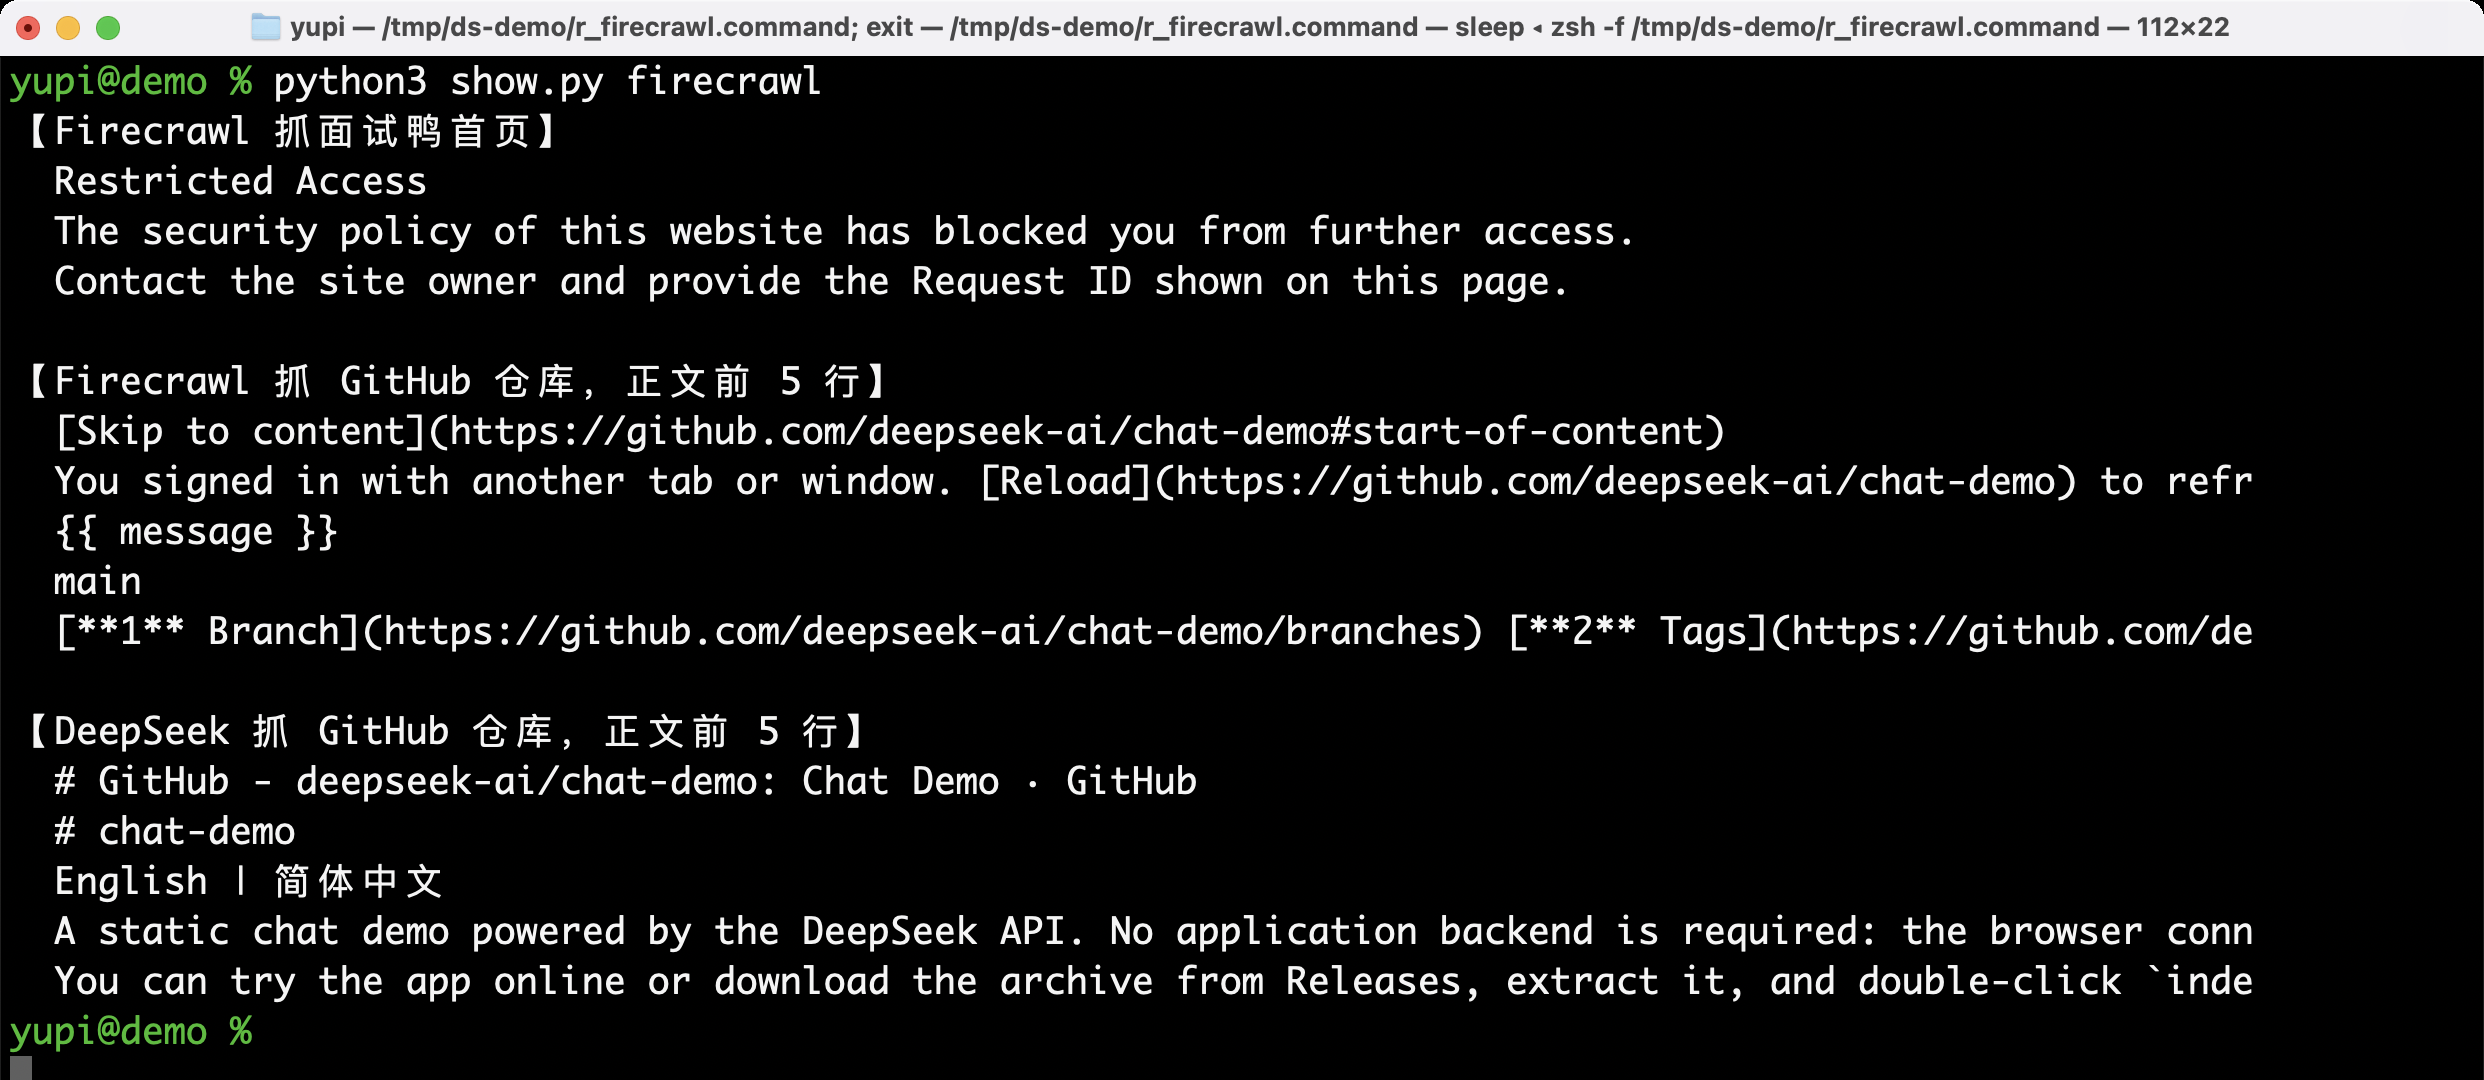
网页抓取方面,DeepSeek 大部分页面零点几秒就返回了,正文也更干净。Firecrawl 抓 GitHub 时混进了大量导航栏,抓我的面试鸭首页更是直接被网站防火墙拦了,只拿到报错页。。
抓取对比
但是 Firecrawl 会执行 JS 渲染页面,我教程网站的章节目录它能够抓到。而且 Firecrawl 还支持整站爬取、浏览器交互这些高级功能。
单论能力,还是 Firecrawl 这种专业服务更成熟。
再对比下价格。Firecrawl 最便宜的 Hobby 套餐年付每月 16 刀,换算下来,抓取一千页大约 21 元,搜索一千次大约 43 元。
而 DeepSeek 都是 5 元一千次,按量付费,还不用订阅套餐,价格上是真香。
所以我的选择是,中文网站的 AI 搜索场景直接用 DeepSeek,需要渲染 JS 或者整站爬取的时候再上 Firecrawl,应该能帮我节省不少费用。
最后哔哔
整体来看,我觉得 DeepSeek 全家桶的能力还是很丰富的,开发者又多了一个选择。
全家桶 API 最大的价值,是把做 AI 聊天应用的门槛又降了一大截。以前做一个能联网、读文件、语音对话的 Agent,得对接好几家服务,现在一个 API Key 就搞定了。
而且是真便宜。将近 20 次对话、两次 35 页的 PDF 解析,再加上 OCR、语音和二十多次搜索抓取,我总共只花了 5 毛多!
但是,每项能力单拎出来,跟专业服务比还是逊色一些,比如网页抓取不支持 JS 渲染,文件解析会丢掉图里的信息,语音合成不能调语速。
所以想快速做个 AI 应用,用全家桶一站式搞定很划算;如果某项能力正好是产品的核心,还是用更专业的服务。
另外,对外提供服务的话,官方要求开启 safety_check 安全审核,并自己承担内容审核、大模型登记、AI 标识等义务。我试了下,开启后问 SQL 注入原理这类技术问题照样能答,没有误杀。
OK 就分享到这里,本文会收录到我免费开源的 《AI 编程零基础入门教程》,上千张图、几十万字,带你从 0 开始快速学会 AI 编程,做出自己的产品、跑通变现全流程,一次拿捏。
鱼皮的 AI 编程教程
我是鱼皮,持续分享 AI 编程干货。觉得有用的话记得点赞收藏和关注~
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号