电商大促前的图片产能规划:并发、队列与排期
原创

大促前两周,需求会从常态值上跳一档。平时一周五个 SKU,这两周可能五十个。按平时的配置去接,头一周就会堵。
堵住之后的反应通常是三件:加并发、加人、通宵。三件都做过一轮会发现,出图量并不是那两天的卡点。图能出得来,但没人验、没人裁、没人等渠道回话。
这篇记的是那次之后重排的一版方式,重点在三处:约束落在哪一段、队列怎么分、倒排的缓冲放在哪。
一、先把链画出来,看卡点落在哪一段
大促的图不是一次生成的成品。它要走完一条有依赖的链:需求定稿、素材清洗、试版定方向、定稿出图、逐张验收、按渠道裁规格、送审、上线。八段里,前一段不出结果,后一段开不了工。
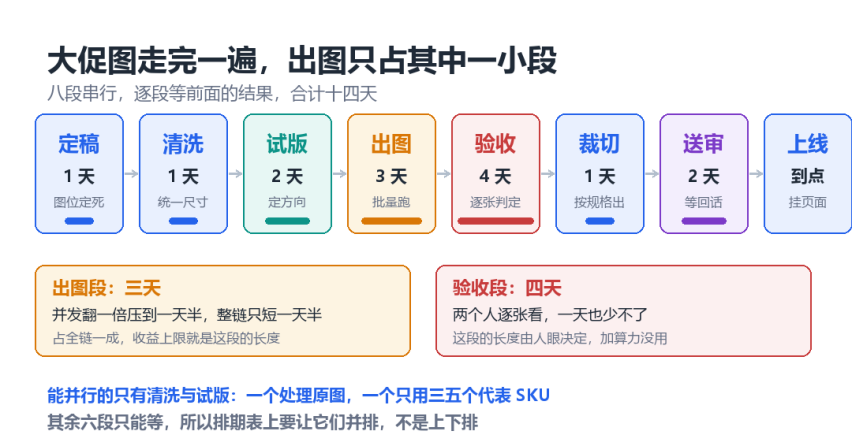
图 1:大促图从需求到上线的八段串行链,以及各段占用的天数(示意图由本文绘制)
按图上标的天数合计十四天,正好对上 D-14 到 D-1 的倒排窗口。其中出图三天,验收四天,送审那两天的进度不归自己管。
这张图能解释一件事:把出图的并发翻一倍,出图从三天压到一天半,整条链只短一天半,占全链一成。验收那四天,如果还是两个人逐张看,一天也少不了。
所以加并发这个动作,收益上限是链上出图那一段的长度。这话听着像常识,但排期一滞后,头一个被想到的永远是算力。
链上还有一段常被浪费:素材清洗和试版定方向可以并行。清洗处理的是原图,试版只用三五个代表 SKU 定方向,两者不互为前提。这一段并排放能省一天,不花额外资源,只要排期表上把它们并排而不是上下排。
这条链没有反馈回路,是它比一般产线好算的地方。每一段的耗时波动可以单独量,量完直接相加,不用考虑上游抖动传到下游会放大。代价是它也不容错:某一段整体滑了,后面所有段跟着滑,没有任何一段能把它吸收掉。
二、需求分三类,砍的次序事先定好
不是所有大促图都一样急。按紧急度分三类,判据要写成人人能对上的条件,不能写成重要程度——后者在评审会上永远吵不完。
A 类,活动主图与会场版式。有对外公布的开始时间,晚一天就错过这一批。
B 类,常规 SKU 套图。只要求在大促窗口里上线,具体哪天不硬。
C 类,历史补图与视觉优化。没有对应活动,纯粹是欠账。
三类的处置写进表里,排期一滑动就照着砍,不在会上临时争。
类别 | 判据 | 可延天数 | 落在哪条队列 | 排期滑动时怎么处置 |
|---|---|---|---|---|
A 类 | 有对外公布的开始时间 | 零天 | 队列二 | 不砍,从队列三抽槽 |
B 类 | 只要求在大促窗口内上线 | 三到五天 | 队列三 | 按 SKU 顺序从后往前砍 |
C 类 | 没有对应活动 | 不限 | 队列三 | 先砍,且平时就该做完 |
三类混在一起排,结果是都赶、都不精。更实际的坏处是 C 类会先占掉配额:它没有截止时间,所以永远有空就跑,等 A 类要跑的时候池子已经满了。这不是态度问题,是队列性质带出来的——没有 DDL 的任务在共享队列里永远抢在前面。
三、产能按出图量估,估完发现卡点在后头
一个 SKU 的完整套图是九个固定图位。按经验,一张交付图背后平均要跑二点五遍,试版、换角度、返工都算在里面。五十个 SKU 就是四百五十张交付图、一千一百二十五张出图量。估产能不能用四百五这个数,要用一千一百二十五。
出图侧的账好算。定稿档单张四十秒上下,六个槽位同时跑,一个八小时窗口的名义产出四千三百张。折损按六成计——重试、换批、参数调整、空转都占时间——实际两千六百张左右。一千一百二十五张,半个窗口跑完。
验收侧的账不好算,但必须算。逐张验收要做三件事:对照图位要求看主体与背景、看边缘与文字、登记判定结果。三件合起来三分钟出头,一人一天按七小时有效工时算,一百二十张上下。两个人干,一天二百四十张,一千一百二十五张要四点七天。
两个数摆在一起,结论就变了:出图侧半个窗口,验收侧接近五天。排期要按后一个数排。
所以那两周真正该加的不是并发,是验收的人手,或者降验收粒度——用抽检代替全检。抽检比例也别拍脑袋,用前两天全检的分歧率来定:两个人各自判一遍同一批,记录判定不一致的比例。不一致率低于 3% 的图位,之后改抽三成;高于一成的,回到全检,并且把判定标准重写一遍。这个比例每批重算,不一次定死。
折损六成这个数也值得单独说一句。它包含四类时间:失败重试、换个批次重新提交、参数来回调、队列空转等人。头一类可以靠工程手段压下去,后三类压不动,它们是人做决定的时间。按十成算出来的产能表,头一次排就会崩。
四、三条队列,配额固定不抢占
按截止时间把活分三条队列。队列一是定稿重跑,也就是对照清单没过的图,量小但卡着上线。队列二是活动主图与会场版式,有硬时间点,按截止时间升序排。队列三是常规套图,按 SKU 顺序跑。
三条队列共用一个并发池。这里有两处要定死。
一处是队列之间不做抢占。抢占看着公平,谁急谁上,但它让长任务反复被打断:一个批次跑到第七张被踢出去,回来要从头再跑,前面七张的配额和时间全沉掉。定稿重跑本来就急,一开抢占,它自己也会被别人抢。
另一处是每条队列有固定配额,不能占满全池。给一组实测出来的比例:全池二十四个槽位,队列一四个,队列二十个,队列三十个。
队列一只给四个,不是因为它不重要,是因为它够用。定稿重跑的日峰值三十张上下,四槽跑满一小时出九十张,余量本来就宽。反过来,按所谓重要程度给它十二个槽,它八成时间在空转,另外两条被它卡住。这类错配在排期表上看不出来,因为表上只有总量,没有占空比。
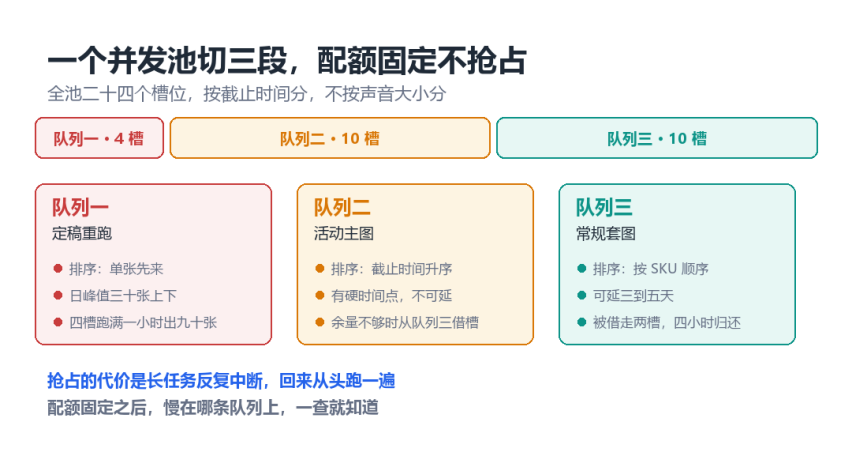
图 2:一个并发池切成三段固定配额,以及三条队列各自的排序规则(示意图由本文绘制)
配额还要能临时让。让的方式是写规则,不是开会协调:队列二的剩余张数超过当日窗口可处理量的一点五倍时,自动从队列三借两个槽,借出以四小时为一段,到期归还。规则写下来的好处是可复算——事后能查出那天为什么慢,而不是靠当事人回忆。
队列内部也要限流。一条队列占满全池的情况必须避免,否则队列二的任务会被队列三堵死——不是被抢走,是被排在同一条队里等。限流的单位是单条队列的并发,不是总并发,两者混在一起配,等于只做了总量控制,没有做隔离。
五、退回件分三类,回不同的队列
退回这个词在不同人嘴里不是同一件事。三类混在一起处理,队列一会被堵死。
一类是没跑出来的:超时、链路中断、结果为空。这类不涉及判断,回队列一,原参数重跑,范围是单张。
二类是跑出来了但规格不对:比例错了、留白不够、超出渠道的文件大小。这类不该重出,回加工段改裁切,重跑范围是零张。
三类是跑出来了但内容不对:主体选错、图位放错、跟卖点不搭。这类必须改提示词再跑,回队列三,范围是整个图位组。
类型 | 判据 | 回流位置 | 重跑范围 | 混在一起处理的后果 |
|---|---|---|---|---|
没跑出来 | 超时、中断、结果为空 | 队列一 | 单张 | 与内容问题混排,该改的批次被拖后 |
规格不对 | 比例、留白、文件大小 | 加工段 | 零张 | 被当成生成问题重跑,下一批还是错的 |
内容不对 | 主体、图位、与卖点不搭 | 队列三 | 整个图位组 | 只重跑不改提示词,同一个错反复出现 |
三类混成一个失败重试按钮,代价很具体。一批五十张里有十张是比例错的,按生成问题重跑一遍,等于白烧十张的配额,而且下一批还是错——原因根本没被改到。
还有一个容易忽略的:三类退回在量上的分布极不均匀。跑了一个月,没跑出来的那一类占七成以上,内容不对的可能一张都没有。这意味着队列一的设计目标不是吞吐,是不要让那七成排到队列三后面去。给它小配额加高优先级,比给它大配额更贴实际。
六、倒排:缓冲压两处,不平均摊
以活动上线日为 D 日往回排,十四天拆成六段,早晚两段各留一处缓冲。
节点 | 要做完的事 | 这一段滑了怎么办 |
|---|---|---|
D-14 | 需求定稿,SKU 清单锁定 | 后面全滑,直接砍 C 类并缩 B 类范围 |
D-12 | 素材清洗与抠图完成 | 与试版并行做,滑一天不占关键路径 |
D-10 | A 类图定稿 | 砍 C 类,两个槽从队列三抽给队列二 |
D-8 | B 类首批交付,开始逐张核对 | 核对粒度从全检改抽检,比例按分歧率定 |
D-6 | B 类返工完成 | 砍 B 类长尾,先保前二十个 SKU |
D-4 | 全部定稿,按渠道裁规格 | 裁切脚本化,一个人批量跑,不再逐张改 |
D-2 | 送审,留出渠道回话的时间 | 不压缩这一段,压缩它等于赌审核不出问题 |
D-1 | 只做紧急修正 | 这一天还开新任务,说明前面某一段没守住 |
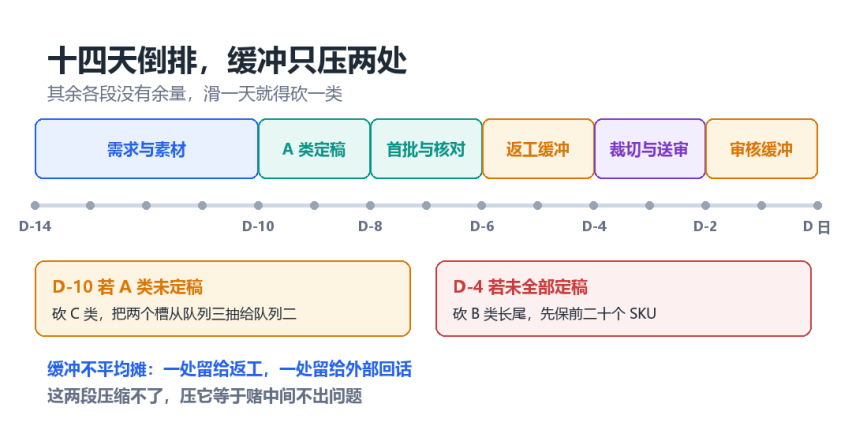
图 3:十四天倒排的六段与两处缓冲,以及两个砍单触发点(示意图由本文绘制)
关键在于缓冲不平均摊。十四天如果每天留半天余量,等于每天都有余量,也等于哪里都没有余量——真出事那天,半天不够任何一段用。可行的做法是把余量集中成两处:D-6 到 D-4 的返工缓冲,D-2 到 D-1 的审核缓冲。前一处是自己的问题,后一处是别人的进度。
倒排的可行性可以当场算,不必等排到一半才发现来不及。算法很短,拿剩余窗口乘有效吞吐,和剩余张数比一下:
def throughput(slots, sec_per_image, hours=8, derate=0.62):
    """名义产出乘实测折损:重试、换批、等人都在里面"""
    return int(slots * hours * 3600 / sec_per_image * derate)
def check(need, slots, sec_per_image, hours=8):
    cap = throughput(slots, sec_per_image, hours)
    return cap >= need, cap, need - cap
# 五十个 SKU、九个图位、放大二点五倍
need = int(50 * 9 * 2.5)          # 1125
print(check(need, 6, 40))         # (True, 2678, -1553)
# 验收侧:一人一天一百二十张,两个人干几天
def review_days(need, people, per_day=120):
    return round(need / (people * per_day), 1)
print(review_days(need, 2))       # 4.7
跑出来的数说明一件事:出图侧永远有余量,验收侧永远不够。所以可行性检验的输入不该是出图能力,该是验收人天。换成后一个数,结论才对——算下来要四点七天,而 D-6 到 D-4 之间只有两天缓冲,缺口两天半,要么加一个人,要么把全检改成抽检。
这个脚本的用途不是算命,是把争论变成一次算术。排期会上说来不及,和算出缺口两天半,是两种不同性质的对话:前者只能靠拍板,后者可以选方案。
七、三处容易忽略的地方
一是大促前不要换系统。换系统要重新熟流程、重新定判断标准,这两件事平时做。大促前换,等于把判断标准的重建压在不能出错的两周,而且出错时没有旧路径可退。
二是大促前不要上新版本。新版的表现要时间摸,摸不清的时候出的图,判断起来会慢一倍。非要用,先在 B 类里挑十个 SKU 试,别碰 A 类。
三是平时按七成跑。全年满负荷,大促就没有腾挪空间。这条听着像管理口号,它决定的其实是插单能力——插单能力本身就是产能的一部分,也是少数能在当天生效的那部分。
八、还没理顺的地方
分层规格这一块,这两周是拿 Flux Art 在跑。试版和定稿能在同一个批次里切规格,省掉换一套东西重新排一遍的手工。但它换过模型之后,旧任务的参数不会跟过来,重新提交要逐项再核一遍——赶工期里这一项比平时烦。
另外两处也没解决。一处是配额的定法:现在是按日峰值反推,反推用的开关系数靠经验,没找到能推出来的算法。换一个大促节奏不同的类目,这套系数就得重估一遍。
另一处是分类边界。活动临时加场的时候,一批 B 类会突然变成 A 类,挤压的是队列三的配额。这时候借槽规则会失效——它按剩余张数判断,不认优先级突变,只能人工介入一次。这个人工口子目前还留着。
九、小结
大促的图片产能,不是靠通宵顶出来的。它靠三件平时做完的事:把图位和判定标准写成清单、把队列按截止时间分开、把缓冲留在该留的地方。
这三件平时做完,大促才有余量;平时不做,大促那两周无论加多少人,都只是在补前面欠的判断。
文中的规格与能力以各家当前页面为准。上面这些数据是在同一套条件下跑出来的,没有对任何一方单独调过参数。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号