算力、接口、散热,三件事挤进三升的机箱
原创
算力、接口、散热,三件事挤进三升的机箱
原创
用户8690294
发布于 2026-11-14 23:16:59
发布于 2026-11-14 23:16:59
在工厂车间里待过的人都有一个印象:一台设备旁边,通常还挂着两三台别的设备。工控机跑逻辑,视觉盒子跑检测,服务器跑模型,中间用交换机和串口线连起来。每一台都有自己的电源、自己的风扇、自己的操作系统。
这两年出现了一种变化:这些东西开始被塞进同一个机箱,体积和一台路由器差不多,但里面装的是能跑 30B 级模型的算力。
01 边缘算力的位置:不是云的缩小版
很多人把边缘设备理解成"小一号的云服务器",这个理解会带偏选型。
云服务器优化的是吞吐和成本:同样的卡,跑更多的请求,单位算力越便宜越好。边缘设备优化的是确定性:这台机器放在产线旁、变电站里、门店后仓,它必须能接上现场的传感器和执行器,必须在断网时继续工作,必须让一个不懂 Linux 的运维人员能重启它。
所以边缘设备的评价标准和云完全不同——不是"跑分多少",而是"能不能装进去、能不能接上、坏了多久能恢复"。
02 外形是被接口决定的
为什么这类设备的外壳总像路由器?因为接口密度决定了形态。
一个典型的边缘节点,背面往往同时挂着:5 个网口(1 个上行、4 个下行,可以做内外网隔离)、若干串口、一排凤凰端子、几根天线。凤凰端子是工业现场的通用语言,CAN、RS485、数字量输入输出、4~20mA 模拟量采集,全都从这里出。
这意味着它不需要额外的协议转换器——PLC 的 485 总线、传感器的模拟量、摄像头的网口,直接进机器。少一级转换,就少一个故障点,也少一个半夜被叫去现场的理由。
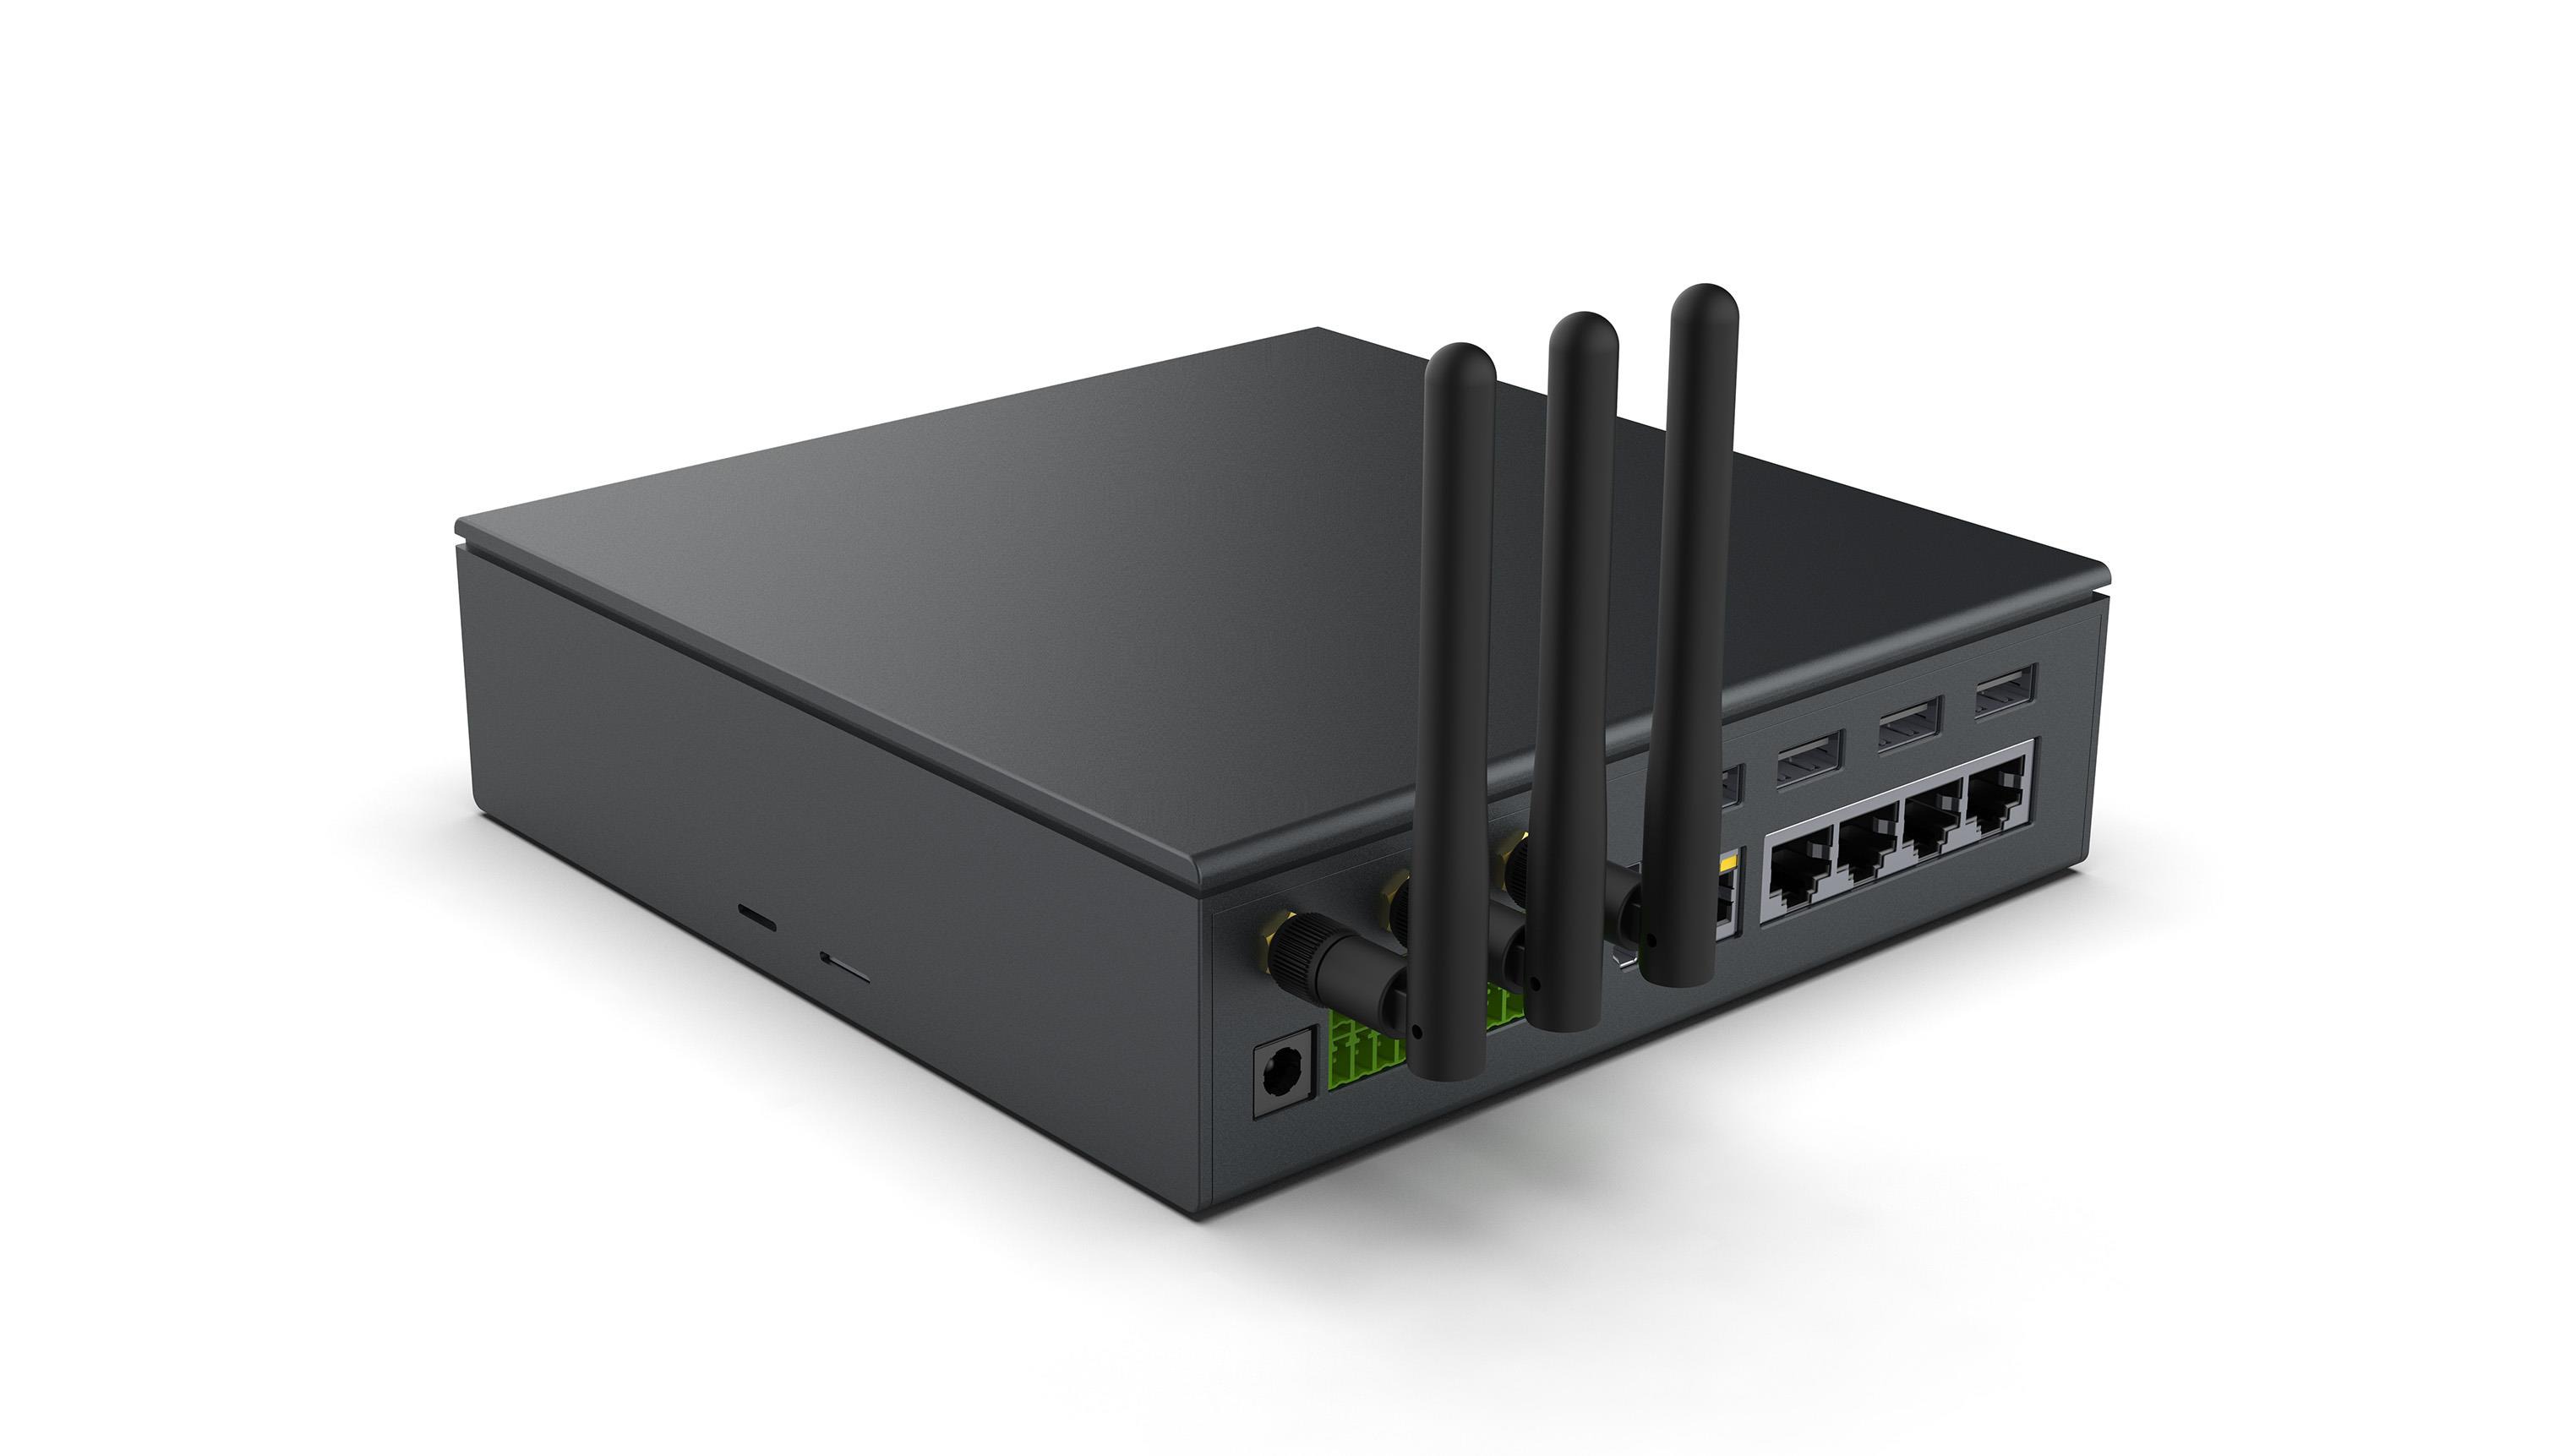
▲ 典型形态:三升左右的金属机箱,天线与网口集中在后侧
网口的分工也值得说一句。1 个 WAN 加 4 个 LAN 不是堆料,而是把"对上"和"对下"隔开:上行接企业网或 5G,下行接产线设备,两边不在同一个广播域里。做过现场的人都知道,产线设备一旦和办公网混在一起,一次广播风暴就够停产半天。
03 三升机箱里塞 45W:散热的物理账
这类设备的整机功耗通常在 45W 级别,听起来不高,但塞进三升的金属壳里,散热就成了主要设计约束。
常见的做法是整块铝壳做散热面,内部用风道把热量导向一侧,靠一到两个小风扇强制对流。纯被动散热在这个功耗级别基本不成立——除非把体积放大一倍,那就不再是"能放在产线旁"的形态了。
代价是灰尘和噪音。工业现场的粉尘会在半年内糊住鳍片,所以进风口通常要做防尘处理,机箱也要设计成可拆洗。工作温度一般标到 -10℃~55℃,这个范围不是为了好看,是因为配电室夏天能到 45℃,而北方冬天的户外机柜会到零下。
供电同理。12V 直流输入、5A 的规格,意味着可以直接从现场的直流屏取电,不必额外配 UPS 和插座。
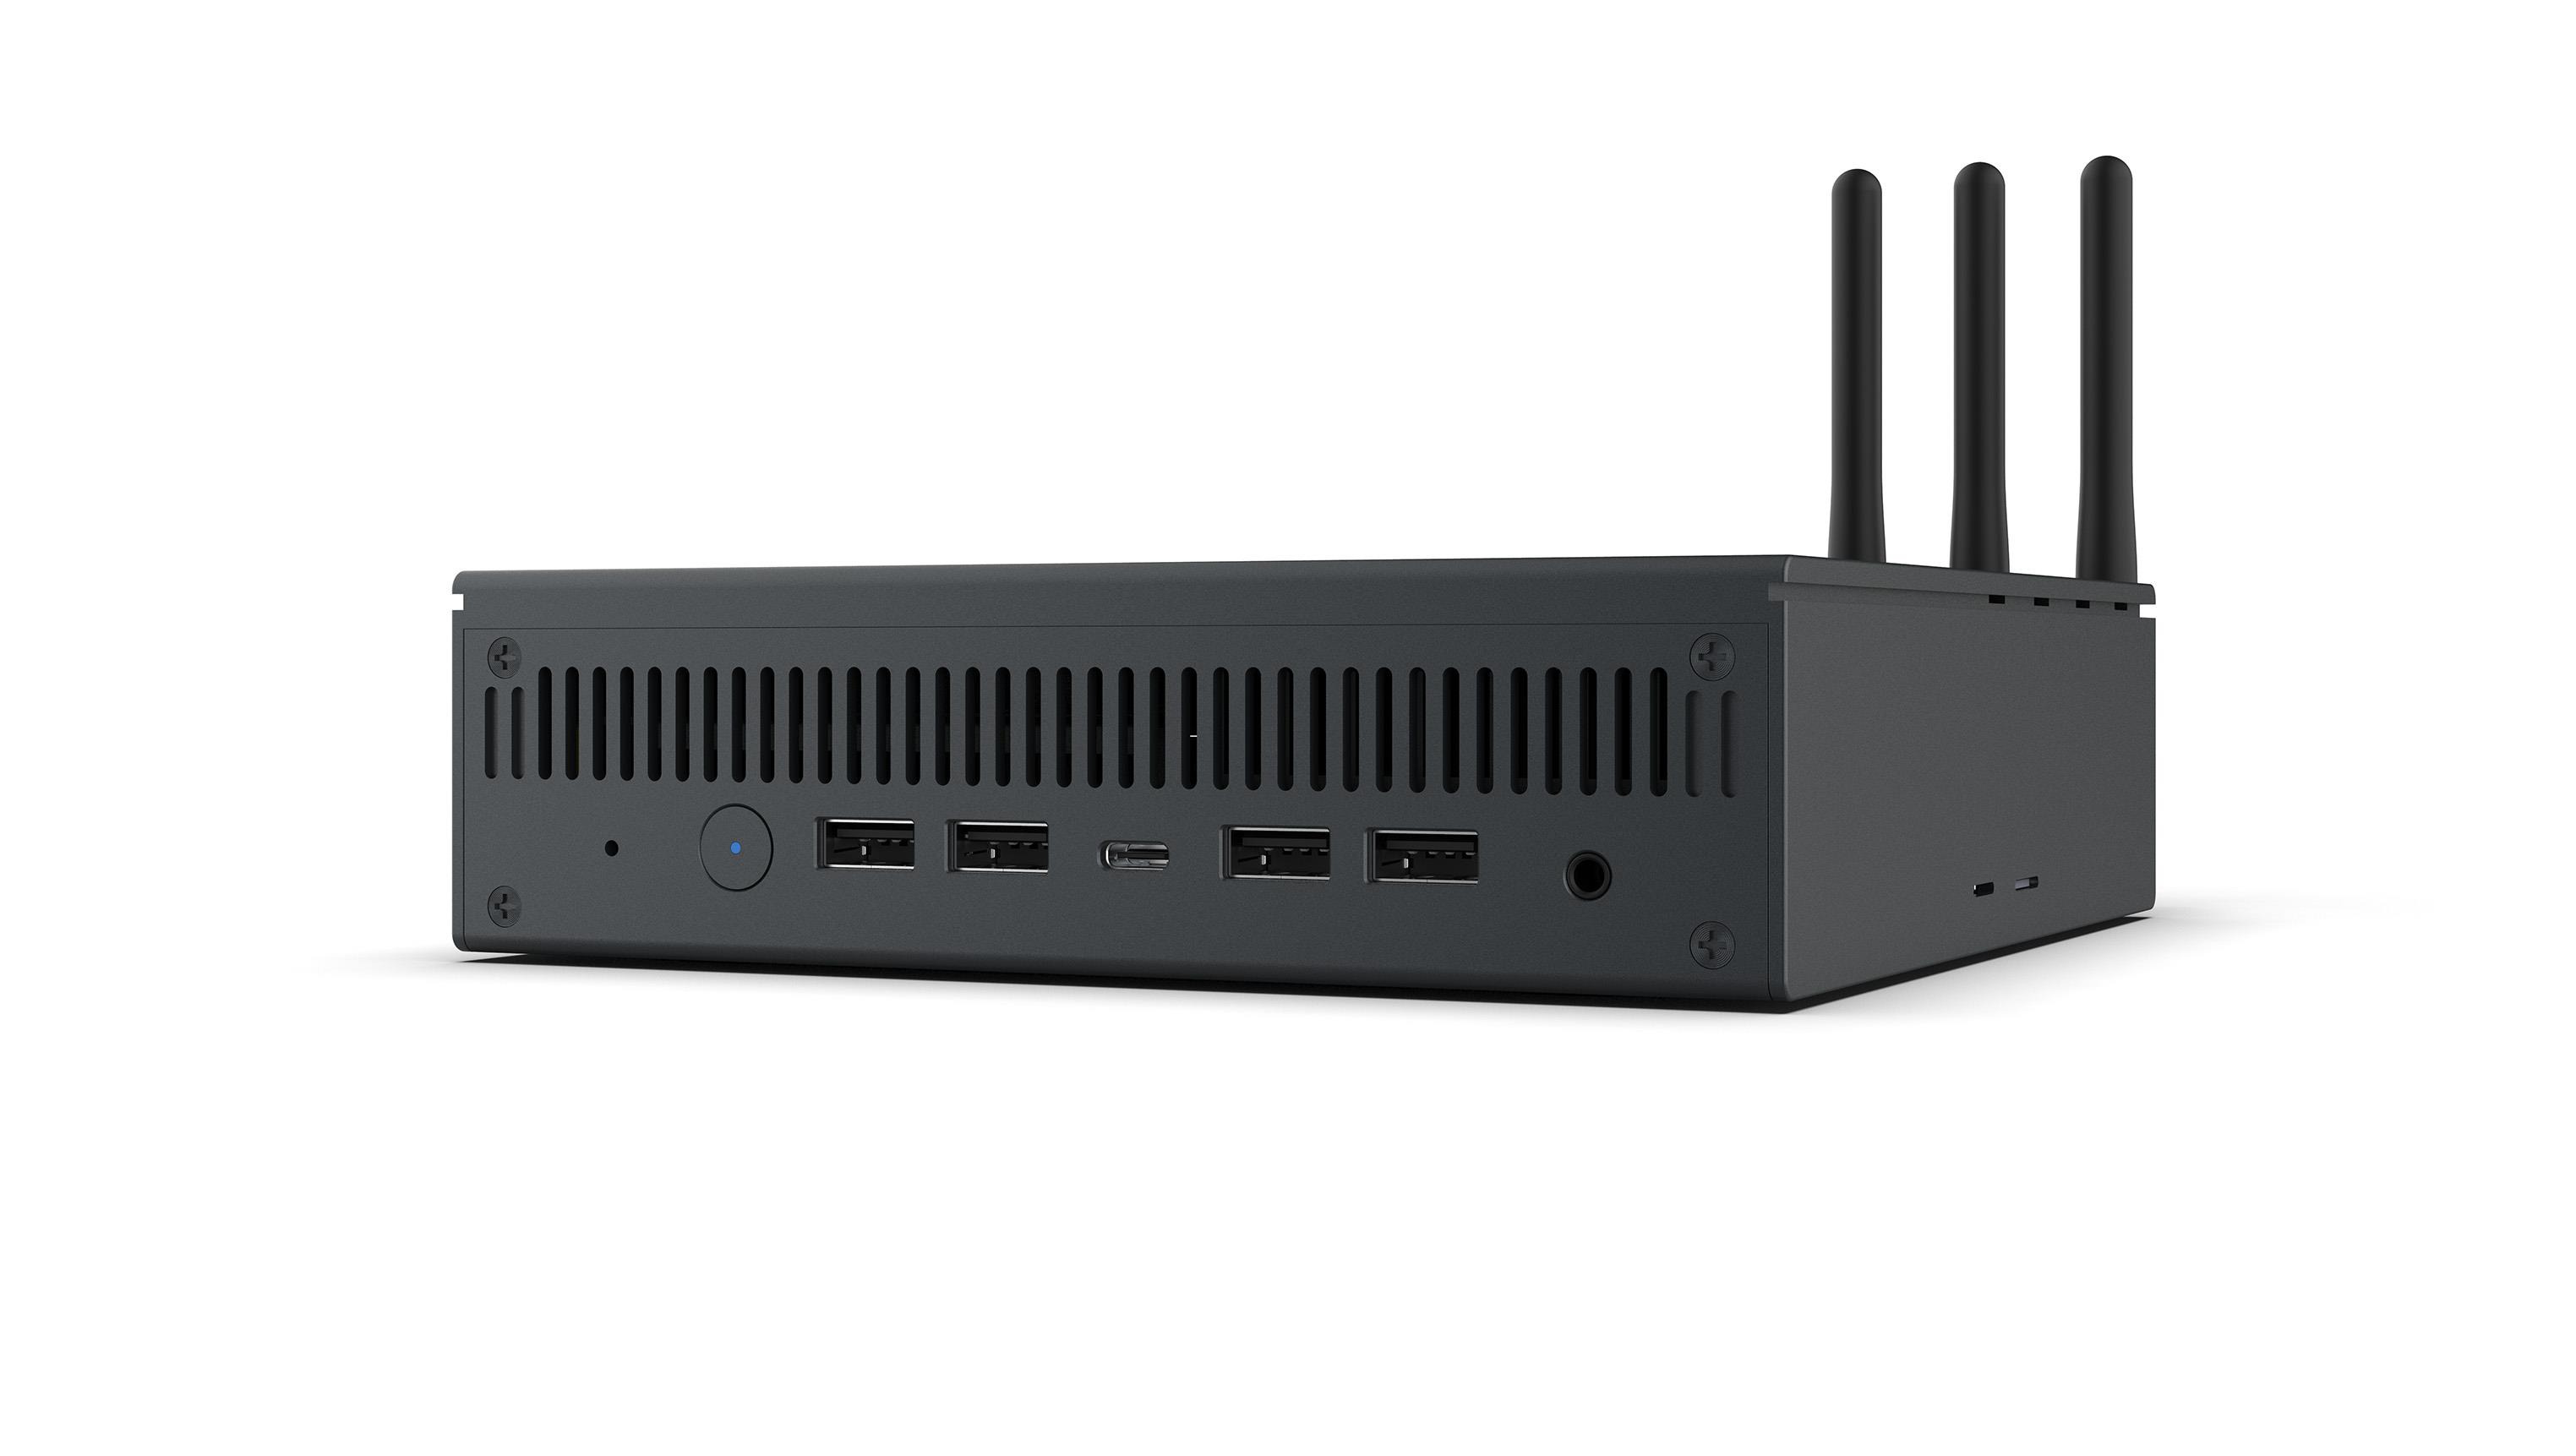
▲ 前面板:电源键、USB 3.0、Type-C 调试口与音频口,检修集中在正面
04 算力怎么配:从 20T 到 160T 的阶梯
边缘节点的算力不是越高越好,而是要和负载对上。行业内常见的分档大致是这样的:
· 20T 级:单路或少量视频的检测识别、OCR、人脸,够用且便宜
· 70T 级:4~8 路视频同时解码加推理,或者小参数量的语言模型
· 160T 级:30B 级别的语言模型、多模态文档解析,需要 24GB 以上内存配合
这里有个容易被忽略的点:**内存比算力更容易卡脖子**。一个大模型能不能跑起来,先看权重加 KV Cache 放不放得下,再看算力够不够快。所以同样是 160T 的卡,24GB 和 48GB 两个版本,能跑的模型完全不是一回事。
把算力做成可插拔模块,是这类设备近年比较普遍的设计。好处很实际:同一套机箱、同一套软件栈,低配做视觉检测,高配跑语言模型,整机厂不必为每一档算力重新开模。在模型一年一迭代的节奏下,这个设计比多几 TOPS 更有价值。
05 30B 模型放在边缘,到底能干什么
先泼一盆冷水:边缘跑大模型,不是让你在车间里和机器人聊天。
真正落地的场景都很"土":把 PDF 规格书、图纸、维修记录解析成结构化数据;把会议录音转成纪要并归档;把几年的工单做成可检索的知识库;把质检照片里的缺陷描述自动写成报告。这些任务的共同点是——数据不能出内网,而且调用频次高。
这类负载对模型的要求不是"聪明",而是"稳定"和"够快"。一个 30B 模型在 160T 级算力上,做文档解析和问答是够用的;但如果是多用户并发,就要在上下文长度、量化精度和响应时间之间做取舍。规格书上写的算力是峰值,实际体验要看实测的 token/s 和首字延迟。
06 部署位置,决定了它的全部设计
同样一台设备,放在产线旁的机架、变电站的屏柜、企业办公机房,要求完全不同。
产线旁要抗振动、抗粉尘、断电自恢复;变电站要宽温、抗电磁干扰、支持串口直连;办公机房要安静、要能进机柜、要支持远程运维。这也是为什么这类设备通常带硬件看门狗和 RTC——不是为了参数好看,而是为了让"无人值守"这件事成立。
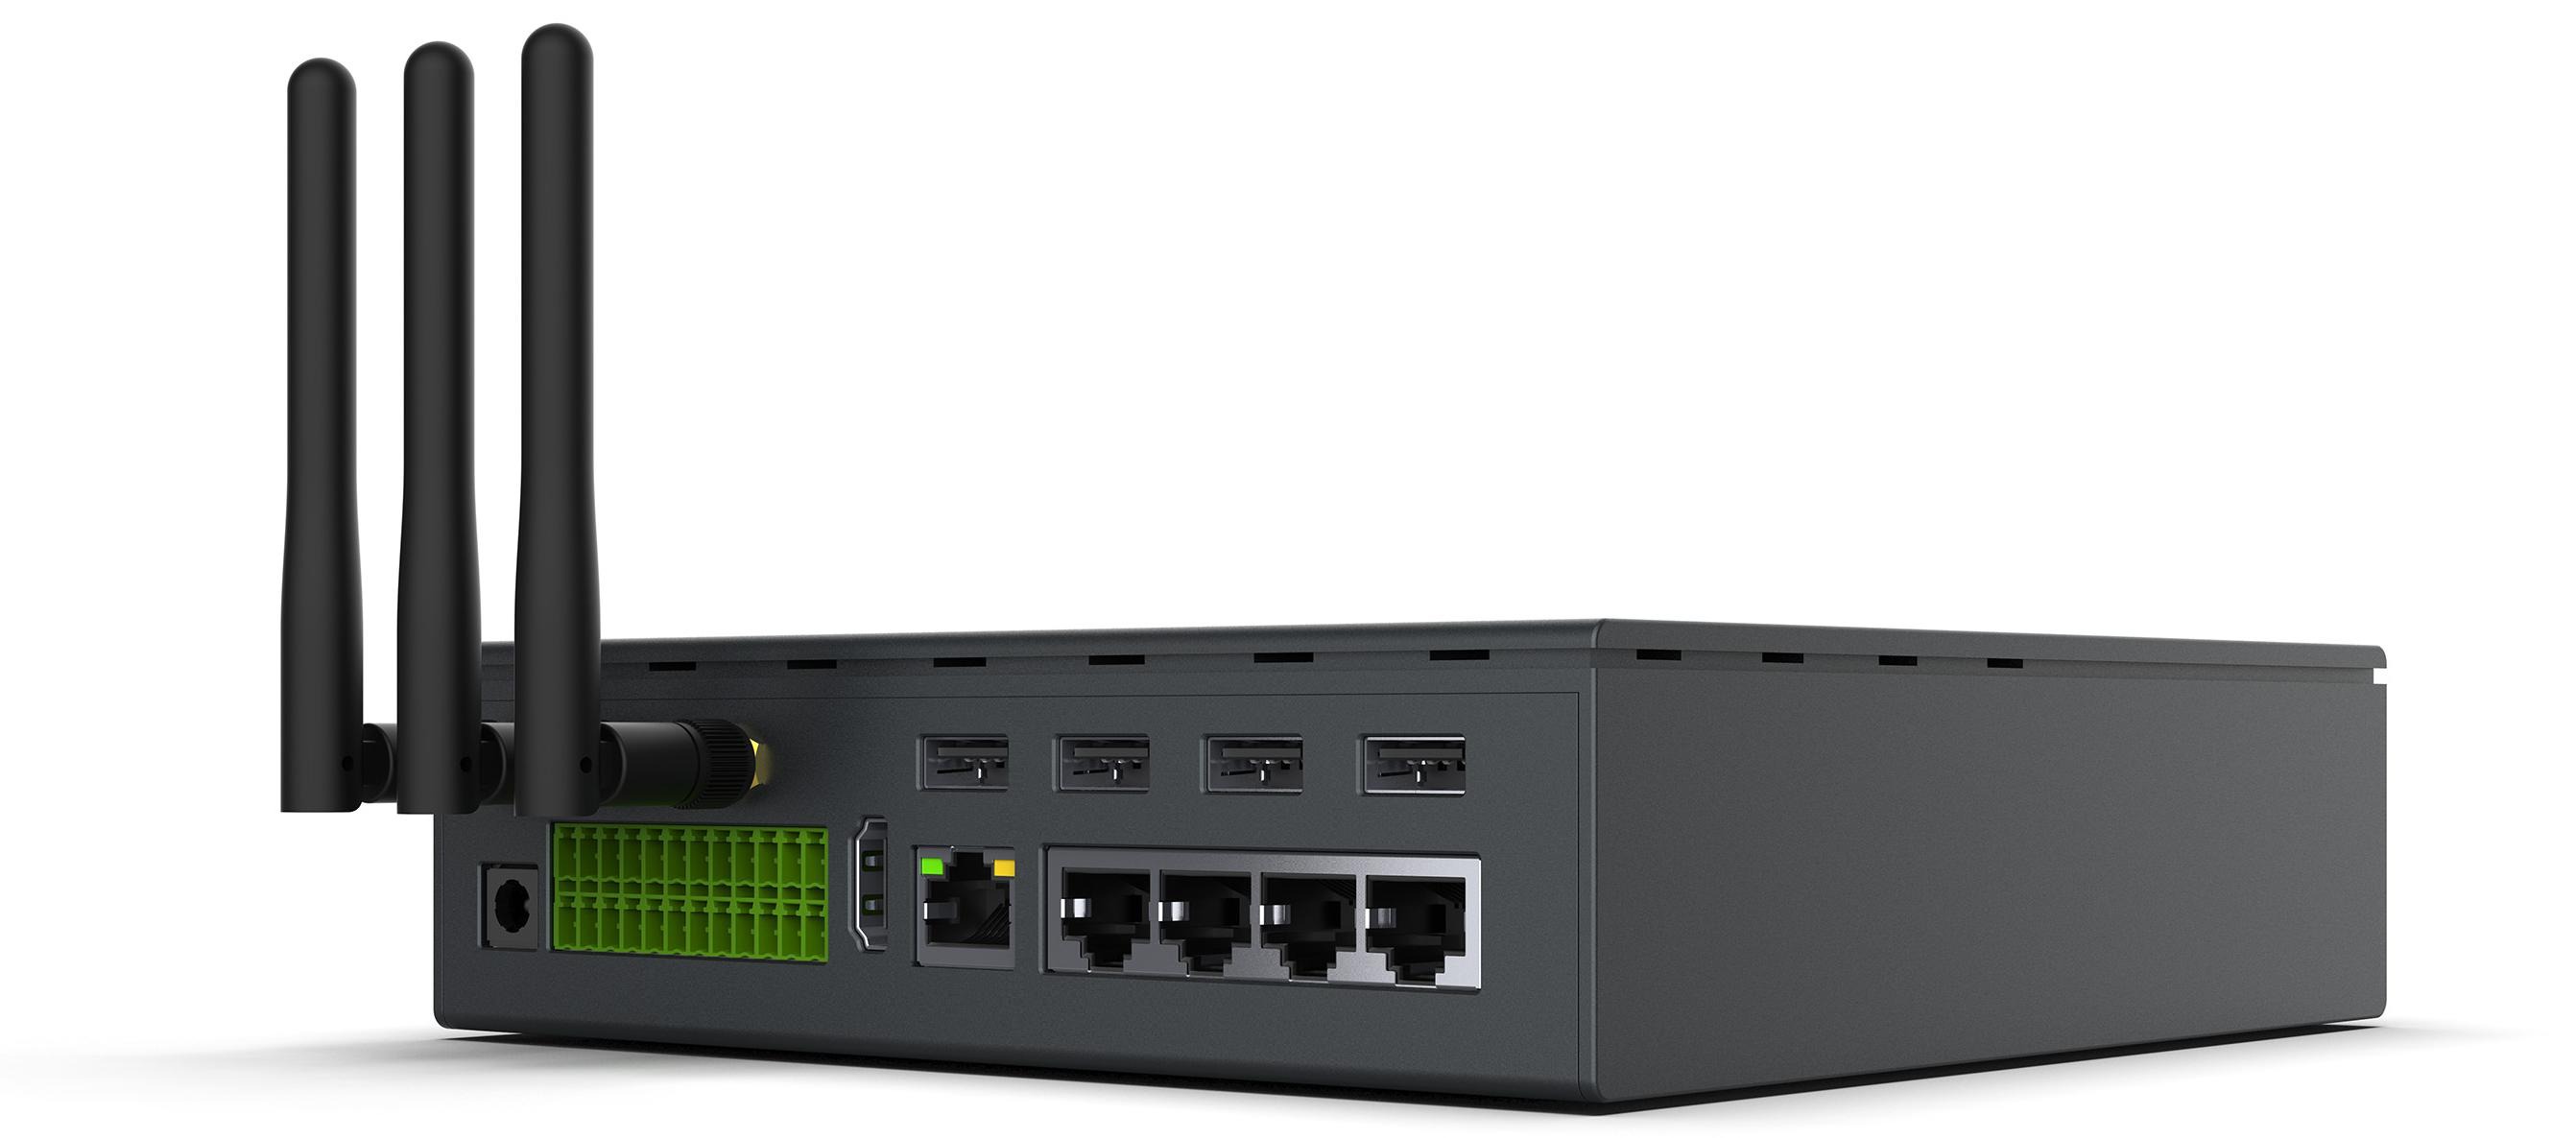
▲ 后部接口:凤凰端子引出 CAN、RS485、I/O 与模拟量采集,旁边是 5 个网口
07 三个常见的选型误区
第一,只看算力数字。峰值算力和实际吞吐之间隔着内存带宽、算子效率、框架适配三层,同一个模型在不同平台上跑,速度能差好几倍。
第二,忽略接口和协议。现场设备不会因为你买了新服务器就改成网口通信,串口和端子该有还得有,转换器越多,故障率越高。
第三,低估软件栈的迁移成本。模型能不能跑,取决于算子覆盖和工具链成熟度。选型时最好先拿自己的模型跑一遍,而不是看厂商的适配清单——清单上的模型,往往是调过的。
08 结语
边缘算力这件事,本质上是在"算力"和"现场"之间找平衡点。参数决定上限,接口决定能不能接上,散热决定能不能连续跑三年。
一台设备长得像路由器,不是设计偷懒,而是被现场的约束一点点塑造出来的结果。
你所在的项目里,边缘设备最难解决的是哪一环——算力、接口,还是现场的供电和散热?评论区聊聊。
(本文为技术观察,不构成采购建议;参数来自公开资料,具体性能以实测为准。)
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号