检索到 ≠ 答得出:用 Jev 给 RAG 知识库加一道证据闸门
原创
检索到 ≠ 答得出:用 Jev 给 RAG 知识库加一道证据闸门
原创
顺势而为
发布于 2026-11-14 23:45:34
发布于 2026-11-14 23:45:34
一封英文售后邮件进来:「新批次开门机的限位开关怎么重新标定?」知识库里同时躺着三份材料:现行版说明书、上一代产品的参数表、以及三年前一封措辞几乎一样的旧邮件。向量检索把旧参数表排在了第一位——它和提问的用词最像。生成模型照单全收,用漂亮的英文给出了一组已经废止的力矩值。
客服复核时拦下了这封回复。但问题不在客服,也不在模型「不够聪明」:系统把「最像」当成了「能答」,然后直接跳到了生成。
这是很多企业 RAG 知识库上线半年后最常遇到的那类事故。不是查不到,是查到了、却答错了,而且错得毫无破绽。今天聊一个思路不太一样的解法:在检索和生成之间,加一层只做判断、不写答案的模型——Jev。
一、RAG 的老问题:排序和可回答性,是两件事
标准 RAG 的流程大家都熟:文档切块、向量化、存进向量库;提问到来时把问题也向量化,取回 Top-k 最相近的片段,塞进上下文,交给 LLM 生成答案。讲究一点的生产系统会在中间加一个 reranker,把候选重新排个序。
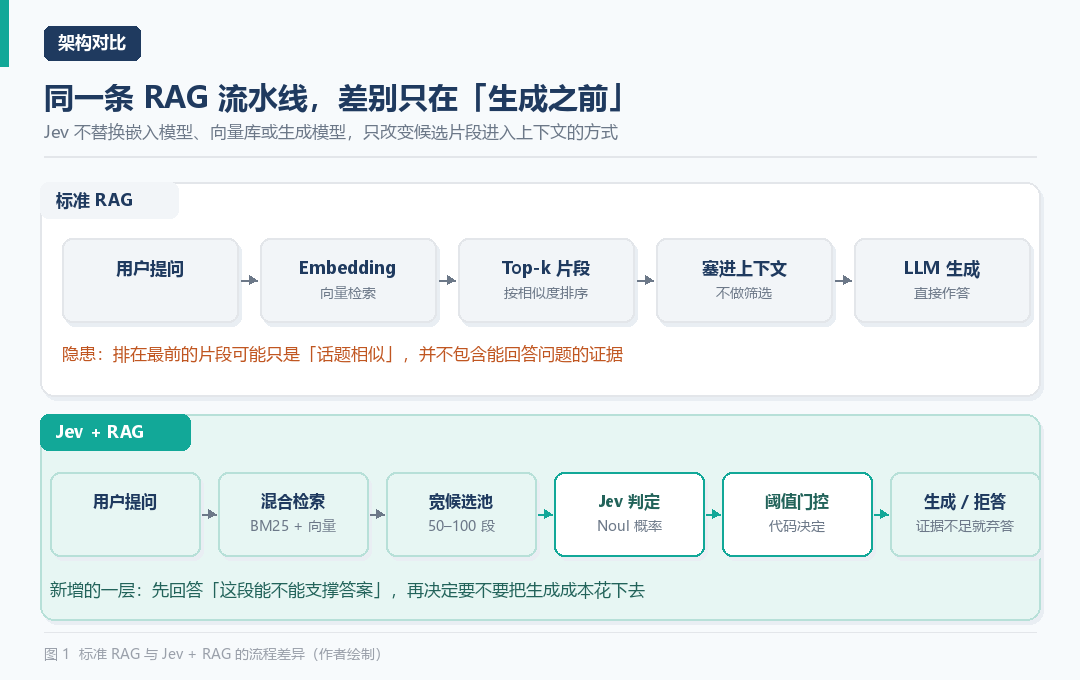
图 1 标准 RAG 与 Jev + RAG 的流程差异
问题恰恰藏在这个「排序」里。
Reranker 给出的是相对分数:它只在当前这批候选里比谁更相关。如果十个候选全都只沾了点边,第一名依然是第一名,0.84 分依然很好看。Spring AI 官方博客里有个很直观的例子:用户问「飓风 Milton 是否在佛罗里达登陆、在哪登陆」,向量检索返回六个相似度 0.54–0.84 的片段,其中四个是参考文献列表和存档链接——反复提到 Milton,却一个字也回答不了问题。
向量相似回答的是「这段文字讲什么」,而业务真正要问的是「这段文字能不能支撑答案」。这是两个不同的判定,用同一个分数混在一起,就会漏。
更麻烦的是,LLM 拿到弱证据并不会主动说「我不知道」。它倾向于把上下文补成一个流畅、合理、有出处的答案。于是企业知识库最危险的失败模式不是「没答上来」,而是「答得很像,但依据是错的」——对售后场景来说,这比不回答的代价高得多。
二、Jev 是什么:一个不生成文字的模型
Jev 是 TypeSafe AI 推出的决策模型(官方称 System One Model)。它和 ChatGPT 这类生成模型最根本的区别是:不做自回归解码,不逐字往外吐文本,只返回带校准概率的结构化判定。
它的 API 极简,只有三类原语:
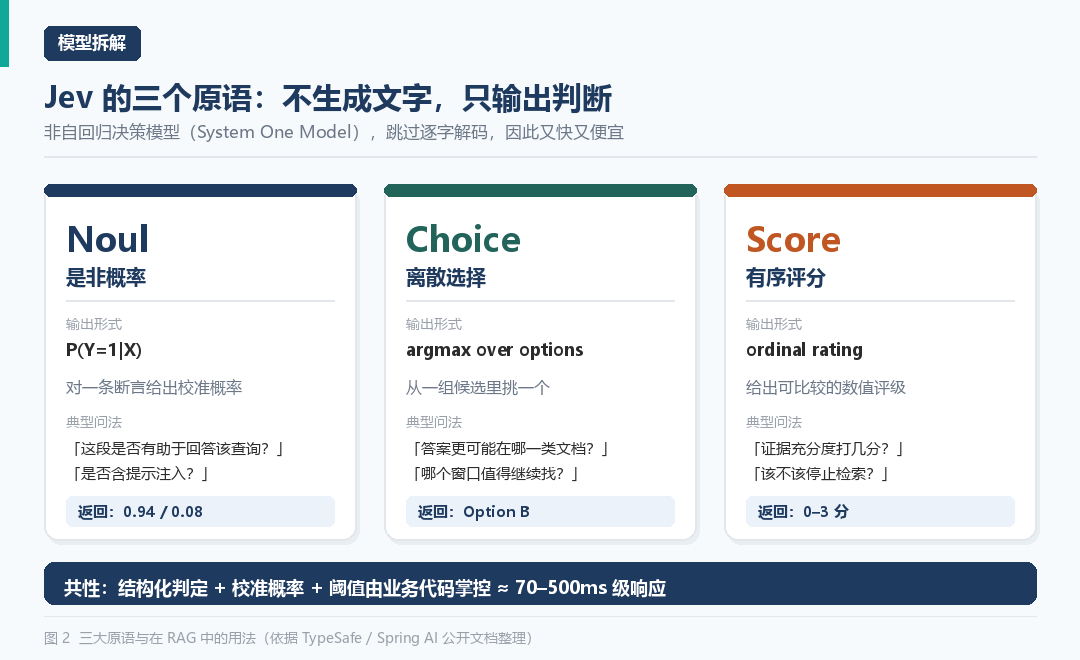
图 2 Jev 的三大原语与在 RAG 中的用法
- Noul:对一个是非断言返回概率 P(Y=1|X)。例如「这段是否有助于回答该查询」,返回 0.94 或 0.08。
- Choice:从一组离散选项里选一个。用于路由、窗口选择。
- Score:给出有序评分。用于可比较的评级。
训练上采用 RLCD(Reinforcement Learning for Calibrated Decisions),重点不是「判得对」,而是「给出的置信度和实际准确率对齐」——0.8 分的东西,真的应该大约有八成把握。这一点对后面要讲的「阈值门控」是前提:概率不可校准,阈值就只是拍脑袋。
因为跳过了逐字生成,公开资料普遍引用的口径是 70–500ms 级响应;Ragwalla 的实测文中给出的单价是 $0.042 / 百万输入 token,输出免费,读 100 个候选大约 $0.004 一次检索。这类数字会随厂商策略变化,落地前以官方价目表为准,别直接写进预算模型。
还有个容易被忽略的好处:判定标准是文本,不是冻结在权重里的规则。想把「相关」改成「相关且属于现行版本」,改一句 typed question 即可,不必重训模型。
三、把 Jev 插进 RAG:改的是「生成之前」
Jev 不替换嵌入模型、不替换向量库、也不替换生成模型。检索阶段原样保留,变化只发生在候选片段进入上下文之前:
- 宽召回:BM25 / 向量 / 混合检索取回一个较大的候选池(50–100 段),先保证答案「在池子里」。
- 批量判定:把查询作为共享状态、每个片段作为独立候选,用一句 typed question 一起问 Jev:「这段文字是否有助于回答该查询?」返回每个候选的概率。
- 阈值门控:应用代码按阈值筛掉低分片段,只把留下来的证据交给 LLM。
- 可回答性检查:同一次请求还可以判断「剩余证据是否足以作答」。不足就跳过生成,直接返回「文档中未找到」,或先触发一次检索重试。
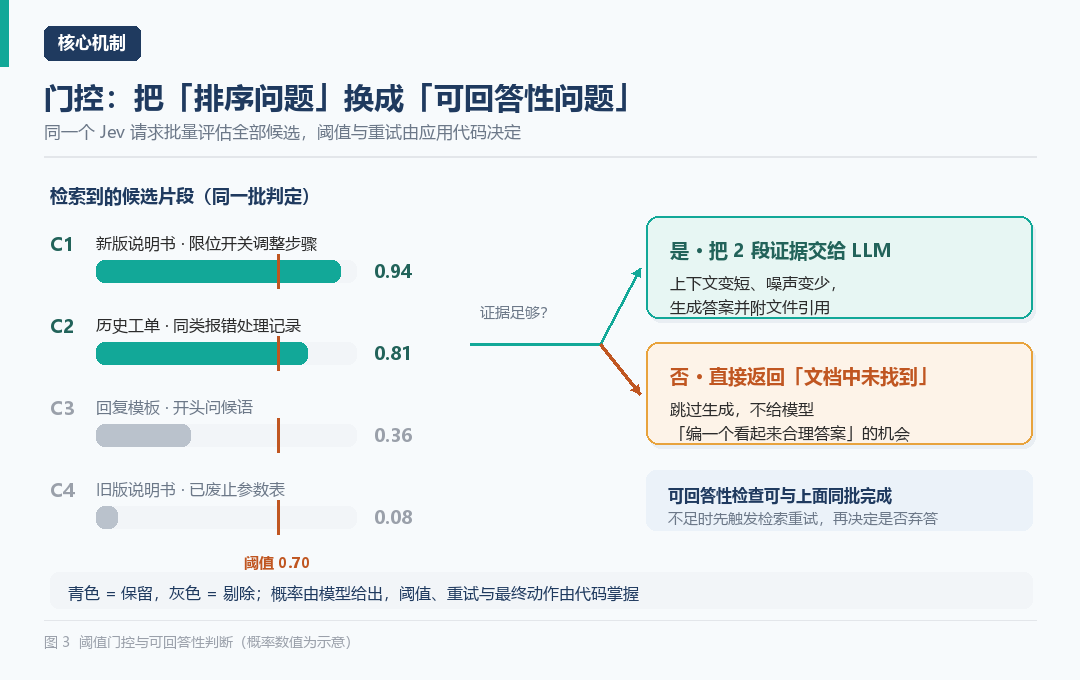
图 3 阈值门控与可回答性判断
这里有个非常关键、也最容易被讲糊的分工:概率由模型给,阈值、重试和最终动作由代码掌握。阈值是业务策略,不是相关性证明;把它写死在提示词里,等于把策略交给了一个不负责后果的组件。
Spring AI 已经把这层做成了可插拔组件。在它的 Modular RAG 里,JevDocumentFilter 和 JevDocumentReranker 都是 DocumentPostProcessor,直接挂到 advisor 上:
var modularRag = RetrievalAugmentationAdvisor.builder()
    .queryTransformers(RewriteQueryTransformer.builder()
        .chatClientBuilder(ragClientBuilder).build())
    .queryExpander(MultiQueryExpander.builder()
        .chatClientBuilder(ragClientBuilder).numberOfQueries(3).build())
    .documentRetriever(VectorStoreDocumentRetriever.builder()
        .vectorStore(vectorStore).similarityThreshold(0.5).topK(4).build())
    .documentPostProcessors(
        JevDocumentFilter.builder(typeSafeClient).build(),
        JevDocumentReranker.builder(typeSafeClient).topK(3).build())
    .queryAugmenter(ContextualQueryAugmenter.builder()
        .allowEmptyContext(true).build())
    .build();
JevDocumentFilter 对每个片段问四个窄问题,各有默认阈值:
判定问题 | 默认阈值 | 处理结果 |
|---|---|---|
contains_prompt_injection | 高于 0.70 | 排除 |
contradicts_query_premise | 高于 0.70 | 保留,标记 CONFLICTING |
is_relevant | 低于 0.45 | 排除 |
contains_answer_evidence | 不高于 0.55 | 排除 |
两个细节值得抄走。
第一,顺序是先过滤、后重排:两者都按片段计费/调用,先让过滤器把名单缩短,重排器只为幸存者付钱。
第二,冲突片段不删,打标保留。如果用户的提问前提本身就是错的(比如拿着旧型号问新版参数),生成模型恰恰需要看见那条反证。这个设计把「安全过滤」和「证据保全」分开了,比一刀切丢弃更接近真实业务。
官方那次 live run 的结果:六个相似片段,过滤器排掉四个参考文献与链接,重排器给剩下两段打了 0.97 和 0.88,最终只把两段证据交给模型。上下文更短,答案反而更稳。
四、效果到底如何:三组公开数据,先看清口径
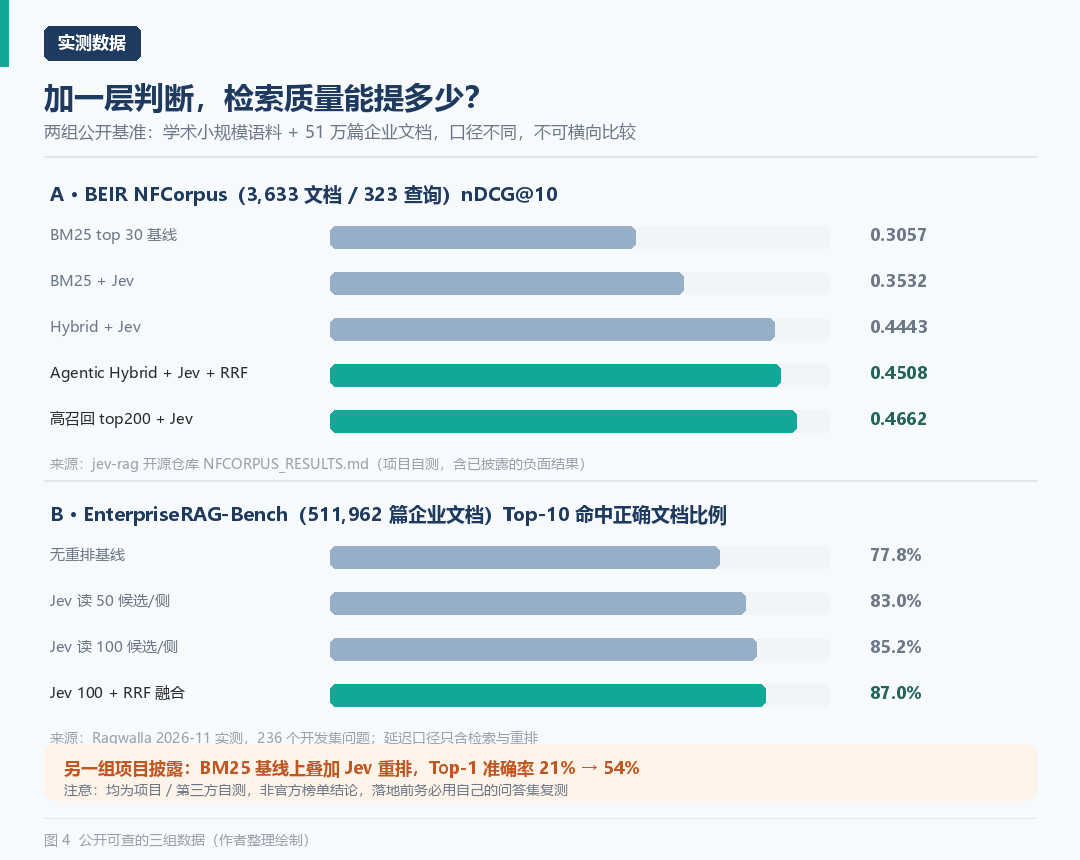
图 4 公开可查的三组数据
第一组是学术小规模语料。 开源项目 jev-rag 在完整 BEIR NFCorpus 测试集(3,633 篇文档 / 323 个查询)上公开了逐流水线结果:BM25 top30 基线 nDCG@10 为 0.3057,叠加 Jev 重排后 0.3532;Hybrid + Jev 到 0.4443;Agentic Hybrid + Jev 再做本地 RRF 融合到 0.4508;高召回 top200 配置到 0.4662。同期纯 Hybrid(不加 Jev)是 0.3967。
第二组更接近企业现场。 Ragwalla 在 EnterpriseRAG-Bench 的 511,962 篇合成企业文档、九个应用(Slack / Gmail / Confluence / Jira 等)上做了检索探针:Top-10 命中正确文档的比例,无重排 77.8%,Jev 读 50 候选/侧 83.0%,读 100 候选/侧 85.2%,Jev 100 + 倒数排名融合(RRF, k=10)到 87.0%。
这组数据里藏着两条比数字本身更重要的结论:
- 重排器要的是深度,不是广度。 该语料中 Top-10 只覆盖 72.5% 的正确文档,而 Top-50 覆盖 83.7%——答案常常就在池子里,只是没排在前面。重排器只能提升它读到的东西。同一实验里,按应用分头搜索再让 Jev 挑选的 fan-out 方案(72.8%)反而输给「一次全库搜索 + Jev 读 90 个候选」(77.7%)。
- 别把检索原来的顺序扔掉。 语义改写类问题在纯 Jev 重排下涨了 19 个点,但跨文档、跨应用的 project_related 问题掉了 14 个点——因为逐段打分会把 Top-10 塞满同一个来源。用 RRF 把 Jev 的序和检索的序融合后,留出一席给「只有检索认为好」的片段,这类问题回到 75%。
第三组是项目披露的 Top-1 准确率:BM25 基线 21%,叠加 Jev 重排后 54%。
必须说清楚边界:以上都是项目或第三方自测,不是官方榜单结论,三组的语料、指标、延迟口径都不同,不能横向比较。Ragwalla 自己也明确写了,端到端的榜单分数还无法单独归因给 Jev;开源项目甚至主动披露了两个负面结果(下面会讲)。把自测数当采购依据,是另一类「查到了但答错了」。
五、装进企业售后知识库:一条能落地的链路
把视角换回制造业售后。这个场景的特殊性在于:资料不是静态的。产品在换代、说明书在改版、历史邮件里混着已废止参数,还要穿插订单、库存查询和情绪安抚。每天几十到上百封邮件,10 多位技术支持工程师,新人要半年才能独立回复——最贵的不是回答,是判断「该信哪份资料」。
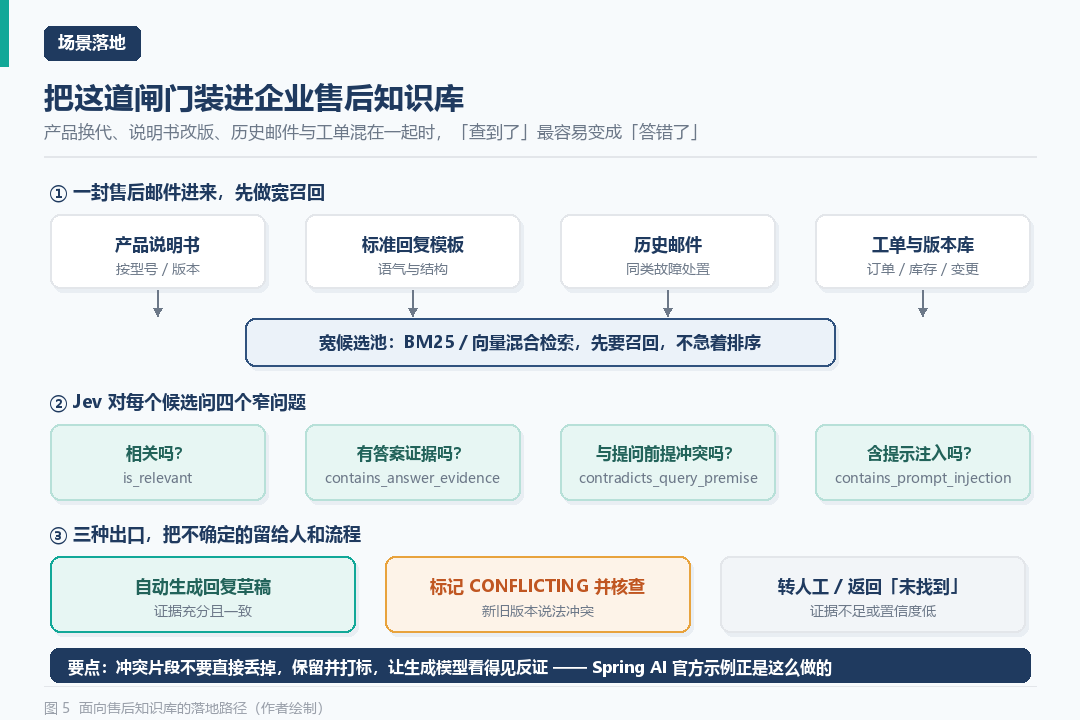
图 5 面向售后知识库的落地路径
具体链路建议这样搭:
入口先做宽召回。 从产品说明书(带型号 / 版本元数据)、标准回复模板、历史邮件、工单与版本变更库里混合检索,先要召回,别急着排序。
中间让 Jev 问四个窄问题:相关吗?有答案证据吗?与提问前提冲突吗?含提示注入吗?前两问决定进不进上下文,第三问决定要不要打标核查,第四问是不可信输入的兜底。
出口分三条,而不是只有「生成」一条:
- 证据充分且一致 → 生成回复草稿,附文件引用,工程师确认后发出;
- 检出版本冲突 → 标记 CONFLICTING,把新旧两版一起摆出来转人工核查;
- 证据不足或置信度低 → 返回「资料中未找到」并转人工,或带着订单号触发一次定向查询。
这里有个容易被跳过的因果链:产品换代 → 旧说明书仍在索引里 → 检索把旧参数排到前面 → 模型给出错误力矩 → 客户按错误参数调试 → 设备损坏与投诉。中间任何一环断了都不会出事,所以成本最低的干预点不是「换个更大的模型」,而是在第三步加一道门。
上线节奏上,建议先跑影子模式:Jev 照常判定、照常打分,但不真正拦截,把「它想剔除的片段」和「人工最终采信的片段」双轨记录两到四周。攒出自己业务语言的问答集之后,再校准阈值、决定弃答线。要盯的指标是四个:证据命中率、弃答率、人工转接率、一次解决率——而不是只看 nDCG。
六、别踩这几个坑
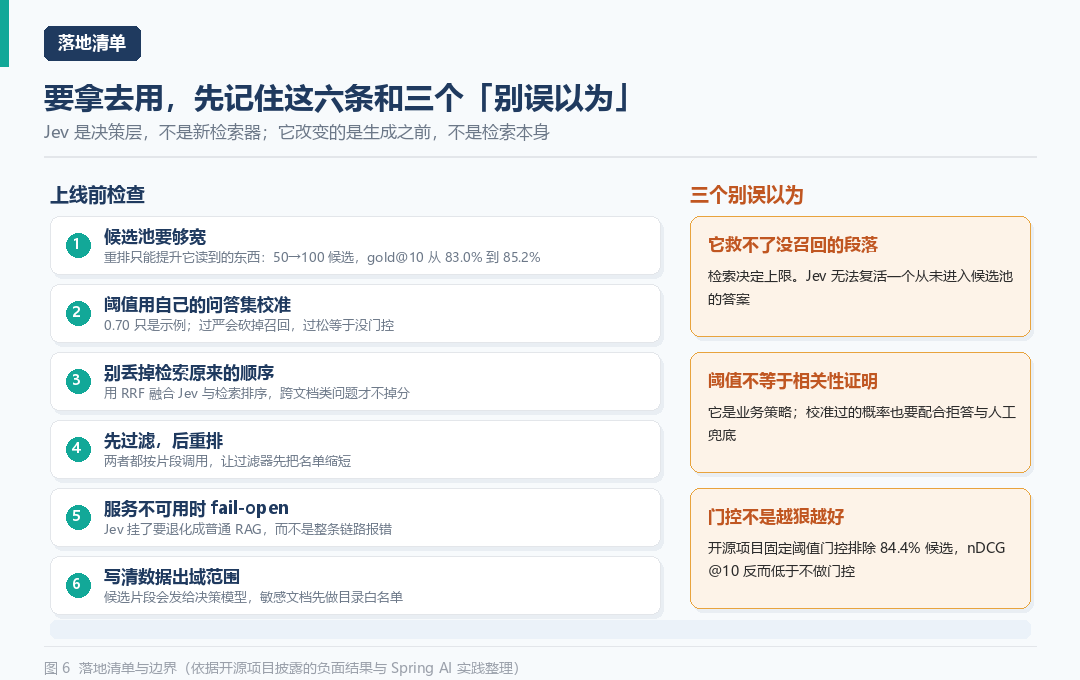
图 6 落地清单与边界
六个上线前检查项,和三个「别误以为」,都画在图 6 里。这里只展开最容易翻车的两条。
门控不是越狠越好。 jev-rag 项目公开披露了一个负面结果:用固定阈值做统一 Passage Gate,一次对每段问四个 Noul 问题,结果排除了 16,150 个候选里的 13,631 个(84.4%),nDCG@10 反而低于不做门控的纯 Hybrid(0.3967)和 Hybrid + Jev(0.4443)。项目把它保留下来做提示注入筛查,明确说明这不是质量路径。同理,Line Search 虽然首命中 nDCG@1 最高(0.5542),但全语料冷调用成本 $4.55,是实验性深搜而非默认。这些「不好看的结果」恰恰比最好看的那一行更值得读。
检索决定上限。 Ragwalla 的失败分析里,21 道三次运行全错的问题中,有 10 道是正确文档从未进入 Jev 读到的 100 个候选——提问用了「attention memory footprint」,文档写的是「KV cache footprints」。这类词法鸿沟,门控层再准也救不回来。另一类失败是近重复文档(同一动作项、不同客户与日期),两段都「能回答问题」,Jev 逐段打分分不出来,需要的是元数据或实体级的区分。
还有三条工程与合规上的常识:Spring AI 的两个 Jev 组件是 fail-open 的,服务不可用时片段会未经过滤直接通过,日志里只有一条 warning,所以要自己监控降级状态;每个组件都按片段调用,四个窄问题一次一批,延迟要实测;以及候选片段会被发送给远程决策模型,混合模式还会把文档文本发给嵌入服务——敏感资料先定目录白名单。开源实现目前是 alpha,本地 HTTP 服务默认无鉴权,别直接暴露到公网。
结语
RAG 这两年被优化得最多的,是嵌入模型、切块策略、向量库和生成模型。Jev 提供的其实是一个更朴素的视角:把「判断」从「生成」里拆出来,交给一个专门做判断、且知道自己有多大把握的模型。
它不提高检索的上限,也不替代任何一个现有组件。它只是在生成之前多问了一句:这些材料,真的够回答这个问题吗?
对企业知识库来说,肯说「资料里没有」的系统,往往比什么都能答的系统更值钱。
资料来源
- Spring AI 官方博客,Spring AI Modular RAG and TypeSafe Jev: Retrieve More, Keep Only What Answers(2026-10-02),含 JevDocumentFilter / JevDocumentReranker 阈值与 live run 结果。
- Spring AI 官方博客,Spring AI TypeSafe: Structured Judgment(2026-09-21),Noul / Choice / Score 原语与 RLCD。
- 开源项目 aifabrice/jev-rag README 与 benchmarks/NFCORPUS_RESULTS.md,MIT 许可,alpha 阶段,含七条流水线与已披露的负面结果。
- Ragwalla,Where Jev Earns Its Place in RAG: Rerank Deep, Don't Route(2026-11-07),EnterpriseRAG-Bench 511,962 篇文档实测。
- The Next Gen Tech Insider,TypeSafe AI Introduces JEV for High-Efficiency RAG and GraphRAG Optimization(2026-10-24),原语定义与 Spring AI 集成片段。
- Modular RAG: Transforming RAG Systems into LEGO-like Reconfigurable Frameworks,arXiv:2407.21059。
本文数据均来自上述公开资料,配图为作者依据公开信息绘制;概率数值与售后场景为示意。落地前请用自有语料复测。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号