用 WorkBuddy 给一个「不能改」的单文件原型加上 11 层功能
原创
用 WorkBuddy 给一个「不能改」的单文件原型加上 11 层功能
原创
用户12900346
发布于 2026-11-16 08:59:38
发布于 2026-11-16 08:59:38
去年到今年,我一直在做一件挺别扭的事:在一份一万多行、单文件的 HTML 原型上,陆续加上订阅计费、家长端、机构分级管理、训练任务闭环这些功能——而那个原型文件,从头到尾一行没改。
现在它是一个在跑的线上产品:62 套中考英语真题、13 张数据表、11 层构建时注入的功能、159 项后端契约测试全绿。整个过程中 WorkBuddy 不是帮我写了几段代码,是陪我做完了一次持续的、有边界的增量改造。
这篇把四件事写清楚:我手上有什么、我怎么配的、六轮具体怎么做的、以及五个真踩过的坑。如果你也在维护一份「别人写的、不许动的、但业务天天要加东西」的代码,这篇应该能直接拿去用。
一、输入材料:动手之前手上有什么
材料 | 当时的状态 |
|---|---|
前端原型 | 单文件 HTML,一万多行,内联 CSS + 内联 JS,没有构建、没有模块、没有测试。所有状态挂在一个顶层对象上,导航、路由、渲染全是脚本级函数。 |
硬约束 | 这份原型是定稿的设计基线,明令不许改一行。理由是视觉和交互已经被业务方验收过,动一处就要重新走一轮验收。 |
真题素材 | 六年中考英语真题,原始形态是纯文本,一套卷一个 txt,题型、题号、选项、解析混在一起,没有结构化。 |
后端 | 一个轻量 Python 服务 + SQLite,已有账号和名单,但没有任何订阅、任务、分级管理的能力。 |
真实反馈 | 家长的、老师的两类,都是口头的、零散的、互相矛盾的。比如家长要「能看见」,老师要「能派活」,这两件事在数据模型上根本不是一个东西。 |
这里面最关键的不是素材多少,是那条硬约束。它把问题从「怎么写」变成了「写在哪」——这一步想错,后面全是返工。
二、WorkBuddy 配置:把约束写在每次对话的第一段
我用的是 Agent 模式(能读写文件、能跑命令的那种)。模式本身没什么可说的,真正决定成败的是三件配置上的事。
1. 把不可协商的约束固定成一句话,每轮开头重复。
我用的是「原型 index.html 一行不改,所有功能通过注入层和后端接口实现」。这句话我几乎每轮都会复述一遍。听起来很笨,但 AI 的上下文会随对话变长而漂移,你不重复,它第三轮就开始「顺手帮你优化一下原型」了。
2. 要求它先核实、再动手。
我给自己定了一条:凡是「产品支持不支持某个卖点」这类判断,必须先去代码里找到依据,再回答。这条救过很多次。有一次我要对外讲四个功能点,让它逐条核实,结果四条全都有代码支撑,但它同时指出了一个我原本准备写成「每个词都有真题原句」的说法——实际是实现里有个兜底分支,找不到原句会换题型补足。如果那句写出去,家长一用就穿帮。
3. 验收标准前置:能跑测试的,不靠眼看。
我要求每一层功能都配一个可重复执行的验收:后端写契约测试(起临时服务、临时库,跑完删掉),前端写一个静态验收页,用无头浏览器加载进去逐项断言,最后把结果写进 document.title,脚本读标题就知道过没过。这个做法后面救了两次命,第五节会讲。
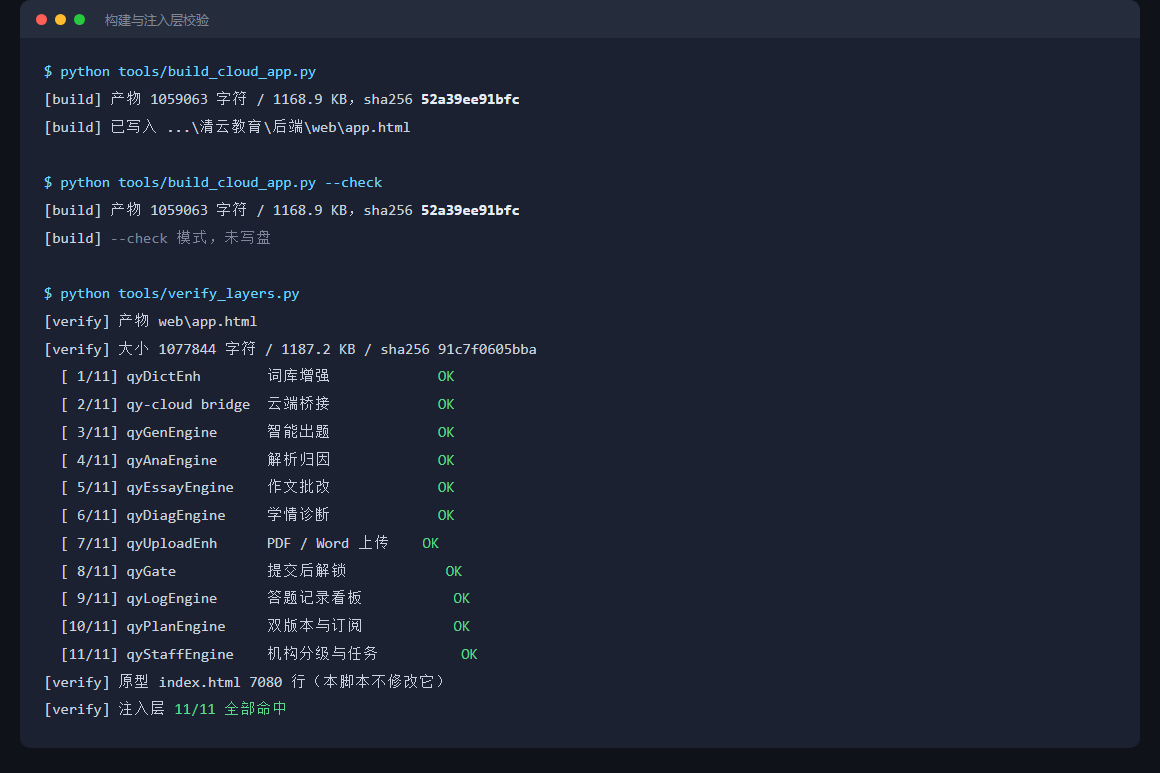
图1 构建与注入层校验
图1:每层功能在构建时按固定顺序内联进单文件产物;独立校验脚本逐个复核 11 层标记,缺失即非零退出,构建不会「看起来成功」。
三、操作步骤:六轮,每轮一个真实需求
「注入层」这个词听着玄,做法其实很土:不改原型,而是在构建时按顺序把独立的功能脚本内联到产物里,每层脚本在运行时去包装原型已有的函数和状态写入点。下面六轮按真实顺序走。
第 1 轮:把真题搬上来。
原始素材是六年纯文本,我先让它把 txt 结构化成 JSON——一套卷一个对象,含年份、题型、题号、题干、选项、答案、解析、正文。然后写一个重建脚本,从源头 txt 生成题库 JSON,前端只读这一份产物。关键是单向依赖:只允许 txt 生成 JSON,不允许手改 JSON,否则下次重建就覆盖没了。这一轮跑完,62 套卷全部可练。
第 2 轮:交卷之前不给讲解。
产品上这是个反常规设计:答案、解析、划词查词,全部锁在「交卷」这个动作之后。技术上就是包一层状态机——在原型的状态对象上记录当前是否已提交,然后包装渲染函数,未提交时把查词入口屏蔽掉,并在页面顶部挂一条状态条,四态切换(未作答/作答中/已提交/已批改)。这一轮只用了一个注入文件,原型零改动。
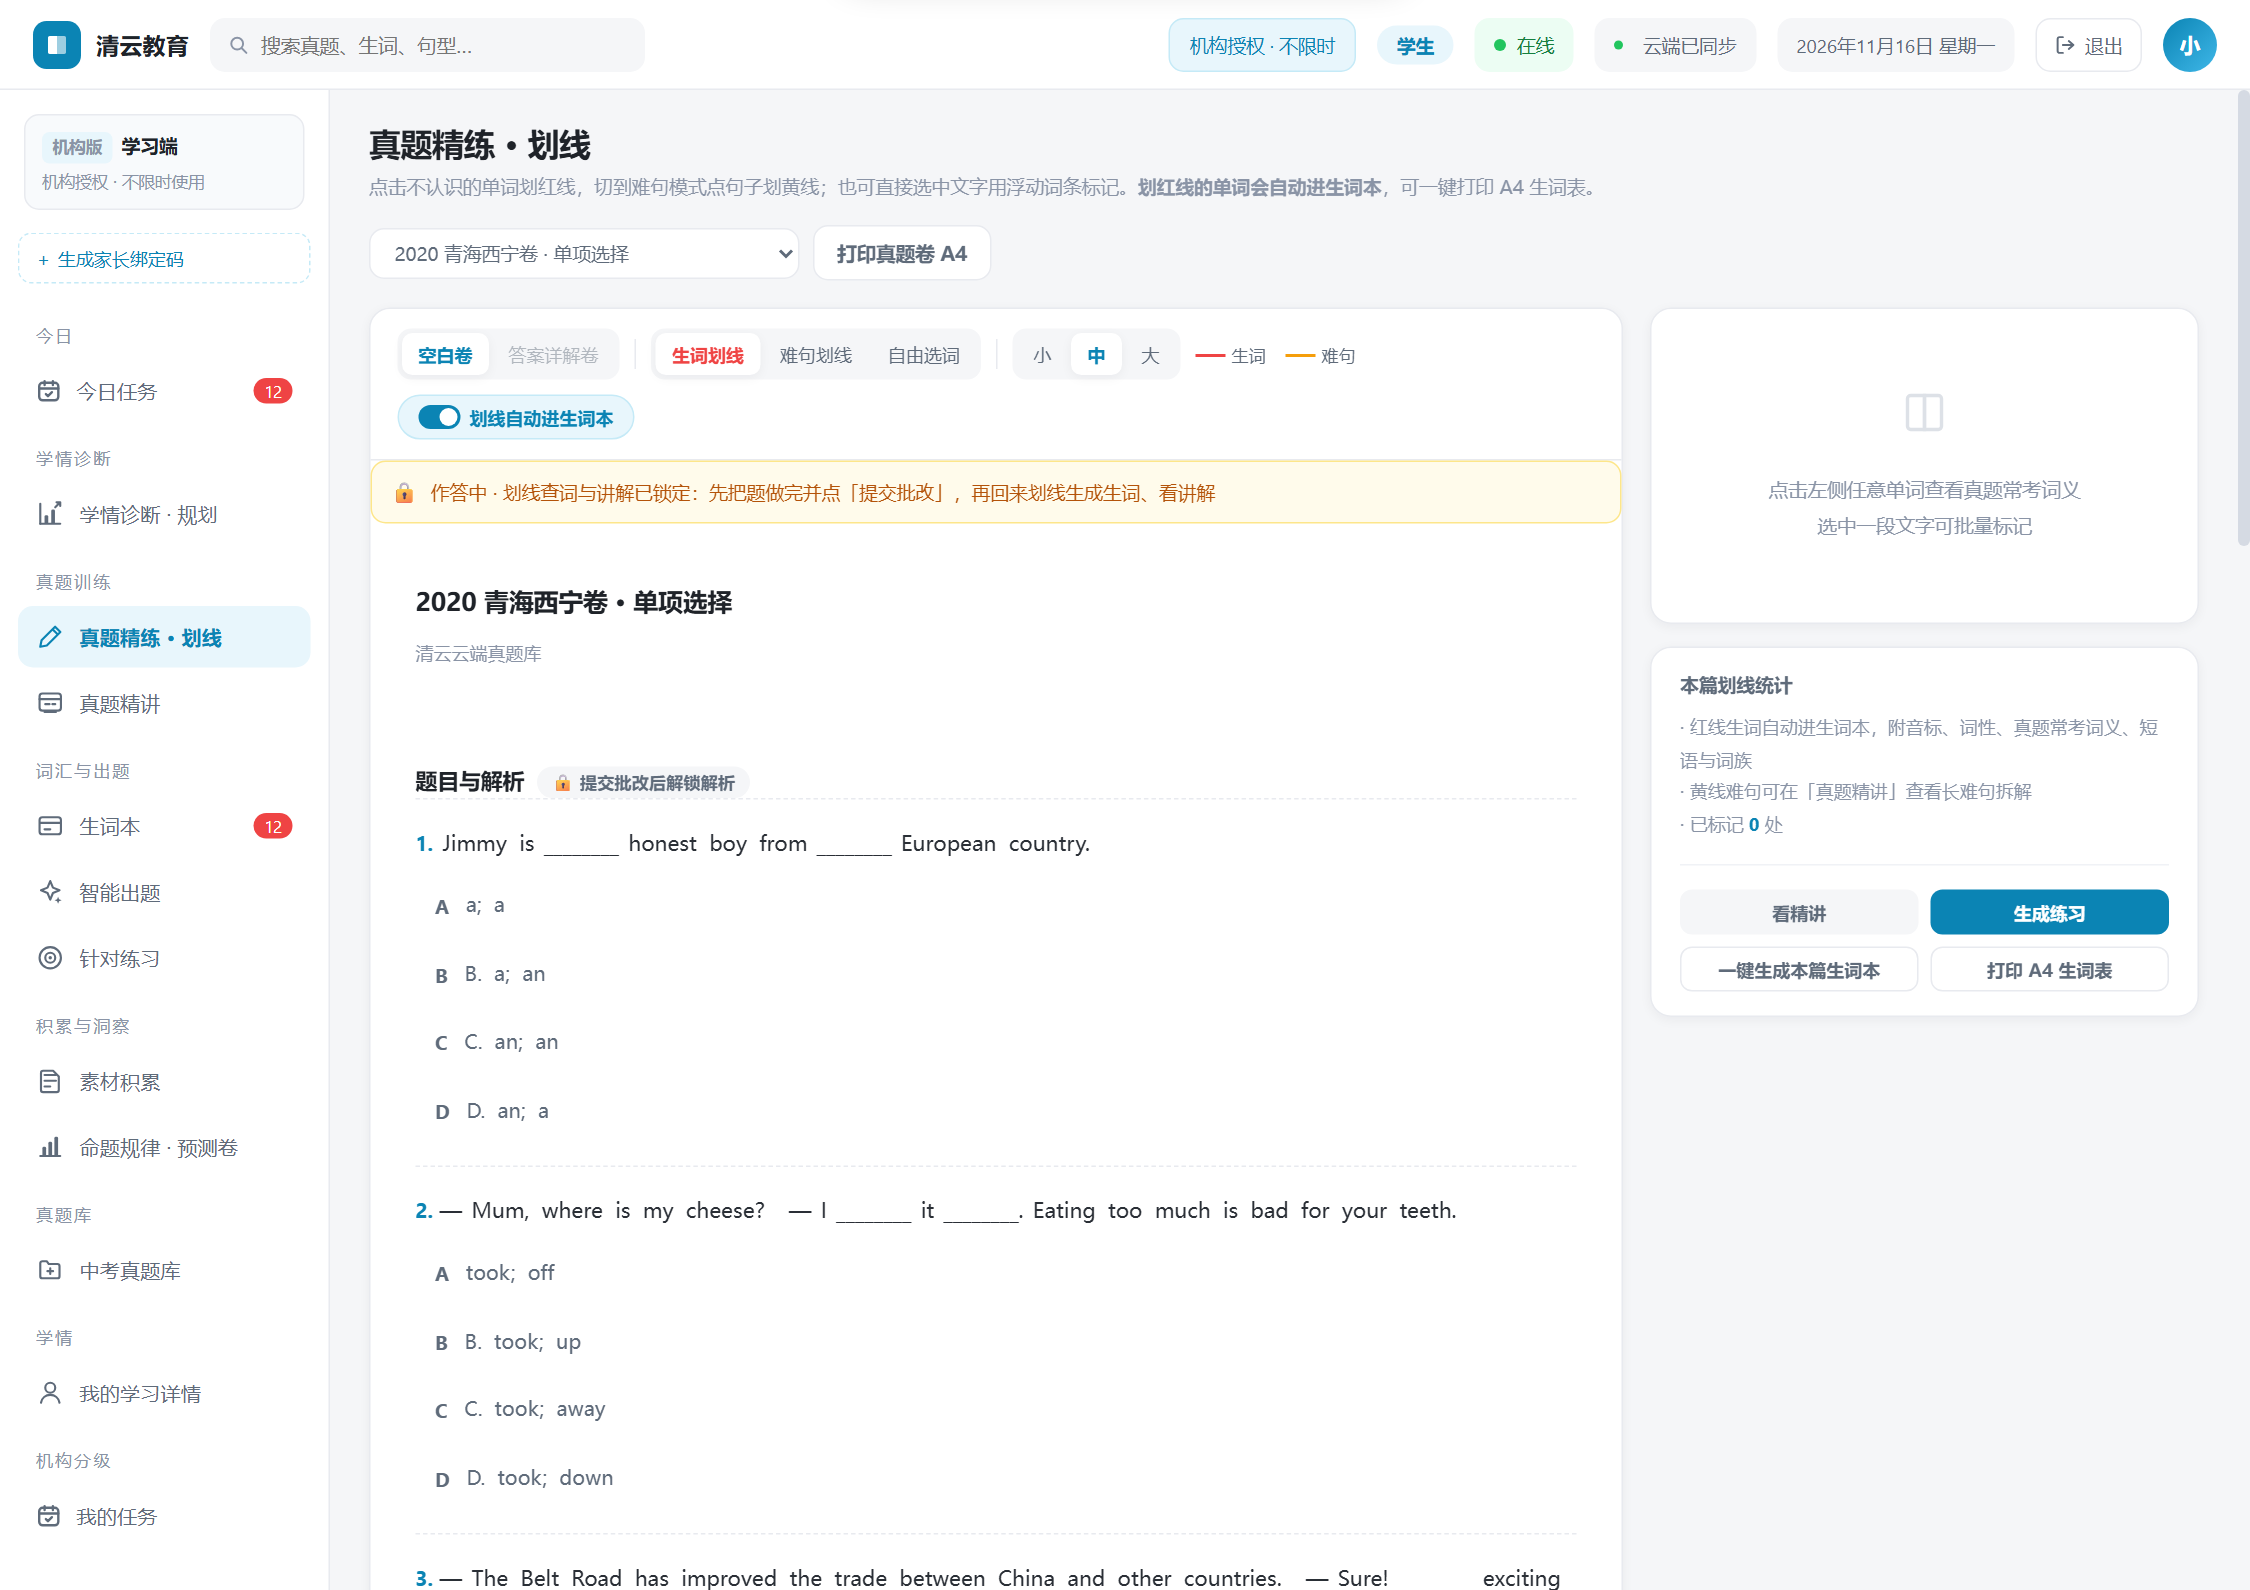
图2 作答中锁态
图2:作答中,答案解析、划词、讲解入口全部锁着;顶部状态条写明「先把题做完并点提交批改」,右上角解析区标着「提交批改后解锁」。
第 3 轮:作文拍照、PDF 和 Word 上传。
两个技术选择值得说。拍照识别用自托管的 OCR(wasm 版),不上传图片、不调外部服务,识别结果只填进校对框,不自动提交——因为手写稿识别率不可能 100%,直接拿去批改等于把错误放大。上传解析纯浏览器端做:docx 用 DecompressionStream 解 zip 再抽 XML 文本;PDF 用懒加载的 pdf.js 抽文字层。扫描版 PDF 抽不出文字层,就明确提示改用拍照或粘贴,不假装能识别。
第 4 轮:双版本 + 服务端硬拦截。
需求是「机构版」和「家庭自用版」两条线,家庭版走订阅制,前七天不计费,到期后必须有有效订阅。这里我踩了一个典型的设计错:第一版只在服务端算了倒计时,接口层没拦,前端弹个提示就完了。结果是改本机时间、或者直接调接口,照样能用——这种「假锁」上线等于没有。改成在请求分发入口统一拦截,到期账户的所有写入型接口直接返回 402,前端只负责显示。
第 5 轮:四级角色链。
管理员建机构和机构负责人 → 负责人建老师、分配学生 → 老师给名下学生布置任务 → 学生做完。这里有两个决定后来证明是对的:一是范围由服务端算,不由前端传(老师只能看到自己名下,负责人看本机构,管理员看全网,靠一个作用域 SQL 拼条件,前端传什么参数都不影响边界);二是新账号手机号即账号 + 一次性初始密码,首次登录强制改密,未改密期间服务端对所有业务接口返回 428,只放行登录、改密和启动必需的几个只读接口。
第 6 轮:任务闭环,做到「交卷即完成」。
最后一轮最难的不是建表,是怎么判断学生真的完成了老师布置的那一项。我的做法是双保险:点「一键开练」时把任务标识和关键参数写进会话存储,交卷时精确匹配;匹配不到再退到服务端按类型、卷号、板块兜底匹配。同时区分完成来源(交卷自动/学生自己标记/老师确认),避免「老师以为布置了、学生以为做了」这种扯皮。
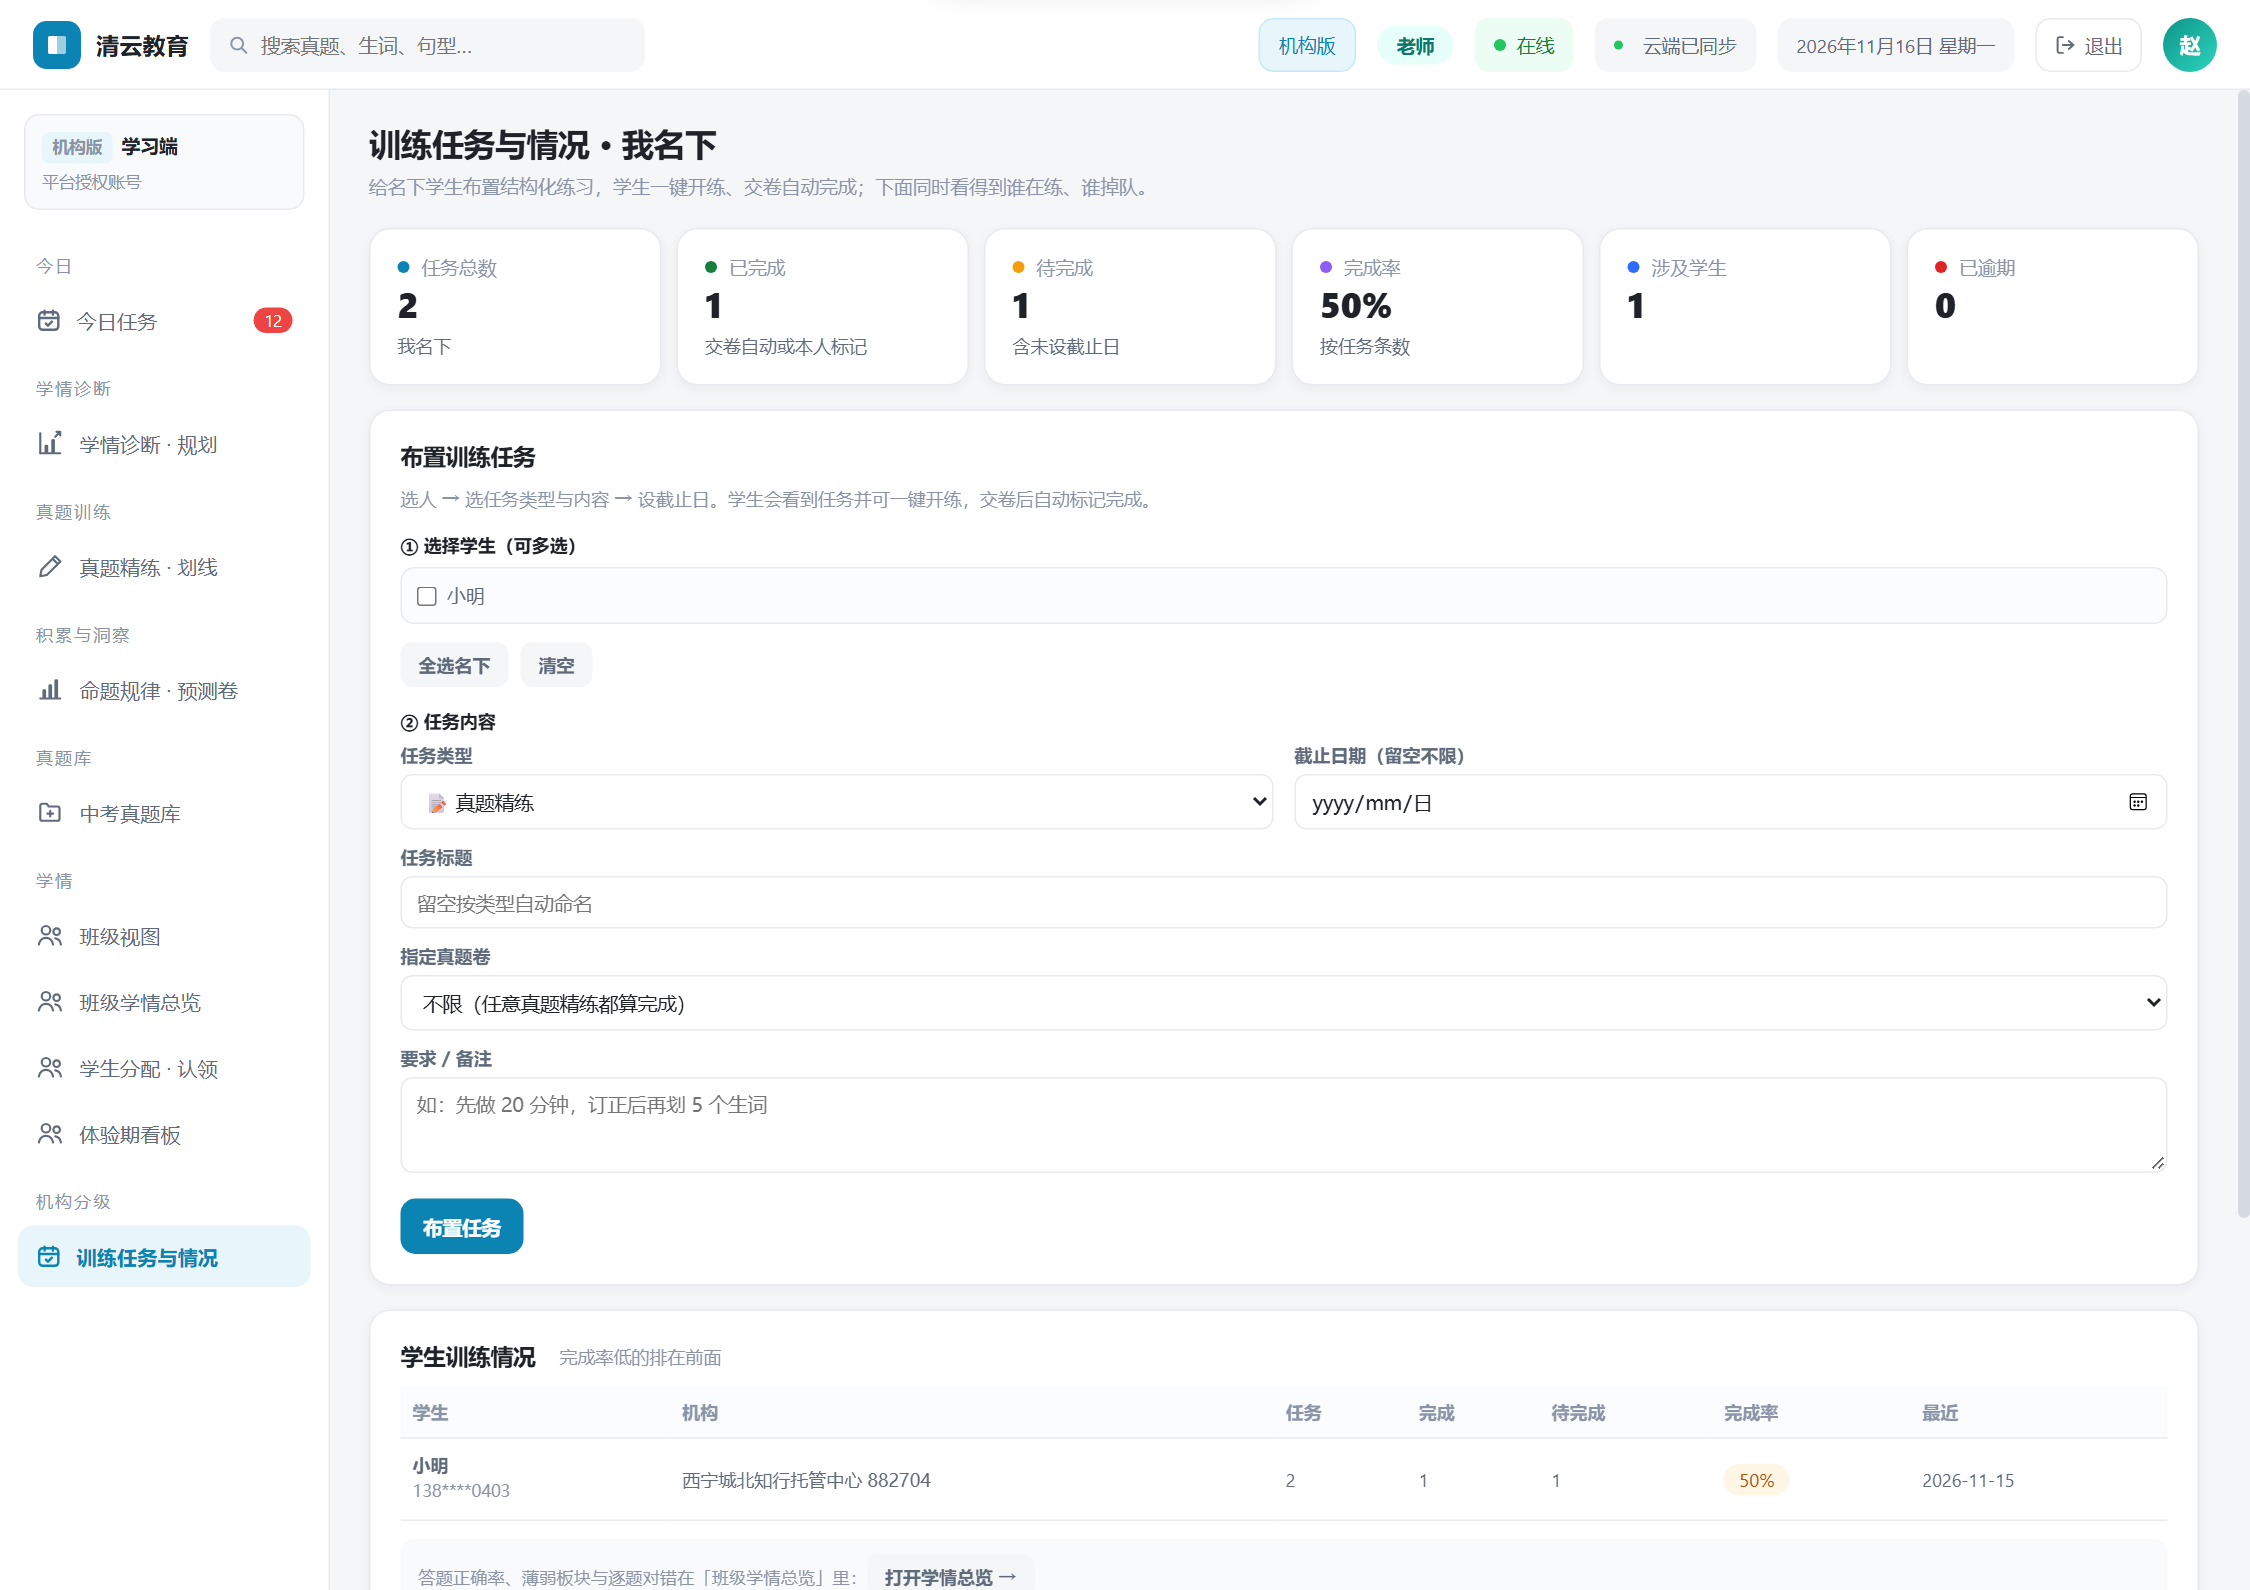
图3 老师布置训练任务
图3:一条任务 = 一个学生的一项练习,六种类型;下方同时给出每个学生的任务数、完成数、完成率,掉队的排在最前面。
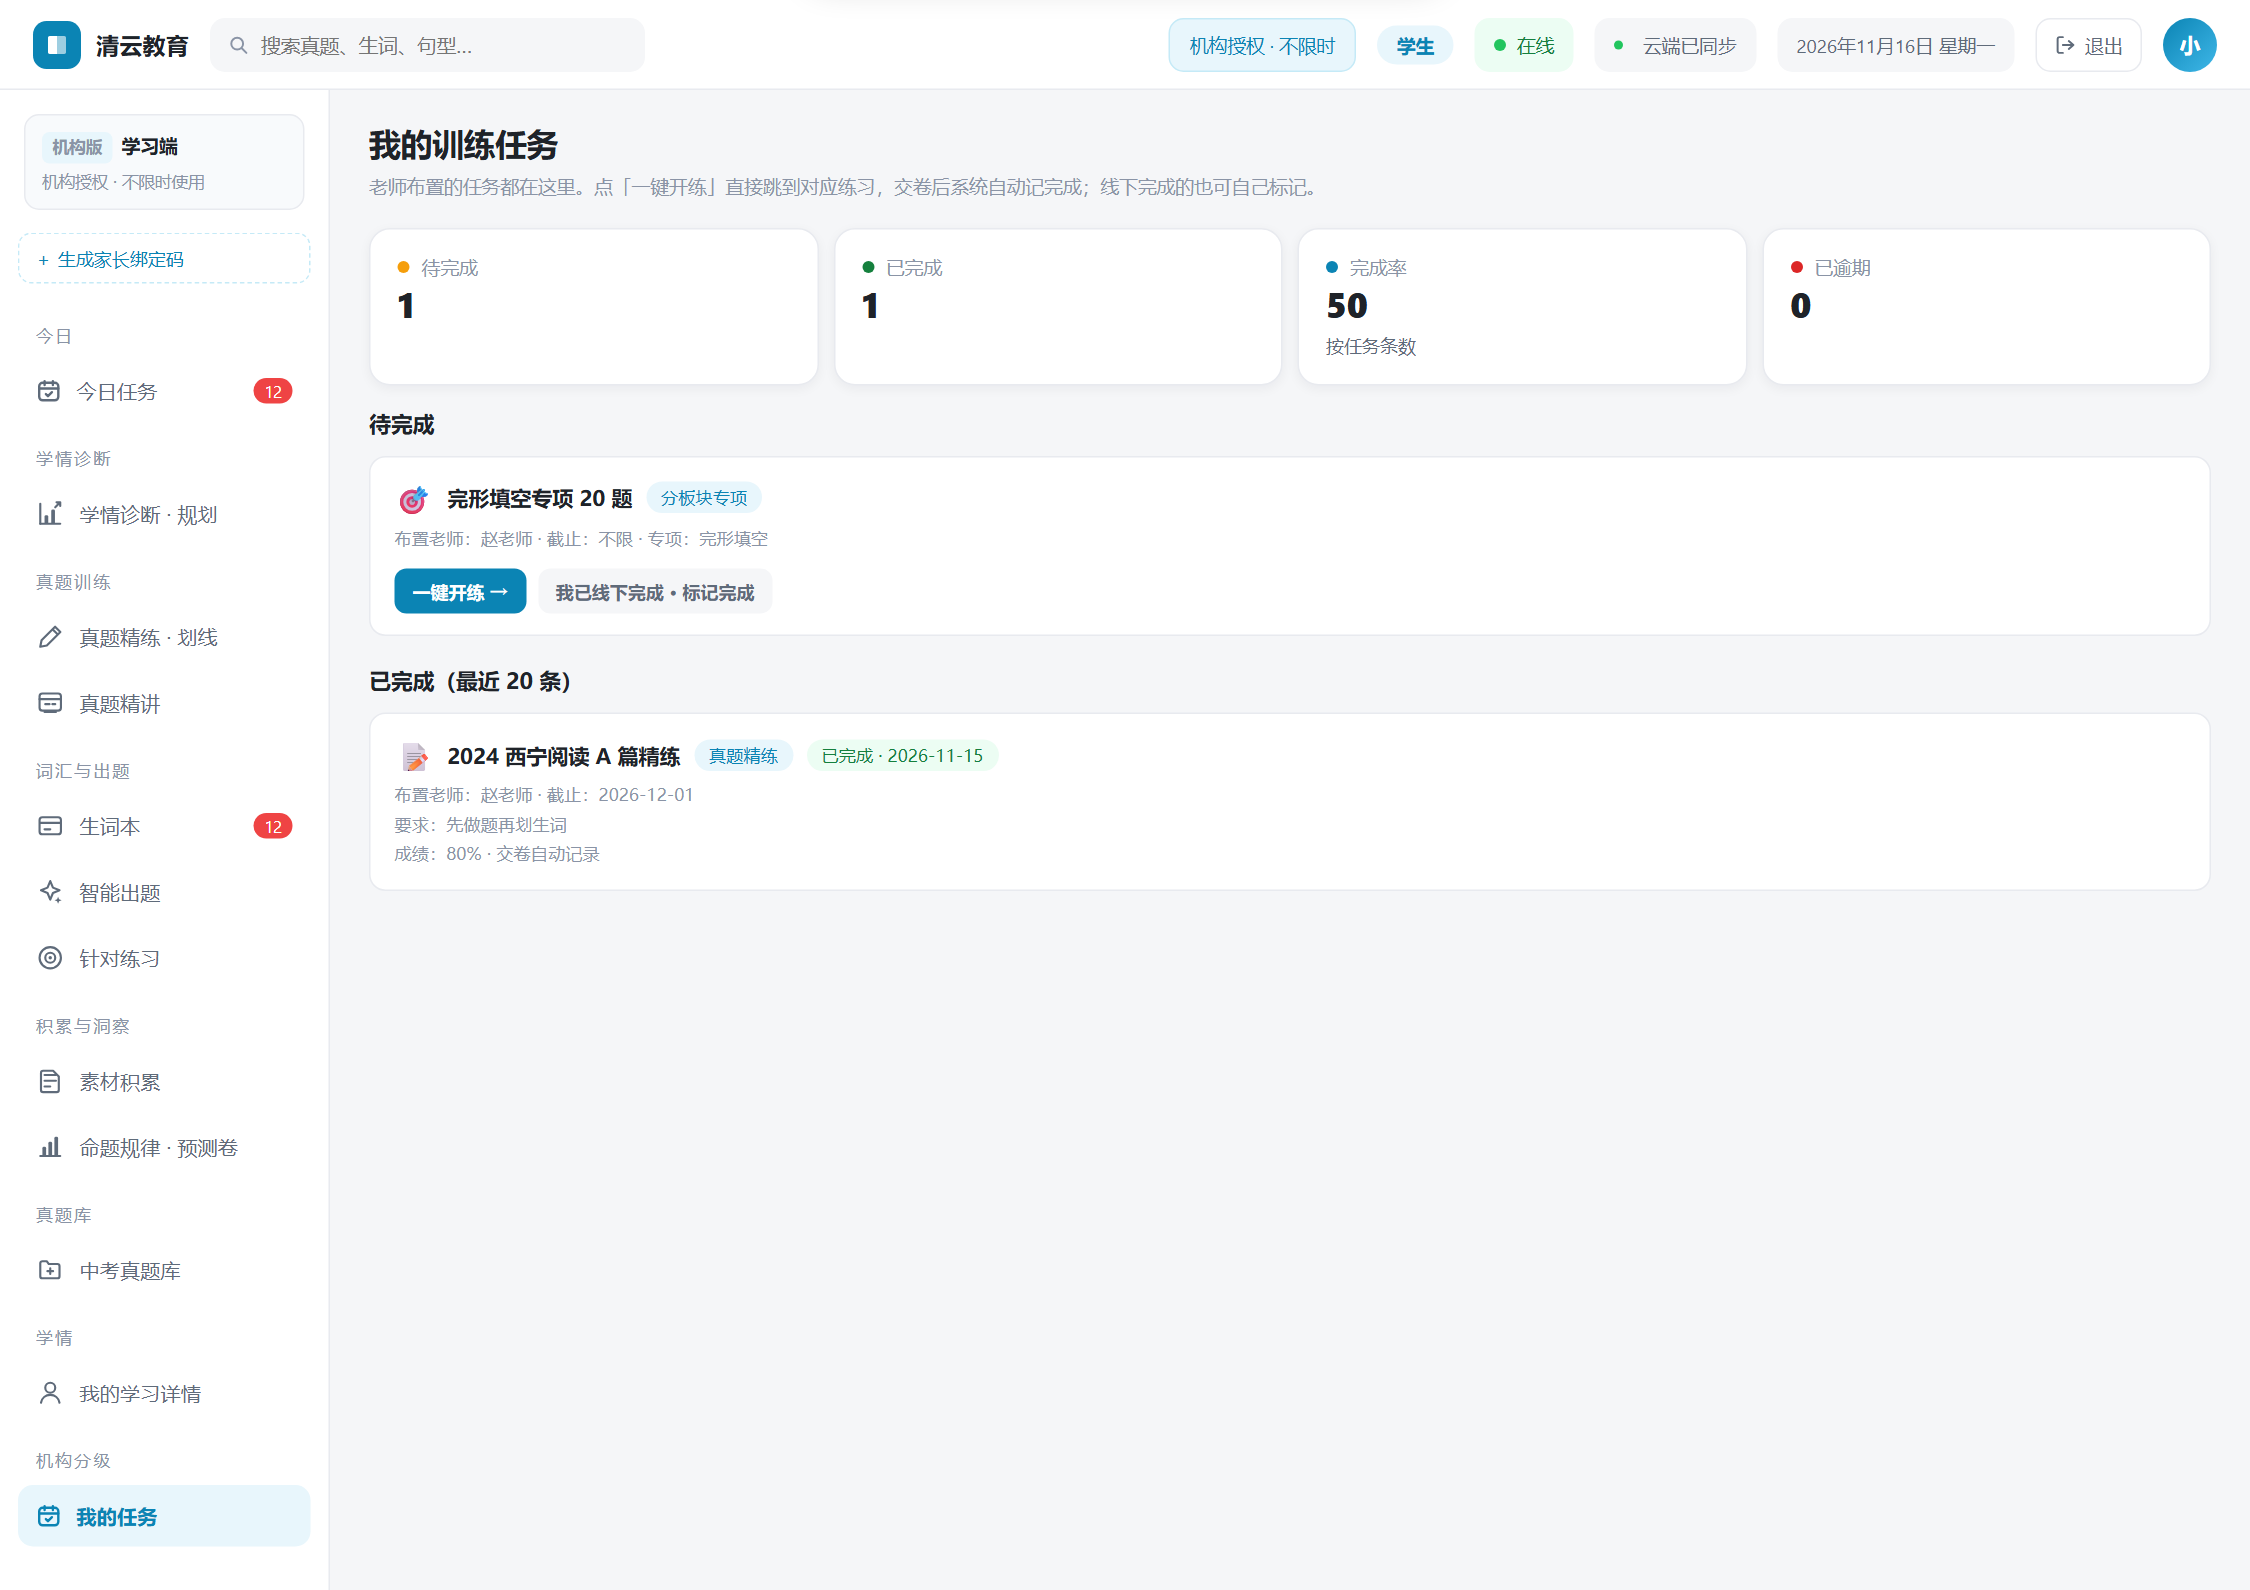
图4 学生我的任务
图4:学生端只做两件事——点「一键开练」或「我已线下完成」;交卷后任务自动变「已完成」,并带上成绩与「交卷自动」的来源标记。
四、产出物:最后交付了什么
产出物 | 规格 |
|---|---|
线上单文件前端 | 构建后约 1.17 MB(1187 KB),内联 11 层功能,原型文件零改动 |
后端服务 | 轻量 Python + SQLite,13 张表,含任务、订单、订阅、角色、机构 |
题库 | 62 套真题,结构化 JSON,从原始 txt 单向生成 |
构建校验 | 构建脚本自带 11 个标记的存在性校验,缺失即非零退出 |
后端契约测试 | 159 项,临时服务和临时库,跑完即清 |
前端验收 | 静态验收页 43 项断言 + 真实登录态端到端 44 项 |
数据迁移 | 老库幂等迁移,新增表和列自动补齐,线上数据零丢失 |
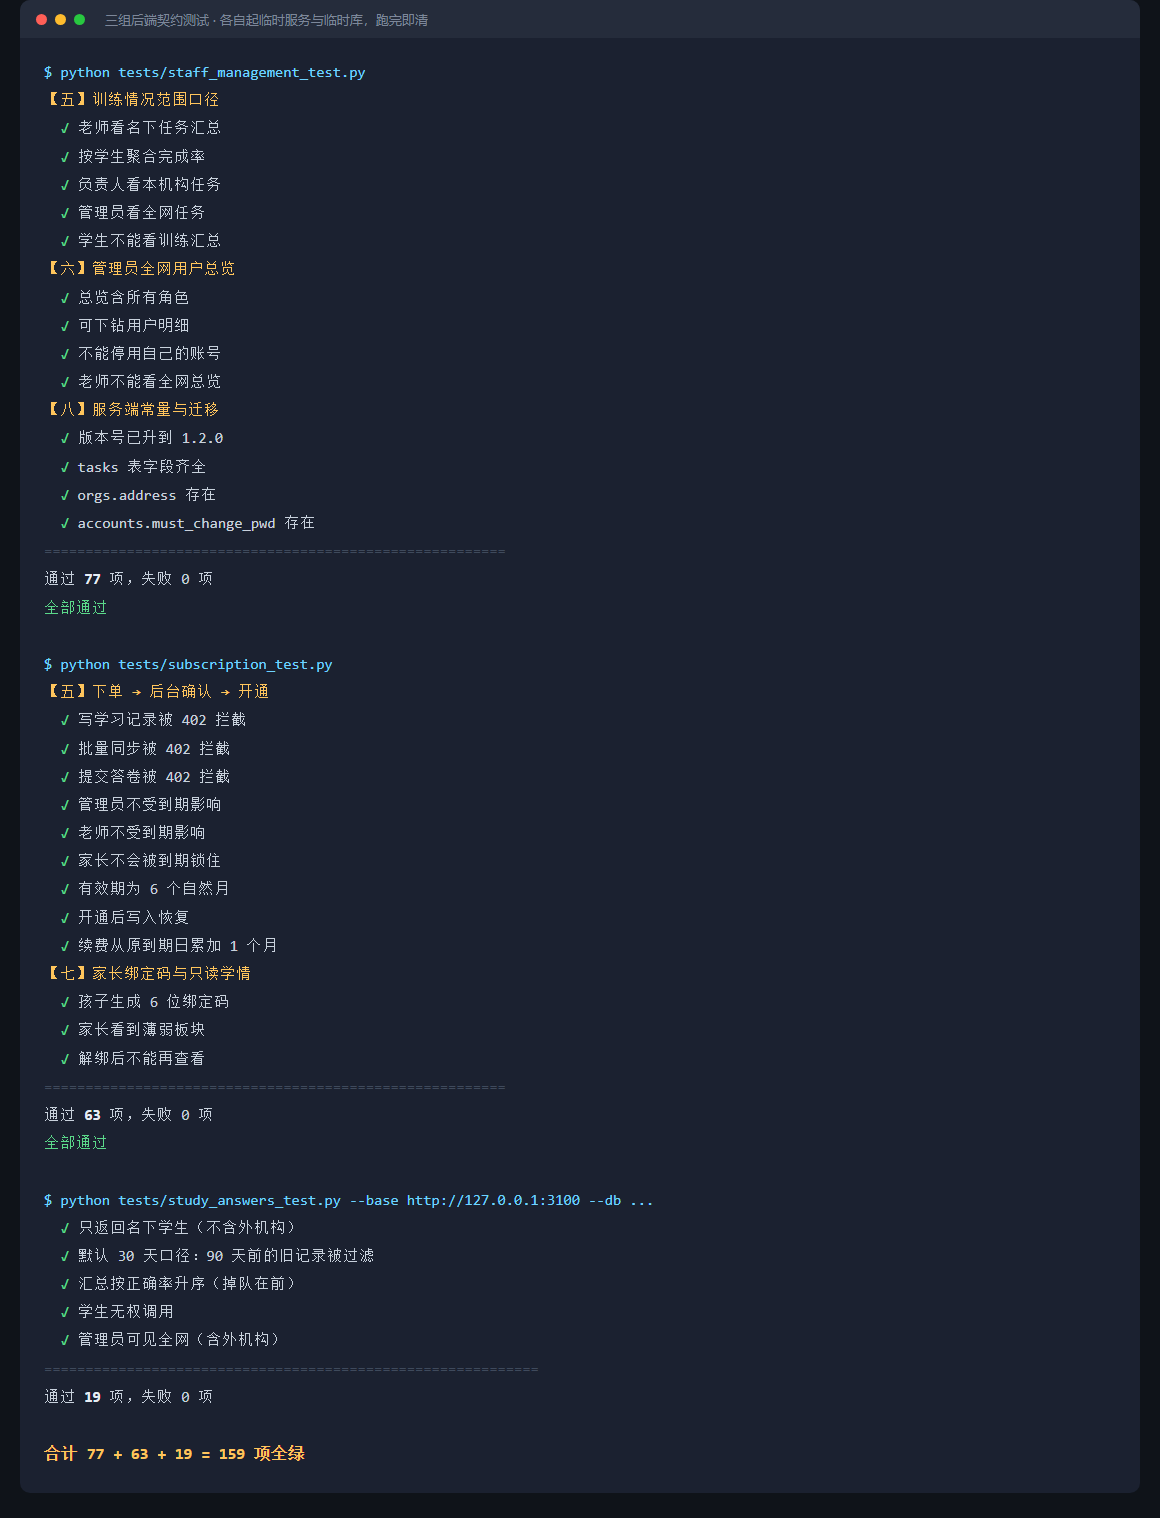
图5 三组契约测试 159 项
图5:分级管理 77 项、订阅回归 63 项、答题看板 19 项,合计 159 项全绿;每组测试自己起临时服务和临时库,跑完即清,不依赖环境。
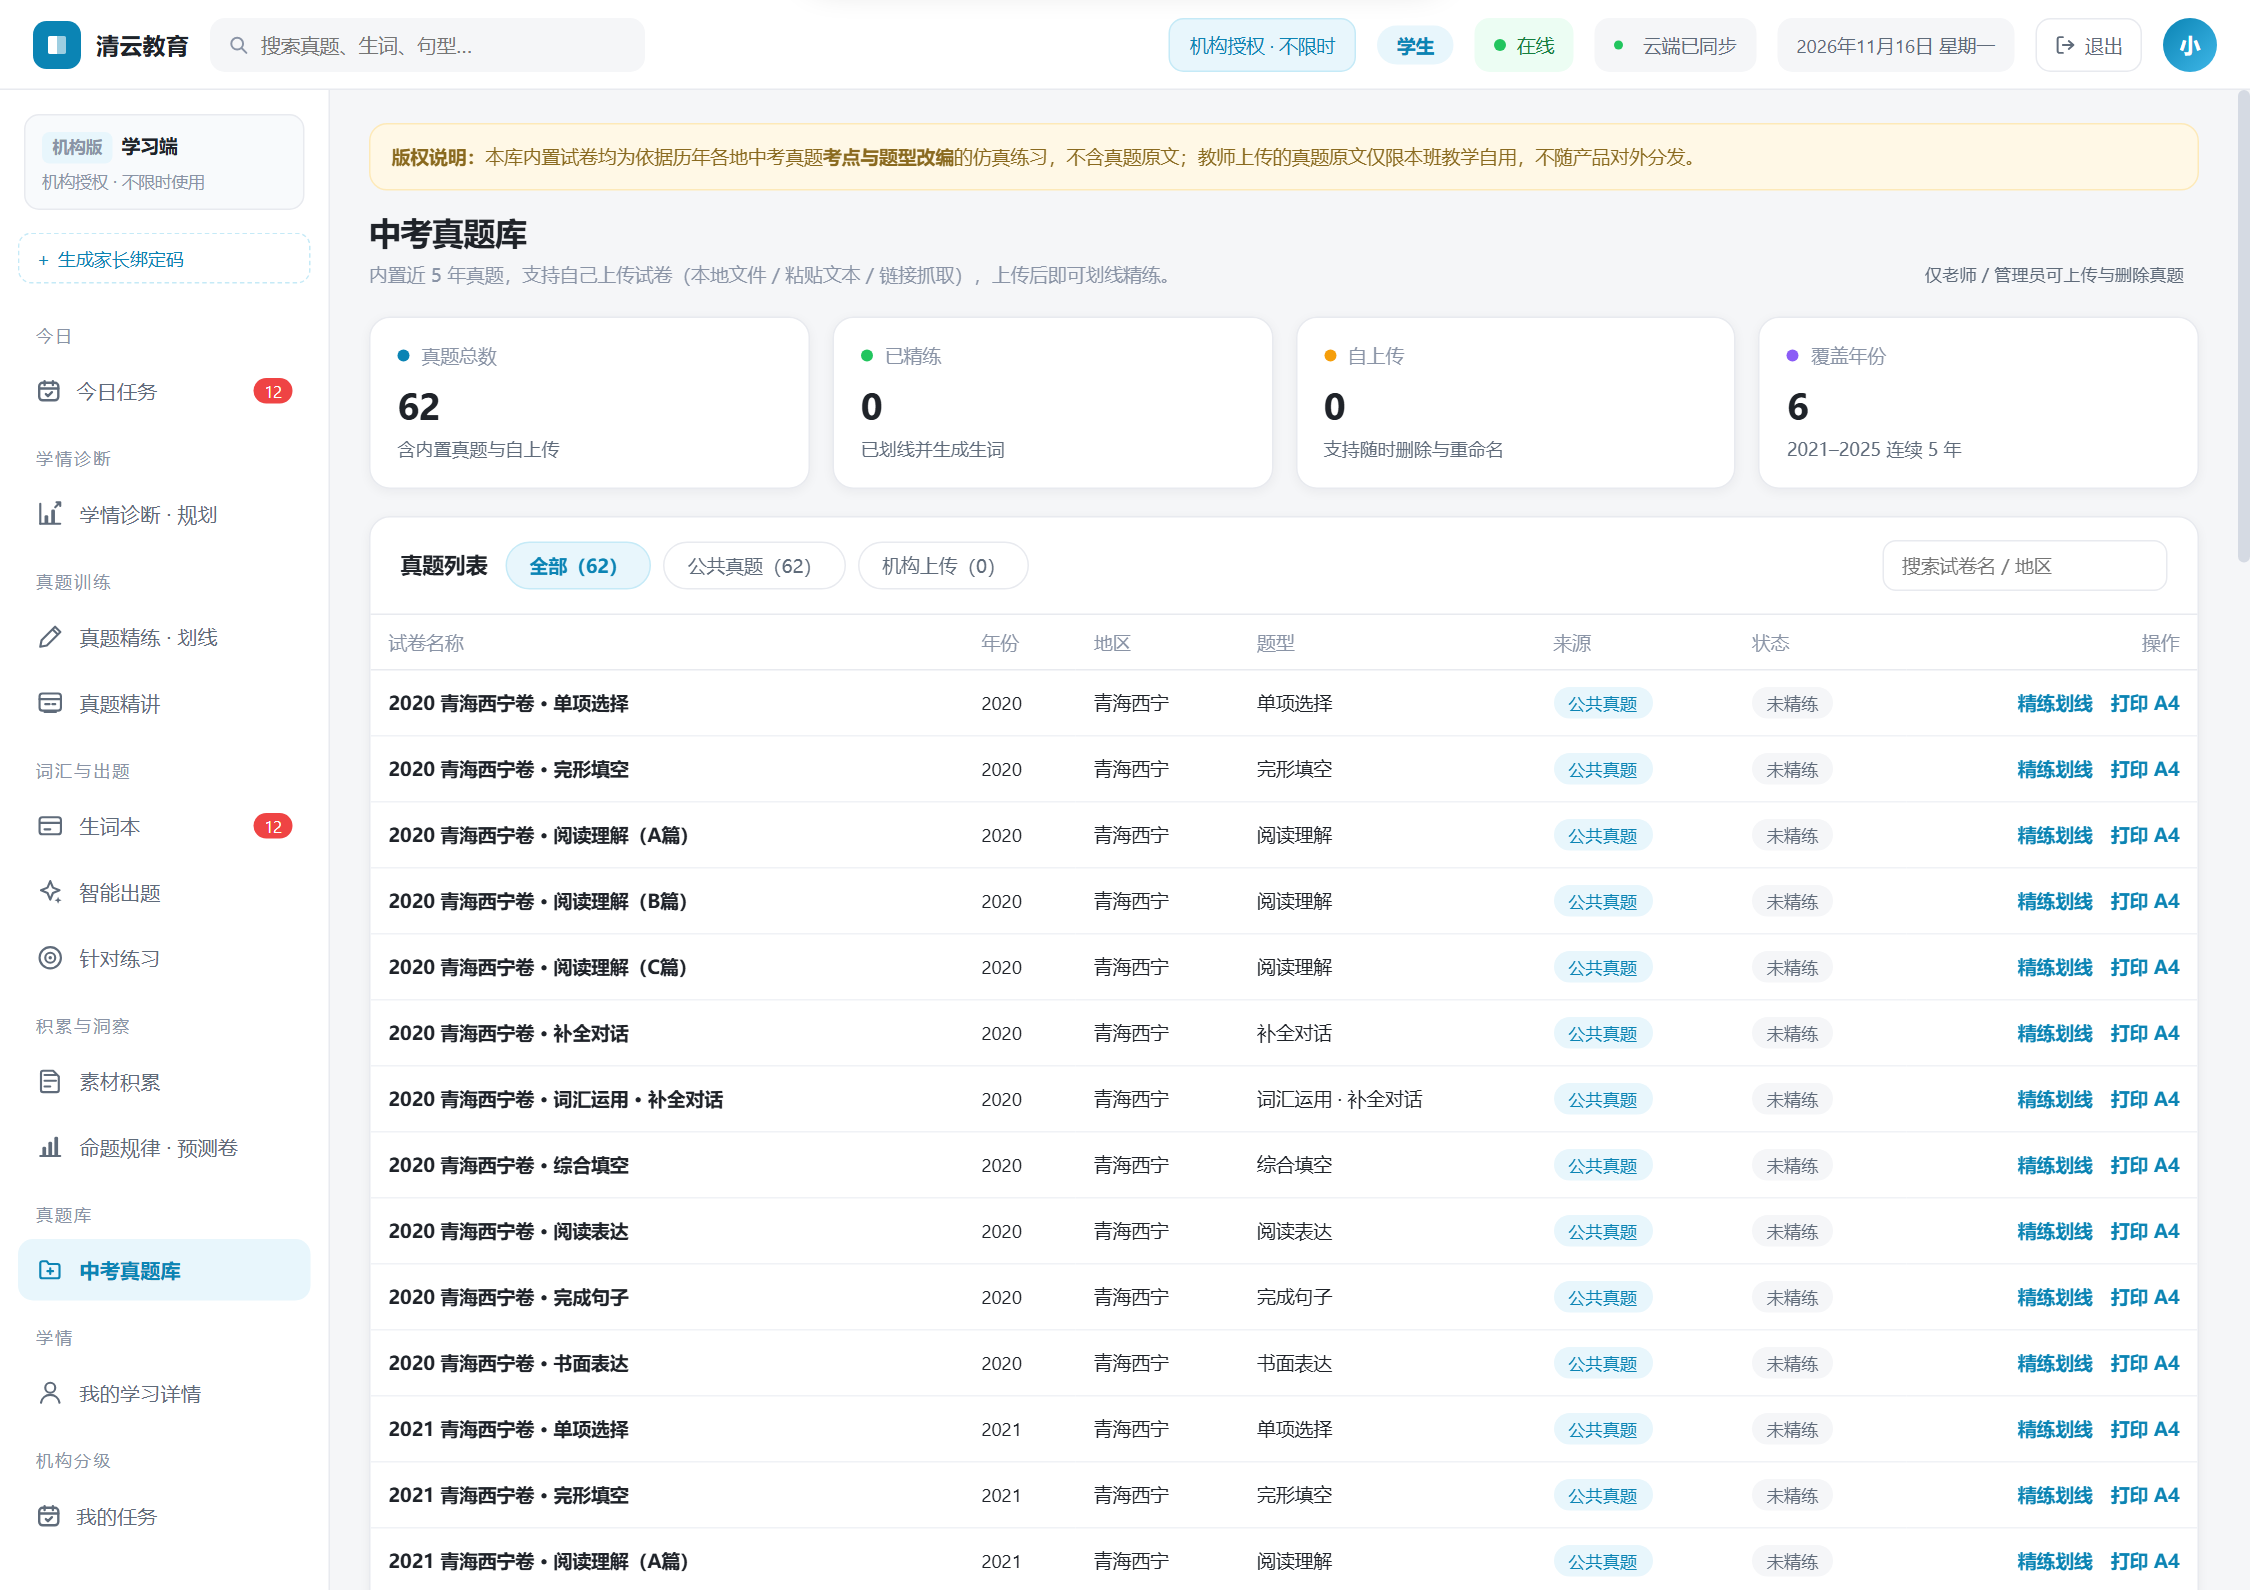
图6 单文件产物真题库
图6:整站只有一个 HTML 文件,62 套真题与 11 层功能都在里面,运行时不发额外的脚本或样式请求。
五、五个真踩过的坑
坑 1:注入脚本改完,产物没重建,验收一直过不了。
我改的是源文件,测的是构建产物,中间隔了一步没跑。更麻烦的是浏览器还缓存了旧产物。定位办法是给验收页的 URL 加时间戳参数,并每次都换一个全新的浏览器用户目录。教训:任何「改完没效果」先怀疑产物和缓存,别急着改代码。
坑 2:端到端测试报了一个「产品缺陷」,其实是测试脚本自己的问题。
现象是:负责人改完密码、页面自动重载后,侧栏退回了学生视角。看着很像真 bug。我停下来用真实登录页(而不是脚本里直接调接口登录)单独复核了一次,一切正常。原因是我那个测试脚本用接口登录,绕过了登录页,没把本地会话和账号记录写进去,所以主程序启动时按默认角色渲染了。教训:当「疑似缺陷」只在一个自动化路径下出现、手工路径不复现时,先怀疑测试的初始化,别急着改产品。这一条帮我避免了一次错误的「修复」。
坑 3:加了服务端 428 拦截,页面反而报「连不上云端」。
首登强制改密上线后,前端启动时会拉几个只读接口,全被 428 拦掉,于是首页显示离线。解决办法是维护一个白名单:只放行启动必需的 GET(同步、题库、名单),写操作和管理接口照样拦。拦截要严,但要给「页面能正常站起来」留一条只读通道。
坑 4:老测试因为规则变了集体失败,看着像代码坏了。
改订阅口径那次,机构版学生从「按个人订阅计时」改成「机构统一授权、不计时」,结果旧的订阅测试全部红灯——因为它拿机构版账号去验证「到期返回 402」,而机构版现在永远不该返回 402。这不是 bug,是测试断言过期了。处理办法是新增一个独立的家用版测试账号,把到期、下单、续费这条链路整体迁移过去,同时补上「机构版过了七天仍可写入」的新断言。教训:口径变了,先把测试里的角色和数据分开,再谈改代码。
坑 5:验收页里取不到原型的状态对象。
原型的核心状态是脚本级声明,挂在 window 上取不到,导致验收页一连串断言全错。最后是在被验收页面里用 Function 构造器把它取出来,才通。这类「脚本级变量不可见」的坑,在给老代码写测试时会反复出现。
六、能带走的三条
一、约束要显式、要重复、要可校验。「不许改原型」如果只说过一次,它迟早会失效。把它变成构建脚本里的一个校验步骤(缺标记就报错退出),它才真的守得住。
二、让 AI 先核实再回答,比让它写得更快重要得多。尤其是要对外承诺的东西——产品到底支不支持、数字对不对、边界在哪,这类问题值得多问一句「依据在哪一行」。
三、能自动跑完的验收,不要靠眼看。159 项后端测试和 44 项端到端,写的时候觉得啰嗦,但它让我在改到第六轮的时候,还敢动第一轮的代码。
最后一句实在话:这套东西不是「一句话生成」的。来回改了几十轮,很多轮是在推翻自己上一轮的设计。WorkBuddy 在这件事里真正省下的不是敲代码的时间,是「想到就能当天试一下」——以前一个念头要排期,现在晚上想明白,第二天就能看见样子。这个循环变快,才是这类工具最值钱的地方。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号