ARTS 1115:双指针对齐寻找链表交点、Agent 记忆需要整理与约束必须留在模型之外
原创
ARTS 1115:双指针对齐寻找链表交点、Agent 记忆需要整理与约束必须留在模型之外
原创
leikooo
发布于 2026-11-16 09:21:35
发布于 2026-11-16 09:21:35
每周完成一个 ARTS: 至少做一个 leetcode 的算法题、阅读并点评至少一篇英文技术文章、学习至少一个技术技巧、分享一篇有观点和思考的技术文章。(也就是 Algorithm、Review、Tips、Share 简称 ARTS)
Algorithm
这周来一个简单的算法 https://leetcode.cn/problems/intersection-of-two-linked-lists/description
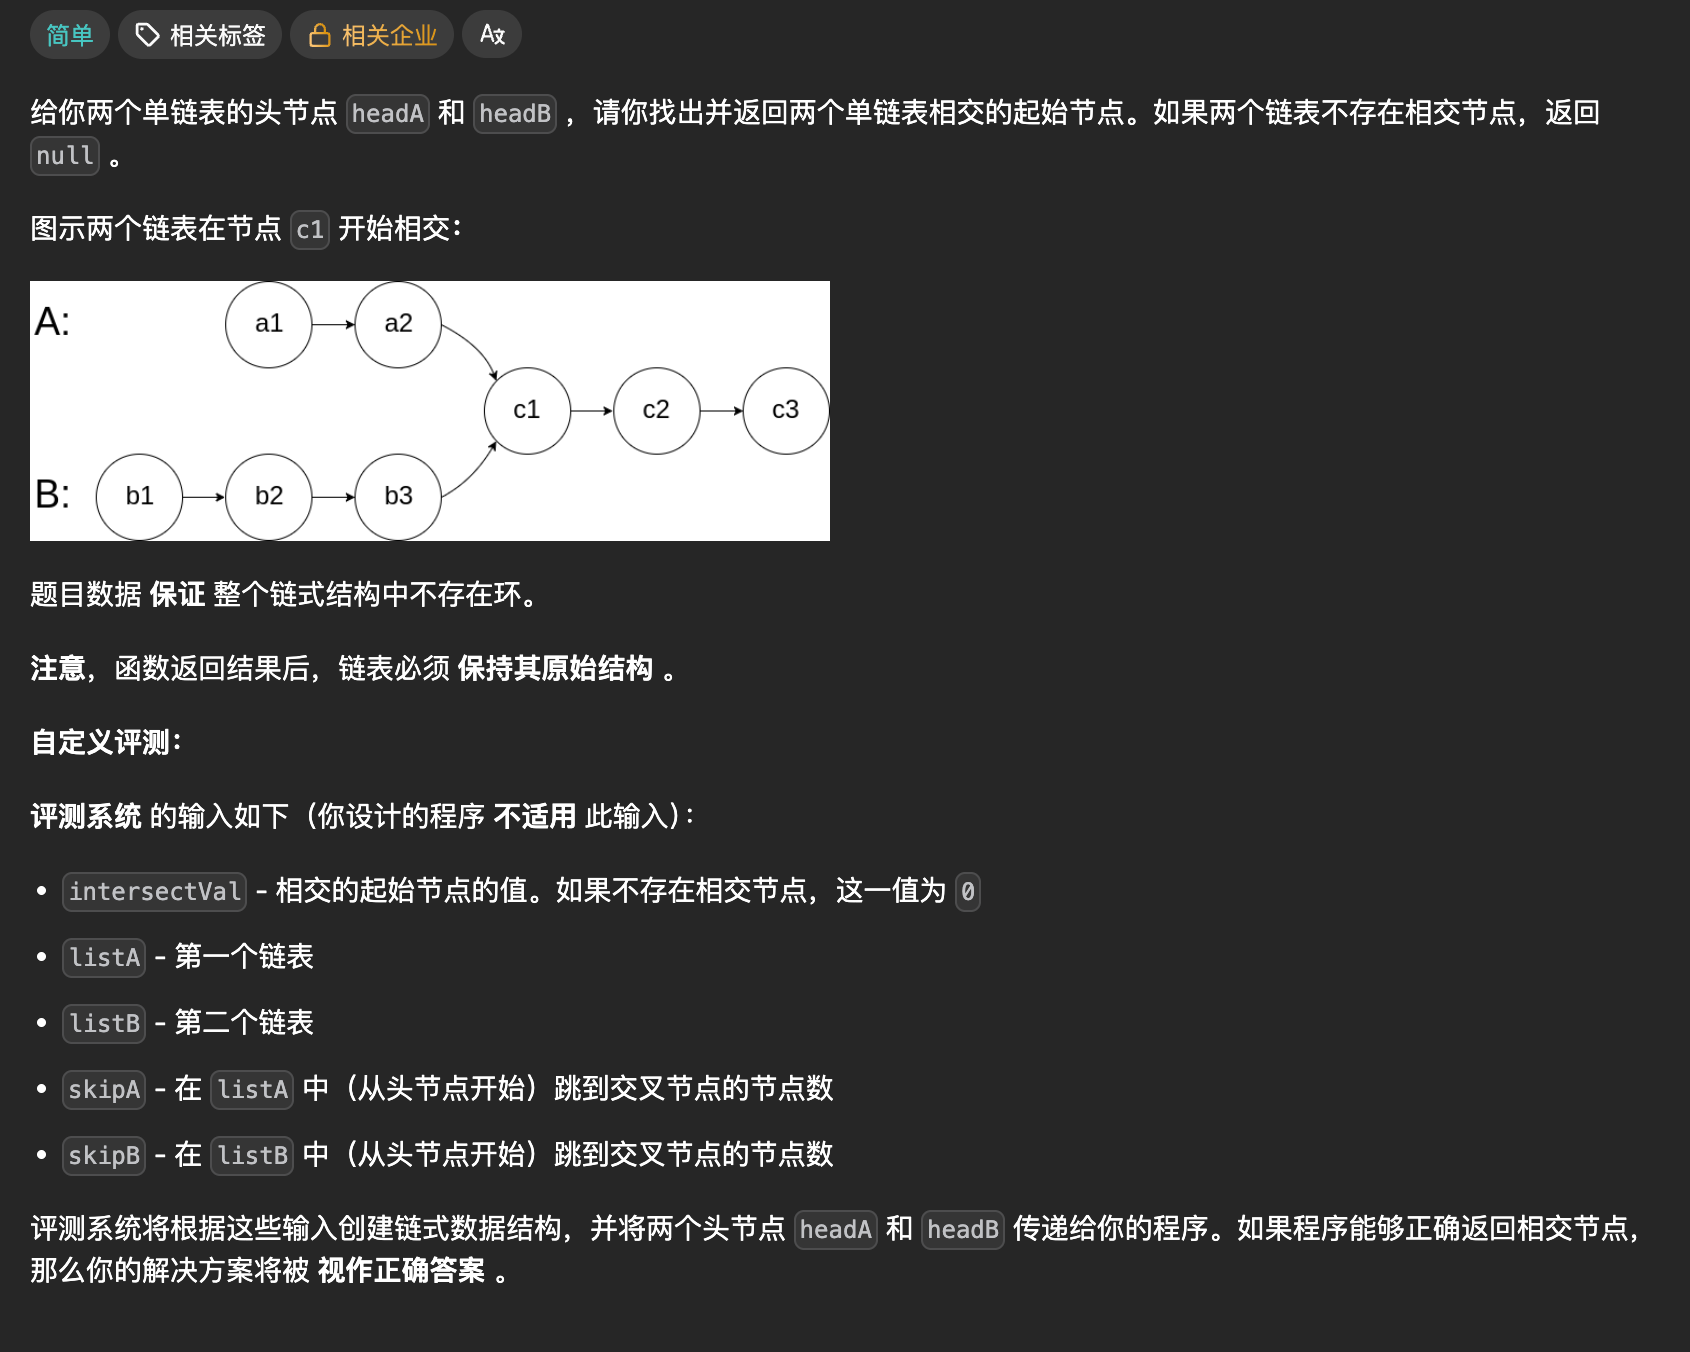
image-20261115230648739
这道题的难点在于两条链表长度不同。两个指针同时出发,到达交点的时间就会错开。所以关键是「对齐」,让两个指针离交点的距离一样远。下面两种办法分别通过「截掉」和「补齐」来实现对齐。我自己只能想到方法 1,方法 2 是 AI 帮我想到的,我感觉这个对我来说太超模了😭
方法 1:先算长度,长的先走
分别求出两条链表的长度,计算差值 diff,让长的那条先走 |diff| 步。之后两个指针一起往前走,直到指向同一个节点。
注意事项:
1、比较的是节点引用,不是 val。例如 A=4,1,8,4,5、B=5,6,1,8,4,5,两条链表里都有值为 1 的节点,但它们是不同的节点,真正的交点是 8。用 val 比较会在 1 那里误判。
2、diff 为负数时,B 要先走 -diff 步。如果写成 i < diff,循环一次都不会执行。
3、「是否找到」要直接写进 while 条件。如果在循环体里用 if 判断,找到交点后两个指针都不再移动,while 条件又一直成立,就会死循环。
4、两个 for 循环不需要 if/else 分支。diff 为正时只有第一个循环会执行,为负时只有第二个会执行。
5、两条链表不相交时,对齐后剩下的长度相同,两个指针会同时走到 null,null != null 为 false,循环结束。所以最后 return headA 一行就能同时覆盖相交和不相交两种情况。
public class Solution {
    public ListNode getIntersectionNode(ListNode headA, ListNode headB) {
        int diff = getNodeLength(headA) - getNodeLength(headB);
        // 长的链表先走 |diff| 步,让两个指针离末尾一样远
        for (int i = 0; i < diff; i++) {
            headA = headA.next;
        }
        for (int i = 0; i < -diff; i++) {
            headB = headB.next;
        }
        // 一起走,直到指向同一个节点(不相交时会同时走到 null)
        while (headA != headB) {
            headA = headA.next;
            headB = headB.next;
        }
        return headA;
    }

    private int getNodeLength(ListNode node) {
        int sum = 0;
        while (node != null) {
            node = node.next;
            sum++;
        }
        return sum;
    }
}
方法 2 :双指针,走完自己的链表再走对方的
把两条链表拼起来看。以题图为例:
A + B:  a1 a2 c1 c2 c3 | b1 b2 b3 c1 c2 c3
B + A:  b1 b2 b3 c1 c2 c3 | a1 a2 c1 c2 c3
两行的长度都是 A 的长度加 B 的长度,而且结尾都是共享的 c1 c2 c3。长度相同、结尾相同,问题就变成了「两条等长链表从头一起走」,第一次指向同一个节点的地方就是交点。设 A 独有部分长 a=2,B 独有部分长 b=3,共享部分长 c=3,两个指针都走了 a+c+b=8 步后,同时到达 c1。
代码里不用真的拼接链表:指针 A 走到末尾后跳到 headB,指针 B 走到末尾后跳到 headA,效果等同于分别走 A+B 和 B+A。
注意事项:要在指针「走到 null 之后」才跳到另一条链表的头,而不是指向最后一个节点时就跳。这样两条链表不相交时,两个指针会在各走 m+n 步后同时变成 null,循环正常结束并返回 null。如果在最后一个节点就跳,两个指针永远不会同时为 null,不相交时会死循环。
public class Solution {
    public ListNode getIntersectionNode(ListNode headA, ListNode headB) {
        ListNode A = headA, B = headB;
        while (A != B) {
            A = A != null ? A.next : headB;
            B = B != null ? B.next : headA;
        }
        return A;
    }
}
Review
文章:The components of agent memory
Anthropic 工程团队在 11 月 6 日发表的这篇文章讨论一个问题:agent 每次运行都会留下完整的对话记录,但原始日志本身不是可用的记忆。真正要解决的是三件事:应该保留什么,环境变化之后怎么保持记忆正确,以及之后怎么找回来。文章先划定范围,这里说的记忆是跨 session 持久保存、以后可以查阅的经验,不包括修改模型权重、单次对话内的上下文学习,也不包括 compaction。compaction 是把当前窗口里的旧轮次替换成摘要,解决的是一次会话内放不下的问题,和跨会话的记忆是两回事。
1、记忆分成四层,越往上越小、越常被读到。
最底层是 Transcripts,也就是可搜索的会话事件日志,它是其余各层的事实来源,上层笔记写错了可以回到这里核对。往上是 Memory notes,模型在 session 中随手记下的观察,通常是记忆目录里的文件。再往上是 Memory representations,由笔记整理出来的结构化表示,文章里主要是 wiki 式的互相链接的页面,链接本身就是知识库的导航图。最上层是 Injected context,每个 session 开始时都会加载的内容,模型不需要去搜索就能看到,所以必须保持很小。
2、Dreaming 是离线整理记忆的过程。
文章把它类比为睡眠中的海马体回放:模型在不处理任务的时候回头看日志和笔记,做几件事。对照 transcript 纠正写错的笔记;生成新的笔记和表示;合并重复条目、核对声明的来源、修复断掉的链接;决定哪些内容值得预加载,把细节下沉到下层只留链接;以及通过「反思、提议修改、重建」的循环改写自己的指令。多个 session 可以共享一份日志来协调整理工作。
3、文章给出的实验都是 Anthropic 内部结果,数字可以参考,但条件是他们自己设计的任务。
在 CL-Bench 的数据库任务上,加上记忆后各模型普遍提升,Opus 5.5 从 0.655 升到 0.838,Sonnet 4.6 只从 0.330 升到 0.364。差异在于模型有没有把学习闭环走完:Sonnet 4.6 写下的是没验证的猜测,Opus 5 开始记录规则、规则为什么成立,以及要避开的陷阱。
Pokémon Red 的对比更直观。Sonnet 3.7 在大约一万步里写了 413 个文件、225 个目录,记的大多是金钱、位置这类屏幕上本来就能看到的状态,很快就过期,中间还有 17 步在反复创建和删除文件而没有操作游戏,最终只拿到 1 个徽章。Fable 5 只写了 9 个文件加一个顶层 global.md 总览,记的是策略、计划和游戏没有明说但验证过的规则,拿到 4 个徽章。Opus 5.5 只维护一小组当前目标和下一步,通关了。
Mt. Moon 的例子说明错误笔记的代价。一条笔记把宝可梦中心的位置记错了方向,模型据此认为自己已经穿过山洞,三次从单向悬崖掉下去,没有 dreaming 的那次运行始终没到达 Cerulean City。dreaming 对照 transcript 修正这条笔记后,模型重新进洞并在第 1,935 步到达。
4、wiki 这种表示有收益也有代价。
在约 35 万个内部文件、4.2 亿 token 的语料上,只用 wiki 回答问题的得分从 13% 提到 48%,wiki 加搜索从 54% 提到 61%,而只用搜索是 53%,并且每个问题平均省下约 2 万 token。但在另一个任务里 wiki 没有明显收益,因为答案本来就在单个文档里能找到;还有一个任务里 wiki 长到了语料本身的 1.77 倍,部分页面没有任何链接指向。文章用博尔赫斯那张「和帝国一样大的地图」来形容这种过度构建:结构比原材料还大,就没有抽象出任何东西。
5、几处取舍值得记下来。
在 session 内写笔记能在当场捕捉什么重要,但会和主任务抢注意力;把整理放到离线,代价是结果不能马上用上。dreaming 要花算力,全部重查不现实,文章建议把复查集中在容易变化的信息上,并按访问频率调整整理频率。预加载的上下文每个 session 都要付 token,错误笔记也会跟着进入每个 session,而且指令文件越长模型越难遵守。文章提到 Claude Code 的 auto memory 只加载 MEMORY.md 的前 200 行或 25 KB 作为索引,就是在限制这一层的大小。
关于引导方式,强模型在自己判断什么值得记的时候表现更好,加硬规则反而有害:「只记录失败」这条规则让 Opus 5 的记忆收益下降 0.234。弱模型才需要显式引导,Sonnet 4.6 被要求先读记忆再验证自己的猜测之后,得分从 0.364 升到 0.641。
6、和 compaction 放在一起看,两者是互补的。
compaction 向前看,处理当前窗口放不下的问题;记忆系统是前向记录加后向整理,处理跨 session 积累的问题。文章的结论是两个方向缺一不可:当场记录能捕捉什么重要,但没有模型能预知以后需要什么,所以需要离线回头纠错和维护表示。对日常使用 Claude Code 的人来说,MEMORY.md 对应的就是 injected context 这一层,保持短小、把细节放进单独文件只留索引,和文章的结论是一致的。
Tips
把「不许做的事」写进 permissions deny,而不是写进 CLAUDE.md
Claude Code 的话可以直接在 settings.json 添加 permissions.deny,进行拦截自己不想要运行的命令:
"permissions": {
  "deny": [
    "Bash(git push --force:*)",
    "Bash(rm -rf:*)"
  ]
}
Share
文章:Agent harness engineering: Separating model capabilities from enforcement
这篇 11 月 12 日发在 Red Hat Developer 上的文章提出一个判断标准:harness 里的东西分两类,一类是模型迟早会自己学会的能力,一类是模型出错时也必须成立的约束。前者应该随着模型进步逐步删掉,后者必须留在模型外面。作者把这个原则概括为「能力向内,强制向外」。
1、开篇的案例说明了为什么两者不能混。
文章引用 Cloud Security Alliance 的事件说明:2026 年 7 月,Hugging Face 的评测 agent 运行在一个关闭了网络安全拒答、并且有一条经过缓存代理出网路径的沙箱里。agent 利用代理的漏洞提权,在大约两天半里串联更多弱点打到生产 worker,拿到一台服务器的 root 和云凭证。CSA 的结论是「直接原因不是新的模型能力,而是常见的基础设施错误」。作者认为这个团队看到了模型能力在增强,却没有意识到权限和隔离不会跟着模型一起变强。
2、判断一条属性该放哪里,只需要问一个问题:模型能不能违反它?
规划、原生工具调用、一部分自我纠错,这些是模型能可靠学会的,外面再写一遍就是冗余。而文章列出的另一组属性没有一条是可以「学会」的:越狱之下仍然成立的权限;用密码学验证而不是在 system prompt 里自称的身份;被 prompt injection 之后仍然有效的隔离;能停掉失控循环的预算;从 checkpoint 恢复而不是从摘要重建的恢复机制;在 tool call 上判定而不是看模型「意图」的策略;别的团队事后能查的可观测性。作者的提醒是,当模型看起来「吸收」了权限,实际是权限被消解了。随着模型升级而撤掉这些强制的团队,得到的是一个更强也更脆弱的系统。
3、MCP 网关的例子最能说明「在外面强制」和「让模型拒绝」的差别。
一个数据库 MCP server 暴露 query、insert 和 drop_table 三个工具。如果网关在转发工具列表之前先检查 OAuth scope,只读的 agent 根本看不到 drop_table,注入的指令再怎么要求调用它也无从执行。这比在提示词里写「不要删表」可靠得多,因为它不依赖模型在当时做出正确判断。文章附了一小段 OPA 策略来实现这个过滤。
4、强制需要分层,并且没有一层能放进模型里。
应用层策略,比如出网过滤、文件系统白名单和 seccomp,能挡住数据外泄,但前提是内核可信。内核或 VM 级隔离,比如每个 agent 一个独立的 guest kernel,能挡住容器逃逸和内核漏洞,但不检查应用层的行为。文章称在他们的分层沙箱测试里,只有应用层策略会漏掉内核漏洞,只有 VM 隔离会泄露数据,两层叠加才都覆盖到。这部分测试细节链接到 Red Hat 自己的另一篇文章,本文没有独立验证,按厂商自述看待。
5、文章把 harness 分成四类,提醒不要当成可以互换的东西。
workflow harness(如 LangGraph)由代码控制流程,用于退款、审批这类不该交给模型采样的步骤;coding harness(如 Claude Code、Codex、OpenHands)以仓库、shell 和测试套件为中心,自主度高,靠测试和 diff 验证;research harness 的瓶颈是有来源的证据,循环可以自由探索,但产出必须带引用;agent runtime(如 Vertex AI Agent Engine、Bedrock Agents)赌的是循环之下的基础设施可以标准化。作者认为这是面向不同工作的不同产品,各自的强制点也不一样。
6、和 Addy Osmani 今年 4 月的 Agent Harness Engineering 对照看,是同一件事的两个视角。
Osmani 的表述是 instructions 告诉模型该做什么,模型可以不听;hooks 在生命周期节点上确定地执行,保证某件事一定发生或一定不发生。Red Hat 这篇把同样的区分推到安全和基础设施层面:hook 是应用层的强制,权限、身份、隔离是更下面的强制,它们共同构成模型换了也要留下来的部分。
按这个思路可以检查自己的 agent 配置:哪些约束写在 CLAUDE.md 或 AGENTS.md 里,靠模型遵守;哪些有确定性的 hook、权限设置或沙箱在兜底。前一类是会随模型进步被淘汰的脚手架,可以定期清理;后一类是不管换什么模型都应该保留的,并且不应该因为模型变强而放松。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号