给了日期没坏算误报,给了日期没给班次还是误报
原创
给了日期没坏算误报,给了日期没给班次还是误报
原创
大升聊APS
发布于 2026-11-16 09:21:39
发布于 2026-11-16 09:21:39
"我就问一句,它坏之前,能不能提前知道?"
月度例会上,设备部长把笔往桌上一放,连着问了五句。生产、工艺、IT 三家都坐在对面,谁都没先接话。
这五句问得不苛刻,是任何一个管设备的人都会问的。按顺序摆出来,逐句给一个务实的回答。
能不能提前知道它会坏
能。但这句话要听全:能不能,取决于厂里有没有喂得进去的东西,不取决于算法。
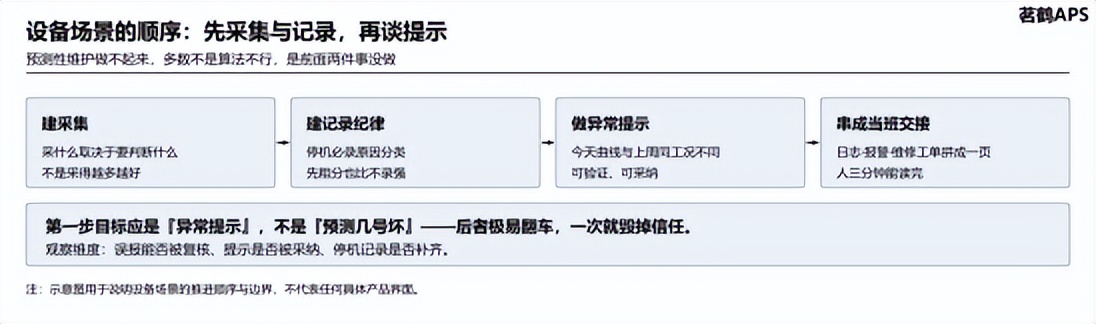
设备这条线最容易被跳过的,恰恰是最前面两步。一开口就问模型、问准确率,而模型要的东西只有两类:稳定的采集数据,和有人签过字的标注记录。前一样靠通道,后一样靠纪律。两样都没有,算法只能空转。
误判的成本也得摆到桌面上:说会坏而没坏,班组白停一次机;说不会坏,下午就停了。没人愿意为一个说不清来源的提示担这个责。
标注也常被误解。它不是给数据打标签的体力活,是"这段曲线后来发生了什么"能被说清楚:这次拆检换的是什么件、磨损长成什么样。这些信息由维修工在工单上写一行字,就不用旁人在机房里猜。
先别问模型行不行,先问三件事:关键量有没有连续在采,停过几次机有几个人知道,每次停的原因写没写下来。三件答不上,后面的讨论都是空的。
要不要先装传感器
先别问装多少,先问要判断什么。
要判断轴承磨损,振温和频谱才有意义;要判断堵转、缺料、空转,电流曲线更直观;要判断温升异常,得看轴承座和油箱。至于润滑油老化、密封件渗漏,眼下更多靠巡检记录和换件周期说话,硬装个传感器去"看",多半看不出来。
采什么,取决于要判断什么,不是越多越好。
点位装得越多,越容易撞上另一种尴尬:几百路数据天天在存,两年后翻不出一个能用的结论。数据存着不用,和没采一样。
有条朴素顺序值得记:先挑三到五台"一停全线就停"的设备,把最关键的两三个量采稳、采连续,比给全厂每台机都挂上传感器值钱。采集链路宁少勿断,宁可少采,采了就要天天准。
两件小事也不能漏。各路数据的时间要对得上,采集端的钟和管理系统的钟差五分钟,一次停机的现场就拼不回来;"同工况"也得有人定义清楚,同一副模具、同一档转速,可比的前提要先写下来。
这条顺序跟部署形态无关。企业自建机房也好,租赁云主机服务器也好,通道跑得通才是前提。
多数厂里也早有底子:点检表在纸上,报警在机柜上,工单在已有的管理系统里。这一段是接过来一起用,把老记录和新增采集对齐,不是推翻再建一套。
要不要上预测性维护
建议先上另一件更便宜的事:停机必录,且必须归类。
很多工厂是这么过的:设备停了,操作工喊一声,维修工跑过去,修完接着做。晚上八点停的,第二天早会才知道;为什么停,全厂只有当班那个人记得,而他下个月可能就调走了。半年之后想复盘,谁都说不清哪台机最常因为什么停。
记录不必复杂。停机时刻、恢复时刻、原因大类,机械、电气、工艺待料、人为误操作这几档,填得上就够起步。先粗分也行,粗分坚持半年,比细分做三个月然后断掉强得多。
原因分类的意义不在报表好看,在于它是标注。将来任何一次判断,都要靠"这类停机以前长什么样"来支撑。没有这份记录,模型看到的只是一段曲线,看不到曲线后来发生了什么。
分类谁定?维修班组自己定,先把口径吵明白,再谈谁来录。
录的动作也别再添负担。停机时刻能从工单的开工完工时间里带出来,就别让人手写两遍;扫一次码能带出机号和班次,就别再抄一遍台账。
谁来判断误报
这一步最容易翻车,翻在目标定得太高。
一上来把目标写成"预测几号坏",等于把自己架在一个不可验证的位置上。现场的设备,有的带着小概率的突变,多数只有大概率的缓慢前兆。给了日期没坏,算误报;给了日期没给班次,还是误报;报了一次没人理会,第二次没人理会,第三次这套东西就没人信了。信任在这件事上往往只有一次机会。
第一步目标应该低一档,也稳一档:异常提示——今天这台设备的曲线,和上周同工况下不一样。
这条提示有三个好处。可以被复核,把上周同期曲线摆在一起,两分钟就看得出对不对得上。可以被采纳,班组长不用停机,多巡两次、多听一会儿就够。可以被回话,看完之后有没有反馈,记录里看得见。
判断权仍然在人身上。系统只负责把可疑的东西挑出来递到手边,误报由设备自己的人判。区别只在于,以前靠经验和手感,现在多了一份可以对着看的历史。
误报也要有账。提示在什么时刻出现、谁去复核的、复核完怎么处置、这台机后来有没有真出问题,这四列记下来,半年后才有资格讨论准不准。没有这本账,说准说误都只是会议室里的印象。
一年能省多少
这个问题不该在这个会上回答,至少不该用"省多少停机时间"来回答。
能省多少,取决于停机原因补齐了没有、提示有没有人用、复核流程走不走得完。这三个变量在不同厂里差别极大,提前给出的任何数字都只是猜。
更要紧的是没有基线。原因没补齐之前,厂里连"同一类原因停过多少次、每次多久"都说不出来。没有这个底,减了多少无从对比。
值得盯的是三个观察维度,以试运行验证为准:误报能不能被复核,提示有没有被采纳,停机记录有没有被补齐。三个维度都在往上走,说明这件事在扎根;有一个连着半年不动,钱就先别追加。
至于大模型该站的位置,不在报警那一层,在把散着的东西串起来这一层。
设备日志、报警记录、维修工单,过去分在三套系统、三个部门手里。当班交接靠口头,夜班发生过什么,白班班长只能翻记录本、挨个问人。把这三样按时间线串起来,写成一份人能在三分钟内读完的当班交接,正是企业专属知识库驱动的大模型应用与决策能力可以承担的事。
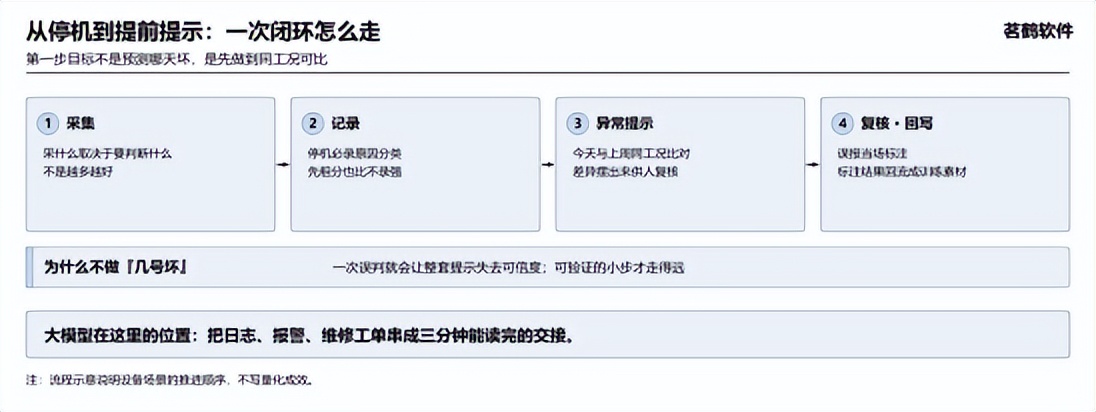
*图2:一次异常提示的闭环(流程示意)*
这一步在现场最容易接受,因为它不指挥任何人干活,只是让人少跑两个部门、少问三个人。看的人能不能在三分钟内说出今晚要盯哪几台,比什么指标都直接。
顺序走完,再回头看部长第一句,答案就换成另一个问法了。
厂里上一次停机,原因写下来了吗?是谁写的,写在哪套系统里,今天还有没有人能把它翻出来,跟下一次可能的异常对上?
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号