省下 30% 的 Flink 算力,作业帮靠的不是扩缩容,是跨池调度
原创
省下 30% 的 Flink 算力,作业帮靠的不是扩缩容,是跨池调度
原创
Lethehong
发布于 2026-11-16 21:04:54
发布于 2026-11-16 21:04:54
自动扩缩容只解决单池内的峰谷,跨池调度才动到资源归属。这篇讲清三件事,调度决策读哪些字段,迁移作业时哪一步最容易把状态搞坏,以及今天就能照着做的核对顺序。
图 1 本文配图:文章主题场景示意
30% 不是扩出来的,是挪出来的
先说结论,作业帮这次省下的 30% 计算资源,公开描述里落点在跨池调度,不在自动扩缩容。
这两件事经常被混着讲。自动扩缩容是在一个资源池里加减 TaskManager,池子的边界不动。跨池调度是把作业从 A 池搬到 B 池,动的是资源归属本身。
为什么后者更省。因为线上 Flink 集群的常态不是总量不够,是分布不均。有的池子白天打满,夜里空转,有的池子反过来。单池扩缩容只能削自己那座山的尖,削不掉两座山之间的落差。
我第一次看到这个说法时愣了一下。大家谈 Flink 降本,默认路径是调并行度、换资源规格、上弹性伸缩,很少有人把「作业搬家」当成一等手段。
但仔细想,这很合理。资源节省的分母是整个集群的 CPU 和内存占用,分子里真正浪费的部分,很大一块来自作业被钉死在一个池子里。
所以这篇我不打算复述他们做了哪些模块。公开信息给的是方向,不是实现。我要做的是把跨池调度这条链路上,哪些环节最容易出问题讲清楚。
因为一旦你决定让作业跨池迁移,风险面就从「资源够不够」变成了「迁移过程中状态对不对」。这是两种完全不同的故障模式。
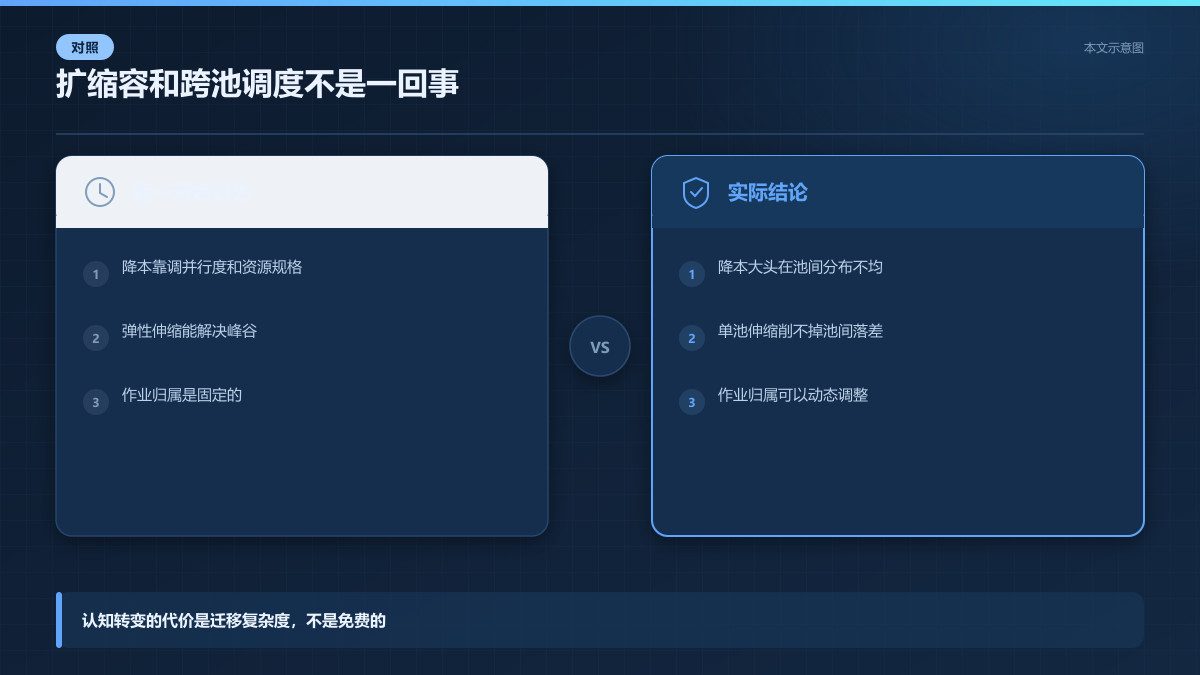
图 2 本文示意图:左边是池内削峰,右边是池间搬作业,风险面完全不同
问题不在调度器,在它读的那几个字段
跨池调度的核心是一个决策函数。输入是集群状态,输出是「这个作业该去哪个池」。听着简单,坑全在输入里。
一个 Flink 作业的调度决策,至少要看这几类字段,作业当前的资源需求(slot 数、内存规格)、所在队列的配额余量、目标池的空闲容量、作业的优先级和 SLA 等级。
问题在于,这些字段的来源不统一。资源需求来自 JobManager 的调度视图,队列配额来自 YARN 或 K8s 的队列管理器,池容量来自资源池的监控采集。三个数据源,三种刷新频率。
如果调度器在决策时读到的是过期快照,就会出现「以为 B 池有空位,搬过去发现没有」的情况。这不是调度逻辑写错了,是决策依据的时效性没对齐。
更麻烦的是配额这一层。Flink on YARN 的场景下,队列配额是硬约束,作业提交时如果目标队列的 vcore 或 memory 不够,提交会直接失败。
而跨池调度往往是在作业运行中触发的。这时候你不是提交一个新作业,是让一个正在跑的作业迁移。迁移的语义在不同部署模式下完全不同。
这里有个关键区别我想单独说。Flink on K8s 的迁移,本质是停掉旧 TaskManager、在新池拉起新的,状态靠 checkpoint 恢复。Flink on YARN 的迁移,涉及 ApplicationMaster 的重新分配,链路更长。
两种模式下,调度器需要读的字段不一样,失败后的回滚路径也不一样。如果一套调度逻辑同时覆盖两种部署模式,字段映射这一层就是最容易埋雷的地方。
我推测作业帮的方案里,调度决策和作业迁移是解耦的两个模块。理由是公开描述里把「跨池调度」和「资源节省」放在一起讲,但没有提迁移过程本身。这说明调度是主线,迁移是执行层。
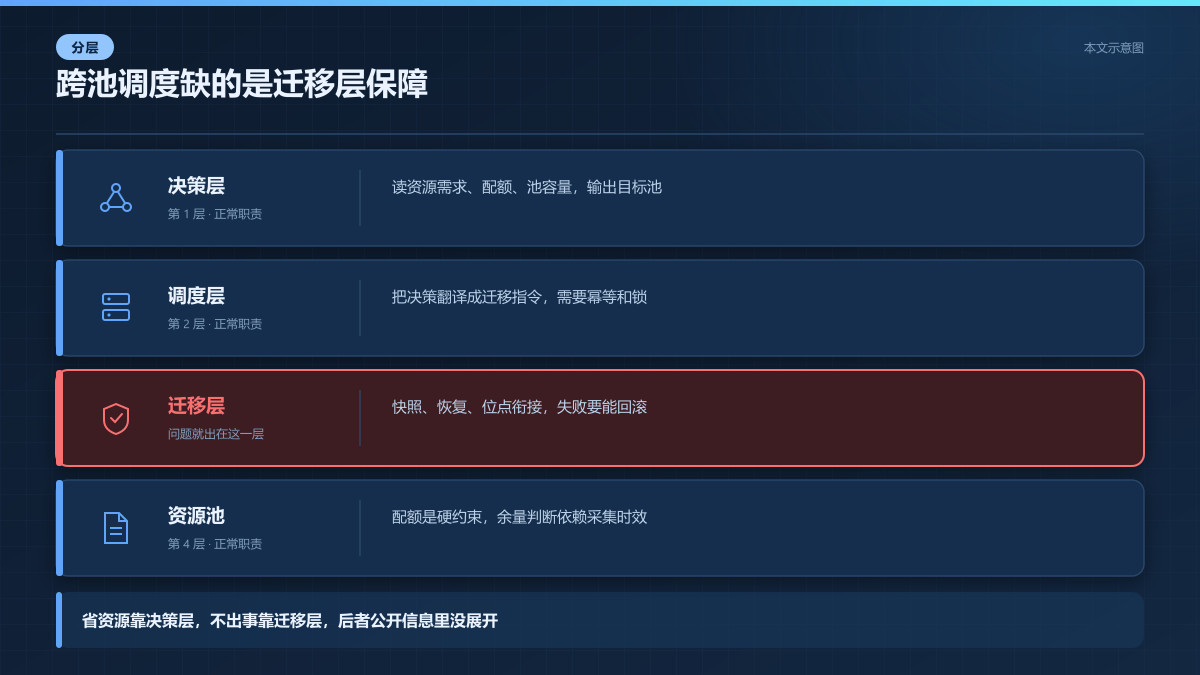
图 3 本文示意图:调度决策和作业迁移是两层,坑主要落在迁移执行这一层
这个推测有依据,但不确认。公开信息没有披露他们的调度器是自研还是基于某个开源组件改造,也没有说决策周期是分钟级还是小时级。
迁移那一步,状态才是真正的赌注
假设调度器已经决定把作业 X 从池 A 挪到池 B。接下来发生的事,决定了这次迁移是省钱还是事故。
第一步是触发 savepoint 或 checkpoint。Flink 的跨池迁移必须依赖状态快照,否则有状态作业搬过去就是从头算。
这里第一个坑是快照的完整性。如果作业正在处理大量状态,savepoint 可能耗时几分钟甚至更长。这段时间里作业是暂停的,SLA 会抖。
第二个坑是快照的兼容性。目标池的 Flink 版本、状态后端配置必须和源池一致,否则快照恢复会失败。版本不一致的情况下,迁移等于重跑。
第三个坑最隐蔽,是水位线(watermark)和事件时间的连续性。有状态作业迁移后,如果 source 的消费位点没有正确衔接,会出现数据重复或丢失。
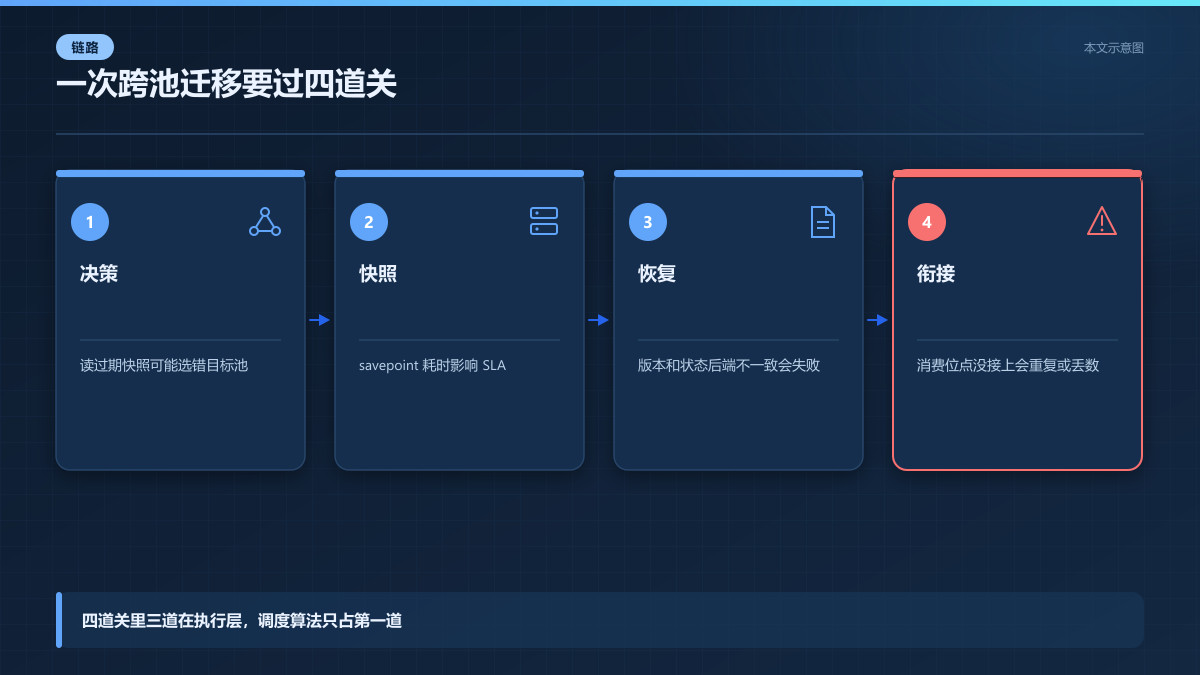
图 4 本文示意图:从调度决策到作业在新池跑起来,每一步都有独立的失败可能
这三个坑的共同点是,它们都不在调度器的决策逻辑里,而在迁移的执行路径上。调度器算得再准,执行层出问题,省下的资源还不够赔故障的。
所以我的判断是,跨池调度这件事,真正的工程量不在调度算法,在迁移的幂等性和可回滚性。
什么叫幂等。同一个作业被调度两次,结果应该一致,不能出现两个实例同时跑的情况。这需要迁移过程中有一个明确的锁或者状态机。
什么叫可回滚。迁移到一半失败,作业要能回到原池继续跑,而不是卡在中间态。这需要迁移前保留原池的资源预留,直到新池确认就绪。
公开描述里没有提这两点。我不知道作业帮是怎么处理的,但这是任何做跨池调度的团队都绕不开的问题。
推演迁移决策顺序(示意代码,把调度决策到迁移执行的调用顺序写出来,暴露时效性和幂等问题)
def migrate_job(job, target_pool, state_store):
    # 第一步,确认目标池容量,注意这里读的是采集快照,可能过期
    if not target_pool.has_free_capacity(job.resource_need):
        return {"ok": False, "reason": "target pool capacity stale or insufficient"}

    # 第二步,加迁移锁,保证同一个作业不会被并发调度两次
    if not state_store.acquire_lock(job.id):
        return {"ok": False, "reason": "job already migrating"}

    try:
        # 第三步,触发 savepoint,这一步耗时取决于状态大小
        snapshot = job.trigger_savepoint()
        if snapshot is None:
            return {"ok": False, "reason": "savepoint failed"}

        # 第四步,校验版本和状态后端兼容性,不一致直接放弃
        if not target_pool.compatible_with(snapshot):
            return {"ok": False, "reason": "version or state backend mismatch"}

        # 第五步,在新池恢复,失败则回滚到原池
        restored = target_pool.restore(snapshot)
        if not restored:
            job.resume_in_origin_pool()
            return {"ok": False, "reason": "restore failed, rolled back"}

        return {"ok": True, "pool": target_pool.name}
    finally:
        state_store.release_lock(job.id)
同类组件的通用规律是,迁移类操作的第一版通常只保证「能搬过去」,幂等和回滚是第二版才补的。如果你的团队正在做类似的事,建议一开始就把回滚路径设计进去。
想自己动手,先量三个数再谈调度
如果你的集群也有资源分布不均的问题,想参考这个思路,我建议先别急着写调度器。先量三个数。
第一个数,每个资源池的日峰谷比。如果所有池子的峰谷曲线形状一样、时间一样,跨池调度省不了多少,因为大家同时忙同时闲。
第二个数,作业在池间的可迁移比例。有状态作业、依赖本地盘的作业、绑定了特定节点的作业,迁移成本高,不一定值得搬。
第三个数,迁移一次的平均耗时和失败率。这个数决定你的调度周期能设多短。如果一次迁移要十分钟,调度周期设成五分钟就没有意义。
这三个数量出来,你才能判断跨池调度对你的集群是不是真能省 30%。作业帮的 30% 是在他们的作业结构下测出来的,不能直接套。
量完之后如果决定做,落地顺序我建议是,先做调度建议(只告警不执行),再做人工触发的迁移,最后才做自动调度。
每一步都留观察期。调度建议阶段看的是决策准不准,人工迁移阶段看的是执行稳不稳,自动调度阶段才谈得上省了多少。
跳过前两步直接上自动调度,出问题时你连是决策错了还是执行错了都分不清。
今天就能做的核对,不用等调度器
不管你打不打算做跨池调度,有几件事今天就能做,而且和这个思路直接相关。
第一件,把你所有 Flink 作业的部署模式、状态后端、Flink 版本列出来。这张表是任何迁移类操作的前提,没有它,迁移的兼容性判断无从谈起。
盘点作业部署模式(示意代码,列出所有 Flink 作业的部署模式和版本,迁移兼容性判断的前提)
#!/usr/bin/env bash
# 盘点集群内 Flink 作业的部署模式与版本,迁移前必须先有这张表
set -euo pipefail

# 按你的环境替换成实际的 REST 入口
FLINK_JM=""

jobs=$(curl -s "${FLINK_JM}/jobs/overview" | jq -r '.jobs[] | [.jid, .name, .state] | @tsv')

printf '%-40s %-30s %-10s\n' "JOB_ID" "NAME" "STATE"
while IFS=$'\t' read -r jid name state; do
  printf '%-40s %-30s %-10s\n' "$jid" "$name" "$state"
done <<< "$jobs"

# 单独确认版本,跨池迁移要求源池和目标池版本一致
curl -s "${FLINK_JM}/config" | jq -r '.flink-version // "unknown"'
第二件,检查每个资源池的队列配额是否和实际使用匹配。很多集群的配额是半年前设的,作业结构早就变了,配额却没动。跨池调度能省资源,前提是目标池的配额真的有余量。
第三件,确认你的 checkpoint 和 savepoint 路径是共享存储。如果每个池的存储是独立的,跨池迁移时快照拿不到,整个方案就不成立。
这三件事都不需要写代码,但它们是跨池调度的地基。地基不平,上面的调度逻辑写得再漂亮也白搭。
过渡方案也有。如果短期内做不了跨池调度,可以先做池内的工作负载再平衡,把大作业和小作业混排,减少单池内的峰谷差。效果不如跨池,但改动小得多。
我没查到的,和我不确定的
这篇的分析建立在公开描述的方向上,具体实现细节我没有渠道确认。
作业帮的调度器是自研还是基于开源组件,公开信息未披露。调度决策的触发条件是定时还是事件驱动,也未披露。
30% 这个数字的统计口径我不清楚。是 CPU 核数、内存用量,还是折算后的成本,三种口径的含金量不一样。
迁移过程中的 SLA 影响,公开描述里没有提。跨池调度如果带来延迟抖动,省下的资源和损失的体验之间怎么权衡,这是每个团队要自己算的账。
我的推断部分,调度与迁移解耦、迁移是执行层,这两条是基于公开描述的合理推测,不是确认的事实。
同类组件的通用规律那一段,是我从 Flink 迁移类操作的常见问题里归纳的,不针对作业帮的具体实现。
如果后续有更详细的实现披露,关于迁移幂等性和回滚路径的判断可能需要修正。
省资源的尽头,是承认作业不该被钉死
这件事真正有意思的地方,不是 30% 这个数字,是它背后的一个认知转变。
过去的思路是,作业属于某个池,池子不够就扩池子。现在的思路是,作业属于整个集群,池子只是当前落脚点。
这个转变一旦发生,资源管理的重心就从「容量规划」移到了「调度策略」。容量规划是静态的,调度策略是动态的。
但动态的代价是复杂度。静态规划下,一个作业的资源归属是确定的,出问题好排查。动态调度下,作业可能今天在这个池、明天在那个池,可观测性要跟上。
所以跨池调度不是一个纯降本手段,它是一次运维模式的升级。省下的 30% 是收益,配套的调度可观测性、迁移回滚机制、SLA 监控是成本。
这笔账划不划算,取决于你的集群规模和作业结构。小集群做跨池调度,收益可能还不够覆盖复杂度。
但如果你的集群已经大到池间分布明显不均,那这件事迟早要做。早做的好处是,你还有时间把回滚路径设计对。
写在最后
跨池调度省的每一分资源,都是从「作业必须待在一个固定池子」这个假设里抠出来的。假设一旦松动,省下的钱和新增的复杂度就得一起算。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号