多智能体编排:Supervisor、Router 与 Subagent
原创
多智能体编排:Supervisor、Router 与 Subagent
原创
老周聊架构
发布于 2026-11-17 12:56:49
发布于 2026-11-17 12:56:49
把三个模型拼在一起,不叫多智能体。多智能体的本质只有八个字:分而治之、控制流。把一个复杂任务拆给专精的子 agent,再交给一个控制结构去协调调度,这才是它真正在解决的问题。很多人一上来就堆 agent,结果上下文互相污染、工具互相干扰、出了 bug 根本不知道该查谁。这篇文章我把三种主流编排模式讲透,并给你一张"该不该拆"的判断表,让你知道什么时候该上多 Agent,什么时候一根筋到底反而更省事。
先破除一个迷思:多 Agent 不是堆更多模型
最容易被误导的一点,是以为"多 Agent = 更强的模型"。不是。模型还是那些模型,真正变化的是控制流:谁决定下一步干什么、谁把结果交给谁、谁的上下文里装了什么。
单 Agent 系统里,规划、工具调用、记忆、输出全挤在一个 prompt 里。任务一复杂,上下文窗口被长文档、历史对话、工具回传、错误日志共同撑爆,有效信号被噪声淹没。更糟的是,几十个 tool 的描述同时躺在上下文里,模型容易张冠李戴——让它查数据库它去调了发邮件的接口,而且你事后很难排查是哪一段上下文诱使它犯错的。
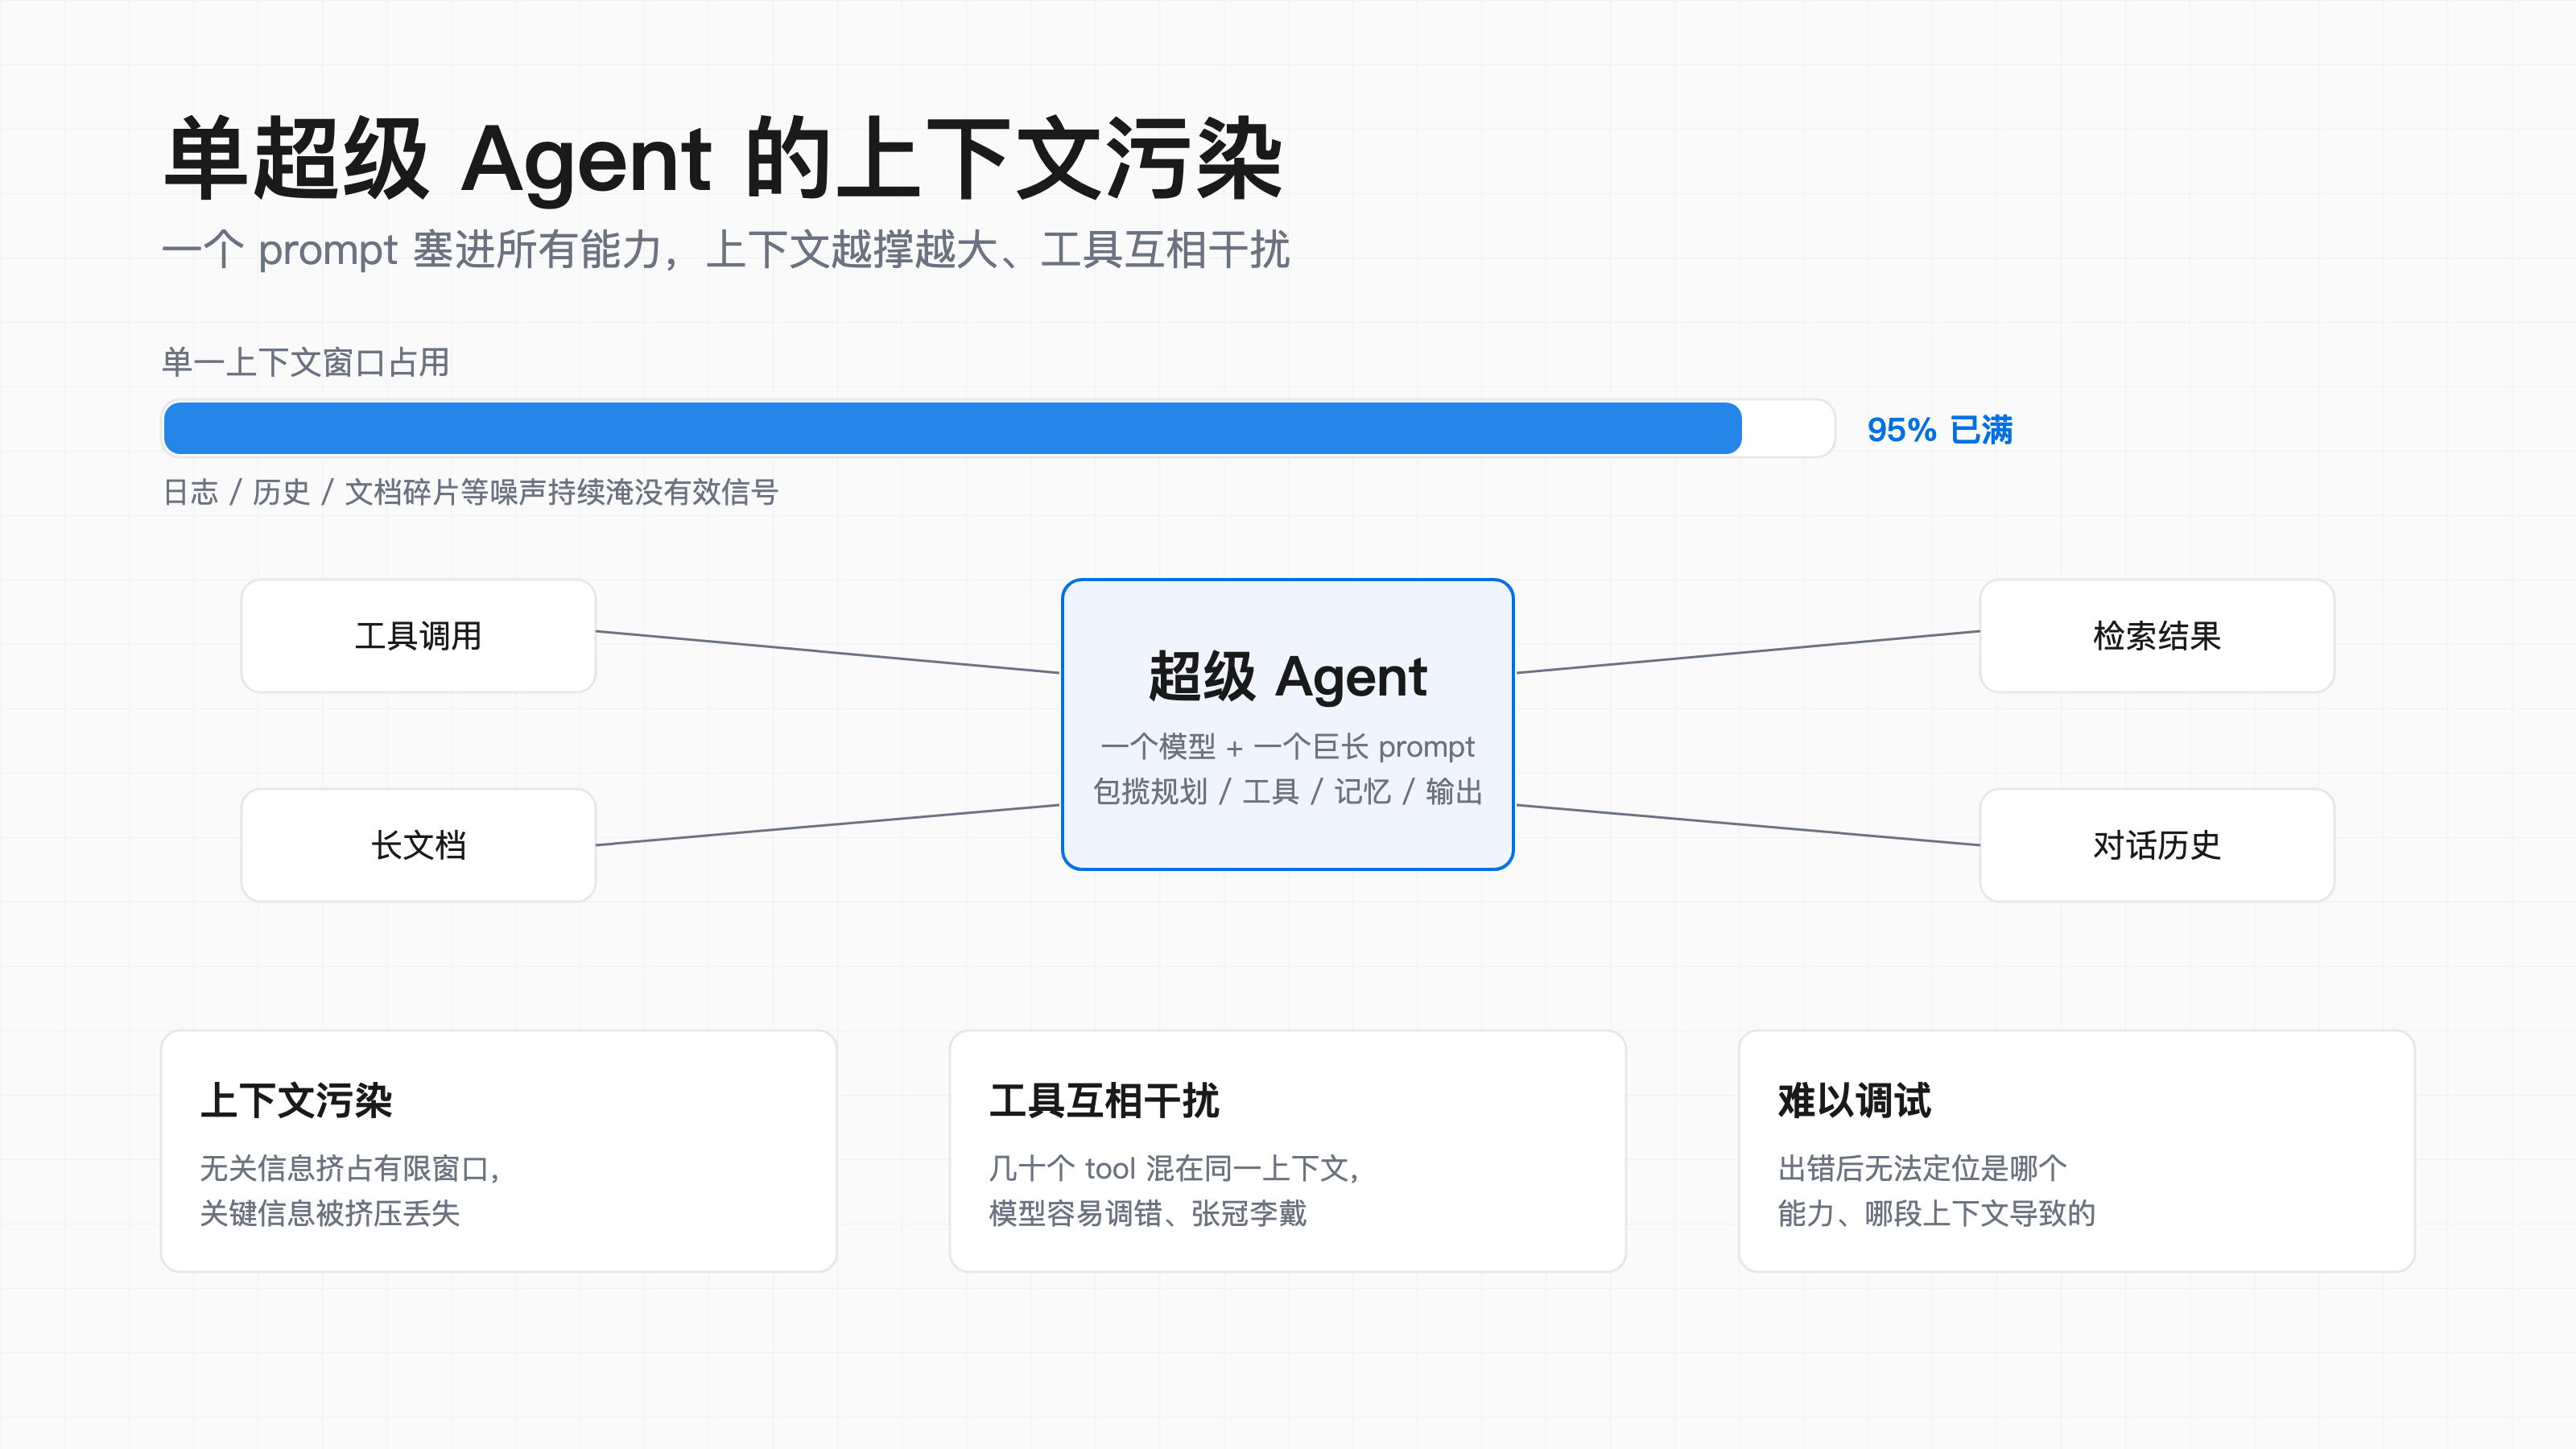
多 Agent 的解法不是"换个大模型",而是把异质的子任务拆出去,各自关进独立的上下文。主管负责编排,worker 负责执行,彼此之间不共享一池子上下文。下面三种模式,区别只在于"控制流长什么样"。
Supervisor:一个主管,N 个专精 worker
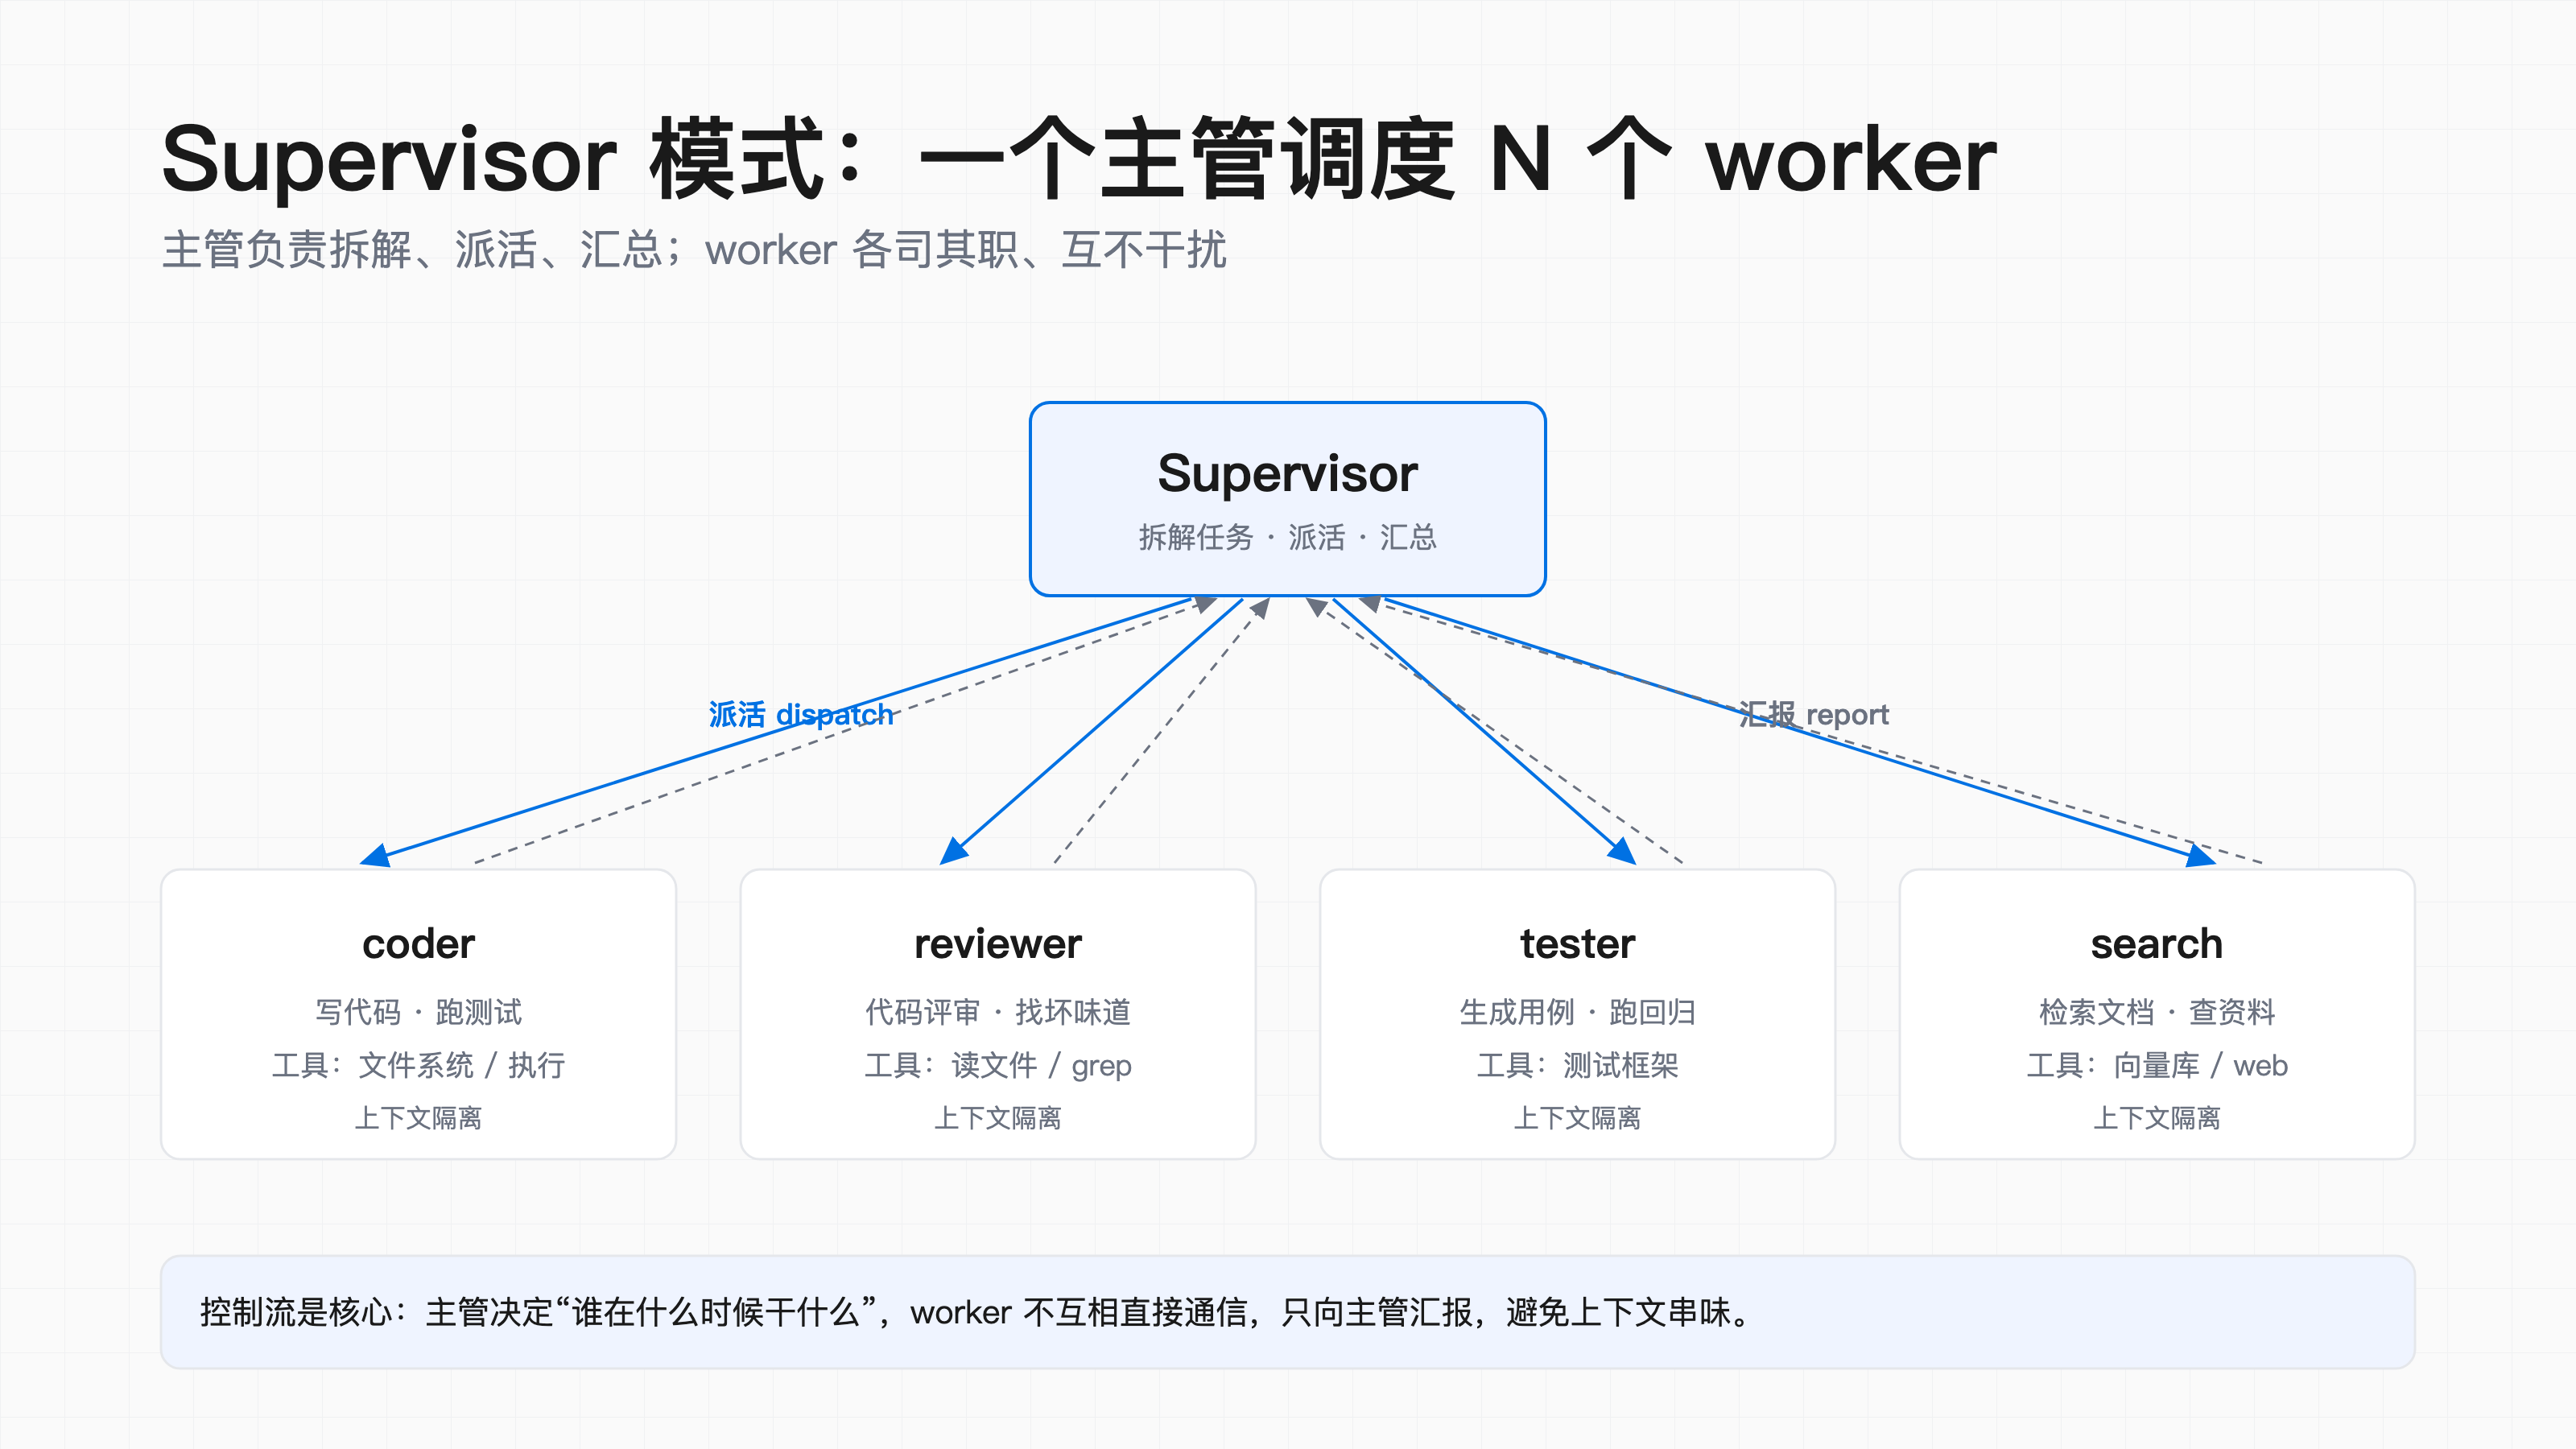
Supervisor 是最像"团队管理"的模式。一个主管 agent 站在最上层,底下挂 N 个专精 worker。主管不自己下场干活,它只做三件事:拆解任务、按需派活、汇总结果。
流程是这样的:用户请求进来,主管先理解意图,判断该派给谁。需要写代码就派给 coder,需要查资料就派给 search,需要评审就派给 reviewer。worker 干完各自汇报给主管,主管把多份产出综合成最终答案。关键在于——worker 之间不直接通信,只向主管汇报,各自的工具和数据互相隔离,不会出现上下文串味。
from langgraph.prebuilt import create_react_agent
from langgraph_supervisor import create_supervisor

# 1. 造专精子 agent:每个只懂一件事、只挂一类工具
def create_agent(name: str, model, tools: list, instruction: str):
    return create_react_agent(
        name=name,
        model=model,
        tools=tools,
        prompt=instruction,
    )

coder = create_agent(
    "coder",
    model="claude-sonnet-4-6",
    tools=[read_file, run_shell],
    instruction="你是编码 agent,只负责写代码、跑测试,不回答业务问题。",
)

reviewer = create_agent(
    "reviewer",
    model="claude-opus-4-6",
    tools=[read_file, grep],
    instruction="你是评审 agent,只负责找 bug 和坏味道,不修改代码。",
)

# 2. Supervisor:把多个 worker 编排成一个有控制流的系统
supervisor = create_supervisor(
    agents=[coder, reviewer],
    model="claude-opus-4-6",
    prompt=(
        "你是技术主管。收到任务后判断该派给 coder 还是 reviewer,"
        "收集他们的产出并汇总成最终交付,不要自己下场写代码。"
    ),
).compile()

result = supervisor.invoke({"messages": "给登录接口加单元测试,并做一次评审"})
Supervisor 最适合"一个请求需要多工种接力"的场景,比如 coding agent 写完,review agent 审,test agent 跑回归,最后主管收口。它的代价是主管那一轮调度本身要消耗一次推理,且如果 worker 太多,主管容易"派错活"。
Router / Dispatcher:按输入类型分诊
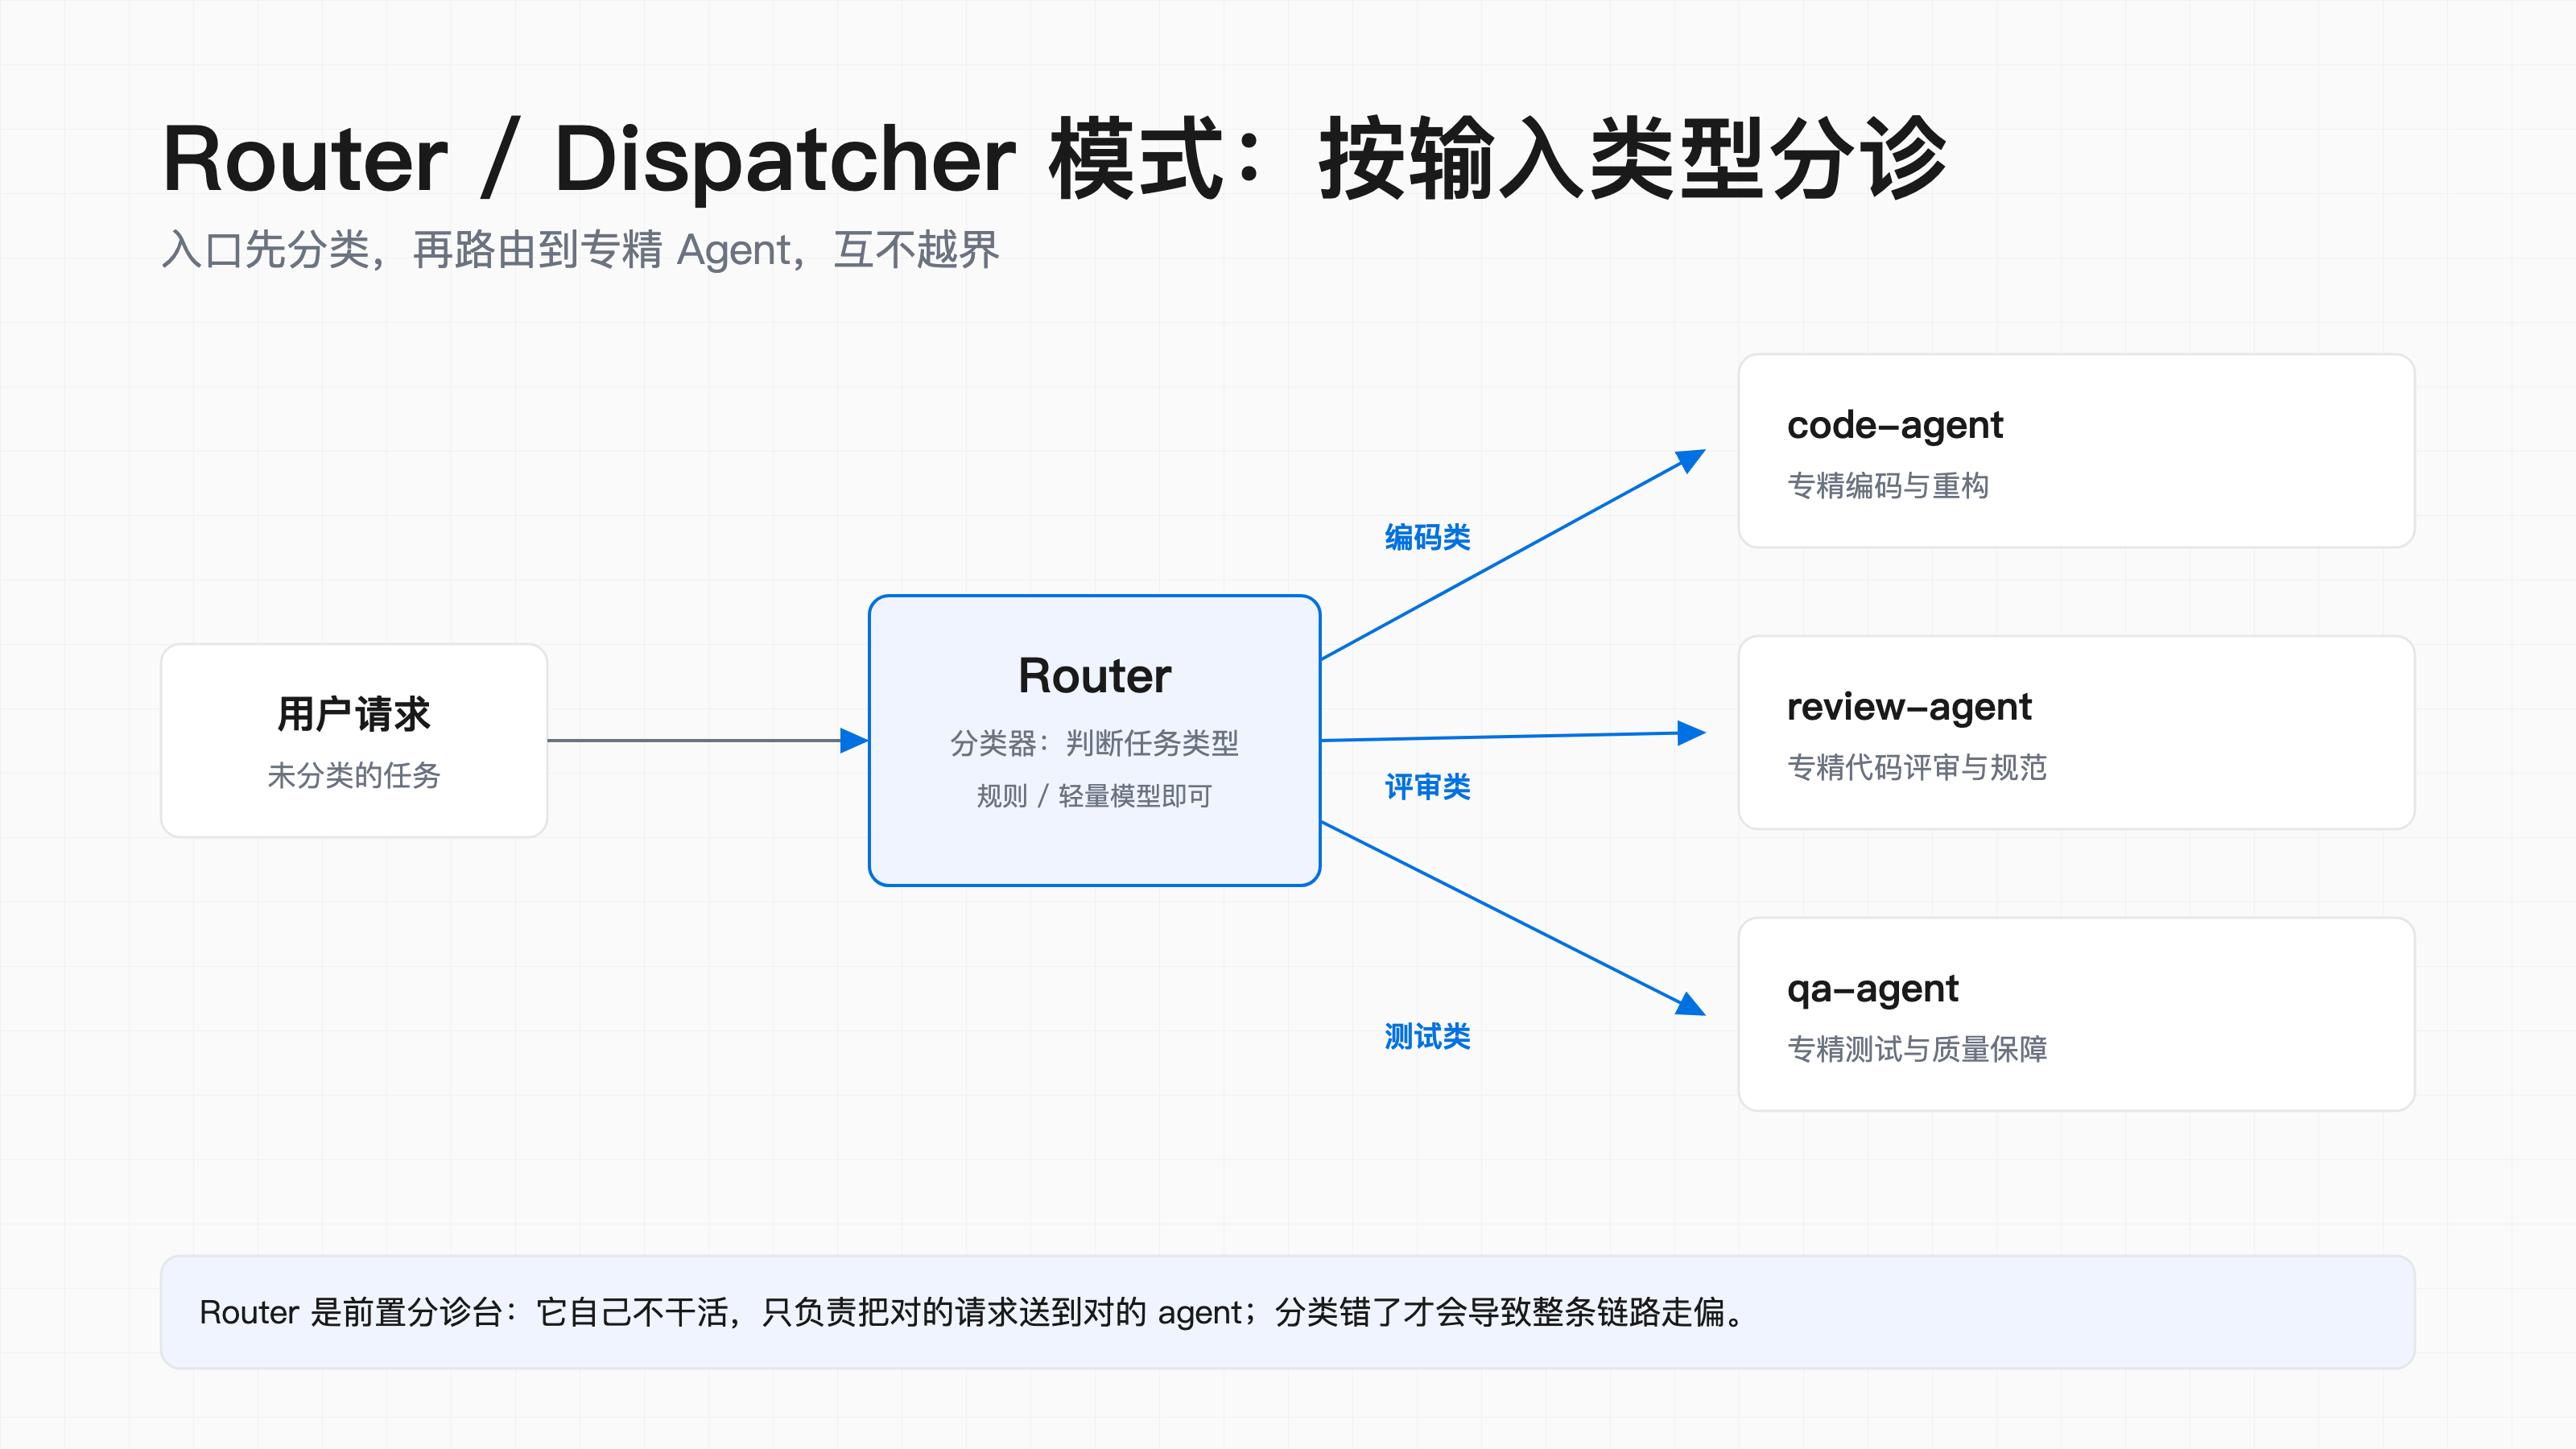
Router 模式不养一个万能主管,而是前置一个分诊台。请求一进来先分类,判断它属于哪一类,再精准路由到对应的专精 agent。编码类去 code agent,评审类去 review agent,质量类去 qa agent——各走各的道,互不了解彼此。
它和 Supervisor 的本质区别在控制流的位置。Supervisor 的主管是"动态决策":同一个请求可能先派 A 再派 B,顺序由主管临场决定。Router 则是"静态分流":分类规则一旦定好,请求走哪条路基本是确定的,不依赖主管的每一轮推理。所以在 Router 里,分类器甚至可以不是一个 LLM,而是一段规则或轻量分类模型,成本低、延迟稳。
# Router:入口先分类,再精准路由(分类器未必需要是 LLM)
def route(task: str):
    kind = classify(task)          # 轻量分类:规则 / 小模型即可
    if kind == "code":
        return coder.invoke({"messages": task})
    if kind == "review":
        return reviewer.invoke({"messages": task})
    return generalist.invoke({"messages": task})
Router 的弱点是"分类错了就全错"——它把赌注压在入口分类的准确性上。如果任务类型边界模糊(一个请求里既有编码又有评审),硬路由就会顾此失彼,这时候就该退回到 Supervisor 的动态调度。
Subagent:主 Agent 临时派个分身去深挖
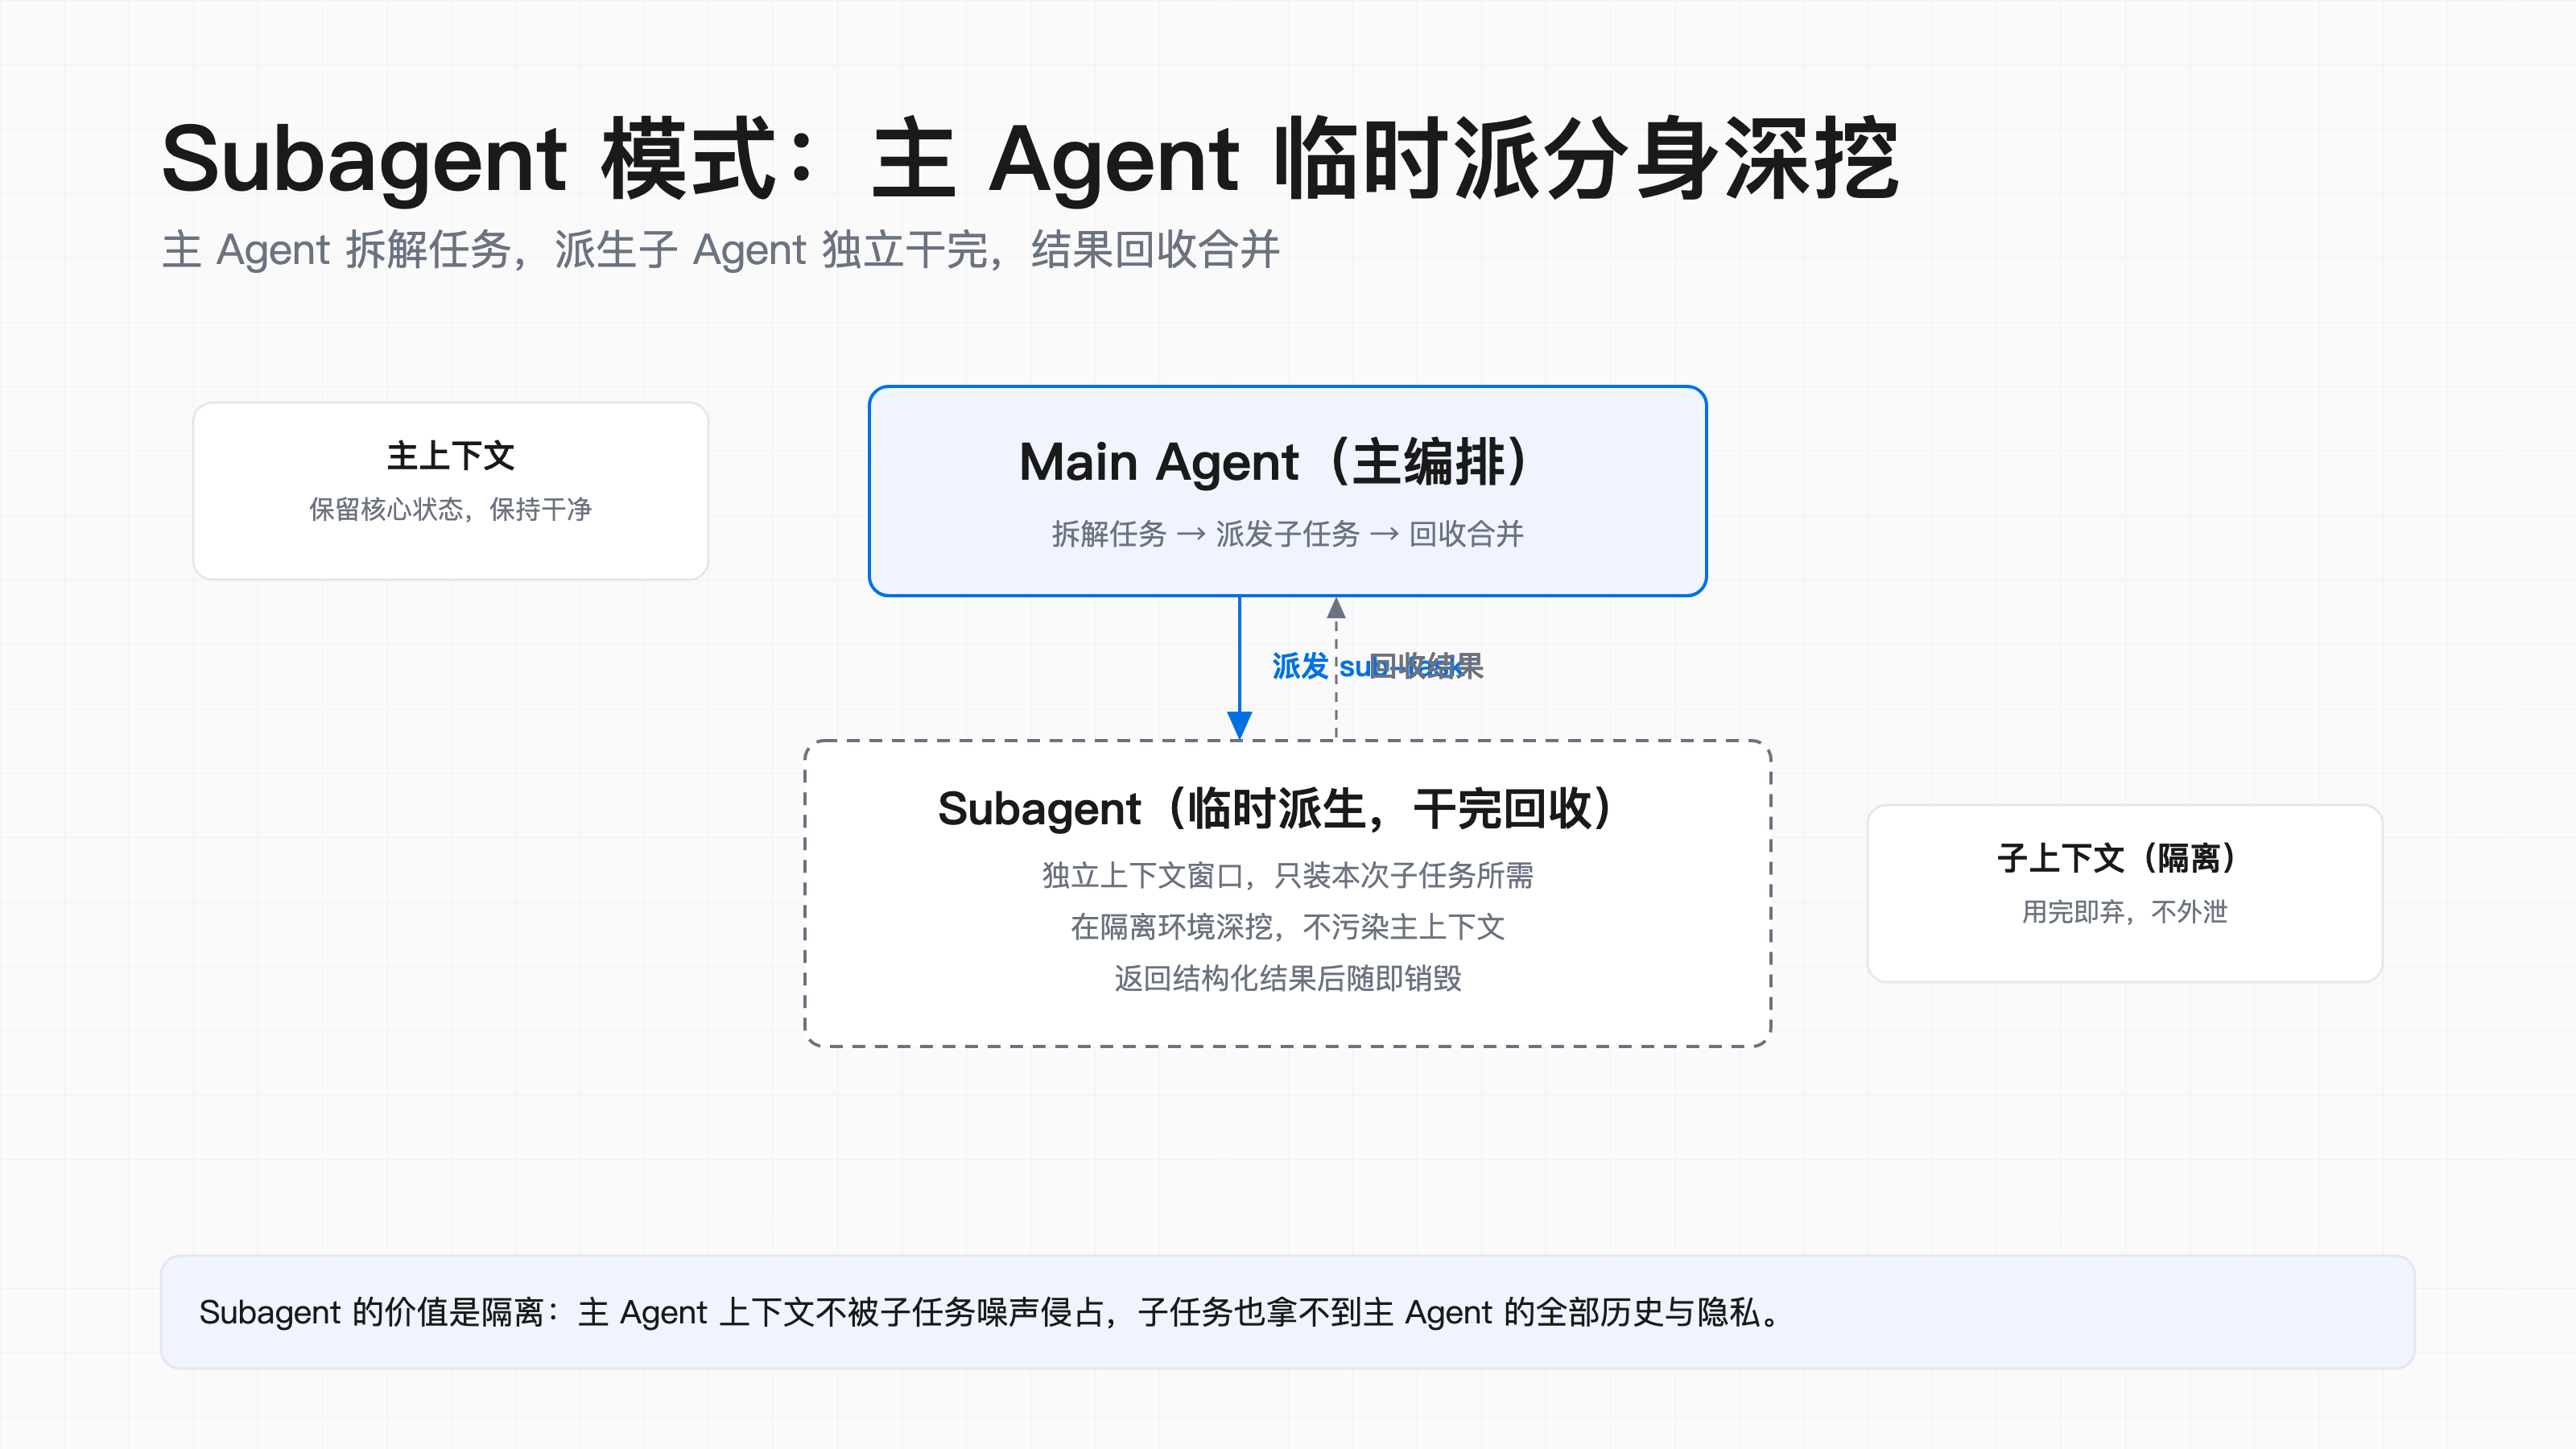
Subagent 是解决"上下文撑爆"最干净的一招。主 Agent 接到大任务后,临时派生一个子 Agent,只给它本次子任务所需的上下文,让它在隔离环境里深挖,干完把结构化结果交回来,随即销毁。子 Agent 的垃圾不产生在主 Agent 的上下文里。
这跟 Supervisor 不同:Supervisor 的 worker 是常驻编制,任务来了派活;Subagent 是按需临时生成,用完即弃。想象主 Agent 要写一份竞品分析报告,它不必把十个竞品的资料全塞进自己窗口,而是派十个 subagent 各读一个,各自返回摘要,主 Agent 只合并这十段摘要。主上下文始终是干净的。
# Subagent:主 agent 临时派生,干完回收,隔离上下文
def solve(task):
    plan = main_agent.plan(task)             # 主 agent 拆解
    for sub in plan.subtasks:
        sub_result = spawn_subagent(         # 临时派生,独立上下文
            task=sub,
            context=plan.shared,
            tools=[web_search, deep_read],
        ).get()                              # 只拿回结构化结果
        plan.shared = merge(plan.shared, sub_result)
    return main_agent.synthesize(plan.shared)
Subagent 的价值核心就在隔离二字:主 Agent 上下文不被子任务噪声侵占,子任务也拿不到主 Agent 的全部历史与隐私。代价是每次派生都有冷启动开销,子任务太碎反而会拖慢整体。
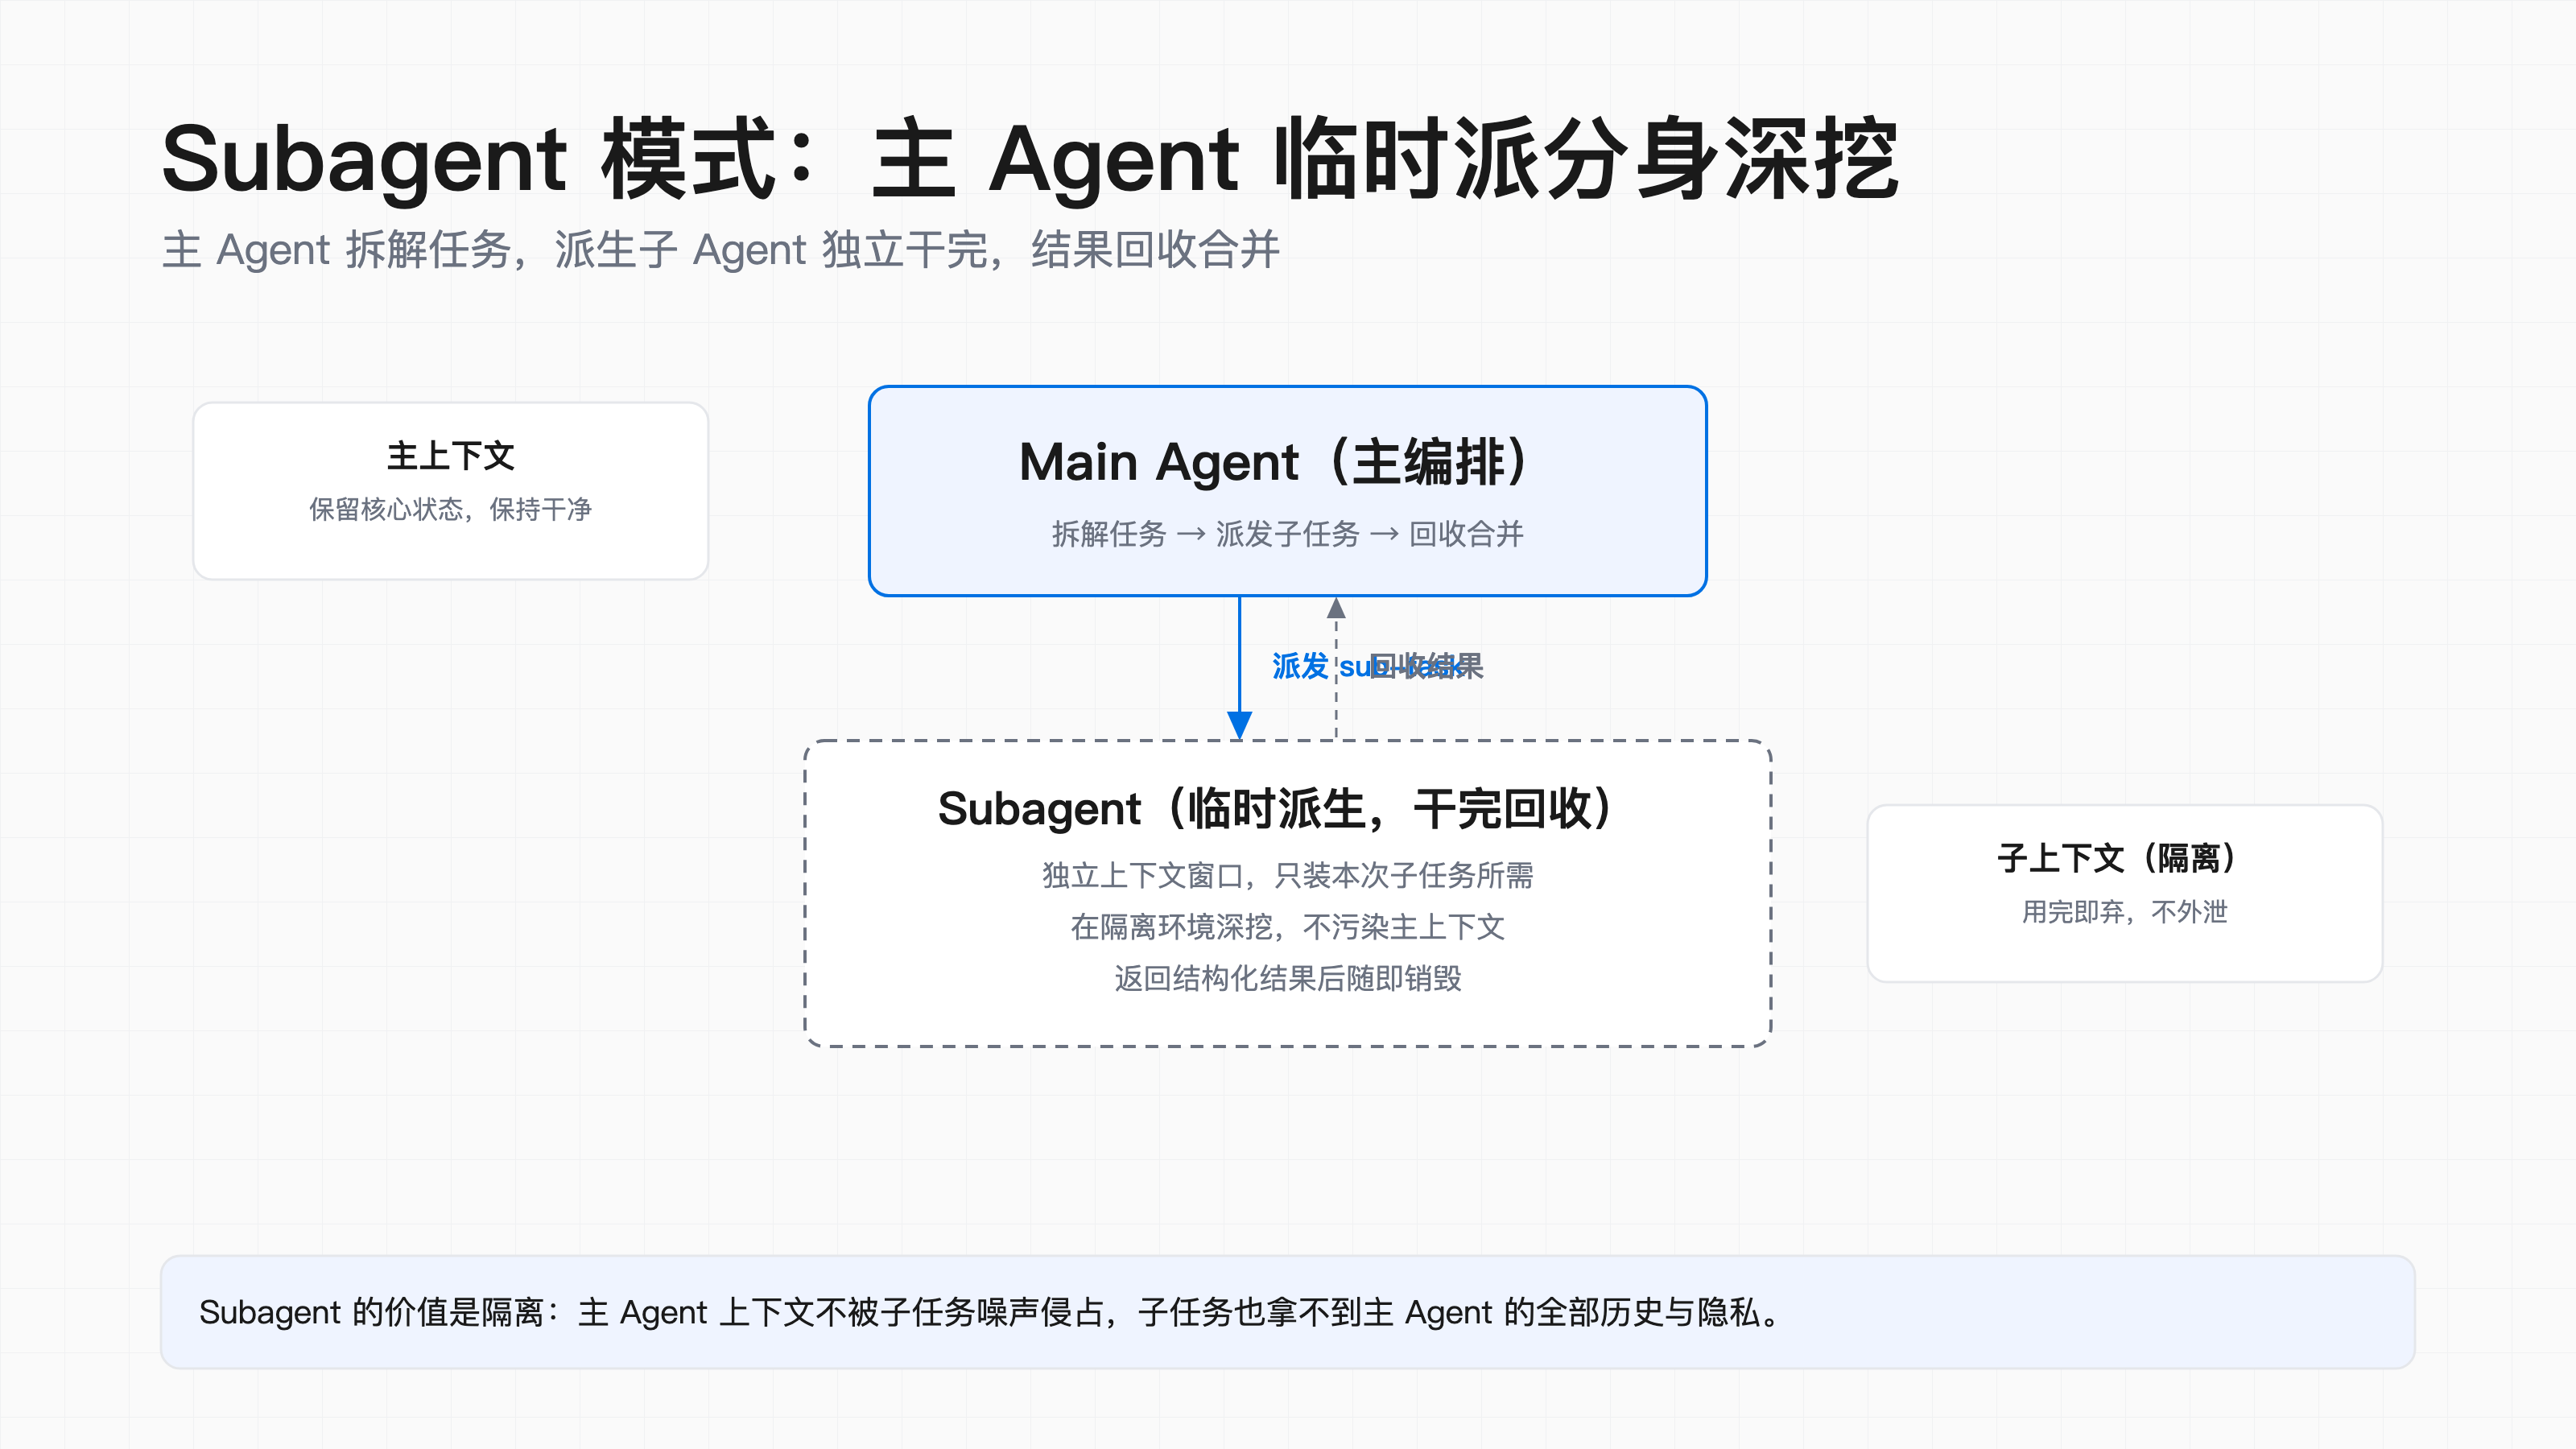
Subagent 由主 Agent 临时派生,在隔离上下文深挖后只回收结构化结果
反模式:什么时候不该上多 Agent
多 Agent 不是银弹。我见过太多团队为了"显得先进"硬上多 Agent,结果复杂度翻倍、延迟翻倍、调试成本翻倍,收益却看不见。下面这张判断表,比任何架构图都实用。
- 该拆 单 Agent 上下文被撑爆:窗口装不下全部状态,有效信号被噪声淹没
- 该拆 任务异质性强:规划、编码、检索、评审差异大,塞一个 prompt 必然互相干扰
- 该拆 需要权限隔离:不同工具或数据要求不同授权级别,必须分而治之
- 别拆 单 Agent 已够用:任务同构、上下文可控,加 Agent 只是徒增延迟和成本
- 别拆 盲目堆 Agent:没有清晰控制流,拆了却靠巧合协作,比单 Agent 更难排查
- 别拆 用多 Agent 掩盖单 Agent 的 prompt 设计问题:先写好 system prompt 和工具描述
一句话总结:多 Agent 解决的是"控制流与隔离"的问题,不解决"模型不够聪明"的问题。如果你的单 Agent 是因为 prompt 写烂、工具描述含糊才表现差,上十个 Agent 只会把混乱放大十倍。先问自己三个问题——上下文装得下吗?任务够异质吗?要隔离权限吗?任一命中就拆,全否就老老实实把单 Agent 调好。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号