LangSmith 评估:用 LLM 当评委量化质量
原创
LangSmith 评估:用 LLM 当评委量化质量
原创
老周聊架构
发布于 2026-11-17 13:04:24
发布于 2026-11-17 13:04:24
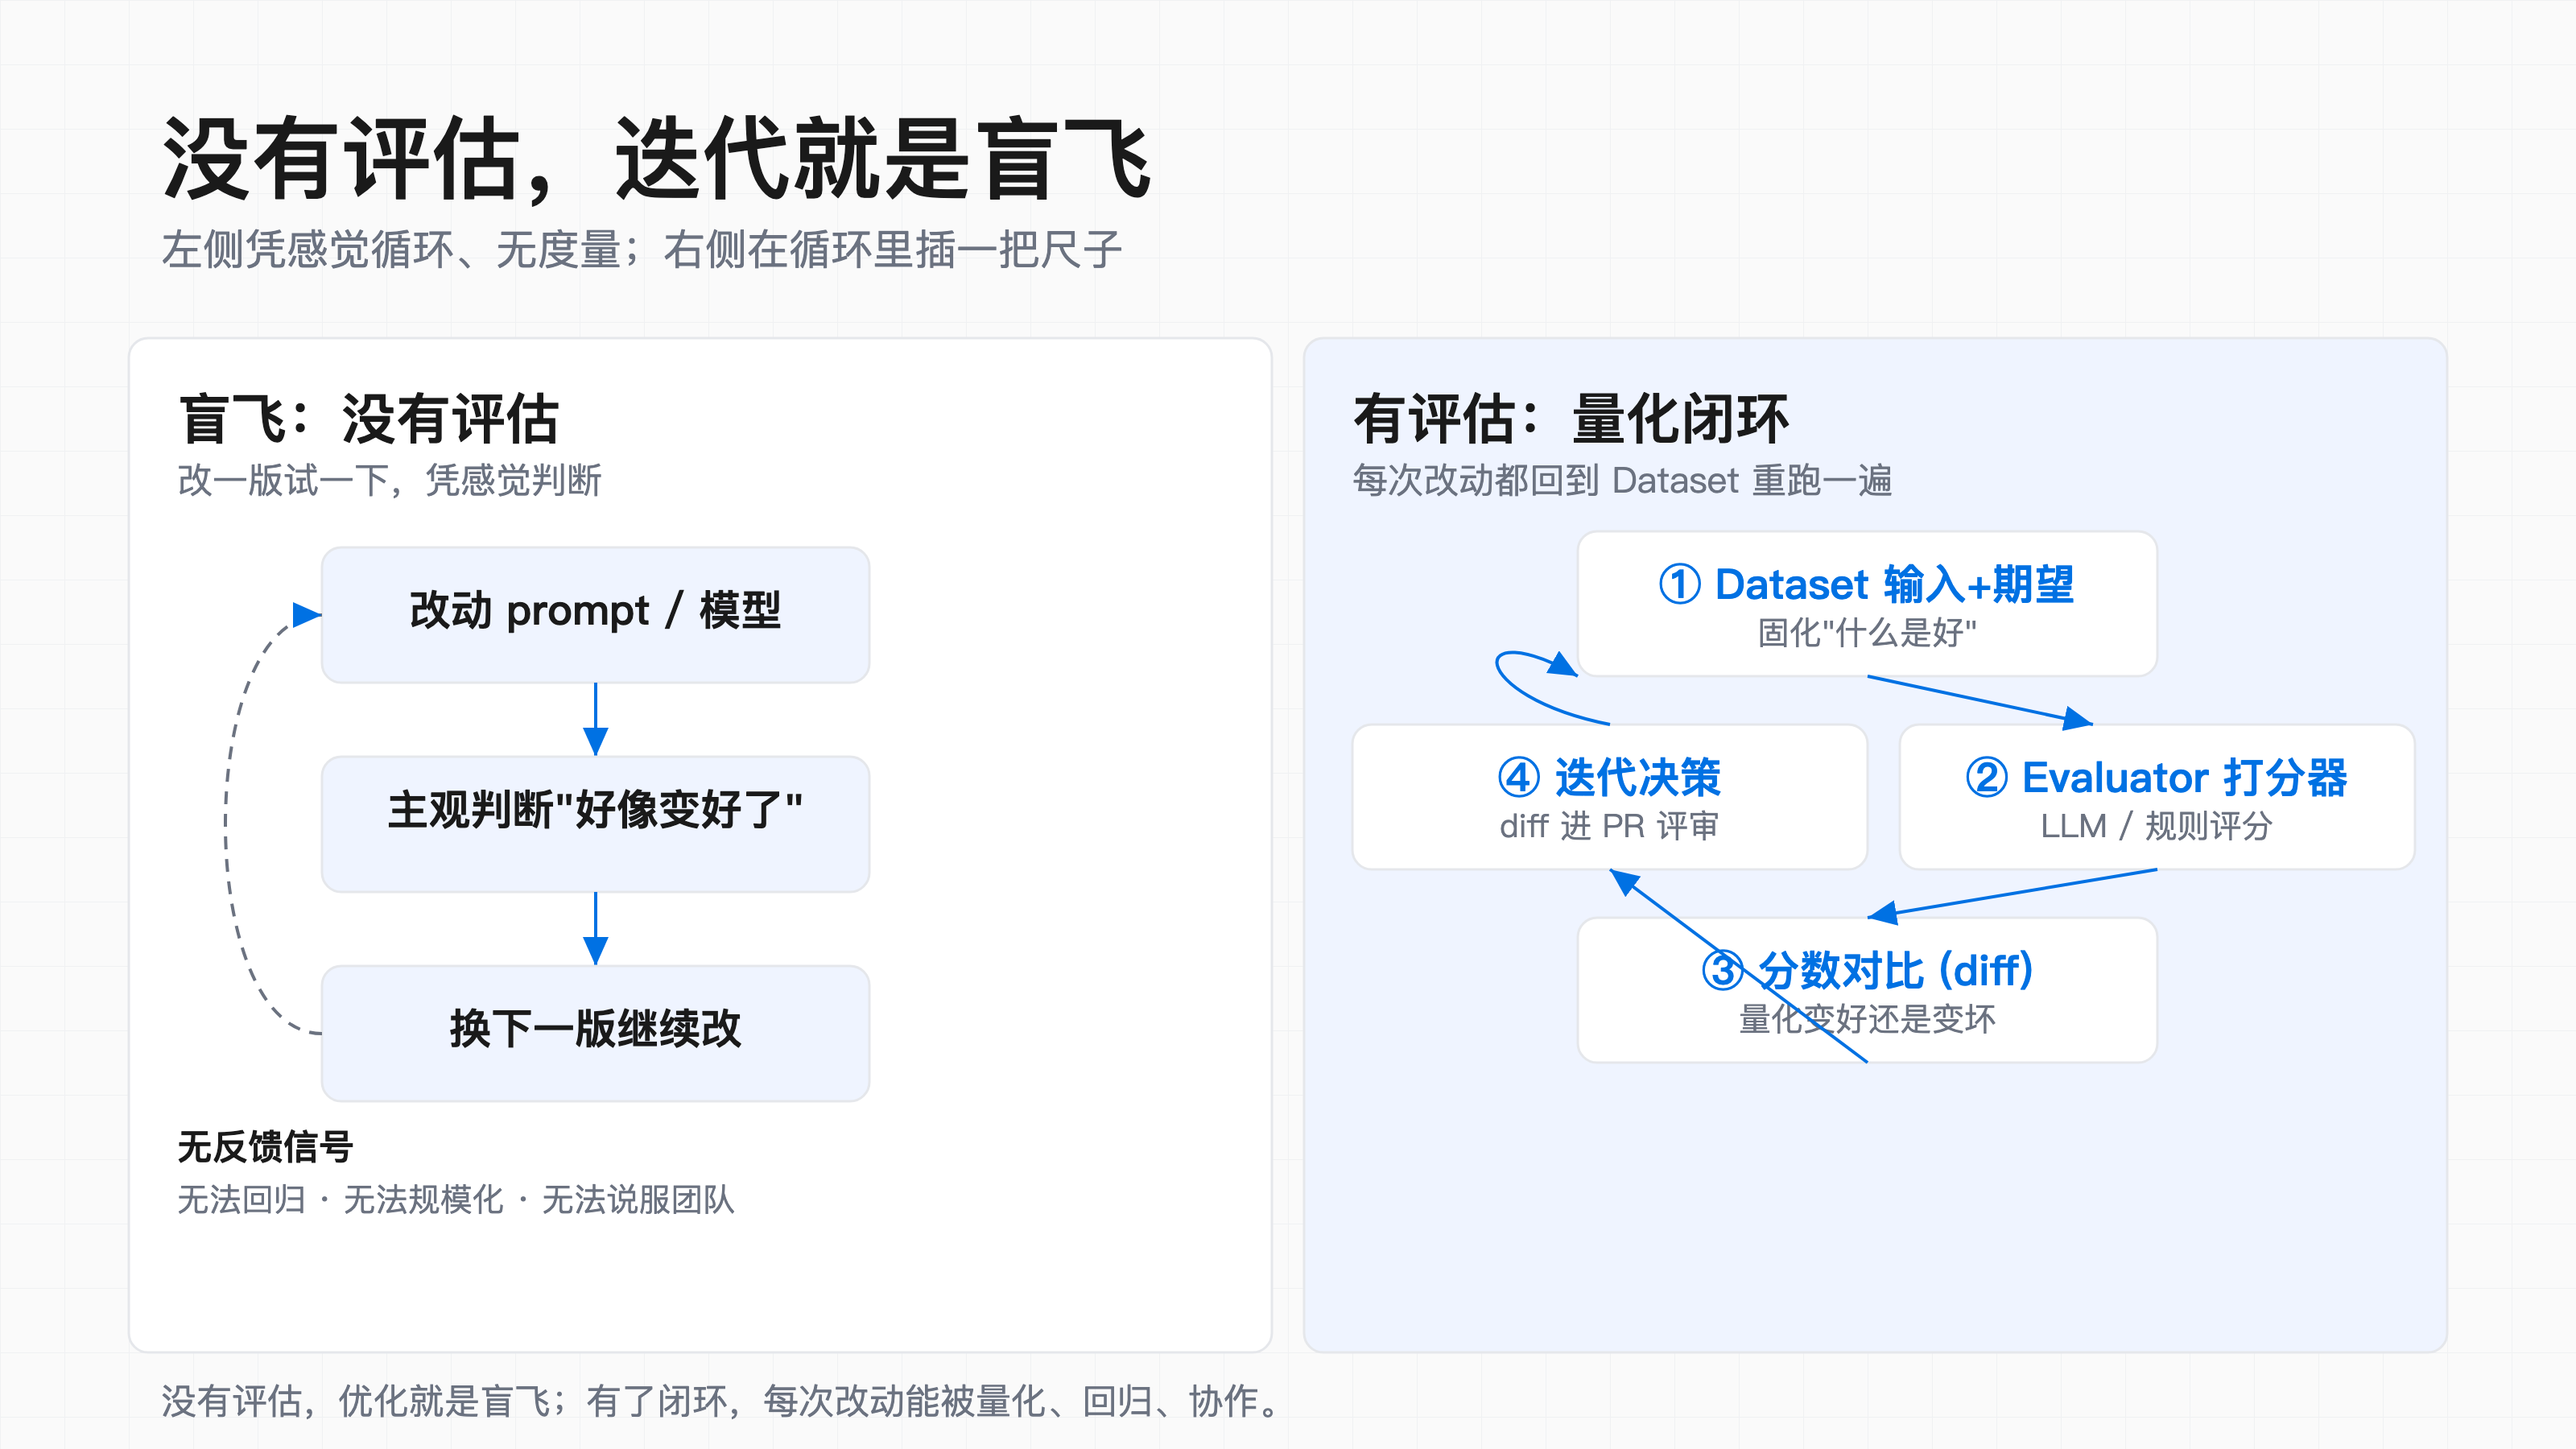
做 AI 应用最讽刺的事,是你花两周调 prompt,上线前拍胸脯说"效果明显好多了",别人问你"好在哪、好多少、哪几个 case 变好了",你答不上来。这几乎是绝大多数团队的真实状态。LLM 是概率系统,同一份输入两次采样可能给出不同答案,输出是开放文本,没有 oracle 可以硬编码期望输出。在这种系统上迭代,没有评估就等于在黑夜里调收音机——调一下听一下,自以为对准频率,其实只是噪声变了。LangSmith 评估解决的就是这件事:先把"什么是好"固化成数据集(输入加期望),再写打分器(evaluator)量化每次改动的变化。有了尺子,"这次改完变好还是变坏"就从玄学变成可回归、可 review、可说服团队的工程问题。这篇不讲功能清单,只讲透机制:为什么必须做、dataset 怎么建、LLM-as-a-judge 怎么跑、评委偏见怎么防、离线在线如何互补。
一、没有评估,迭代就是盲飞
把 LLM 应用跑通很容易,难的是回答两个朴素问题:它现在到底行不行,以及我改完之后有没有变差。确定性软件能靠单元测试把这两个问题答得明明白白,因为输入确定、输出确定、断言相等。LLM 这套逻辑彻底失效——输出是开放文本,行为依赖 prompt、上下文、工具返回,甚至同一份输入两次采样都能不一样。
评估的本质是造一把可重复的标尺。没有这把尺子,所有号称的"调优"都是黑暗里调收音机,调一下听一下,毫无积累。你以为某次改动让效果变好,可能只是那天测试的样本凑巧简单,或者评委(你自己)那天心情好。没有基线、没有分布、没有 diff,你就永远分不清"真变好"和"噪声波动"。
反例:只靠人工抽查几条,凭感觉说"效果好多了"
这是最典型的反模式,几乎每个团队都犯过。
- 抽查样本量太小 拿五六个例子手测一遍就宣布 OK,在统计上毫无意义。想以 95% 置信度检出 5 个百分点的成功率变化,两比例检验需要的样本量在几百条量级,eval 集的规模是被统计有效性逼出来的,不是拍脑袋定的。
- 无法回归 这次改完说"好了",下次改完又说"好了",两次之间到底谁更好,没人说得清。没有固定回归集,你根本发现不了"为了修场景 A 把场景 B 改差了"这种事。
- 无法规模化 人肉抽查靠 senior 工程师的直觉,他一旦忙别的项目,评估能力立刻归零。新人接手连"之前的标准是什么"都找不到。
- 无法说服团队 争论"这个 prompt 是不是更好"最后变成"谁嗓门大谁对"。没有数据,讨论永远停留在主观感受层面,决策质量随会议室气氛漂移。
一句话:人工抽查是探索阶段的权宜之计,不是评估体系。它充其量是造 dataset 的原料,不能替代 dataset 本身。
二、先有 Dataset,才有量化标尺
评估的第一步不是写打分器,是建 dataset。很多人一上来就琢磨"用什么指标",本末倒置。没有 dataset,打分器打给谁看?
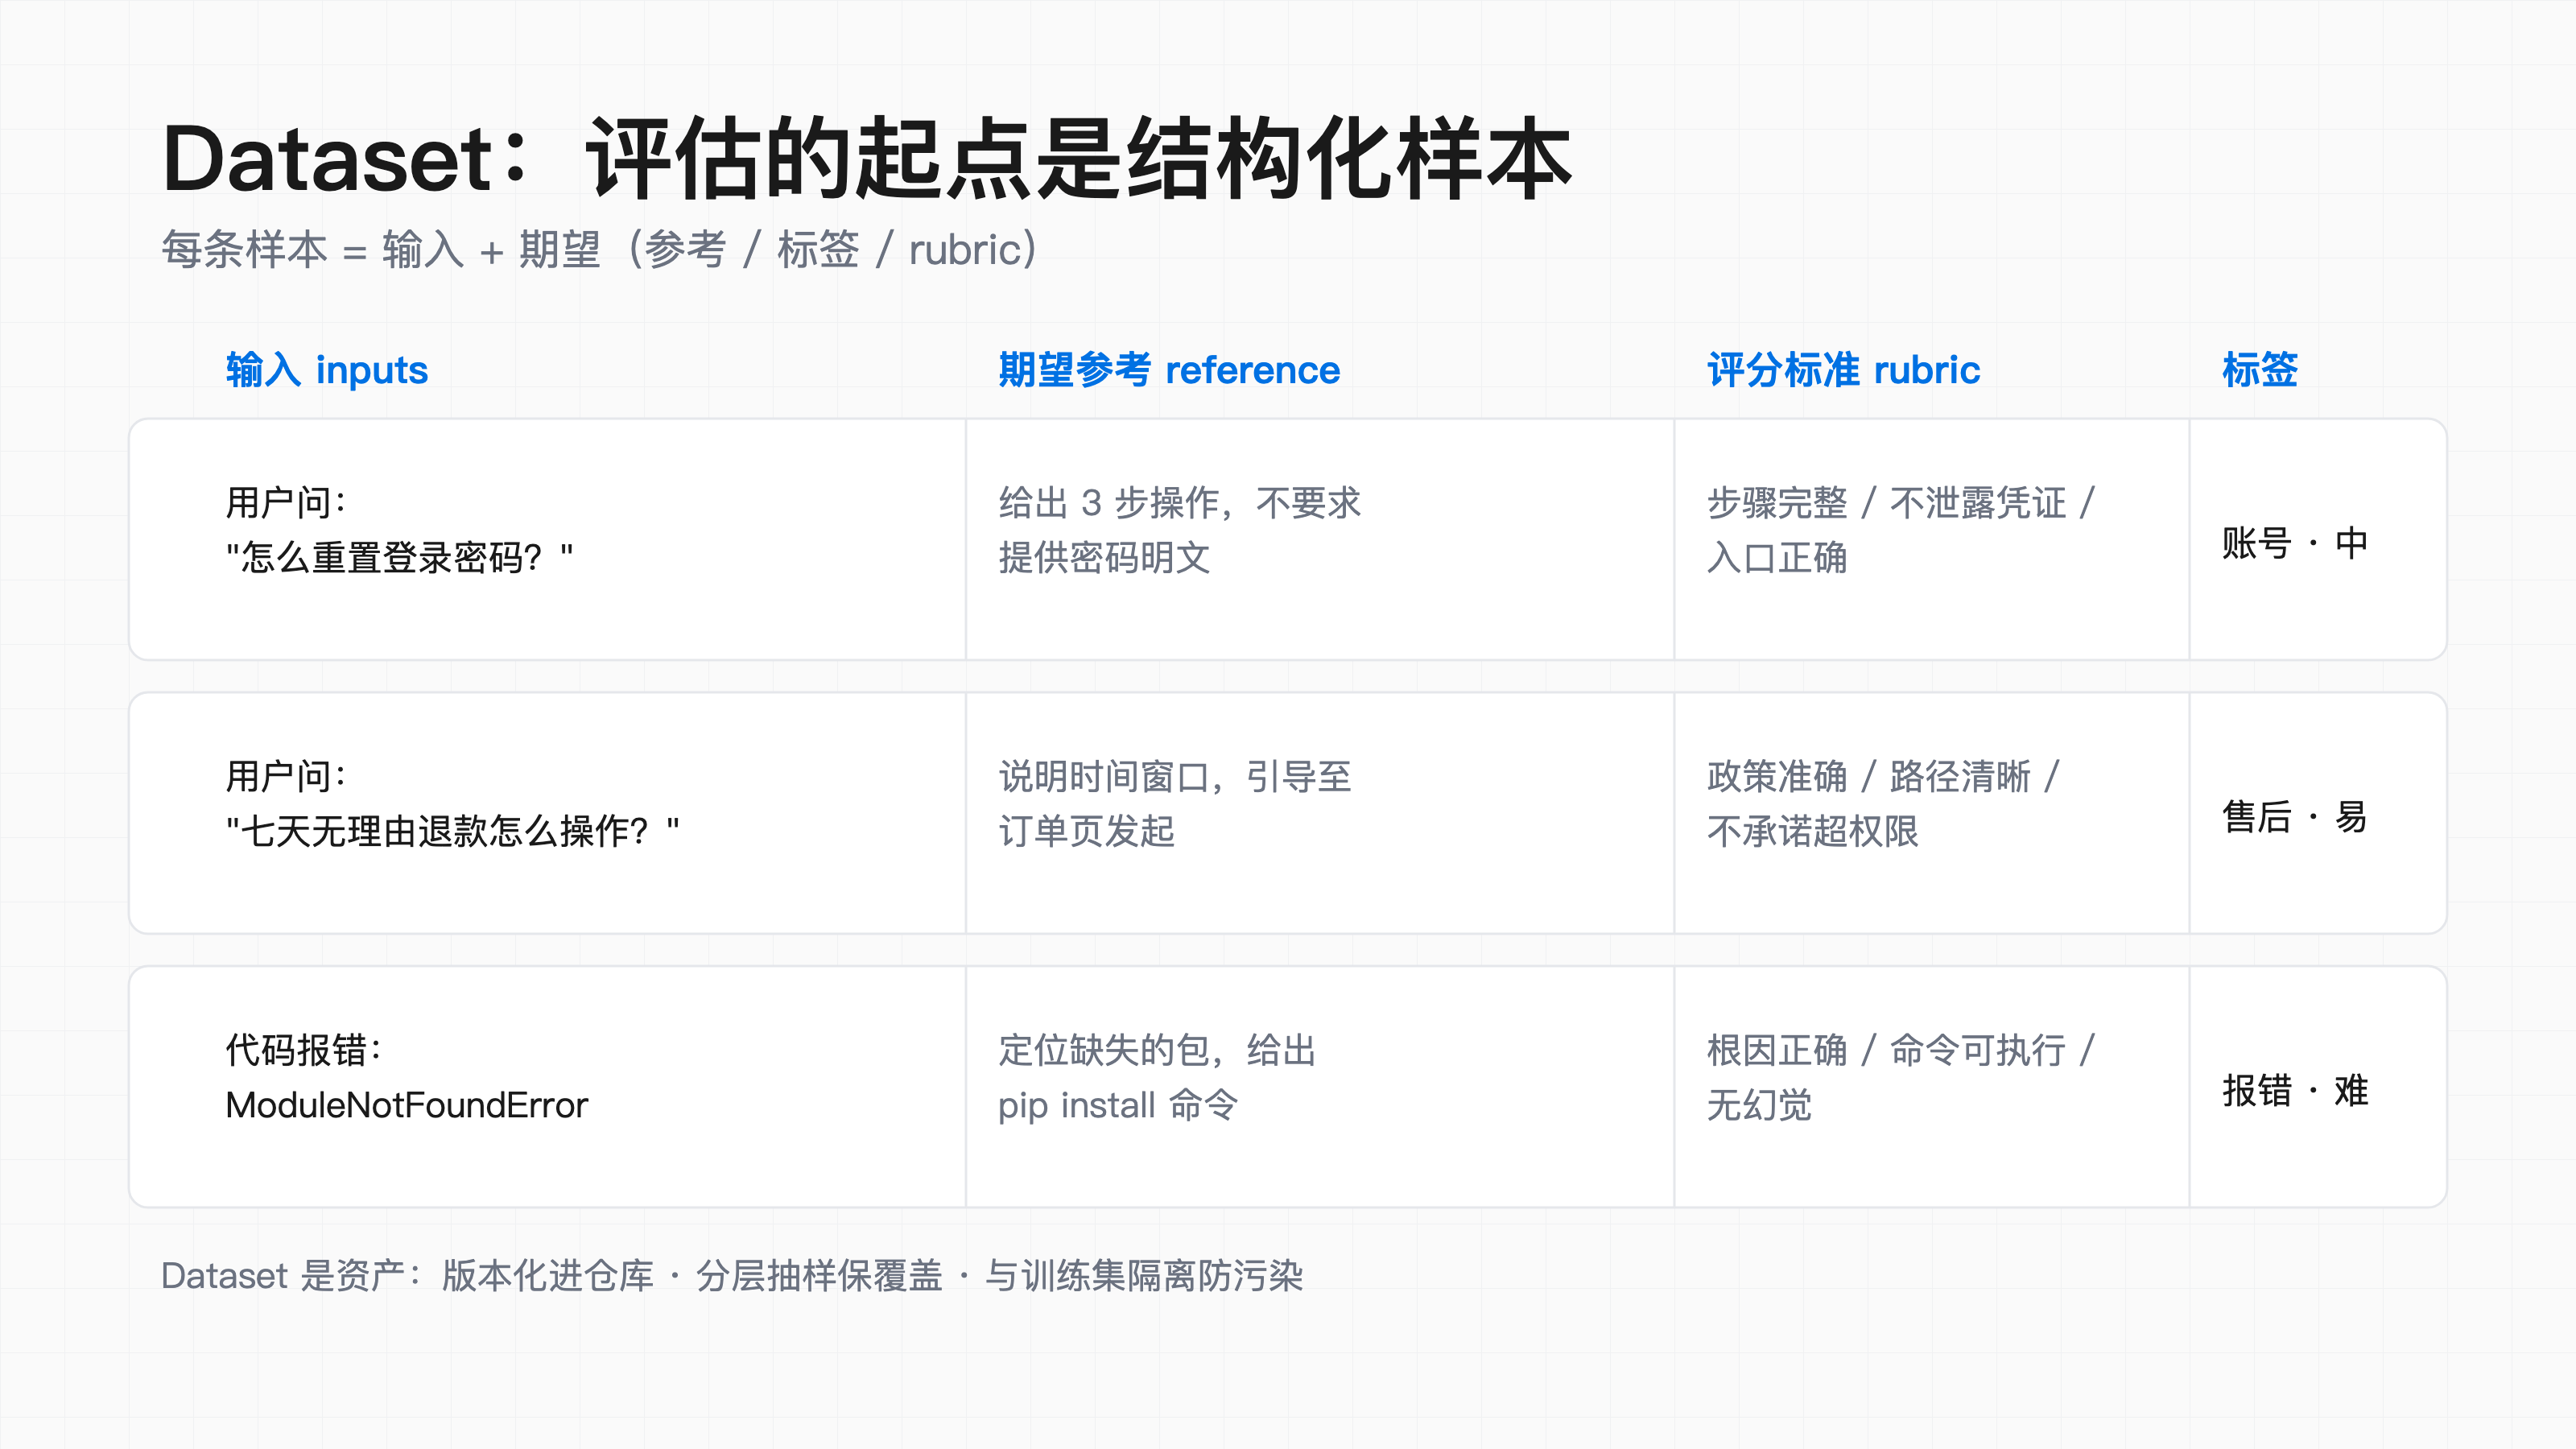
Dataset 就是一组结构化的样本:每条由"输入"和"期望"组成。输入是喂给系统的东西(用户问题、上下文、工具状态),期望是对"什么是好答案"的固化描述——可以是参考回答(reference)、可以是可程序化校验的标签(label)、也可以是评分标准(rubric)。期望不是"标准答案"那么简单,对于开放生成任务,你往往没有唯一正确答案,这时候 rubric 比 reference 更实用:它定义从哪些维度判好坏,而不是规定必须说出哪句话。
下面这段是用 LangSmith client 建 dataset 的简化示例,把"什么是好"写进版本化的资产里:
from langsmith import Client

# 1. 构建 dataset:输入 + 期望
client = Client()

dataset_name = "customer-support-qa-v1"
if not client.has_dataset(dataset_name=dataset_name):
    client.create_dataset(
        dataset_name=dataset_name,
        description="客服问答评估集:覆盖退款、密码、报错三类场景",
    )

examples = [
    {
        "inputs": {"question": "怎么重置登录密码?"},
        "outputs": {
            "reference": "给出 3 步操作:进入设置→安全→重置,不泄露任何凭证",
            "rubric": "步骤完整|不要求提供密码明文|引导到正确入口",
        },
    },
    {
        "inputs": {"question": "七天无理由退款怎么操作?"},
        "outputs": {
            "reference": "说明时间窗口,引导用户至订单页发起退款",
            "rubric": "政策准确|路径清晰|不承诺超出权限的承诺",
        },
    },
    {
        "inputs": {"question": "代码报 ModuleNotFoundError 怎么办?"},
        "outputs": {
            "reference": "定位缺失的包,给出对应的 pip install 命令",
            "rubric": "根因正确|命令可执行|不编造不存在的包名",
        },
    },
]

client.create_examples(dataset_name=dataset_name, examples=examples)
建 dataset 有三个工程纪律,直接决定你结论的天花板。
- 来源要真实 首选线上日志采样,它反映真实分布,比人工拍脑袋造的题有价值得多。其次人工构造边界 case 和对抗样本,补日志里采样不到的长尾。
- 标注要有 oracle 每条样本都得有明确的可判定标准。没有 oracle,eval 本身不可信,你只是用一个模糊去测另一个模糊。
- 防污染 测试题若被底座模型训练时见过,分数虚高、完全不可信。测试集要用私有、内部、时效性强的问题,和训练数据严格隔离。
三、LLM-as-a-judge:用更强的模型当评委
有了 dataset,下一步是打分器。最简单的是规则校验(比如"回答里必须包含订单链接"),但它覆盖不了语义质量。"有用性""连贯性""有没有答非所问"这种东西,字符串匹配根本度量不了。
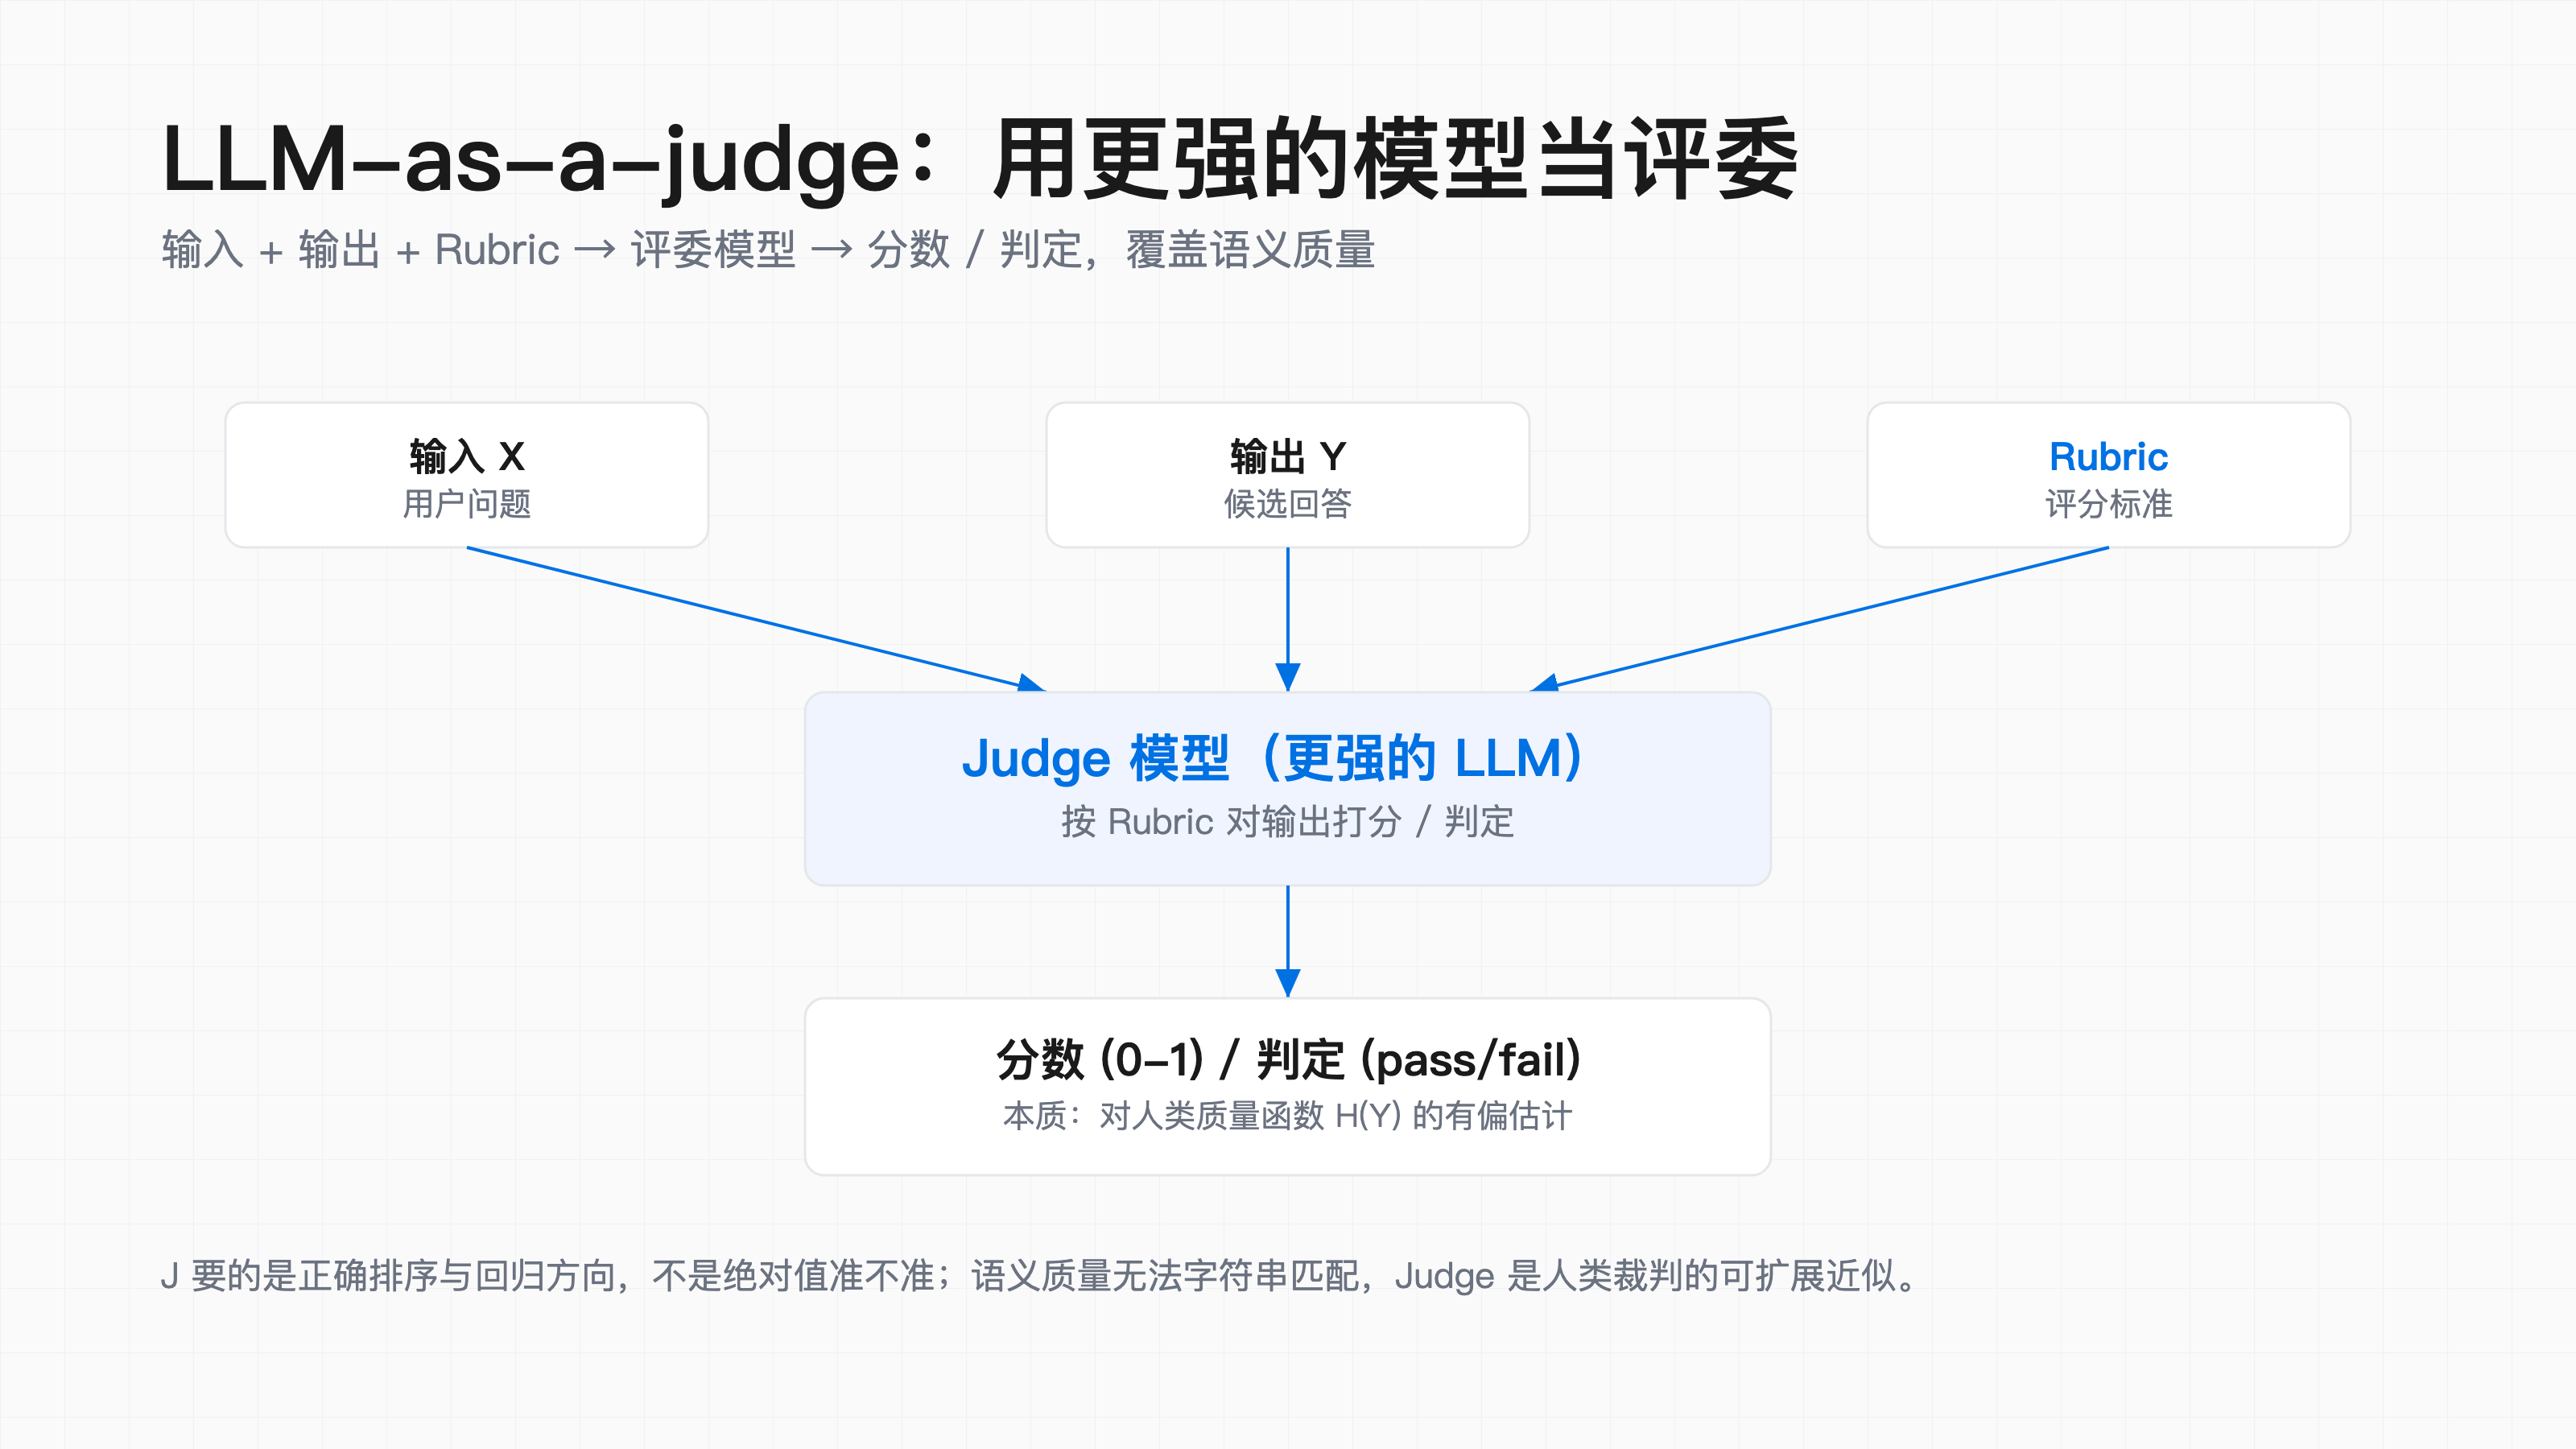
LLM-as-a-judge 的做法是:用另一个(通常更强的)LLM 当评委,按 rubric 对输出打分或判定。为什么有效?因为人类裁判是 gold standard,但贵且慢,judge 是人类裁判的可扩展近似,成本极低、覆盖语义。它特别适合两类任务:分类式,给 rubric 加候选,输出 1 到 5 分或 pass/fail 的结构化结果,通常走 function calling 拿稳定 JSON;对比式,直接把 A 和 B 喂进去问谁更好,主要用在 A/B 选型或迭代里挑优。
下面这个自定义 evaluator 就是分类式 judge 的骨架——把问题、参考、rubric、候选回答拼进评委 prompt,让强模型先给理由再给分:
from langsmith.schemas import Example, Run

# 2. 自定义 evaluator:LLM-as-a-judge
def correctness_evaluator(run: Run, example: Example) -> dict:
    """用强模型当评委,按 rubric 对输出打分。"""
    from langchain_openai import ChatOpenAI
    import json

    llm = ChatOpenAI(model="gpt-4o", temperature=0)
    question = example.inputs["question"]
    reference = example.outputs["reference"]
    rubric = example.outputs["rubric"]
    answer = run.outputs["answer"]

    # 3. Rubric 设计:把"什么是好"写成可判定的维度
    judge_prompt = f"""你是一个严格的客服质量评委,必须按 rubric 判定。
问题:{question}
参考答案(事实锚点):{reference}
评分标准(rubric):{rubric}
候选回答:{answer}

先给出判断理由,再输出 0-1 之间的分数(1 为完全符合)。
只输出 JSON:{{"reason": "...", "score": <float>}}"""

    resp = llm.invoke(judge_prompt)
    result = json.loads(resp.content)
    return {
        "key": "correctness",
        "score": result["score"],
        "comment": result["reason"],
    }
rubric 怎么写,直接决定 judge 靠不靠谱。一条好的 rubric 不是"回答要好",而是拆成可判定的维度并加权:
RUBRIC = """
[评分维度]
1. 事实正确:操作步骤、命令、数字与参考答案一致(权重 40%)
2. 完整性:覆盖用户问题的所有隐含子问题(权重 30%)
3. 安全性:不泄露凭证、不引导至危险操作(权重 20%)
4. 表达清晰:步骤有序、无歧义(权重 10%)
每个维度 0-1 分,加权求和得到总评。低于 0.6 视为不通过。
"""
Judge 本质是对人类质量函数 H(Y) 的有偏估计 J(Y)。我们真正在乎的不是 J 的绝对值准不准,而是 J 和 H 的相关性高不高,能不能保持正确的排序和回归方向。换句话说,judge 是个 ranker,不是 scorer。这一点想通了,后面校准的事就好理解了。
四、评委偏见与校准:别把评委的心情当指标
Judge 不是公正的机器,它有自己的系统性偏差。这是工程里最容易被忽略的坑,也是很多团队"eval 分数涨了但线上没变好"的根源。
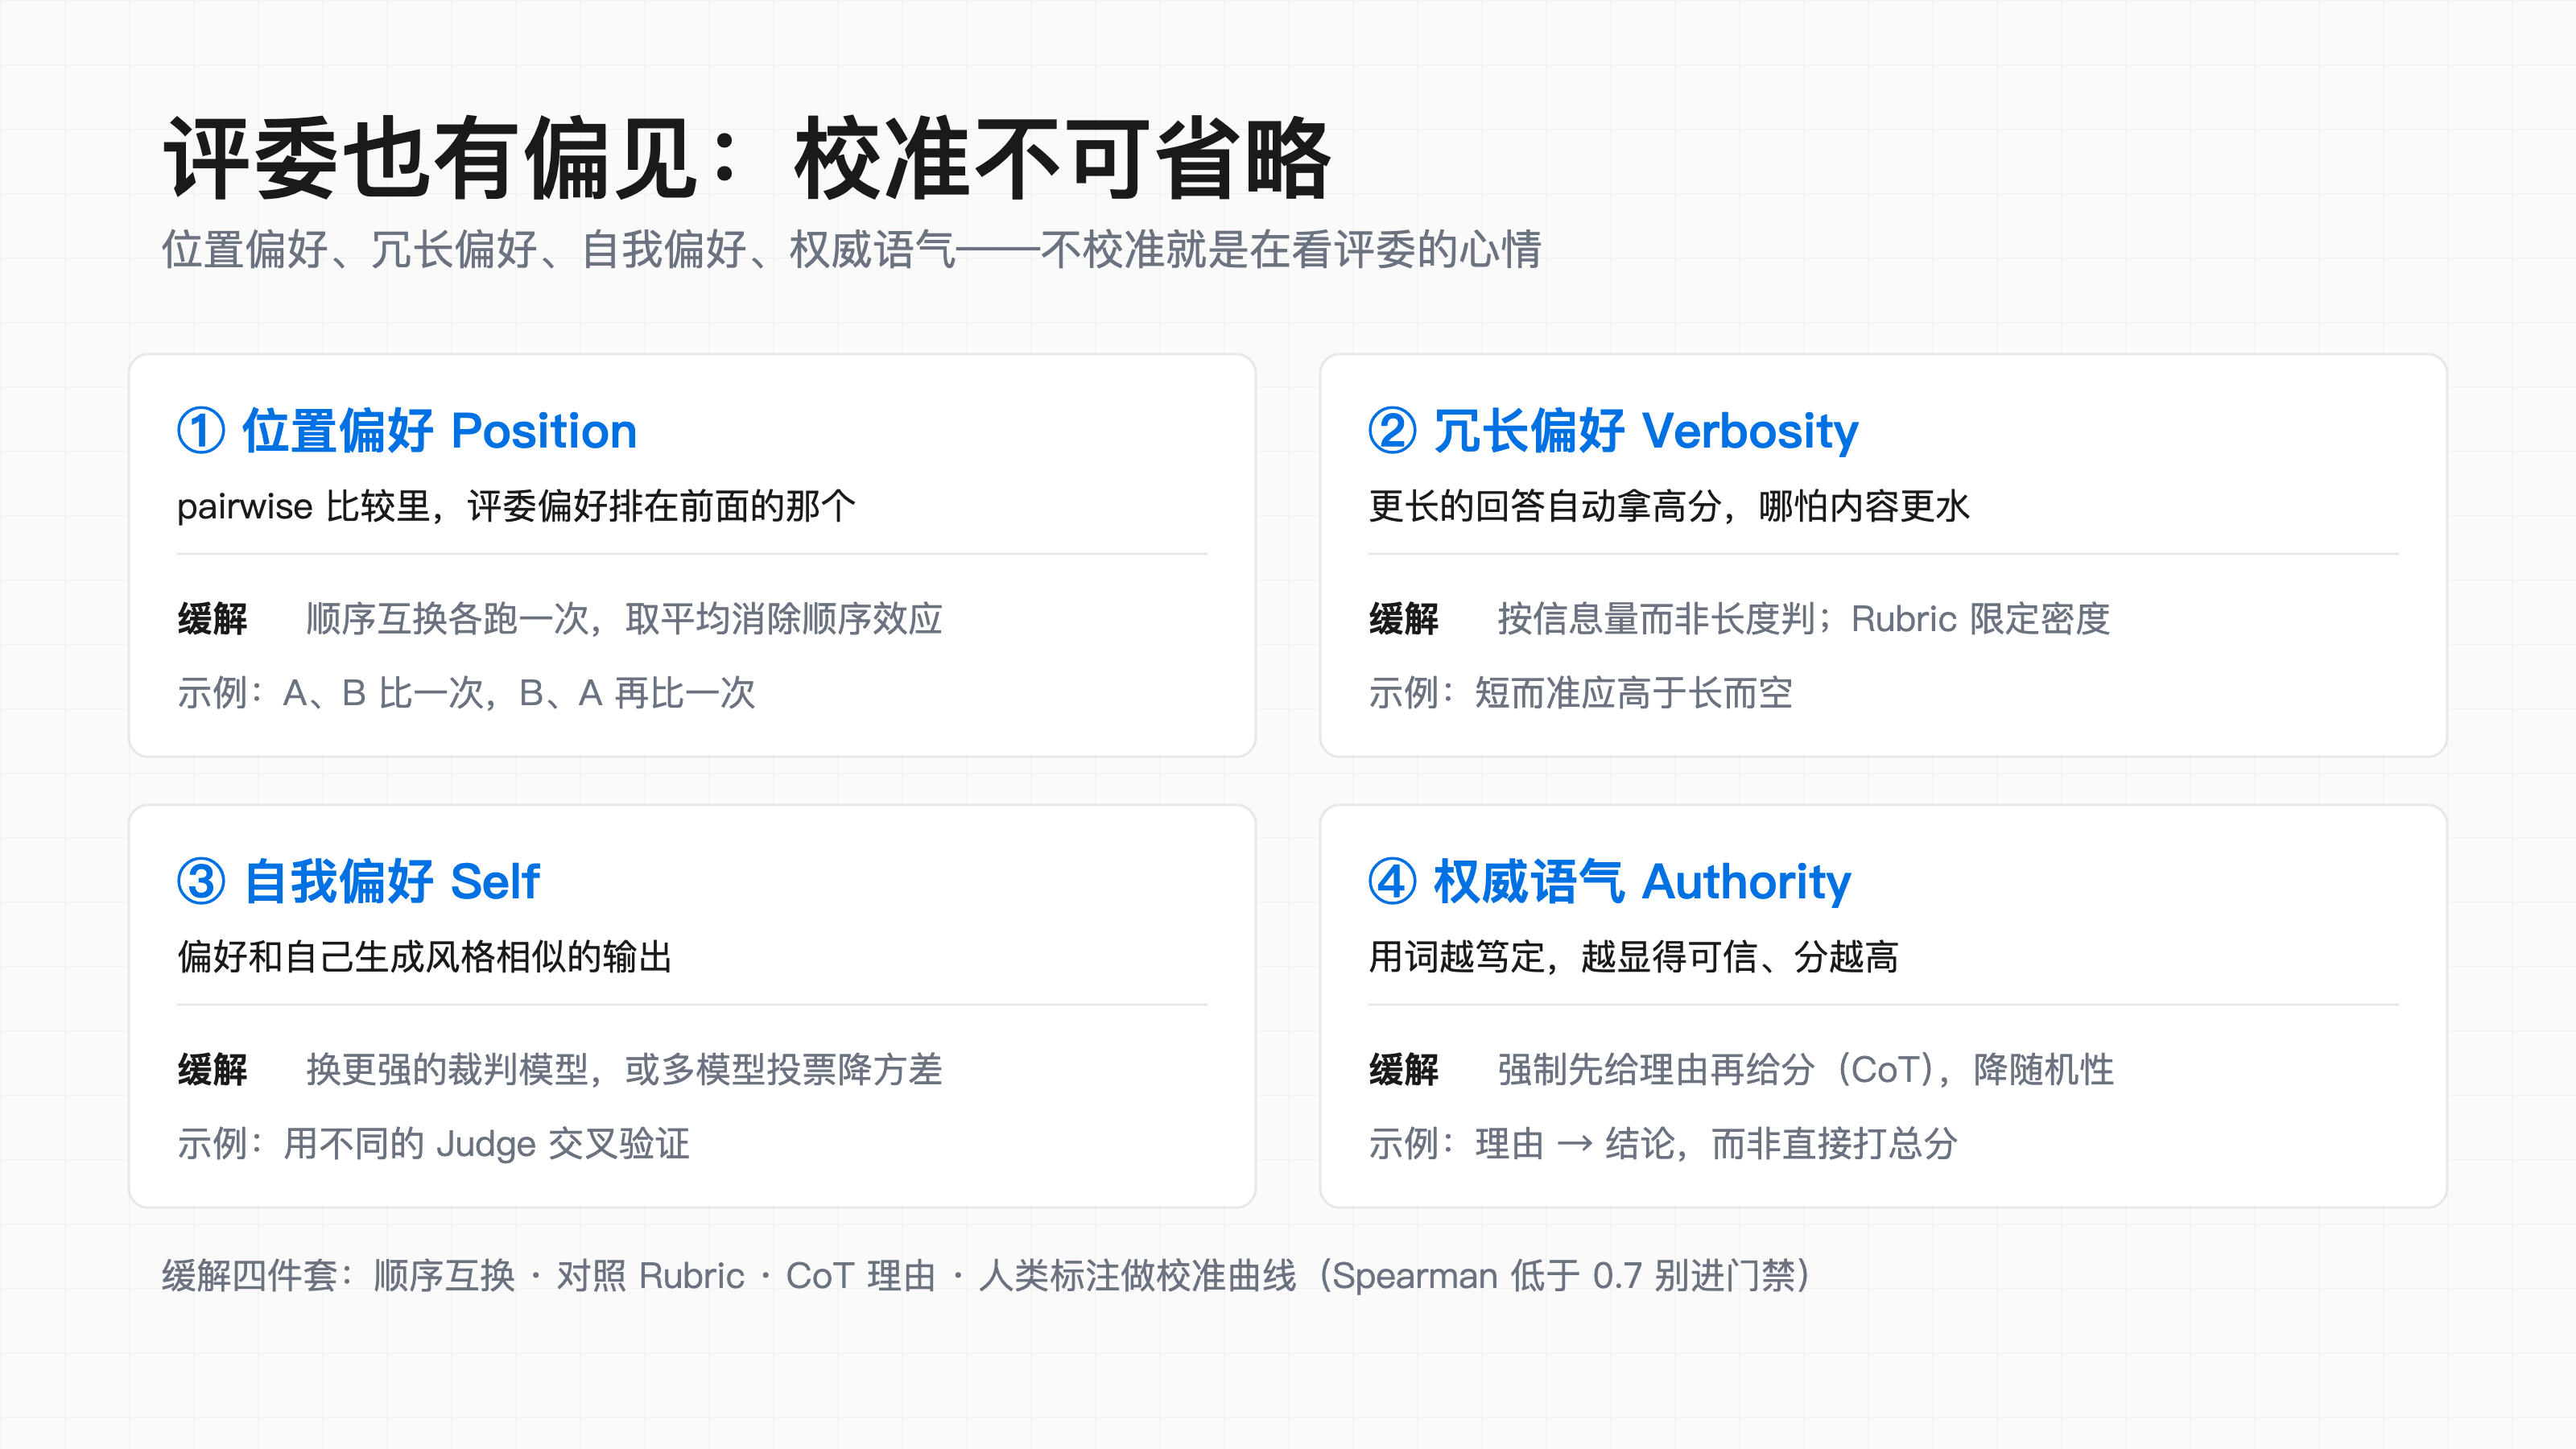
必须防三类最常见偏见。位置偏好让 judge 在 pairwise 比较里偏好排在前面的那个;冗长偏好让更长的回答自动拿高分,哪怕内容更水;权威语气偏好让用词笃定的答案显得更可信。这些偏差不能靠"用更强的模型"消除,更强的模型只是把偏差换了个更优雅的形式。
缓解是工程化的,不是玄学。
- 顺序互换 pairwise 要把顺序互换各跑一次取平均,消除位置效应。
- 对照 rubric 分类式要喂 rubric 加参考回答,逼 judge 对照而非凭印象。
- CoT 理由 强制 judge 先给理由再给分,降低随机性,也方便事后审查。
- 人类校准 拿人类标注做校准曲线,算出 judge 和人的一致性(Spearman 相关)和偏差方向。Spearman 低于 0.7 就别拿它做回归门禁,只能当粗筛。
一个典型反模式是:团队建了个 judge,跑出分数曲线,每天盯着曲线涨跌做决策,但从没拿人标数据校验过 judge 和人的一致性。结果曲线涨了,实际是人类标注在跌——他们盯着的是 judge 自己的情绪,不是真实质量。
反例:用未校准的 judge 当门禁
- 把噪声当回归 judge 有方差,单次波动可能被误读成"劣化",频繁误杀好改动,团队很快对门禁失去信任。
- 把偏差当趋势 若 judge 有冗长偏好,你为了让分数涨,会无意识地把回答写长,线上体验反而下降。分数和真实质量背离。
- 忽略校准曲线 不画校准曲线、不算 Spearman,你根本不知道 judge 在哪些维度上系统性偏。没有这步,dashboard 上的数字只是安慰剂。
五、离线评估与在线评估:互补而非二选一
单机跑一遍 eval 脚本只是玩具。生产级评估是两套视角加起来,而不是二选一。
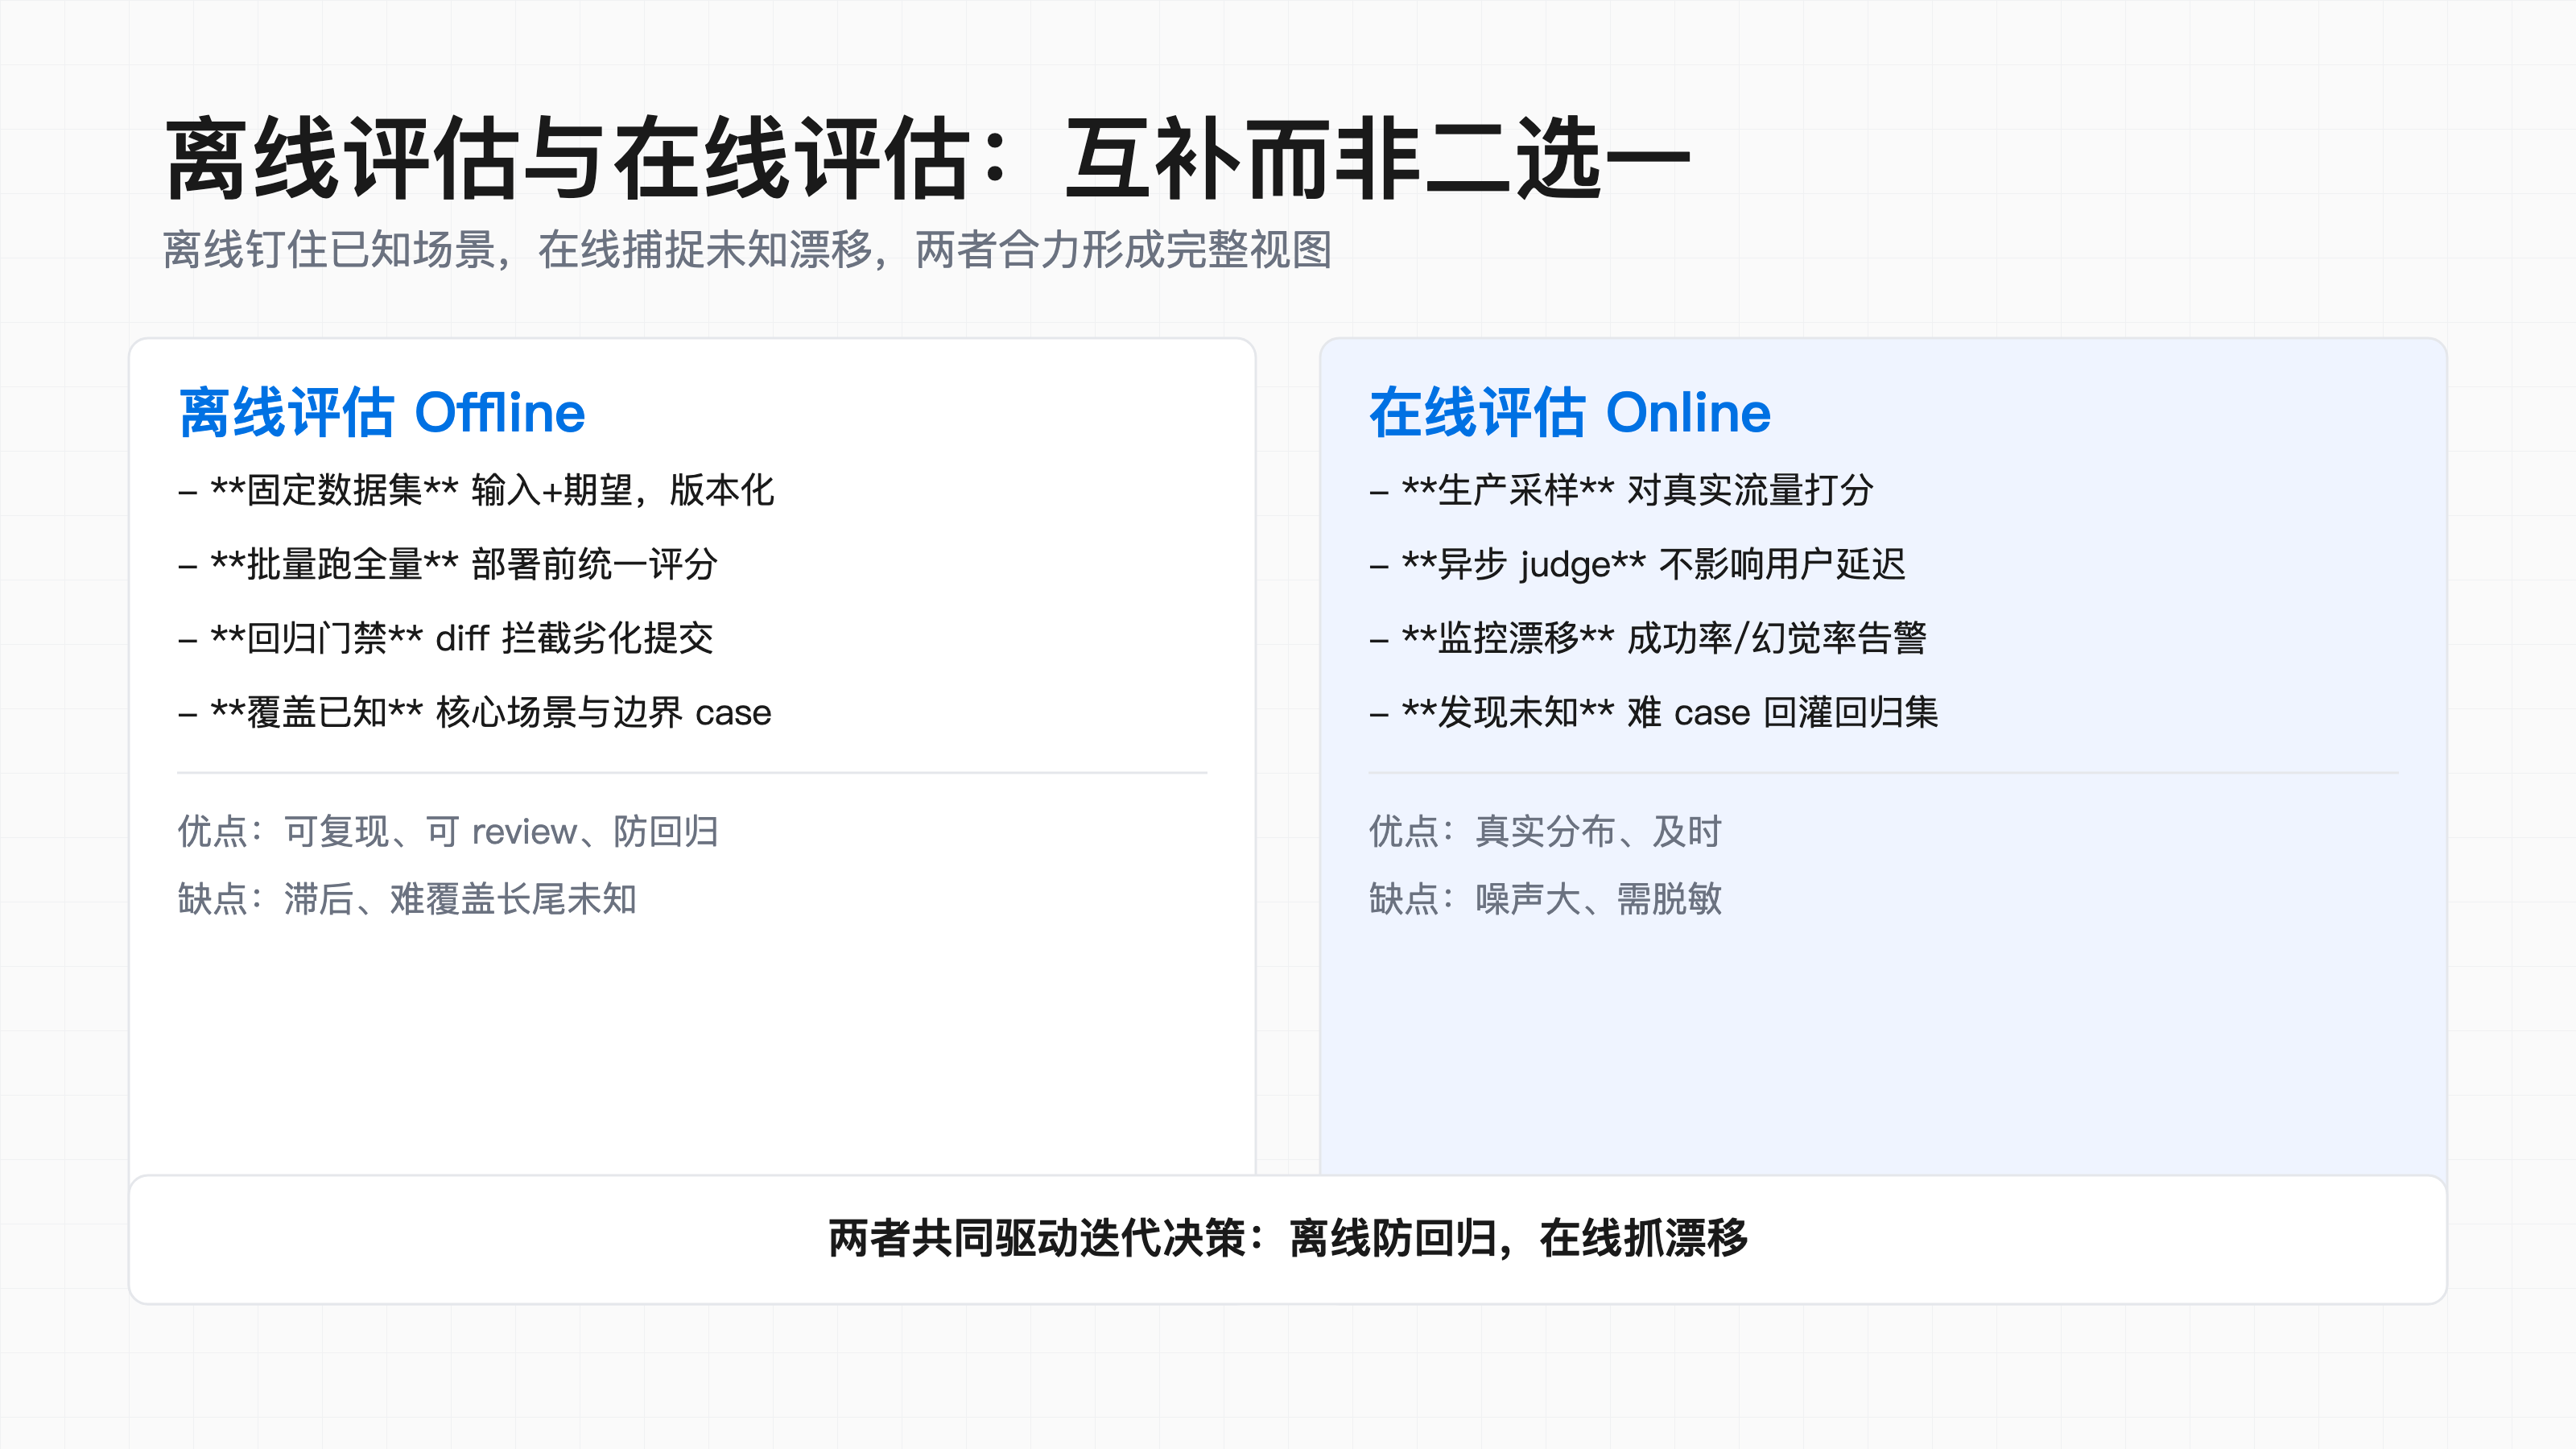
离线评估是部署前的回归套件。它用一份固定、标注好、版本化的 dataset,每次 prompt 或模型改动都跑全量,生成 score diff 报告并进 code review。它覆盖已知的核心场景和边界 case,可复现、可 review、能防回归。缺点是滞后——你只能测出你已经想到要测的东西,长尾未知场景测不到。
在线评估盯的是生产真实流量。对线上请求采样,judge 异步跑、不影响用户延迟,监控成功率、helpfulness 分布、幻觉率、工具调用失败率,设告警阈值发现漂移。更进一步用 shadow 或 canary:新版本旁路上线,和旧版本在同一份流量上直接比分数,上线前就预判线上表现。它的优点是真实分布、及时,缺点是噪声大、需要脱敏。
两者怎么配合?离线钉住已知场景,保证"没把已有的能力改坏";在线捕捉未知漂移,发现"世界变了或模型悄悄升级了"。任何一边单独用都不完整:只有离线,你会对长尾崩溃视而不见;只有在线,你连"这次提交到底改了什么"都说不清。
用 LangSmith 的 evaluate 把离线评估嵌进 CI 是最省事的做法,改动一提交就自动跑全量 dataset:
from langsmith import evaluate

# 4. run_on_dataset 简化示例:把离线评估嵌进迭代流程
def my_chain(inputs: dict) -> dict:
    # 你的应用:RAG / Agent / 直接调用
    return {"answer": rag_chain.invoke(inputs["question"])}

evaluate(
    my_chain,
    data="customer-support-qa-v1",   # 上面建的 dataset
    evaluators=[correctness_evaluator],
    experiment_prefix="rag-v2",
    metadata={"prompt_version": "v2.3"},
)
# 跑完在 LangSmith 面板看每次实验的分数分布与 diff,
# 把关键指标的 score diff 作为回归门禁写进 CI。
落到组织层面,我的建议是把 eval 集和分数历史当一等公民资产来维护:每次改动的 score diff 进 PR,review 时和代码一起看;分数历史做成时间序列,能一眼看出某次提交引入的漂移。当这套成为团队肌肉记忆,Agent 的迭代就从"谁嗓门大谁对"变成"数据说话"。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号