RAG 生产事故复盘:那些踩过的坑
原创
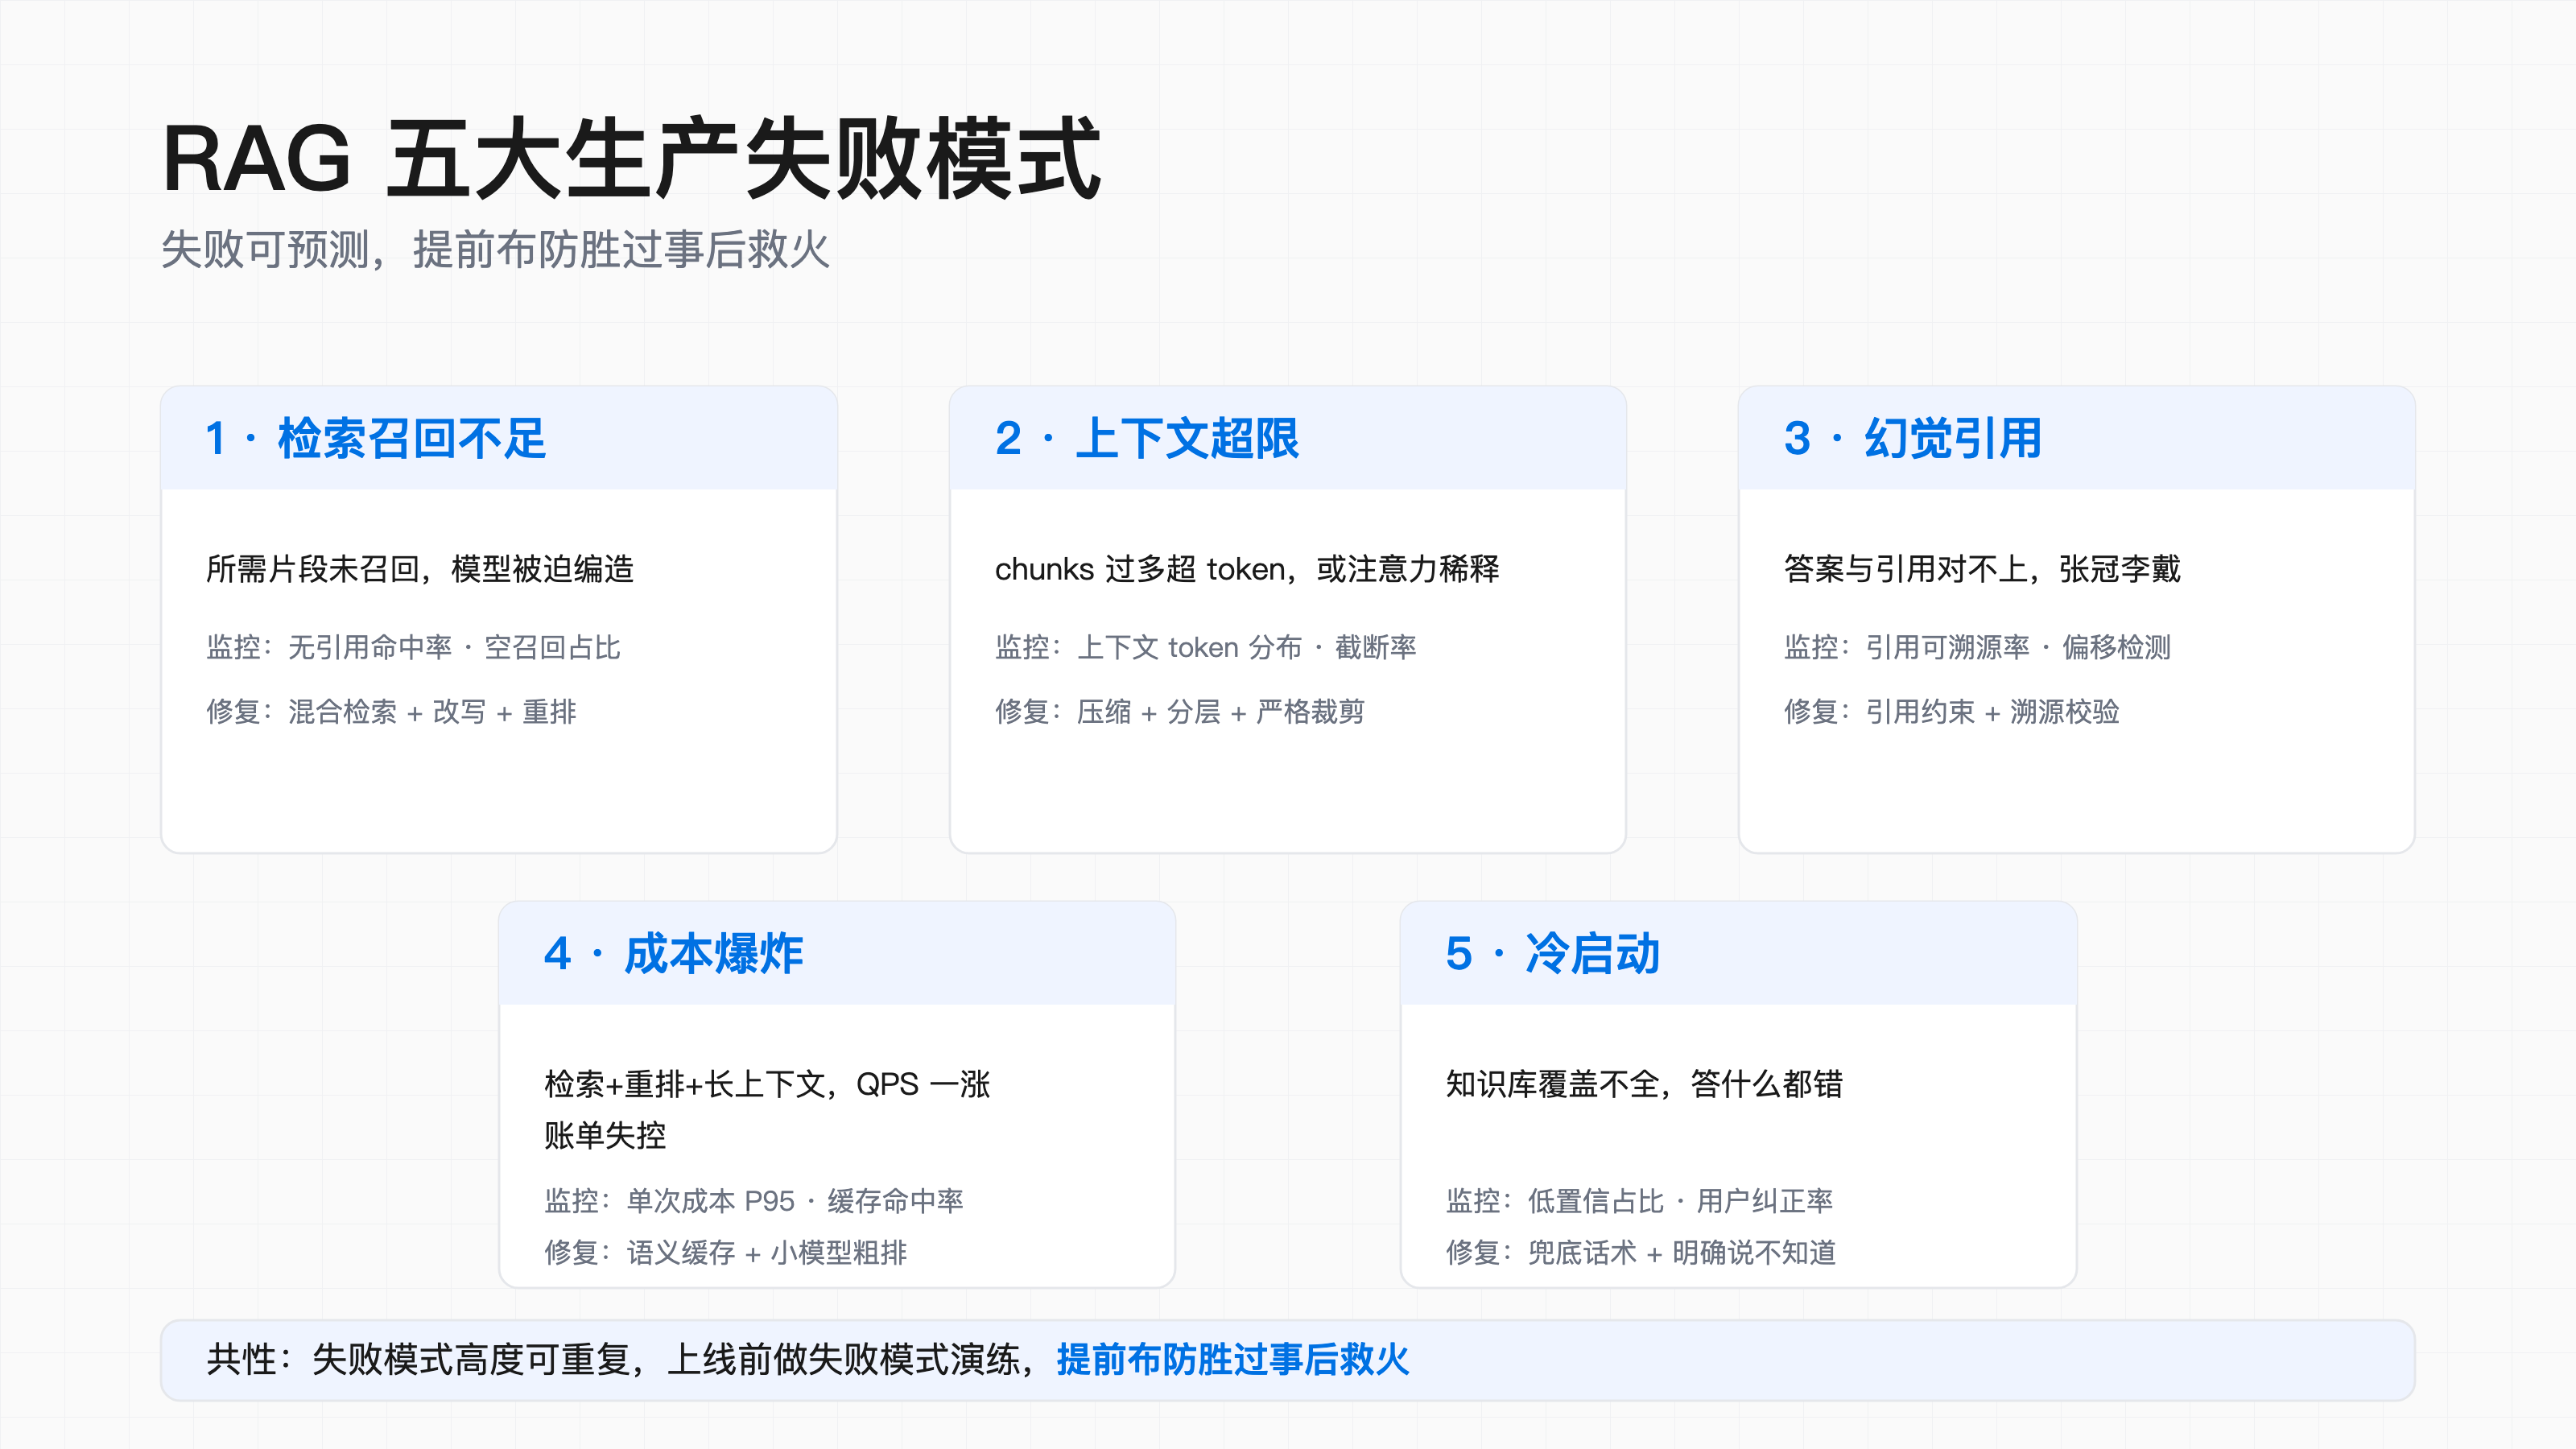
RAG 上线不是终点,真正磨人的是它跑起来之后的样子。某天早上告警响起:召回掉了、上下文爆了、引用张冠李戴、账单一夜涨了十倍。你以为这是偶发故障,其实每一种都有迹可循。RAG 的失败模式高度可重复,提前布防远比事后救火划算。这篇文章不聊方法论鸡汤,只把我们踩过的五个坑拆开讲透:机制、监控信号、修复手段,以及上线前最该补的那场演练。每个坑都给了监控信号和修复代码,方便你直接照着布防。
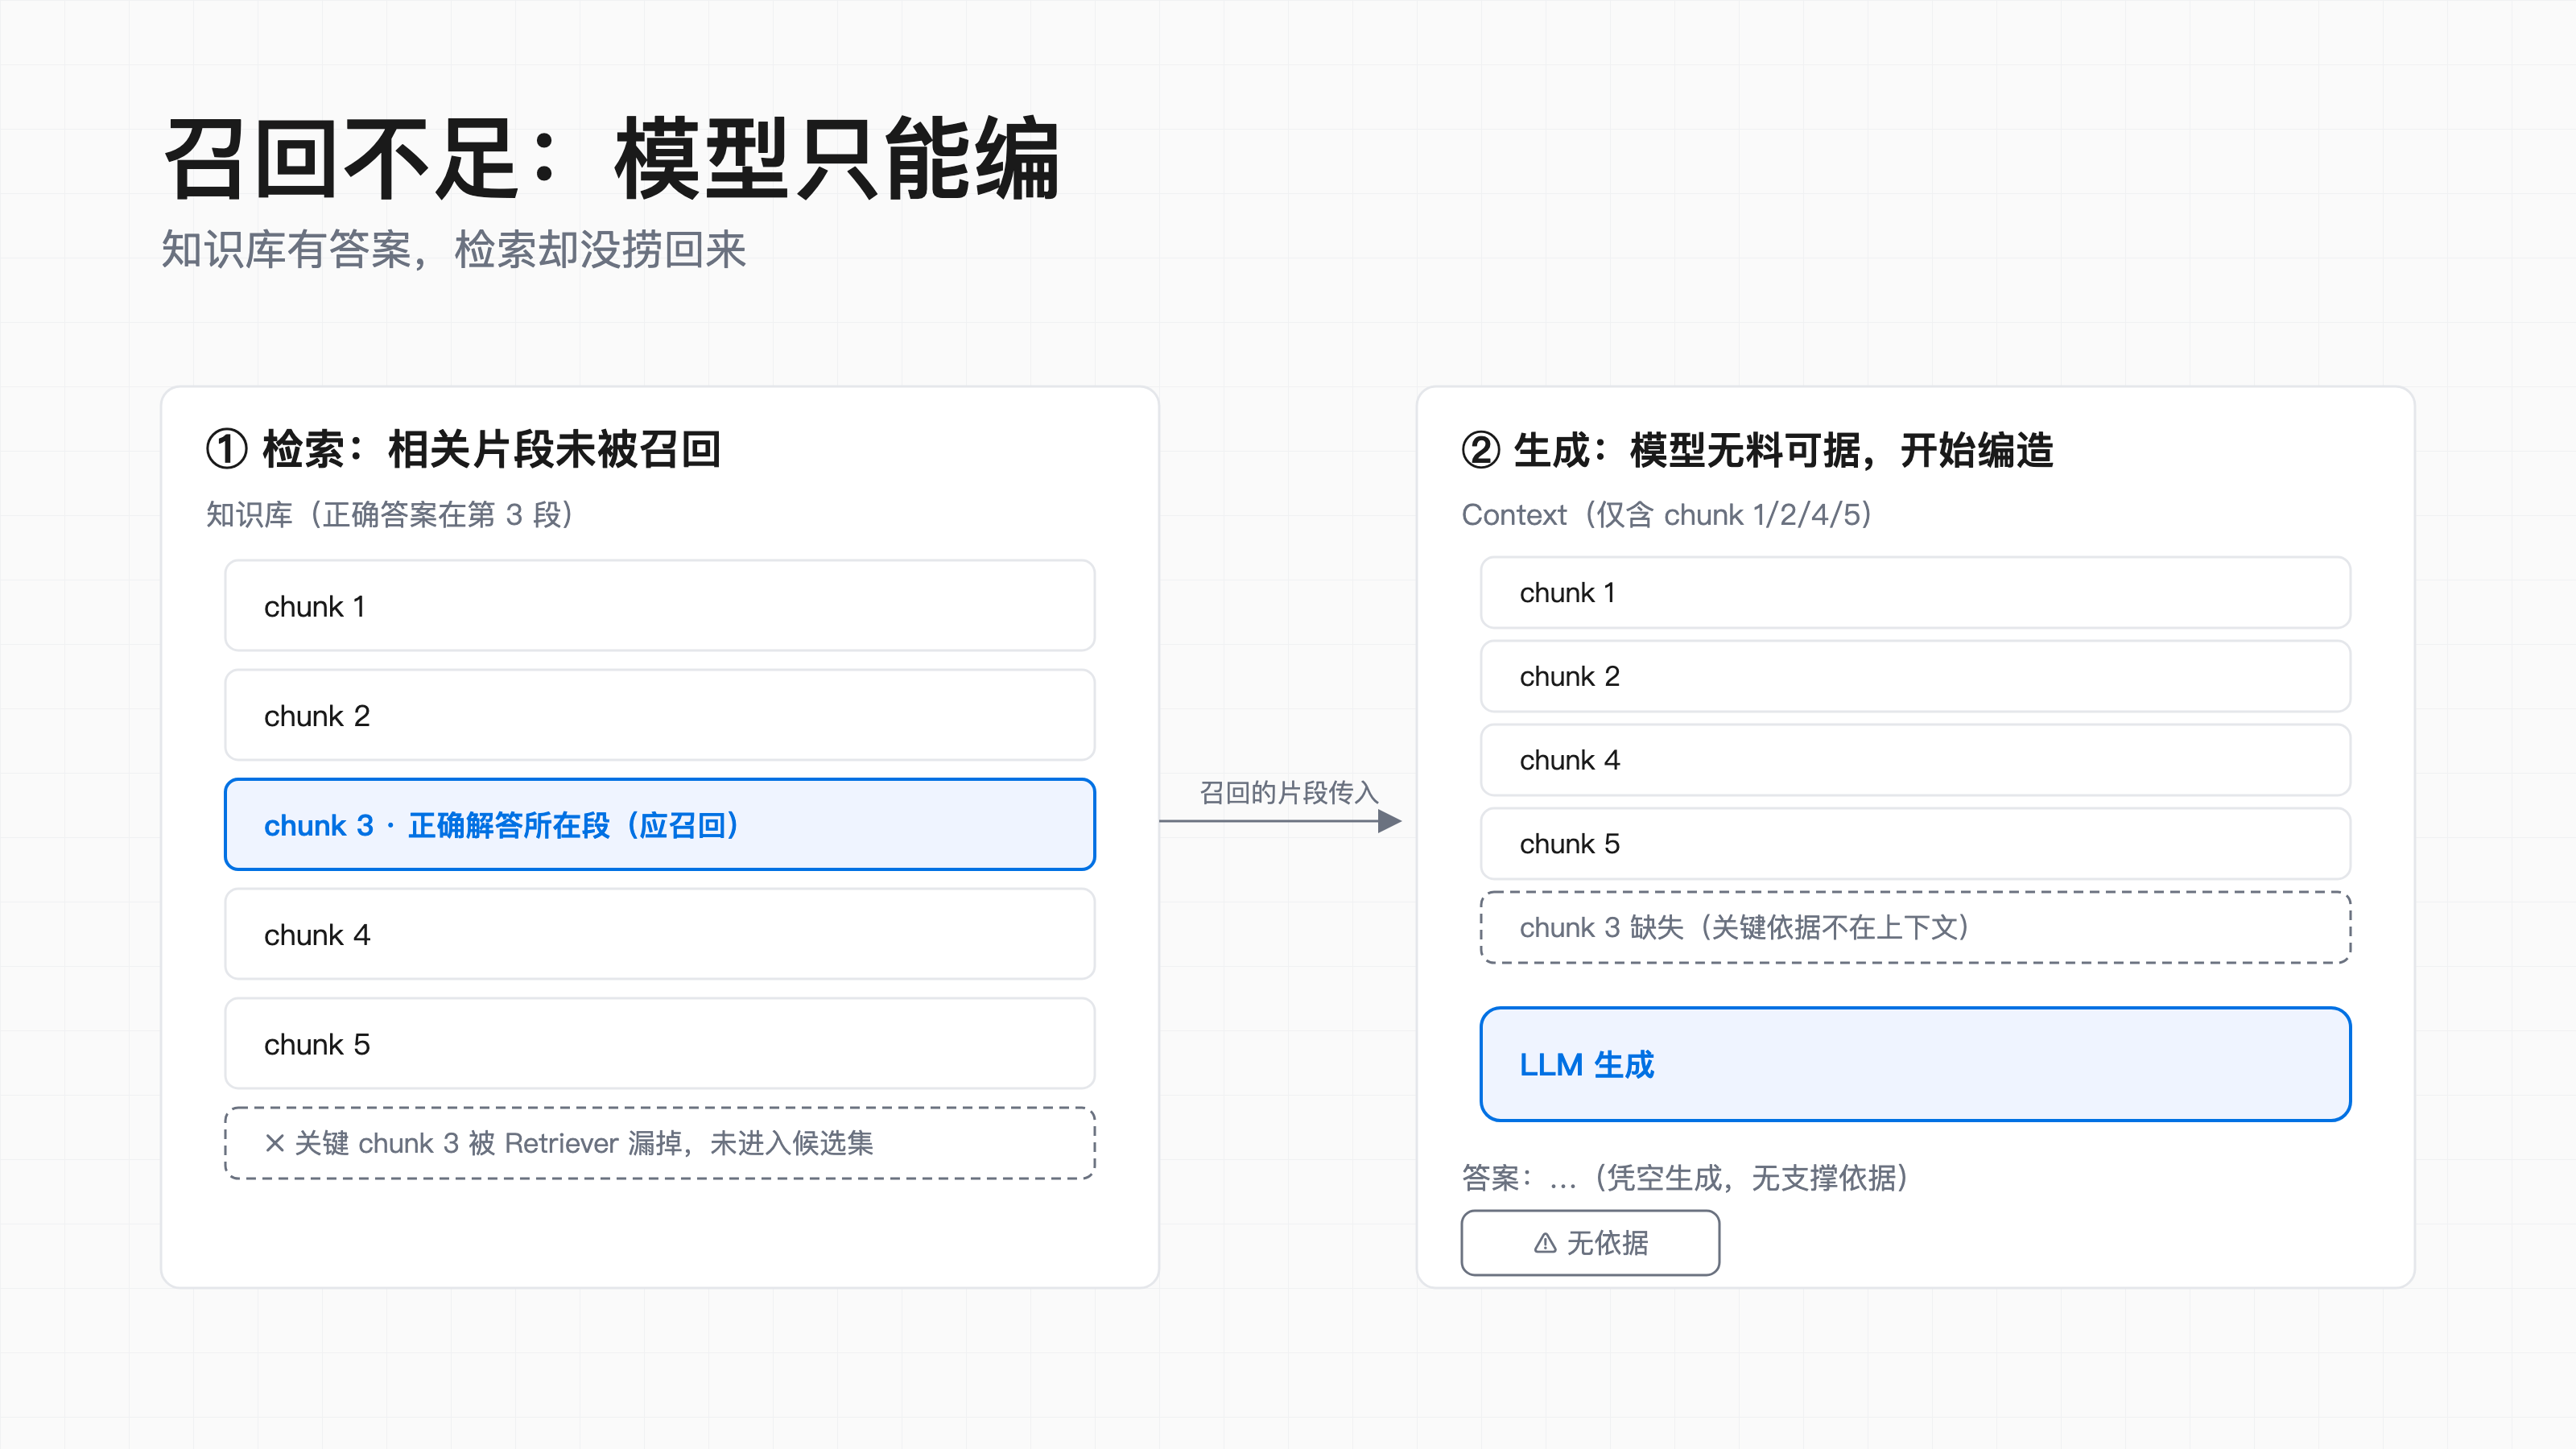
一、检索召回不足:模型只能编
召回是 RAG 的地基。地基漏了,上层模型再聪明也救不回来。最典型的事故是:用户问的东西,知识库里明明有答案,检索阶段却没把那段捞回来。模型面前只有一个空盘子,它不会老实说"我没料",而是开始自由发挥。
机制
- 切分粒度错 按固定 500 字符硬切,把一个完整步骤劈成两半,两段的向量表示都两头不靠。
- 纯向量对关键词不敏感 提问里带着具体报错码 "ERR_507"、"Kubernetes 1.28",稠密向量把它们语义化了,BM25 才能抓的硬词直接扑空。
- query 与文档表述错位 用户说"怎么退款",文档写的是"订单撤销流程",字面不重叠,向量也未必拉得近。
监控信号
- 无引用命中率 返回答案里声称依据的内容,在召回集中找不到的比例。
- 空召回占比:top-k 召回数为 0 或低于阈值的请求比例。
- 用户追问率:一个问题被改述后反复重提的频率,间接反映首轮没答对。
修复手段
从"单路向量"升级为"混合检索 + query 改写 + 扩召回再重排":
# 召回不足:混合 + 改写 + 扩召回 + 重排
candidates = bm25_search(query) ∪ vector_search(query, k=20)   # 先混合
rewritten  = llm_rewrite(query)                                # query 改写对齐表述
candidates += vector_search(rewritten, k=20)
expanded   = dedupe(top_k(candidates, k=50))                  # 先扩召回
ranked     = rerank(expanded, query, k=8)                     # 再精排压回可控量
if not ranked:
    return FALLBACK_ANSWER                                    # 兜底,而不是硬编
反例 只接了一个 dense vector store 就信心满满上线。碰到带版本号、错误码的硬词 query,召回率断崖式下跌,答案开始凭空编报错的解决步骤。用户在评论区贴出"你给的步骤文档里根本没有",这才回头补 BM25。
二、上下文超限:塞太多反而听不进去
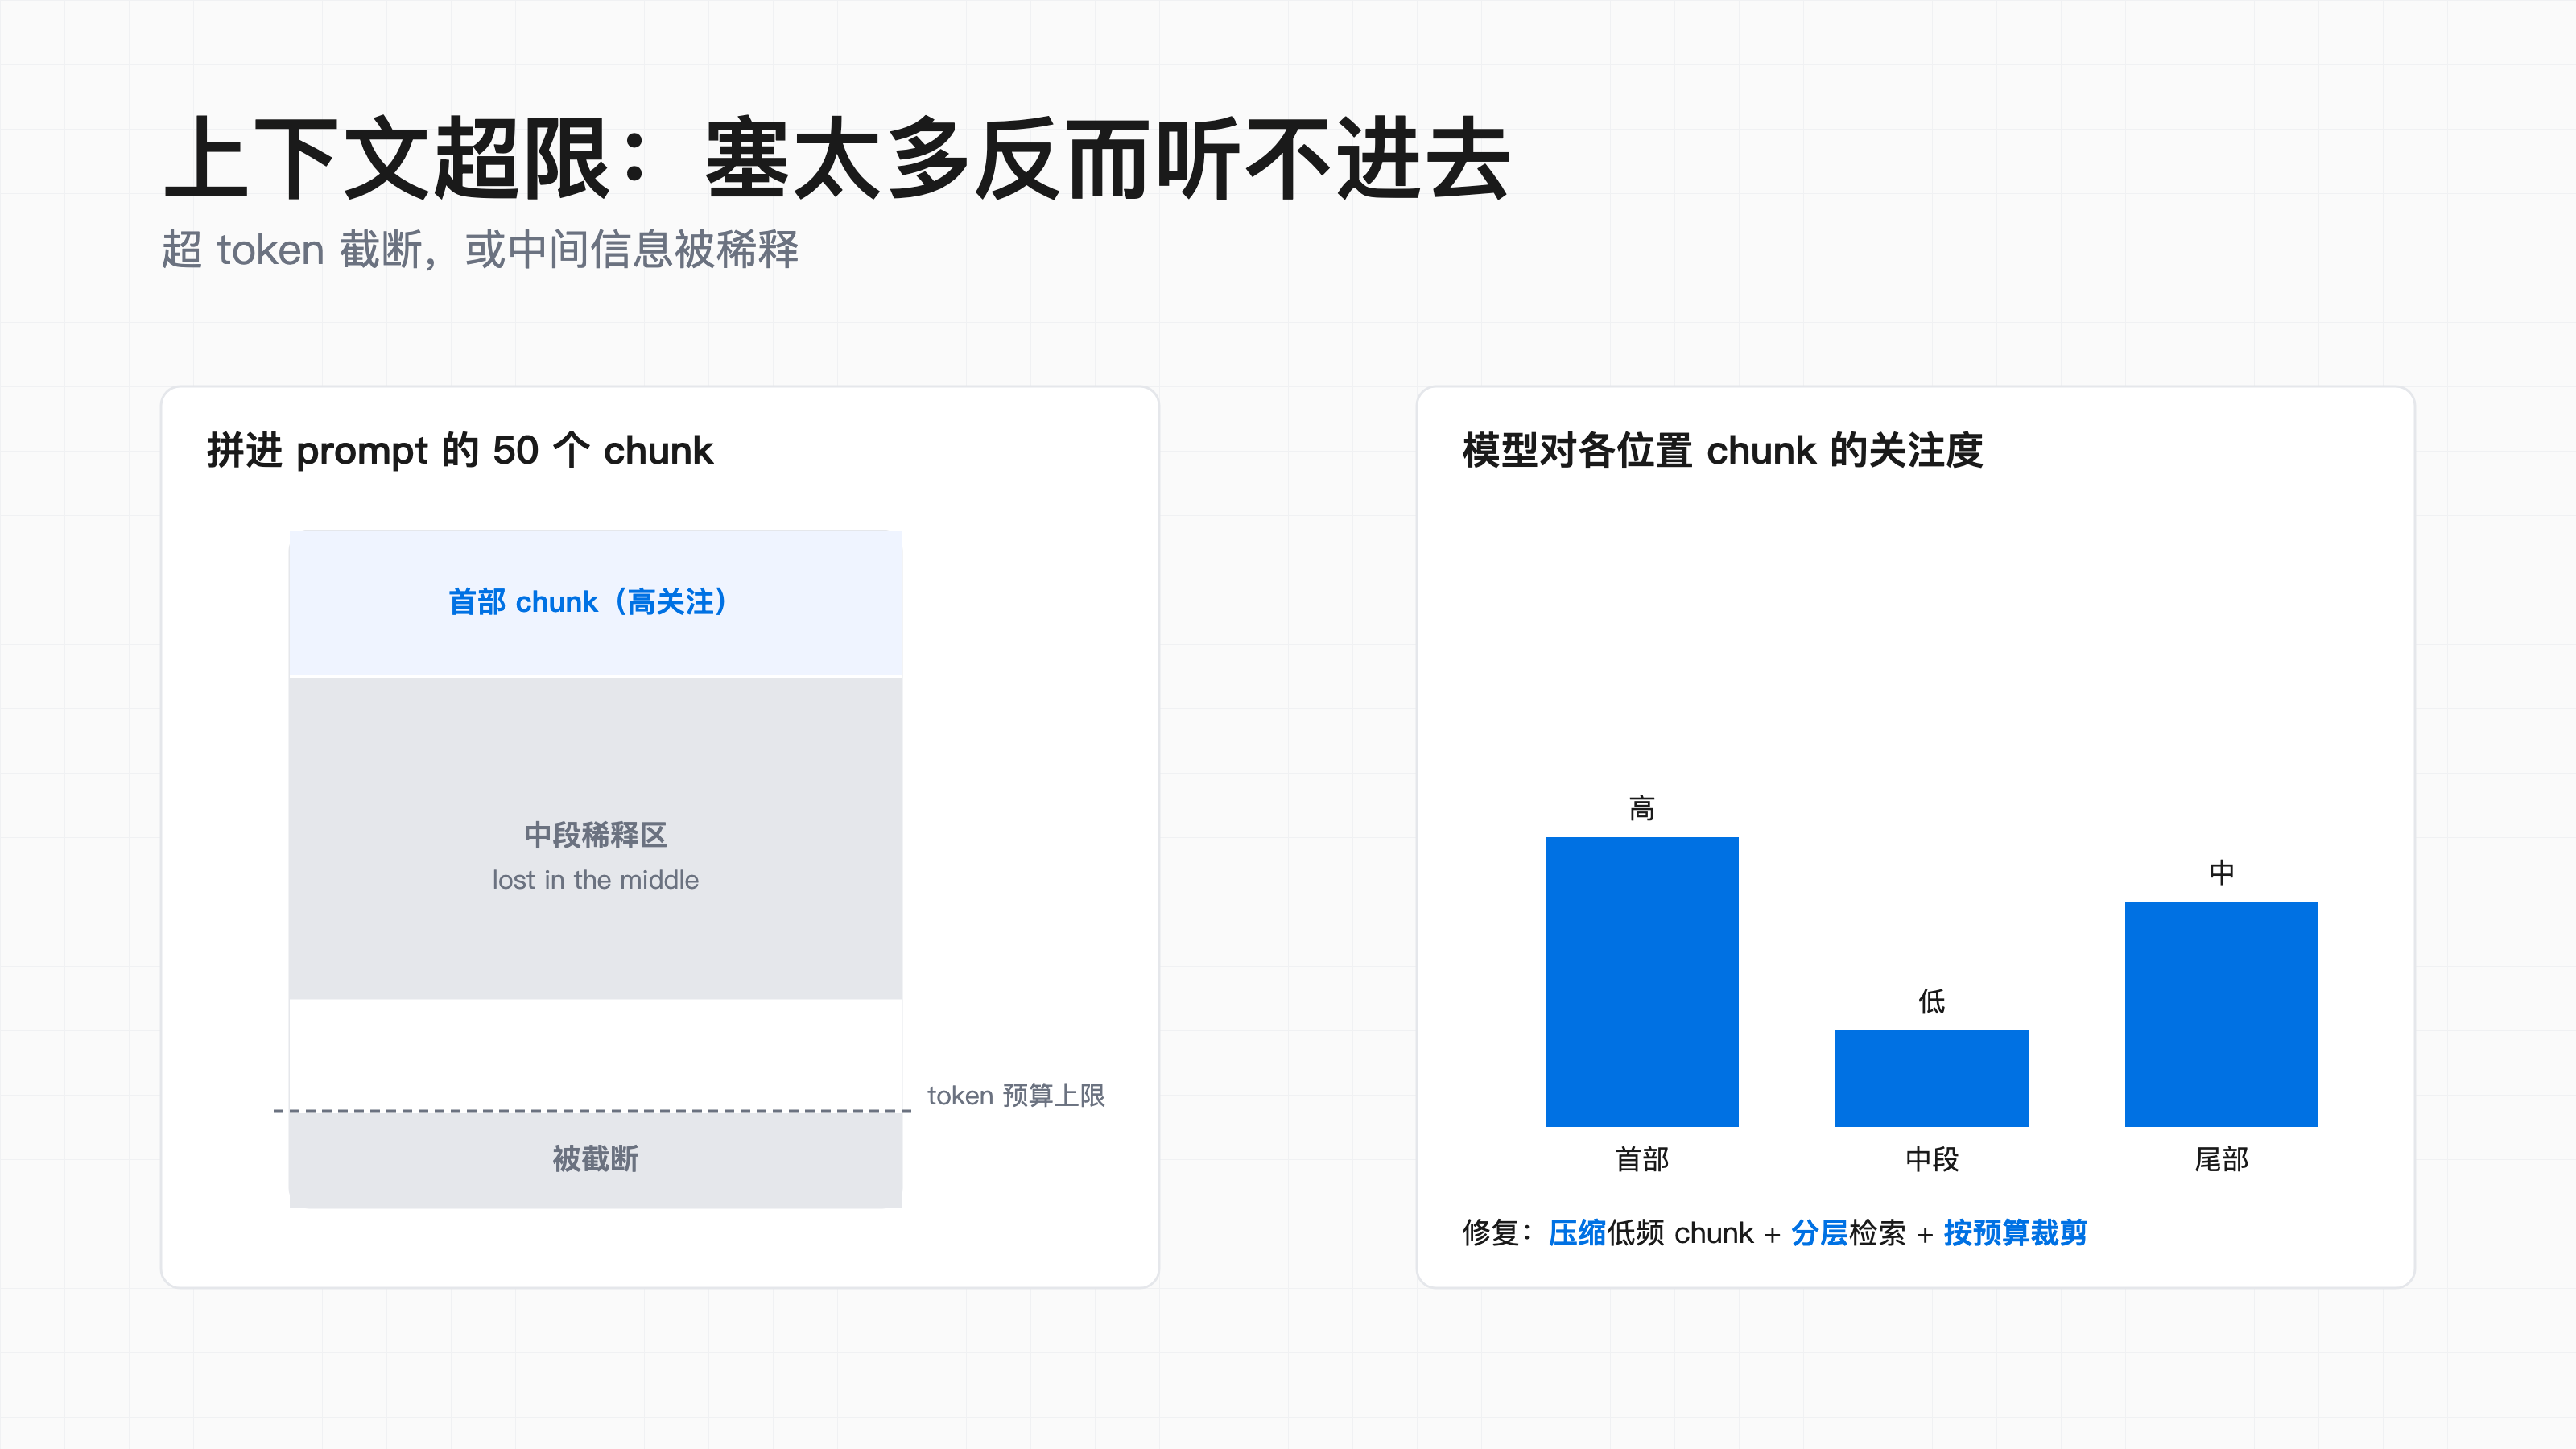
另一头是贪心。团队为了"不让模型漏看",把 top-50 的 chunks 全塞进 prompt。结果要么超 token 被截断,要么触发注意力稀释,中间一大段模型根本没正眼瞧。
机制
- 硬截断 上下文窗口是死线。塞 50 个 chunk 超预算,前面被砍,真正该用的那段刚好在砍掉的位置。
- 丢失的中间(lost in the middle) 研究已经证明,模型对 prompt 中段信息的利用率明显低于首尾。你把最关键的放中间,它反而忽略。
- 噪声挤占 无关 chunk 混在里头等于喂了干扰项,模型更容易被带偏。
监控信号
- 单请求上下文 token 数分布,超 80% 预算的请求占比。
- 被截断比例:实际拼装 token 与计划 token 的比值。
- 准确率随 chunks 数变化的曲线,如果 30 个比 10 个还差,就是稀释了。
修复手段
压缩、分层、严格裁剪三件套:
- 压缩 低优先 chunk 先过一遍摘要,缩成 1-2 句再进上下文。
- 分层检索 先检索到文档级,再只展开命中段落,避免整篇灌入。
- 严格裁剪 按相关性分数 + token 预算硬截断,宁缺毋滥。
# 上下文超限:按预算裁剪 + 低优先压缩
def build_context(chunks, token_budget=6000):
    chunks.sort(key=lambda c: c.score, reverse=True)
    ctx, used = [], 0
    for c in chunks:
        if used + c.tokens <= token_budget:
            ctx.append(c); used += c.tokens
        else:
            summary = compress(c)                  # 超限的低价 chunk 压成摘要
            if used + summary.tokens <= token_budget:
                ctx.append(summary); used += summary.tokens
    return ctx                                     # 永远不超预算
反例 为了"显著性"把所有召回原样堆叠,关键结论放在第 18 个 chunk 中间。用户问一个明确数字,模型答非所问。debug 时发现那段就在被稀释的中段,首尾全是噪声。
三、幻觉引用:张冠李戴
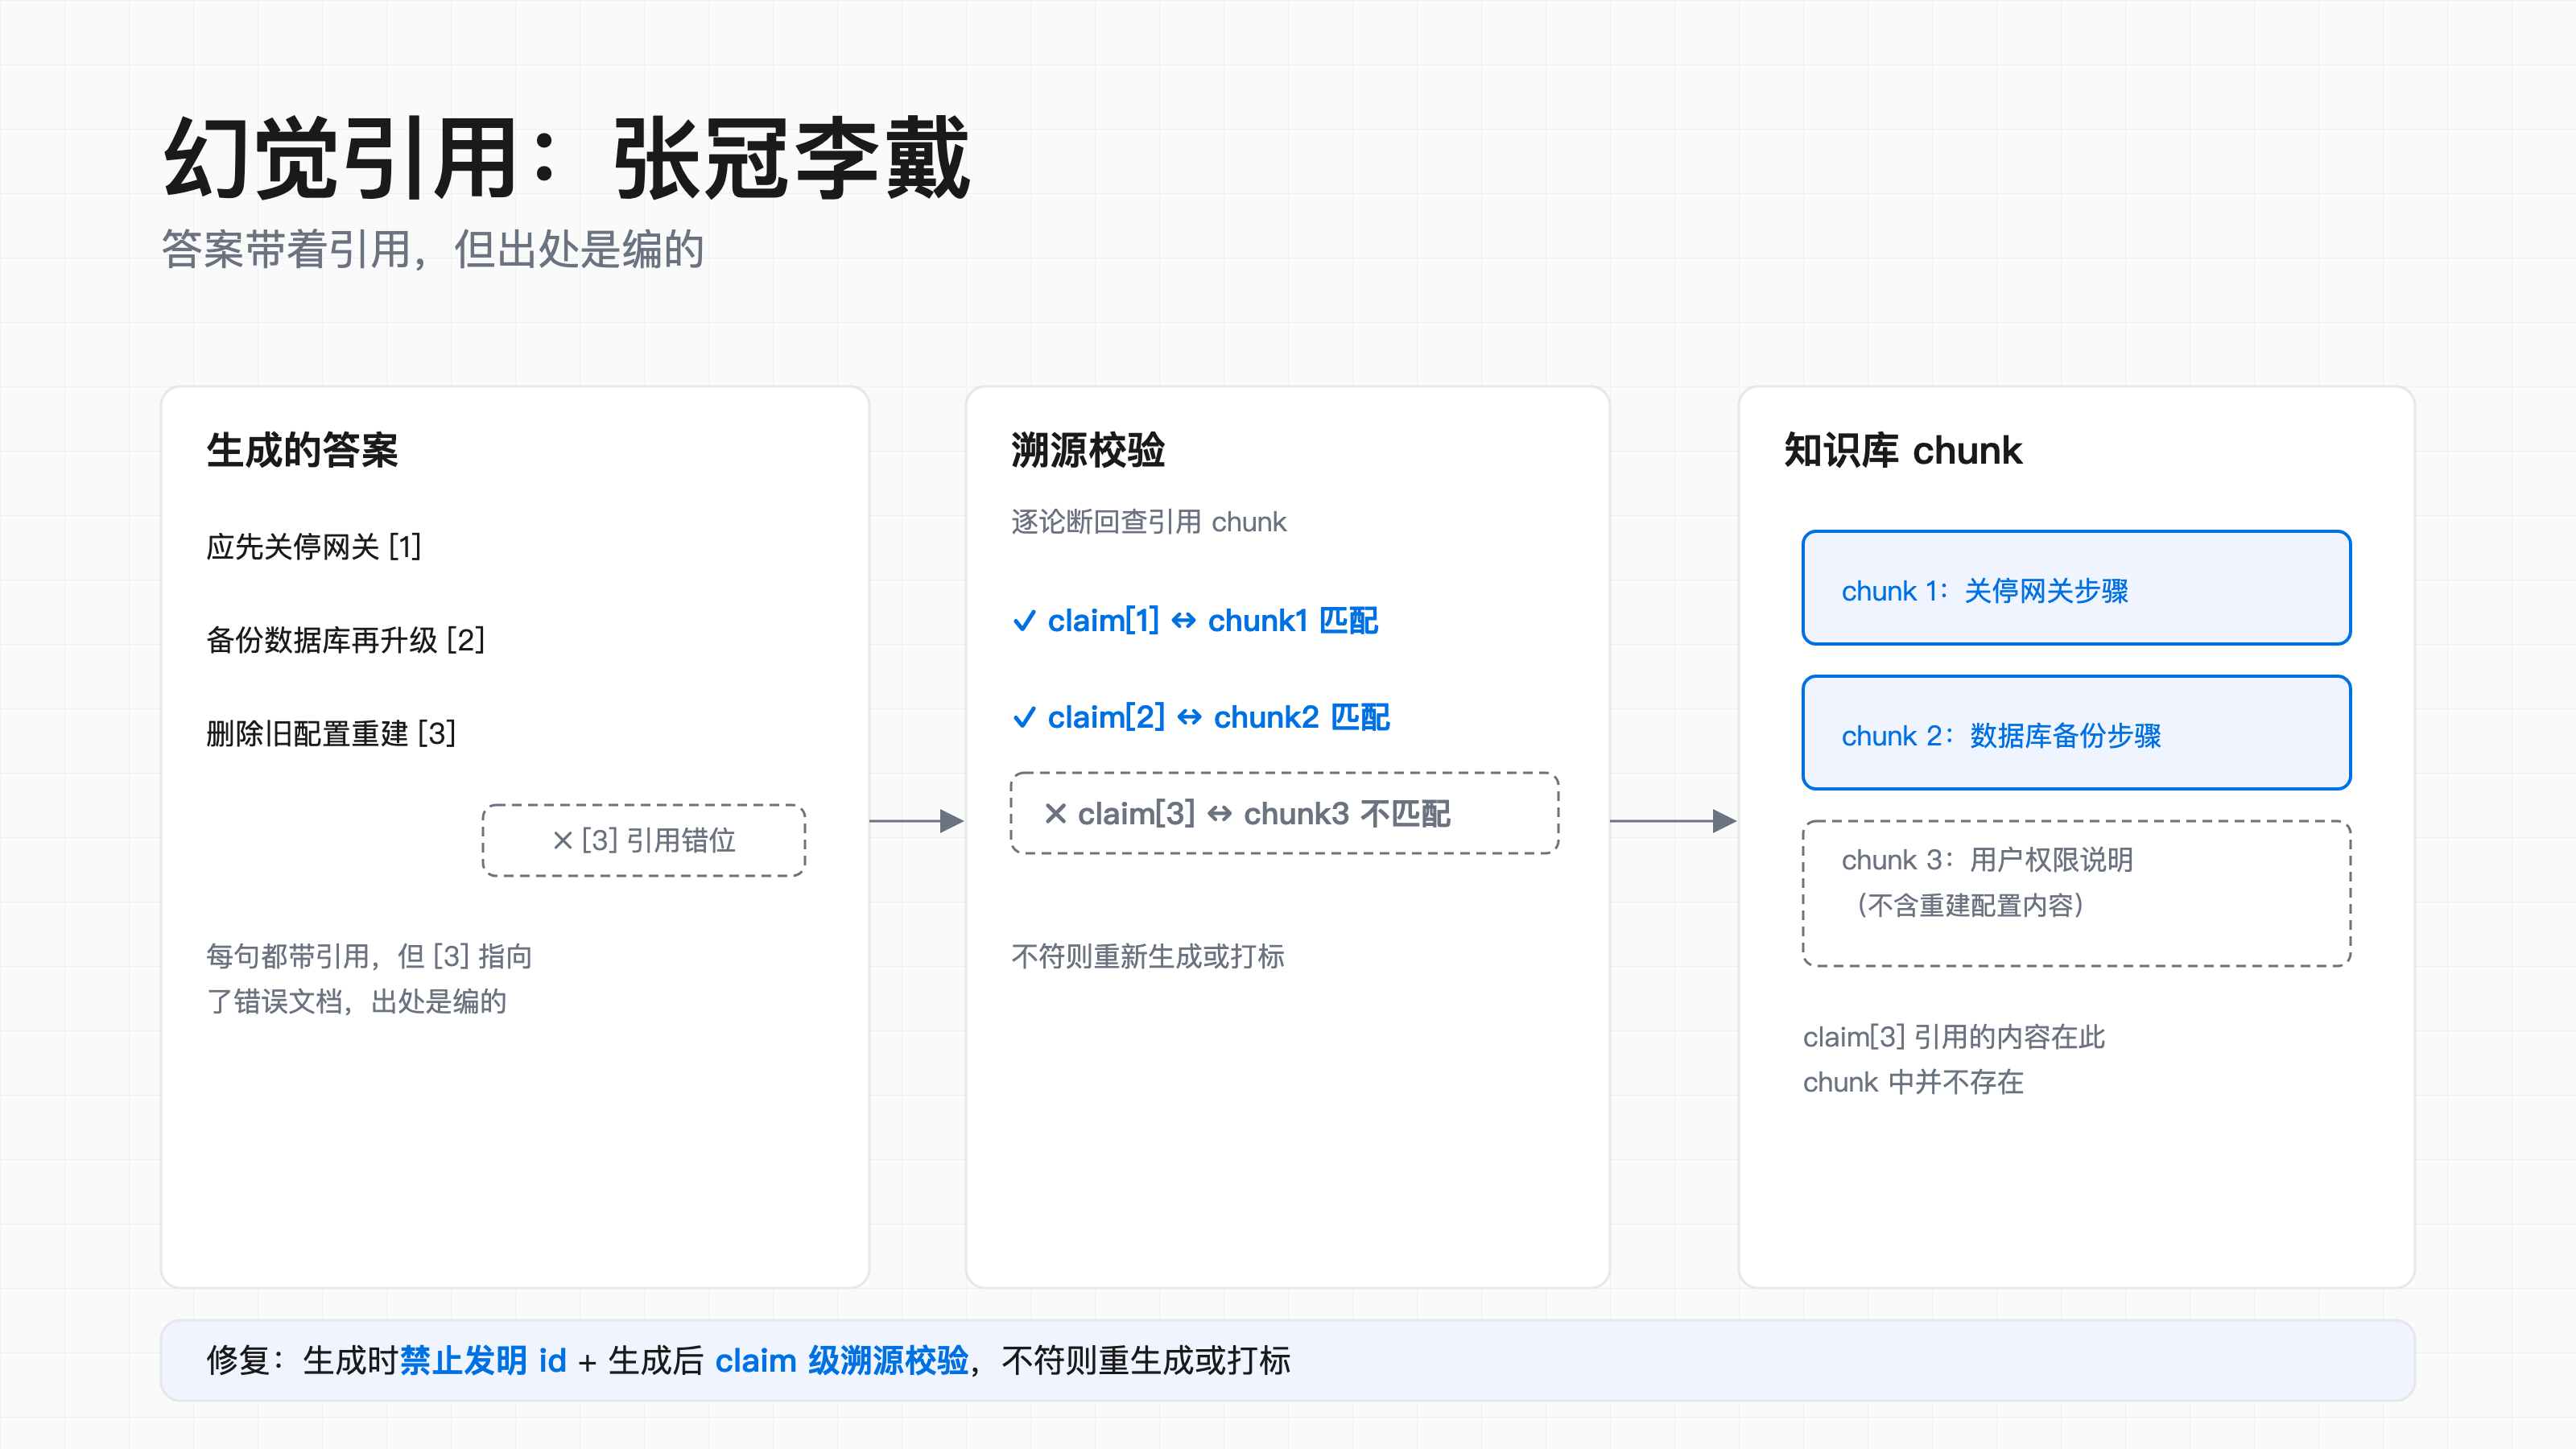
比编答案更隐蔽的是假引用。答案读起来有凭有据:"根据《部署手册》第 3.2 节,应先关停网关"。你去翻第 3.2 节,写的却是数据库备份。引用是假的,出处是编的,用户信了,后果比纯幻觉还严重,它披着可信的外衣。
机制
- 大模型生成时会"顺手"补一个看起来合理的引用标记,尤其当 prompt 要求"每个论断都标注来源"。
- 多文档拼接时,chunk 边界和文档元信息丢失,模型把 A 文档的结论安到 B 文档头上。
- 重排改变了 chunk 顺序,但引用下标没跟着更新,整条引用链错位。
监控信号
- 引用可溯源率 答案里每个带引用的论断,能否在对应 chunk 原文中找到支撑句。
- 引用偏移检测:引用的 chunk id 与实际支撑句所在 chunk 不一致的比例。
- 用户举报引用错误,这是最贵但最真实的信号。
修复手段
强制引用约束 + 溯源校验:
- 生成约束 要求模型只引用给定的 chunk id 集合,禁止发明 id。
- 生成后校验 抽答案里每个论断,回查它引用的 chunk 是否真包含支撑证据,不符就重新生成或打标。
# 幻觉引用:生成后逐论断回查证据
answer = generate(query, cited_chunks)
for claim in extract_claims(answer):
    cid = claim.citation_id
    if not has_evidence(claim.text, cited_chunks[cid]):
        claim.flag = "UNVERIFIED"          # 标记不可信
        # 或触发 regenerate,并限制最多重试 2 次
if too_many_unverified(answer):
    answer = reanswer_with_stricter_constraint(query, cited_chunks)
反例 prompt 里写"请为每句话标注引用",却没校验引用真实性。模型为了合规给每句都加了 1,数字和段落对不上也没人发现,直到一个细心用户逐条核对,在群里甩出截图。
四、成本爆炸:账单先崩了
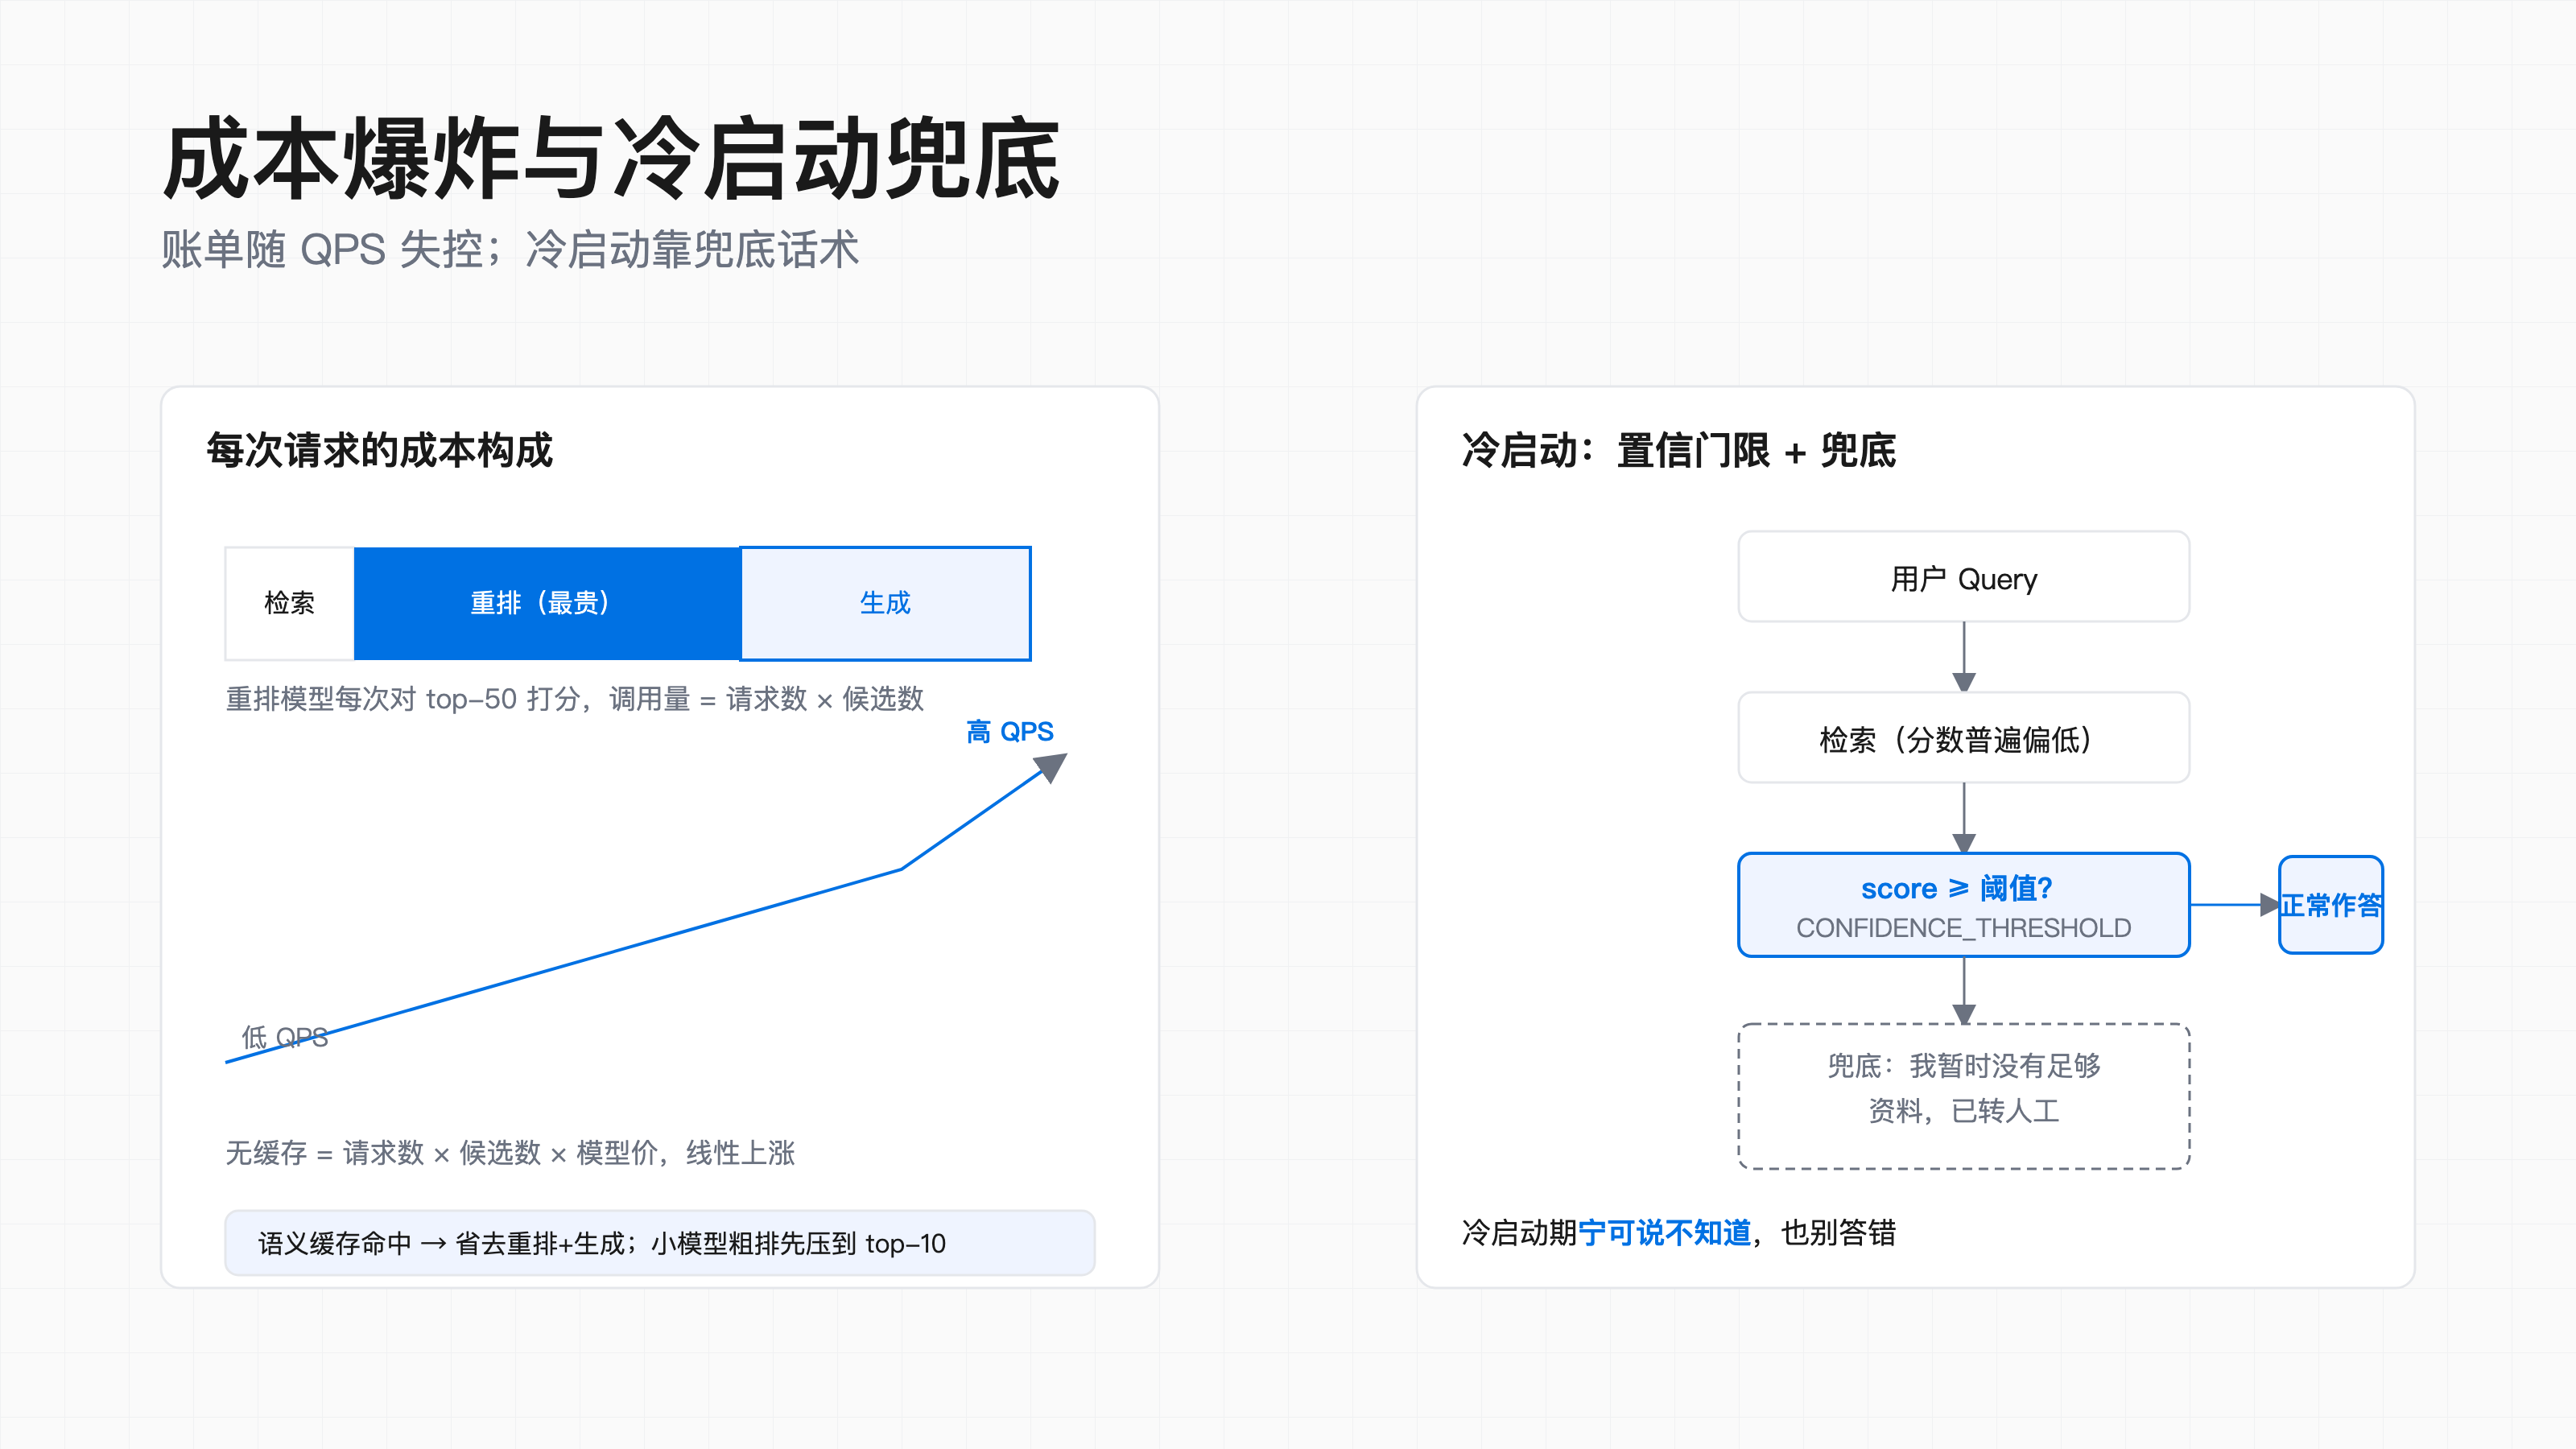
前三节讲"对不对",这一节讲"贵不贵"。RAG 每次请求的真实成本 = 检索调用 + 重排模型调用 + 长上下文生成。平时觉得不贵,一旦QPS 上来,账单是线性甚至超线性地涨。
机制
- 重排模型(reranker)通常是独立的小/中模型,每次对 top-50 打分,调用量 = 请求数 × 候选数。
- 长上下文生成:上下文越长,每 token 输入输出都更贵,且首 token 延迟更高。
- 没有缓存:相似问题反复检索、反复重排、反复生成,做了一堆重复劳动。
监控信号
- 单次请求成本的分位数 P50 / P95。
- QPS × 单次成本 的日账单趋势。
- 缓存命中率,命中为 0 说明全在重复计算。
修复手段
语义缓存 + 召回层数控制 + 小模型粗排:
- 语义缓存 对语义等价的 query 复用上一次的答案/检索结果,重排和生成直接省掉。
- 小模型粗排 用便宜的小模型先把 50 压到 10,再让贵的大模型只排 10。
- 召回层数控制 限制级联检索的跳数,避免多层展开放大调用。
# 成本爆炸:缓存 + 小模型粗排省钱
key = semantic_hash(query)               # 语义去重,不是字面相等
hit = cache.get(key)
if hit:
    return hit                           # 命中即返回,省下全部下游调用

coarse = small_model_rank(candidates, k=10)   # 便宜模型粗排 top-10
fine   = large_model_rank(coarse, k=3)        # 贵模型只排 top-3
answer = generate(query, fine)
cache.set(key, answer, ttl=3600)
反例 上线时日活几十,账单几十块,没人管成本。一次运营活动把 QPS 推到 20 倍,重排模型调用随之翻 20 倍,月底账单是预算的 13 倍。要是早接语义缓存和粗排,至少砍掉六成调用。
五、冷启动:知识库还在穿开裆裤
最后一个坑不在技术细节,在时间。知识库刚建起来时,覆盖是残缺的。你问 A,它没收录;问 B,只收了一半。这时候模型信心满格地答错,比"我不知道"危害更大,它错得理直气壮。
机制
- 覆盖率缺口 新业务、新文档还没进索引,长尾问题全部落空。
- 置信度虚高 检索到一点边角料,模型就敢延展成完整答案,误把"沾边"当"说对了"。
- 缺乏边界声明 系统不知道自己"不知道",不会主动交白旗。
监控信号
- 新文档入库占比与覆盖查询命中率随时间的变化。
- 低置信回答占比:检索分数普遍偏低但仍强行作答的请求比例。
- 用户纠正 / 反馈为负的比例。
修复手段
兜底话术 + 明确"我不知道" + 知识边界:
- 置信门限 检索分数低于阈值,直接走兜底,不强行作答。
- 兜底话术 明确告知"我暂时没有足够资料",并引导到人工或文档。
- 持续补全 把落空 query 沉淀下来反哺知识库,这块也能接上前面的语义缓存。
# 冷启动:置信门限 + 兜底,宁可说不知道
best = ranked[0]
if best.score < CONFIDENCE_THRESHOLD:
    return "这个问题我暂时没有足够资料,已记录并转人工补充"
if best.score < SOFT_THRESHOLD:
    return f"以下信息可能不完整:{generate(query, best)}"
return generate(query, ranked)            # 高置信才正常答
反例 知识库上线第一天就接到全员试用,大家问了一堆新功能文档还没上传的问题。系统答得斩钉截铁,三个部门同事照着错答案做了配置,返工成本比重新建库还高。
反例与反模式:只测 happy path 就上线
- 只在 perfect case 上验收 上线前用几条"答案就在第一段"的样例跑通就判可用。真实流量里 query 千奇百怪,happy path 覆盖率可能不到 5%。
- 没有失败模式演练 没做过"抽掉某段知识""注入噪声 chunk""并发打满"的演练。事故来了才逐个补,被动挨打。
- 监控只看成功率 成功率 99% 看起来很美,但那 1% 的失败全是幻觉引用和编造,恰恰是最伤信任的。
正解:上线前把五个失败模式各造一组对抗样本,跑一遍看系统怎么崩、怎么兜底。把"无引用命中率""引用可溯源率""单次成本 P95"钉成看板,事故还没发生就能看见趋势。提前布防,胜过事后救火。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号