温湿度一体化监控平台数据架构设计:图书馆库房环境时序数据存储与查询
原创
温湿度一体化监控平台数据架构设计:图书馆库房环境时序数据存储与查询
原创
盛世宏博科技
发布于 2026-11-18 15:42:19
发布于 2026-11-18 15:42:19
温湿度一体化监控平台数据架构设计:图书馆库房环境时序数据存储与查询
物联网 · 智慧图书馆 · 时序数据存储 · 盛世宏博
一、引言
图书馆库房温湿度与空气质量一体化监控平台,持续采集海量环境感知数据,包含温湿度、PM2.5、PM10、VOC、二氧化硫、硫化氢、设备运行状态、故障告警、机组联动记录等多类信息。区别于普通业务平台的事务型数据,库房环境数据具备高频采集、时序强关联、测点数量庞大、长期归档、查询模式固定等特征。在古籍特藏库、密集书库、过刊库房、音像载体库房的长期运维与审计要求下,平台不仅要实现实时数据展示、告警推送,还需要支撑跨月份、跨年度历史曲线回溯、超标统计、馆藏环境评估报表、专项检查溯源。
很多早期监控平台直接采用传统关系型数据库 MySQL、SQL Server 存储环境采集数据,项目上线初期运行正常,随着测点增加、数据日积月累,逐步出现查询卡顿、报表生成超时、磁盘占用爆炸、数据清理困难等问题。尤其是图书馆库房项目,测点按分区部署,单校区几十个库房、上百个传感节点,采集周期普遍2~5秒一条,一年单测点数据量可达数百万条,传统数据库面向行存储、事务优先的设计思路并不适配时序场景。
同时,图书馆行业还有特殊约束:信创国产化适配、数据不可随意删除、日志全链路留存、断网补传数据一致性、多维度筛选(按库房、分区、测点、时间区间、超标类型)、低并发下的稳定查询,以及和边缘网关离线缓存链路协同。本文围绕图书馆库房温湿度一体化监控平台,从时序数据特征、分层数据架构、存储选型、写入链路、索引设计、查询优化、冷热分层、数据治理、灾备审计、落地坑点等维度,完成一套面向馆藏环境场景的时序数据架构设计,兼顾实时展示、历史回溯、报表导出、信创适配需求,适用于新建智慧图书馆监控平台开发,也可用于存量平台存储架构重构。
二、图书馆库房环境时序数据业务特征与访问模型
2.1 时序数据核心特征
- 时间单调递增:每一条感知记录都携带采集时间戳,数据产生顺序和时间强绑定,数据几乎不会更新历史旧记录,以追加写入为主,更新场景极少,仅存在少量补传修正。边缘网关断网缓存恢复后批量补传,是最主要的非实时写入场景。
- 测点维度固定:基础维度包含库房ID、分区ID、测点编号、传感器类型、协议类型(Modbus TCP/UDP/SNMP)、设备IP、从站地址;指标为温度、湿度、PM2.5、PM10、VOC、H₂S、SO₂、设备状态、故障码、机组模式。维度字段相对稳定,不会频繁变更。
- 写入流量平稳、持续高频:常规测点轮询周期2
5s,参考测点1020s,写入流量均匀,无电商类尖峰脉冲流量;但大库房集群测点总量高,长期累积数据体量巨大。 - 查询具有明显的时间局部性:高频查询分为两类,一类是近7天实时曲线,用于日常运维查看;另一类是月度、季度、年度区间报表,用于图书馆评估、专项检查、审计溯源;极少随机查询零散时间点。
- 数据生命周期分层:最近30天数据需要高并发、低延迟查询;30天~1年数据用于常规报表;1年以上归档数据,访问频次极低,仅在古籍保护专项验收、档案核查时调取。
- 数据质量干扰多:存在传感器漂移、网络抖动、网关重试、粘包解析异常、探头故障带来的脏数据,架构需要内置数据清洗、标记、过滤能力,不能直接落库原始报文。
2.2 业务访问模型梳理
写入侧来源
- 边缘网关实时上报标准化时序指标(主数据流);
- 网关离线缓存恢复后的批量补传数据(回灌数据流,容易产生乱序);
- 人工校准记录、传感器校准台账、设备更换记录(元数据,低频写入);
- 告警事件、联动动作日志、用户操作日志(事件流,独立于环境指标流)。
查询侧业务场景
- 大屏实时监控:查询每个测点最新一条数据,刷新周期5s;
- 单测点曲线:选定库房+测点,查询一段时间内连续指标,前端渲染曲线;
- 分区统计报表:按库房分区,统计区间内温湿度最大值、最小值、平均值、超标时长、超标次数;
- 复合条件检索:筛选同时满足湿度超标、酸性气体超标记录,用于复合风险复盘;
- 审计溯源:根据时间范围,查询某台设备全部采集记录、联动指令日志;
- 导出归档:批量导出CSV、Excel报表,用于馆藏保护报告、上级检查。
约束边界
- 不支持高频修改历史采集值;
- 补传数据允许时间戳早于当前系统时间,需要支持乱序写入;
- 信创环境:支持国产服务器、国产操作系统、国产数据库适配;
- 数据留存要求:行业常规要求环境监测数据至少留存3~5年,古籍特藏库建议长期归档。
2.3 传统关系库存储痛点复盘
大量项目直接使用MySQL存储时序表,表结构:时间戳、测点ID、温度、湿度、PM2.5、状态,单表持续写入,随着数据量上涨,暴露一系列问题:
- 索引压力大:时间索引、测点索引叠加,写入时索引维护开销持续上涨,写入变慢;
- 区间查询扫描行数巨大:查询一年曲线,需要扫描数百万行,超时、拖垮数据库;
- 分区维护复杂:MySQL分区依赖人工维护,冷热数据迁移成本高;
- 压缩效率差:时序数据重复度高,行存储压缩率低,磁盘占用高;
- 批量补传容易锁表:网关断网恢复一次性回灌几千条历史数据,容易引发锁竞争,影响实时写入。
因此,一体化监控平台架构采用时序数据库承载指标流 + 关系库承载元数据与告警事件的混合架构,而不是单一数据库。
三、分层数据整体架构设计
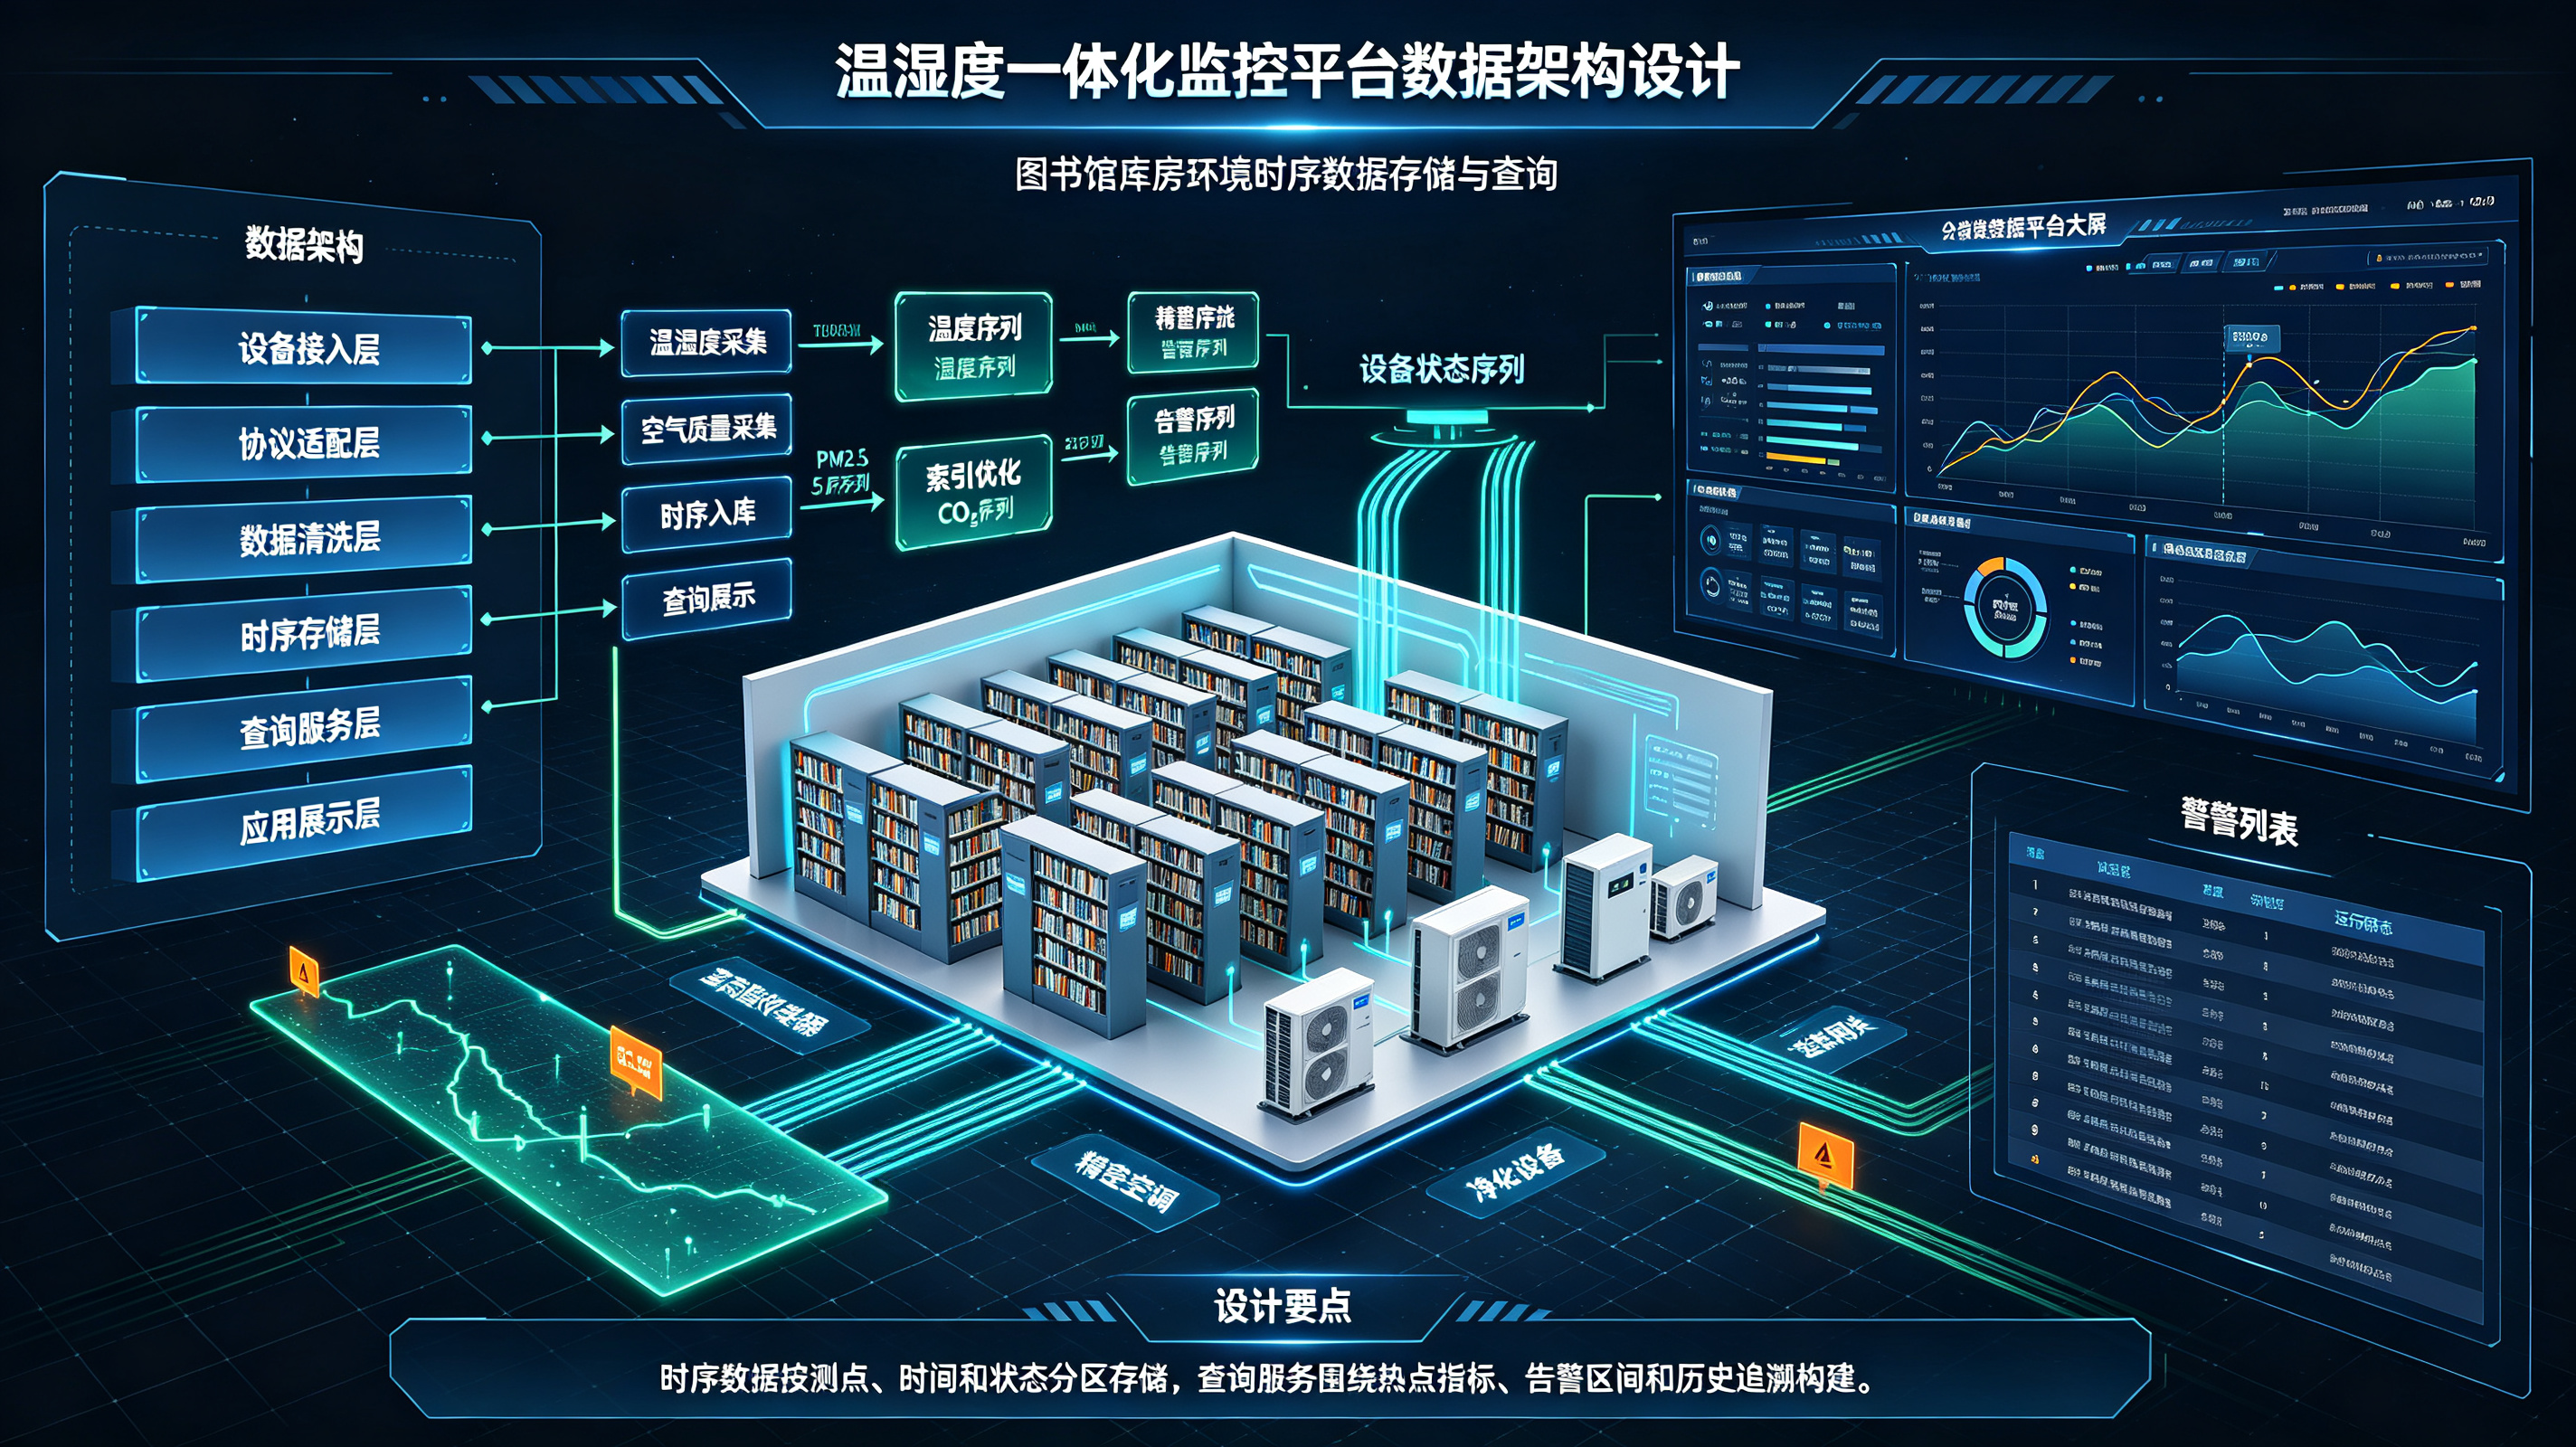
整体架构分为四层:采集接入层、数据清洗与转发层、存储分层层、应用服务层,配套统一元数据管理、数据质量模块、灾备与审计模块。
3.1 采集接入层
接入来源为部署在各个库房的国产化边缘网关,网关完成Modbus TCP/UDP/SNMP协议解析、本地联动、异常过滤,向上统一以MQTT协议或者HTTP批量上报标准化JSON报文,不直接透传原始Modbus报文。 单条上报报文样例:
{
  "gatewayId":"GW-001",
  "warehouseId":"LIB-01-01",
  "zoneId":"ZONE-02",
  "sensorId":"S-0012",
  "ip":"192.168.1.12",
  "ts":1763456789000,
  "temp":20.3,
  "hum":52.1,
  "pm25":12,
  "pm10":16,
  "voc":0.21,
  "h2s":0.002,
  "so2":0.001,
  "devStatus":0,
  "quality":"good"
}
网关支持批量打包上报,降低连接开销,批量包内携带多条不同测点或者同一测点历史补传数据。
3.2 数据清洗与转发层
该层作为消息中间件+计算处理,承担流量削峰、乱序处理、脏数据过滤、指标标准化,是隔离采集端和存储端的缓冲层。
- 消息队列:采用MQTT Broker或者Kafka作为消息总线,实时数据和补传数据分Topic隔离,避免历史补传流量冲击实时流;
- 流式计算处理器:消费消息,执行一系列校验规则:
- 时间戳校验:时间戳不能为未来时间,历史补传时间戳设置可容忍窗口(例如7天),超过窗口直接丢弃并记录异常日志;
- 值域校验:温度 -10
60℃,湿度0100%RH,气体浓度不能为负数,超出范围标记为invalid脏数据,不写入时序库,写入异常日志表; - 重复数据去重:根据sensorId+ts联合去重,防止网关重试上报重复报文;
- 指标衍生计算:同步计算当日温湿度波动幅度、是否超标,打上标签tag(normal、warn、alarm);
- 分流:清洗完成后,时序指标流向时序数据库;告警事件、用户操作、设备台账、测点元数据流向关系型数据库;原始全量报文可选择写入对象存储归档,用于问题复盘。
3.3 存储分层层(核心)
采用冷热分离存储架构,三类存储组件各司其职,不混用。
(1)时序数据库(核心指标存储)
用于存放清洗后的环境时序指标,选型优先支持信创适配的时序数据库,例如InfluxDB、TDengine、DolphinDB,在国产化环境下优先TDengine,适配鲲鹏、飞腾芯片,银河麒麟、统信操作系统。 数据模型设计:
- 超级表(STable):
env_data,统一所有环境测点; - 标签(TAG):warehouseId、zoneId、sensorId、sensorType,标签用于快速分区过滤;
- 字段(FIELD):temp、hum、pm25、pm10、voc、h2s、so2、devStatus、quality;
- 主键:timestamp + sensorId; TDengine天然按标签分片,同一库房、同一测点的数据自动聚合,时序区间查询效率极高,自带数据压缩,时序数据压缩比通常可以达到5~10倍,大幅降低磁盘压力。
数据生命周期TTL策略:
- 热数据(0
30天):原始精度,保留原始采集粒度(25s),内存+磁盘缓存,低延迟查询; - 温数据(30天~1年):降采样聚合,生成5分钟聚合值(最大值、最小值、平均值),原始细粒度数据自动归档;
- 冷数据(1年以上):聚合为1小时统计值,写入低成本归档存储,仅保留统计指标,原始高频点按需离线归档至对象存储。
降采样是时序库优化的核心:前端查看年度曲线时,直接读取1小时聚合数据,不需要扫描数百万原始点,曲线渲染速度提升数十倍。定时降采样任务由数据库自带定时任务或者外部调度器执行。
(2)关系型数据库(国产兼容,如达梦、人大金仓、MySQL)
不存放高频时序指标,只存放结构化元数据和事务类数据:
- 测点元数据表:库房信息、分区信息、传感器档案、IP、协议、校准记录、设备型号、安装位置;
- 告警事件表:告警开始时间、结束时间、告警等级、测点、告警内容、处置人、处置时间;
- 联动日志表:下发Modbus指令、机组启停、风阀调节记录;
- 用户权限、角色、报表任务、导出任务记录; 元数据和时序库通过sensorId外键关联,平台展示时,时序库拿指标,关系库拿测点名称、库房备注、位置描述。
(3)对象存储(MinIO、国产对象存储)
两类归档内容:
- 原始未清洗报文日志,保留周期3个月,用于故障排查、报文抓包复盘;
- 导出的历史报表文件、年度环境评估报告,长期归档; 对象存储低成本、适合大文件、低频访问数据,不参与实时查询链路。
3.4 应用服务层
业务服务基于存储层封装统一数据访问SDK,对上层大屏、Web接口、报表服务、告警服务提供统一能力,屏蔽底层存储差异。 接口分为三类:
- 实时数据接口:查询最新测点值,从时序库读取最新一条;
- 历史曲线接口:自动根据查询时间跨度,选择原始粒度或者降采样聚合数据;
- 统计报表接口:读取聚合结果,计算超标时长、极值、均值,生成馆藏环境报表。
四、时序库表结构与降采样设计(TDengine示例)
4.1 超级表定义
CREATE STABLE env_data (
  ts TIMESTAMP,
  temp FLOAT,
  hum FLOAT,
  pm25 FLOAT,
  pm10 FLOAT,
  voc FLOAT,
  h2s FLOAT,
  so2 FLOAT,
  devStatus TINYINT,
  quality BINARY(16)
) TAGS (
  warehouseId BINARY(32),
  zoneId BINARY(32),
  sensorId BINARY(32),
  sensorType BINARY(32)
);
每一个传感器自动生成一张子表,标签作为分区维度,查询时优先过滤标签。
4.2 降采样子表设计
- 5分钟聚合表
env_5min:按sensorId + 5min时间窗口,统计max、min、avg; - 1小时聚合表
env_1hour:按sensorId + 1h窗口,统计max、min、avg、超标次数; 定时任务执行窗口聚合,写入对应聚合表,聚合表和原始表标签保持一致。 前端查询逻辑:
- 时间区间 ≤7天:查询原始细粒度表;
- 7天<区间 ≤90天:查询5分钟聚合表;
- 区间>90天:查询1小时聚合表; 这个逻辑在服务层封装,前端无感知,避免超长区间查询原始海量点。
五、写入链路优化与乱序数据处理
图书馆场景写入最大难点来自网关断网补传带来的乱序数据。网关在库房断网时本地缓存几百、几千条数据,网络恢复后批量上报,报文时间戳远小于当前系统时间,属于典型乱序写入。 优化方案:
- 设置时序库乱序容忍窗口,例如24h,窗口内的乱序数据允许写入;超过窗口直接丢弃并记录异常;
- 实时Topic和补传Topic分离,补传流量单独限流,防止瞬间大量历史数据打满写入带宽;
- 网关侧限制单次补传批量大小,单批次不超过200条,分批上报;
- 去重逻辑放在消息处理层,基于sensorId+ts唯一键去重,避免网关重试产生重复时序点;
- 写入幂等:同一报文重复投递,不会产生重复记录。
写入性能优化:
- 开启批量写入,单批次100~200条;
- 按库房分区打散写入,避免单点写入热点;
- 标签提前规划,不要动态新增标签,动态标签会严重降低时序库性能。
六、查询优化方案
6.1 标签优先过滤
所有查询条件优先使用TAG过滤warehouseId、sensorId,再做时间范围筛选,时序数据库基于标签分片,过滤速度远快于字段过滤。 反例:先查时间,再过滤测点;正例:先锁定测点标签,再限定时间区间。
6.2 曲线查询自动降采样
业务层封装路由,根据时间跨度自动切换聚合表,是图书馆平台最关键的优化点。很多平台卡顿,就是因为查一年曲线还在读取原始秒级数据。
6.3 报表预计算
月度、季度报表是固定查询模式,不要每次用户点击报表实时计算。增加定时报表任务,每月固定时间,预计算所有库房分区统计结果,存入关系库报表结果表,用户打开报表直接读取预计算结果,响应速度毫秒级。 预计算指标:区间温湿度最大值、最小值、平均值、湿度超标总时长、温度超标次数、酸性气体超标记录数。
6.4 缓存加速
Redis缓存热点数据:
- 所有测点最新实时值,缓存5s;大屏刷新直接读Redis,不穿透时序库;
- 近24h高频查看的测点曲线,缓存聚合结果; 缓存失效策略:时间窗口滚动失效,不缓存跨年度冷数据。
七、数据质量、校准与数据血缘设计
图书馆环境数据具备审计属性,数据不能只存数值,必须绑定质量信息:
- 脏数据标记:值域异常、解析失败、探头故障的数据标记,报表统计时可以选择“是否排除无效数据”;
- 传感器校准关联:时序记录和校准台账关联,当传感器完成校准之后,历史数据可以标记校准版本,区分校准前后数据;
- 数据血缘:每一条指标记录,记录来源网关、上报时间、清洗时间,出现异常数值可以回溯到原始报文;
- 告警联动:时序指标一旦持续触发阈值,流转到告警引擎生成告警事件,写入关系库告警表。
八、灾备、备份与信创适配要点
8.1 备份策略
- 时序库:定时快照备份,热数据每日备份,冷数据每周备份;
- 关系库:逻辑备份,每日全量备份+binlog增量;
- 跨机房备份:重要古籍馆项目,开启异地备份;
- 备份校验:定期恢复测试,保证备份文件可读取,满足审计调取。
8.2 信创适配约束
- 数据库选型优先国产时序库、国产关系库,避免强依赖国外闭源组件;
- 中间件、操作系统、服务器芯片全栈适配;
- 网络隔离:时序数据库不直接暴露办公网,由业务服务层统一访问,符合等保2.0;
- 日志留存:所有数据访问、导出操作日志留存,满足文博单位等保审计要求。
九、落地高频踩坑清单
- 标签随意新增:开发阶段频繁新增tag,导致时序库分片膨胀,写入查询性能持续下降;标签提前在需求阶段固定;
- 不做降采样:所有查询直接读取原始表,年度报表几十秒加载超时,用户体验差;
- 乱序窗口设置过大:窗口设置几天,大量过期补传数据写入,数据库索引持续膨胀;
- 时序库存储所有元数据:把测点名称、位置都放在时序标签,标签过大,索引效率降低;元数据放到关系库;
- 没有限流:网关断网恢复一次性推送上万条历史数据,瞬间打满数据库IO;
- 报表实时计算:每次导出报表都实时扫描海量时序数据,导出任务容易超时失败;
- 忽略时间时区:全部时间戳统一使用UTC时间戳,前端根据图书馆本地时区转换,避免夏令时、时区偏移导致曲线错位。
十、方案适用边界
本架构面向图书馆库房温湿度+空气质量一体化时序监控场景,适合测点规模几十到几百个的智慧图书馆项目;如果扩展到上万测点的园区级物联网平台,需要进一步增加分布式时序集群、分片路由能力。 时序数据库擅长指标追加、区间查询,但不适合复杂多表关联、复杂事务;所以和关系库混合使用,各司其职。同时时序架构解决的是数据存储查询问题,上游的传感器校准、边缘网关联动逻辑依然独立在边缘层,存储层不参与实时控制逻辑,保证断网自治。
十一、总结
图书馆库房温湿度一体化监控平台的数据架构,核心是区分时序指标流和事务元数据流,采用时序数据库承载高频环境指标,关系库承载设备台账、告警、联动日志,对象存储负责原始报文与报表归档,搭配消息队列削峰、流式清洗、冷热分层降采样、Redis热点缓存的整套体系。 针对图书馆场景独有的网关断网补传乱序、长期归档审计、信创适配、馆藏评估报表需求,通过标签化分片、自动降采样、预计算报表、可控乱序窗口等手段,解决传统关系库存储时序数据查询慢、磁盘占用高、报表超时的痛点。这套架构既能支撑大屏实时监控低延迟展示,也可以稳定支撑跨年度历史曲线回溯、馆藏环境评估、上级专项检查的数据溯源,为古籍、图书文献长期保存提供可靠的数据底座。
关键词:物联网,智慧图书馆,温湿度监控,时序数据库,时序数据,数据架构,TDengine,数据存储,环境监测,盛世宏博
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号