科研实验室以太网温湿度记录仪UDP报文解析实践
原创
科研实验室以太网温湿度记录仪UDP报文解析实践
原创
HONSOR盛世宏博
发布于 2026-11-19 14:24:50
发布于 2026-11-19 14:24:50
科研实验室以太网温湿度记录仪UDP报文解析实践
物联网 · 实验室环境监控 · UDP报文解析 · 盛世宏博
一、实践背景与需求说明
科研实验室包含精密仪器室、标准物质储藏间、样品前处理区、天平室等功能区域,对于温湿度数据的实时性、时序连续性、数据溯源能力有着明确要求,部分检测实验室需要满足CNAS、CMA评审对原始监测数据的审计规范。在大规模多点位部署场景中,以太网温湿度记录仪采用UDP主动上报模式,相比TCP轮询、Modbus TCP轮询架构,具备更低的传输时延、更高的并发承载能力,单台边缘网关可以接入上百台终端设备,适合大面积、多分区实验室集群监测。
UDP协议本身属于无连接传输协议,不存在握手、ACK应答、内置重传机制,报文传输可靠性完全依靠上层业务逻辑实现。同时,市面上以太网温湿度记录仪的UDP报文大多为厂商自定义二进制私有协议,没有统一标准,报文结构、字节序、校验方式、字段定义各不相同,在现场调试阶段极易出现报文接收正常、解析错误、脏数据入库、时间戳错乱、设备识别失败等问题。很多项目故障根源并不是网络不通,而是报文解析逻辑适配缺陷,包括字节序混淆、偏移量计算错误、校验算法不匹配、预留字段误解析、补发报文和实时报文混处理等。
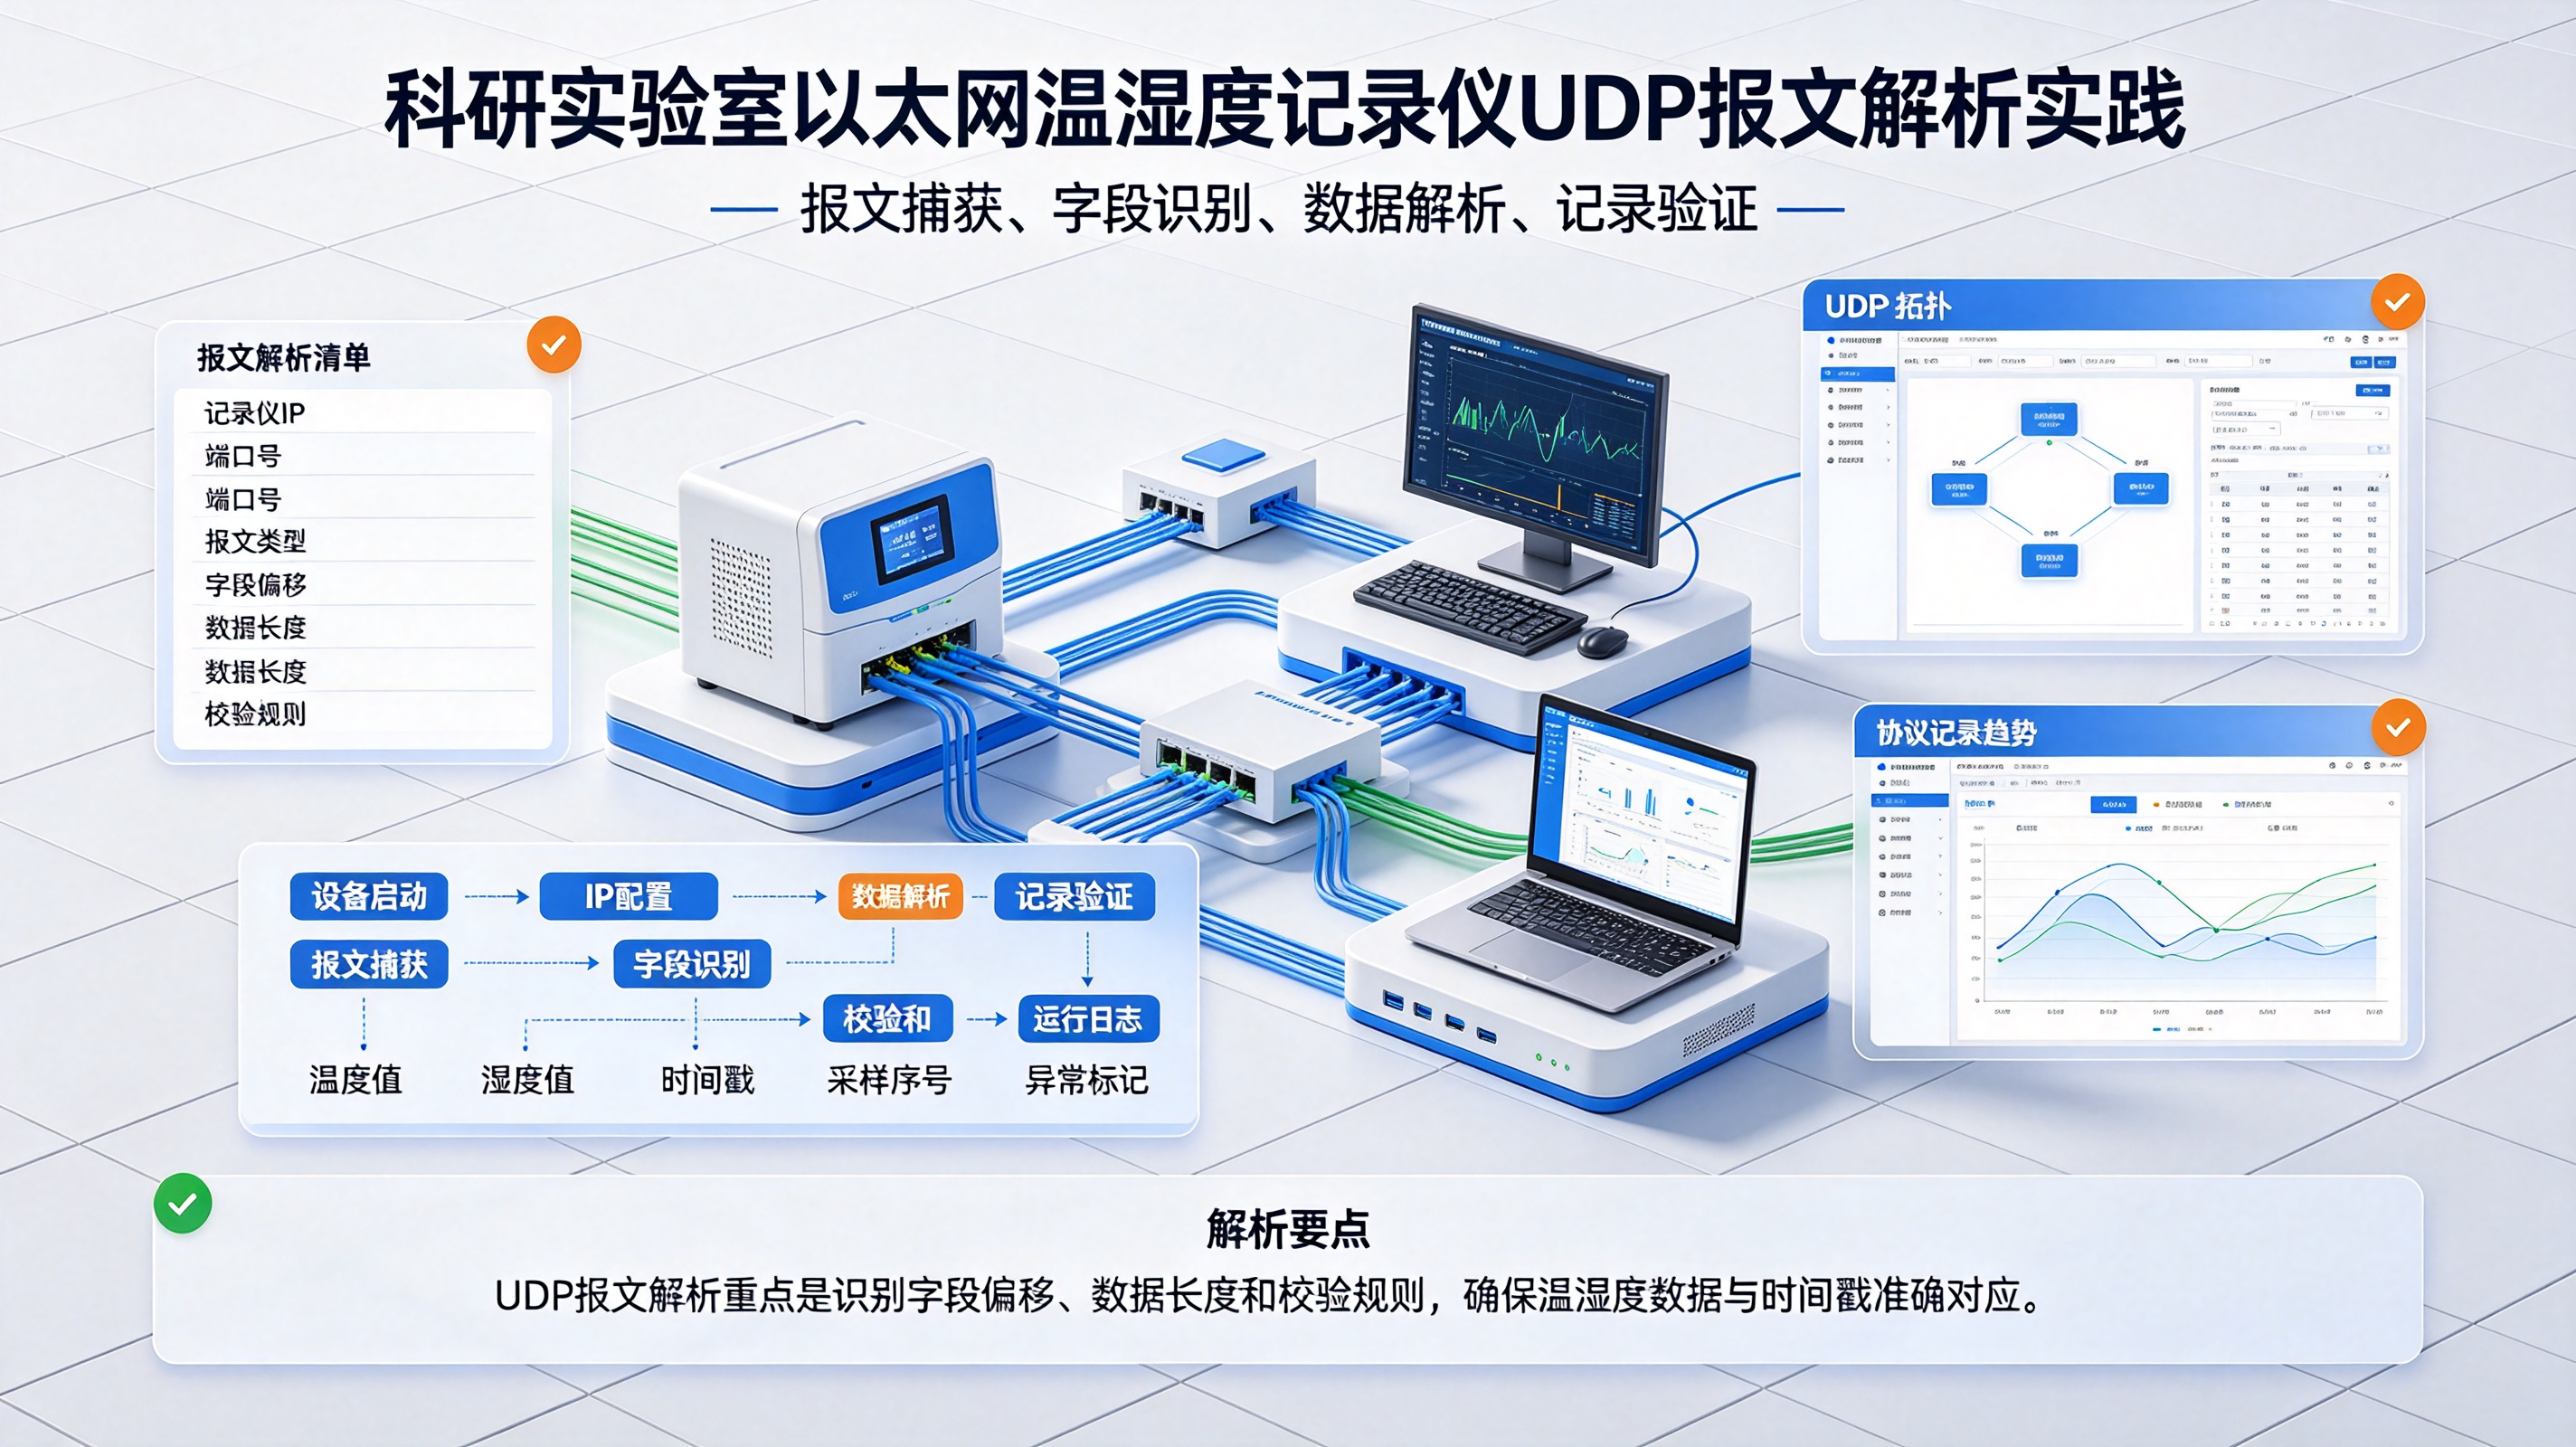
本次实践围绕科研实验室自研UDP报文格式,从报文结构定义、抓包分析、字节序处理、CRC校验实现、解析代码开发、异常报文过滤、补发报文识别、时序对齐、现场调试排错、数据入库规范等环节完整落地,形成一套可复用的UDP二进制报文解析流程,适配实验室温湿度记录仪高频采集、断点缓存补发、多设备并发上报的业务场景。
二、UDP报文基础特征与实验室场景约束
科研实验室网络环境具备特殊性,网段多采用VLAN隔离,交换机默认开启UDP风暴抑制、端口限速策略,部分点位距离边缘网关较远,报文传输过程存在比特翻转、丢包、重复推送现象;同时记录仪开启自定义重传机制,同一条采集报文会多次发送,网关侧会收到大量重复UDP数据包。 在这类场景下,UDP报文解析程序不能只做简单的字段提取,必须内置完整的过滤、校验、去重、时序处理逻辑。 本项目选用的以太网温湿度记录仪工作模式为主动上报,设备按照配置周期(默认1s,可配置500ms~60s)向边缘网关固定IP与端口发送UDP报文;设备内置Flash存储,网络中断时缓存采集数据,网络恢复后批量补发历史报文,实时报文与补发报文共用同一套报文结构,依靠状态标记位区分。 报文承载在IPv4 UDP数据包内,UDP头部由交换机、操作系统内核处理,应用层只需要读取UDP载荷(Payload)部分,也就是自定义二进制报文。在抓包分析时,Wireshark中过滤条件为udp.port == 目标端口号,只关注UDP载荷数据,排除UDP头部8字节。
三、自定义UDP报文结构定义
本项目记录仪UDP载荷固定长度64字节,采用大端(Big-Endian)字节序,二进制字段连续排布,帧头固定用于同步,CRC16校验覆盖帧头至状态扩展字段,预留字段用于后期扩展露点、VOC、压差、光照等环境参数采集。报文字段详细分配如下:
偏移地址(Byte) | 字段长度(Byte) | 字段名称 | 字段说明 |
|---|---|---|---|
0 | 2 | FrameHeader 帧头 | 固定 0xAA 0x55,用于帧同步,过滤无效杂包 |
2 | 4 | DeviceSN 设备序列号 | uint32,设备唯一标识,不依赖IP识别点位 |
6 | 2 | TempRaw 温度原始值 | int16,放大系数10,实际温度=原始值/10.0,支持负数 |
8 | 2 | HumRaw 湿度原始值 | int16,放大系数10,实际湿度=原始值/10.0 |
10 | 4 | Timestamp 采集时间戳 | uint32,Unix时间戳,设备本地采集时刻 |
14 | 2 | Status 设备状态字 | bit位定义:bit0传感器故障,bit1低电压,bit2超限告警,bit3补发标记 |
16 | 2 | AlarmThreshold 告警标识 | 预留区分温/湿度超限,0无告警,1温度超限,2湿度超限,3温湿度同时超限 |
18 | 2 | CRC16校验值 | 校验范围:偏移0~17字节,CRC16-Modbus多项式 0x8005 |
20~63 | Reserve 预留扩展区 | 44字节 | 预留扩展环境参数,默认填充0x00 |
重点字段说明:
- 补发标记位:Status的bit3置1时,代表本条报文为网络恢复后的历史补发报文,平台在报表统计时纳入时序,但日志中标记补发,方便审计区分实时采集和补传数据;
- 时间戳为记录仪本地NTP同步后的采集时间,不是网关接收报文时间,避免网络延迟带来的时序偏差;
- 温度字段为有符号整型,覆盖低温样品储藏室0℃以下监测场景;
- 帧头固定双字节,用于快速过滤随机干扰产生的无效报文,减少后续校验计算开销。
四、抓包分析与报文预校验流程
报文解析开发前,必须先在现场完成抓包采样,确认报文长度、字节序、校验算法,避免文档和固件实际输出不一致。推荐两种抓包方式:网关本地tcpdump抓包、交换机镜像口Wireshark抓包。 tcpdump抓包命令示例:
tcpdump -i eth0 udp port 18600 -X -w lab_udp.pcap抓包得到pcap文件后,使用Wireshark打开,定位UDP数据包,查看Data段二进制载荷,核对帧头、SN、温湿度数值、校验字节。 完整预校验顺序不可颠倒: 第一步:报文长度校验,判断载荷长度是否等于64字节,长度不符直接丢弃; 第二步:帧头校验,判断前两个字节是否为0xAA、0x55,帧头错误直接丢弃; 第三步:CRC16校验,取0~17字节数据,使用0x8005多项式计算CRC,和报文内CRC字段比对,校验失败判定为传输比特翻转,丢弃脏包; 第四步:字段解析,校验全部通过之后,再提取SN、温湿度、时间戳、状态、补发标记等业务字段; 第五步:报文去重,基于SN+采集时间戳组合做去重,过滤重传产生的重复报文。
很多工程调试中出现的异常数据,都是跳过前置校验,直接解析字段,干扰报文直接进入业务逻辑,造成曲线跳变、告警误触发。
五、CRC16校验算法实现(CRC16-Modbus)
报文校验采用工业场景通用CRC16-Modbus,多项式0x8005,初始值0xFFFF,输出不反转,是很多物联网记录仪通用方案,也是现场最容易踩坑的点:字节序、初始值、输出反转配置错误,会出现抓包报文看起来正常,但校验永远失败。 Python参考实现代码,用于调试阶段校验:
def crc16_modbus(data: bytes) -> int:
    crc = 0xFFFF
    poly = 0xA001
    for b in data:
        crc ^= b
        for _ in range(8):
            if crc & 0x0001:
                crc = (crc >> 1) ^ poly
            else:
                crc = crc >> 1
    return crc

# 校验区域:报文0~17字节
crc_calc = crc16_modbus(raw_data[0:18])
crc_pkt = int.from_bytes(raw_data[18:20], byteorder="big")
if crc_calc == crc_pkt:
    print("CRC校验通过")
else:
    print("CRC校验失败")
在边缘网关高并发场景,正式业务代码改用C语言实现CRC查表法,提升计算效率,减少CPU占用,适合单网关上百台终端并发上报场景。
六、UDP报文解析核心代码实现
解析程序运行在Linux工业边缘网关,采用socket监听UDP端口,接收报文之后执行校验、解析、字段转换、去重、推送消息队列。UDP socket是无连接套接字,绑定0.0.0.0+目标端口,循环接收报文,使用struct按照大端格式unpack二进制字段。 调试版本Python解析示例:
import socket
import struct
import time

UDP_LISTEN_PORT = 18600
# 缓存最近5s的(sn,ts)组合,用于报文去重
duplicate_cache = {}
CACHE_EXPIRE = 5

def parse_udp_packet(raw_data: bytes):
    if len(raw_data) != 64:
        return None
    # 帧头校验
    if raw_data[0] != 0xAA or raw_data[1] != 0x55:
        return None
    # 校验CRC
    data_for_crc = raw_data[0:18]
    crc_calc = crc16_modbus(data_for_crc)
    crc_pkt = int.from_bytes(raw_data[18:20], byteorder="big")
    if crc_calc != crc_pkt:
        return None
    # 大端解包
    fmt = ">I h h I H H"
    unpack_data = struct.unpack(fmt, raw_data[2:20])
    sn, temp_raw, hum_raw, ts, status, alarm_flag = unpack_data
    temp = temp_raw / 10.0
    hum = hum_raw / 10.0
    is_retrans = (status >> 3) & 0x01
    sensor_err = (status >> 0) & 0x01
    low_power = (status >> 1) & 0x01
    over_limit = (status >> 2) & 0x01
    res = {
        "sn": sn,
        "temp": temp,
        "hum": hum,
        "ts": ts,
        "is_retrans": is_retrans,
        "sensor_err": sensor_err,
        "low_power": low_power,
        "over_limit": over_limit,
        "alarm_flag": alarm_flag
    }
    return res

if __name__ == "__main__":
    sock = socket.socket(socket.AF_INET, socket.SOCK_DGRAM)
    sock.bind(("0.0.0.0", UDP_LISTEN_PORT))
    while True:
        data, addr = sock.recvfrom(1024)
        pkt = parse_udp_packet(data)
        if pkt is None:
            continue
        key = (pkt["sn"], pkt["ts"])
        now = time.time()
        # 去重逻辑
        if key in duplicate_cache:
            continue
        duplicate_cache[key] = now
        # 清理过期缓存
        del_keys = [k for k,v in duplicate_cache.items() if now - v > CACHE_EXPIRE]
        for k in del_keys:
            del duplicate_cache[k]
        print(pkt)
        # 推送至消息队列、入库、告警判断
代码分层设计:接收层只负责收取UDP报文,解析层独立做校验和字段转换,业务层(入库、告警、转发)和解析逻辑解耦,防止数据库IO阻塞导致UDP接收缓冲区溢出、内核丢包。正式工程中引入redis或者内存队列,接收线程和消费线程分离。
七、补发报文时序处理与异常场景适配
科研实验室记录仪支持断点缓存补发,网络恢复后会短时间批量上报多条历史报文,会带来两个典型问题:历史报文时间戳早于当前时间、大量补发报文瞬间涌入造成解析线程压力陡增。 在解析逻辑中增加两条处理规则:
- 识别补发标记位is_retrans=1,入库时单独标记
retrans: true,实时曲线展示优先绘制实时报文,历史补发报文回填历史时序间隙,报表统计不区分实时/补发,保证连续台账; - 补发报文做流量限流,网关侧对补发报文进行平滑分发,避免瞬时大量报文冲击数据库,防止数据库写入超时;
- 时间戳合法性校验,过滤时间戳明显超出合理范围(比如过去5年、未来时间)的异常报文,这类报文一般是固件异常、内存溢出导致的脏数据。
同时,解析逻辑严格以设备SN+采集时间戳作为唯一主键,网关接收报文的时间只作为日志接收时间,不替代设备采集时间戳,满足CNAS溯源要求,原始采集时间由终端传感器侧记录,不受网络传输延迟影响。
八、现场调试常见报文解析故障与定位方法
8.1 故障现象:抓包可以收到UDP报文,解析全部失败
排查方向:优先核对字节序,很多记录仪文档标注和实际固件不一致,存在小端输出;其次核对CRC多项式、初始值,部分厂商CRC采用0x1021;核对报文长度,确认是否包含额外的包头、尾包。 定位手段:Wireshark手动提取一段已知温湿度的报文,代入代码单步调试,比对计算CRC和报文内CRC字段。
8.2 故障现象:温度数值异常,出现超大负数或者极大正数
根因:int16和uint16混淆,温度是有符号数,unpack时使用H(无符号)而不是h(有符号),低温场景下数值错乱。
8.3 故障现象:间歇性出现重复告警,曲线出现重复点
根因:开启重传之后没有去重逻辑,同一条报文多次解析入库,重复触发告警。解决方案:SN+时间戳缓存去重,缓存窗口略大于重传间隔(本项目设置5s)。
8.4 故障现象:补发报文入库之后时序错乱、历史曲线颠倒
根因:补发报文到达顺序无序,网关收到之后直接入库,没有按时间戳排序。解决方案:网关侧收到补发报文放入时序缓冲区,按时间戳排序之后再写入时序数据库。
8.5 故障现象:部分点位偶发CRC校验失败
根因:实验室大功率设备启停带来电磁干扰,网线屏蔽不良,传输过程比特翻转。优化方案:更换屏蔽网线,单端接地,同时增加告警统计,平台统计CRC失败率,失败率持续走高时推送链路故障预警。
九、解析程序的性能优化与工程落地要点
在多点位科研实验室场景,单网关接入80~120台记录仪,采集周期1s,报文并发压力较高,Python版本适合调试,正式部署建议C语言开发,同时配套以下优化:
- 增大Linux内核UDP接收缓冲区,修改
net.core.rmem_max、net.core.rmem_default,防止报文短时间突增时内核缓冲区溢出丢包; - 报文解析逻辑无阻塞,不包含任何数据库同步写入操作,解析完成后丢入消息队列,异步消费;
- 日志分级输出,调试阶段打印完整报文十六进制,正式运行只输出CRC错误、传感器故障、离线告警等关键日志,避免日志文件快速膨胀;
- 报文解析逻辑单独封装为动态库,和平台解耦,后期更换其他厂商UDP记录仪时,只替换解析模块,上层业务、入库、告警逻辑不用改动;
- 所有原始UDP报文可以选择开启本地pcap滚动存储,当出现数据争议、评审溯源时,复现原始报文,验证解析逻辑正确性。
十、方案总结
UDP报文解析不是简单的二进制字段提取,而是一套包含帧同步、长度校验、CRC校验、字节序转换、去重、时序排序、补发识别的完整链路。在科研实验室以太网温湿度记录仪项目中,UDP主动上报模式具备优秀的并发能力,但是报文私有协议带来的适配成本、调试难度高于标准Modbus TCP、SNMP协议。 本实践流程从抓包分析、协议逆向核对、校验算法实现、代码开发、异常过滤、补发时序处理、现场排错全链路落地,解决了实验室场景下重复报文、传输干扰、断点补发带来的解析异常问题,解析后的数据可直接用于时序数据库存储、CNAS台账报表、分级告警以及对接智慧校园实验室安全平台。该解析框架具备良好的可移植性,仅需要修改报文结构体定义、CRC参数,即可适配其他厂商自定义UDP温湿度记录仪。
关键词:UDP报文解析、以太网温湿度记录仪、科研实验室、二进制协议、CRC16、报文去重、断点补发、边缘网关 标签:物联网、UDP协议、温湿度监测、报文解析、盛世宏博
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号