为什么 MySQL 偏偏选了 B+ 树?
原创
为什么 MySQL 偏偏选了 B+ 树?
原创
leikooo
发布于 2026-11-20 09:21:59
发布于 2026-11-20 09:21:59
大家在业务里应该都碰到过这种事:
- 一张两千多万行的
user表,select * from user where id = 12345眨眼就回来了; - 同一张表,
where nickname = 'leikooo'却慢到能感觉出来,explain一看,type = ALL,全表扫描; - 给
nickname加一个索引,同样的 SQL 立刻变快; - 面试时被问「MySQL 的索引为什么用 B+ 树」,脱口而出「因为快」,再往下问就卡住了。
索引天天用,可真要问起来,大家可能也说不太清:索引到底是什么(what)?InnoDB 里的 B+ 树怎么一步步找到那一行(how)?它为什么偏偏是 B+ 树,而不是 hash、红黑树或者 B 树(why)?这篇文章就顺着这三个问题,把 B+ 树索引从头讲一遍。
索引是什么
先说是什么。一句话:索引是一份「按 key 排好序、能快速跳到目标位置」的目录。
大家去图书馆找一本书,不会从第一排书架挨本翻,而是先查索书号,比如 TP311.13,T 区、P 架、311 那一层,三步就站到了书跟前。字典的部首目录、书最前面的目录页,都是同一个思路:多花一点空间存一份目录,换来查找时不用从头翻。
数据库也一样。没有索引的时候,where nickname = 'leikooo' 只能把两千多万行全读一遍,一行一行比;有了索引,就能像查索书号一样,几步跳到目标。
InnoDB 里的索引分两种,后面会反复用到:
- 聚簇索引(主键索引):按主键排序,叶子里存的就是整行数据。也就是说,InnoDB 的表本身就是一棵按主键组织的 B+ 树,「数据」和「索引」是同一个东西。
- 二级索引:比如给
nickname建的索引,按nickname排序,叶子里存的不是整行,而是这一行的主键值。查到主键后,还得回聚簇索引里再找一次整行,这一步叫回表。
目录有了,接下来的问题是:这份目录在磁盘上长什么样?
B+ 树长什么样,一次查找怎么走
InnoDB 读写磁盘的最小单位是页(page),默认 16KB。B+ 树的每个节点就是一页。整棵树分两类页:
- 非叶子页:只存 key 和「指向下一层哪一页」的指针,像书的目录,不存任何行数据;
- 叶子页:按 key 排好序,存真正的数据(聚簇索引存整行,二级索引存主键);而且相邻的叶子页之间用双向链表串起来。
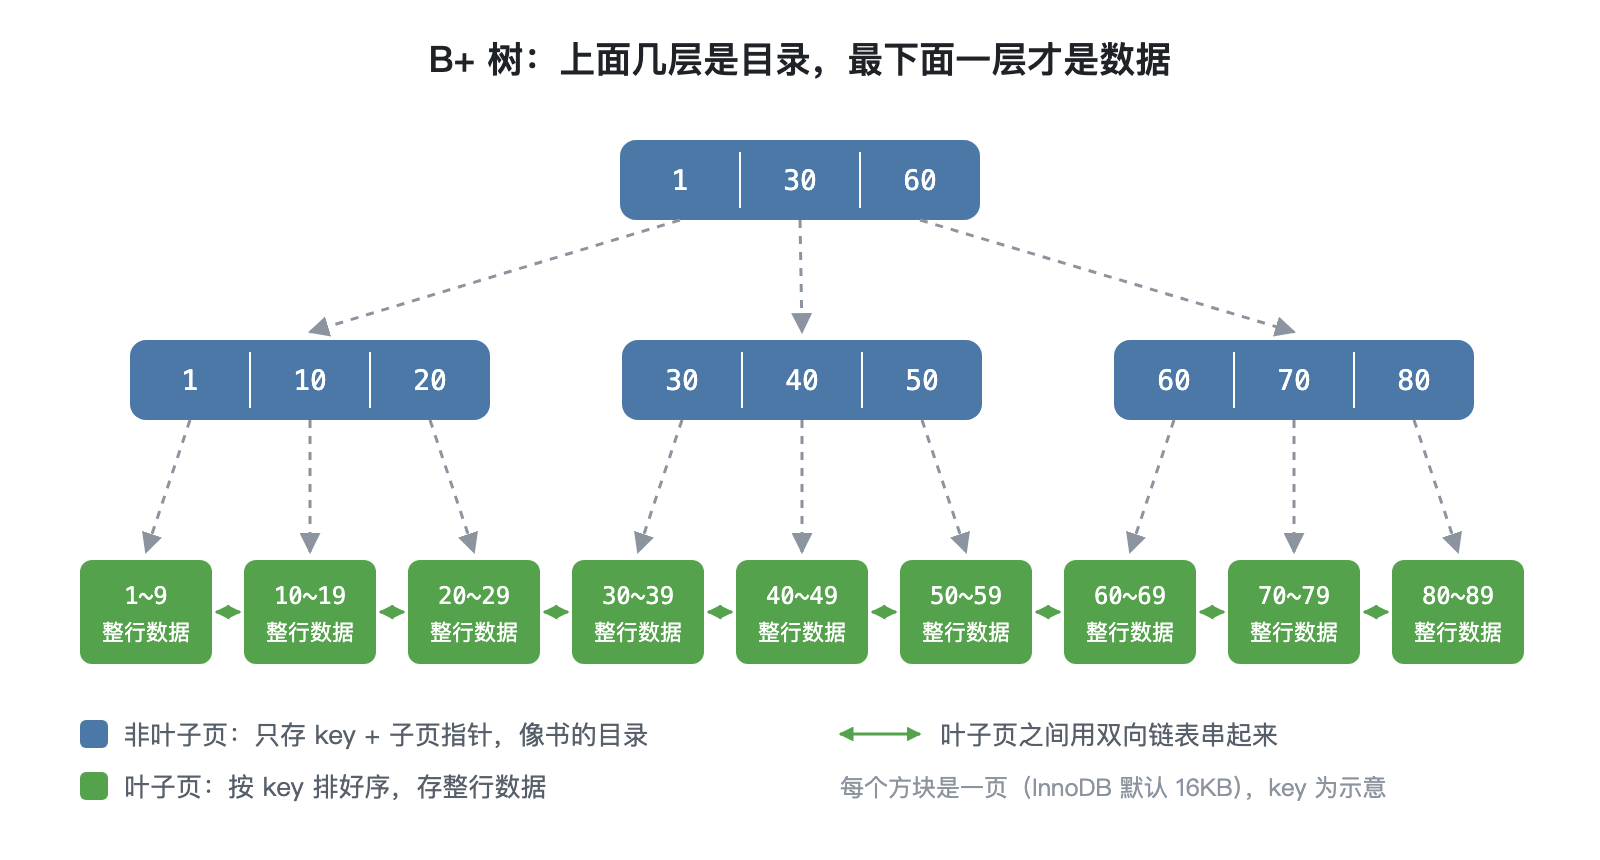
B+ 树:上面几层是目录,最下面一层才是数据
一次查找具体怎么走? 以 where id = 37 为例(图里的 key 是示意):
- 读根页:根页里有
1 | 30 | 60三格,30 ≤ 37 < 60,所以顺着 30 这一格的指针往下走; - 读非叶子页:这一页是
30 | 40 | 50,30 ≤ 37 < 40,继续顺着 30 往下走; - 读叶子页:到了「30~39」这一页,页内的记录是有序的,二分一下就找到了
id = 37这一行。
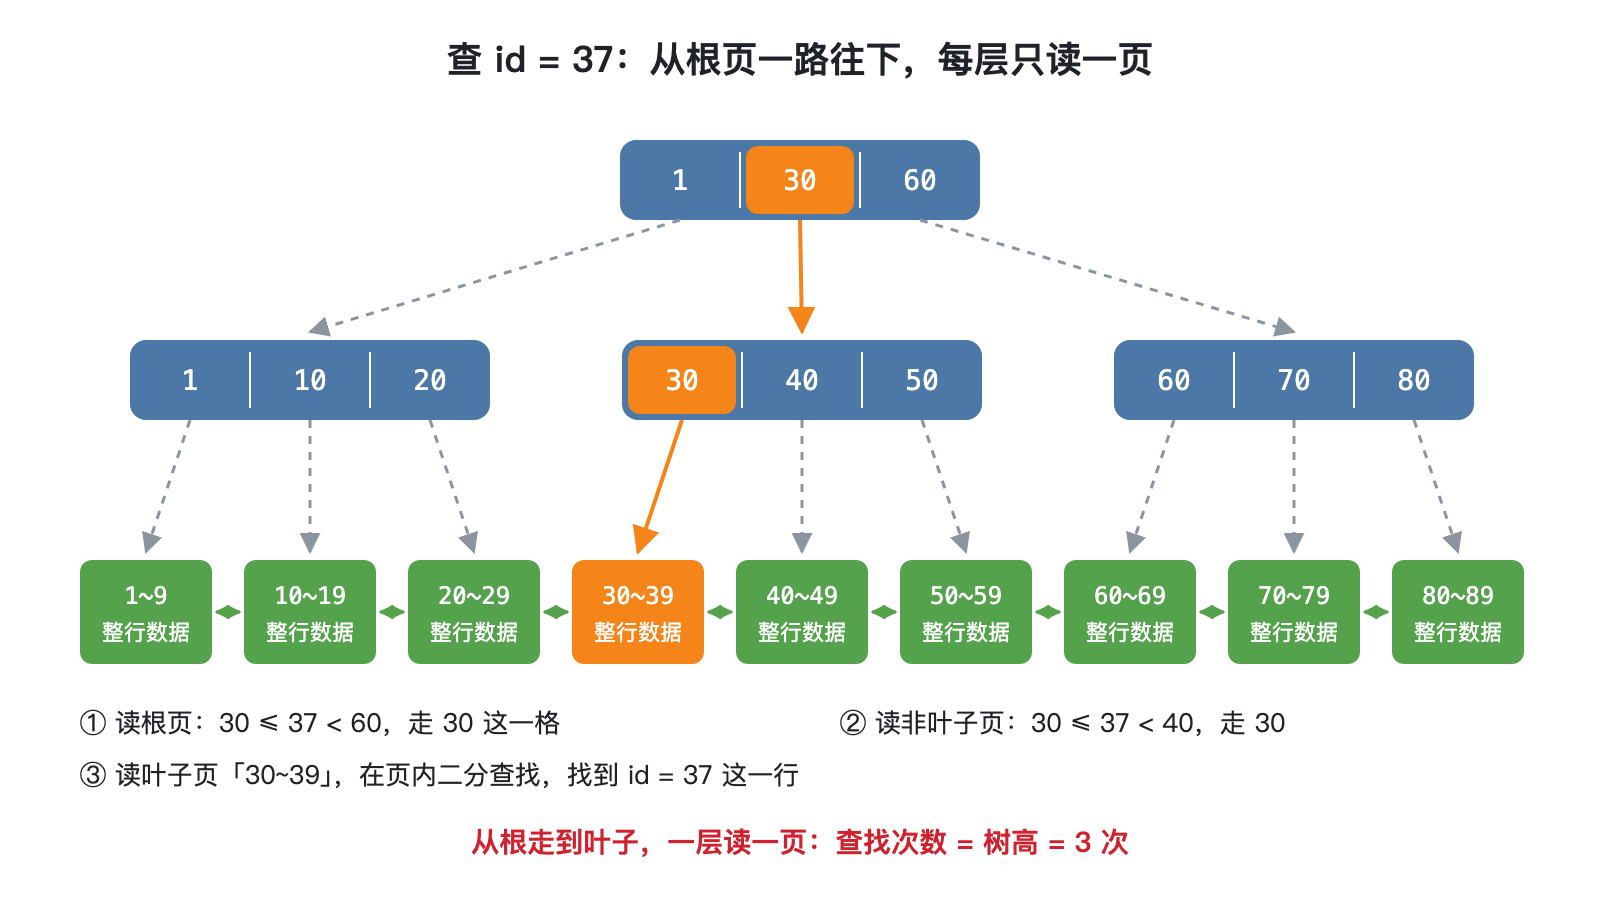
查 id = 37:从根页一路往下,每层只读一页
整个过程每层只读一页,树有几层就读几页。页内那点二分查找是在内存里做的,和从磁盘读一页比起来几乎可以忽略。所以衡量一棵索引树快不快,看的就是一个数:树高。
为什么叶子之间还要串一条链表? 因为业务里大量的查询不是「找一行」,而是「找一段」:where id between 30 and 50、order by create_time limit 20、where age > 18。有了链表,定位到第一条之后,顺着链表往后读就行,不用每找一条都从根重新走一遍。这一点到「为什么」那一节会变成决定性的理由。
三层能装多少行
树高决定了查找次数,那三层的 B+ 树到底能装多少数据?大家可以自己算一遍,用的都是很朴素的数:
- 一页:16KB,也就是 16,384 字节;
- 非叶子页里的一项:一个
bigint主键 8 字节,加一个页指针(按常见估算口径记 6 字节),一共 14 字节,所以一页能放16384 ÷ 14 ≈ 1170项; - 叶子页:假设一行数据 1KB,一页能放
16384 ÷ 1024 = 16行。
一层一层乘下去:
- 第 1 层:1 个根页,指向 1,170 个子页;
- 第 2 层:1,170 个非叶子页,一共指向
1,170 × 1170 = 1,368,900个叶子页; - 第 3 层:1,368,900 个叶子页,每页 16 行,一共
1,368,900 × 16 = 21,902,400行。
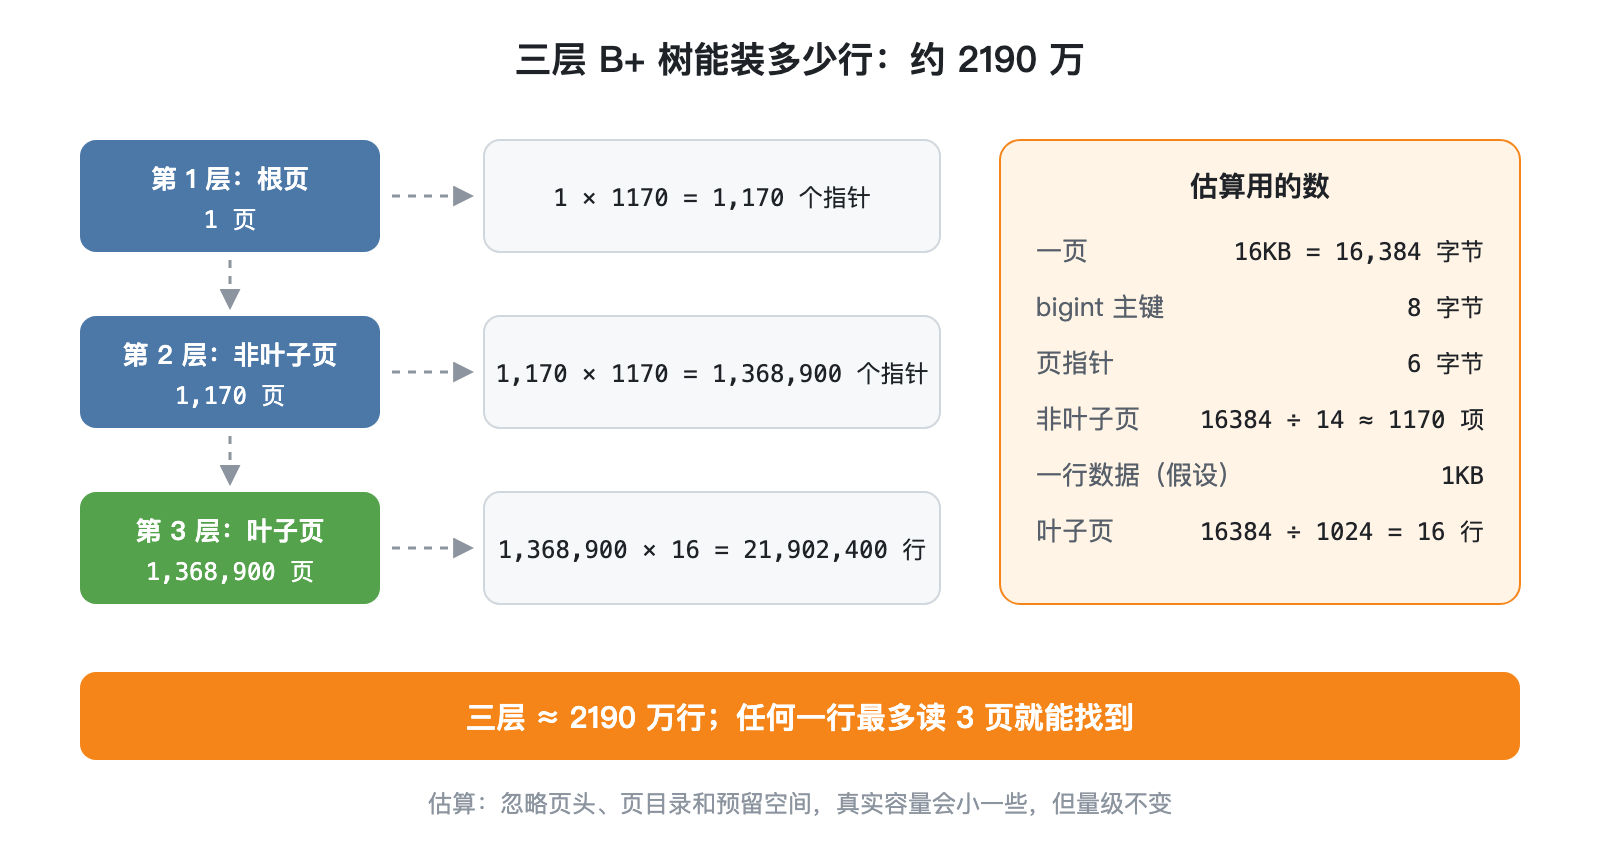
三层 B+ 树能装多少行:约 2190 万
三层,约 2190 万行。只有两层的话是 1170 × 16 = 18,720 行;四层就到了 1170³ × 16 ≈ 256 亿 行。也就是说,绝大多数业务表,从几万行到几千万行,B+ 树都只有 2~4 层。这也是开头那张两千多万行的表查主键依然很快的原因:最多读 3 页。而且根页和上面几层的页访问极其频繁,通常一直待在 InnoDB 的 buffer pool 里,真正要去磁盘读的往往只有最底下的 1~2 页。
当然,这是估算:页头、页目录、每条记录的头信息、为后续插入预留的空间都被忽略了,真实容量会小一些,但量级不会变。
为什么说主键越短越好? 因为非叶子页能放多少项,直接取决于 key 有多长。同样用上面的口径(指针 6 字节、一行 1KB),换几种常见的主键类型算一下:
| 主键类型 | key 长度 | 非叶子页能放 | 三层能存 |
| ------------------------- | -------- | ------------ | ------------- |
| int | 4 字节 | 1,638 项 | 42,928,704 行 |
| bigint | 8 字节 | 1,170 项 | 21,902,400 行 |
| binary(16) 存 UUID | 16 字节 | 744 项 | 8,856,576 行 |
| char(36) 存 UUID 字符串 | 36 字节 | 390 项 | 2,433,600 行 |
同样三层,char(36) 的 UUID 只能装 243 万行,不到 bigint 的九分之一。表一旦超过这个数,就要长到第四层,每次查找多读一页。
为什么偏偏是 B+ 树
先别急着背「B+ 树的优点」,换个角度想:我们真正想要的是什么?
数据放在磁盘上,磁盘有个特点:按页读,一次随机读很贵。机械盘一次随机 IO 大约 10ms,SSD 快得多,但和内存比起来仍然差着几个数量级。所以我们想要的索引要同时做到两件事:
- 点查时读的页尽量少,也就是树要尽量矮;
- 范围查询、排序也要快,因为业务里「找一段」和「找一个」一样常见。
把能想到的数据结构都过一遍,看看每个卡在哪:
- 办法一:hash 索引。 点查确实是一步到位,算一下 hash 就知道在哪个桶。但 hash 的本事恰恰是把相邻的 key 打散(讲 hash 的那篇文章里说过,它是「确定性的随机」)。
where id between 30 and 50这 21 个 id,用crc32(id) % 8算一下,会散满全部 8 个桶,hash 索引根本不知道「30 后面是 31」,只能把所有桶扫一遍;order by、>、like 'abc%'同理全都用不上。MySQL 的 Memory 引擎支持 hash 索引,InnoDB 也有一个自适应 hash 索引,但都只是给热点等值查询加速的配角。 - 办法二:平衡二叉树 / 红黑树。 有序,范围查询也能做。问题出在太高:每个节点只放 1 个 key,存 21,902,400 行,平衡二叉树最矮也要
⌈log₂(21,902,401)⌉ = 25层。一层一次随机 IO,按机械盘算就是 250ms,一次点查都受不了。Java 的TreeMap用红黑树没问题,是因为它在内存里,读一个节点只要几纳秒。 - 办法三:B 树。 B 树也是多路的,一个节点放很多 key,已经矮了很多。但 B 树的非叶子节点也存整行数据,一行 1KB 的话,一页只能放 15 行,扇出只有 16。同样存 2190 万行,B 树要 7 层。而且数据分散在每一层,范围查询要在树里上上下下地中序遍历,没法顺着一条链表一路读下去。
- 办法四:跳表。 Redis 的 ZSet 就用跳表,有序、实现简单。但跳表的层高是随机的,节点之间靠指针随意跳,没法把「一个节点 = 一页」对齐到磁盘页上,每跳一次都可能是一次随机 IO。它适合内存,不适合磁盘。
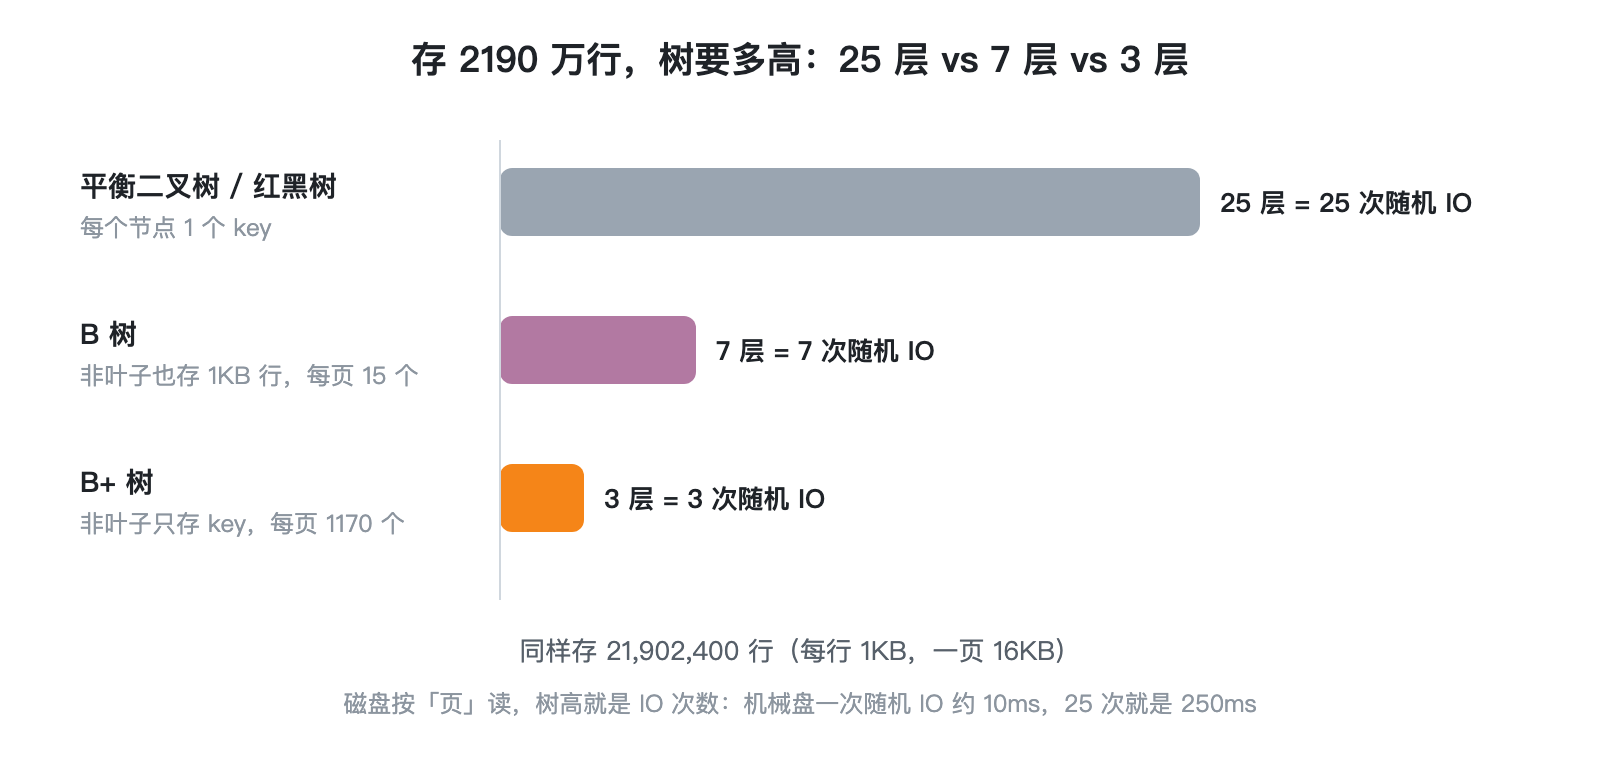
存 2190 万行,树要多高:25 层 vs 7 层 vs 3 层
四个办法摆在一起,B+ 树做对的事情就清楚了:
- 非叶子页只存 key,一页塞下 1170 个分叉,树就变得极矮:2190 万行,3 层;
- 数据全部在叶子,叶子有序且串成链表,范围查询定位到起点后顺着链表往后读,
between 30 and 50只读 3 个叶子页,读出来天然就是有序的。
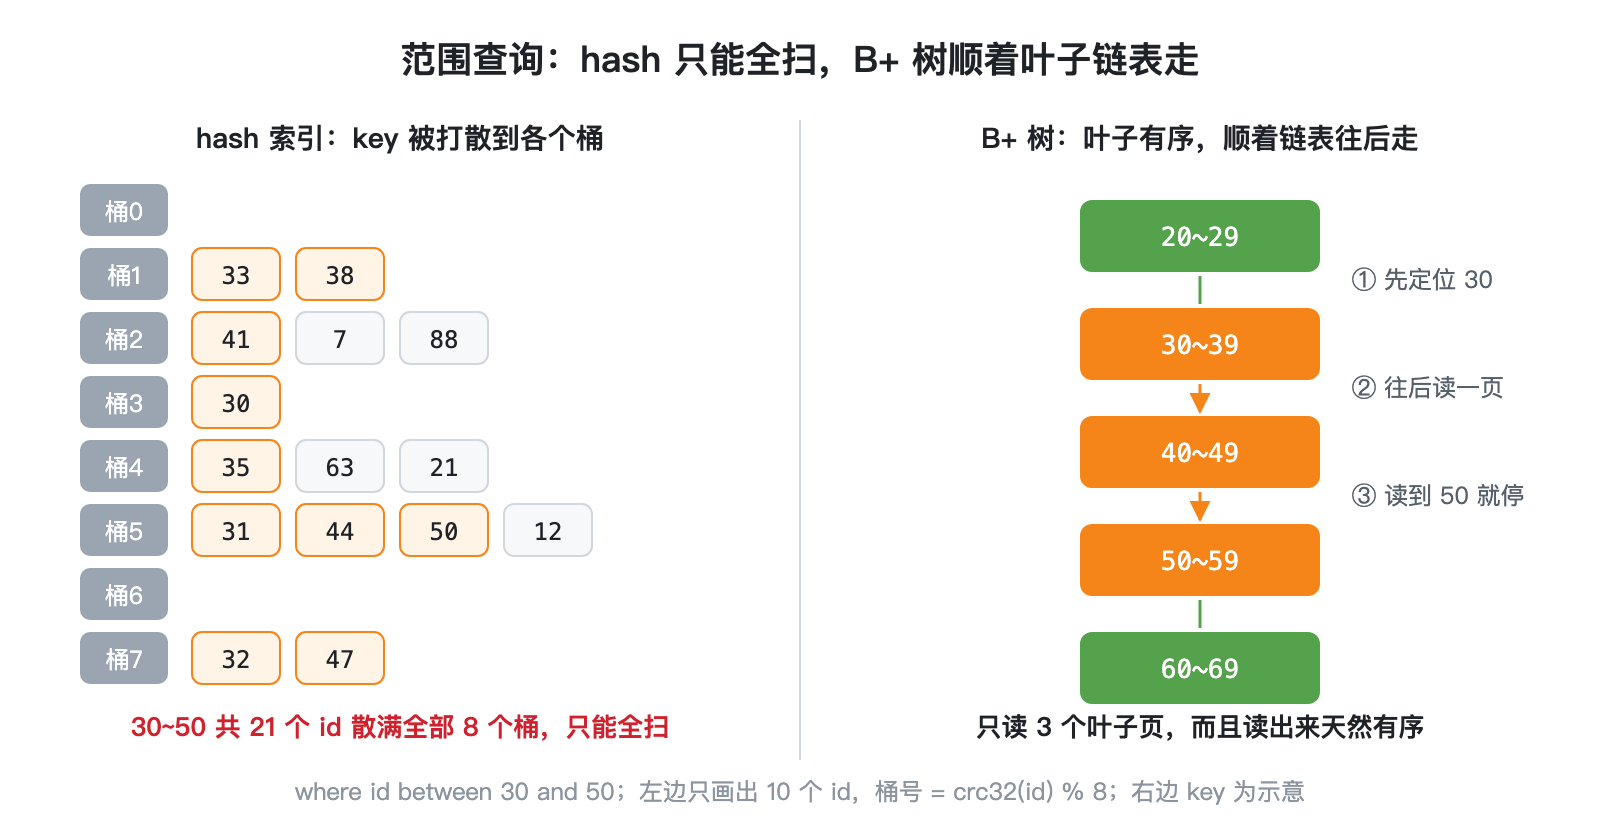
范围查询:hash 只能全扫,B+ 树顺着叶子链表走
B+ 树的精髓可以压成一句话:矮胖的目录 + 有序成链的叶子。「矮胖」让点查只需要 3 次左右的磁盘 IO,「有序成链」让范围查询变成顺序读。hash 有前者没有后者,红黑树和跳表有后者没有前者,B 树两样都只做到一半。
想通这一点,B+ 树的其它优点就都是推论了:查询性能稳定(任何一行都在叶子,路径长度一样)、全表扫描只要顺着叶子链表扫一遍、非叶子页小而热,很容易整个缓存在内存里。
落到业务里:主键、回表和最左前缀
理解了「矮胖 + 有序」,很多大家耳熟能详的 MySQL 规范,就都能自己推出来了。
为什么推荐自增主键,不推荐 UUID? 除了上一节说的「UUID 太长、扇出小」,还有一个更要命的问题:插入位置。自增 id 一个比一个大,新行永远追加在最右边那个叶子页的末尾,前面写满的页再也不会被动。UUID 是随机的,新行可能要插进任何一个已经满了的页中间,InnoDB 只好把这一页分裂成两页,各留一半空间,还要去上一层改指针。
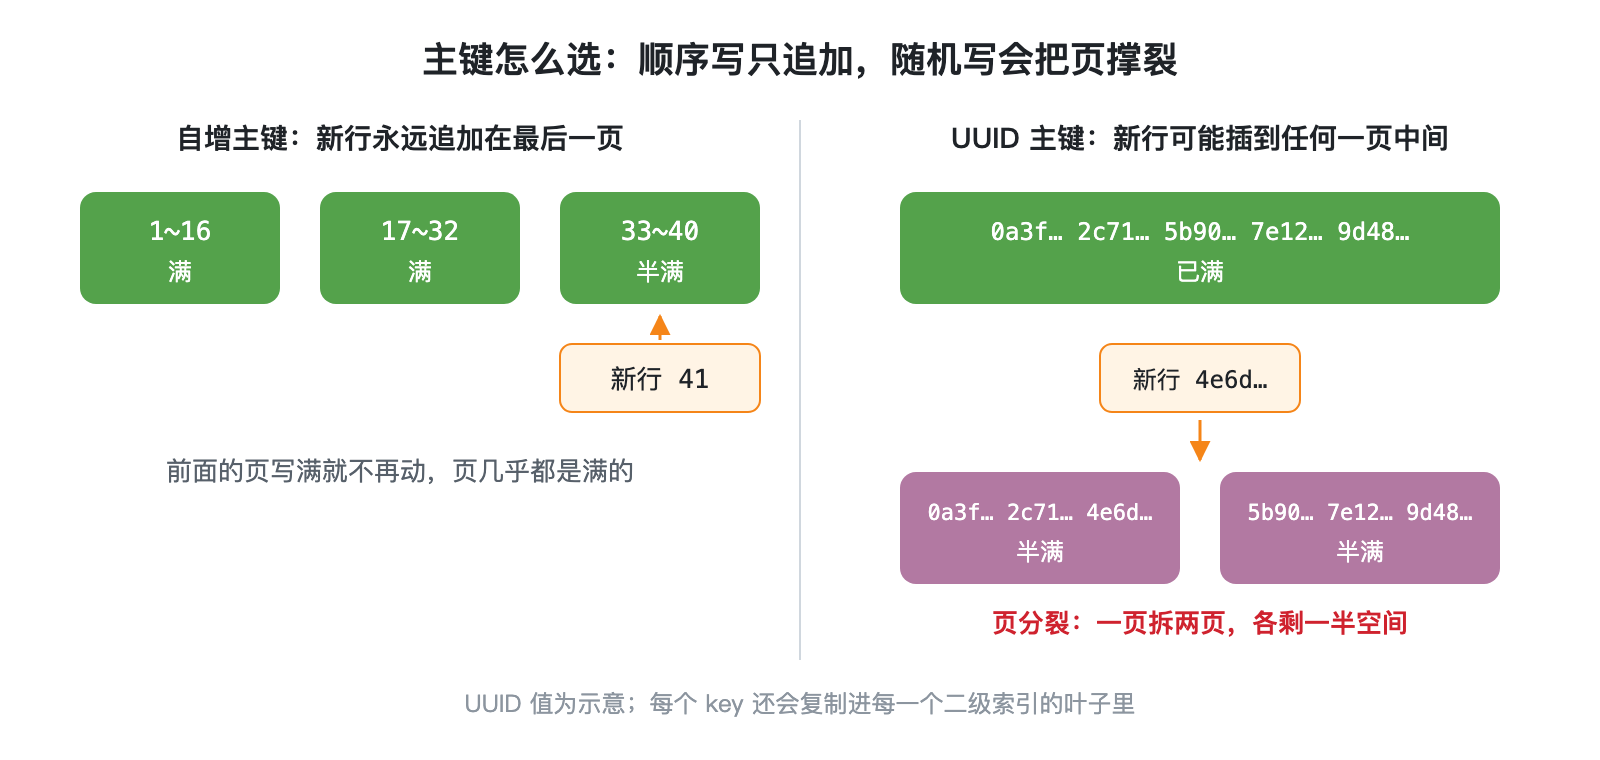
主键怎么选:顺序写只追加,随机写会把页撑裂
后果是写入时频繁分裂、随机 IO 变多,页里留下大量空洞,同样的数据要占更多页。更隐蔽的是,每一个二级索引的叶子里都存着主键,主键从 8 字节的 bigint 变成 36 字节的字符串,一张表有 5 个二级索引,就有 5 份这样的膨胀。业务确实需要全局唯一 id 时,大家常用的是雪花算法这类「整体递增」的 bigint,就是同时照顾了唯一性和顺序写。
为什么 select \* 有时比 select id, nickname 慢一大截? 假设在 nickname 上建了索引:
-- 二级索引的叶子里有 nickname 和主键 id,直接返回,不用回表(覆盖索引)
select id, nickname from user where nickname = 'leikooo';

-- 还要其它列:先在二级索引里拿到 id,再回聚簇索引走一遍 B+ 树取整行(回表)
select * from user where nickname = 'leikooo';回表等于再走一次三层的树。查一行无所谓,where nickname like 'lei%' 命中一万行,就是一万次回表,而且这一万个主键往往是乱序的,每次都可能落在不同的页上。如果要的列都在索引里,就叫覆盖索引,explain 的 Extra 里会显示 Using index。
为什么联合索引要讲「最左前缀」? 联合索引 (city, age) 的叶子,是先按 city 排,city 相同再按 age 排,就像电话簿先按姓排、同姓再按名排:
| 查询条件 | 能不能用索引 | 原因 |
| ---------------------------- | ------------ | ------------------------------------------ |
| city = '北京' | 能 | 所有北京的行在叶子里挨在一起 |
| city = '北京' and age > 18 | 能 | 北京这一段里,age 也是有序的 |
| age > 18 | 不能直接定位 | age 只在同一个 city 内部有序,整体看是乱的 |
这和电话簿一样:知道姓张,能一下翻到张姓那几页;只知道名叫「伟」,就只能从头翻到尾。说到底,B+ 树只能利用「有序」,哪一列在全局上有序,就只能从哪一列开始用。
最后回到开头的问题:
- 是什么:索引是一份按 key 排好序的目录,InnoDB 用 B+ 树来存它,表本身就是一棵按主键组织的 B+ 树;
- 怎么做:从根页往下,每层读一页,16KB 的页能放 1170 个分叉,三层就能装下约 2190 万行;
- 为什么:磁盘按页读、随机 IO 贵,B+ 树用「矮胖的目录 + 有序成链的叶子」,同时把点查压到 3 次 IO 左右、把范围查询变成顺序读。
所以开头那张两千多万行的表,where id = 12345 只是在一棵三层的树上往下走了三步;而 where nickname = 'leikooo' 慢,是因为 nickname 没有自己的那份目录,只能一页一页地翻完整本书
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号