AI 原生企业的智能体底座:语义层、驾驭工程与数据飞轮
原创
AI 原生企业的智能体底座:语义层、驾驭工程与数据飞轮
原创
OneCode
发布于 2026-11-20 22:52:17
发布于 2026-11-20 22:52:17
Agentic Enterprise · 底座设计
AI 原生企业的智能体底座:语义层、驾驭工程与数据飞轮
从表单与流程,到业务对象与 Agentic Workflow;让业务部门自己造智能体,让平台守住边界
2026-11-20 | 阅读约 20 分钟 | 语义层 · Agent Harness · 数据飞轮
摘要:2026 年,企业智能体的竞争已经从“接入模型”转向“上下文与治理”。行业讨论的焦点,不再是“Agent 能不能跑”,而是“Agent 能不能 grounded(有依据)、能不能 write-back(写回业务)、能不能被治理”。本文以 formAgent 与 skillCenter 沙箱为样本,把“表单 / 流程 / 知识库”这些上一代概念升级为“业务对象 / Agentic Workflow / Context 层”,并给出 AI 原生企业智能体底座的三个新基建:语义层、驾驭工程、数据飞轮,以及 A/B/C 控制平面如何让高效与安全同源。
本文结构
- 语义层:业务部门直接定义企业本体
- 数据飞轮:专业 Agent 的检索、分析与规则回填
- 控制平面:A/B/C 让高效与安全同源
过去两年,企业级智能体最大的误区,是把“表单”当成业务对象,把“知识库”当成上下文,把“流程”当成 Agent 编排。概念不升级,底座就会停留在上一代:页面画得越来越快,但 Agent 依然不知道“这个字段是什么意思、这条规则为什么这么算、结论该写回哪里”。
2026 年的行业共识已经很清楚:没有语义层,Agent 的准确率会在跨系统数据面前迅速下降;没有 Harness,Agent 的能力无法稳定复现;没有数据飞轮,Agent 永远是一次性工具。本文讨论的,正是这三件事如何落到一个可运行、可治理的企业底座上。
01语义层:业务部门直接定义企业本体
“技术平权”这个词已经不新鲜了。真正的问题是:业务部门到底被赋予了什么权力?如果只是“能拖拽页面”,那不是平权,而是把 UI 编辑器的负担转移给了业务。AI 原生企业要赋予业务部门的,是定义业务对象、企业本体与 Agent 行为边界的权力。
先把概念升级讲清楚。下面五组词,代表了从“上一代信息化”到“AI 原生”的跨越:
旧概念 | 新概念 | 为什么要升级 |
|---|---|---|
表单 | 业务对象 / 语义契约 | 表单只是业务对象在某个节点上的呈现;业务对象才是可复用、可校验、可编排的语义契约。 |
流程 | Agentic Workflow | 流程是给人走的;Agentic Workflow 是人类、Agent、工具共同执行的编排。 |
知识库 | Context 层 | 知识库是文档集合;Context 层是经过治理、可以进入模型上下文的企业语义。 |
字段字典 | 企业本体 | 字典是选项集合;本体是概念、关系、约束、证据与版本。 |
技能沙箱 | Agent Harness | 沙箱只是隔离环境;Harness 是上下文、标准、护栏与运行时的组合。 |
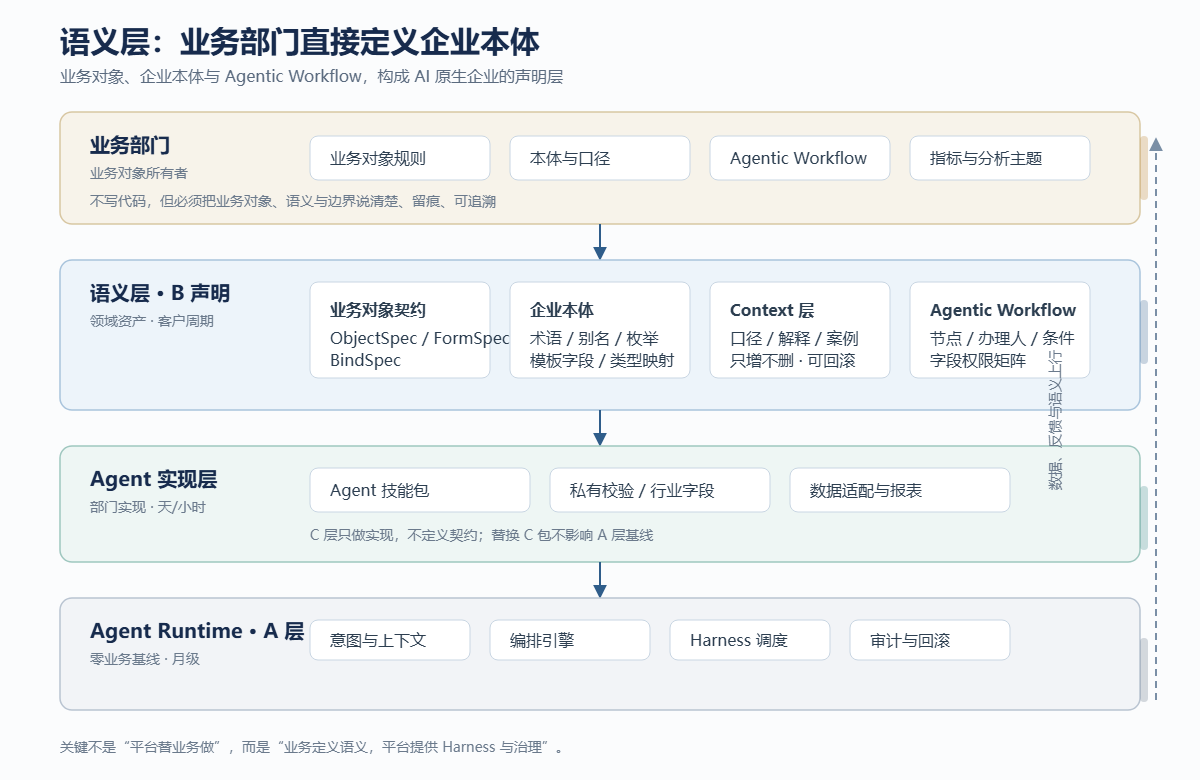
图 1 语义层不是“业务写代码”,而是“业务定义对象与语义,平台提供 Harness 与治理”
1.1 业务对象 + 企业本体:让业务数据闭环到语义层
业务部门提出需求时,通常不会说“我要一个 Entity”,而是说:“报销单要有费用类型、金额、部门、收款账号;费用类型只能从财务的枚举里选;金额要带两位小数;部门要带出负责人。”这些话里,已经包含了业务对象、属性、类型、枚举、外观与引用关系。
formAgent 做的第一件事,是把这些业务语言归一成三类契约:ObjectSpec(业务对象与属性,落地时对应 ModelSpec)、FormSpec(布局、校验、动作)、BindSpec(Workflow 节点与字段权限)。三条建模路线——视图优先、数据库表优先、模型/字典优先——只是契约的不同来源,后续的生成、编译、绑定、发布走同一条流水线。
概念升级的关键:不要再说“做一张表单”。要说“定义一个业务对象,并声明它在申请、审批、查询、报表四个场景下分别如何呈现”。表单是视图,业务对象是资产。
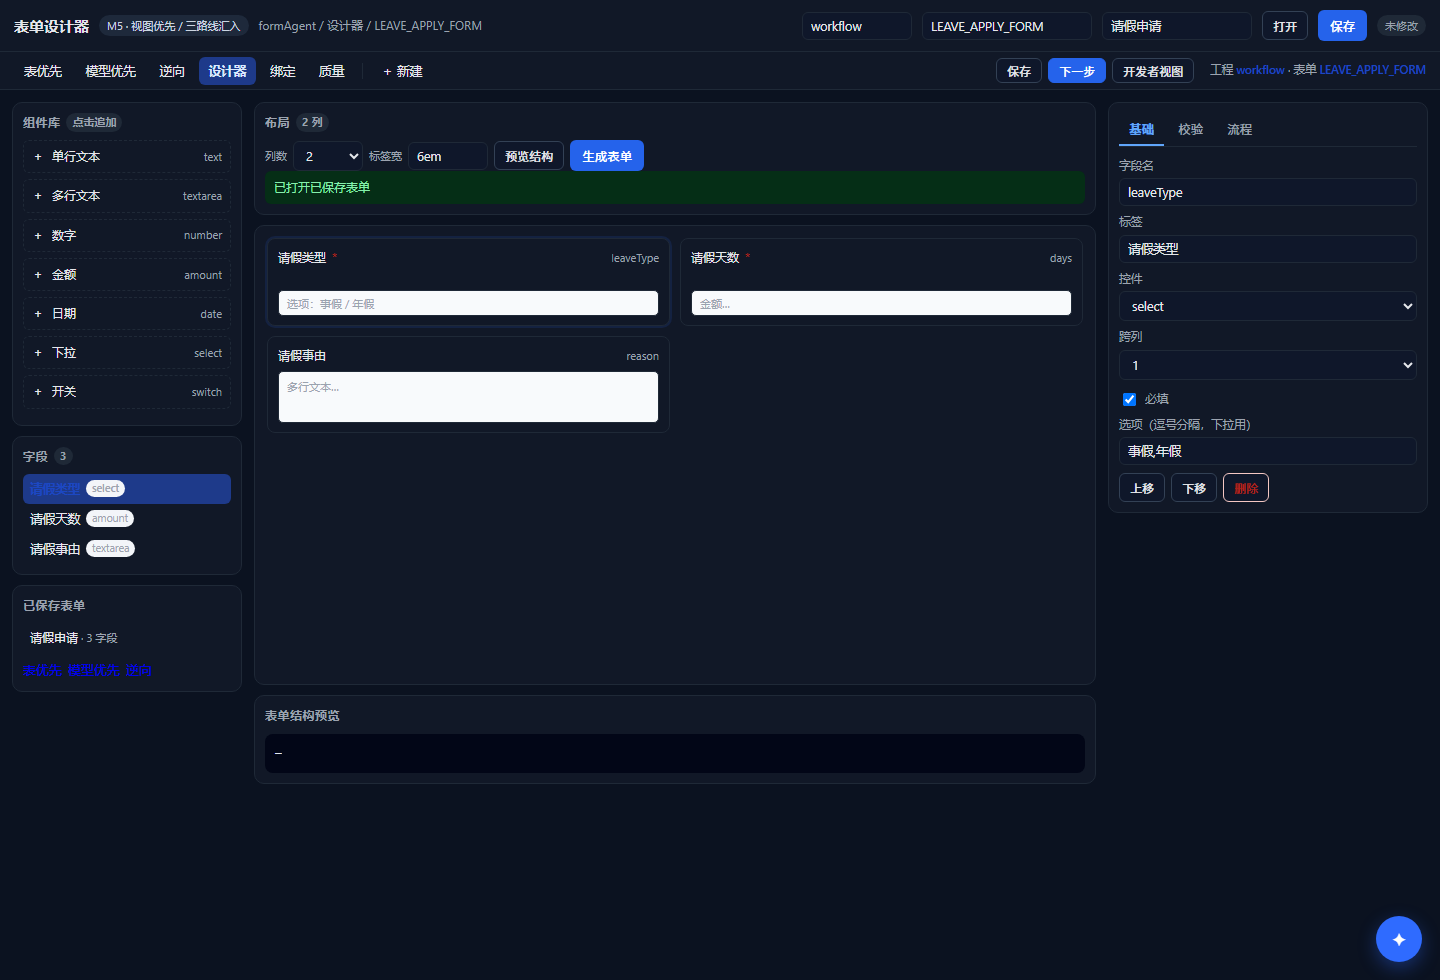
图 2 业务对象工作台(原表单设计器):左侧组件与字段树,中间栅格画布,右侧属性;业务人员直接调整布局、校验、字典与 Workflow 页签。截图来自实际运行界面。
“数据库表优先”是存量企业最需要的入口。很多企业的业务规则并不在文档里,而在十几年前建的那张表里。贴一段 CREATE TABLE,解析字段、类型、注释与主键,一键生成业务对象与实体;对象属性改了,还能反向吐出差分 ALTER语句。存量系统不必重写,先被理解,再被接管。
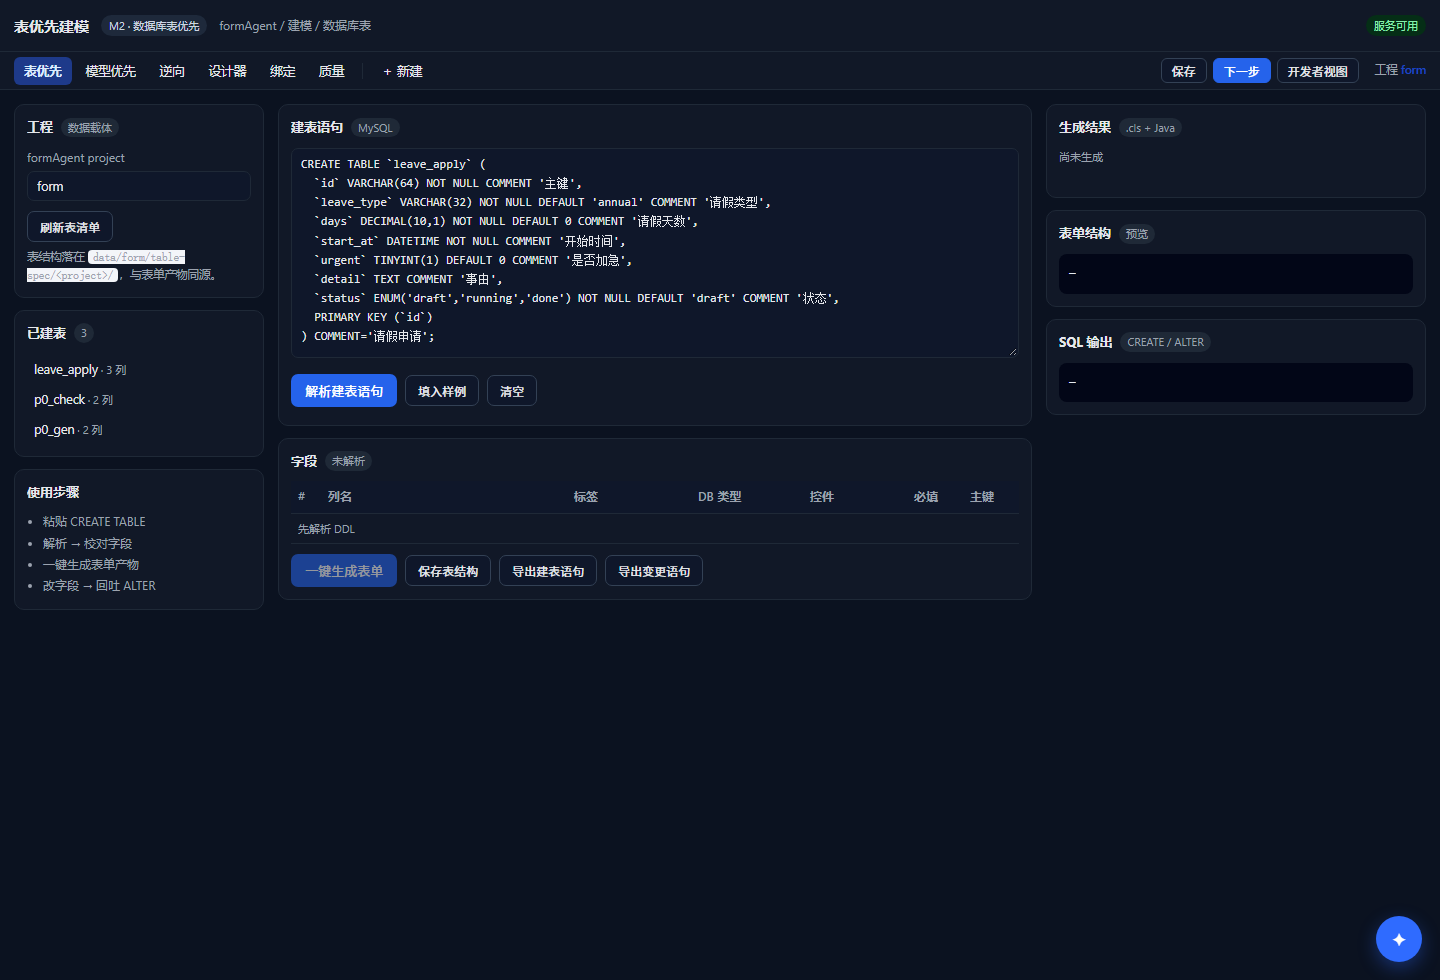
图 3 数据库表优先:贴 DDL → 解析字段 → 一键生成业务对象与实体;同一份表结构还能回吐变更 SQL。截图来自实际运行界面。
“模型/字典优先”则更接近业务部门的日常语言。财务模板、主数据、枚举三本字典已经沉淀为可检索的模型目录:选择公司、选择模板、勾选字段,系统自动带出控件类型、枚举候选、必填与外观。业务部门不需要知道 VARCHAR(32)和 DECIMAL(18,2)的区别,只需要确认“这个属性是不是这个意思”。
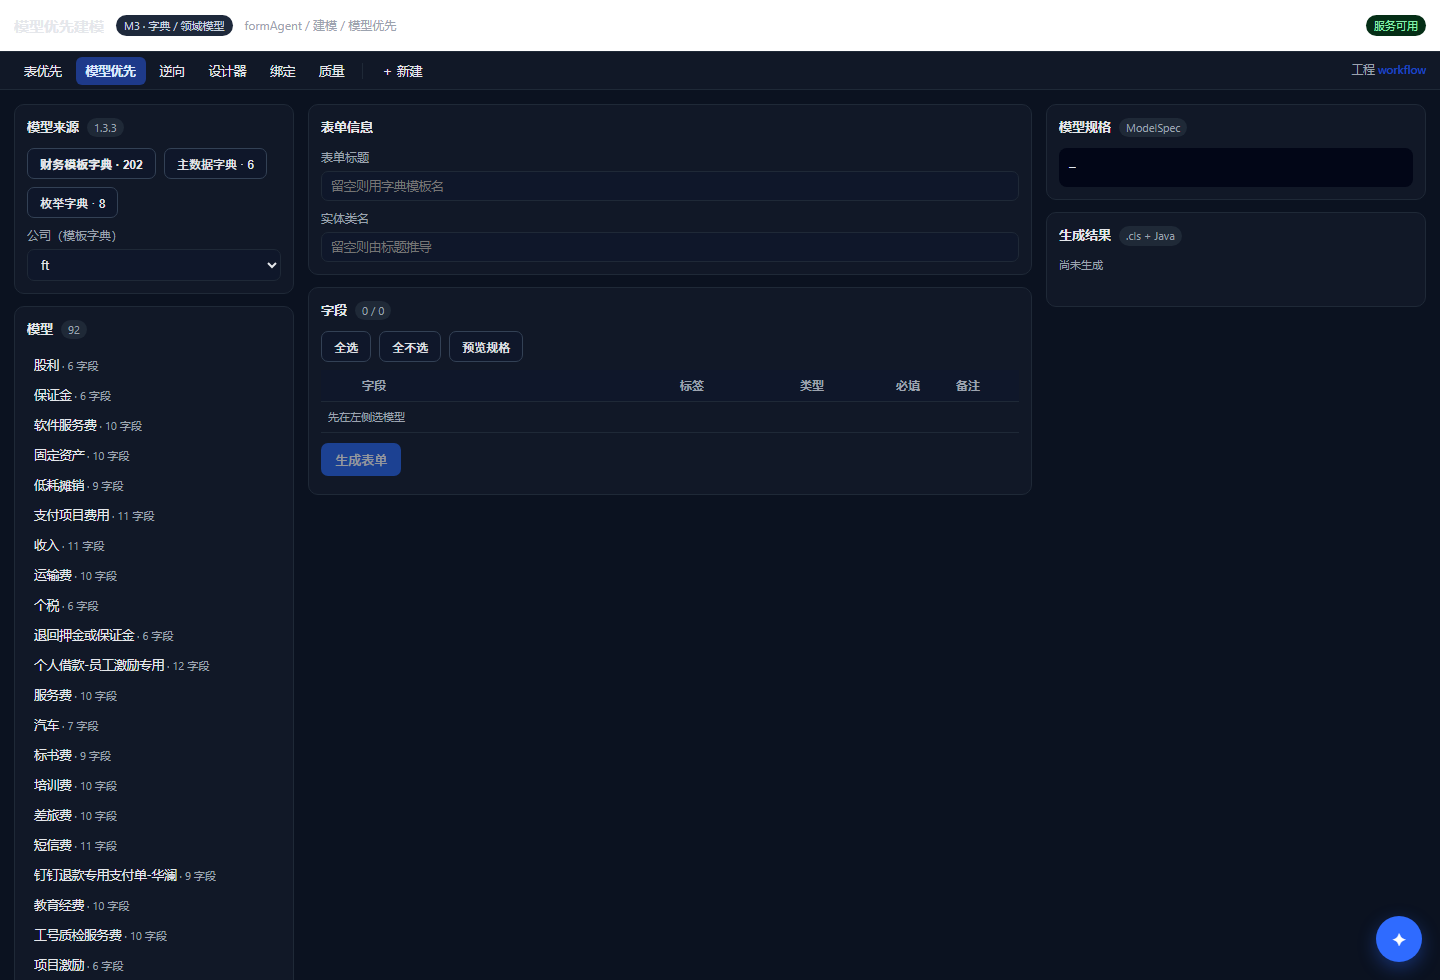
图 4 模型/字典优先:财务模板、主数据、枚举形成模型目录,勾选字段即可生成业务对象。截图来自实际运行界面。
真正让这套能力产生复利的,是企业本体。它不是文档库,而是业务对象的可计算语义:术语与别名、枚举与选项值、模板字段、类型映射、命名归一、外观规则、弹出数据源,以及公司/租户作用域。
当一个属性被提交给本体索引时,系统按“语义精确 → 别名精确 → 包含匹配”的顺序检索,并给出候选的控件类型、枚举、外观与置信度。置信度 ≥ 0.9自动采用;0.6–0.9进入人工确认;< 0.6交给 LLM 兜底或人工对象化。这条分级线,是自动化与可控性之间的工程分界。
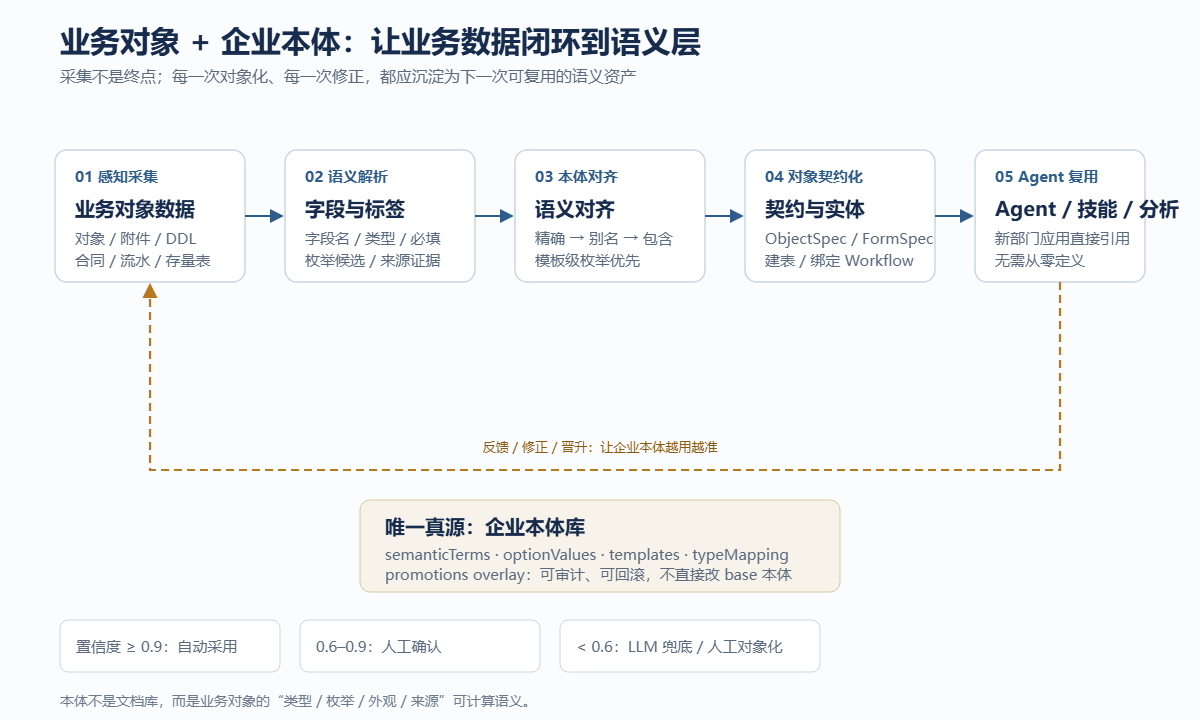
图 5 业务数据闭环到语义层:感知采集 → 语义解析 → 本体对齐 → 对象契约化 → Agent 复用,再由反馈与晋升把经验写回本体
以“报销单”为例。业务人员写下“费用类型”,本体把它解析为枚举属性,并带出财务模板级的选项;写下“税额”,本体带出金额类型、两位小数与单位;写下“部门”,本体带出组织引用与负责人弹出源。第一次是人工确认,第二次是自动带出,第三次就变成了部门默认值。
表单是一次性的,业务对象与企业本体是复利的。业务数据闭环到语义层之后,下一次建模不是从零开始,而是从企业已经确认过的语义开始。
更重要的是,本体的修正不是“直接改大字典”。修正样本先进入反馈队列,经过 accepted / corrected / rejected / pending的裁决,再以 promotion overlay 的方式晋升;晋升结果可审计、可回滚,不直接污染 base 本体。这让业务部门敢于修正,也让平台敢于放开修正。
1.2 Context 层:业务部门独立运营上下文
2026 年最热的技术词之一,是 Context Engineering(上下文工程)。它讲的不是“把文档塞进向量库”,而是决定:什么信息进入上下文、以什么粒度进入、什么时候失效、由谁负责更新。知识库只是 Context 层的一个数据源,远不是全部。
很多企业的知识库失败,不是因为文档太少,而是因为上下文没有流程:谁提出、谁起草、谁评审、谁发布、谁修订、谁负责,全是模糊的。结果是文档越堆越多,口径越查越乱。
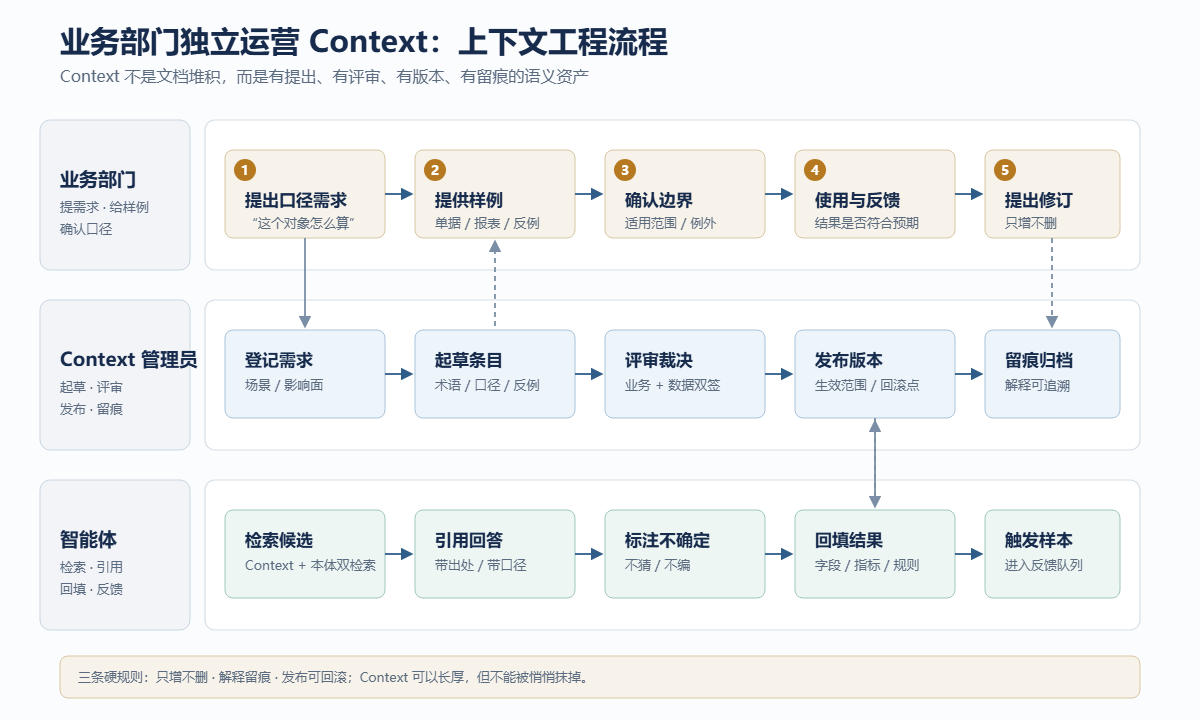
图 6 Context 运营流程:业务部门提出与确认,Context 管理员起草、评审、发布与留痕,Agent 检索、引用并触发反馈样本
在这套流程里,业务部门不是知识库的“读者”,而是 Context 的作者与维护者。他们提出口径需求、提供正例反例、确认适用边界;Context 管理员负责把口径写成可检索的条目、组织评审、发布版本、保留解释链;Agent 负责在使用中引用、标注不确定、把结果与偏差回填到反馈队列。
流程背后有三条硬规则:
RULE 01
只增不删
既有解释不能被悄悄抹掉。新口径可以叠加、可以修订,但历史解释必须保留,保证企业语义的演化史可追溯。
RULE 02
解释留痕
每一条口径都要能回答“谁提出、依据是什么、适用到哪里、什么时候生效”。Context 不是结论,Context 是结论加证据。
RULE 03
发布可回滚
Context 版本与 Workflow、Agent 版本一样,必须可回退。口径变更不是一次性的公告,而是一次受控的发布。
当 Agent 回答业务问题时,它不是在“自由发挥”,而是在检索 Context 层与企业本体之后,带着出处和口径回答。下面这张截图来自财务 Agent 的实际运行:用户询问“产出物位置校验”,Agent 在 Context 层中定位到最相关的流程规则,并给出产物归属、产出声明与校验点。
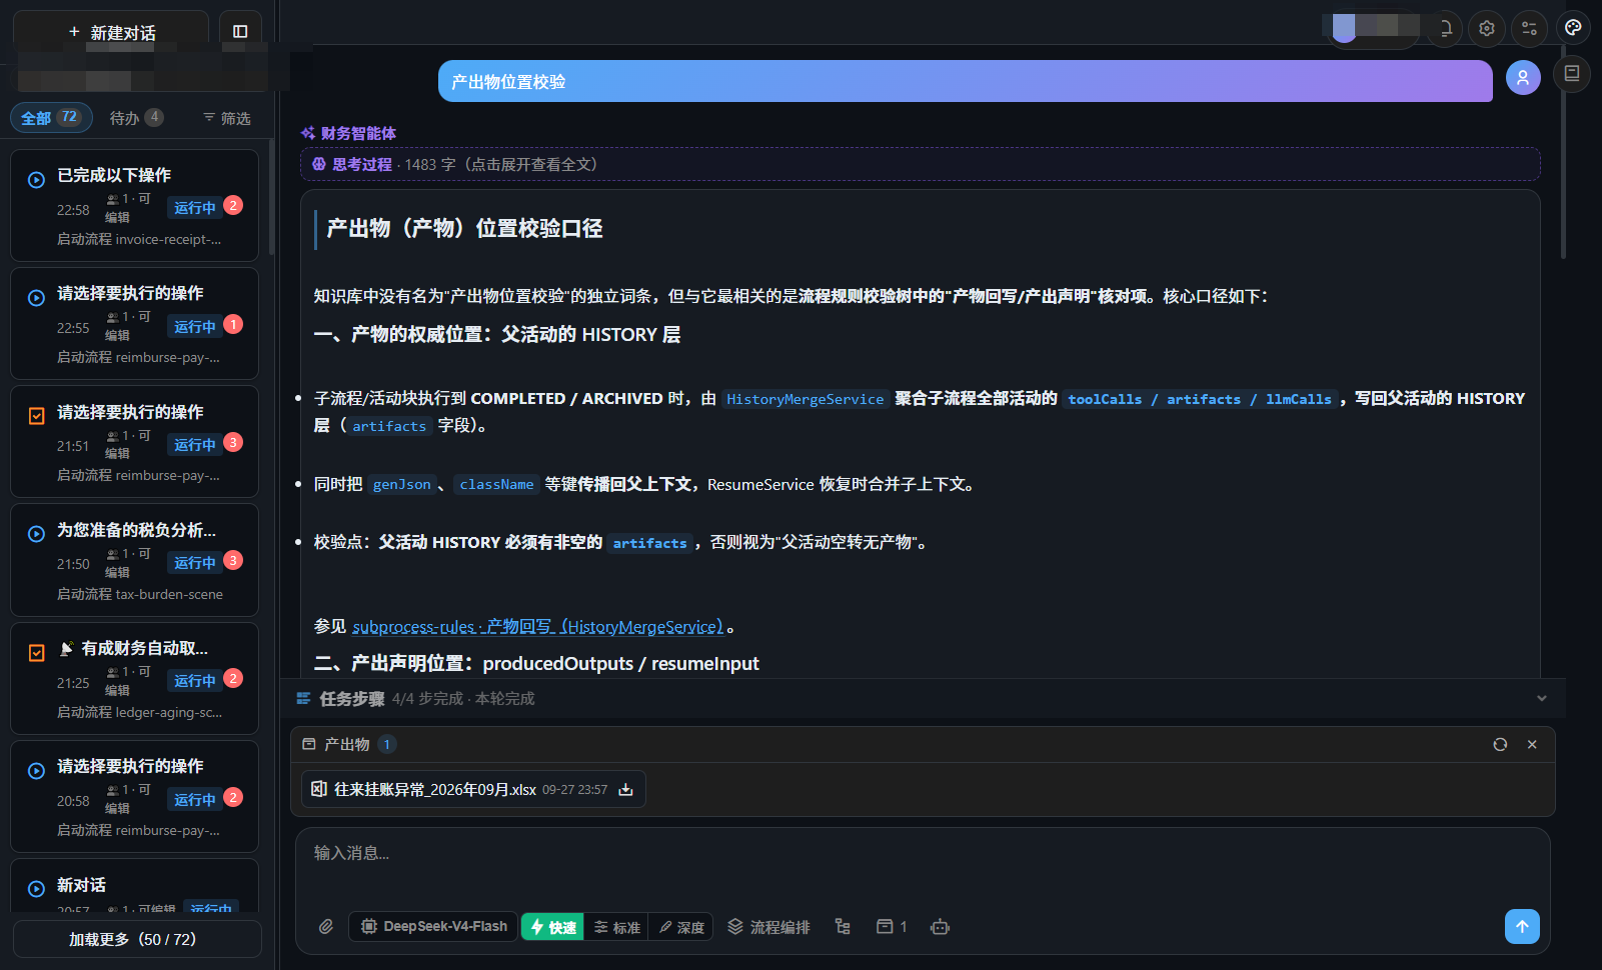
图 7 财务 Agent 检索 Context 层后回答“产出物位置校验”:引用 HISTORY 层、artifacts、producedOutputs 等口径,并保留执行轨迹。截图来自实际运行界面。
这张截图说明了一件事:Context 层的价值不在于“存了多少文档”,而在于“回答时能不能被引用、被追溯、被修正”。当业务部门拥有解释权,平台就不需要替业务解释;当解释留痕,Agent 就不需要靠提示词“猜”。
1.3 Agent Harness:全生命周期驾驭
Gartner 在 2026 年软件工程趋势中,把 Harness Engineering(驾驭工程)定义为:用上下文、标准与护栏配置 AI Agent,使其可靠执行任务;并预测到 2028 年,具备 AI coding harness 基础设施的组织,部署后缺陷会显著减少。这个判断对业务 Agent 同样成立:Agent 的能力上限,不只取决于模型,而取决于它被什么样的上下文与护栏驾驭。
通用底座必须覆盖 Agent 的全生命周期:业务对象需求、语义建模、对象契约、契约门、Agent 技能包、Harness 装载、Workflow 绑定、发布、运行回流。
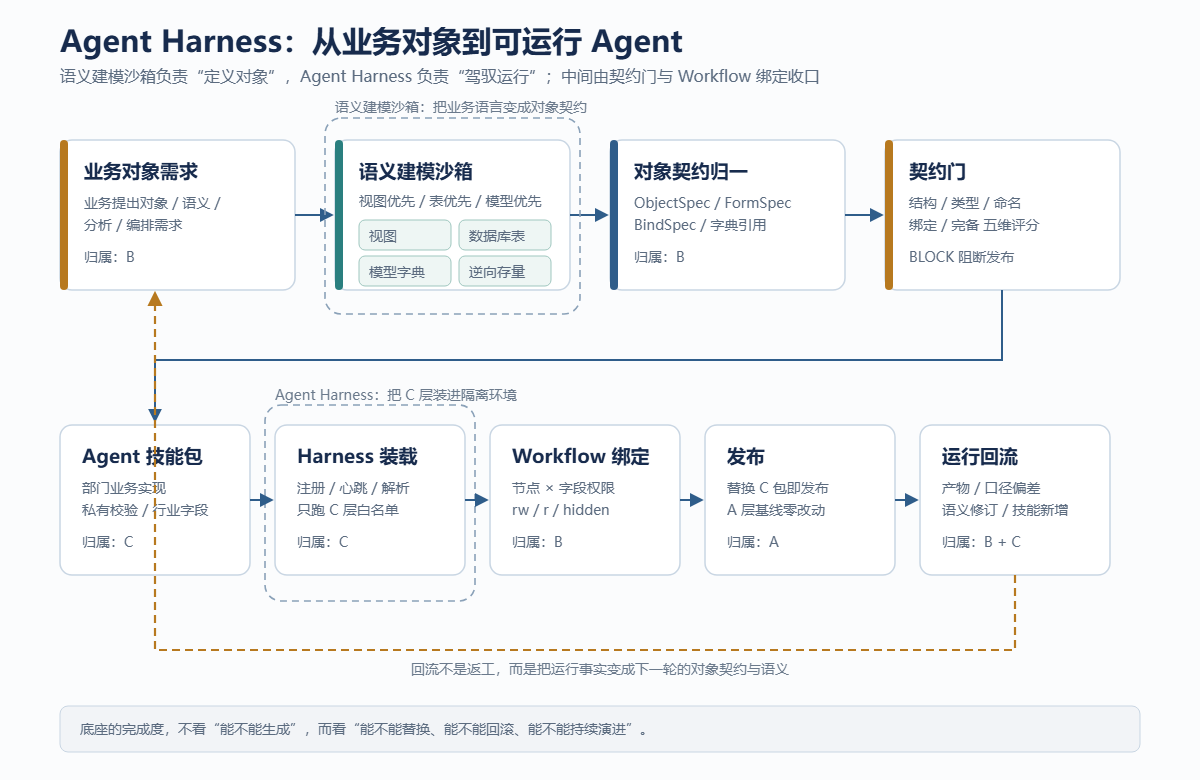
图 8 Agent Harness 全生命周期:语义建模沙箱负责“定义对象”,Harness 负责“驾驭运行”,契约门与 Workflow 绑定把两端收口
这里有两个沙箱,职责不同,但共享同一套租户、令牌、白名单与审计:
沙箱 | 输入 | 产出 | 归属 |
|---|---|---|---|
语义建模沙箱 | 业务语言、DDL、视图、存量代码 | ObjectSpec / FormSpec / BindSpec / 产物 | B + C |
Agent Harness | C 层代码包、能力声明、上下文与护栏 | 可运行的部门 Agent 与技能 | C |
契约门是语义建模沙箱的出口。它从结构完整性、类型与控件、命名规范、Workflow 绑定、对象完备性五个维度评分;BLOCK 级问题阻断发布,WARN 可运行但需修复,INFO 只是优化提示。契约门不是“建议”,而是发布前必须通过的机器闸门。
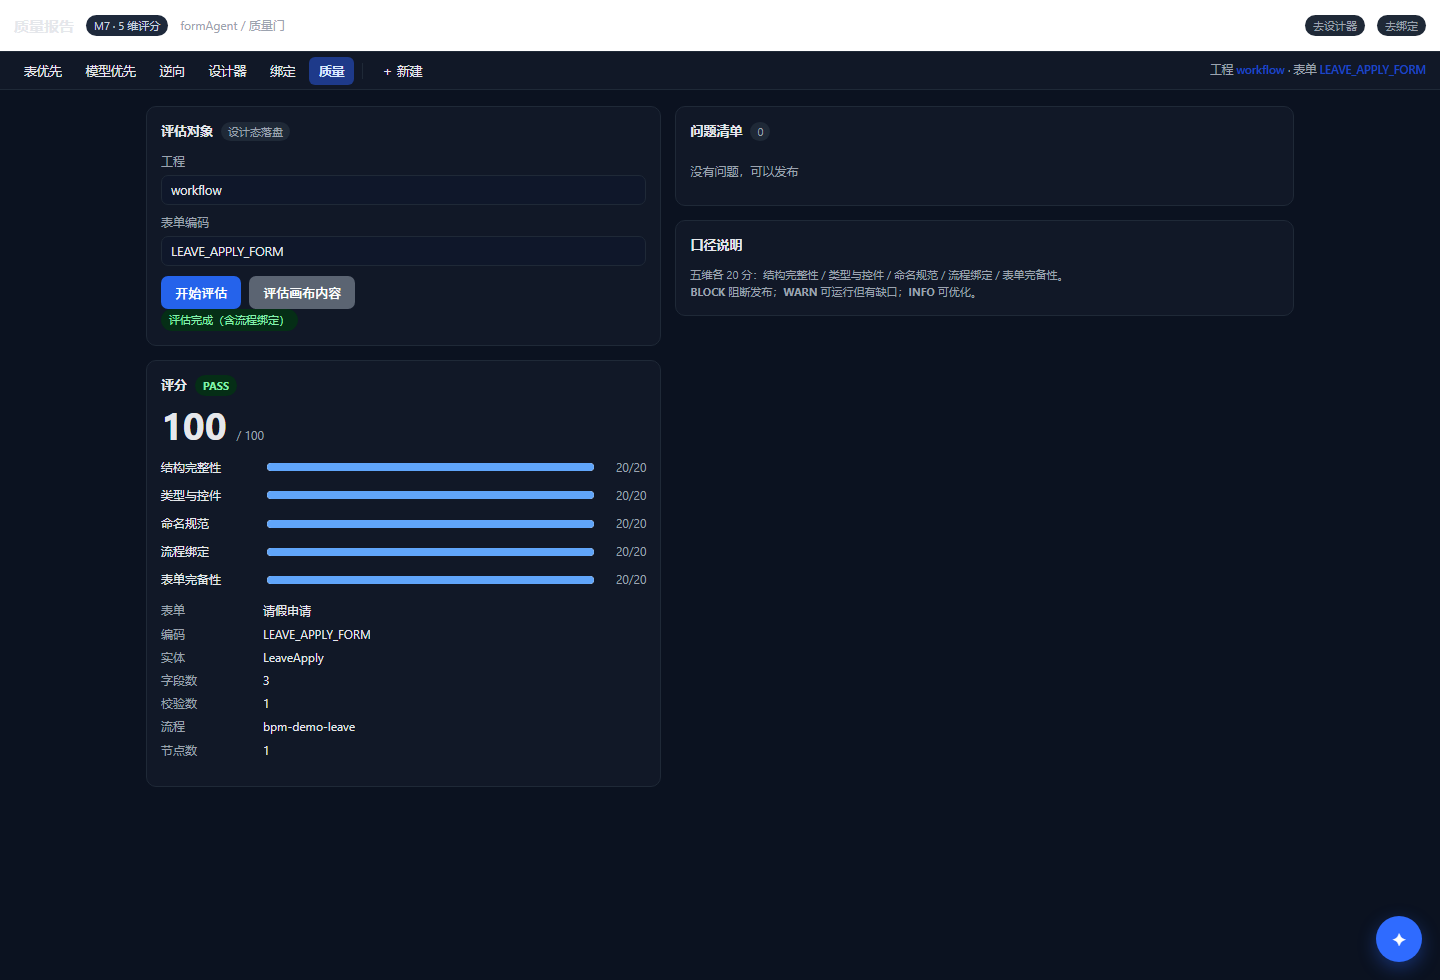
图 9 契约门:五维各 20 分,总分 100;BLOCK 阻断发布,WARN 与 INFO 分级提示。截图来自实际运行界面。
Harness 则由 skillCenter 管理。它的契约非常克制:每租户一个沙箱,不区分工程;只允许 C 层能力(构建、运行、测试、日志);心跳上报的模块必须是 ooder-biz-*、ooder-domain-*或中心已登记的工程;心跳超时即离线,不换绑、不回传密钥;共享令牌未配置时默认拒绝,而不是放行。
下面这张截图来自 codeAgent 工作台:左侧是工程与 VFS 文件,中间是对话与执行,右侧是 Harness 状态——沙箱地址、令牌、工程绑定、编码探测、harness 结论与日志。它把“代码在哪里、跑在哪个沙箱、能不能编译/打包/部署/运行”这些事实,直接摊在了业务与研发面前。
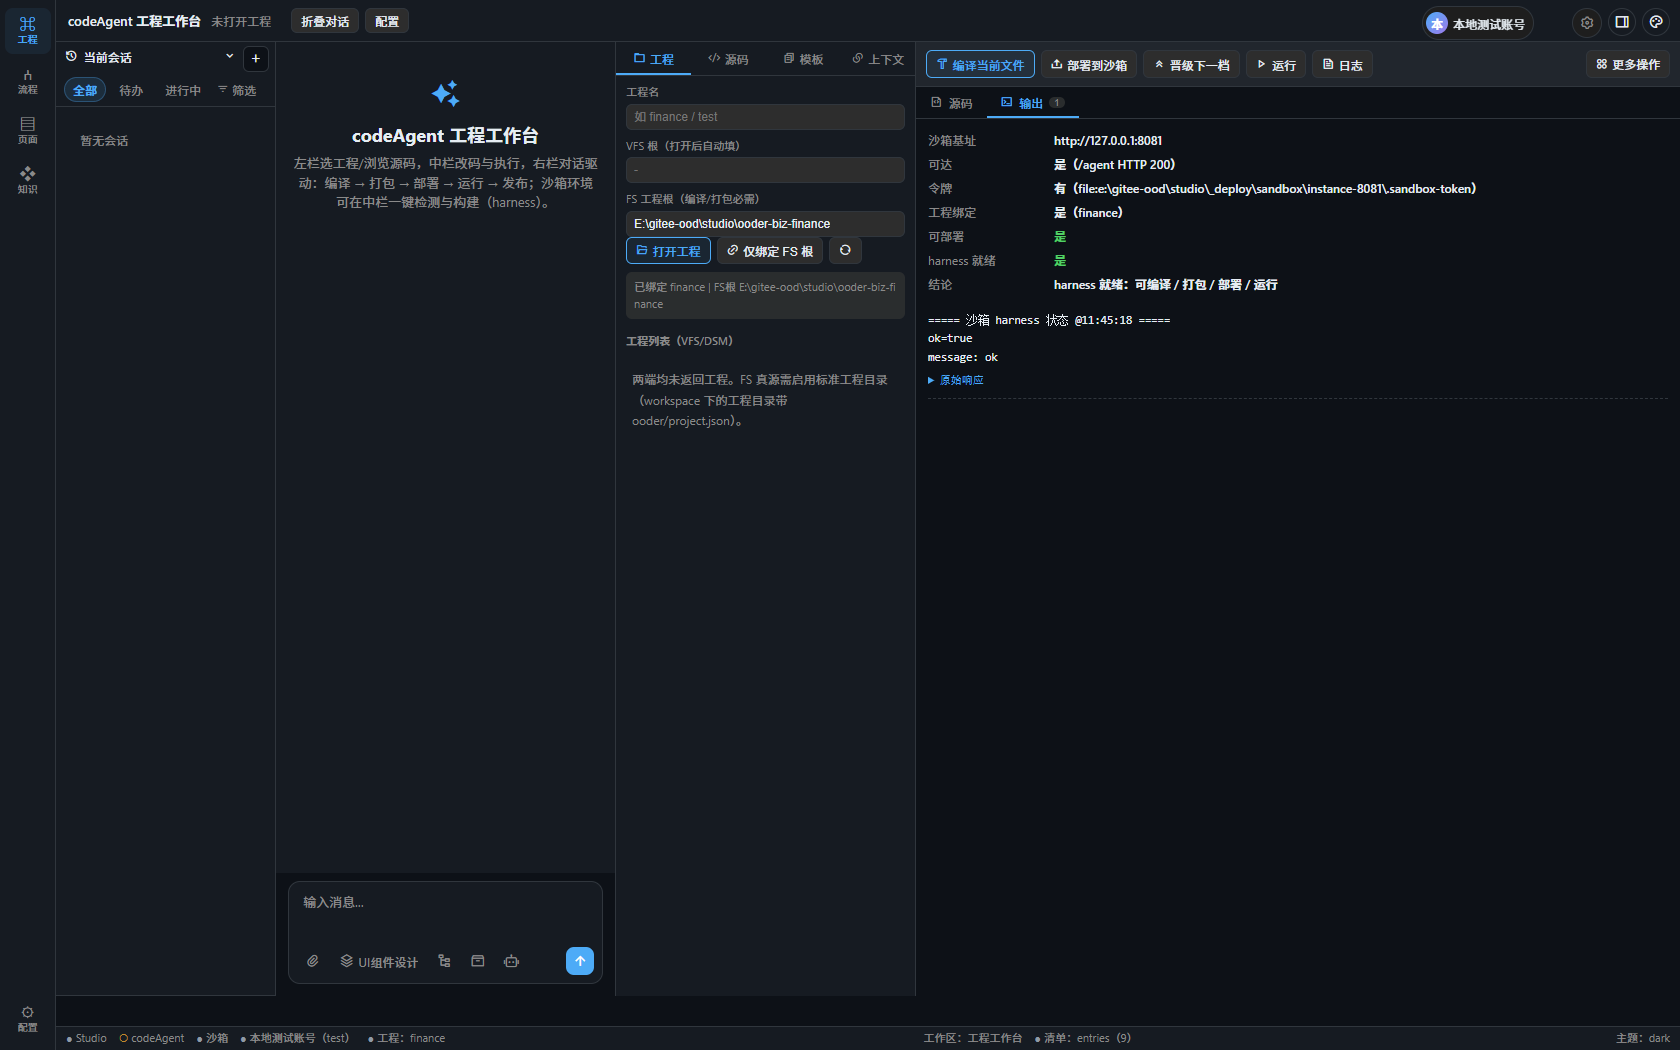
图 10 codeAgent 工作台:工程、VFS、Harness、执行状态同屏可见;Harness 只承担 C 层代码,状态可探测、可审计。截图来自实际运行界面。
Workflow 则是把“对象契约”与“Agent 运行”粘起来的最后一公里。流程定义列表展示了定义总数、写操作开关、上游来源与只读/可写状态;运行态再把节点与字段权限矩阵写进 config.fieldPerm,让“谁能看到什么、谁能改什么”在流程到达节点时自动生效,而不是靠前端隐藏。
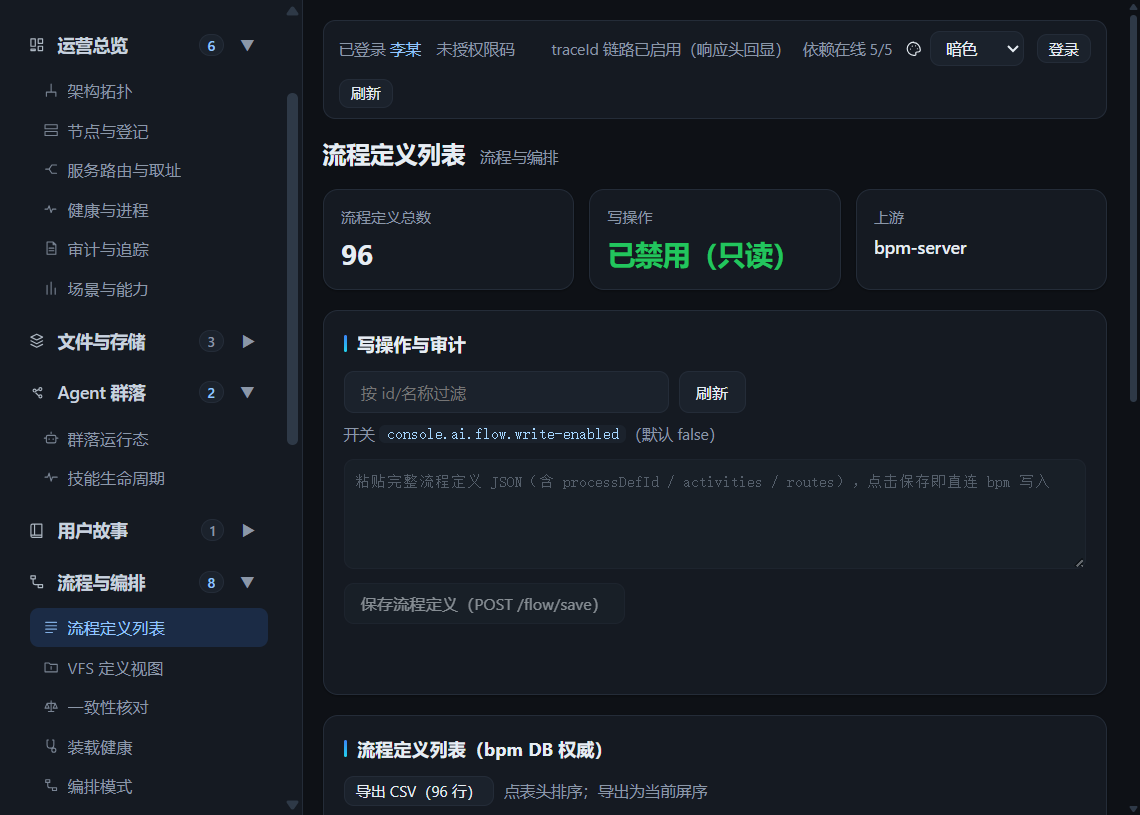
图 11 Agentic Workflow 定义与写操作审计:定义总数、写操作开关、上游来源、只读/可写状态集中呈现;写操作受开关与审计约束。截图来自实际运行界面。
全生命周期可用的标志,不是“功能很多”,而是:业务部门能自己从业务对象走到 Agent 上线,并且每一步都有契约门、有回退、有留痕。
◆ ◆ ◆
02数据飞轮:专业 Agent 的检索、分析与规则回填
2026 年的企业智能体,不再比“谁更会聊天”,而是比“谁能把分析结论写回业务”。如果 Agent 只能生成一段报告,它就是一个高级搜索框;如果 Agent 能把结论写回字段、指标、规则与流程节点,它才成为企业系统的一部分。
2.1 专业 Agent 的工作方式:四步闭环
- 语义检索:先找依据,再回答同时检索企业本体与 Context 层:本体给出对象、属性、枚举与数据位置,Context 给出口径、解释、案例与政策。检索结果带出处,不带出处的不进入结论。
- 语义查询:按口径取数,而不是临时写 SQL查询技能绑定的是已经确认过的业务对象与指标口径。业务人员看到的是一句业务问题,系统执行的是受控查询;权限、租户、数据范围在查询前就已经确定。
- 归因分析:对比、归因、风险提示分析不是生成一段“看起来很像”的文字,而是基于取数结果做对比、归因、异常识别与风险提示。结论必须能回到数据与口径。
- 规则回填:把结论写回业务把分析结果写回字段、指标、规则或流程节点:凭证字段、费用类型、税率、指标定义、合同条款、履约节点。没有回填,分析就是一次性消耗;有了回填,分析才会变成下一次的默认值。
判断一个专业 Agent 是否“专业”,不看它说了什么,而看它能不能回答三个问题:依据来自哪里?数据怎么取的?结论写回了哪里?
2.2 三类专业 Agent:同一底座,不同领域包
财务、BI、合同看起来是三个完全不同的领域,但放在通用底座上,它们的结构高度一致:都有自己的数据源、本体用法、分析产出与回填对象。
Agent | 主要数据 | 本体用法 | 分析产出 | 回填对象 |
|---|---|---|---|---|
财务 Agent | 银行流水、发票、报销单、科目余额、合同付款节点 | 科目、税额、费用类型、账龄、往来单位 | 税负分析、凭证生成、账龄扫描、报销直付 | 凭证字段、费用类型、税率、付款状态 |
BI Agent | 预算、资金、风险事件、项目与组织数据 | 指标、维度、预算科目、口径 | 预算对比、资金展望、风险雷达、结构分析 | 指标定义、分析主题、预警规则 |
合同 Agent | 合同主表、条款、相对方、履约节点、收付款计划 | 条款类型、金额、税率、相对方、节点 | 条款风险、履约进度、收付款计划 | 条款字段、履约节点、付款条件 |
先看财务。下面这张截图来自财务 Agent 的实际运行:用户让“税务雷达执行体”导出上个月的税负分析结果;Agent 自动取数,梳理科目余额表与应交税费明细科目,生成税负分析表并补齐历史月份,校验资产负债表的资产与负债权益合计是否平衡,同时提示个税需要用户上传申报数据。
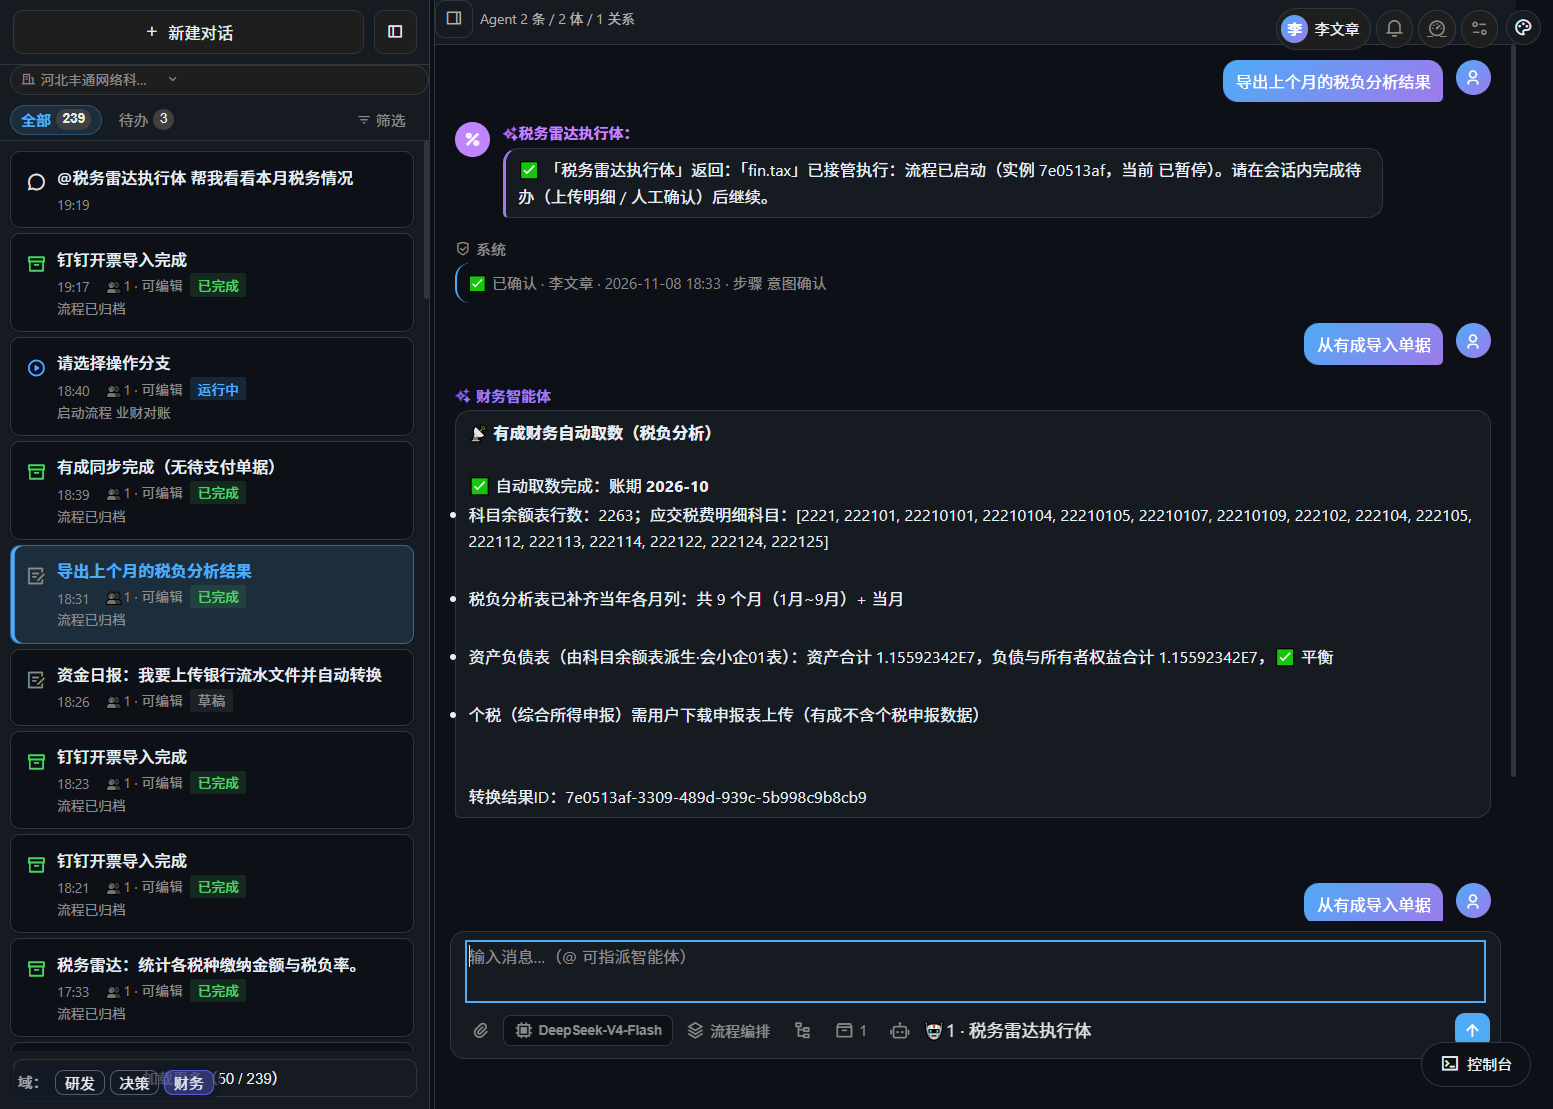
图 12 财务 Agent 的税负分析:自动取数、科目梳理、税负分析表、资产负债平衡校验、个税待办与转换结果 ID。截图来自实际运行界面。
这张截图里有三个值得注意的细节。第一,Agent 不是“直接回答税负是多少”,而是先把取数过程、科目范围、月份范围、校验结果摊开;第二,它知道自己的能力边界,个税数据需要用户上传,就明确提示,而不是编造;第三,它产出了转换结果 ID,说明分析结果进入了可追溯的产物体系,而不是停留在聊天窗口。
再看 Agent 入口。财务、技术、数据决策、知识、专利、代码等 Agent 并列在同一个入口里,用户不需要记住每个系统的地址,只需要选择“谁来处理”。这背后不是简单的菜单聚合,而是统一的 Agent 名册、能力声明与路由。
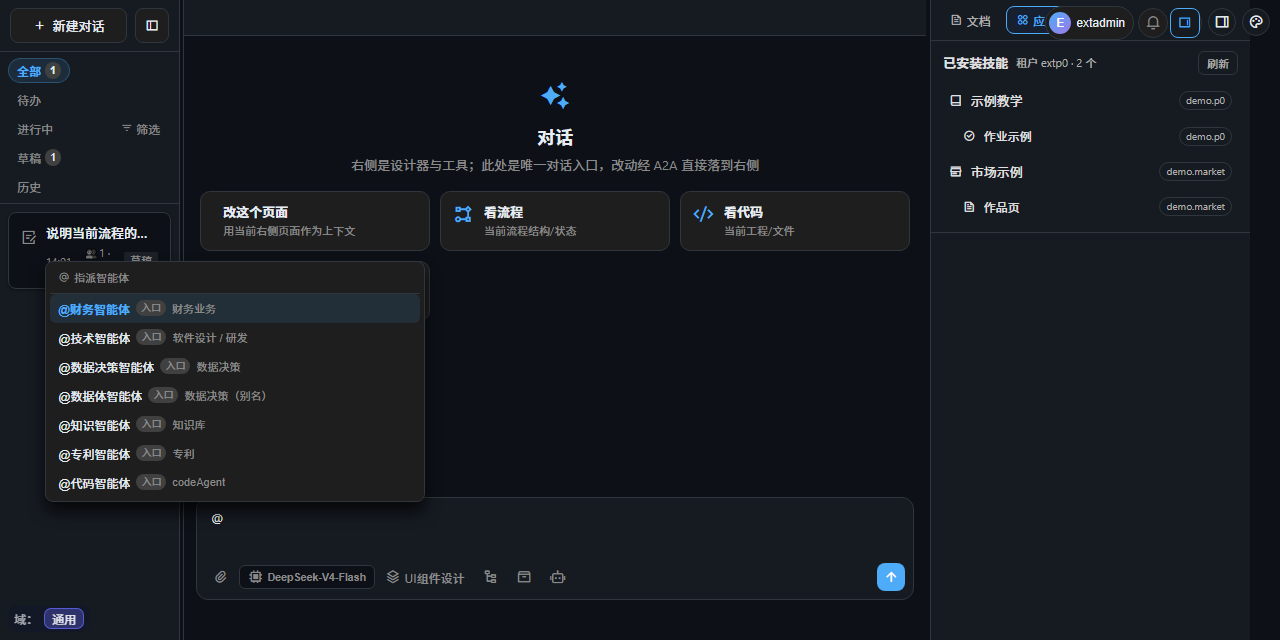
图 13 统一入口下的专业 Agent:财务、技术、数据决策、知识、专利、代码;用户选“谁来处理”,平台负责路由到对应能力。截图来自实际运行界面。
名册层则把“有哪些执行体、各自能做什么、挂在哪个节点上”变成可核对的事实。下面这张截图展示了财务域的执行体:银行流水转换、报销付款导出、开票回款对账、税负分析;每个执行体都有能力数、场景组与节点信息。
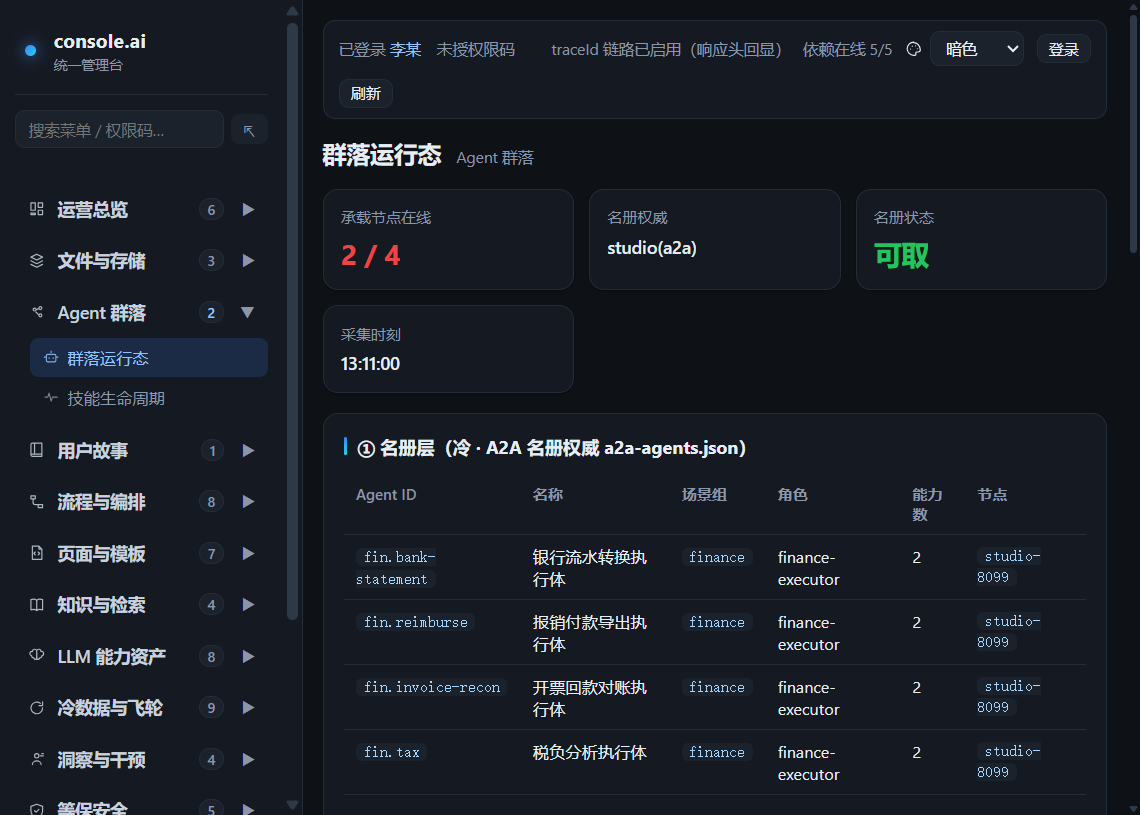
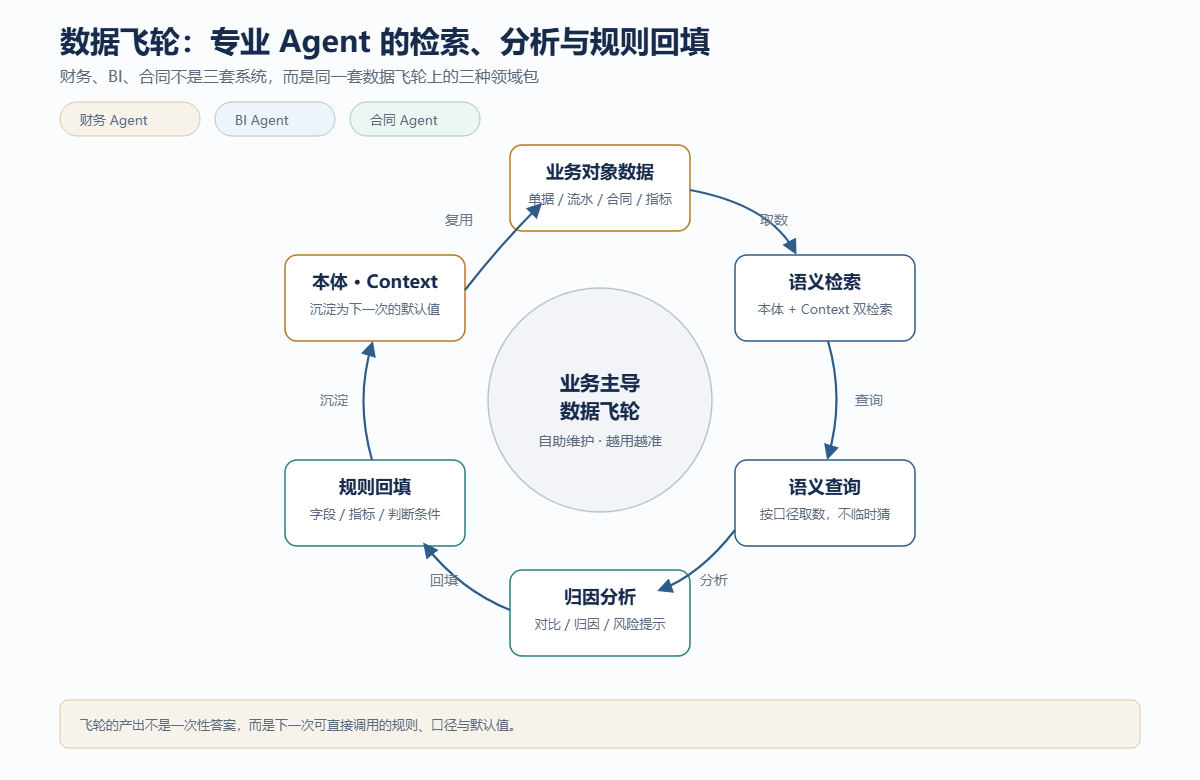
图 14 Agent 名册:财务域执行体(流水转换、报销付款、开票回款对账、税负分析)与能力数、节点信息集中呈现,便于对账与治理。截图来自实际运行界面。
BI 与合同 Agent 遵循同样的结构,只是领域包不同。BI 的“分析”更多落在预算对比、资金展望、风险雷达与结构分析;合同的“分析”更多落在条款风险、履约进度与收付款计划。它们共享同一套本体口径、同一套对象契约、同一套 Workflow 待办与 Harness 技能,差异只在 B/C 层的领域包。
专业 Agent 的专业化,不在提示词,而在领域包。提示词决定它“像不像专家”,领域包决定它“是不是专家”。
2.3 数据飞轮:业务主导的自助维护
把上面的四步闭环连起来,就得到一张数据飞轮:业务对象数据进入语义检索,检索支撑语义查询,查询支撑归因分析,分析产生规则回填,回填沉淀为本体与 Context,本体与 Context 再服务下一次检索。
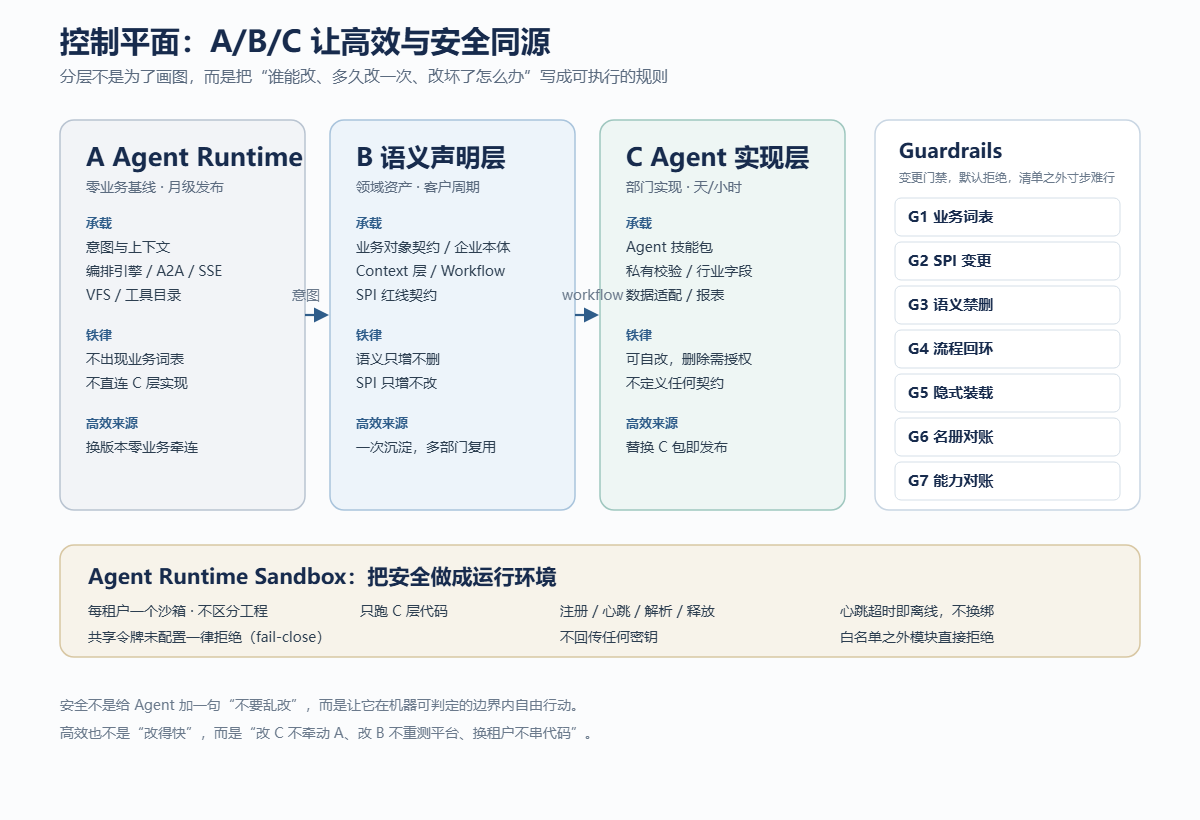
图 15 业务主导的数据飞轮:语义检索 → 语义查询 → 归因分析 → 规则回填 → 本体/Context 沉淀 → 再检索
这张飞轮有三个“业务主导”的设计点:
主导点 01
规则由业务确认
本体候选、Context 条目、指标口径是否晋升,不由模型自行决定,而由业务部门确认。Agent 可以建议,但不能代替业务签字。
主导点 02
结果由业务评价
分析结论是否符合预期,由业务在使用中反馈。反馈进入 accepted / corrected / rejected 队列,成为下一轮修正样本。
主导点 03
版本由业务决定
口径什么时候生效、适用哪些部门、是否回滚,由业务与 Context 管理员共同决定;平台只负责版本、权限与审计。
行业坐标:CAICT《智能原生(AI Native)研究报告(1.0)》把飞轮拆成数据闭环、模型迭代、用户感知、价值转化四个要素;Gartner 2026 年战略技术趋势把多智能体系统(MAS)与 Harness Engineering 列入重点。本文的差异是:不把飞轮停在方法论,而是把它落到可执行的 B/C 资产——业务对象、企业本体、Context 层、Agent 技能包与 Workflow。
举个具体的例子。税负分析时,Agent 发现“进项税额”的取数口径与财务确认的口径不一致:有的月份按认证日期,有的月份按入账日期。它没有直接改数,而是把差异、影响金额与两种口径的对比回填到反馈队列。业务确认“以认证日期为准”,Context 管理员发布新版本,本体晋升对应的属性口径。下一次分析,Agent 自动按新口径取数,不再需要人工提醒。
这就是“业务主导的数据飞轮自助维护”:飞轮不是模型自转,而是业务规则的自转。模型负责检索、计算与回填,业务负责确认、评价与版本;平台负责权限、审计与回滚。
◆ ◆ ◆
03控制平面:A/B/C 让高效与安全同源
讲到这里,一个自然的问题会出现:业务部门权力这么大,平台怎么保证安全?答案不是“收紧权限”,而是“分层 + 控制平面”。A/B/C 不是一张架构图,而是一套治理契约:谁能改什么、多久改一次、改坏了怎么办,全部写成可执行的规则;身份、策略、运行时与生命周期,由控制平面统一编排。
3.1 三层职责:A 持平台,B 持领域,C 持实现
层 | 持有什么 | 绝不持有什么 | 发布节奏 |
|---|---|---|---|
A Agent Runtime | 会话、意图路由、编排引擎、A2A、SSE、VFS、工具目录 | 任何业务词表、领域知识、部门流程 | 月级 |
B 语义声明层 | 业务对象契约、企业本体、Context 层、Workflow 定义、SPI 契约 | 具体业务实现、租户私有代码 | 客户周期 |
C Agent 实现层 | 业务对象生成器、专业 Agent 技能、部门私有逻辑 | 契约定义、平台能力 | 天 / 小时级 |
三层之间只有一条合法调用路线:A —(意图)→ B —(workflow / ObjectSpec)→ skills → C。A 不直连 C;B 是语义与声明的关口;C 只做实现。这条路线同时解决三件事:解耦(A 换版本不影响 B/C)、审计(跨界流量过 B 的 workflow)、权限(A 拿不到 C 的内部实现名)。
图 16 A/B/C 控制平面与 Guardrails:每层有明确的承载物、铁律与发布节奏;门禁把“安全”做成机器可判定的规则
3.2 安全:把边界做成运行环境
安全不是给 Agent 加一句“不要乱改”,而是让它在机器可判定的边界内自由行动。Agent Harness 的每一条契约,都是这条原则的落地:
- 只跑 C 层:Harness 能力只允许
C_LAYER_BUILD / RUN / TEST / LOG,心跳上报的模块必须是 C 层白名单或中心已登记工程; - 租户隔离:每租户一个 Harness,不区分工程;同一租户换 Harness 需要先释放,禁止静默换绑;
- 默认拒绝:共享令牌未配置时一律拒绝,而不是放行;心跳超时即离线,不回传任何密钥;
- 变更门禁:业务词表扫描、SPI 变更闸、语义禁删闸、流程回环不变式、隐式装载闸、名册对账、能力对账,七道门禁在变更落库前逐项判定。
这些规则有一个共同点:它们都不依赖模型自觉。默认拒绝、白名单、TTL、只增不删、机器对账,全部是可计算、可验证、可回滚的。企业不必“信任 AI”,只需要信任这套闸门。
3.3 高效:让变更节奏彼此正交
高效不是“改得快”,而是“改得不动底座”。A/B/C 把三种变更节奏物理隔离:平台月级发布,领域按客户周期发布,业务按天/小时发布。三者互不牵连,才可能出现“业务部门当天改、当天上线”的效率。
- 替换 C 包即发布:业务 jar 与平台基线保持数量级差异,替换
lib/biz/不需要重传平台基线; - 一次沉淀、多部门复用:企业本体、对象契约、Workflow 定义归 B 层,财务沉淀的口径可以被合同、BI 复用;
- 多租户共享底座:每个租户一个 Harness,共享同一套 A 层能力,但代码、数据、令牌彼此隔离;
- 运行态可回滚:Context 版本、Agent 技能包、Workflow 定义都保留回滚资产,出问题以分钟计恢复,而不是以天计排查。
高效与安全不是取舍,而是分层的结果。分层越清,业务越敢改;边界越硬,平台越敢放。
回到文章开头的问题:业务部门能不能直接定义企业本体与 Agent 行为?能,但前提是语义有地方放、Context 有流程评审、契约有版本可回滚、Agent 有 Harness 可运行、变更门禁可拦截。通用企业智能体底座的核心设计,正是把这五个“有”做成默认能力,而不是项目交付时的一次性承诺。
04结语:AI 原生企业的终点,是业务部门自己能造 Agent
把全文收束成三句话:
第一,业务对象 + 企业本体,证明“业务语言可以编译成语义契约”。表单只是视图,业务对象才是资产;三条建模路线与四类逆向,让存量系统也能被理解、被接管。
第二,Agent Harness 证明“业务实现可以被隔离生产”。每租户一个 Harness、只跑 C 层、心跳续约、离线即拒绝、密钥不回传,让业务部门可以快速发布,而平台不必承担不可控的风险。
第三,Context 层 + 数据飞轮,证明“不同部门的数据可以共享同一套语义”。本体管业务对象的语义,Context 管口径与解释;一个负责“是什么”,一个负责“为什么”。两者都不属于某个 Agent,而属于企业自己。
三者合起来,就是 AI 原生企业智能体底座的核心设计:A 持平台,B 持领域,C 持实现;语义建模沙箱负责定义对象,Agent Harness 负责驾驭运行,企业本体与 Context 负责让一切说同一种语言。
判断 AI 原生底座是否真正成立,只需要问一个问题: 业务部门新增一个业务对象、改一个 Agent 行为、换一个口径,还需不需要找平台排期? 如果不需要,而且改完还能回滚、能审计、能复用,那么底座就成立了。
最终交付给企业的,不是几个财务、BI、合同 Agent,而是一条任何部门都能自己使用的 Agent 生产线。平台在背后守住边界,业务在前台定义语义;Agent 在中间完成语义检索、受控查询、归因分析与规则回填。数据越用越准,规则越用越厚,Agent 越用越多——这才是 AI 原生企业智能体底座真正的价值。
说明:本文截图来自项目实际运行界面,示例数据仅用于说明架构与流程;图中出现的组织、人名与金额不代表真实业务数据。流程图使用 SVG 绘制,发布到公众号前建议导出为 2x PNG 以适配平台图片格式。 行业参考:Gartner《2026 年十大战略技术趋势》与《Hype Cycle for Agentic AI》;CAICT《智能原生(AI Native)研究报告(1.0)》;Gartner 2026 软件工程趋势中的 Harness Engineering;Atlan《Ontology AI Grounding》;Bain《The Lakehouse Becomes the Agentic Enterprise Control Plane》;Capgemini《Agentic Process Automation 2026》。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号