GPT Image 2.6 上生产:并发、异步回调与产物归档
原创

把 gpt-image-2.6 接进生产链路,和在网页上试几张图是两件事。
网页上只要关心「好不好看」,生产链路要关心另外三件事:任务怎么排、结果怎么收、记录怎么留。这篇按工程视角把三个环节拆开,附上一组可以直接落地的参数。
一、任务怎么排:先分清同步与异步
图像接口本质上是异步的。提交一次请求,拿到任务号,然后等结果。等的方式有两种:轮询和回调。
轮询实现简单,缺点是占连接、费请求、容易把无谓的调用打满。适合任务量小、对延迟不敏感的批处理。
回调(Webhook)更省资源,但对服务端有要求:要有一个公网可访问的接收端点,要做签名校验,要处理重复投递。
生产环境一般两条都上:主用回调,回调超时或丢失时用轮询兜底。
提交任务
 ├─ 写入任务表(状态=submitted)
 ├─ 调用生成接口,拿 task_id
 └─ 返回 202 给上游

回调到达
 ├─ 校验签名
 ├─ 按 task_id + 状态去重
 ├─ 下载图片,落对象存储
 └─ 更新状态=done,发消息给下游

兜底轮询(每 30s)
 └─ 扫状态=submitted 且超过 90s 的记录,主动查一次
两个细节容易出问题。
去重不能靠应用层判断。 回调会重复投递,尤其在上游重试的时候。落库时以 task_id + status 作为去重依据,重复的写入直接拦在数据库这一层。
乱序要处理。 同一个任务可能先收到 done 再收到 processing,如果按到达顺序更新状态,终态会被覆盖回中间态。做法是给状态定一个序,只允许单向推进。
二、结果怎么收:三种输出格式的链路不同
2.6 新增了 GIF 与 SVG 两种输出,它们的链路和位图不一样,要在任务表里加一个 output_format 字段分流。
位图:返回 base64,解码后落存储,再做压缩与尺寸派生。
GIF:通过 output_format="gif" 指定,配合 frame_count(2–16,默认 9)与 frame_duration_ms(默认 200)。只支持生成端点,编辑端点不返回动图,动图上也不能直接做局部重绘。
SVG:通过 output_format="svg" 指定,n 固定为 1,不支持流式与部分图预览。产出的是静态矢量文件,里面没有脚本、没有外链资源、也没有内嵌位图。这一路要先落原始文件,再做结构与图层校验,才能进素材库。
有个接口层的坑值得记:SVG 请求会先出一张参考图,再由另一个模型据此写矢量代码,两段都要走一遍。如果按「一次生成」去估算,这条链路会被低估。
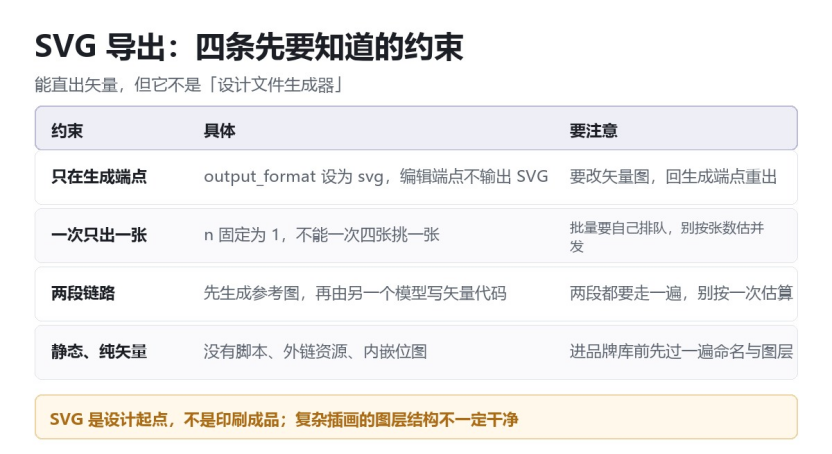
示意图:SVG 导出在端点、批量、产出与文件属性上的四条约束
三、并发怎么控:按上游限额的六成设
并发给满是新手最容易犯的错。看起来快,实际是给自己制造限流。
经验值:把并发设成上游限制的六成,留出重试的余量。这样在个别请求超时重试时,不会立刻触顶。
具体做法:
· 用队列削峰,提交端只负责入队,不直接打接口
· 消费端按并发上限取任务,失败进重试队列,最多重试三次
· 重试要带退避,间隔递增,别用固定间隔
· 给单批任务设上限,比如一次不超过 20 张,先看成品率再决定是否继续
最后一条是控量的关键。批量任务里成品率低的时候,继续追加只会放大返工。
四、画质怎么定:先看这张图交付到哪
2.6 的质量是六种:low、medium、high、xhigh、max、auto;2.5 同样是六种,2 是三种。名字一样,含义不完全一样,同一段描述在两个版本上出来的密度会有差别,换版本时要重看一遍。
定画质的顺序最好是反过来——先问这张图最终用在哪,再选:
· 试版与内部对稿:low 或 medium,够看清构图与配色
· 详情页主图:high 起步,等比例裁切之后仍要经得起放大
· 印刷或大幅展示:xhigh 或 max,把边缘与纹理留足余量
· 不想逐张判断:auto,交给模型按描述复杂度自己定
实践里容易踩的坑是「一路拉满」。定稿拉满是合理的,起草拉满只是把错误放大之后再重看一遍。所以链路里通常并存两个版本:试版走轻的一侧,定稿走重的一侧,任务表里需要一个 model_version 字段,否则回头分不清哪张是哪一版出的。
五、记录归档:把每次生成挂到业务对象上
如果出图不是给一个项目用,而是给多个商品、多个店铺用,每次生成必须能归到对象上,否则没法判断哪一段该调。
最小可用的归因表,至少四个维度:
维度 | 说明 |
|---|---|
商品/项目 | 这次生成的图属于哪个 SKU 或哪个活动 |
图位 | 主图、详情页、场景图、动图 |
模型版本 | 2.0 / 2.5 / 2.6,以及 flare / sunburst |
结果 | 采用 / 废弃 / 重试 |
有了这四个维度,才能回答「这个 SKU 的图是怎么来的」「换到 2.6 之后哪一类更稳」这类问题。
六、几个上线后才会遇到的事
超时阈值设短了。 高画质 + 高 complexity 的请求会明显变慢。默认超时不要按低画质设,否则大量请求「假失败」,实际已经生成但结果丢了。
重试没有幂等键。 同一个业务请求重试两次,会产生两张图、两份消耗。提交时带业务侧生成的幂等标识,上游按这个标识去重。
对象存储的命名没规划。 图一多就找不到了。建议按 业务/日期/任务号_图位 三层结构,任务号与数据库对得上。
忽略了水印与元数据。 2.6 生成的图带 SynthID 与 C2PA 元数据。转码、压缩时如果把这些字段清掉,来源信息就断了。对需要留痕的场景,这一步要单独处理。
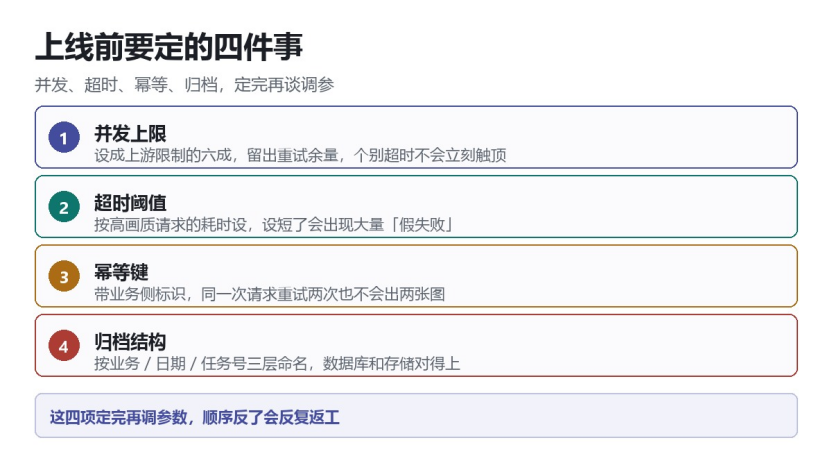
示意图:上线前要定的四件事,并发、超时、幂等、归档
结语
接一个图像模型到生产链路,难点从来不在调用本身,在状态管理、异常收场和记录归档。
2.6 带来的变化集中在三处:输出格式多了两种,链路要分流;参数多了一个维度,映射要重写;质量选项的含义也变了,取值要重新对一遍。
把这三件事在接入前想清楚,后面会省很多事。至于用哪家平台承载,判断标准可以很简单:能不能在同一个账号里同时跑新旧版本,能不能把调用记录挂到业务对象上。Flux Art 这类多模型 AI 视觉创作与生产平台在这两点上做得比较直接,网页端与开放接口共用一套账号,任务记录里带着模型、图位与状态,做归因时不用自己重新定义口径。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号