基于 YOLO11 的下水管道六类缺陷检测:从数据采集到推理复核的工程闭环
原创
基于 YOLO11 的下水管道六类缺陷检测:从数据采集到推理复核的工程闭环
原创
用户8779533
发布于 2026-11-21 15:47:41
发布于 2026-11-21 15:47:41
城市排水管网和工业管廊的巡检长期依赖人工判读与离线抽检,管径小、光线差、内壁纹理复杂,缺陷样本在整段视频中往往只占很短时间。要把这类场景做成可复用的检测能力,关键不在于单点模型指标,而在于把数据采集、对象存储、标注、训练、推理和人工复核串成一条可追溯的链路。本文以 YOLO11 为目标检测训练模型,结合下水管道六类缺陷数据集,梳理一套偏工程落地的实施思路,重点说明数据集组织方式、样本特征、训练与推理配置,以及上线前需要验证的环节。
行业需求与任务定义
管道缺陷检测的业务目标通常有三个层次:一是从巡检视频中定位异常帧和异常区域;二是给出缺陷类别,便于维修派单和优先级排序;三是保留可复核的证据链,让复核人员能快速确认模型输出。对应到算法侧,这就是一个多类别目标检测任务,输入是管道内窥摄像头采集的图像帧,输出是缺陷框、类别和置信度。
与通用目标检测相比,管道场景有几个明显约束。第一,成像条件不稳定,补光不均、镜头起雾、运动模糊都会影响特征表达。第二,部分缺陷是形态类异常而非独立物体,例如变形、错口这类需要结合管道结构判断的类别,标注一致性比框的紧致程度更重要。第三,缺陷在画面中可能很小,直接缩放到低分辨率会丢失判别信息。因此工程上更合理的做法是把检测模型放在抽帧后的高分辨率图像上运行,再用跟踪或帧间投票降低单帧误检。
数据集说明(来源:数据集说明表)
本次使用的数据集目录名为 P188.下水管道六类缺陷数据集下水管道数据集,项目名为 xiashuiguandao6leiquanxie。数据集包含六个标注类别:Deformation(变形)、Deposition(沉积)、Disconnect(断开连接)、Misalignment(未对准)、Obstacle(障碍物)、Rupture(破裂)。整套数据集共 12423 张图片,训练集、验证集与测试集已按比例划分完成,标注文件为 txt 格式,标签与图片一一对应,可直接用于 YOLO11 训练,无需额外格式转换。
当前整理出的演示素材来自 label_studio_import/oss_selected_100 目录,包含 100 张代表性图片、Label Studio 导入 JSON、标注界面配置,以及由这些图片生成的轮播视频 100张图片视频.mp4。这批素材的用途是标注流程演示和数据集预览,与完整训练集在规模上不同,阅读时需要注意区分:完整数据集用于训练与评估,100 张精选样本用于说明标注规范和画面特征。
数据格式方面,txt 标签与图片同名对应,符合 YOLO11 直接读取的目录约定。工程上建议在对象存储中按 images/train、images/val、images/test 与 labels/train、labels/val、labels/test 的镜像结构组织,训练前用脚本校验图片与标签的一一对应关系,避免出现空标签文件或越界坐标。
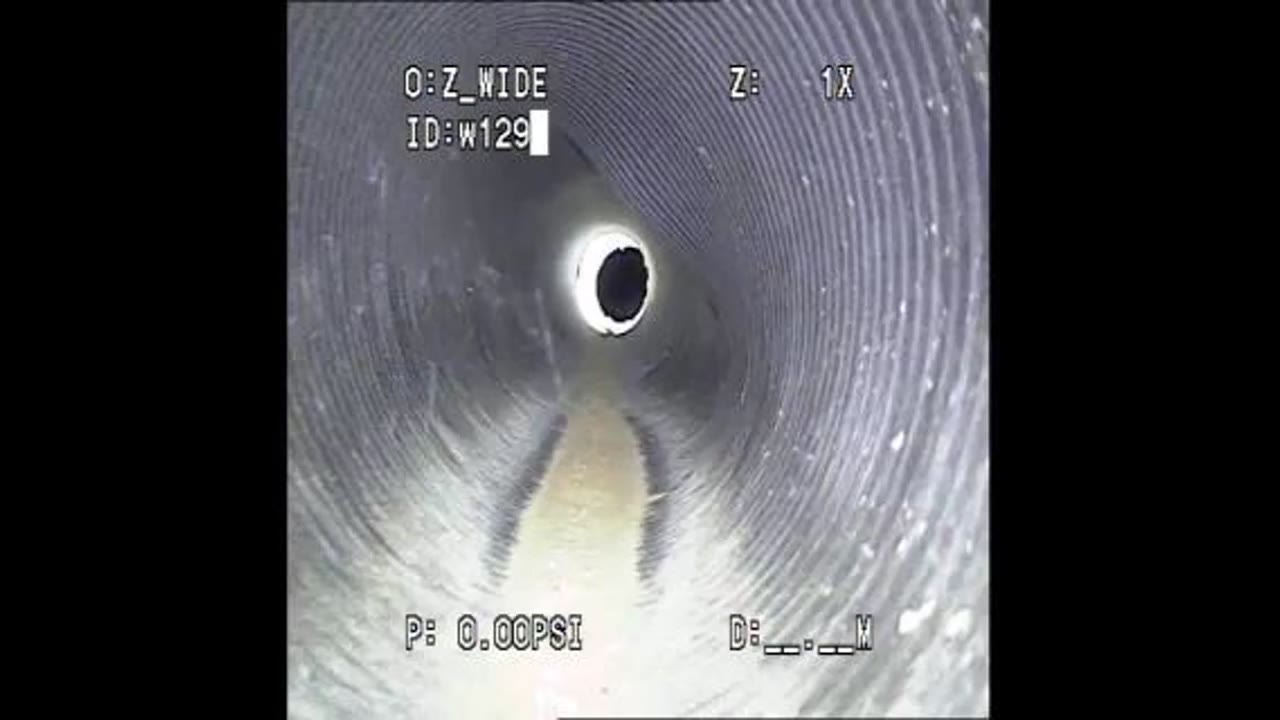
数据集样本抽帧
数据集样本抽帧,用于展示管道内部画面特点,不对具体缺陷类别作断言。
样本特征分析
从抽帧画面看,管道内部以环形或半环形视角为主,画面中心区域通常更清晰,边缘存在暗角和畸变。内壁纹理重复度高,水渍、泥沙附着和光照反射容易与真实缺陷混淆,这也是训练中需要重点关注的地方。
结合素材观察,可以归纳出三类难点。第一,类别间视觉相似性较高。沉积与障碍物在画面中都表现为局部遮挡,变形与错口都涉及管道几何结构的偏移,仅凭单帧局部纹理很难稳定区分,需要模型学习更大范围的上下文。第二,小目标与模糊目标占比不低,部分缺陷区域面积小、对比度低,标注框容易偏松或偏紧,进而影响回归质量。第三,管道纹理本身具有强重复性,模型在训练早期容易对背景纹理过拟合,表现为训练损失下降但验证集召回不稳定。
针对这些特征,工程上可以采取几项措施:在数据侧保证每个类别在训练集和验证集中都有足够样本,避免长尾类别被背景淹没;在增强侧控制水平翻转、随机缩放和亮度扰动的幅度,避免破坏管道结构的空间关系;在标注侧对边界模糊的样本建立统一的判定口径,减少同一缺陷在不同标注人员之间的差异。
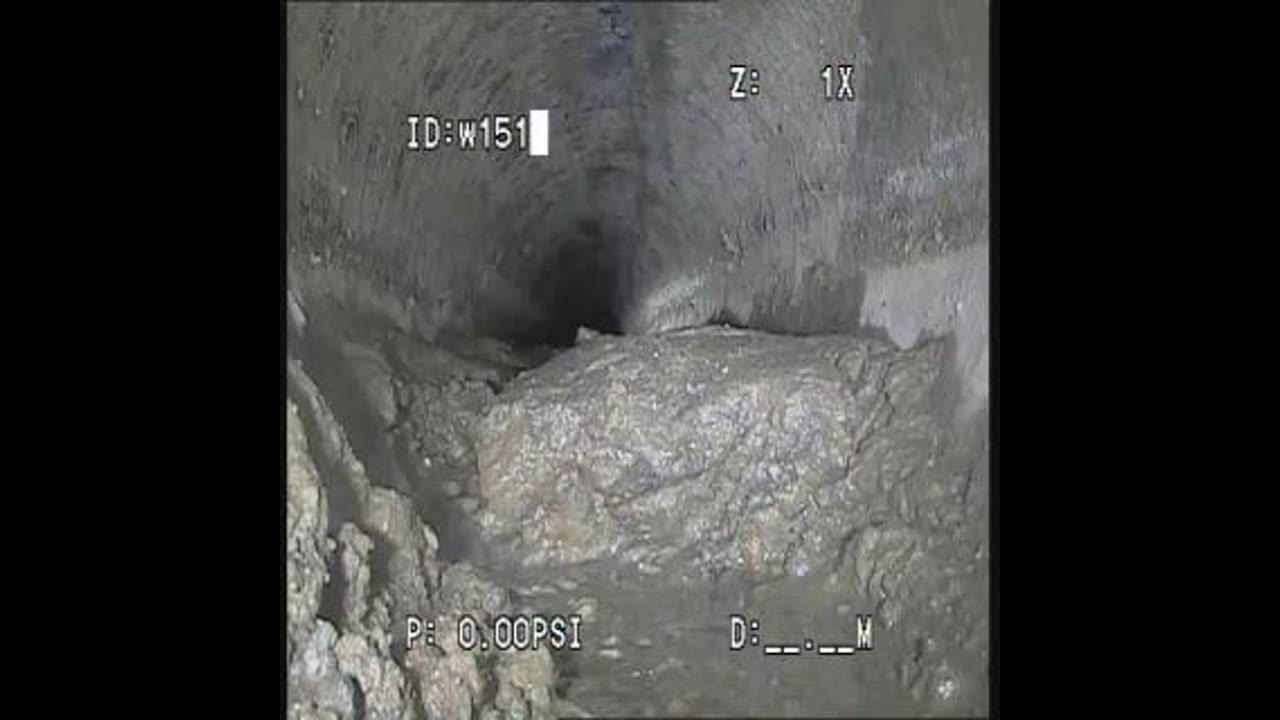
数据集样本抽帧
数据集样本抽帧,展示管道内部典型画面,配图仅作场景说明。
标注流程与类别体系
标注环节建议使用 Label Studio 完成初标,再导出为 YOLO11 可直接消费的 txt 格式。类别体系固定为上述六类,标注时需要注意两点:一是框应覆盖缺陷的可见范围,不强行外扩到正常管壁;二是对于跨越画面边缘的缺陷,按可见部分标注并在备注中说明,避免同一缺陷在相邻帧中被重复计为新目标。
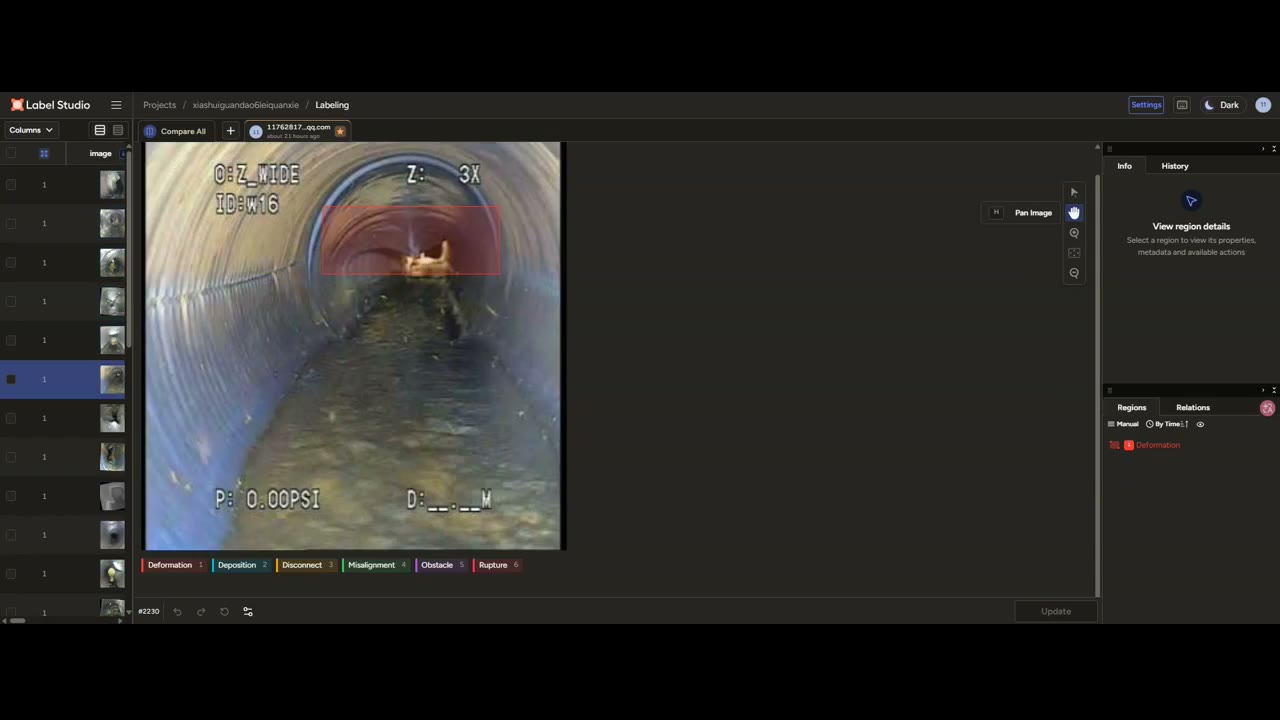
Label Studio 标注界面示例
Label Studio 标注界面示例,界面中的类别图例不代表当前图片的全部缺陷结论。
标注完成后建议做一轮交叉复核,重点检查类别混淆高发的样本对,例如沉积与障碍物、变形与错口。复核记录可以随标注文件一起存入对象存储,形成“原图—标注—复核结论”的可追溯关系,这对后续模型误检分析很有价值。
训练与推理链路
整体链路可以拆成五段:视频抽帧与筛选、对象存储归档、标注与格式转换、YOLO11 训练、推理与人工复核。
数据采集与归档。 巡检视频按批次抽帧,抽帧间隔根据巡检速度和缺陷持续时间确定,通常保证同一缺陷在连续帧中出现数次即可。筛选后的图像连同原始视频一起上传到对象存储,按项目、批次、日期分层存放,图像与标签使用相同的相对路径,便于训练脚本直接按前缀拉取。
训练配置。 YOLO11 的训练入口是 yolo detect train,核心是数据配置文件与超参配置。下面给出一个可直接套用的配置示例,路径按对象存储挂载或本地缓存目录替换即可。
# data_pipeline.yaml
path: /data/pipeline_defect
train: images/train
val: images/val
test: images/test

names:
  0: Deformation
  1: Deposition
  2: Disconnect
  3: Misalignment
  4: Obstacle
5: Ruptureyolo detect train \
model=yolo11n.pt \
data=data_pipeline.yaml \
imgsz=960 \
epochs=100 \
batch=16 \
patience=20 \
device=0 \
project=runs/pipeline \
name=yolo11_baseline几点工程建议。输入尺寸方面,管道缺陷偏小,imgsz 不宜过低,960 是一个折中值,显存紧张时可降到 640 并配合切片推理。模型规模方面,先用轻量档位跑通链路和评估流程,再根据验证集表现决定是否换更大档位,避免一开始就在大模型上消耗调试时间。训练轮次配合 patience 做早停,减少过拟合带来的无效训练。
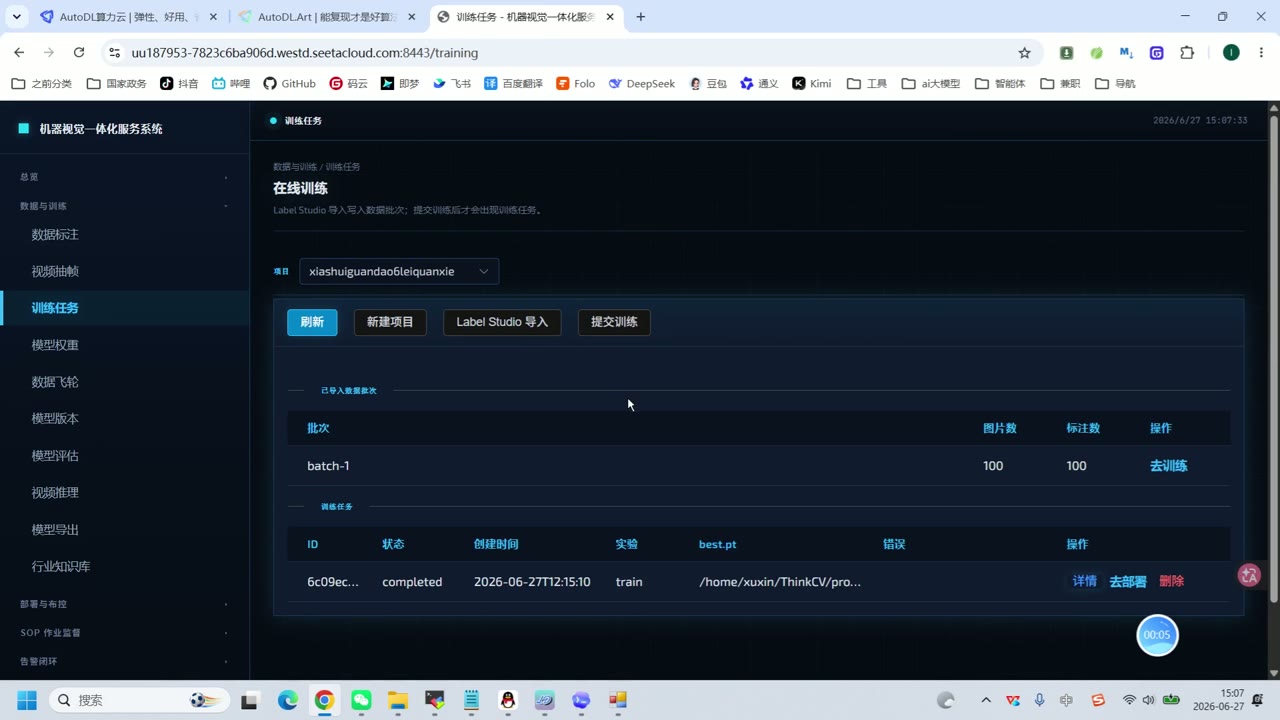
模型训练操作界面
模型训练操作界面,展示训练配置与参数设置。
推理与复核。 推理阶段建议保留原始分辨率,先做整图检测,再对低置信度结果做局部裁剪复检。视频场景下可以引入简单的帧间关联:同一位置连续多帧出现同类检测才进入复核队列,单帧偶发的高置信框先降级处理。复核界面需要同时展示原图、检测框、类别和置信度,复核人员的确认或驳回结果回写到存储,作为下一轮难例挖掘的输入。
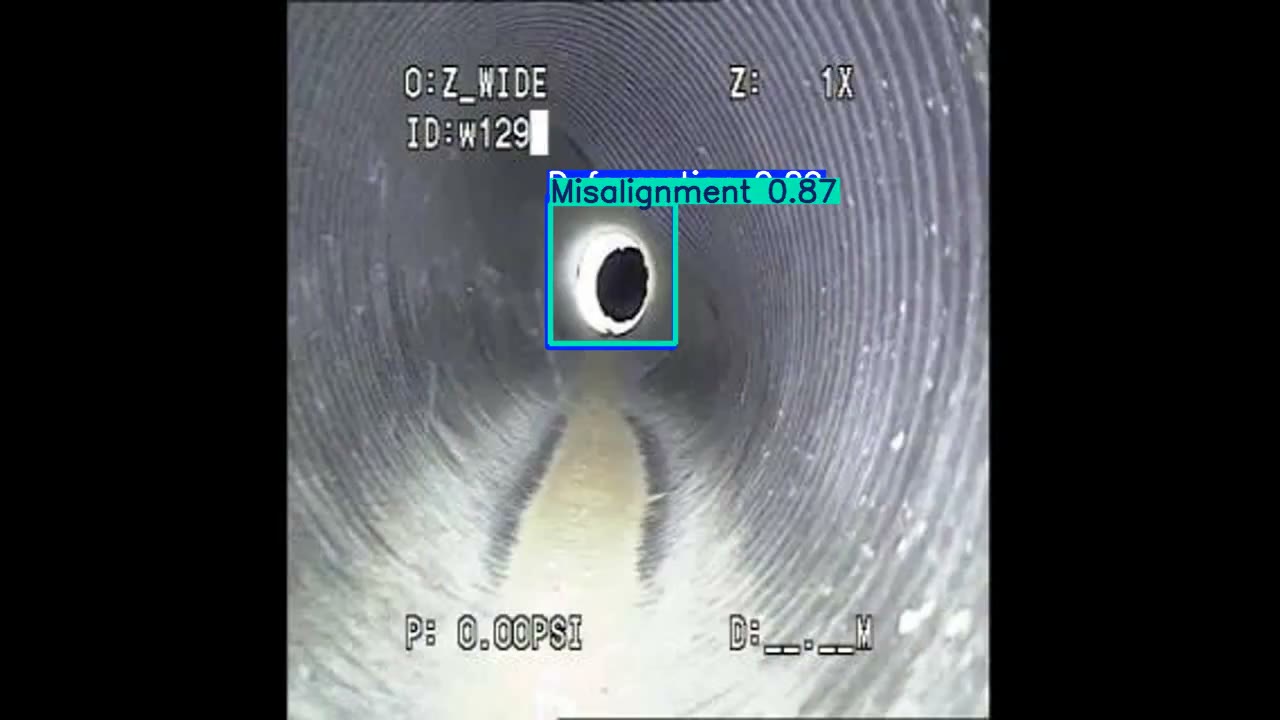
模型验证结果截图
模型验证结果截图,具体类别以图片中可见标签为准。
上线前验证
上线前不建议只看单一 mAP,而应按业务关注点拆分验证。第一,按类别统计召回与误检,重点看长尾类别是否被系统性漏检。第二,按画面质量分组评估,例如清晰帧、模糊帧、暗光帧分别统计,判断模型是否过度依赖成像条件。第三,做阈值敏感性分析,观察置信度阈值变化时精确率与召回率的取舍,为复核队列的容量规划提供依据。第四,用连续视频段而非孤立图片做端到端回放,检查帧间抖动和重复告警。
验证集应与训练集在采集批次上尽量分离,避免同一段视频的相邻帧同时出现在训练和验证中造成指标虚高。这一点在管道场景尤其重要,因为相邻帧的画面差异很小。
风险与优化方向
过拟合与背景干扰。 管道纹理重复度高,模型容易记住背景而非缺陷特征。可以通过增加不同管径、不同光照的样本,或在增强中引入适度的对比度和噪声扰动来缓解。
类别混淆。 沉积与障碍物、变形与错口在视觉上接近,建议在标注阶段补充判定规则文档,并在训练后针对混淆对做专项误检分析,必要时调整类别边界或引入辅助分支。
小目标与模糊目标。 提高输入分辨率、使用切片推理、在标注侧保证小目标框的紧致度,都是可尝试的方向。同时要接受这类样本在复核环节保留一定人工介入。
数据闭环。 把复核结果按类别和场景归档,定期回流为增量训练数据,是维持模型长期可用的关键。回流数据需要重新走标注和校验流程,不能直接把模型输出当作真值。
存储与成本。 原始视频体积大,建议在对象存储中设置生命周期策略,长期保留抽帧图像和标签,原始视频按批次保留有限时长,兼顾追溯需求和存储成本。
总结
下水管道缺陷检测的工程难点集中在数据一致性和场景复杂性上,模型本身只是链路中的一环。以 YOLO11 为训练模型,配合规范的 txt 标注、对象存储归档和复核回流机制,可以把一次性的检测任务变成可持续迭代的能力。本文给出的数据集组织方式、训练配置和验证思路适用于城市排水管网、工业管廊等类似场景,实际落地时仍需结合具体管径、成像设备和巡检节奏调整抽帧策略与阈值设置。建议先把数据闭环跑通,再逐步优化模型规模与推理效率,避免在链路未稳定时过度投入调参。
附:样本与标注图集
以下图片均取自该数据集真实样本、YOLO 标注效果图与 Label Studio 标注工作台界面,用于对照上文的数据组织与标注流程说明。
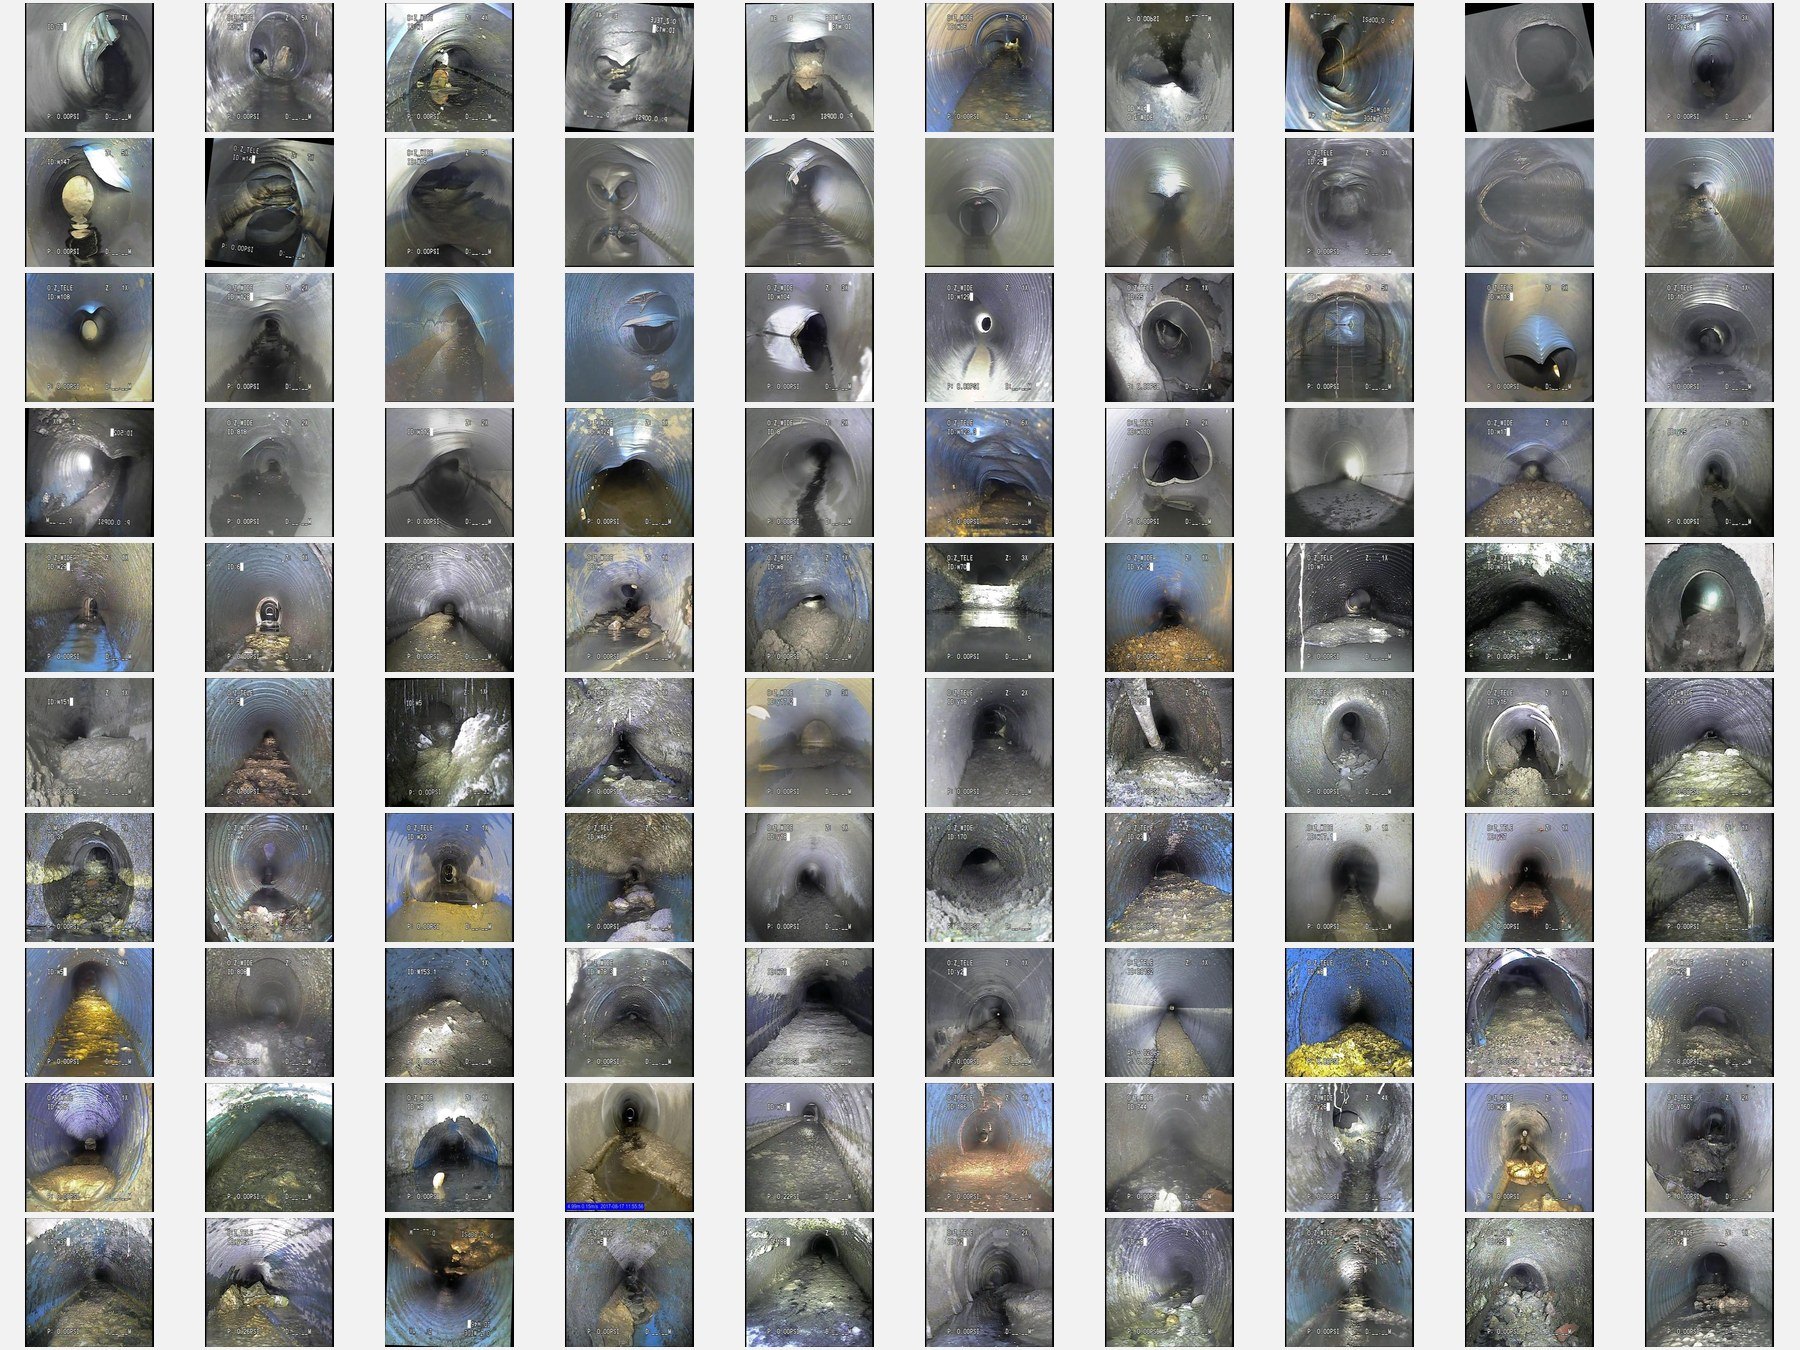
图 01 · 前 100 张样本总览(真实数据压缩包内抽取)
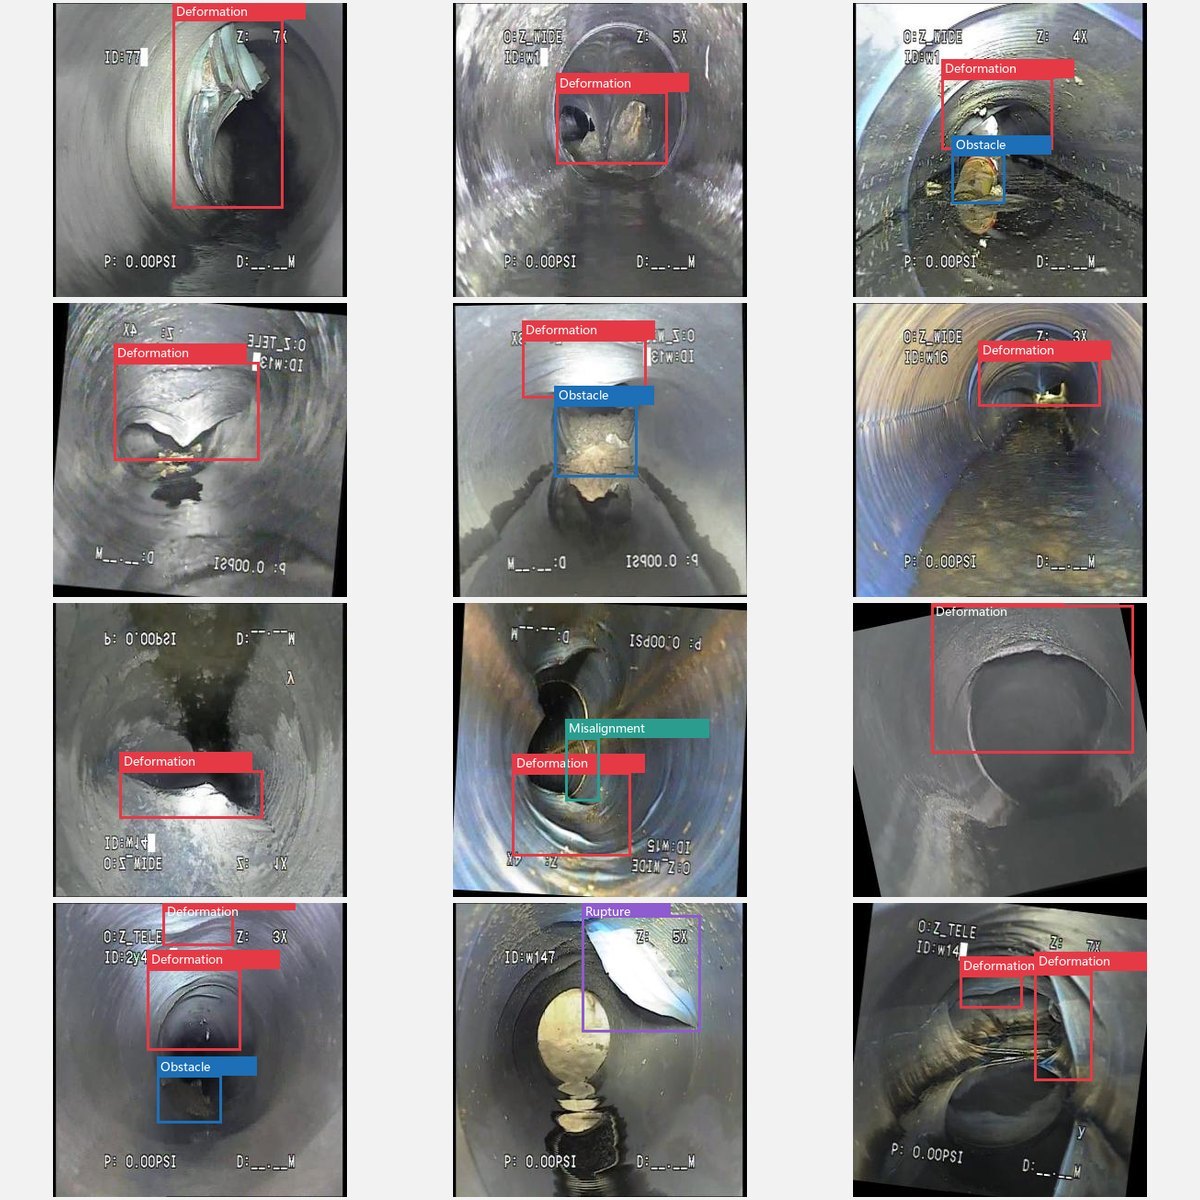
图 02 · YOLO 标注效果展示(一)· 检测框 + 类别标签
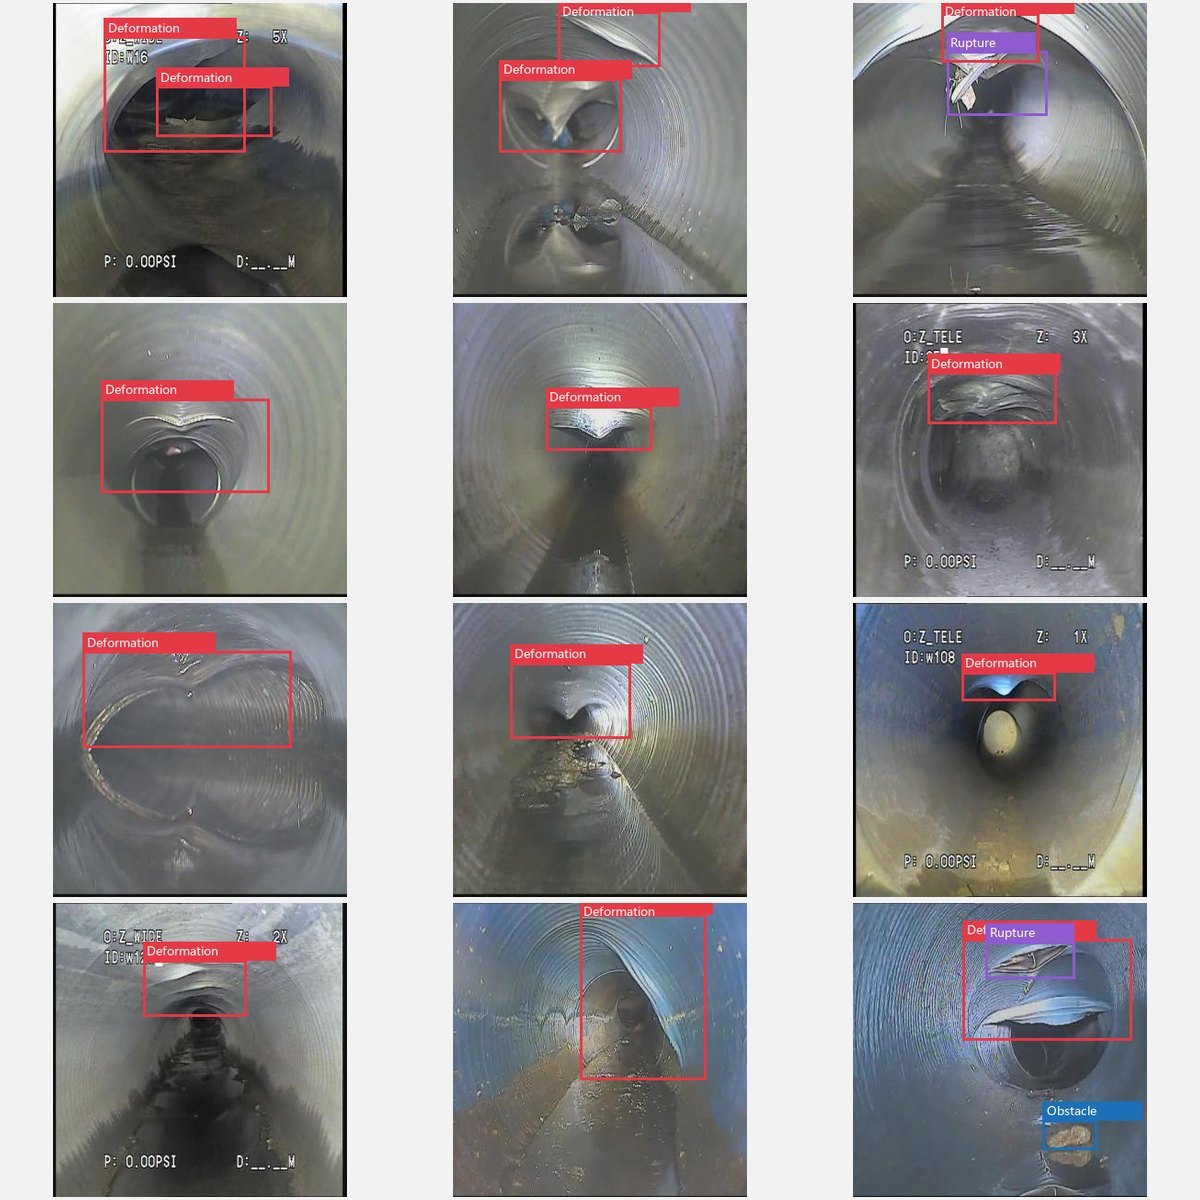
图 03 · YOLO 标注效果展示(二)· 不同场景样本
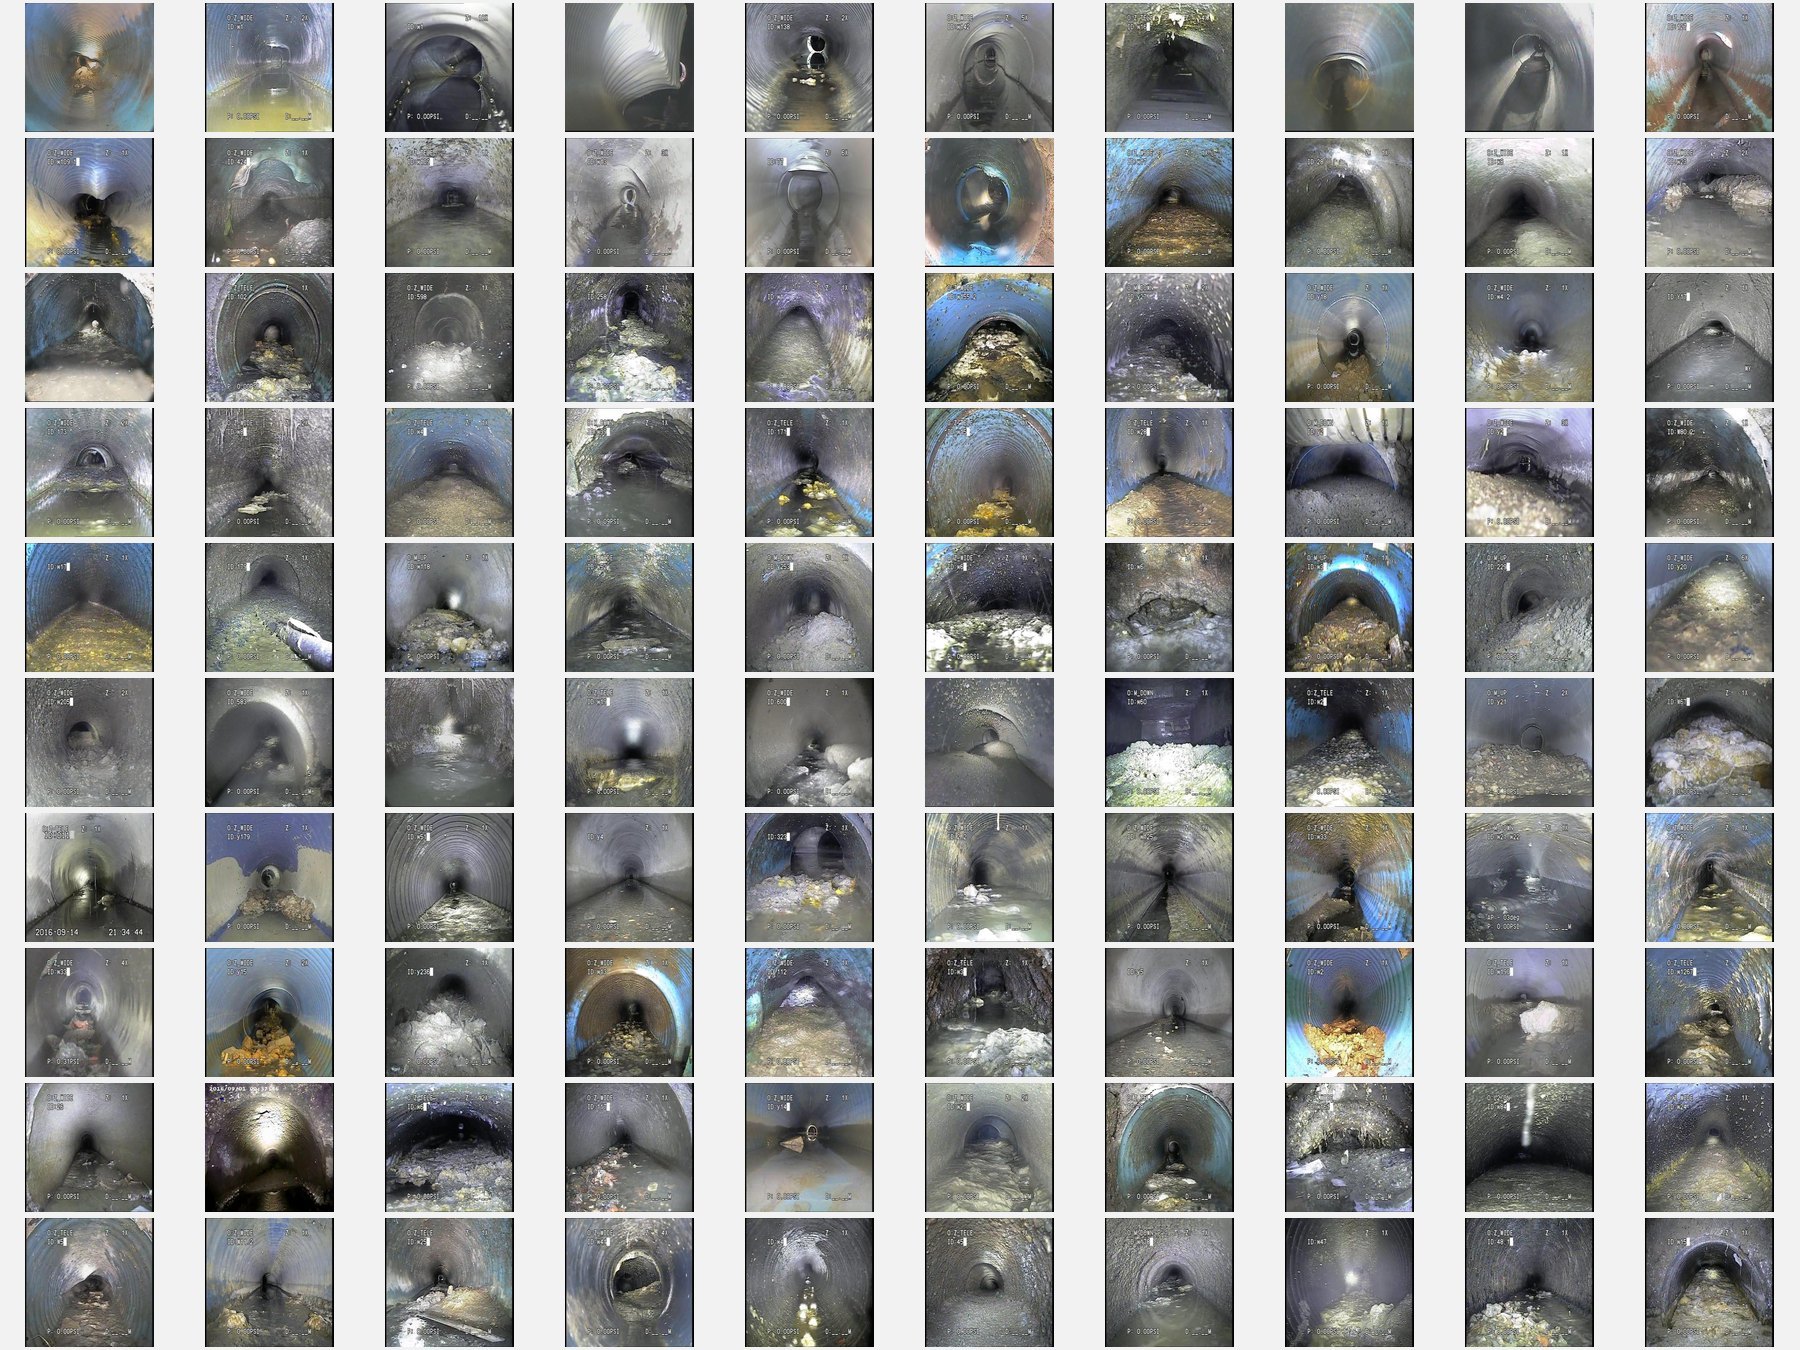
图 04 · 样本总览(第 101–200 张)
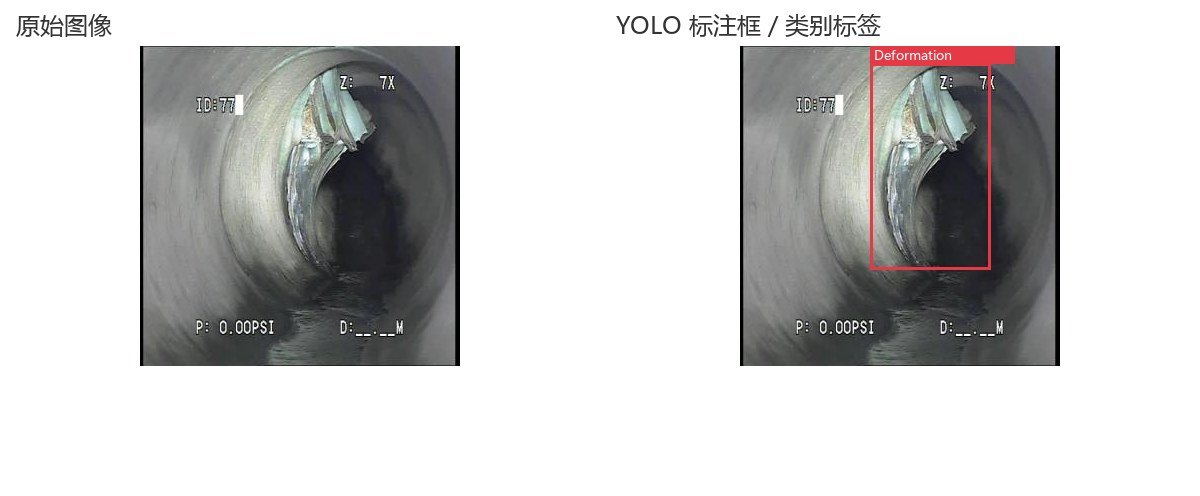
图 05 · 标注细节对比 · 左原始图像 / 右标注结果
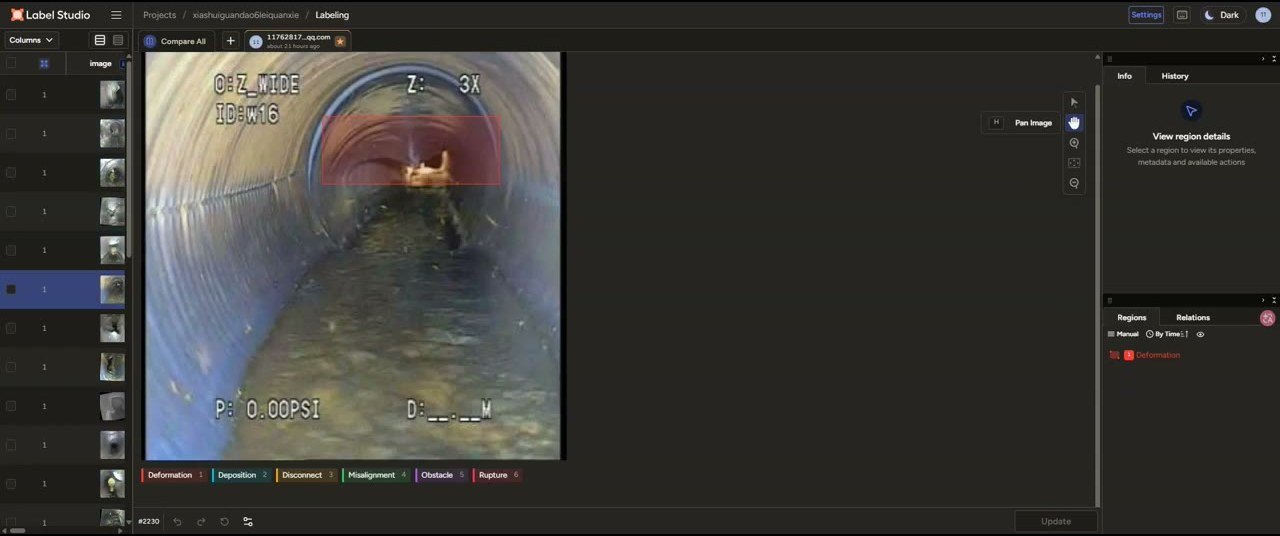
图 06 · Label Studio 标注工作台 · 任务列表与标注画布
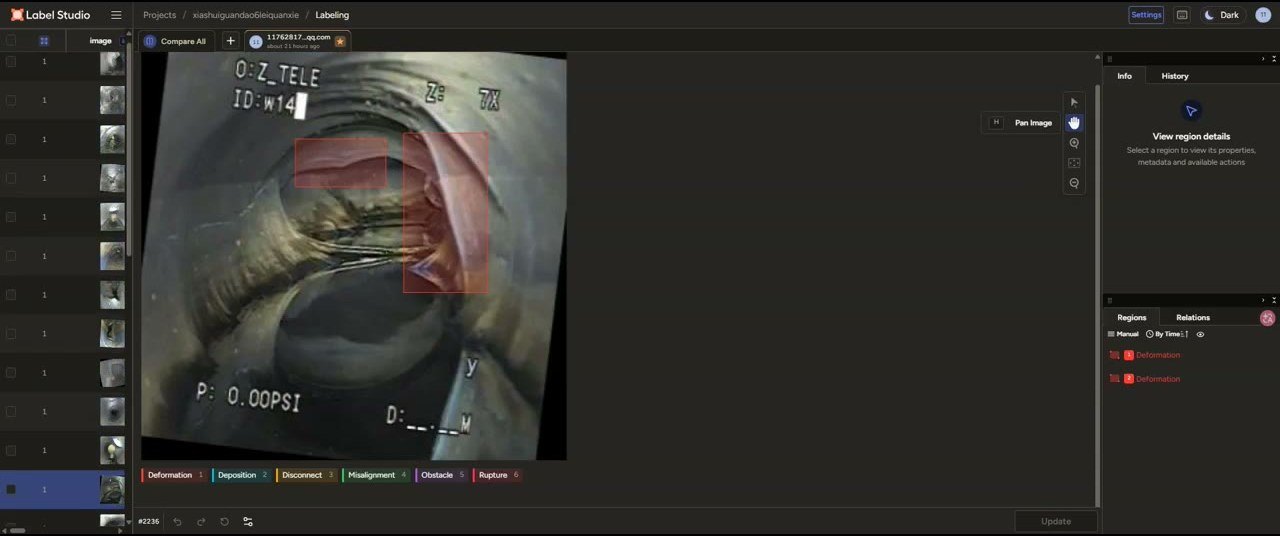
图 07 · Label Studio 标注工作台 · 检测框与类别标注
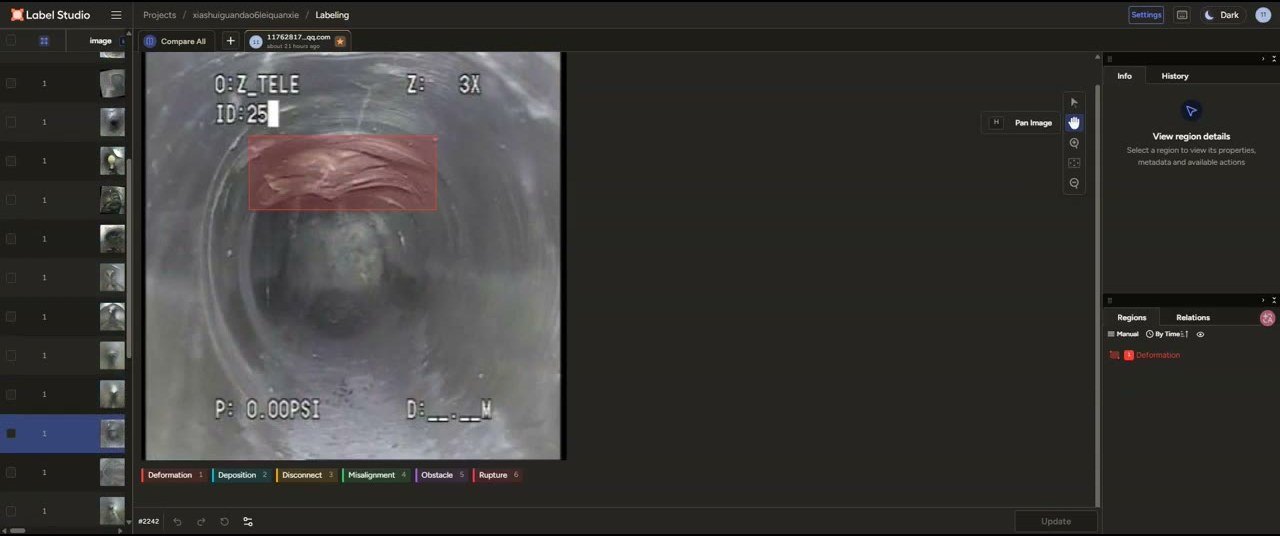
图 08 · Label Studio 标注工作台 · 标注区域与质检面板
附:配套数据资源
本文为工程实践记录,用于说明数据集组织、标注与训练流程,不涉及商业推广。下列入口仅用于复现文中实验。
本文不含商品定价、交易入口与联系方式,实验数据请按数据集说明合理使用。
- 资源入口(百度网盘,纯文本):https://pan.baidu.com/netdisk/share?surl=eV_NnxoTWk8tq1JKwVMw3A&pwd=cltv
- 提取码:cltv
请按数据集说明合理使用。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号