从数据到告警:基于 YOLO11 的睡岗检测工程化落地实践
原创
从数据到告警:基于 YOLO11 的睡岗检测工程化落地实践
原创
用户8779533
发布于 2026-11-21 20:45:06
发布于 2026-11-21 20:45:06
在工厂车间、值班室、监控中心和仓储安防等场景中,岗位纪律检查长期依赖人工巡查与录像回看。这类方式存在两个突出问题:一是抽查覆盖率低,夜间和凌晨时段尤其容易漏检;二是事后追溯成本高,等到发现问题时往往已经产生安全风险。将目标检测模型引入监控链路,把"人看画面"变成"模型筛画面、人做复核",是当前较为务实的技术路径。
本文围绕一套基于 YOLO11 的睡岗检测训练系统,梳理从视频抽帧、对象存储管理、标注、训练、推理到上线前验证的完整工程闭环,并给出可复用的配置示例与风险提示。文中不涉及具体精度指标与商业落地结论,重点在于流程设计与工程细节。
一、行业需求与问题拆解
睡岗检测的本质是"人员在岗状态"的视觉判定问题,但直接把它当作一个二分类问题处理并不合适。工程上需要拆成三层:
- 目标层:先在画面中稳定检出人员目标,得到可靠的人体框;
- 状态层:基于人体框区域判断是否存在睡岗姿态(如伏案、仰靠、长时间静止等);
- 业务层:结合时间窗口、区域规则和告警策略,把单帧判定升级为可复核的事件。
YOLO11 在目标层承担核心角色。相比早期检测模型,YOLO11 在网络结构和训练策略上做了持续优化,对小目标和遮挡场景的鲁棒性更好,同时保持了较好的推理速度,适合部署在边缘设备或与视频流服务同机运行。对于值班室这类画面中人员占比不大、背景干扰较多的场景,检测框的稳定性直接决定了后续状态判定的上限。
二、数据集说明(来源:数据集说明表)
本系统使用的数据集为 YOLO 格式的睡岗检测数据集,项目名称为 shuigangjiance,属于第一批整理素材。数据集的核心客观信息如下:
- 标注类别:
sleep,即单一类别的人员睡岗状态标注; - 图片规模:100 张代表性图片,对应 Label Studio 任务数量 100;
- 数据组织:素材来自
label_studio_import/oss_selected_100目录,包含已挑选图片、Label Studio 导入 JSON、标注界面配置,以及由这些图片生成的轮播预览视频; - 视频素材:
100张图片视频.mp4,由 100 张图片合成,可用于数据集预览与流程演示; - 格式:标注结果可直接导出为 YOLO 训练所需的标签格式,便于接入 YOLO11 训练流程。
从规模上看,100 张图片属于小样本演示级数据集,适合验证标注规范、训练链路和推理接口是否打通,而不适合直接作为生产模型的唯一数据来源。实际工程中建议以此为基础扩展采集,覆盖不同光照、不同摄像头角度和不同岗位姿态。
三、样本特征分析与采集建议
结合数据集描述中的业务场景,睡岗检测样本具有以下几个典型特征,采集和标注时需要重点关注:
1. 画面来源以固定机位监控为主。 摄像头位置固定、视角俯视或斜视,人员通常位于画面中下部。这类样本的背景相对稳定,但也意味着模型容易学到"背景捷径",换一个机位后性能可能下降。建议采集时保留多机位、多分辨率素材。
2. 人员尺度差异明显。 值班室近景机位下人体框较大,仓储或车间远景机位下人体框可能只占画面很小比例。训练时应关注输入分辨率与增强策略,避免小目标被过度下采样。
3. 姿态类别内部差异大。 "睡岗"可能表现为伏案、仰靠、侧趴等多种形态,单一类别标注需要明确判定边界,否则标注一致性难以保证。建议在标注规范中写清"什么算 sleep、什么算正常在岗",并对边界样本做二次复核。
4. 负样本同样重要。 正常坐姿、低头看手机、短暂弯腰取物等画面容易被误判,采集时应主动纳入这些易混淆样本,降低误报率。
5. 时间维度信息有价值。 单帧图像难以区分"闭眼休息"和"低头记录",但连续多帧的静止时长可以显著提升判定可靠性。工程上建议在推理侧引入帧间缓存。
四、训练与推理链路设计
4.1 数据采集与对象存储
视频抽帧后,建议统一上传至对象存储(如 COS)进行集中管理,按"批次/场景/日期"划分前缀,例如:
dataset/shuigangjiance/batch01/frames/
dataset/shuigangjiance/batch01/labels/
dataset/shuigangjiance/batch01/meta/
对象存储的好处在于:标注平台可直接通过 URL 拉取图片,训练节点可并行下载,版本回溯也有据可查。抽帧脚本建议保留原始视频名与帧号映射,便于后续问题样本回溯。
4.2 标注流程
标注采用 Label Studio 完成,类别体系保持单一 sleep 类别,标注框覆盖完整人体区域。导入 JSON 与界面配置随数据集一并提供,可直接复用。标注完成后导出 YOLO 格式标签,目录结构遵循标准约定:
images/train/
images/val/
labels/train/
labels/val/
小样本条件下建议按 8:2 划分训练集与验证集,并保证同一视频抽出的帧尽量不跨集合,避免数据泄漏导致验证结果虚高。
4.3 YOLO11 训练配置示例
以下为一份可直接参考的训练配置(data.yaml 与训练脚本),参数需根据实际硬件与数据规模调整:
# data.yaml
path: /data/shuigangjiance
train: images/train
val: images/val
names:
0: sleepfrom ultralytics import YOLO
model = YOLO("yolo11n.pt") # 可选 n/s/m 等不同规模
results = model.train(
data="data.yaml",
epochs=100,
imgsz=640,
batch=16,
device=0,
workers=4,
patience=30,
project="runs/shuigang",
name="exp01",
pretrained=True,
augment=True,
cache=False,
)几点工程建议:
- 小样本优先使用预训练权重,从头训练在 100 张量级下很难收敛到可用状态;
- 开启适度增强(马赛克、随机缩放、色彩扰动),但避免过度裁剪导致人体框被截断;
- 验证集指标只作参考,最终以业务场景下的漏检/误报统计为准;
- 保存最佳权重与最后权重,便于对比过拟合情况。
4.4 推理与复核链路
推理侧建议采用"检测 + 规则 + 复核"三段式:
- YOLO11 对抽帧图像或视频流做人员检测,输出
sleep类别框与置信度; - 规则层对连续帧结果做时间窗口聚合,例如"连续 N 秒检出且静止"才触发候选事件;
- 复核层将候选事件截图、时间戳、摄像头编号推送到人工复核界面,由值班人员确认或驳回。
这一设计把模型的单帧不确定性交给规则和时间维度消化,同时保留人工兜底,符合安防类应用的合规要求。
五、上线前验证要点
在接入真实监控链路前,建议完成以下验证:
- 离线验证:在独立于训练集的留出集上统计漏检与误报,重点关注夜间低照度、逆光、遮挡等困难样本;
- 跨机位验证:用未参与训练的摄像头画面测试,检验模型是否过拟合特定背景;
- 时序验证:对完整录像做逐帧推理,观察告警是否抖动、是否存在短时误触发;
- 性能验证:在目标硬件上测量单帧推理耗时与显存占用,确认满足实时或准实时要求;
- 接口验证:检查检测结果、截图和元数据能否正确写入下游告警系统。
验证阶段不建议只看单一指标,漏检和误报在业务上的代价并不对称,需要结合岗位重要性设定不同阈值。
六、风险与优化方向
1. 小样本泛化风险。 100 张图片难以覆盖真实场景分布,建议持续扩充数据,优先补充误报样本和困难样本,形成"上线—回流—再训练"的闭环。
2. 隐私与合规风险。 涉及人员画面的采集、存储与告警需遵循相关管理规定,建议对截图做脱敏处理,并限制访问权限。
3. 类别定义模糊风险。 单一 sleep 类别在边界样本上容易产生标注分歧,可考虑在标注规范中增加"疑似"辅助标记,用于后续分析而非直接训练。
4. 模型漂移风险。 摄像头移位、光照变化、工位调整都会导致分布偏移,建议定期抽样复核模型输出,必要时触发再训练。
5. 规则参数调优。 时间窗口、置信度阈值、静止判定阈值需要结合现场节奏调整,建议做成可配置项而非硬编码。
6. 推理资源优化。 多路视频并发时,可采用抽帧推理、模型量化、批处理等方式控制算力成本。
总结
基于 YOLO11 的睡岗检测系统,技术难点并不只在模型本身,而在于把数据采集、对象存储、标注、训练、推理和人工复核串成一条可维护的链路。本文给出的流程以 100 张演示级数据集为起点,重点说明了样本特征、训练配置和上线前验证的关注点。实际工程中,建议把数据回流和规则调优作为长期工作,持续补充困难样本、校准判定阈值,才能在真实监控场景下获得稳定可用的检测效果。
附:样本与标注图集
以下图片均取自该数据集真实样本、YOLO 标注效果图与 Label Studio 标注工作台界面,用于对照上文的数据组织与标注流程说明。
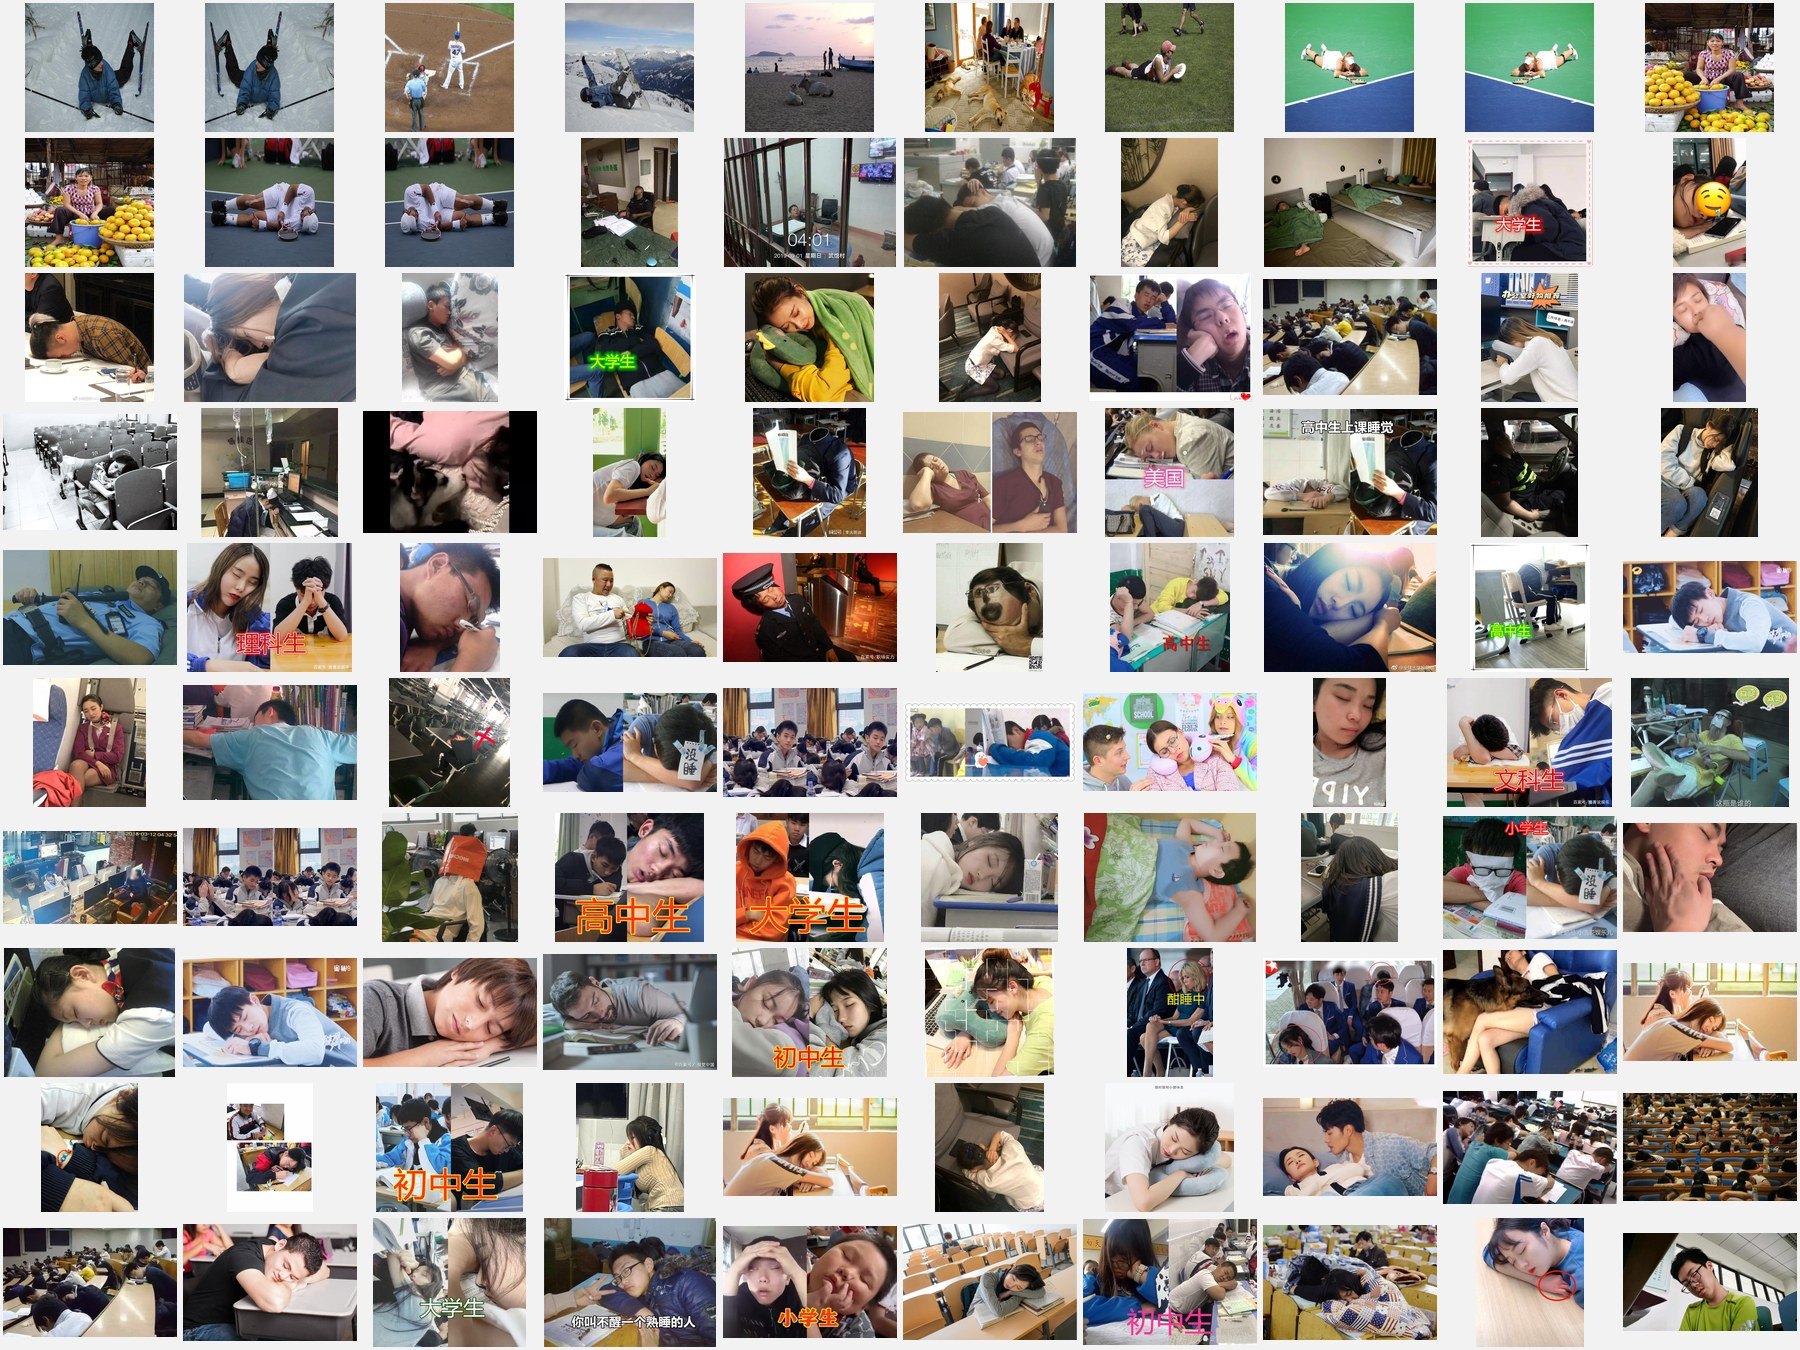
图 01 · 前 100 张样本总览(真实数据压缩包内抽取)
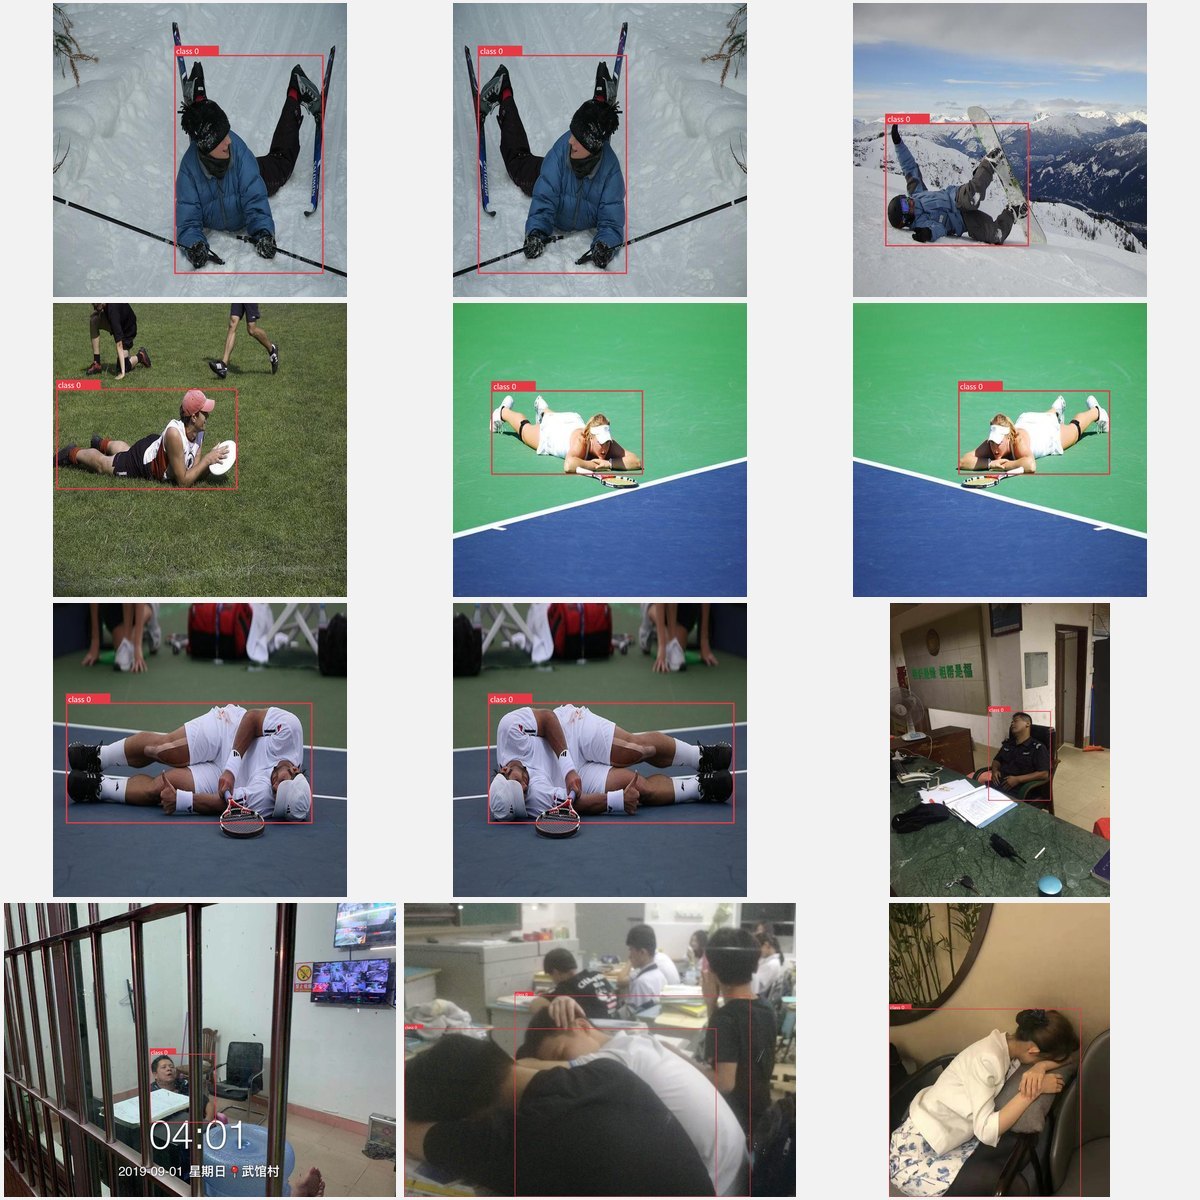
图 02 · YOLO 标注效果展示(一)· 检测框 + 类别标签
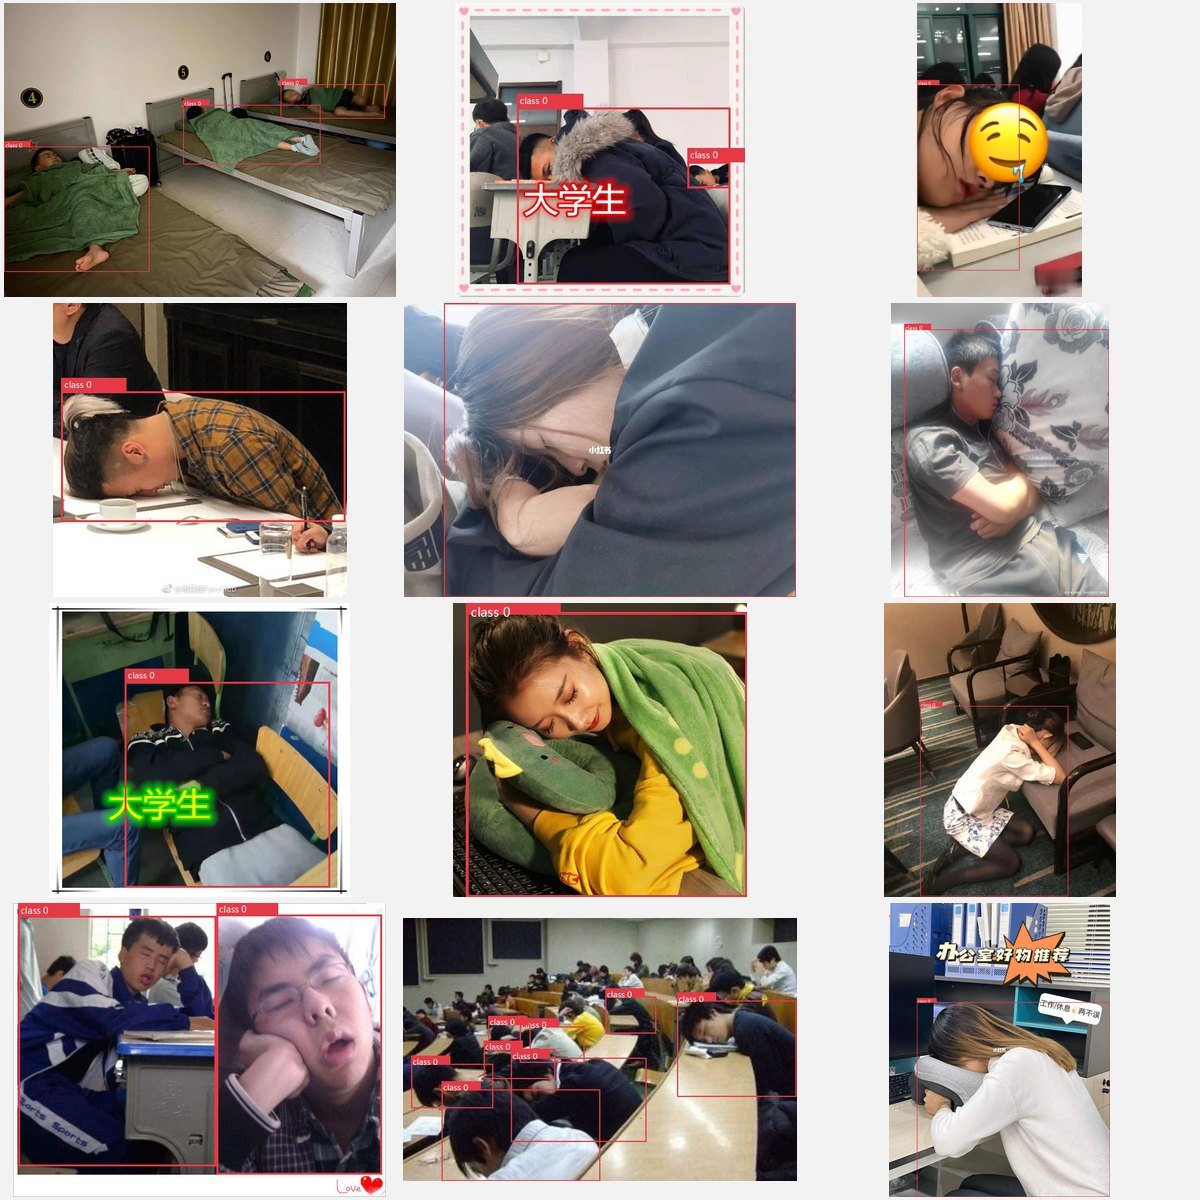
图 03 · YOLO 标注效果展示(二)· 不同场景样本
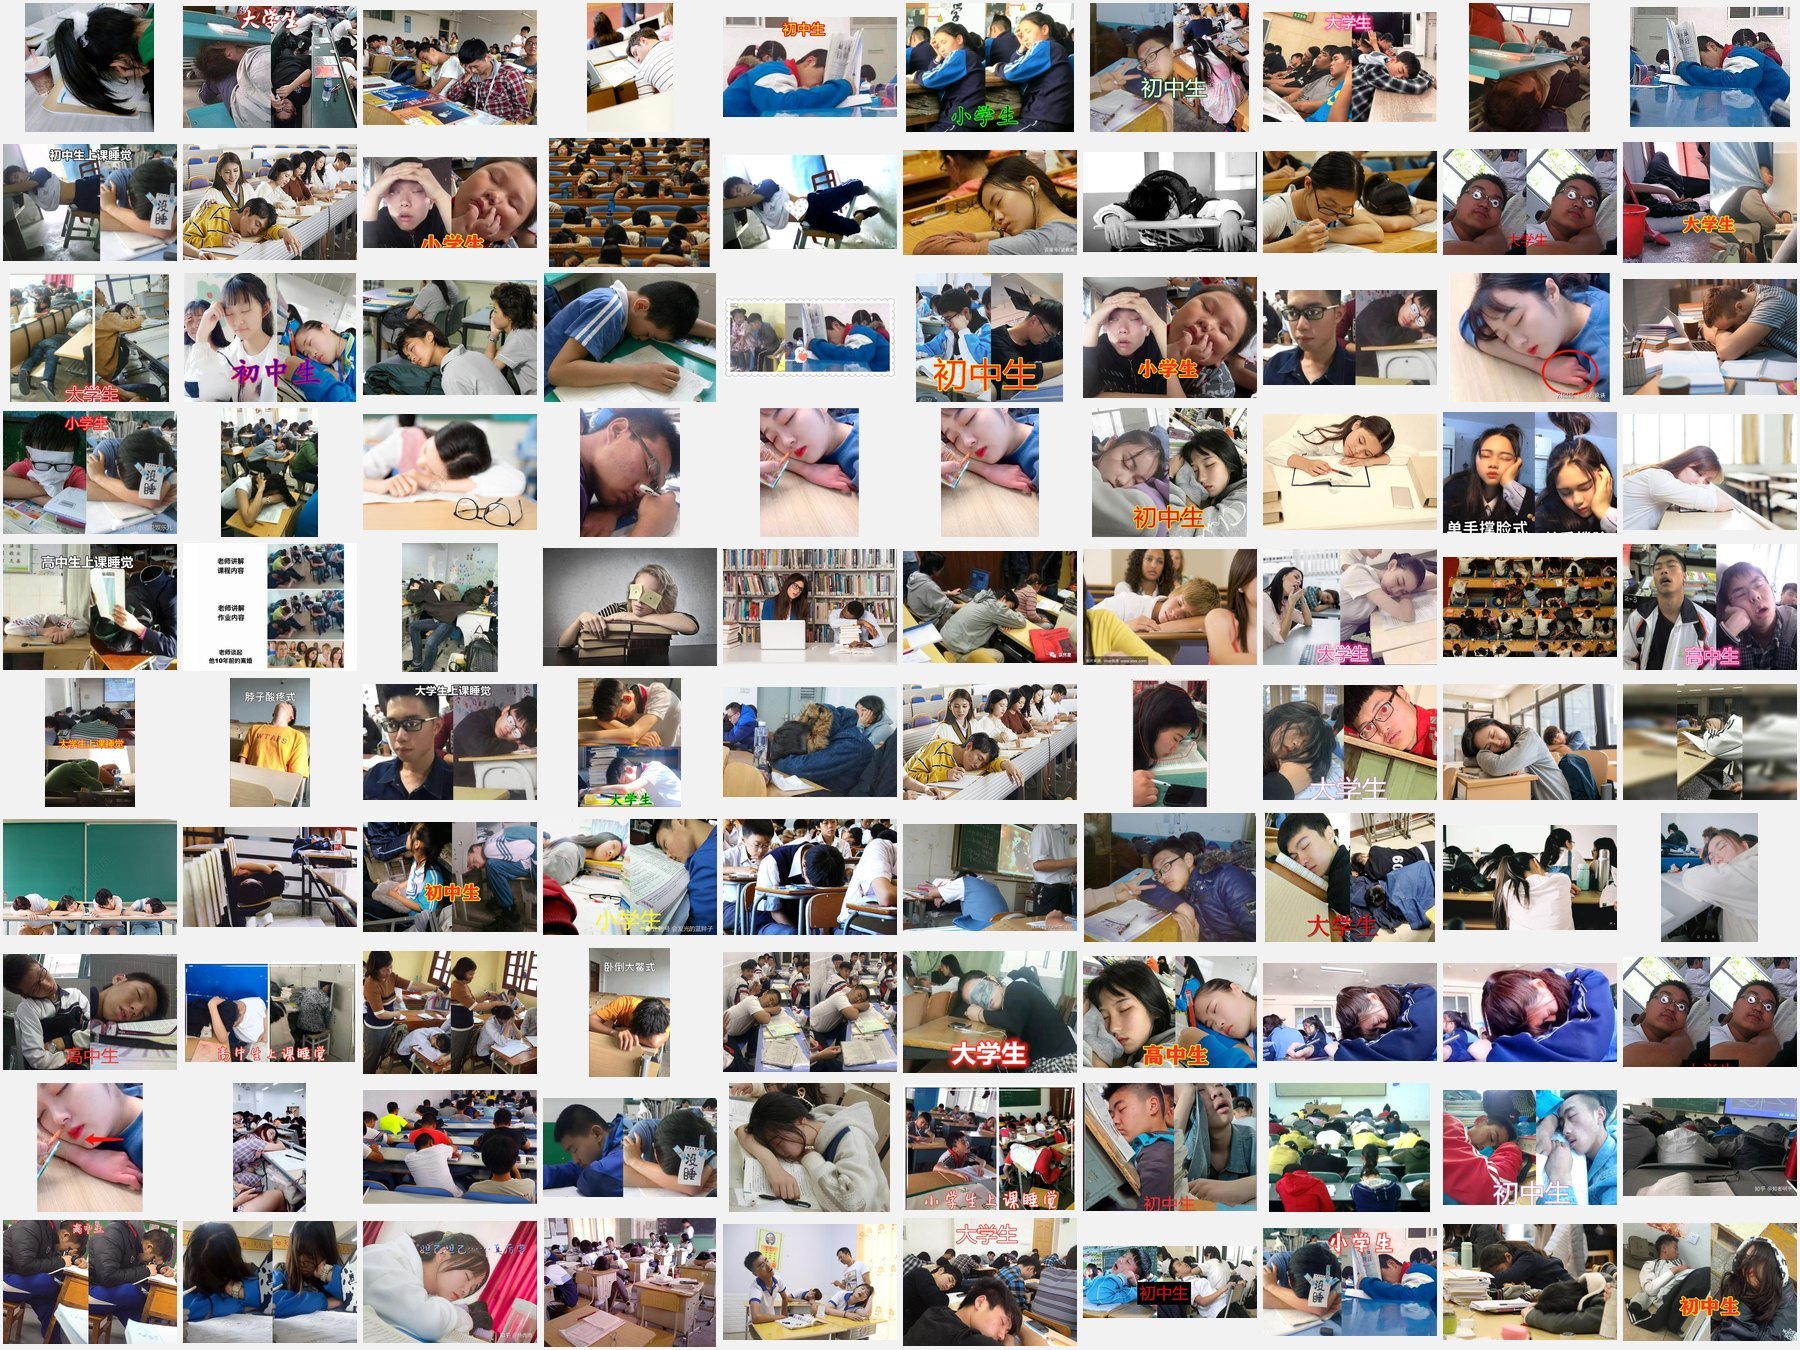
图 04 · 样本总览(第 101–200 张)
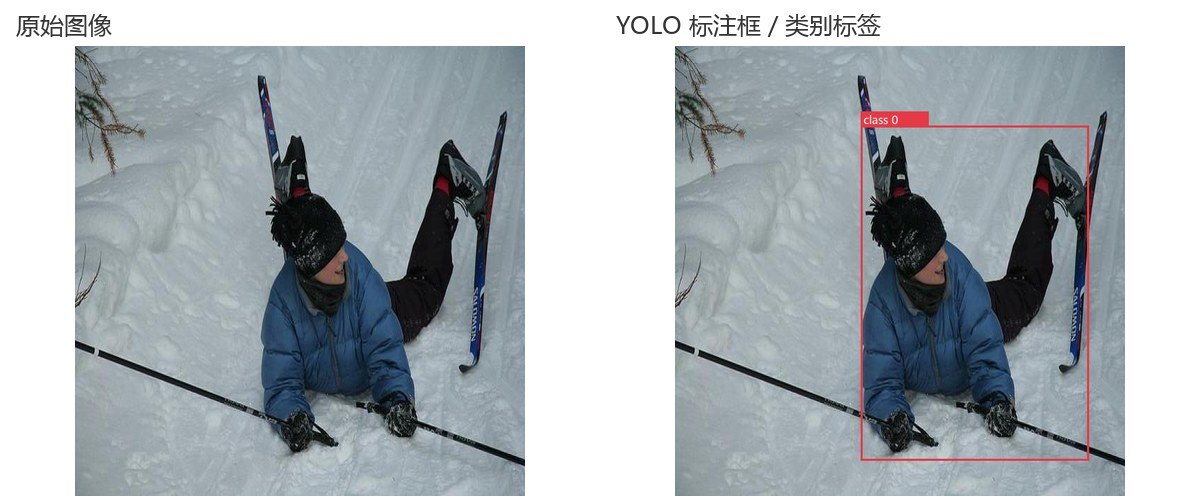
图 05 · 标注细节对比 · 左原始图像 / 右标注结果
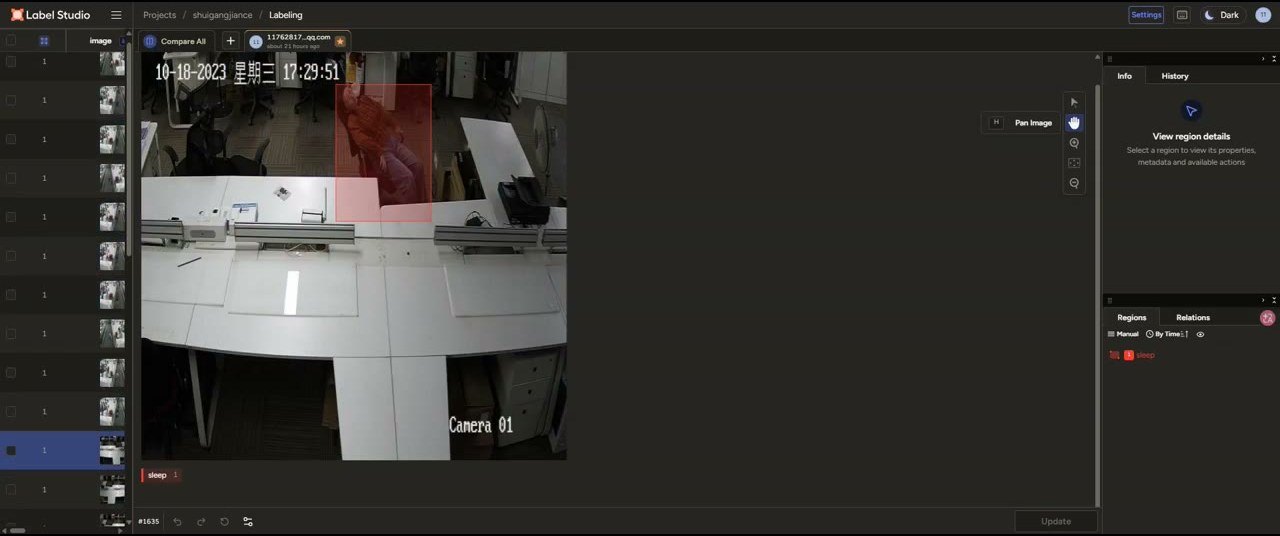
图 06 · Label Studio 标注工作台 · 任务列表与标注画布
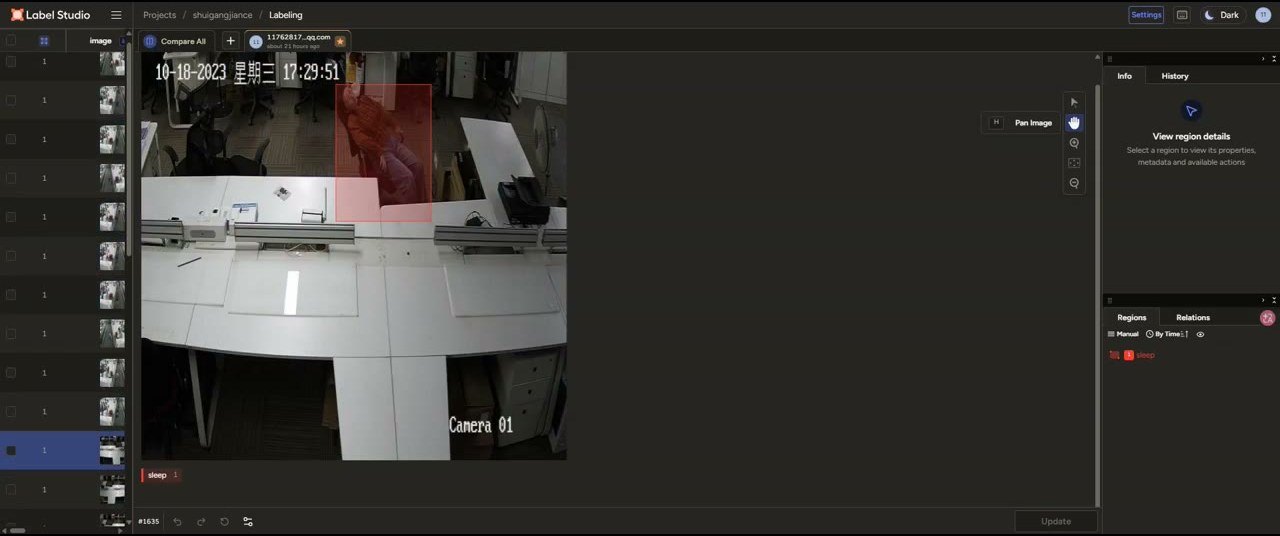
图 07 · Label Studio 标注工作台 · 检测框与类别标注
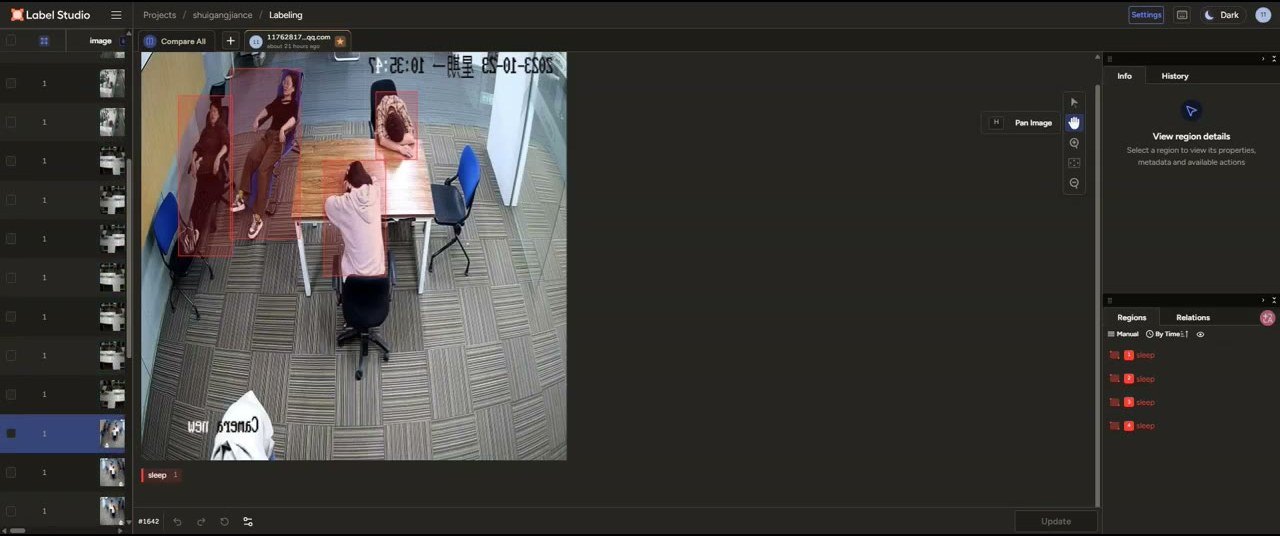
图 08 · Label Studio 标注工作台 · 标注区域与质检面板
附:配套数据资源
本文为工程实践记录,用于说明数据集组织、标注与训练流程,不涉及商业推广。下列入口仅用于复现文中实验。
本文不含商品定价、交易入口与联系方式,实验数据请按数据集说明合理使用。
- 资源入口(百度网盘,纯文本):https://pan.baidu.com/s/1DPFjg9Ji-kvWHWUlAP0g-g?pwd=GBb4
- 提取码:GBb4
请按数据集说明合理使用。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号