开源性能分析上云,Pinterest 和英特尔到底改的是哪一层
原创
开源性能分析上云,Pinterest 和英特尔到底改的是哪一层
原创
Lethehong
发布于 2026-11-22 12:57:49
发布于 2026-11-22 12:57:49
先把这件事的性质说清楚
2026 年 11 月 22 日,InfoQ 中文报道了 Pinterest 联合英特尔把开源性能分析推向互联网级规模这件事。公开信息到这一步为止,只有一句标题和方向,没有架构图,没有版本号,没有改造前后的数据对比。
所以这篇不是复述新闻。我要做的是把「互联网级规模」这五个字拆开,看它到底压在性能分析链路的哪一段上,以及这一段为什么是过去十年里最难动的地方。
先给结论。性能分析从单机走向集群,瓶颈几乎从来不在采样频率,也不在火焰图的渲染。真正的成本集中在三处,采样数据的聚合、符号表的解析、以及跨主机的数据归并。这三处任何一处没换掉,规模一上去就会塌。
Pinterest 和英特尔这次联合,从公开的表述看,动的是开源工具链而不是自研黑盒。这一点值得单独说,因为它决定了你我能从中拿走什么。如果是一家公司自研的闭源 profiler 做到这个规模,对读者来说只有羡慕的份。开源工具链被改造,意味着改造思路和补丁迟早会流出来。
但我得先把话说在前面。公开信息没有披露他们具体改了哪几个组件,我下面所有的拆解,都是基于同类系统在互联网规模下的通用规律做的推断,不是对他们实现方案的描述。这一点我会在每个关键判断上标清楚。
单机 profiler 为什么一上集群就废
你在一台机器上跑 perf 或者 py-spy,体验是顺的。采样、落盘、生成火焰图,几百 MB 的数据,本地几分钟就完事。
换成一千台机器,同样的操作会变成灾难。不是慢一点,是量级上的失控。一台机器每分钟产生几十 MB 原始采样,一千台就是几十 GB 每分钟。这些数据如果原样汇聚到中心节点,网络先撑不住,然后是存储,最后是解析。
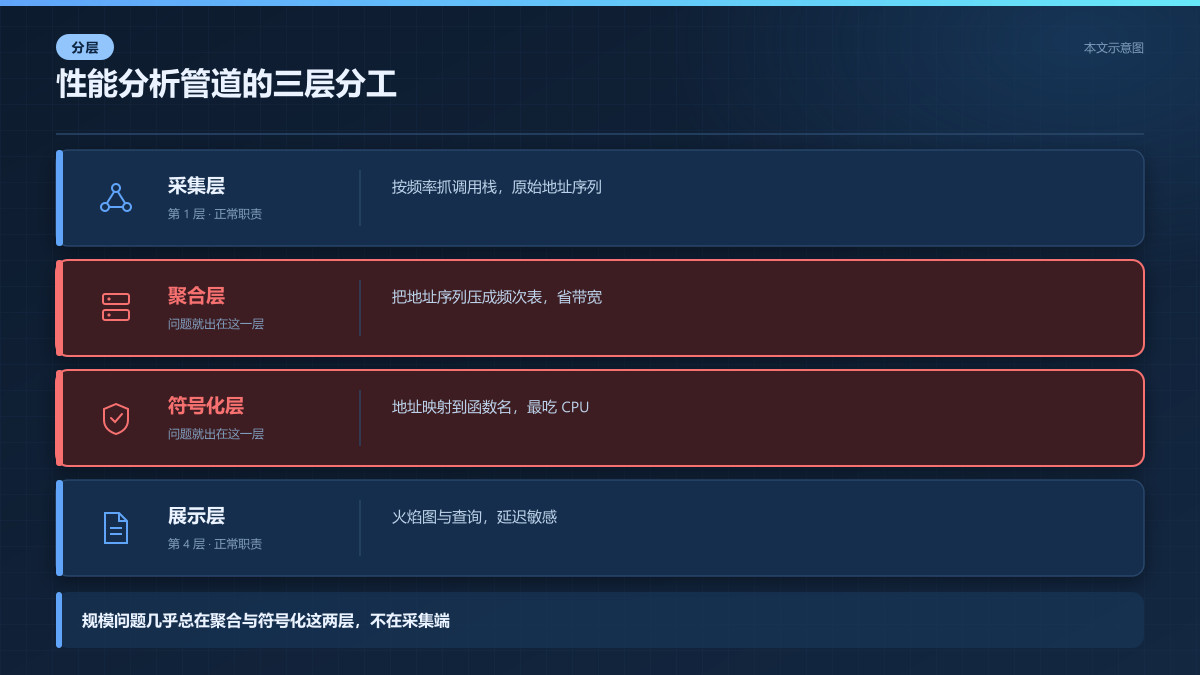
图 1 本文示意图:采样、聚合、符号化三层各自承担什么,规模问题通常出在层与层之间的边界上
很多人第一反应是加大机器。这条路走不通,原因在于采样数据的形态。原始采样里占大头的是调用栈的地址序列,这些地址本身没有意义,要经过符号化才能变成人能看的函数名。符号化是 CPU 密集的,而且是逐栈进行的。
所以问题不在采集端,在采集端和展示端之间的那段管道。这段管道要做三件事,压缩、聚合、符号化。三件事的先后顺序不同,成本差一个数量级。
这里就是第一个判断。互联网级性能分析的核心设计,不是把采样做得更细,而是把「在哪一层做聚合」这个问题回答对。在采集端聚合,丢细节;在中心聚合,带宽爆掉。正确的做法通常是在中间加一层按主机或按服务聚合的节点,先把地址序列压成频次表,再往上送。
这是我基于同类系统的推断。Pinterest 具体是不是这么分的层,公开信息没说。但如果你要自己搭,这个分层是绕不开的第一道选择题。
我见过太多团队在第一步就选错。他们直接把原始采样往 Kafka 里灌,想着后面再处理,结果三天之后 topic 积压到告警,运维半夜打电话过来问是不是被打了。这不是容量规划没做好,是聚合层的位置从一开始就放错了。
符号化这一步,才是真正的规模杀手
我单独把符号化拎出来说,因为它是被低估最严重的一环。
一个调用栈在符号化之前,长这样,一串十六进制地址。要把它变成 main 调用 handle_request 调用 query_db 这样的可读栈,需要拿着地址去查对应二进制的符号表。符号表可能是 ELF 的 .symtab,可能是 DWARF 调试信息,也可能是 JVM 的映射文件。
单机上这不是问题,符号表就在本地。集群上问题来了,一千台机器可能跑着几十个不同版本的二进制,每个版本有自己的符号表。中心节点要做符号化,就得先把所有版本的符号表都拉过来,然后对每一条采样栈做地址到符号的映射。
这个映射的复杂度是采样条数乘以符号表大小。采样条数在互联网规模下是十亿级,符号表动辄几百 MB。乘起来就是一个不可能在合理时间内完成的计算。
所以真正做过这件事的团队,符号化一定不会放在中心做。常见的做法有两种,一是在采集端用本机符号表做增量符号化,只上传符号化后的栈;二是维护一个地址到符号的全局缓存,命中就跳过。第一种省带宽但吃采集端 CPU,第二种省 CPU 但缓存一致性难做。
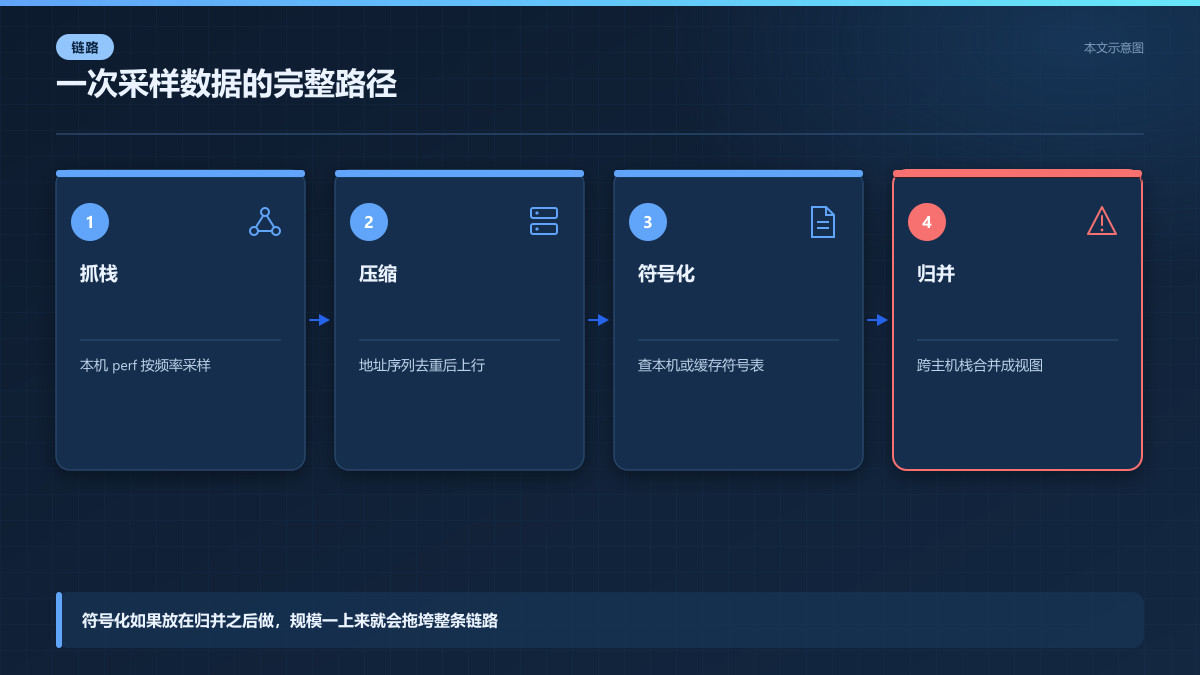
图 2 本文示意图:从主机抓栈到最终火焰图,中间经过哪些环节,哪一步在规模下最先崩
我倾向于认为这次改造在符号化这一层做了文章,理由是英特尔的参与。英特尔在 perf 和符号解析上有长期的积累,他们最清楚符号化在规模下的痛点在哪。这仍然是推断,公开信息没有证实。
还有一个细节容易被忽略。符号表本身也在变。每次发版,二进制变了,符号表跟着变,缓存里的地址映射就失效一批。发版越频繁的团队,这个失效比例越高。互联网公司的发版频率,一天几次是常态,这意味着符号缓存的有效期可能只有几个小时。这一层如果没设计好,缓存命中率会低到没有意义。
你自己动手前,先量这三个数
如果你读到这里想在自己环境里试,我建议先别急着搭。先量三个数,量完你就知道自己该走哪条路。
盘点二进制版本散度(示意代码,统计同一种服务在环境里有多少个不同构建版本,判断符号化成本)
推演采样数据量级(示意代码,用三个输入估算每分钟原始采样体积,判断聚合层是否必须前置)
第一个数,你的采样原始数据每分钟产生多少 MB。第二个数,你环境里同时存在的二进制版本有多少个。第三个数,你的调用栈平均深度是多少。
这三个数决定了你的瓶颈在哪。数据量大但版本少,符号化不是问题,带宽是问题。版本多但数据量小,符号化是问题,带宽还好。栈特别深的,压缩和聚合的收益会被放大。
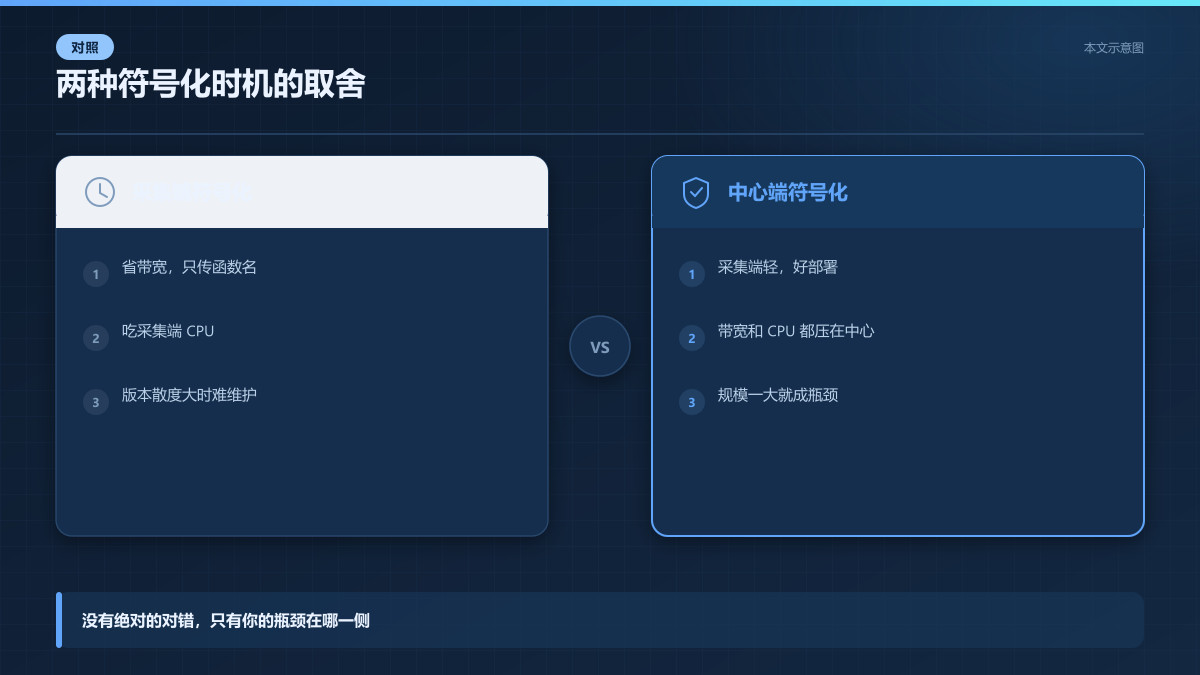
图 3 本文示意图:采集端符号化和中心端符号化各自的代价,决定你的系统能撑到多大规模
下面这段脚本是我自己会先跑的,用来盘点环境里的二进制版本数。它不采集任何性能数据,只是把版本散度摸清楚。
我为什么先量版本数而不是先量数据量。因为数据量你可以靠加机器硬扛一阵,版本散度不行。版本数一多,符号化那一步的成本是指数往上走的,加机器解决不了。先把这一项摸清楚,你才知道自己是不是一开始就站在了错的那条路上。
这两个脚本都只是估算,不是精确测量。真实的采样体积还跟编译器优化、内联深度、语言运行时有关。但量级判断够了,你需要知道的是自己在一百 MB 还是十 GB 这个档位,不是精确到小数点后两位。
过渡方案,做不到全量就先做抽样
不是每个团队都能立刻改造整条管道。如果你今天就想拿到一点集群级的性能视图,有个过渡办法。
在采集端做固定比例的抽样,比如百分之一的主机开启采集,其余关闭。这样你拿到的不是全量视图,但能拿到一个有统计意义的样本。代价是你可能错过只在个别主机上出现的长尾问题。
另一个过渡办法是把符号化推迟到查询时。采集端只存原始地址和二进制指纹,展示的时候按需符号化当前查询涉及的栈。这样存储成本降下来,代价是首次查询会慢。
这两个办法我都用过,都不完美。抽样会漏长尾,延迟符号化会让交互变卡。但在你还没能力改造整条链路之前,它们能让你先看到东西,而不是什么都看不到。
如果非要我选一个先上,我选抽样。原因很实际,抽样的改造成本最低,在采集端加一个开关就行,不需要动存储格式,也不需要改查询链路。延迟符号化要改的地方多得多,采集端要存指纹,查询端要能按需拉符号表,中间还得有个服务把两边对上。先上抽样,等你确认了集群级视图确实有人用,再投入做延迟符号化。
这里有个坑我得提醒。抽样比例不要设成动态的,不要根据负载自动调整。动态抽样会让你的数据在不同时间点之间不可比,今天百分之一明天百分之十,两次采样的火焰图放在一起看就是错的。固定比例,哪怕固定得偏低,也比动态的强。
这次改造最值得学的是取舍,不是技术
抛开具体实现不谈,这件事最值得琢磨的是取舍。
性能分析系统有一个不可能三角,精度、成本、实时性。三者最多取其二。Pinterest 做到互联网级规模,一定在某一个维度上做了让步。公开信息没说是哪一个。
我的判断是,他们让掉的是实时性。互联网级规模下,分钟级的延迟是可以接受的,秒级不是必须的。把实时性让掉,换来的是聚合和符号化的批处理空间,成本能降一个量级。
这个判断如果成立,对读者的启示是,你在设计自己的可观测性系统时,先问清楚业务到底需要多实时。如果业务能接受五分钟的延迟,你就不该为秒级实时付那个钱。
但我也得说清楚,这只是推断。Pinterest 到底让掉了哪个维度,要等他们的技术博客或者演讲出来才能确认。在那之前,任何说「他们就是这么做的」的说法,都超出了公开信息能支撑的范围。
取舍这件事说起来容易,做起来难在跟人解释。你告诉业务方性能数据要延迟五分钟,第一反应一定是问为什么不能实时。你得能说清楚,实时的代价是每月多烧多少机器,而这笔钱换来的那四分多钟,在实际排查里到底有没有用。这个问题答不上来,取舍就落不了地。
我怎么验的,以及哪些只是推演
这一节我得单独交代,因为前面几节的判断分量不一样,混在一起读容易被当成同一等级的事实。
关于「符号化是规模杀手」这个判断,我的依据是通用的复杂度分析,不是对 Pinterest 系统的测量。采样条数乘以符号表大小这个乘法关系,在任何做逐栈符号化的系统里都成立。这一条我有把握。
关于「聚合层应该前置」这个判断,依据是我自己搭过和见过的小规模系统。几百台主机这个量级上,前置聚合的收益是明确的。但一千台以上、跨地域、多租户的情况下,前置聚合会不会带来新的问题,比如聚合节点本身成为单点,我没有验证过。这一条是推断加经验,不是定论。
关于「他们让掉的是实时性」这个判断,纯粹是从不可能三角推出来的。我没有任何内部信息。这一条最弱,你读的时候应该把它当成一个待验证的假设,不是结论。
我能验的部分到此为止。再往下走,需要的是 Pinterest 的实际架构披露,或者我自己有一个千台规模的环境去试。这两样我都没有。
这次没查到什么,比查到什么更值得说
写到这里,我必须把没查到的部分摆出来。
公开信息没有披露他们改造了哪几个开源组件,没有给出改造前后的资源对比,没有说符号化是在哪一层做的,也没有说采样数据在管道里经过了几次压缩。这四个空白,决定了这次改造的可复制性到底有多高。
还有一个更根本的空白,他们到底解决了什么问题。是采样开销太大影响了被监控业务,还是存储成本扛不住,还是查询太慢没人用。不同的起点,对应完全不同的技术路线。
所以我给这篇文章的定位是,它是一次基于公开方向的推理练习,不是一份实施指南。你可以拿它当思考框架,但不能拿它当操作手册。
等后续有更详细的技术材料出来,我会回来修正这里的判断。在那之前,我对自己的结论保持保留。
如果你手上有千台规模的可观测性环境,欢迎拿我上面那三个数去量一遍,把你量到的结果跟我的推演对一下。对不上的地方,大概率是我错了,不是数据错了。
写在最后
性能分析这件事,难向来的不是把数据采上来,是采上来之后你打算在哪一层把它变小。Pinterest 这次改造真正值得抄的,是他们敢在某个维度上做让步。你如果也在搭可观测性,先想清楚自己能接受多大的延迟,再决定在哪儿切那一刀。
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号