基于 YOLO11 的仪表读数检测工程闭环:从视频抽帧、对象存储到训练与复核
原创
基于 YOLO11 的仪表读数检测工程闭环:从视频抽帧、对象存储到训练与复核
原创
用户8779533
发布于 2026-11-22 18:31:57
发布于 2026-11-22 18:31:57
工业现场的设备巡检正在从“人工抄表 + 纸质记录”向“视觉识别 + 结构化回传”演进。仪表读数是其中最具代表性的任务之一:它既要求模型能稳定定位表盘上的单个数字,又要求整条链路能把分散的图片、标注、权重和推理结果管理起来,形成可追溯的工程闭环。本文以一套面向工业仪表、能源计量与设备巡检场景的读数检测数据集为例,讨论如何围绕 YOLO11 搭建从数据采集、对象存储、标注、训练到推理复核的完整流程,并给出可直接参考的配置示例与上线前验证清单。
一、行业需求:为什么仪表读数检测需要工程化闭环
仪表读数识别的业务目标很明确:把表盘上的数字序列转换为结构化数值,减少人工抄表的频次与误差。但真正落地时会遇到三类问题。
第一类是数据分散。现场采集的图片往往来自不同批次、不同设备、不同光照条件,如果缺少统一的存储与命名规范,后续标注和训练很难复用。
第二类是标注一致性。仪表读数不是单一目标检测,而是“多数字实例检测 + 顺序还原”。如果标注时数字边界框的松紧程度不统一,模型学到的特征分布就会漂移。
第三类是推理结果需要复核。检测框只能说明“这里有一个数字”,最终读数是否正确还需要按位置排序、拼接和阈值过滤。缺少复核环节,误读会直接进入业务系统。
因此,合理的做法是把整条链路拆成“采集—存储—标注—训练—推理—复核”六个环节,每个环节都有明确的输入输出和校验点。YOLO11 在其中承担数字实例检测的核心角色,前后环节则负责保证数据质量和结果可信度。
二、数据集说明(来源:数据集说明表)
本节信息依据数据集说明表整理,仅保留可验证的客观描述。
- 数据集名称:仪表读数检测数据集。
- 适用场景:工业仪表、能源计量和设备巡检,用于识别仪表数字读数,辅助自动抄表和设备状态采集。
- 标注类别:0、1、2、3、4、5、6、7、8、9,共 10 类,每个类别对应一个数字字符。
- 标注格式:Label Studio 导入格式,配套
label_config.xml标注配置,可导出为目标检测常用的边界框标注。 - 规模信息:数据集说明表标注的整体规模为 6559 张、10 类;本次整理的精标子集包含 100 张图片、100 个 Label Studio 任务,并配有对应的视频素材文件,可用于预览和短视频展示。
- 目录组织:包含
label_studio_import/oss_selected_100导入目录、selected_100_images图片目录、selected_100_annotations_oss.json标注文件,以及视频素材下的预览视频。 - 任务类型:目标检测。模型输出每个数字字符的边界框与类别,再由后处理按位置还原读数。
需要说明的是,10 类数字标签意味着这是一个“字符级检测”任务,而不是整表读数回归任务。字符级检测的好处是类别体系稳定、可解释性强,缺点是后处理逻辑必须与检测结果严格配套。
三、样本特征分析:难点在哪里
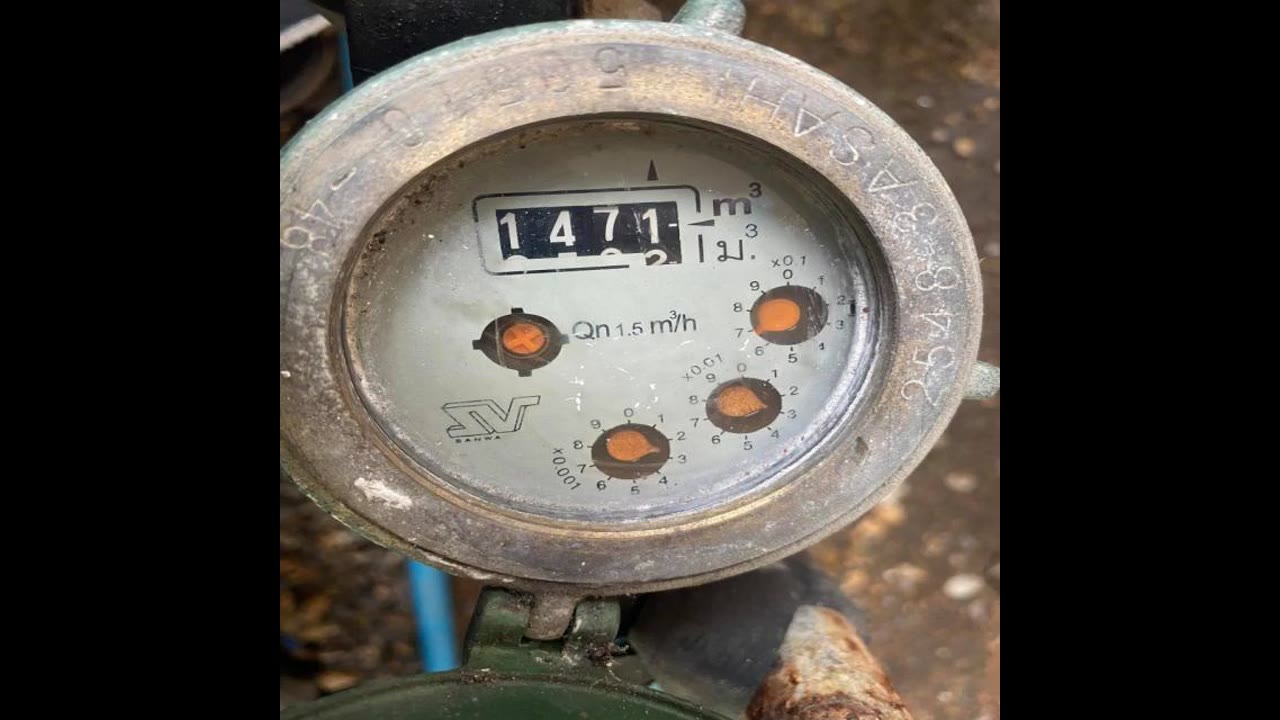
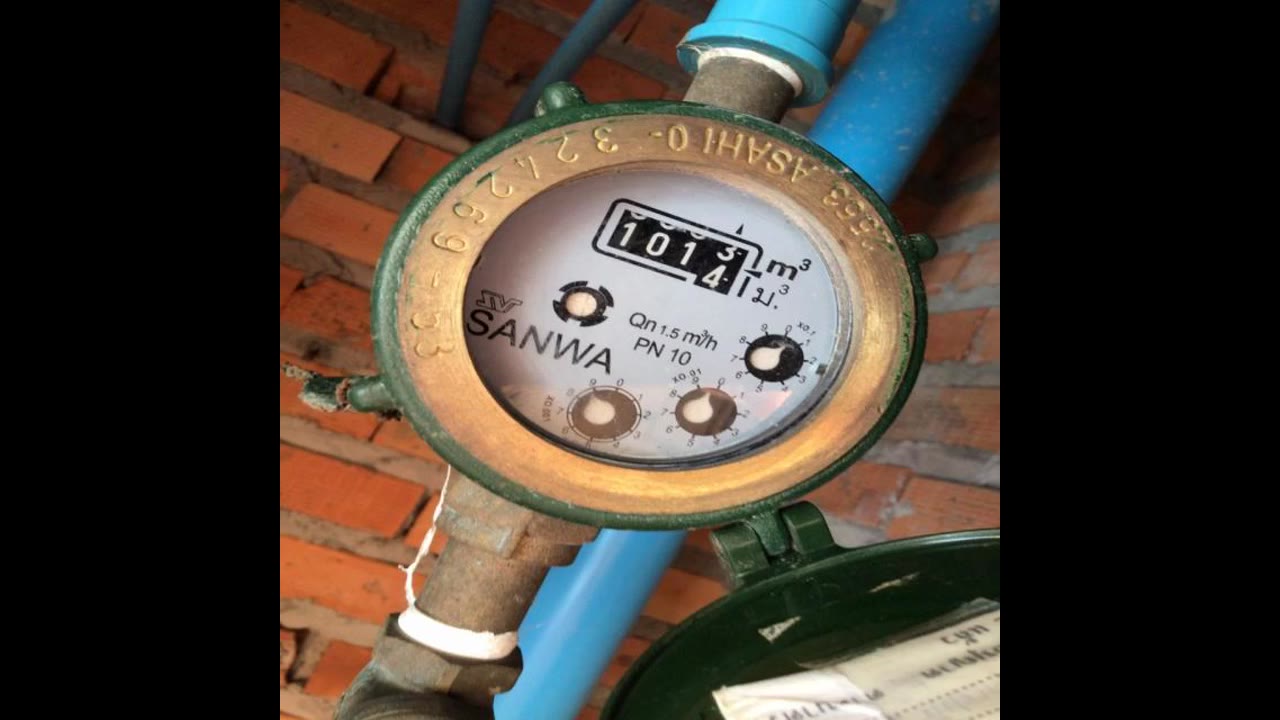
从样本抽帧和标注界面可以看到,仪表读数检测的难点主要集中在以下几个方面。
1. 仪表型号与外观差异大。 不同品牌、不同型号的仪表在字体、字距、背景色、数字窗口形状上都有差异。模型需要在这些外观变化下保持对数字形态的稳定响应,这对训练数据的多样性提出了要求。
2. 光照与成像质量波动明显。 现场存在逆光、局部过曝、反光和低照度等情况,部分样本为黑白或低对比度画面。数字与背景的对比度下降后,边界框容易偏移或漏检。
3. 数字排列方式不统一。 有的仪表是横向排列,有的是纵向滚轮式,还有带小数点的组合。检测阶段只负责定位单个数字,读数还原阶段需要依据坐标排序,因此排序规则要能适配不同排列方向。
4. 长数字序列与相邻数字粘连。 当数字间距较小时,相邻字符的边界框可能重叠,后处理需要设置合理的 IoU 阈值和中心点距离约束,避免把两个数字合并成一个。
5. 类别不平衡。 数字 0 到 9 在真实读数中出现的频率并不均匀,某些数字在样本中偏少,训练时需要通过数据增强或采样策略缓解。
仪表读数检测数据集 原始样本抽帧
仪表读数检测数据集 原始样本抽帧
四、训练与推理链路:以 YOLO11 为核心
4.1 数据采集与对象存储
采集环节建议统一使用“批次 + 项目 + 设备编号”的命名规范,原始图片和抽帧图片分别存放。图片上传到对象存储(如 COS)后,标注文件中的图片路径直接引用 OSS 地址,避免本地路径在多人协作时失效。数据集说明中的 selected_100_annotations_oss.json 就是这种思路的体现:标注 JSON 与 OSS 图片地址绑定,标注工具和训练脚本读取同一份地址,减少路径转换成本。
对于视频素材,建议先按固定间隔抽帧,再人工筛选清晰帧进入标注队列。抽帧的好处是能把一段巡检视频拆成独立样本,同时保留时间戳,便于后续追溯。
4.2 标注流程
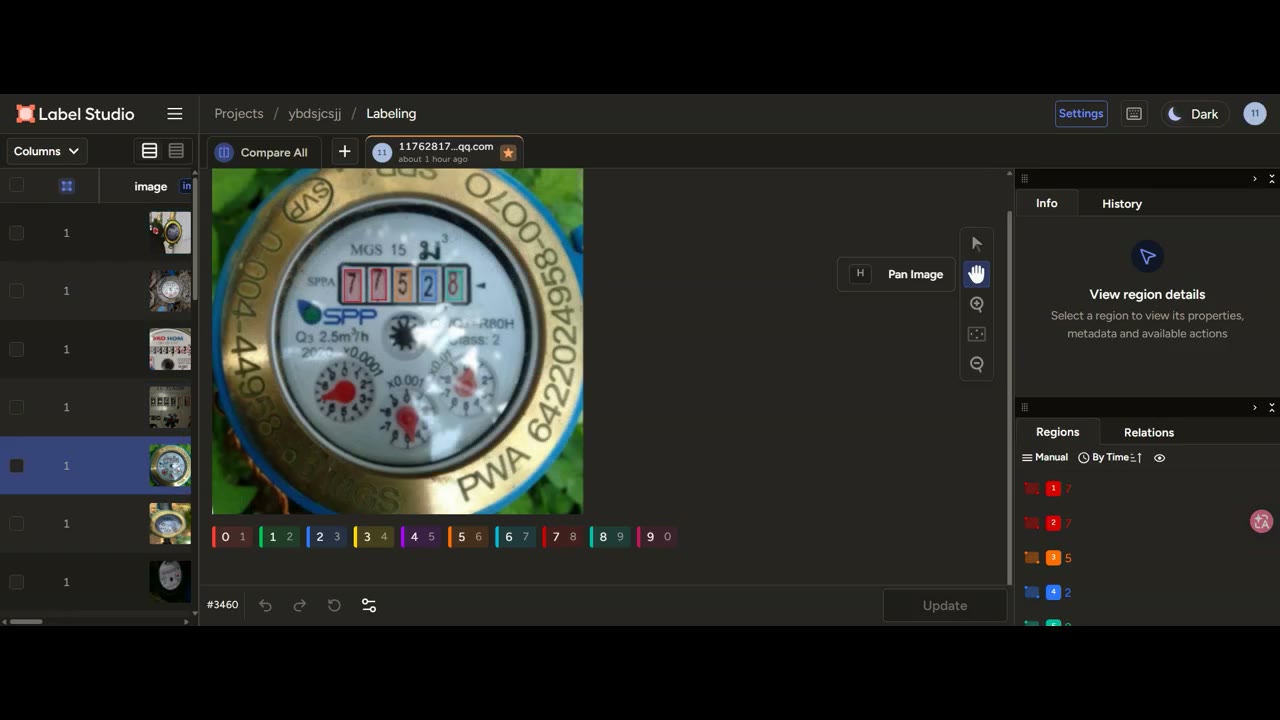
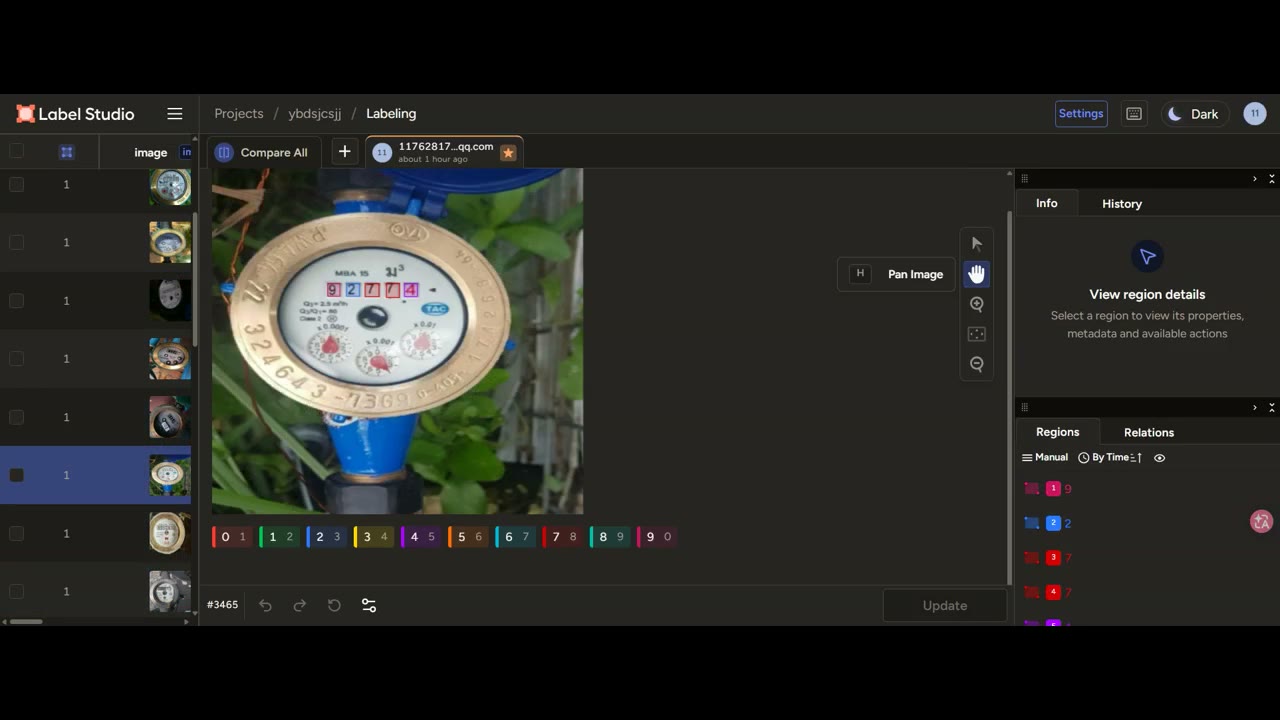
标注使用 Label Studio,类别体系固定为 0 到 9 十个数字标签。标注时需要注意三点:边界框尽量贴合数字笔画外沿但不过度外扩;相邻数字的框不要相互覆盖;对模糊到无法辨认的数字,宁可跳过也不要凭猜测标注。标注完成后导出 JSON,再转换为 YOLO11 训练所需的标签格式。
仪表读数检测数据集 标注界面示例
仪表读数检测数据集 标注界面示例
4.3 YOLO11 训练配置示例
YOLO11 的训练入口与数据配置遵循 Ultralytics 的通用约定。下面给出一个可直接参考的 data.yaml 与训练脚本示例,参数需根据实际显存和数据规模调整。
# data.yaml
path: /data/meter_digits
train: images/train
val: images/val
test: images/test

names:
  0: "0"
  1: "1"
  2: "2"
  3: "3"
  4: "4"
  5: "5"
  6: "6"
  7: "7"
  8: "8"
9: "9"from ultralytics import YOLO
model = YOLO("yolo11n.pt")
results = model.train(
data="data.yaml",
epochs=100,
imgsz=640,
batch=16,
device=0,
workers=4,
project="runs/meter_digits",
name="yolo11n_baseline",
pretrained=True,
optimizer="auto",
patience=20,
hsv_h=0.015,
hsv_s=0.5,
hsv_v=0.4,
degrees=3.0,
translate=0.1,
scale=0.4,
fliplr=0.0, # 数字翻转会改变语义,建议关闭水平翻转
mosaic=0.8,
)这里有两个与数字识别相关的细节值得注意。其一,fliplr 建议设为 0,因为水平翻转会把数字变成镜像字符,破坏类别语义。其二,degrees 可以保留小幅旋转增强,用于模拟拍摄角度偏差,但不宜过大,否则数字形态失真。
训练过程中建议同时记录损失曲线、mAP 指标和验证集可视化结果。若验证集上出现“框位置正确但类别混淆”的情况,优先检查标注类别是否一致,而不是盲目增加训练轮数。
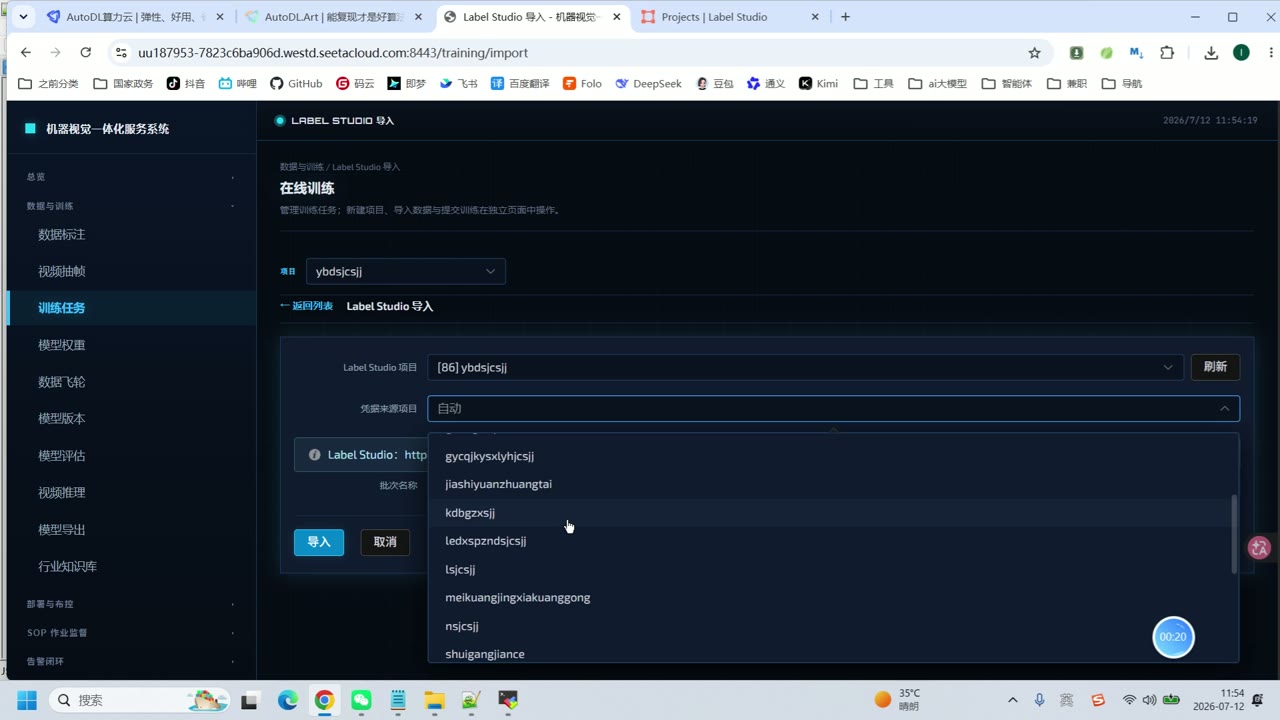
仪表读数检测数据集 模型训练操作界面
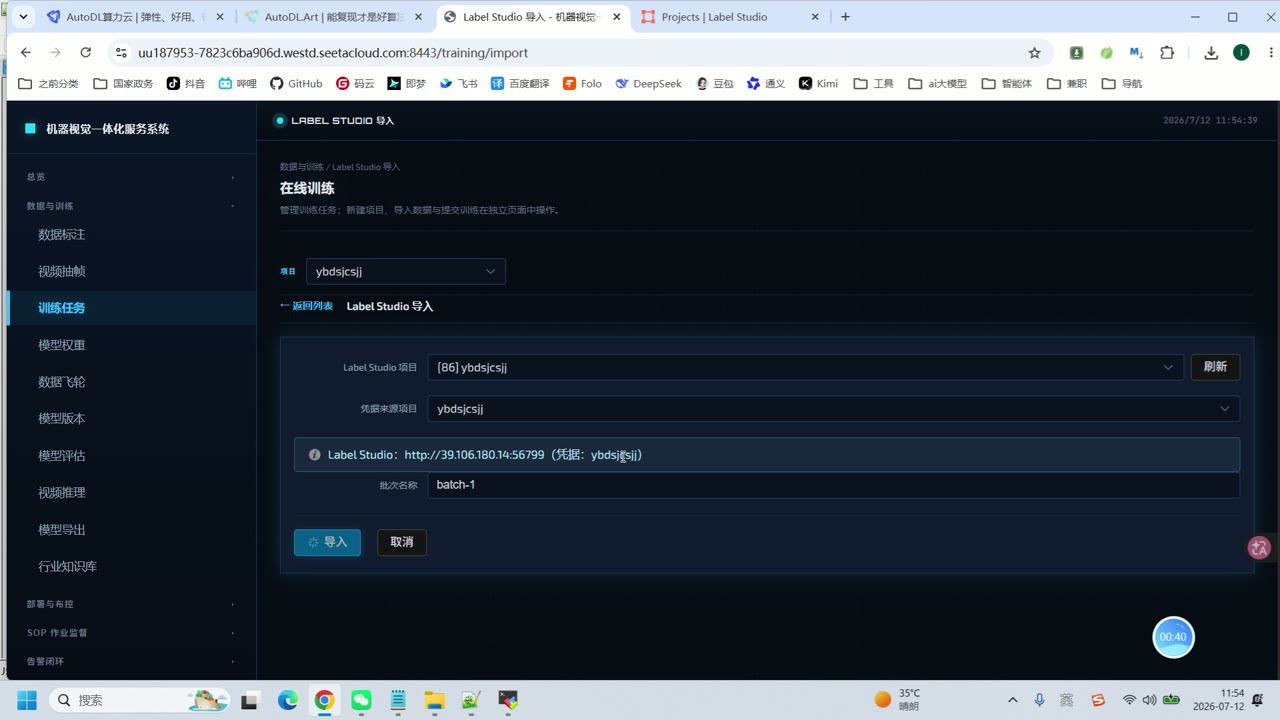
仪表读数检测数据集 模型训练操作界面
4.4 推理与读数还原
推理阶段使用训练好的 YOLO11 权重对整表图片做检测,得到每个数字的类别、置信度和边界框。随后进入后处理:
- 按置信度阈值过滤低质量框;
- 依据边界框中心点的纵坐标分组,同一行的数字归为一组;
- 组内按横坐标从左到右排序,拼接为读数序列;
- 对存在小数点的仪表,依据点位或固定位宽规则插入小数点;
- 输出结构化结果,并保留原始检测框用于复核。
from ultralytics import YOLO

model = YOLO("runs/meter_digits/yolo11n_baseline/weights/best.pt")
results = model.predict(source="oss://bucket/meter/sample.jpg", conf=0.35, imgsz=640)

for r in results:
    boxes = r.boxes
    items = []
    for xyxy, cls, conf in zip(boxes.xyxy.tolist(), boxes.cls.tolist(), boxes.conf.tolist()):
        items.append({
            "x1": xyxy[0], "y1": xyxy[1], "x2": xyxy[2], "y2": xyxy[3],
            "label": str(int(cls)), "conf": conf
        })
    # 后续按行分组、按列排序、拼接读数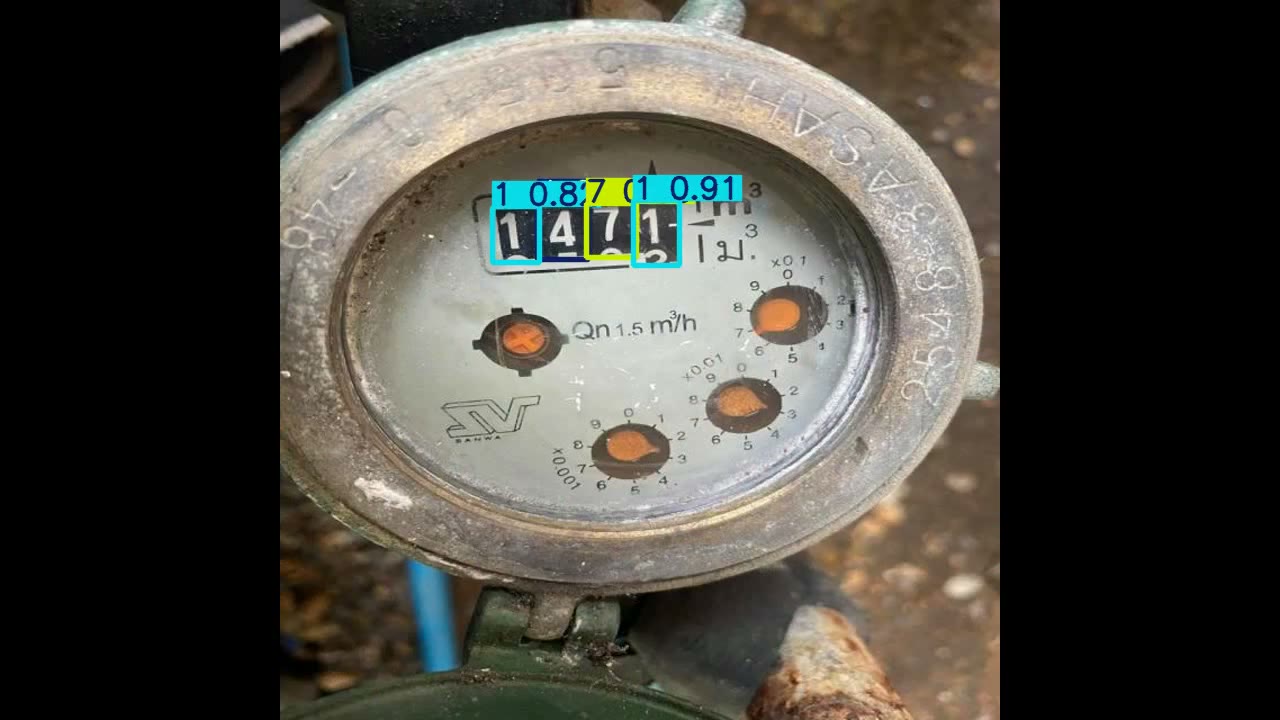
仪表读数检测数据集 模型验证结果截图
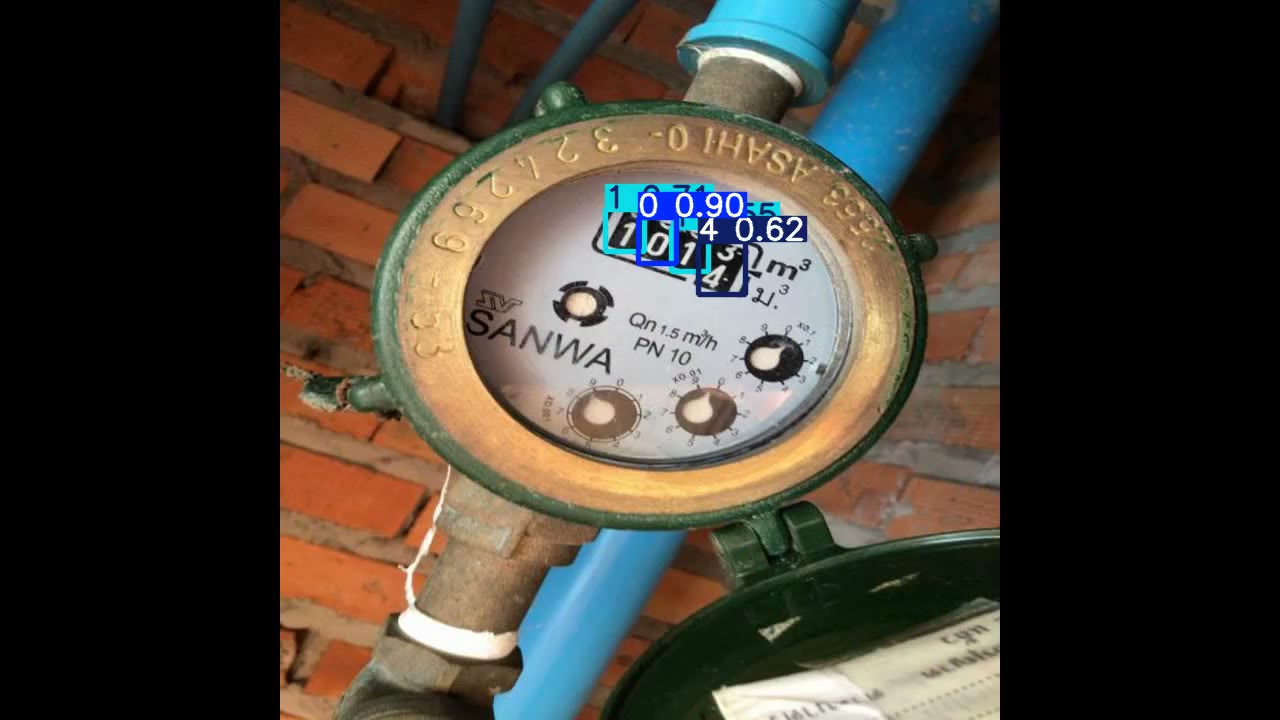
仪表读数检测数据集 模型验证结果截图
五、上线前验证:需要检查什么
模型训练完成不等于可以上线。建议在正式接入业务前完成以下验证。
1. 离线指标验证。 在独立验证集上统计各类别的精确率、召回率和 mAP,重点关注出现频率低的数字类别,避免整体指标被高频类别拉高。
2. 读数级验证。 检测指标好不代表读数正确。需要构造“整表读数”评测集,统计完全正确率、字符错误率和漏读率,并区分错误来源是漏检、误检还是排序错误。
3. 边界场景验证。 覆盖低照度、强反光、数字粘连、部分遮挡、倾斜拍摄等场景,观察模型是否出现系统性偏移。
4. 阈值敏感性验证。 置信度阈值会同时影响漏检和误检,建议绘制阈值与读数正确率的关系曲线,选择业务可接受的平衡点。
5. 复核流程验证。 对低置信度结果和读数异常结果(如位数不符、数值跳变)设置人工复核入口,确保异常样本可回溯到原图和检测框。
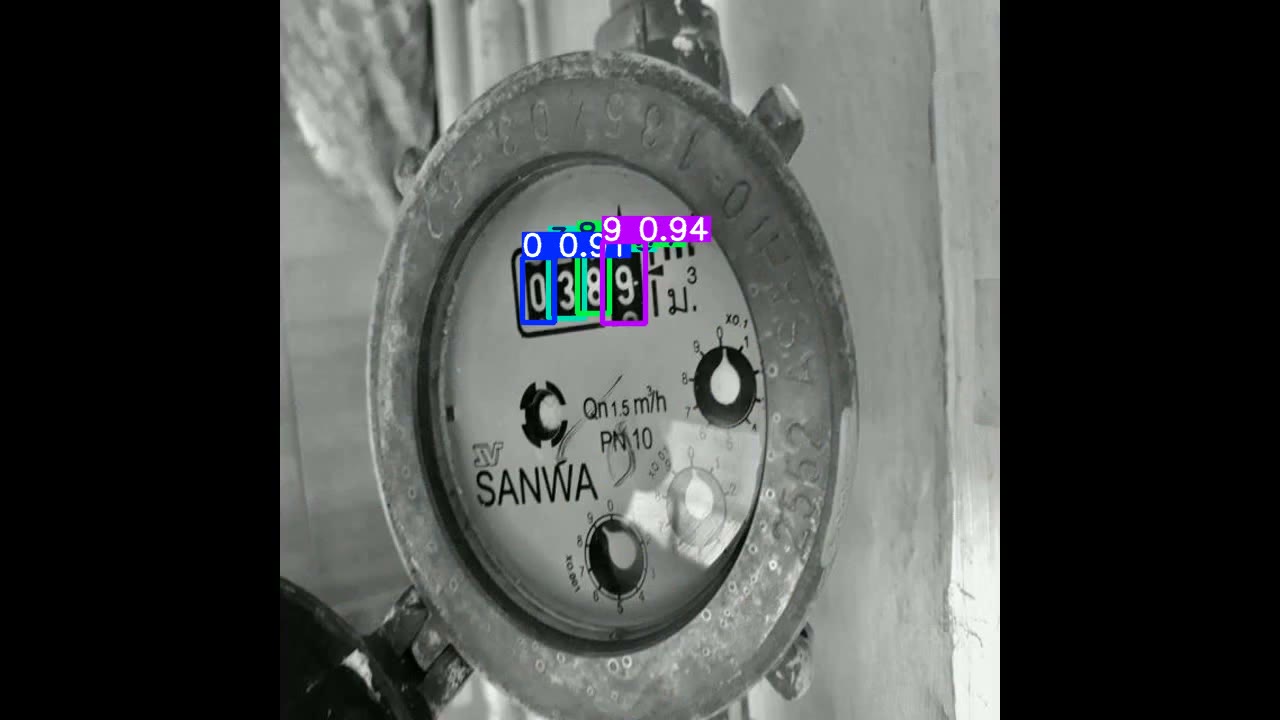
仪表读数检测数据集 模型验证结果截图
六、风险与优化方向
数据层面。 当前精标子集规模有限,类别分布和场景覆盖可能不足。建议持续补充不同型号、不同光照的样本,并对稀有数字类别做定向采集。视频抽帧时注意去重,避免相邻帧高度相似导致训练集与验证集泄漏。
标注层面。 数字边界框的松紧标准需要在标注规范中写清楚,多人标注时建议做交叉抽检。类别体系保持稳定,不要在中途增删标签,否则需要重新映射。
模型层面。 YOLO11 的 n 规模适合快速验证和边缘部署,若精度不足可考虑更大规模的变体,但需评估推理时延。对于长数字序列和粘连问题,可以在检测后增加基于投影或序列建模的后处理模块。
工程层面。 图片和标注统一走对象存储,训练脚本与推理服务读取同一份地址规范;权重文件、训练日志和验证结果按批次归档,保证任何一次读数结果都能追溯到对应的模型版本。
合规层面。 现场采集的仪表画面可能包含设备编号等敏感信息,上传对象存储前应做脱敏或访问控制,推理结果对外输出时避免携带原始图片地址。
八、总结
仪表读数检测的价值不在于单点模型指标,而在于“采集—存储—标注—训练—推理—复核”这条链路是否稳定可复现。以 YOLO11 作为数字实例检测的核心模型,配合对象存储统一图片地址、Label Studio 保证标注一致性、后处理完成读数还原、复核环节兜住异常结果,才能让视觉识别真正进入业务流程。对于准备启动类似项目的团队,建议先把数据规范和评测口径定下来,再迭代模型规模与增强策略,避免在指标波动中反复返工。
数据集说明(来源:数据集说明表)
仪表读数检测数据集YOLO目标检测数据集检测模型6559张10类
附:样本与标注图集
以下图片均取自该数据集真实样本、YOLO 标注效果图与 Label Studio 标注工作台界面,用于对照上文的数据组织与标注流程说明。
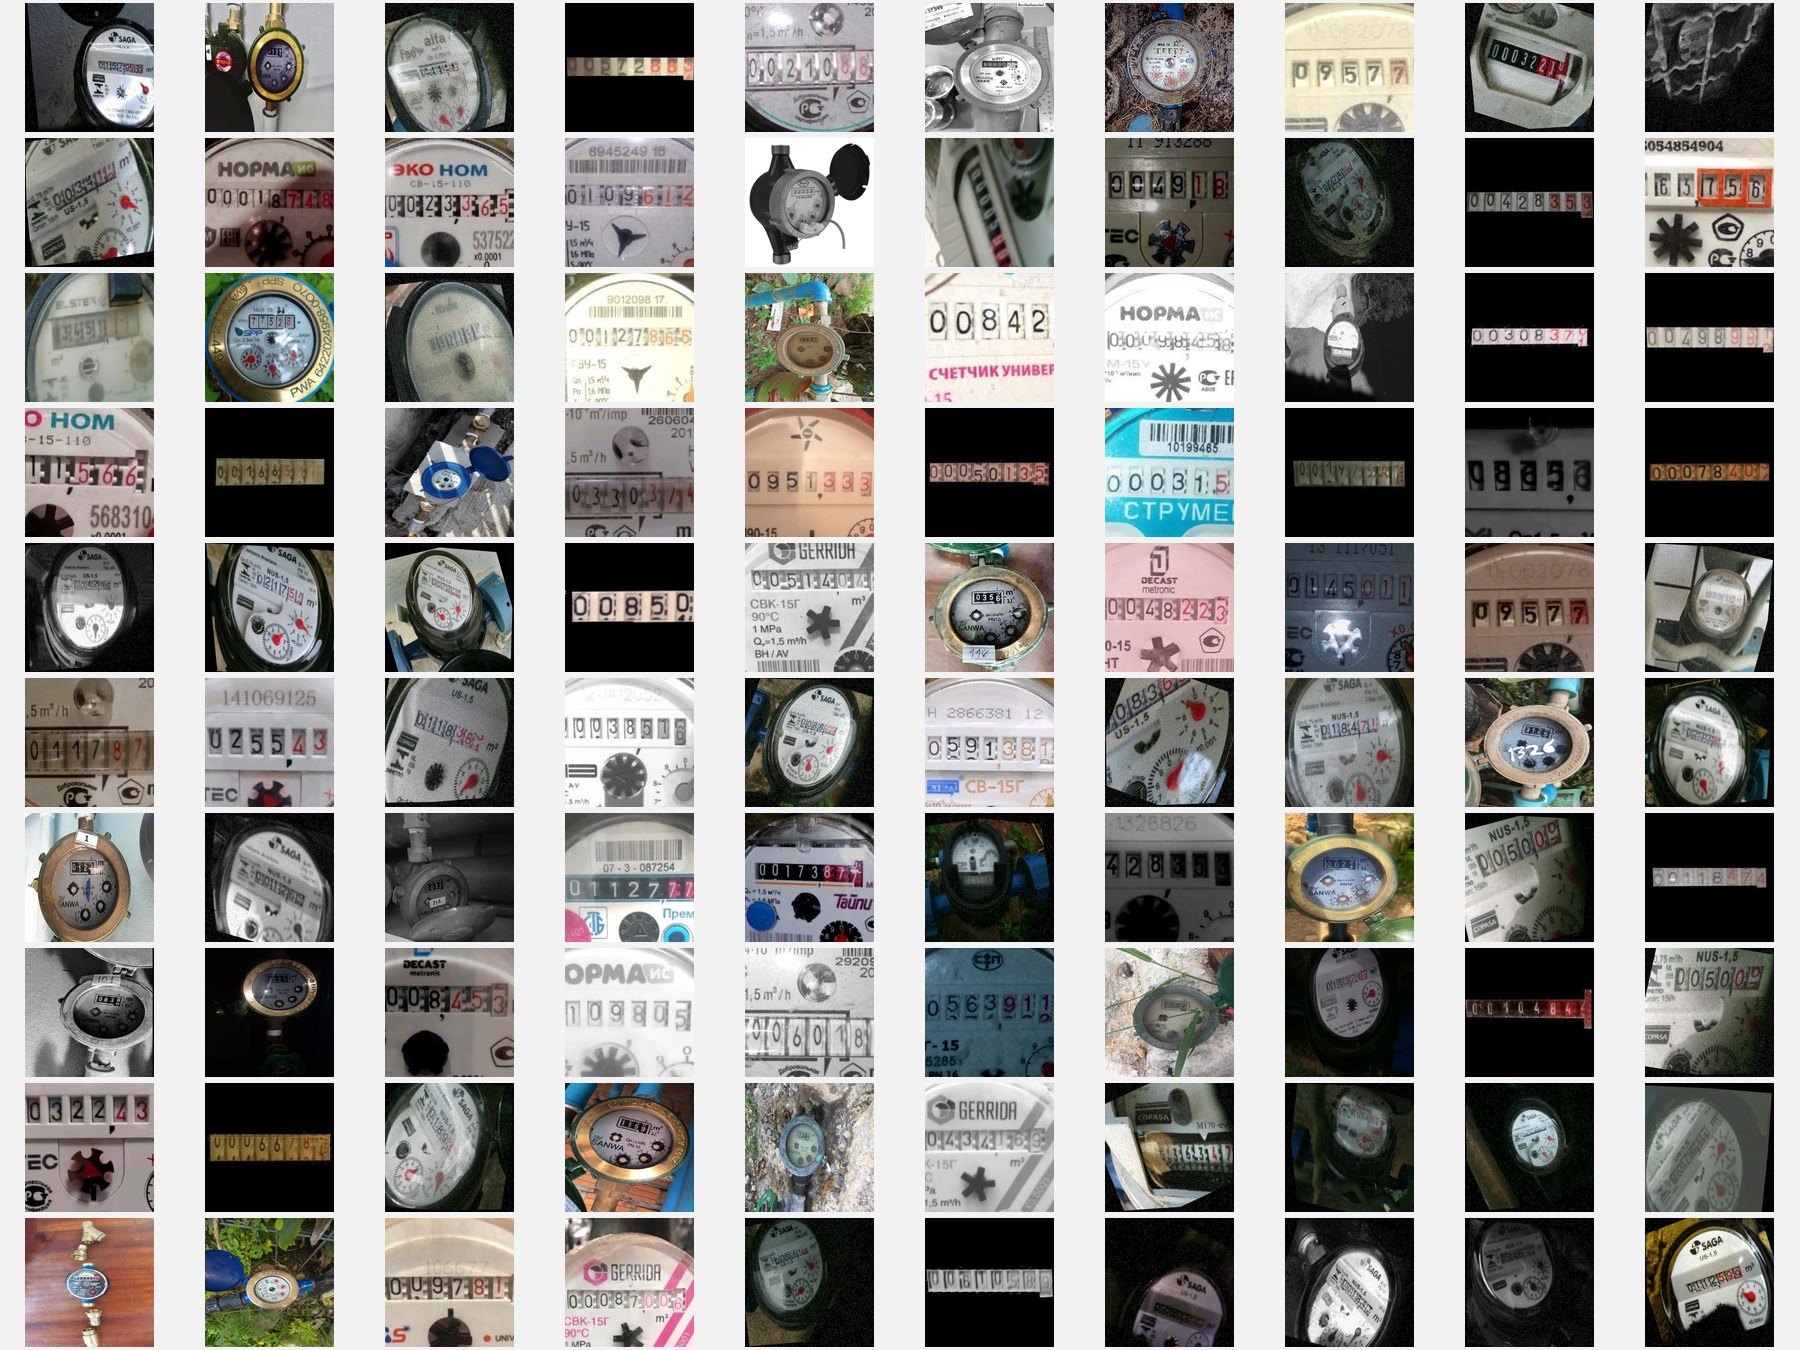
图 01 · 前 100 张样本总览(真实数据压缩包内抽取)
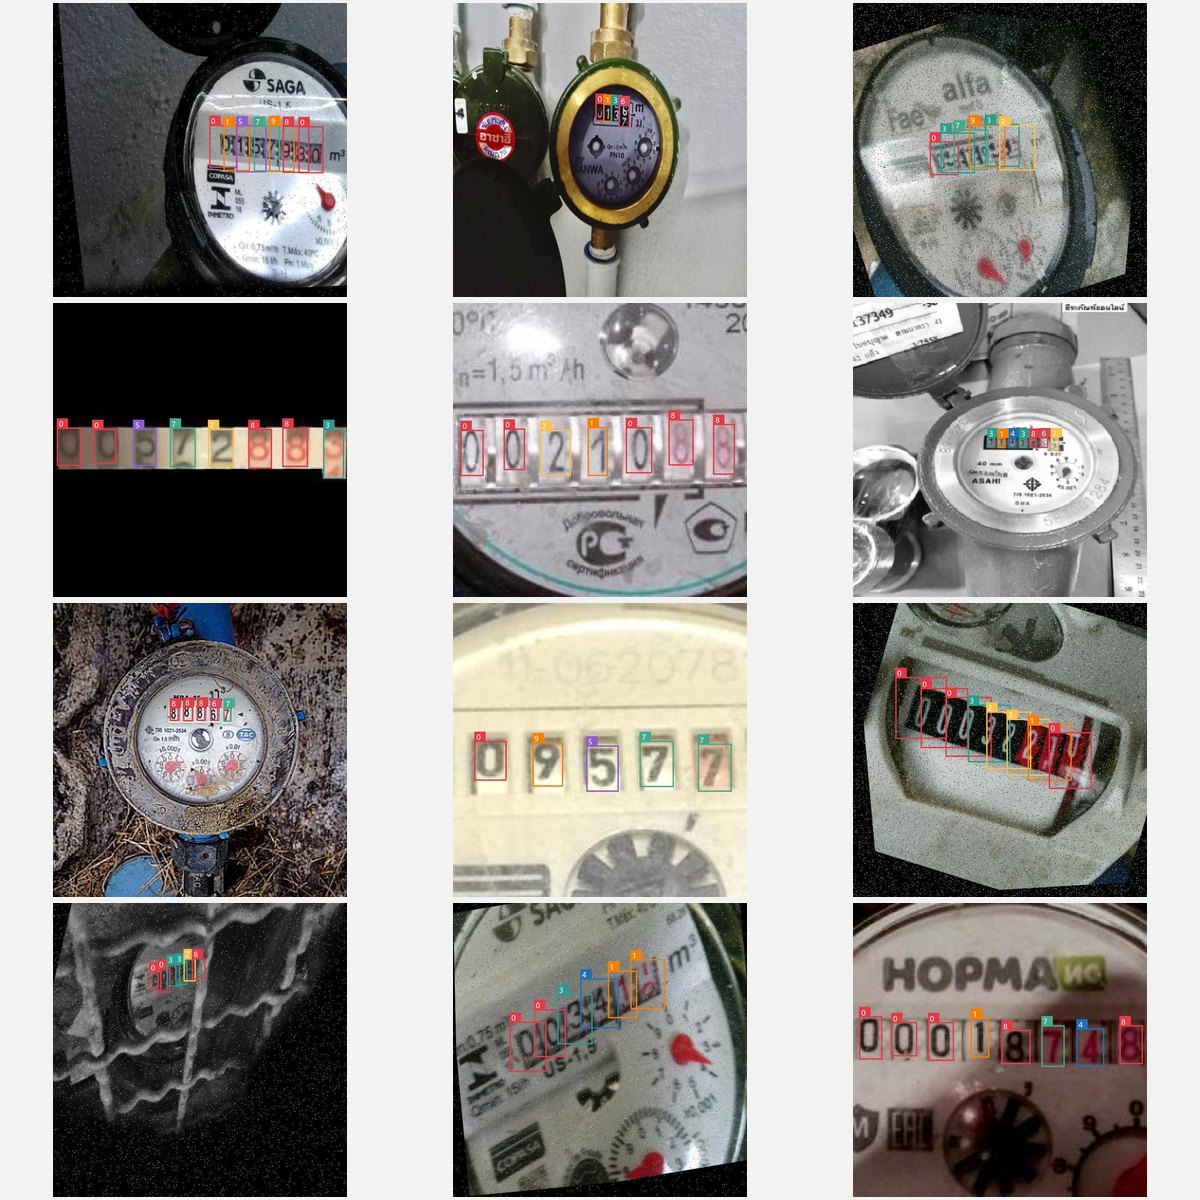
图 02 · YOLO 标注效果展示(一)· 检测框 + 类别标签
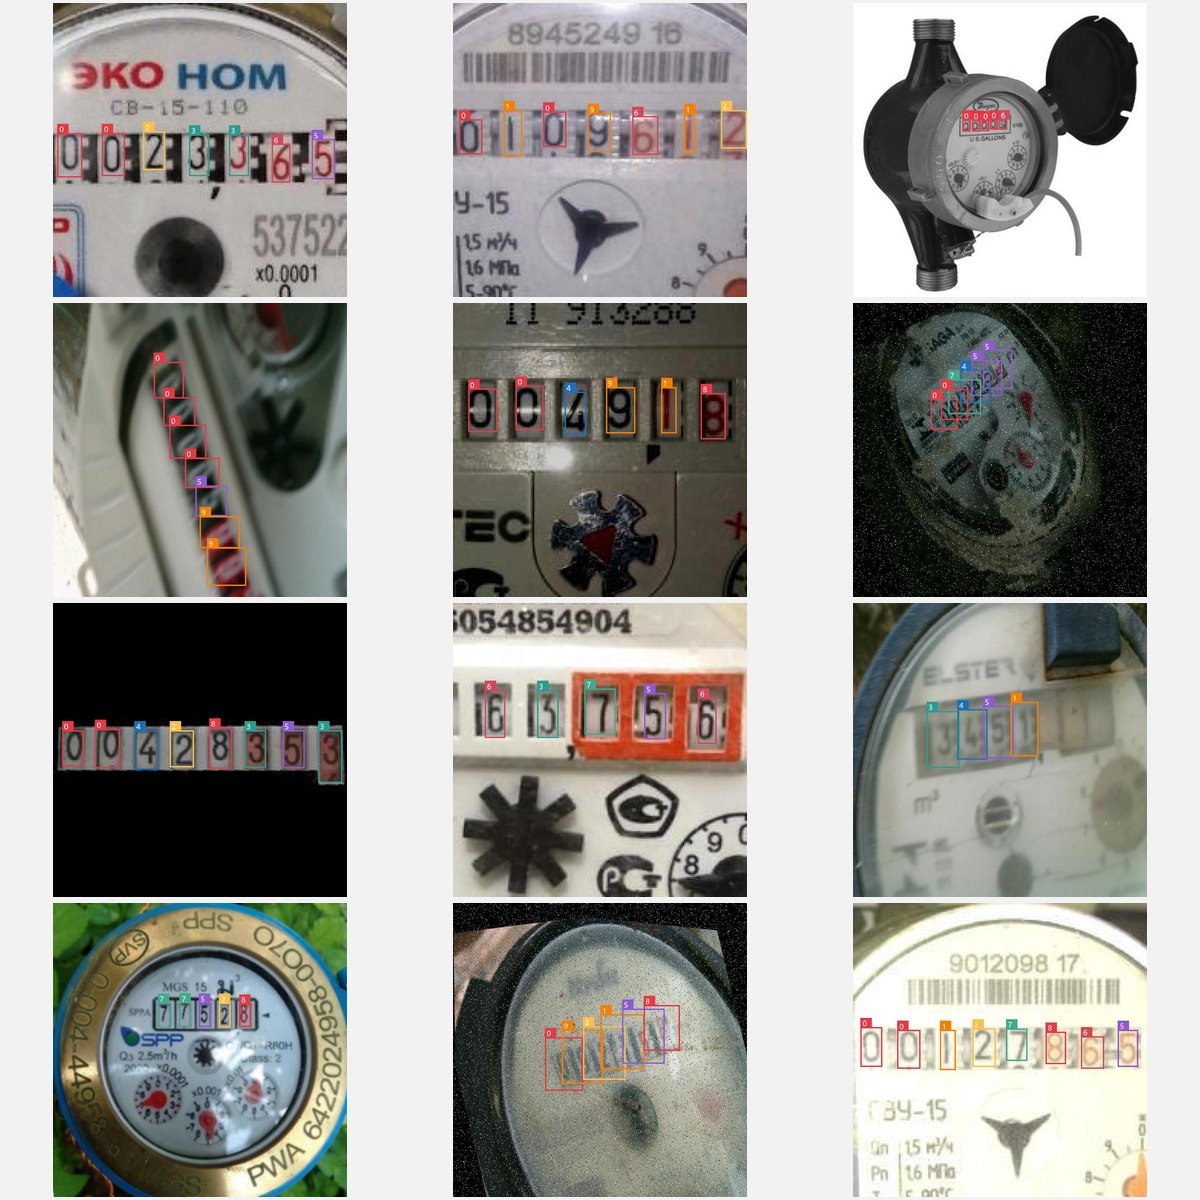
图 03 · YOLO 标注效果展示(二)· 不同场景样本
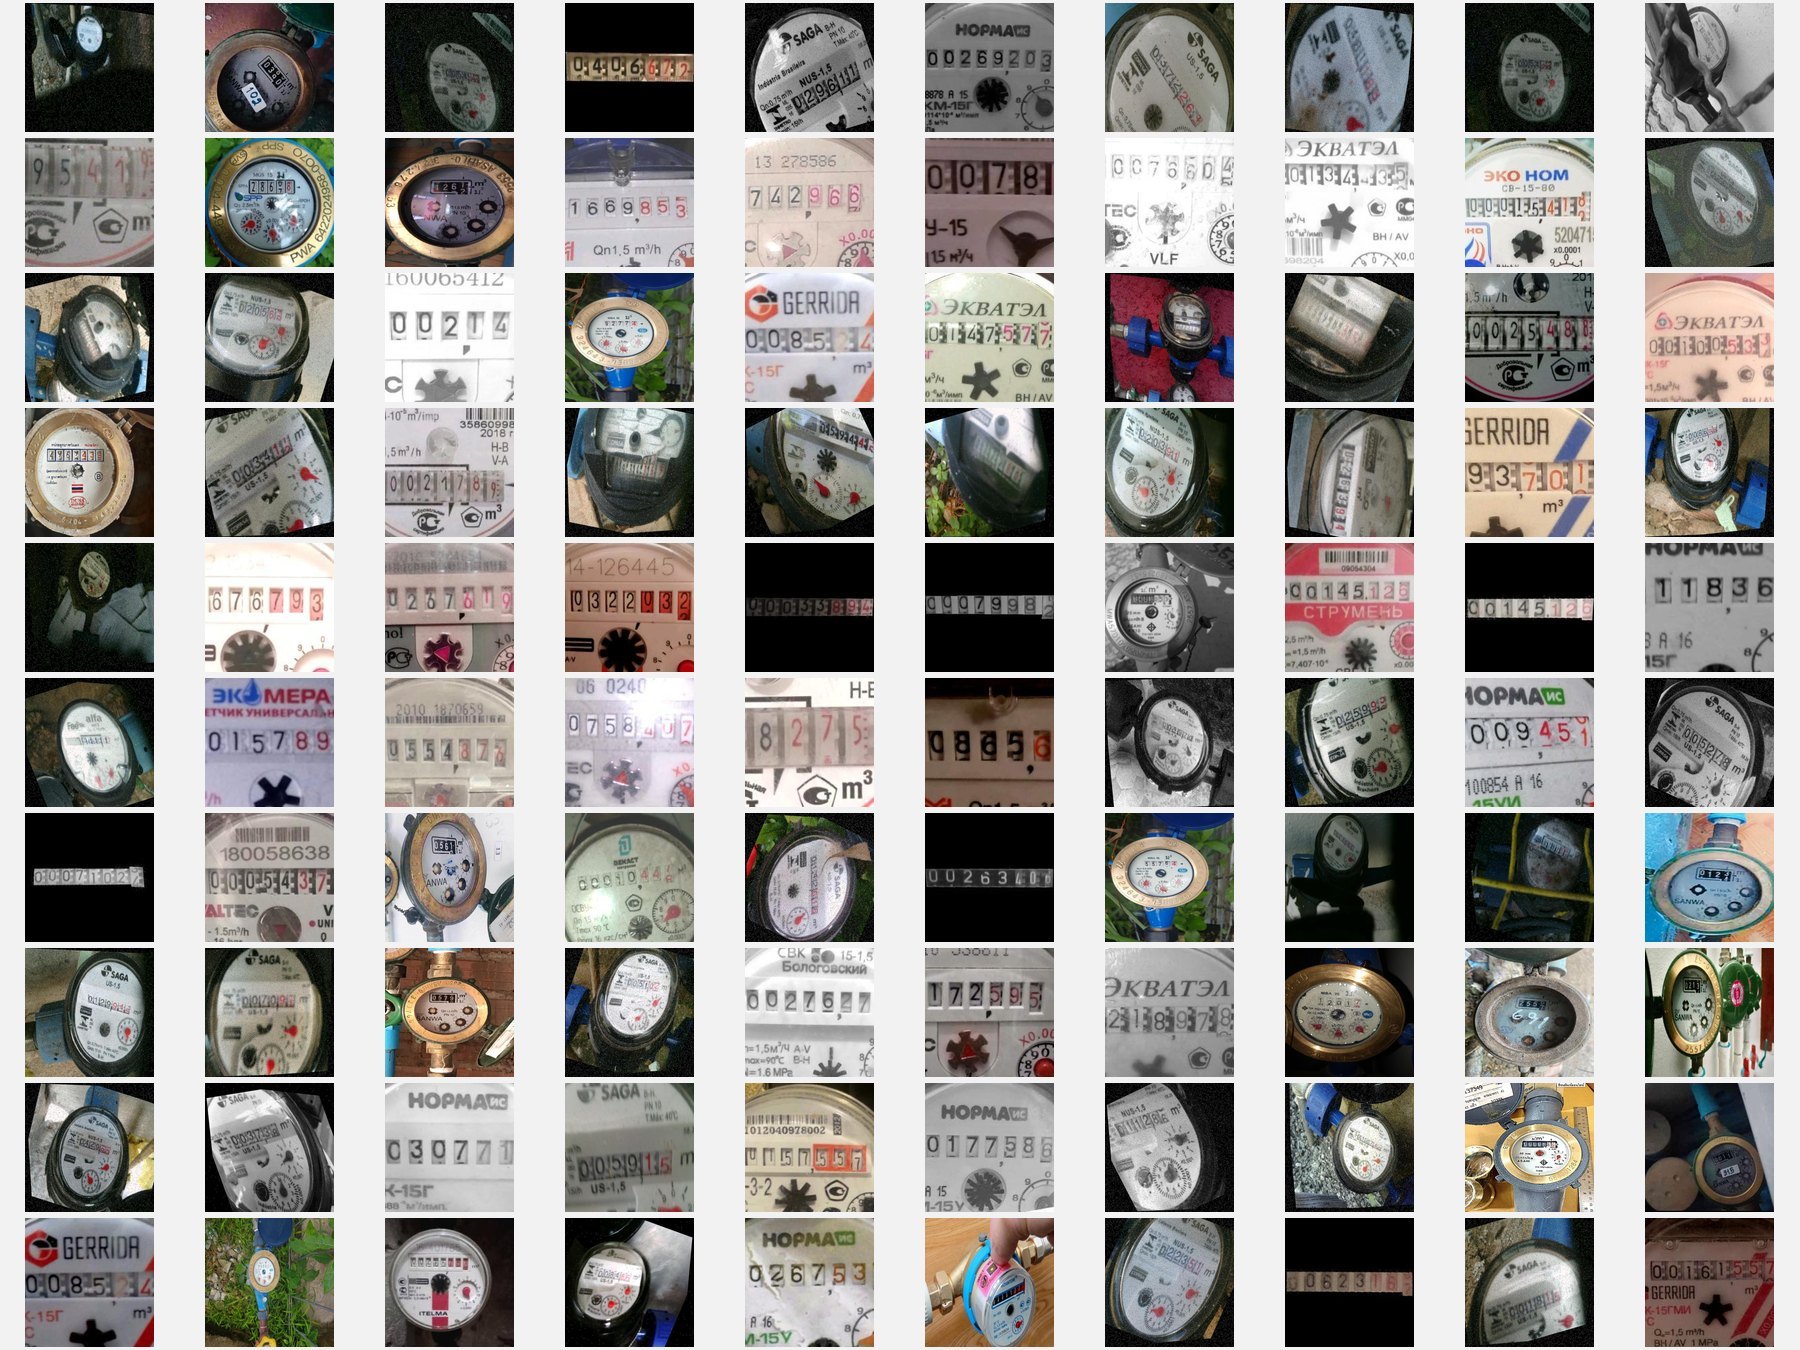
图 04 · 样本总览(第 101–200 张)
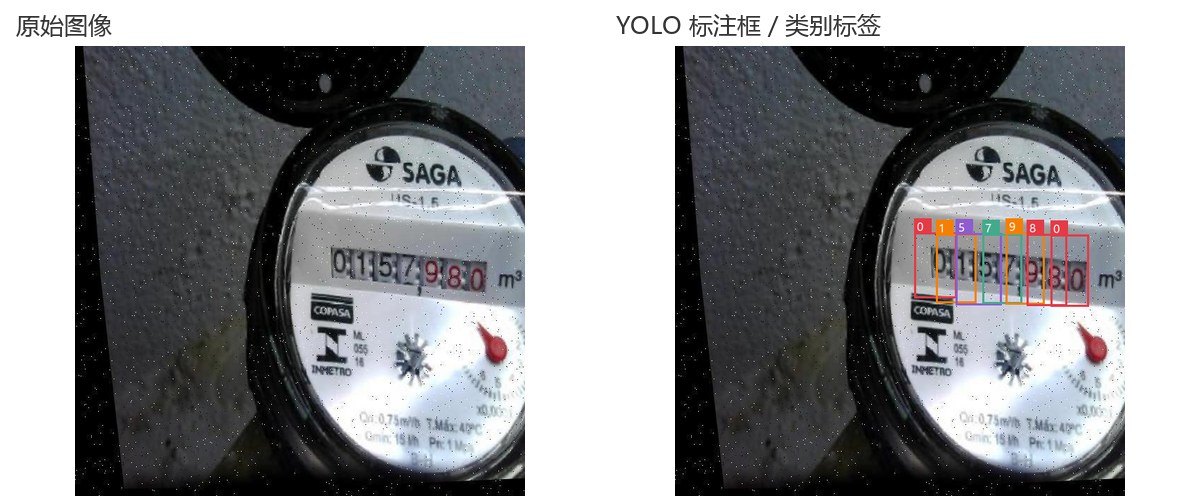
图 05 · 标注细节对比 · 左原始图像 / 右标注结果
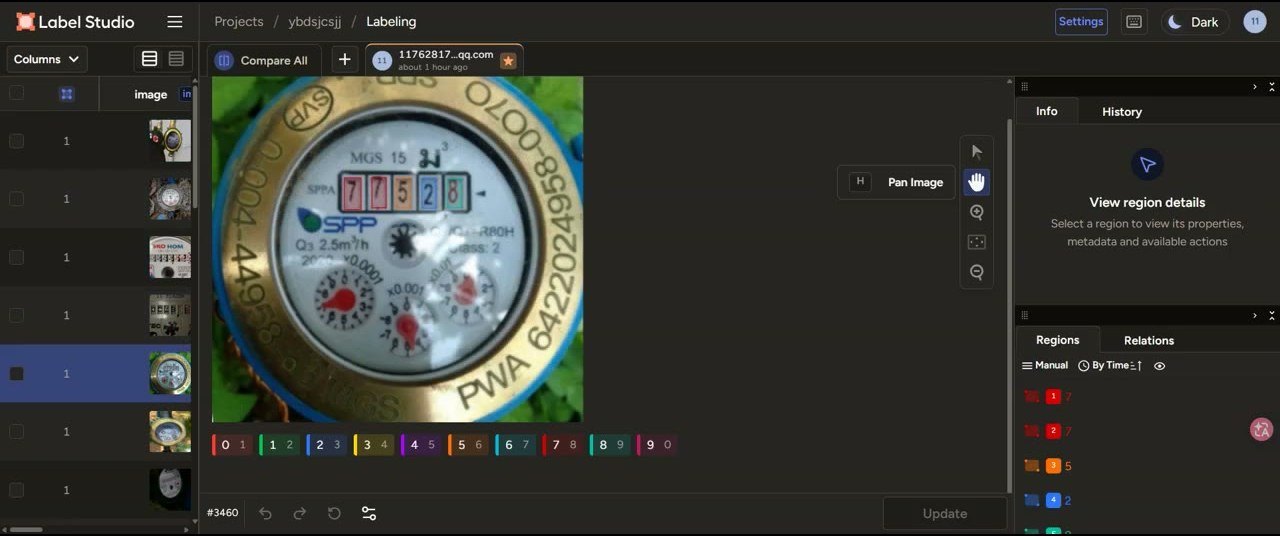
图 06 · Label Studio 标注工作台 · 任务列表与标注画布
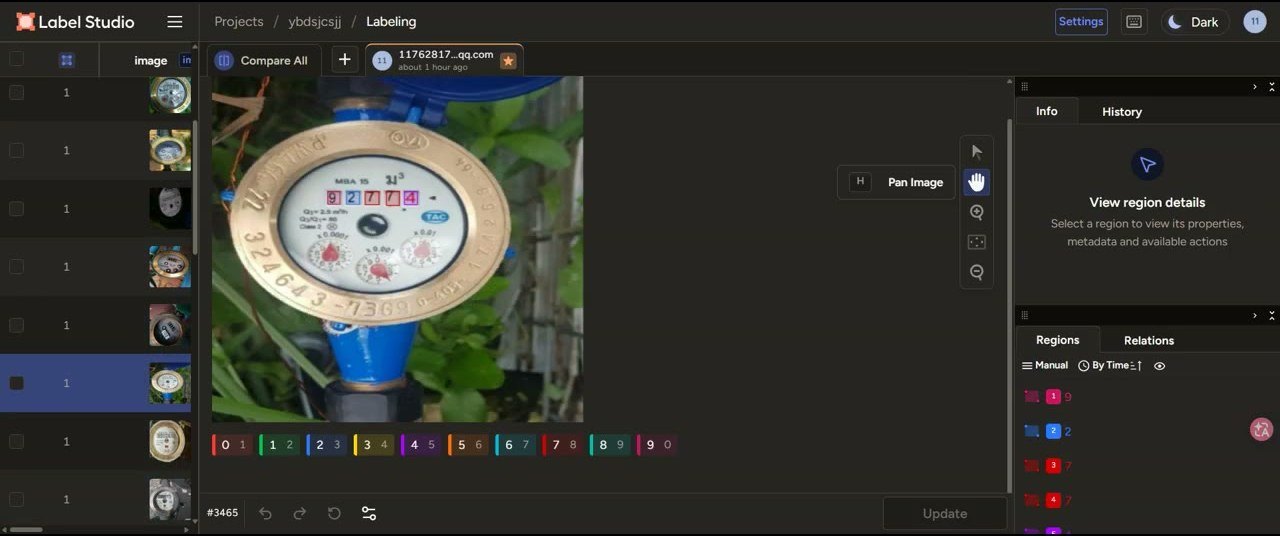
图 07 · Label Studio 标注工作台 · 检测框与类别标注
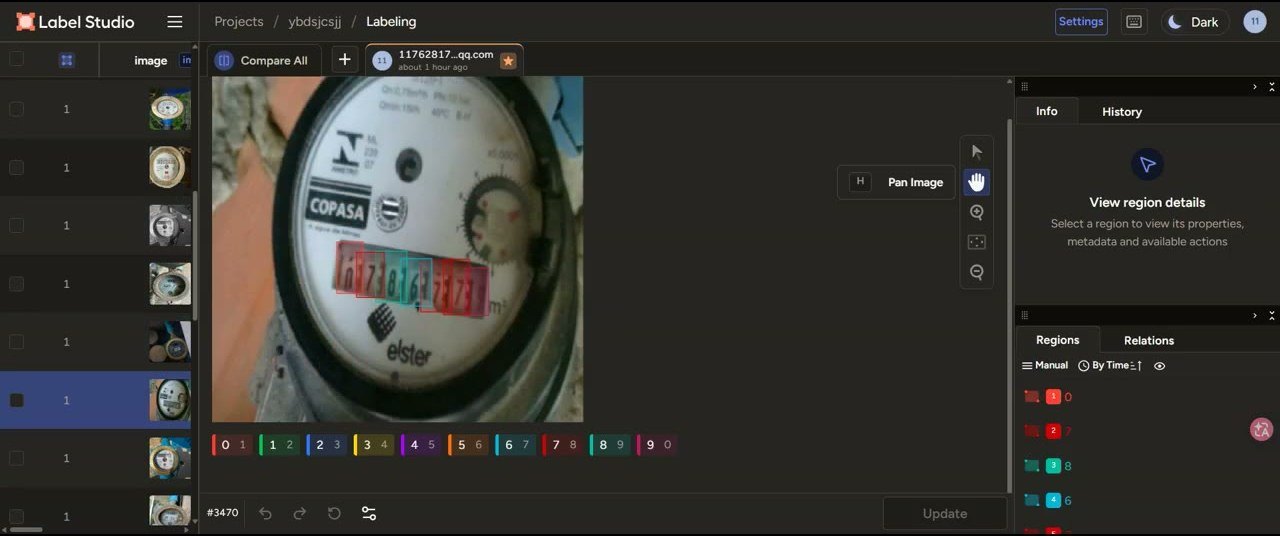
图 08 · Label Studio 标注工作台 · 标注区域与质检面板
从工程落地看,上面这条「数据整理—标注—训练—验证」链路也可以放到 ThinkCV 一体化训练平台上完成:数据集接入后,0、1、2、3、4、5 等标注结果可直接对接训练任务,提交后由平台调度并自动生成模型,再经过模型评估、导出与下游对接,把推理中发现的难例回流数据集形成数据飞轮。它减少的是环境搭建和手工搬运的摩擦,模型效果仍取决于标注质量与场景覆盖。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号