变电站红外液体泄漏检测工程闭环:基于 YOLO11 的数据采集、训练与复核实践
原创
变电站红外液体泄漏检测工程闭环:基于 YOLO11 的数据采集、训练与复核实践
原创
用户8779533
发布于 2026-11-22 18:33:06
发布于 2026-11-22 18:33:06
变电站设备巡检中,液体泄漏属于典型的低频次、高后果异常。人工巡检受限于班次密度和夜间照明条件,往往难以及时发现渗漏初期迹象。红外热成像能够把温度差异转化为可视化信号,配合目标检测模型,可以在监控画面上自动圈定疑似泄漏区域,为运维人员提供复核线索。本文以一套面向变电站液体泄漏的红外检测数据集为基础,围绕 YOLO11 梳理从数据采集、对象存储管理、标注、训练到推理复核的完整工程链路,并讨论上线前需要关注的验证要点与风险。
一、行业需求与任务定义
变电站内充油设备、管道法兰、阀门连接处是液体泄漏的高发部位。泄漏在红外画面中通常表现为与周边设备存在温差不均的区域,但这一信号会受到环境温度、设备负载、拍摄角度和画面噪声的共同影响。工程上把任务定义为单类别目标检测:在红外图像中定位疑似泄漏区域,输出边界框与置信度,由人工复核后决定是否派单处置。
选择 YOLO11 作为训练模型,主要考虑其在检测精度与推理速度之间的平衡,便于后续迁移到边缘侧或云端推理服务。需要说明的是,单类别检测并不等于问题简单——泄漏目标形态多样、边界模糊,模型容易在低对比度场景下出现漏检,这决定了后续数据治理和验证环节必须做扎实。
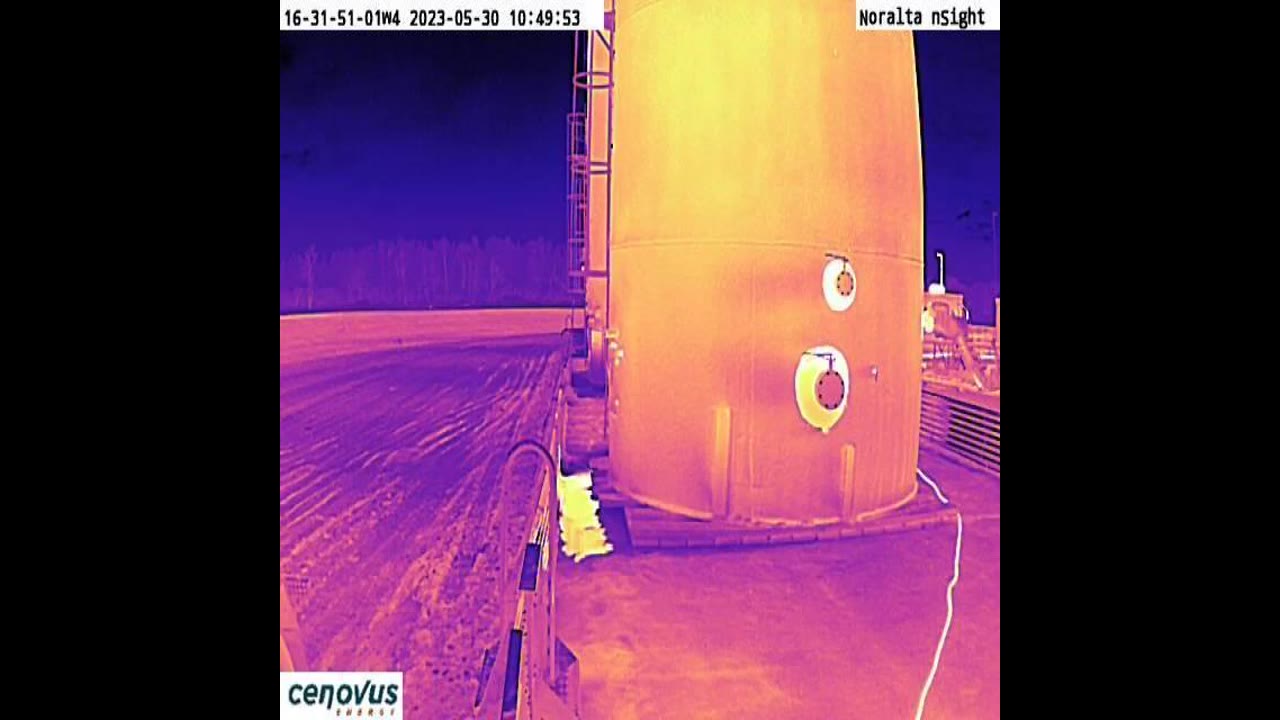
变电站液体泄露红外检测YOLO数据集 原始样本抽帧
二、数据集说明(来源:数据集说明表)
该数据集命名为“变电站液体泄露红外检测YOLO数据集”,项目标识为 substation_liquid_leak_ir,批次为 2026-07-10。数据集面向变电站巡检、电力设备运维和红外安全监控场景,标注类别为单一类别 leak,属于单分类目标检测数据。
规模方面,完整数据集约 5,152 张,本次从中精选 100 张红外图像,对应 Label Studio 任务数量为 100 条,标注结果以 Label Studio 导出的 JSON 形式组织,并配套标注配置文件。素材目录中另附一段由这些图像合成的视频文件,可用于数据集预览或项目展示。标注类型统一为 leak,未设置多类别层级。
从适用任务看,该数据适合作为红外泄漏检测的基线数据集,用于验证 YOLO11 在单类别小样本条件下的训练流程、标注格式转换和推理链路,也可作为扩充数据前的流程样板。由于样本量有限,直接用于生产环境前需要补充更多场景与工况数据。
三、样本特征分析
红外图像与可见光图像在数据特性上有明显差异。样本画面以设备热分布为主体,泄漏区域与背景的对比度取决于温差大小,部分样本中目标边缘并不锐利,标注框存在一定的主观边界判断空间。样本抽帧显示,画面覆盖了不同设备布局和拍摄视角,背景中存在管道、柜体等结构,这些结构在热成像下可能形成与泄漏相似的亮暗区域,构成误检来源。
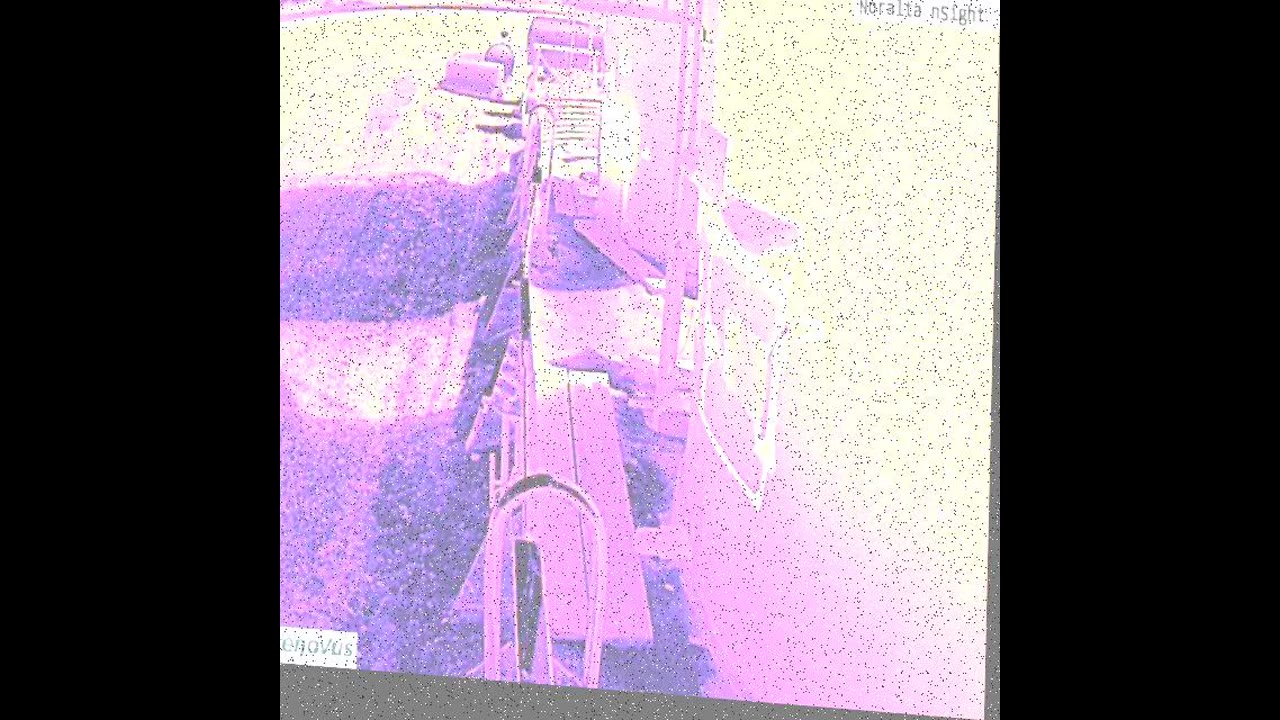
变电站液体泄露红外检测YOLO数据集 原始样本抽帧
由此可以归纳出几个影响模型学习的关键因素:一是画面清晰度与对比度直接决定目标可辨识度;二是泄漏点形状和位置分布较分散,模型需要较强泛化能力;三是部分目标特征不明显,标注一致性依赖标注规范。这些因素在训练前应通过数据清洗和标注复核加以控制。
四、数据采集、存储与标注流程
工程闭环的第一步是数据采集。红外巡检视频或定时抓拍图像经由采集端汇聚后,建议统一上传至对象存储(如 COS)进行集中管理,按批次和场景建立目录前缀,保留原始文件与元信息,避免本地散落导致版本混乱。对象存储同时便于后续训练任务按需拉取,减少数据搬运成本。
标注环节采用 Label Studio 完成。标注配置中定义单类别 leak,标注人员对每张图像绘制边界框,导出 JSON 后转换为 YOLO11 训练所需的标签格式。为保证一致性,建议在标注规范中明确边界判定原则,例如以温差区域的可辨识外沿为准,并对存疑样本进行二次复核。
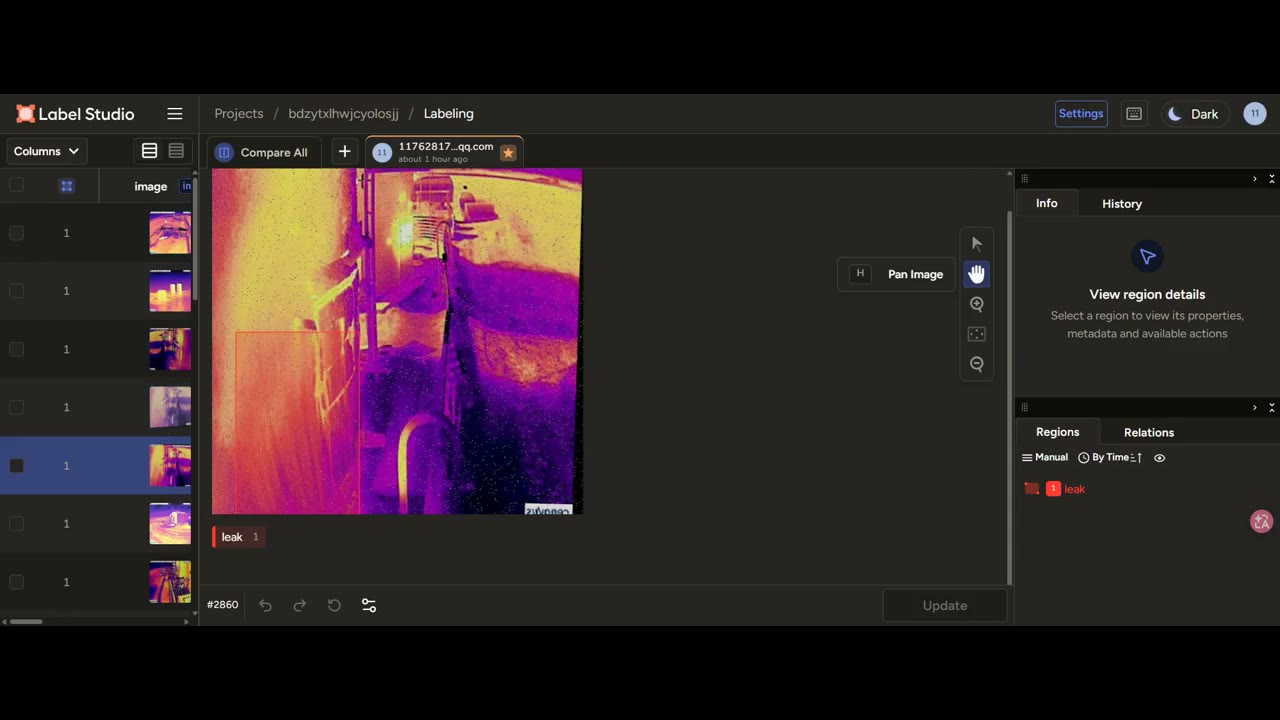
变电站液体泄露红外检测YOLO数据集 标注界面示例
标注完成后,按训练集与验证集划分数据,并检查标签文件与图像的一一对应关系。对于小样本数据集,划分时应尽量保证场景分布均衡,避免验证集集中于单一视角。
五、YOLO11 训练与推理链路
训练阶段以 YOLO11 检测模型为基线,数据配置文件指向转换后的图像与标签目录,类别数设为 1。以下为示意性配置,具体路径与超参需按实际环境调整:
# data/leak_ir.yaml
path: ./datasets/leak_ir
train: images/train
val: images/val
names:
0: leakfrom ultralytics import YOLO
model = YOLO("yolo11n.pt")
model.train(
data="data/leak_ir.yaml",
epochs=100,
imgsz=640,
batch=16,
device=0,
)训练过程中建议关注损失曲线与验证集指标的变化趋势,结合小样本特点适当使用数据增强,但需注意红外图像不宜做过度色彩扰动,几何变换和亮度对比度调整更为稳妥。训练完成后导出权重,进入推理链路。
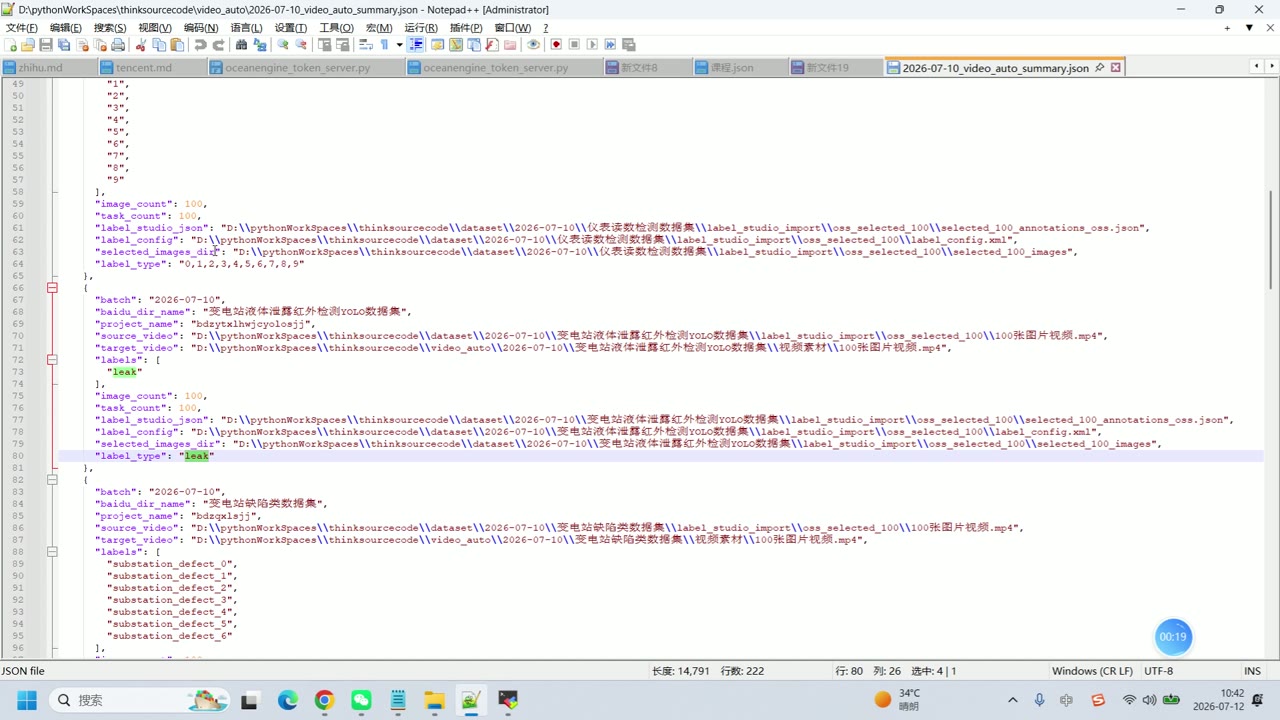
变电站液体泄露红外检测YOLO数据集 模型训练操作界面
推理侧可部署为服务化接口:输入图像经预处理后送入 YOLO11 模型,输出检测框、类别与置信度,再按阈值过滤并写入结果存储,供前端展示与人工复核。对于视频流场景,可按固定抽帧间隔推理,降低算力压力。
六、上线前验证与人工复核
上线前验证应覆盖三类内容。第一是离线指标评估,在独立验证集上统计精确率、召回率等指标,重点关注漏检情况,因为泄漏场景中漏检的代价通常高于误检。第二是阈值调优,通过调整置信度阈值观察误检与漏检的平衡,形成适合业务侧复核能力的配置。第三是可视化抽检,对模型输出进行人工比对,确认检测框位置合理。
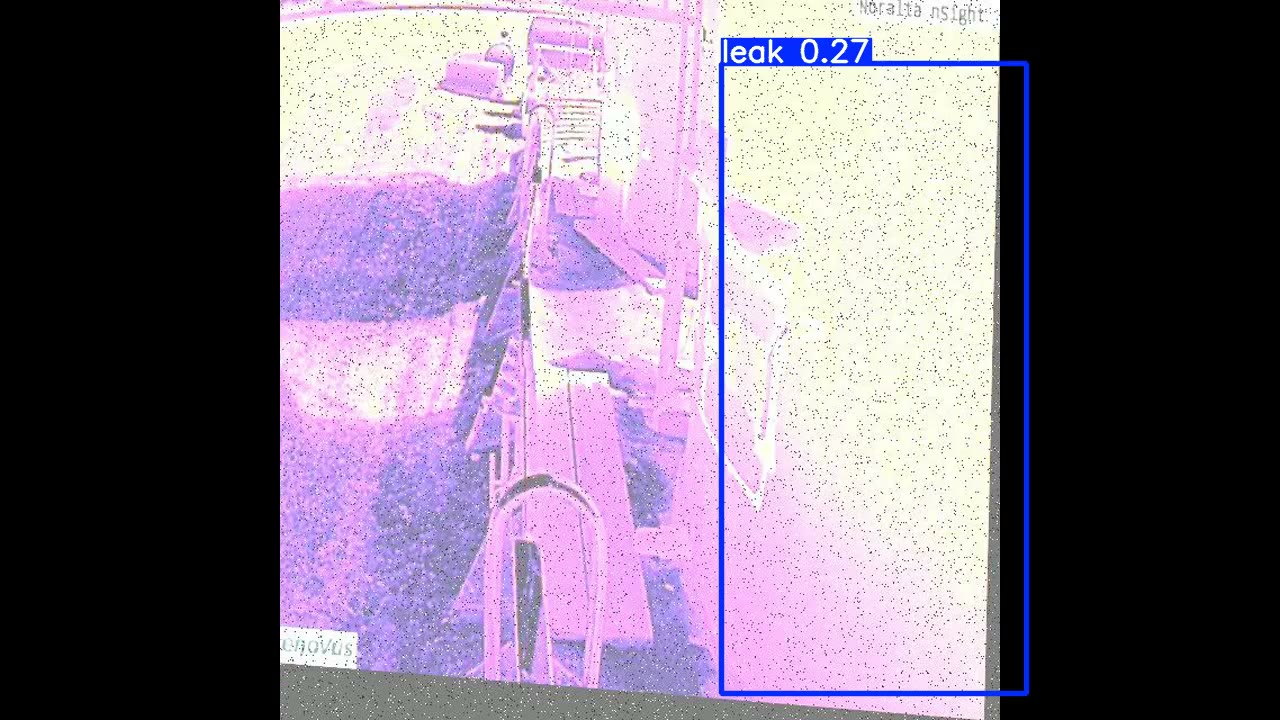
变电站液体泄露红外检测YOLO数据集 模型验证结果截图
复核流程建议设计为“模型提示—人工确认—结果归档”的闭环。模型输出仅作为线索,由运维人员在原始画面上确认后再决定处置动作,同时把复核结论回流为新的标注数据,形成数据迭代。这样既控制了误报带来的干扰,也为后续模型优化积累样本。
七、风险与优化方向
从样本观察看,当前链路存在几方面风险。其一,低对比度或模糊画面下模型容易漏检或误检,需要在采集端提升成像质量,或在预处理阶段做对比度增强。其二,泄漏目标形态多样,单一批次数据难以覆盖全部工况,模型泛化能力受限。其三,样本量偏小,验证指标波动较大,结论需谨慎解读。
优化方向可以围绕三点展开:扩充多场景、多时段、多设备类型的红外数据,提升类别内多样性;完善标注规范并引入交叉复核,降低标注噪声;在训练中引入更稳健的增强策略和难例挖掘,针对漏检样本做重点补充。此外,推理侧可结合时序信息,对连续帧的检测结果做一致性过滤,减少瞬时误报。
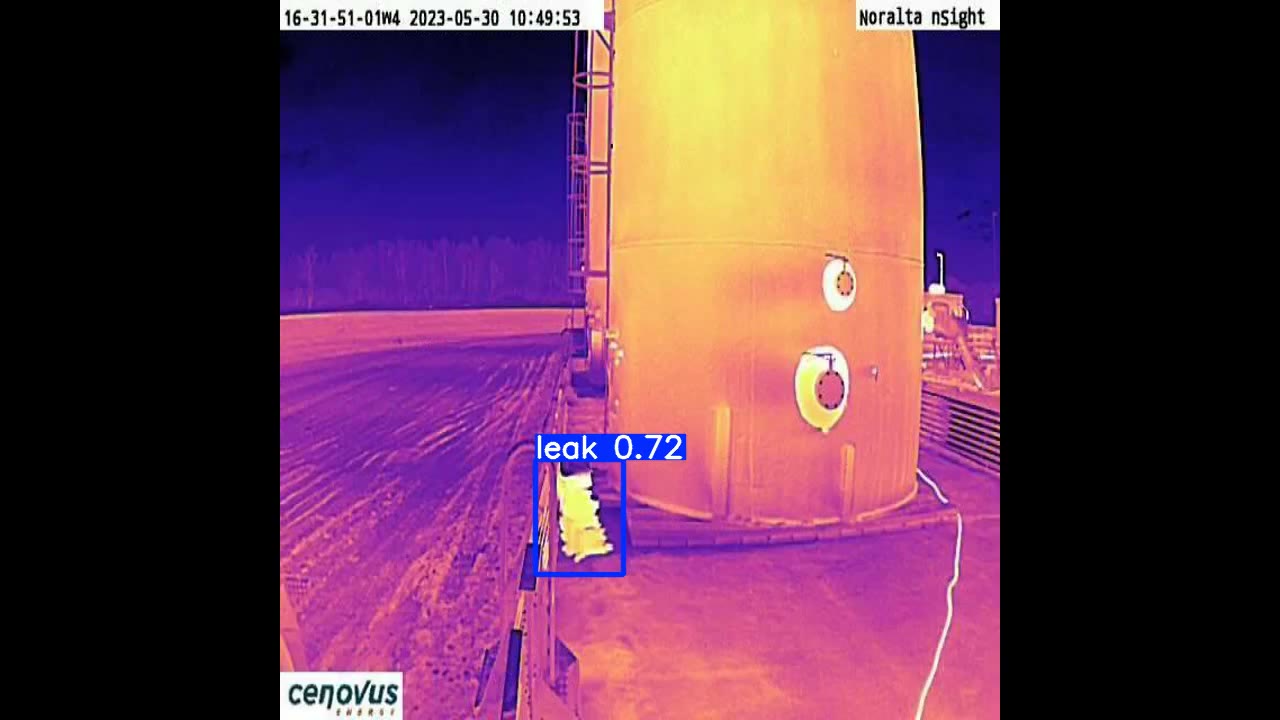
变电站液体泄露红外检测YOLO数据集 模型验证结果截图
九、总结
本文以变电站液体泄漏红外检测为背景,梳理了基于 YOLO11 的工程闭环:从红外数据采集与对象存储管理,到 Label Studio 标注与格式转换,再到训练、推理和人工复核。单类别小样本数据集适合作为流程验证的起点,但距离稳定生产应用仍需在数据规模、成像质量和验证方法上持续投入。工程实践中,把模型定位为辅助线索而非最终结论,配合规范化的复核与数据回流机制,才能让检测能力在真实运维场景中逐步收敛。
数据集说明(来源:数据集说明表)
【变电站液体泄露红外检测YOLO数据集】1分类,
附:样本与标注图集
以下图片均取自该数据集真实样本、YOLO 标注效果图与 Label Studio 标注工作台界面,用于对照上文的数据组织与标注流程说明。
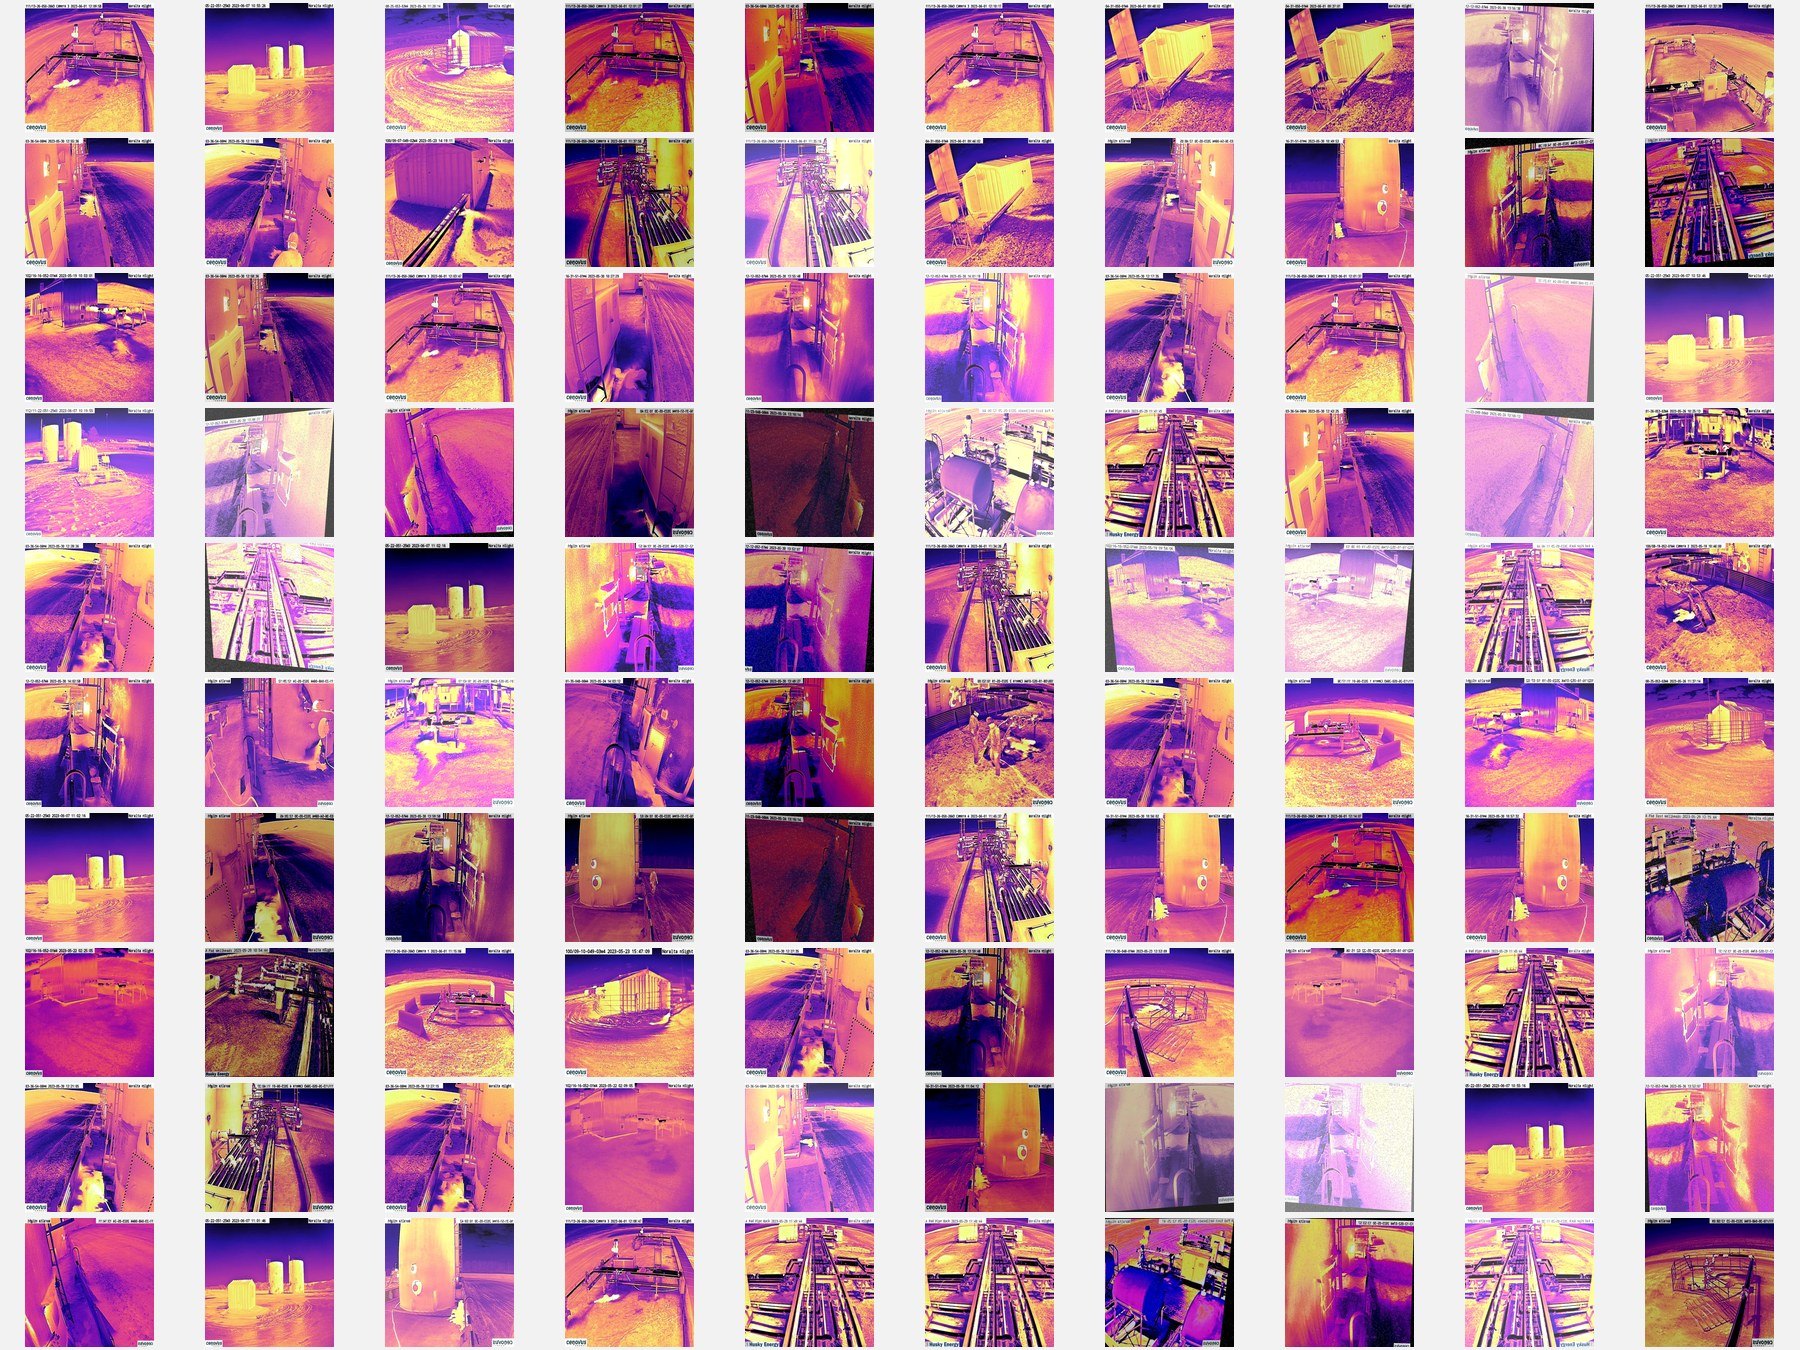
图 01 · 前 100 张样本总览(真实数据压缩包内抽取)
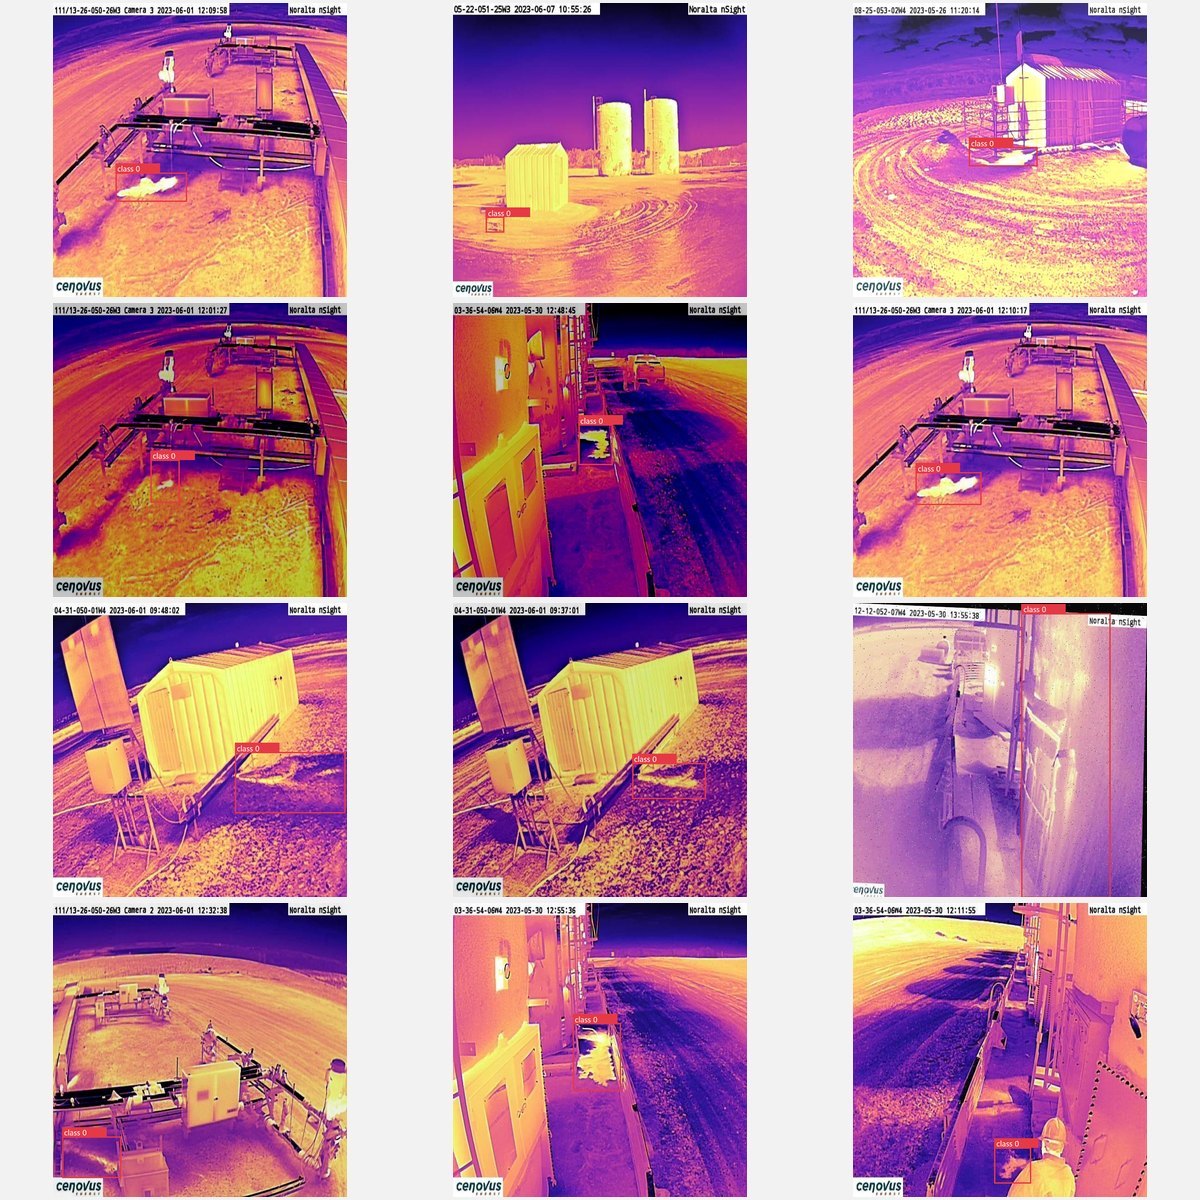
图 02 · YOLO 标注效果展示(一)· 检测框 + 类别标签
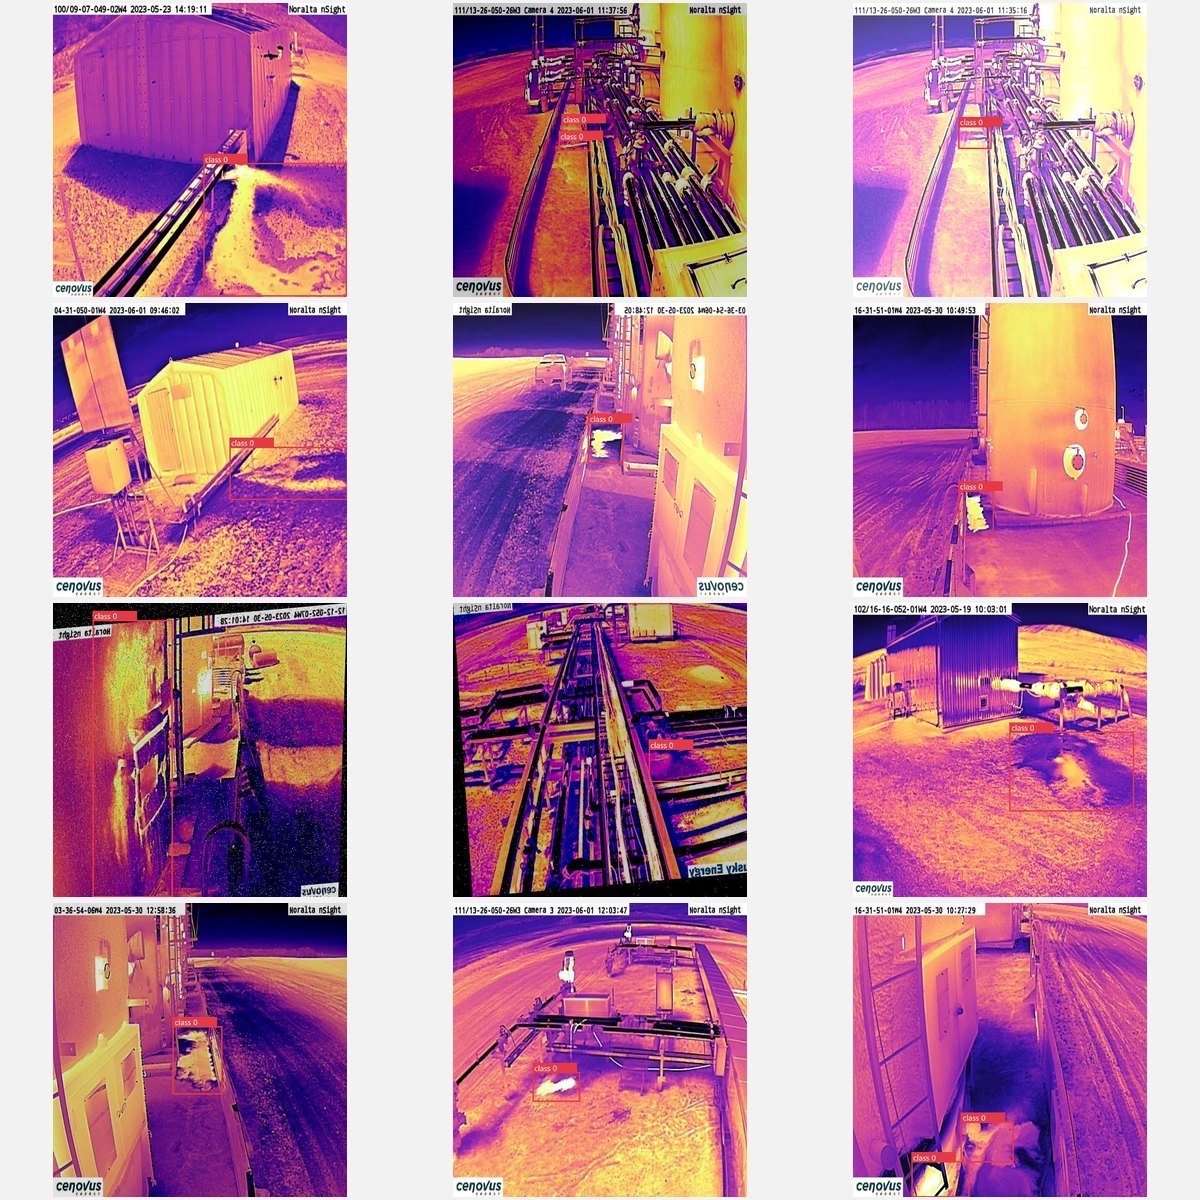
图 03 · YOLO 标注效果展示(二)· 不同场景样本
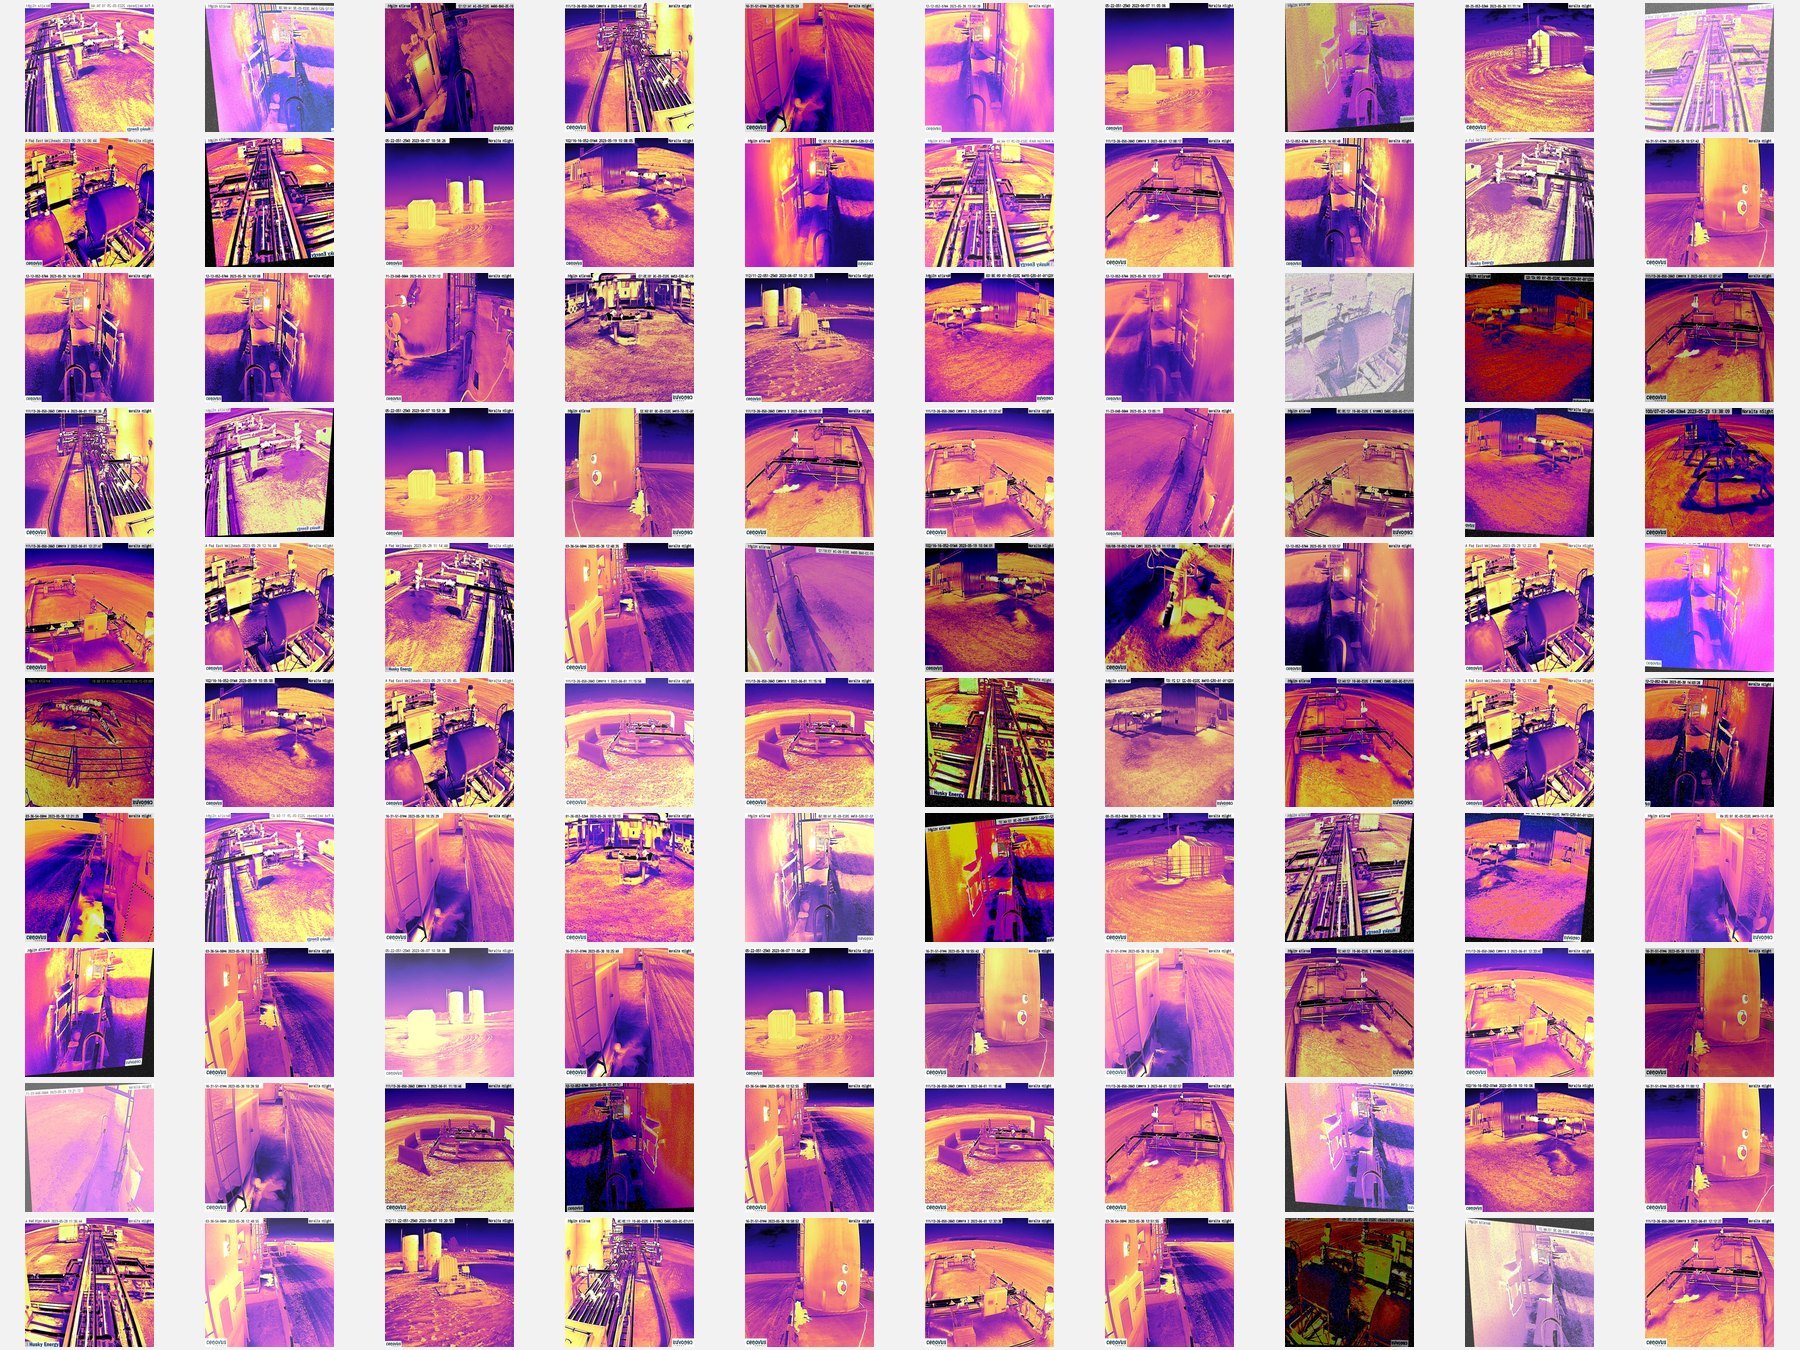
图 04 · 样本总览(第 101–200 张)
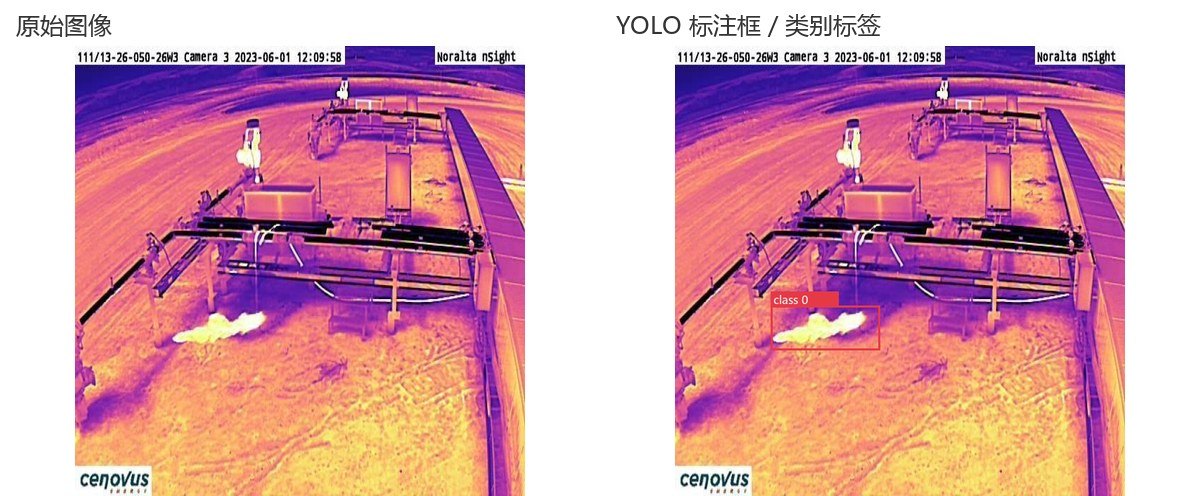
图 05 · 标注细节对比 · 左原始图像 / 右标注结果
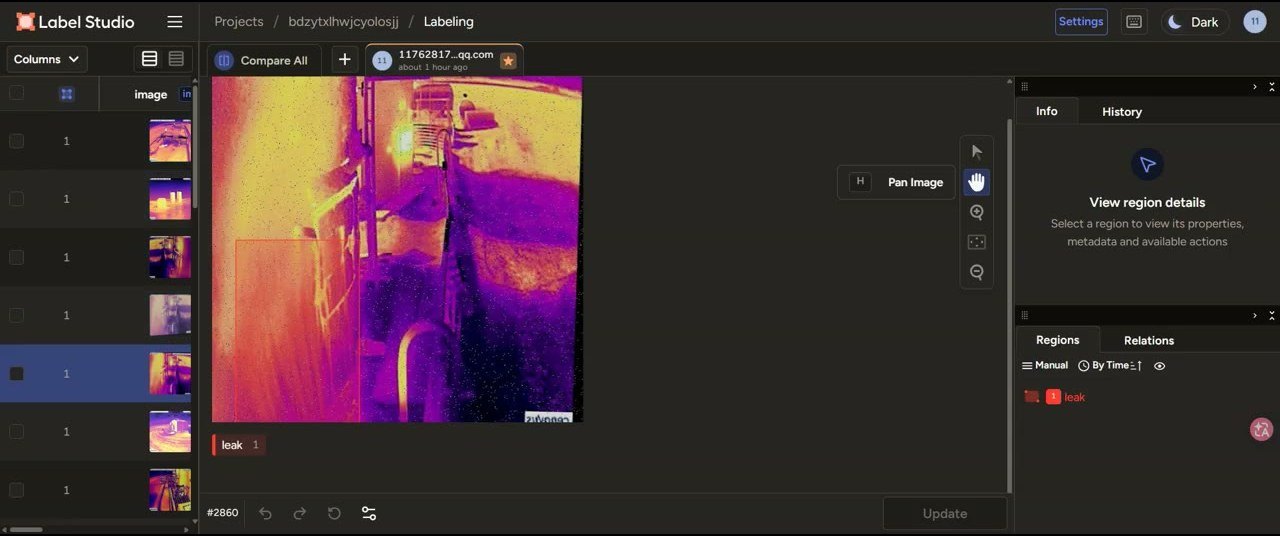
图 06 · Label Studio 标注工作台 · 任务列表与标注画布
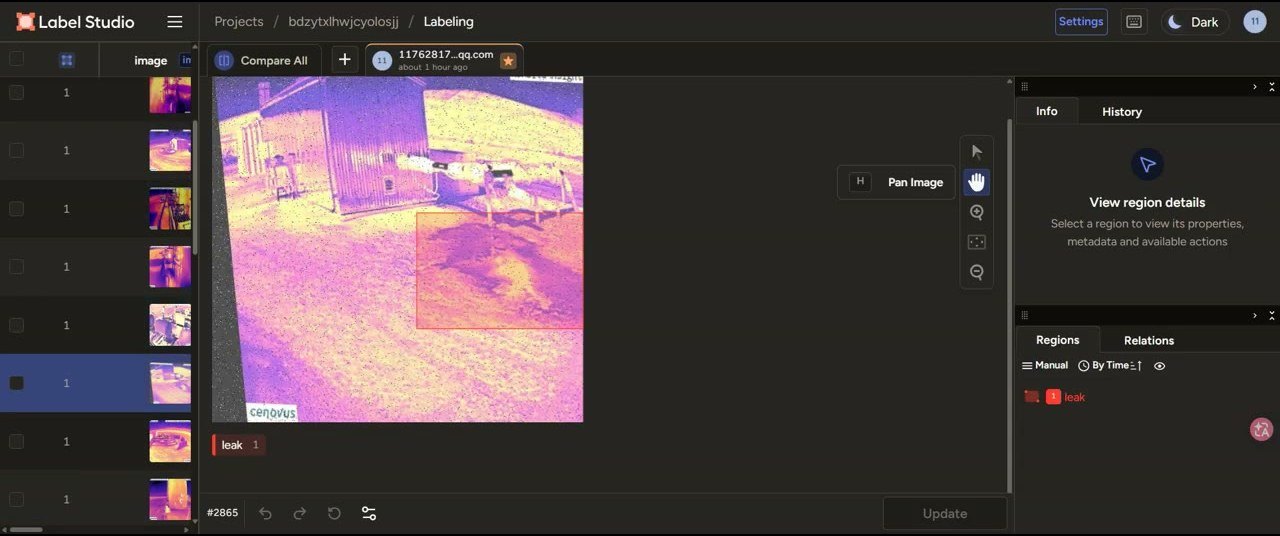
图 07 · Label Studio 标注工作台 · 检测框与类别标注
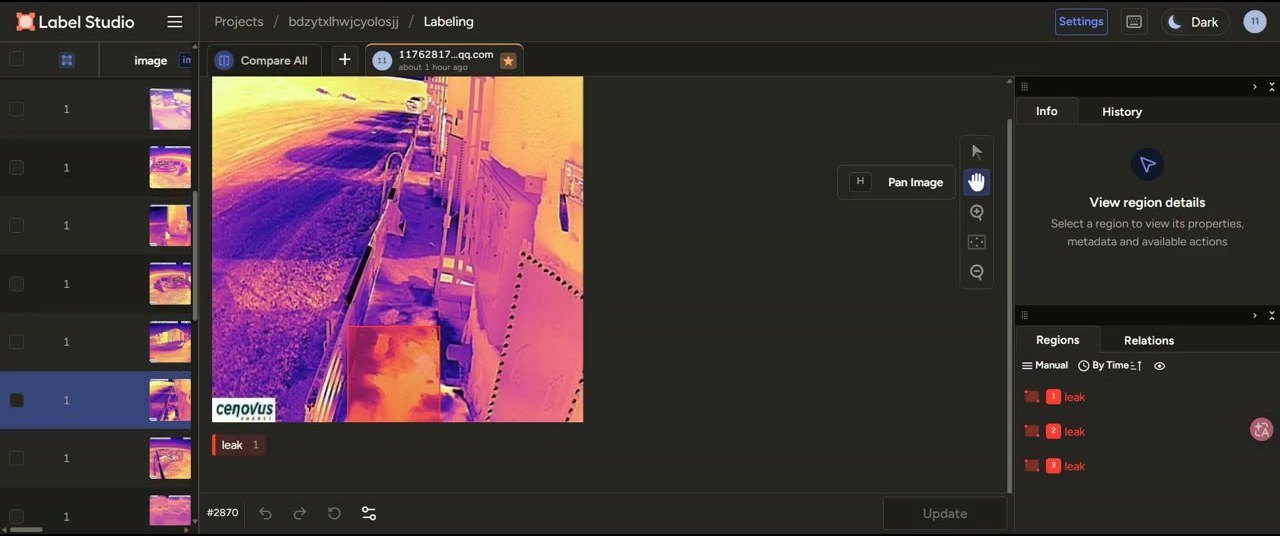
图 08 · Label Studio 标注工作台 · 标注区域与质检面板
从工程落地看,上面这条「数据整理—标注—训练—验证」链路也可以放到 ThinkCV 一体化训练平台上完成:数据集接入后,leak 等标注结果可直接对接训练任务,提交后由平台调度并自动生成模型,再经过模型评估、导出与下游对接,把推理中发现的难例回流数据集形成数据飞轮。它减少的是环境搭建和手工搬运的摩擦,模型效果仍取决于标注质量与场景覆盖。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号