变电站二次设备状态检测工程实践:基于 YOLO11 的数据采集、训练与复核闭环
原创
变电站二次设备状态检测工程实践:基于 YOLO11 的数据采集、训练与复核闭环
原创
用户8779533
发布于 2026-11-22 18:37:50
发布于 2026-11-22 18:37:50
变电站二次设备(压板、空开、指示灯、面板显示等)的状态巡检长期依赖人工目视核对。这类目标尺寸小、外观相似度高、背景金属纹理复杂,且不同光照与拍摄角度下成像差异明显,单纯依靠人工既耗时又容易出现漏判。将目标检测模型引入巡检链路,可以把"逐屏核对"转变为"模型初筛 + 人工复核"的模式,既保留人工判断的最终决策权,又显著压缩重复劳动。
本文围绕一套变电站缺陷类数据集,梳理从视频抽帧、对象存储管理、Label Studio 标注、YOLO11 训练到推理与上线前验证的完整工程闭环,并给出可迁移的配置示例与风险提示。文章重点在于流程可复现性,而非某一项指标的绝对值。
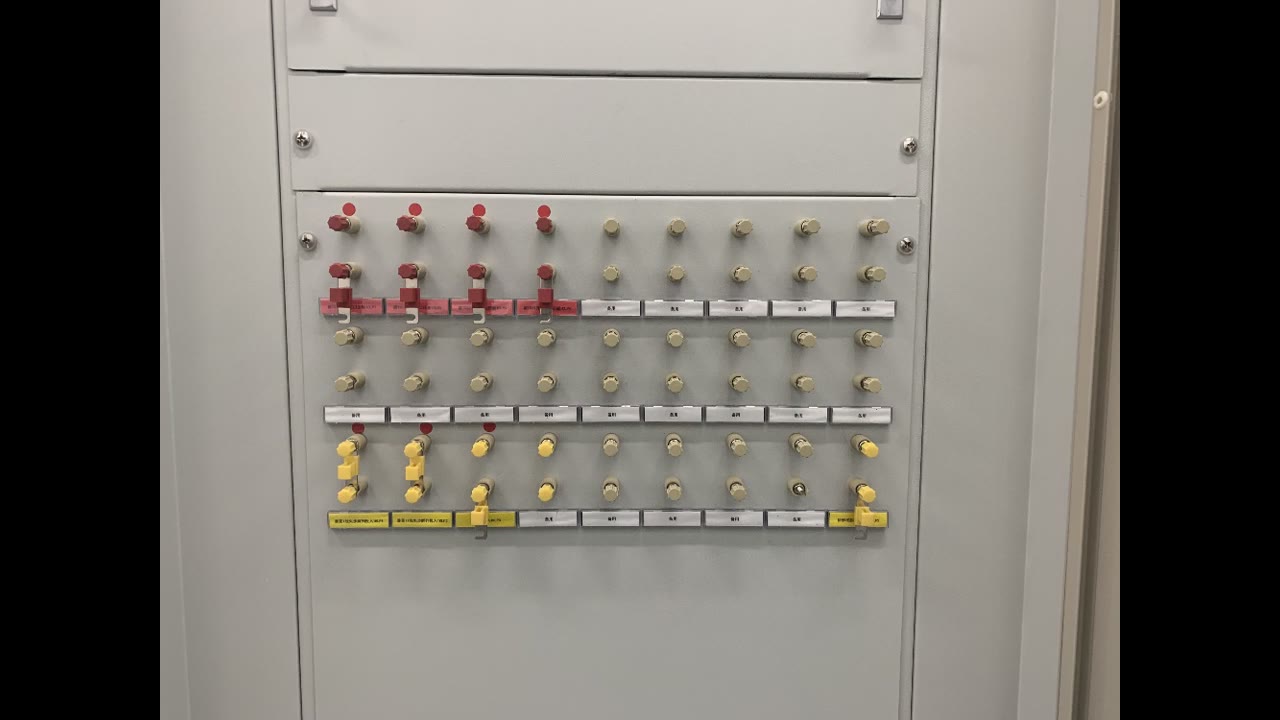
变电站缺陷类数据集 原始样本抽帧
行业需求与任务定位
二次设备屏柜是变电站运维的高频检查对象。压板投退状态、空开分合位置、指示灯亮灭、面板显示是否异常,直接关系到保护逻辑的正确性。传统巡检方式存在三个痛点:
- 目标密集且相似:同一屏柜上往往排列数十个外观接近的压板与空开,人工核对容易串行误读;
- 状态语义依赖上下文:同一部件在不同工况下的"正常"形态不同,需要结合标签文本与位置关系判断;
- 记录难以结构化:纸质或口头记录不利于后续追溯与统计分析。
目标检测模型的价值在于把屏柜画面中的关键部件定位出来,输出类别与置信度,形成结构化记录,供运维人员在复核界面逐条确认。需要强调的是,模型输出应定位为"辅助提示",最终处置仍由具备资质的人员完成。
数据集说明(来源:数据集说明表)
本节信息依据数据集说明表整理,仅保留可验证的客观描述。
- 数据集名称:变电站缺陷类数据集,面向二次设备指示状态异常场景,覆盖压板状态、空开状态、指示灯与面板显示异常等检查项。
- 标注格式:YOLO 格式,如需其他格式可另行转换。
- 类别数量:7 个类别,类别标识为
substation_defect_0至substation_defect_6,说明表中同时给出了各类别的标签数量,从数百到数千不等,类别分布存在明显不均衡。 - 数据规模:说明表标注的标签总量较大;当前工程批次中用于标注与预览的样本为 100 张图片,对应 100 个 Label Studio 任务,并配套一段由这些图片合成的预览视频。
- 数据特点:说明表明确标注"无任何数据增强",图像为高清图片。这意味着训练阶段的数据增强策略需要由使用方自行设计,不能假设数据已具备多样性。
- 适用任务:变电站巡检、电力设备运维等场景下的目标检测与状态识别,可作为算法验证与流程打样的基础数据。
由于类别数量分布不均衡,训练时不宜直接采用默认的类别权重,建议结合过采样、损失加权或分层划分来缓解长尾问题。
样本特征分析与标注策略
从样本抽帧看,画面以屏柜正面近景为主,目标呈现以下特征:
- 小目标占比高:单个压板或指示灯的像素面积有限,输入分辨率过低时容易丢失细节,建议训练分辨率不低于 640,必要时提升至 960 或 1280;
- 类内差异小、类间差异大:同类部件在不同屏柜上的外观高度一致,但不同类别之间可能仅靠颜色或位置区分,模型容易在高相似度部件间混淆;
- 背景干扰:金属面板反光、丝印文字、线缆走线都会形成干扰纹理,需要在标注时严格贴合目标边界,避免把背景纹理纳入框内;
- 拍摄条件波动:不同批次的图片在曝光、白平衡、拍摄距离上存在差异,这是后续做增强设计的主要依据。
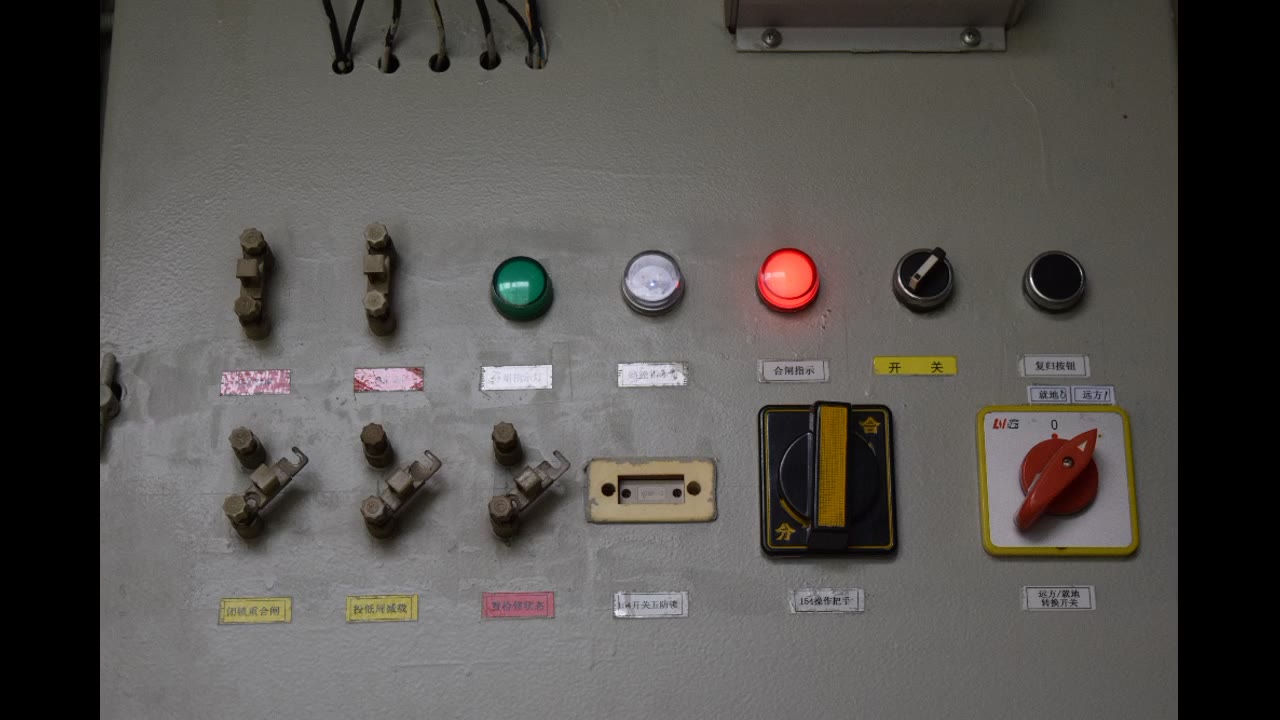
变电站缺陷类数据集 原始样本抽帧
标注环节采用 Label Studio 完成,标注配置以 XML 形式管理,导出为 JSON 后再转换为 YOLO 格式。工程上建议把标注文件与图片统一走对象存储(如 COS)管理,标注 JSON 中保留 OSS 图片地址,这样标注、训练、推理三端引用的是同一份资源,避免本地路径漂移导致的样本丢失。
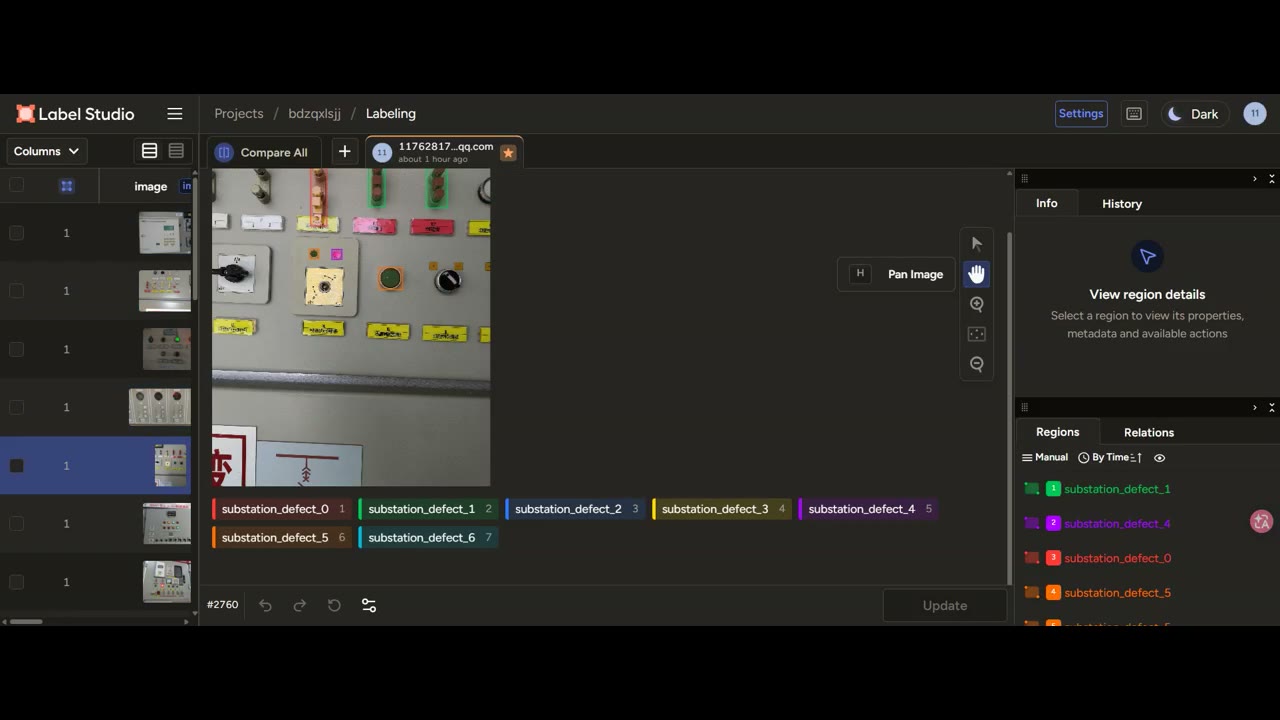
变电站缺陷类数据集 标注界面示例
标注质量控制建议关注三点:一是对同一屏柜的多张图片保持类别定义一致;二是对遮挡、反光严重的样本单独标记,决定是剔除还是保留;三是定期做交叉复核,抽取一定比例样本由第二人重标,统计一致性。
训练与推理链路
整体链路可以概括为:视频抽帧 → 对象存储归档 → Label Studio 标注 → 格式转换与数据集划分 → YOLO11 训练 → 验证集评估 → 推理服务与复核界面。
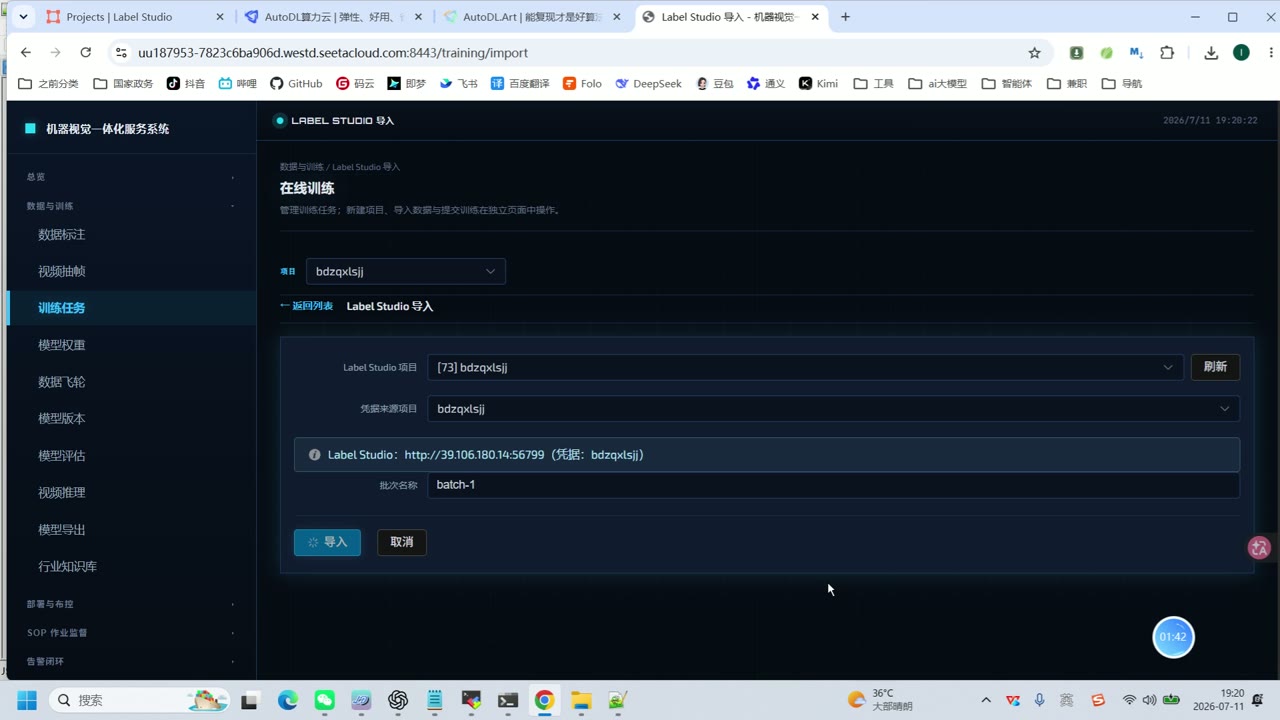
变电站缺陷类数据集 模型训练操作界面
数据准备阶段,按场景或屏柜维度划分训练集、验证集与测试集,避免同一屏柜的近似帧同时出现在训练与验证中造成指标虚高。目录结构遵循 YOLO 约定:
dataset/
├── images/
│   ├── train/
│   └── val/
├── labels/
│   ├── train/
│   └── val/
└── data.yaml
data.yaml 中显式声明类别名称与路径:
path: ./dataset
train: images/train
val: images/val
names:
  0: substation_defect_0
  1: substation_defect_1
  2: substation_defect_2
  3: substation_defect_3
  4: substation_defect_4
  5: substation_defect_5
  6: substation_defect_6
训练配置以 YOLO11 为基线,示例参数如下,实际取值需结合显存与数据规模调整:
model: yolo11m.pt
data: data.yaml
epochs: 100
imgsz: 960
batch: 16
optimizer: AdamW
lr0: 0.001
lrf: 0.01
warmup_epochs: 3
mosaic: 1.0
close_mosaic: 10
hsv_h: 0.015
hsv_s: 0.7
hsv_v: 0.4
degrees: 0.0
translate: 0.1
scale: 0.5
fliplr: 0.5由于原始数据未经增强,mosaic、色彩扰动与尺度变换是提升泛化能力的主要手段;但要注意水平翻转对带有方向语义的部件可能引入错误标签,若类别定义与左右方向相关,应关闭 fliplr。close_mosaic 在训练末期关闭马赛克增强,有助于模型收敛到更贴近真实分布的形态。
推理阶段保持与训练一致的预处理,输出检测框、类别与置信度。对于屏柜场景,建议在推理后增加一层基于位置关系的后处理,例如按行、按列对检测框排序,使复核界面中的条目顺序与物理布局一致,降低人工核对成本。
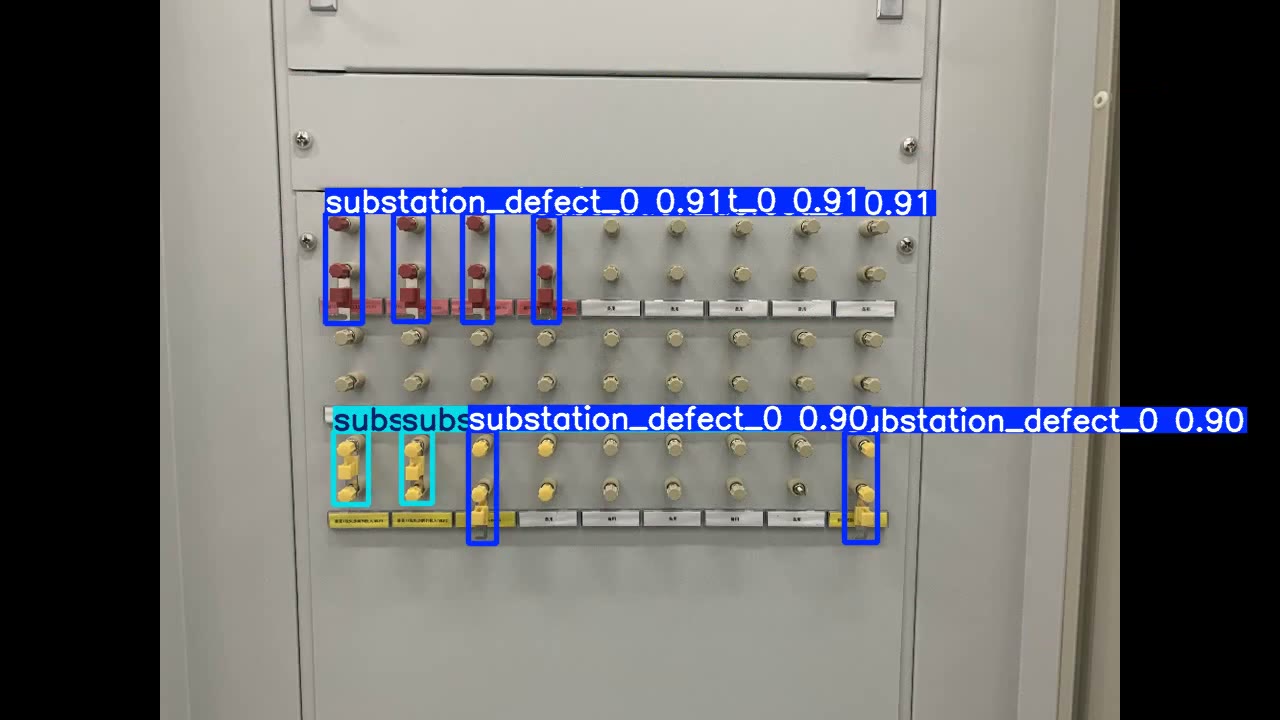
变电站缺陷类数据集 模型验证结果截图
上线前验证
模型进入实际巡检流程前,建议完成以下几类验证:
- 离线指标验证:在独立测试集上统计各类别的精确率、召回率与 mAP,重点关注样本量少的类别,避免被大类别的指标掩盖;
- 置信度分层分析:按置信度区间统计误检与漏检分布,确定复核界面中"高置信自动通过、低置信强制人工确认"的阈值策略;
- 场景鲁棒性验证:补充不同光照、不同拍摄距离、不同屏柜型号的样本,观察指标衰减幅度;
- 端到端时延验证:从图片上传、推理到结果回传的完整链路耗时,确认是否满足巡检节奏;
- 人机一致性验证:抽取一定数量样本,对比模型输出与人工复核结论,统计一致率与分歧类型。
验证过程中发现,部分类别在复杂或模糊场景下的置信度偏低,说明模型对成像质量的依赖较强。这类问题不应仅靠调阈值掩盖,而应从数据侧补充对应场景样本。
风险与优化方向
- 类别不均衡:说明表中的标签数量差异明显,长尾类别容易欠拟合。可通过分层采样、类别加权损失或针对性补采缓解。
- 小目标与高相似度部件:多个旋钮、按钮外观接近时误检率上升,建议提高输入分辨率,并在后处理中引入空间约束。
- 数据多样性不足:原始数据无增强,若采集来源单一,模型可能过拟合到特定屏柜样式。应持续补充不同厂家、不同型号的设备画面。
- 标注一致性风险:类别定义模糊会直接传导为标签噪声,需维护统一的标注规范文档并定期校准。
- 复核流程设计:模型输出必须可追溯,建议记录每次推理的模型版本、输入图片地址与置信度,便于问题回溯。
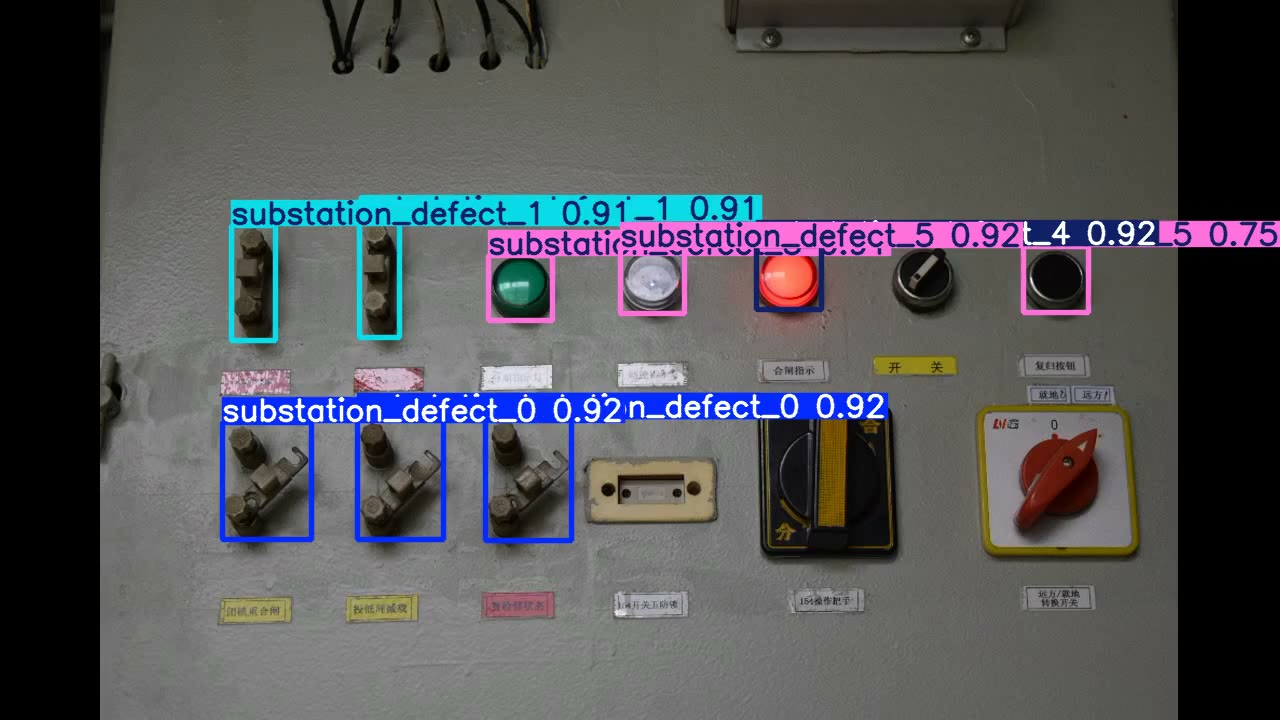
变电站缺陷类数据集 模型验证结果截图
从工程落地看,上面这条「数据整理—标注—训练—验证」链路也可以放到 ThinkCV 一体化训练平台上完成:数据集接入后,substation_defect_0、substation_defect_1、substation_defect_2、substation_defect_3、substation_defect_4、substation_defect_5 等标注结果可直接对接训练任务,提交后由平台调度并自动生成模型,再经过模型评估、导出与下游对接,把推理中发现的难例回流数据集形成数据飞轮。它减少的是环境搭建和手工搬运的摩擦,模型效果仍取决于标注质量与场景覆盖。
总结
变电站二次设备状态检测的工程难点不在于选一个检测模型,而在于把数据采集、存储、标注、训练、推理与复核串成可复现、可追溯的闭环。本文以 YOLO11 为训练基线,结合变电站缺陷类数据集的客观信息,给出了数据组织、配置示例与验证清单。实践中应把模型定位为辅助工具,通过置信度分层与人工复核相结合的方式控制风险,并持续用真实场景样本驱动迭代。对于希望迁移该方案的团队,建议优先解决类别不均衡与标注一致性问题,这两项对最终可用性的影响往往大于模型结构的选择。
附:样本与标注图集
以下图片均取自该数据集真实样本、YOLO 标注效果图与 Label Studio 标注工作台界面,用于对照上文的数据组织与标注流程说明。
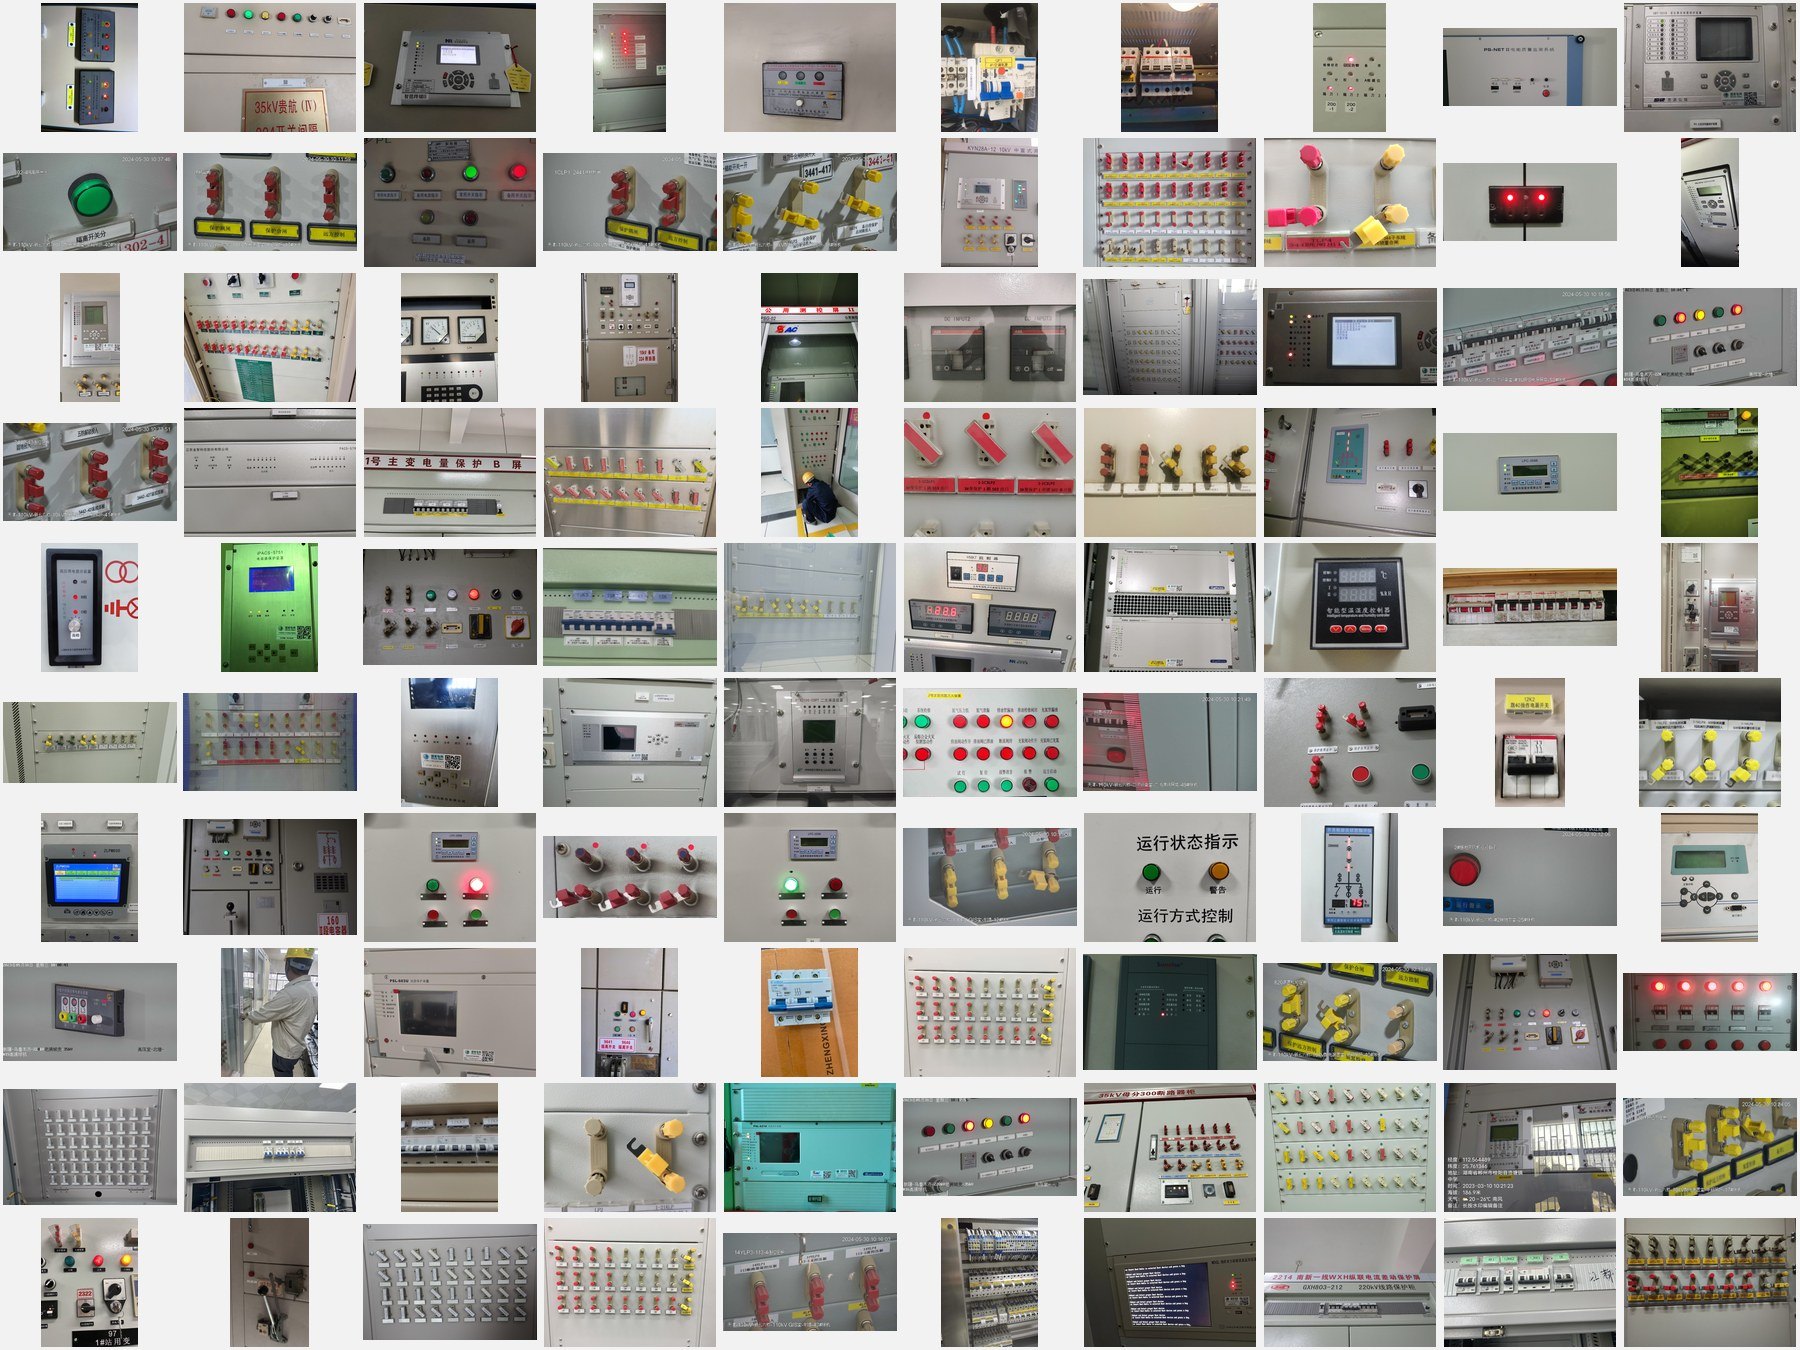
图 01 · 前 100 张样本总览(真实数据压缩包内抽取)
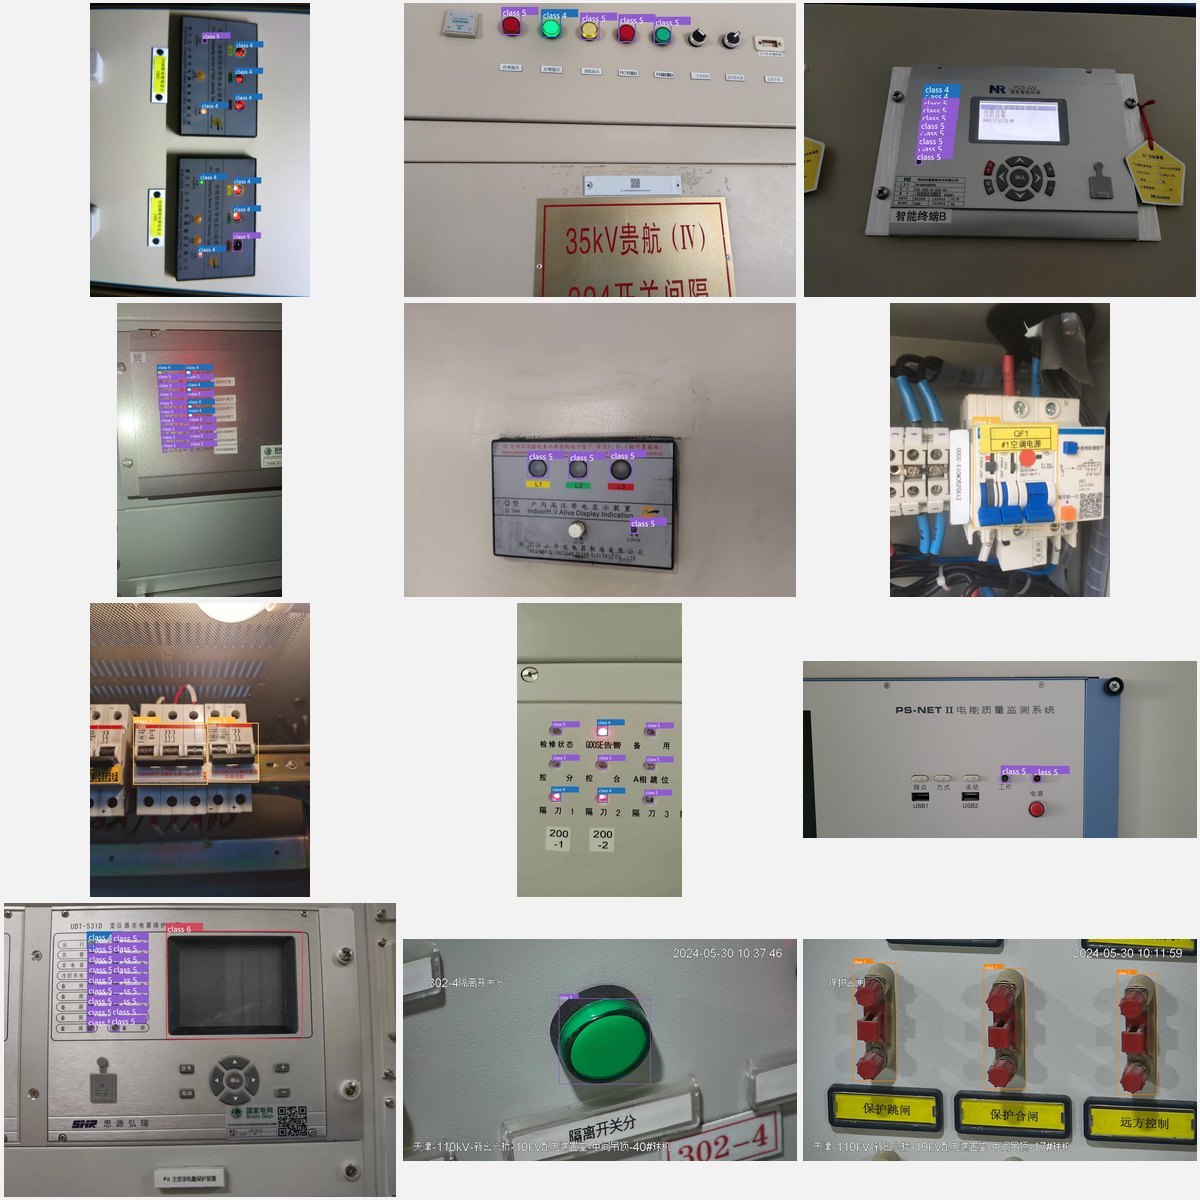
图 02 · YOLO 标注效果展示(一)· 检测框 + 类别标签
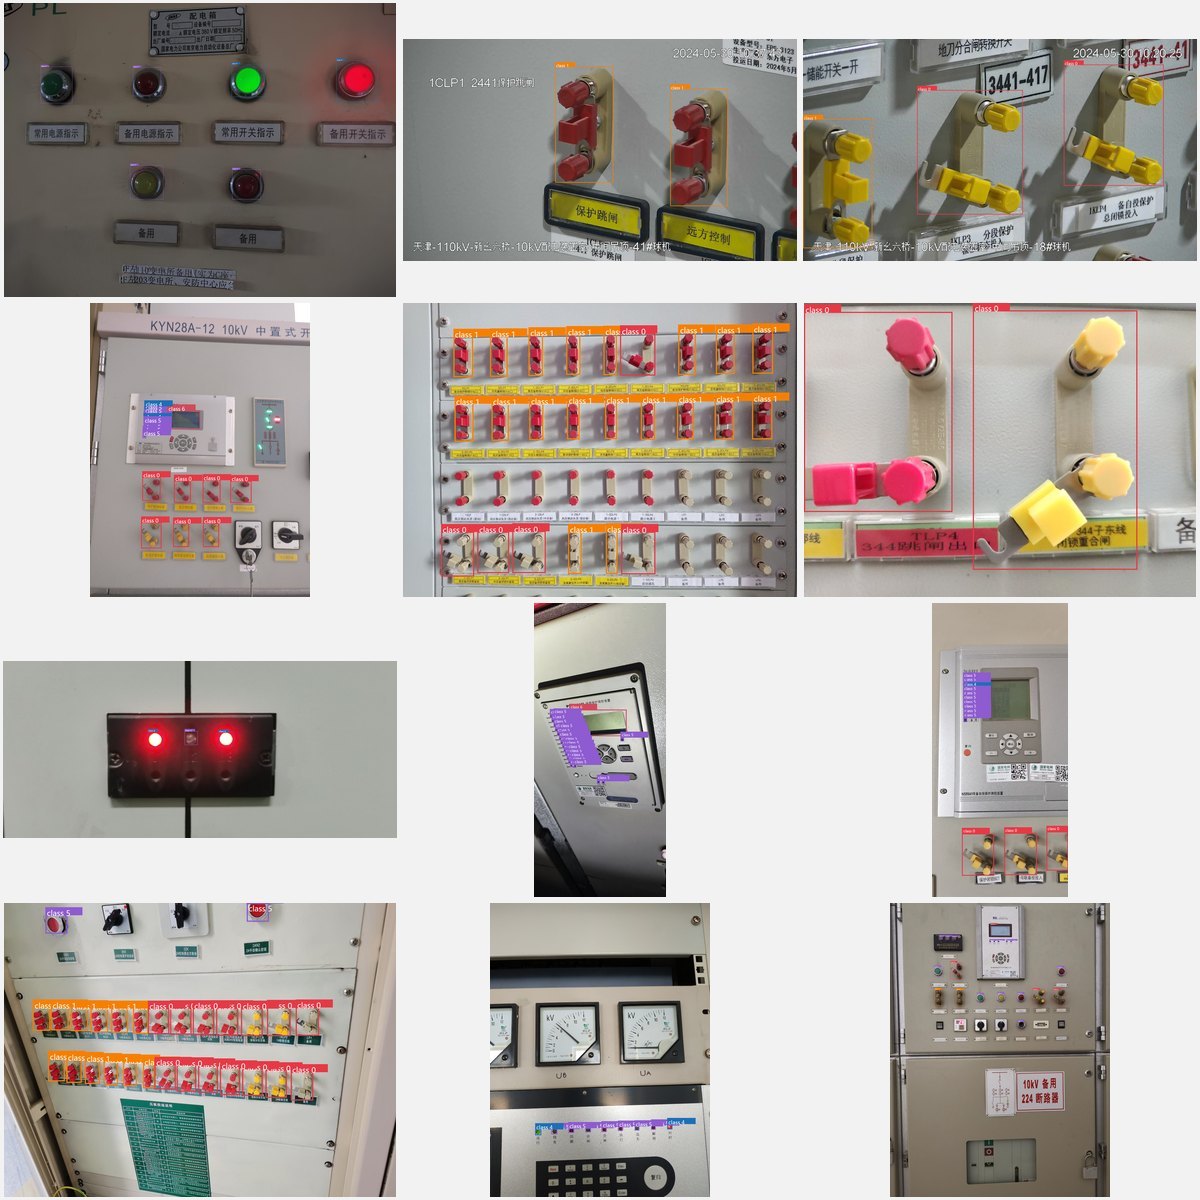
图 03 · YOLO 标注效果展示(二)· 不同场景样本
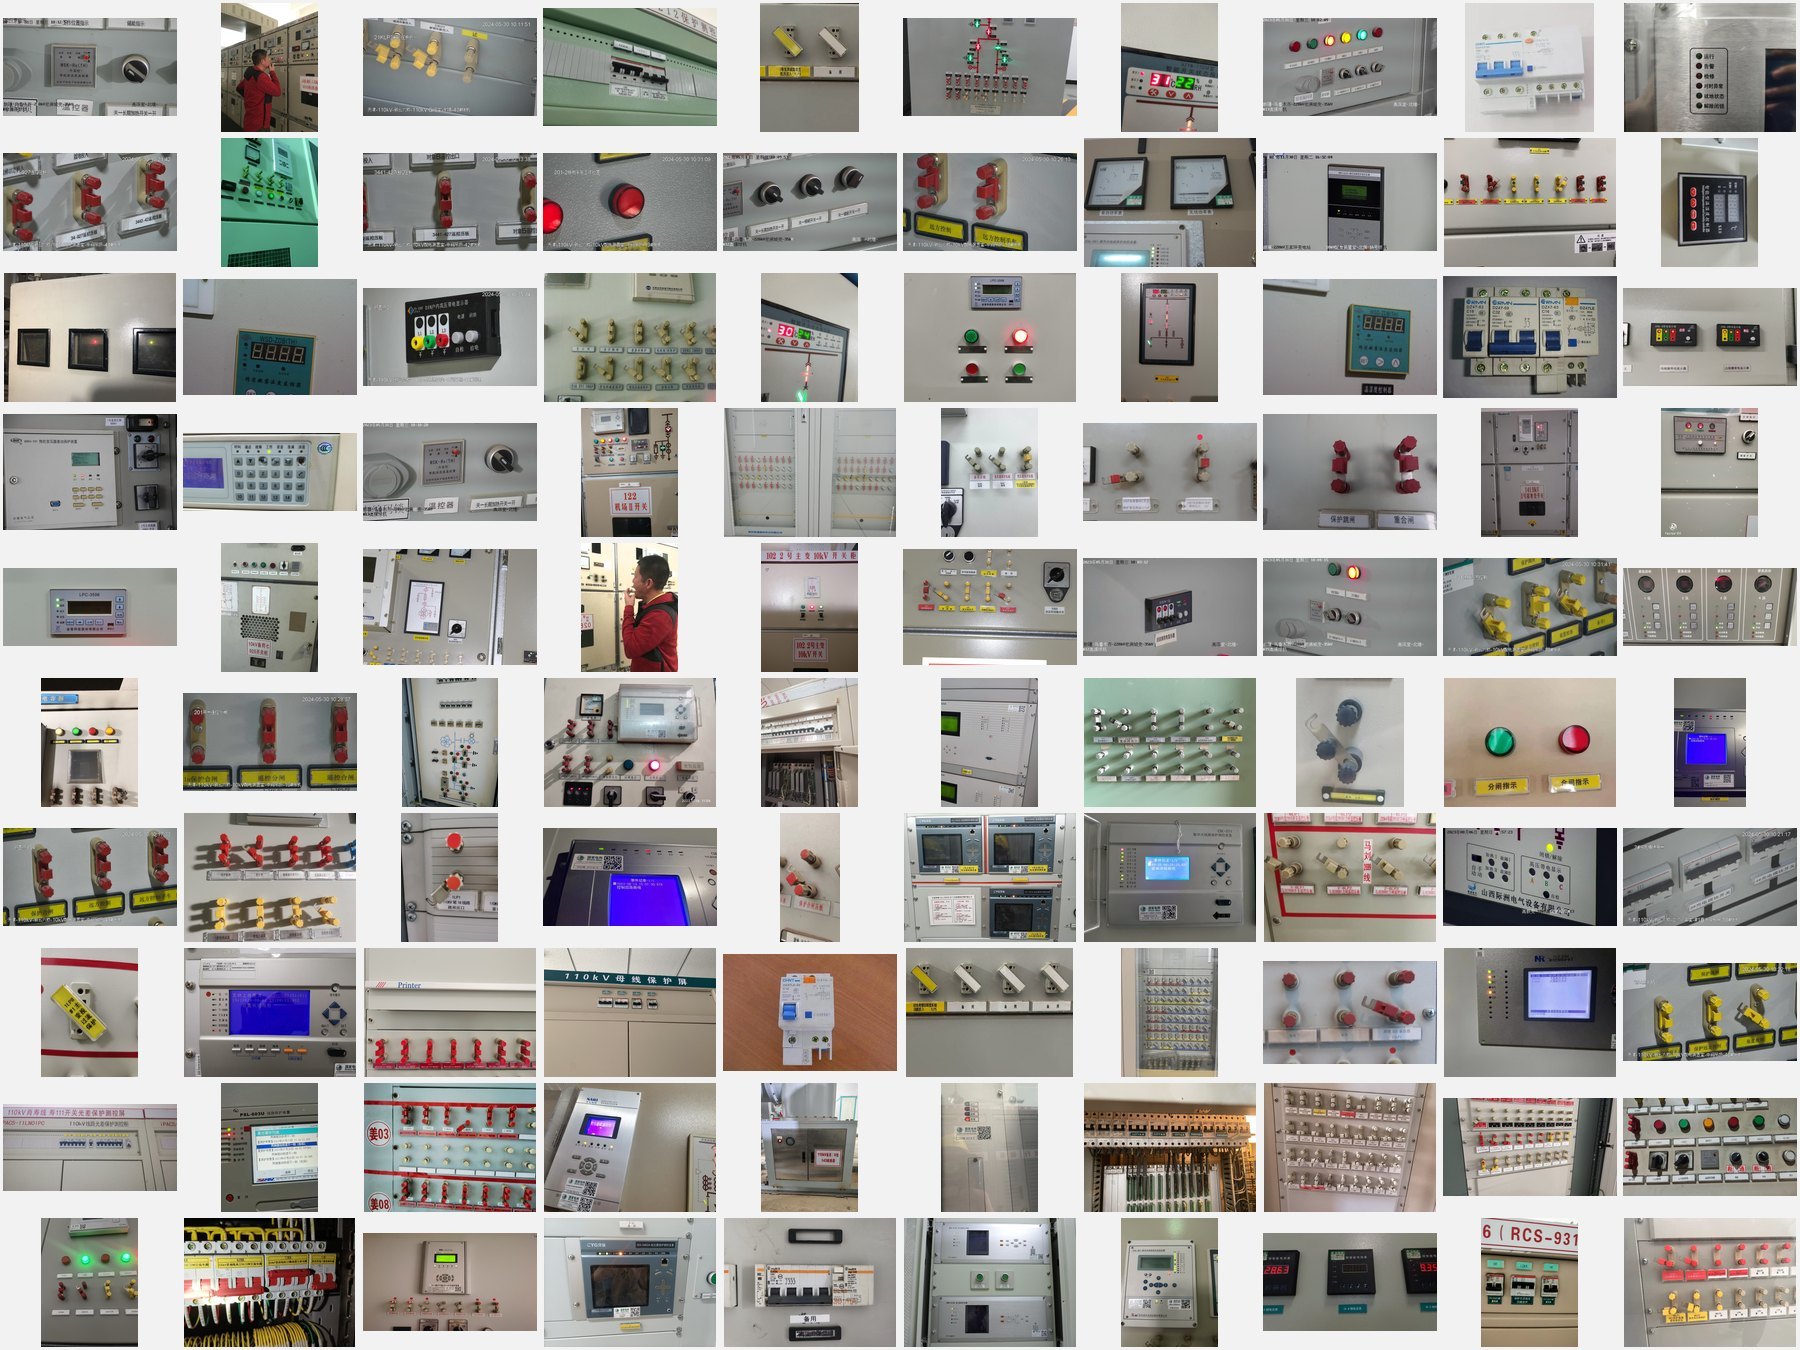
图 04 · 样本总览(第 101–200 张)
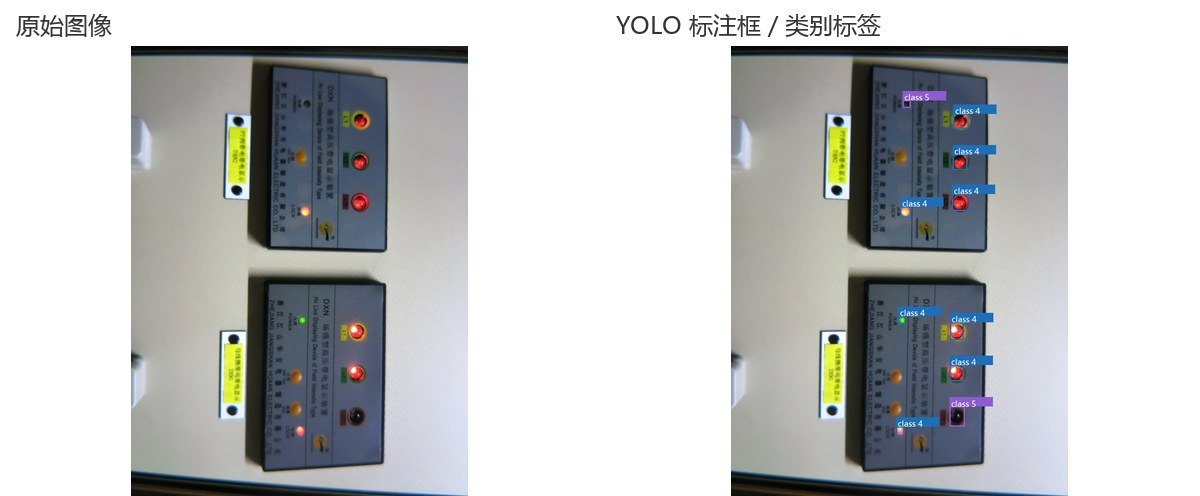
图 05 · 标注细节对比 · 左原始图像 / 右标注结果
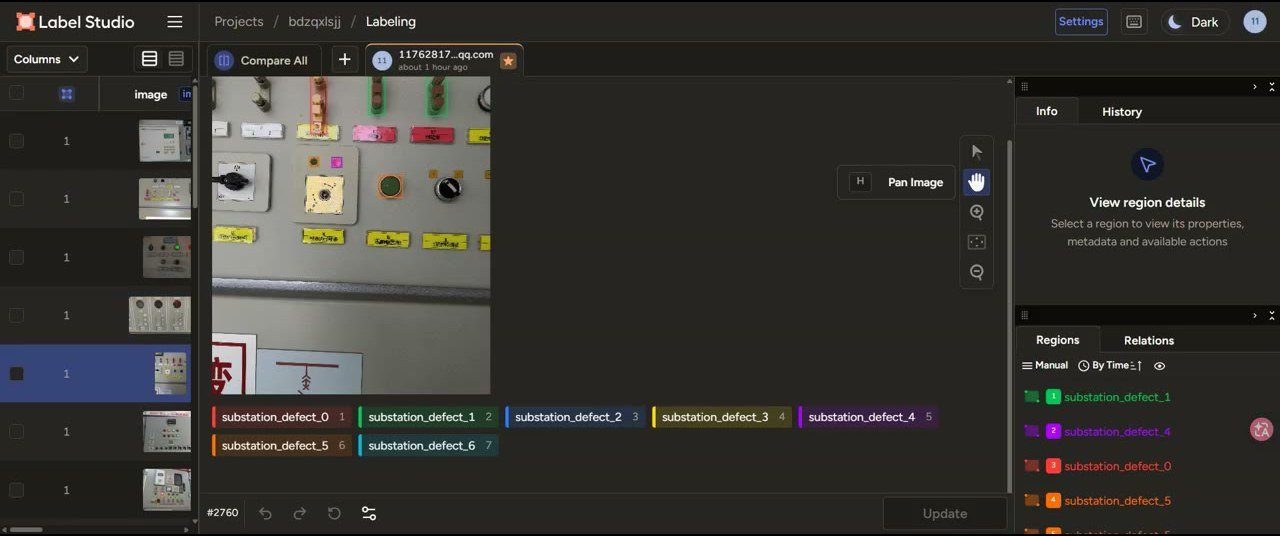
图 06 · Label Studio 标注工作台 · 任务列表与标注画布
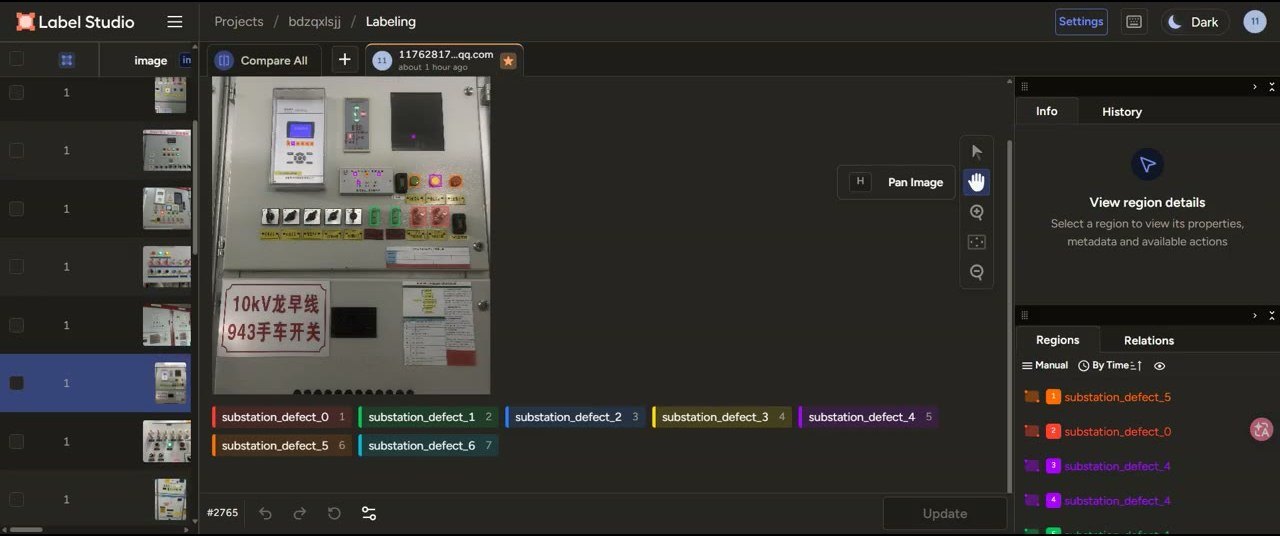
图 07 · Label Studio 标注工作台 · 检测框与类别标注
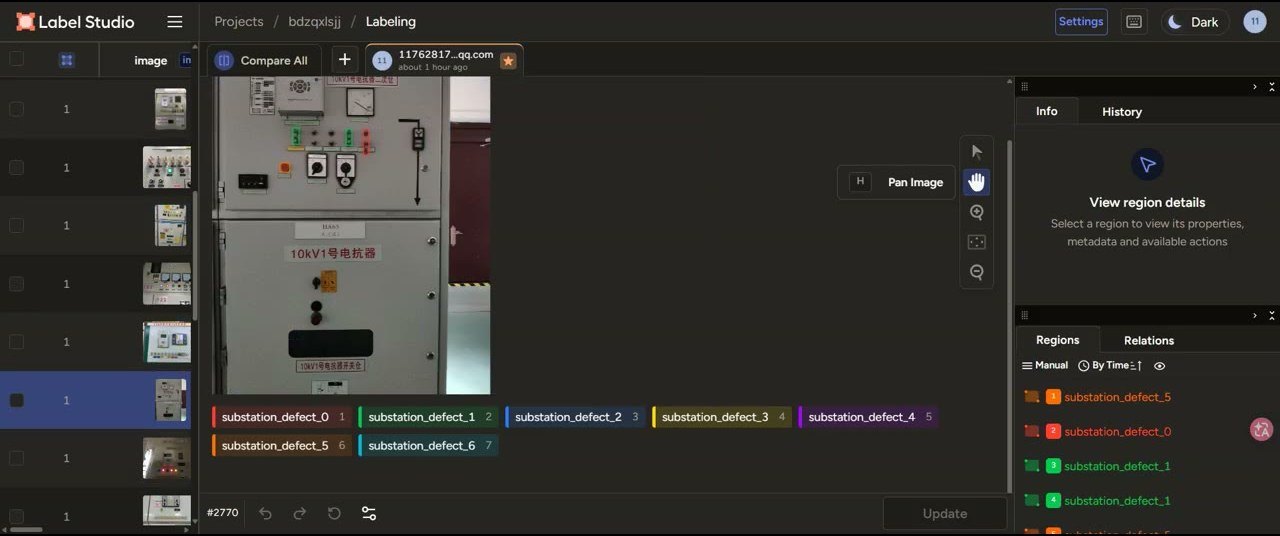
图 08 · Label Studio 标注工作台 · 标注区域与质检面板
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号