最简 RAG 打平 SOTA:Agent 记忆不是检索题
原创
最简 RAG 打平 SOTA:Agent 记忆不是检索题
原创
顺势而为
发布于 2026-11-22 20:52:08
发布于 2026-11-22 20:52:08
摘要:最简 RAG 在标准记忆基准上打平 SOTA,八千条真实轨迹里记忆却大多没被用上。问题不在架构不够复杂,而在尺子只量到检索闸门:送达不等于使用,能改变下一步动作的才叫记忆。本文用十一月五篇一手论文拆开三段链路,给出可落地的验收集。
一位欧洲客户三个月前投诉过:某型号开门机在低温下限位失灵。售后智能体把那封邮件存进了长期记忆,这次客户又来问同一型号,检索也确实命中了那封旧邮件。
然后,它生成的英文回复,还是那套标准排查模板。
记忆送达了,动作没变。(示意场景)
过去两年,我们给 Agent 加记忆的方式,几乎是往同一个方向使劲:抽取事实、改写覆盖、反思总结、建知识图谱,写入侧越堆越厚。2026 年 10 到 11 月,一批一手实测把这套做法的底牌翻开了——不是"记忆没用",而是我们一直在用一把只量到第二道闸门的尺子,给整条链路打分。
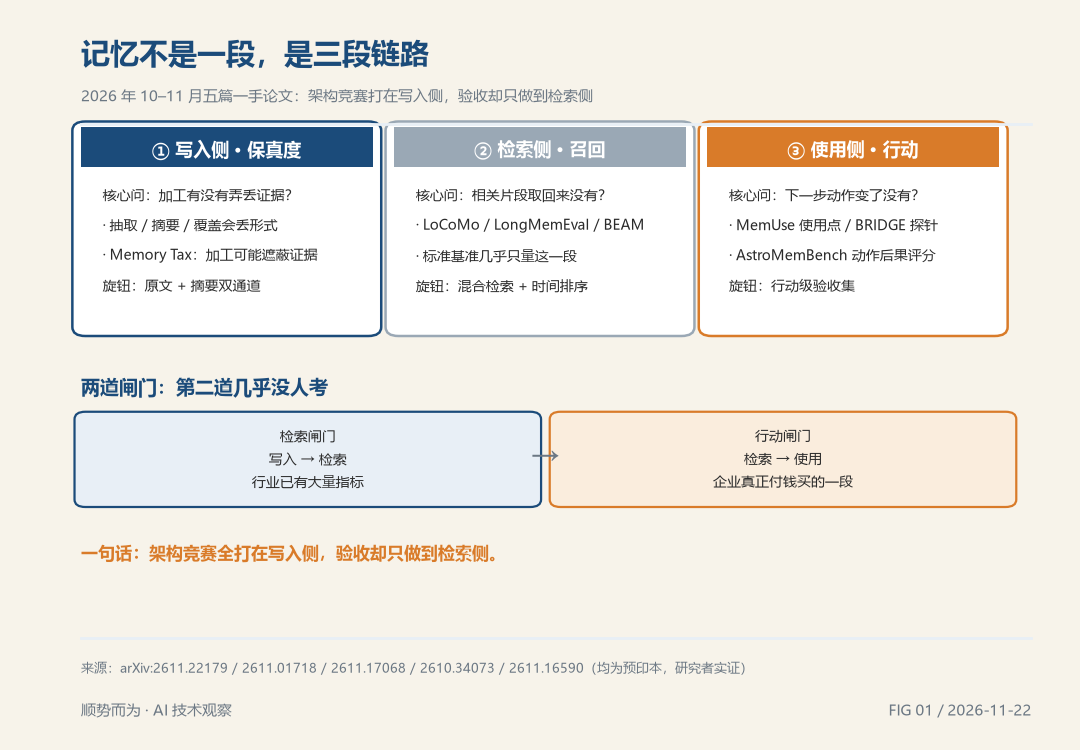
图 1 记忆系统的三段链路与两道闸门:标准基准几乎只量中间那一段
01 先把三笔账分开
先划清边界,免得把三件事混成一件。
此前聊过"上下文腐烂":单次请求窗口里,长得像答案的干扰项会争抢注意力,解法是去重、压缩、短窗口重启。那是输入侧、同窗口内的问题,不需要外部存储。
也聊过"RAG 证据闸门":检索到了不等于答得出,那是一次问答里的门控问题。
今天说的是第三件事:跨会话的外部记忆系统。它由三段串成——
- 写入侧:把原始交互加工成事实、摘要、图谱,代价是可能丢证据;
- 检索侧:查询时把相关片段取回来,标准基准几乎只量这一段;
- 使用侧:取回来的证据,有没有改变 Agent 下一步的决策或动作。
前两段之间有一道检索闸门,后两段之间有一道行动闸门。企业真正付钱买的是第三段的产出,可行业里绝大多数榜单、选型对比和验收用例,考的都是第二段。
一句话:架构竞赛全打在写入侧,验收却只做到检索侧,最值钱的那一段没人考。
02 最简 RAG 打平 SOTA
先看最扎心的一组数字。
arXiv:2611.22179《RAG in a Trenchcoat》投中 NeurIPS 2026 主会(11-17 提交),作者把复杂记忆模块全拆了,只留一个叫 BRIDGE 的极简 RAG——
- 按自然边界把对话切块,每块生成一条观察笔记,抽取时让它看见前 10 条笔记;
- BM25 与余弦各取 top 60,用 RRF 融合,索引里同时放笔记和原文;
- 取回 10 块,其中 3 块给原文、7 块给摘要,最后按时间先后重新排好再交给模型。
没有图数据库,没有覆盖层,没有反思步骤,没有图合成,也没有工作记忆缓存。每次写入一次抽取调用,每次查询一次读取调用。
结果呢?在 LongMemEval-S 与 BEAM 上,它与已发表的最佳系统在 bootstrap 置信区间内打平;在 EverMemBench 上,反而超出最佳记忆基线 5.7 到 6.3 分,且差异落在置信区间之外。
数据卡片|BRIDGE:极简 RAG 的标准基准成绩 LongMemEval-S:落后 EmergenceMem 1.4 分,95% CI 重叠 → 作者判为「打平」而非「胜出」 BEAM 100K 十能力均值:0.370±0.006 vs LIGHT 0.345;剔除 Event Ordering 后 0.360±0.007 vs 0.375 EverMemBench:反超 MemOS 5.7 分(gpt-4.1-mini)/ 6.3 分(gemini-3-flash),超出 CI 成本:约 5–7K reader tokens/查询,比喂全上下文少 17–154 倍 口径:arXiv:2611.22179 官方摘要与全文;baseline 数字来自各系统已发表报告,prompt 深度、检索预算、分块仍各自为政,故作者只在 CI 内 claim parity,不 claim superiority
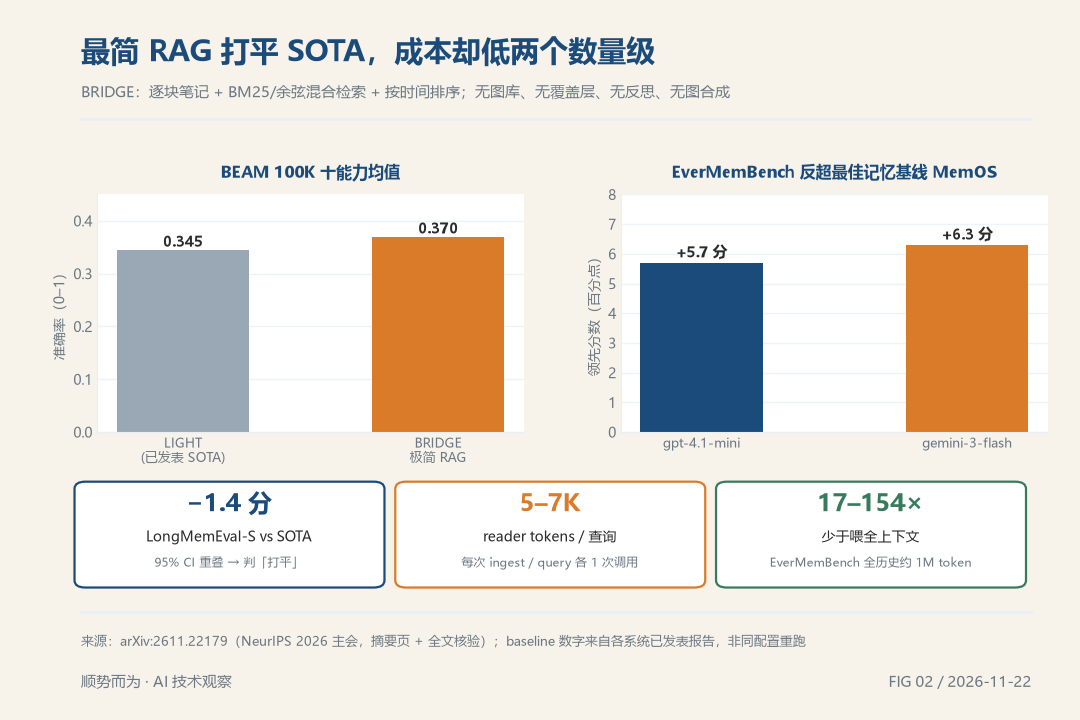
图 2 极简 RAG 在三个标准基准上的打平与反超,以及它的 token 成本
注意口径:这不是"RAG 打赢了所有记忆系统"的宣言,而是一次受控对齐——同一 reader、同一官方裁判,但各家提示深度与检索预算并不统一。作者自己把话说得很克制。
真正值得琢磨的,是他们怎么解释这个结果。
03 打平本身就是结论
论文里有一句几乎可以当标题用的话:"区分记忆设计的,不是它检索到了什么,而是它让 Agent 做成了什么。" 另一句更短:"检索到一条记忆,不等于使用了它。"
换句话说,打平不是因为 BRIDGE 更强,而是这些基准分辨不出记忆设计的好坏——它们量的是 what memory retrieves,不是 what memory enables when the agent acts。同一份历史,问答里答对就过关;至于这条事实有没有改变后续动作,题目里根本没设置需要它出手的时刻。
另一篇论文把这件事在真实轨迹里量了出来。arXiv:2611.01718《Delivered, Not Used》(2026-11-01)提出 MemUse:不看终点分数,而是回到每条记忆被送达的那一刻,比对该 Agent 当时已经能看到什么,再顺着后续动作追后果。规模是 8,000 条带记忆的 SWE-bench Verified episodes,加 2,000 条无记忆基线,覆盖全部 500 个任务、12 个 Python 仓库、每种配置各跑 4 次,涉及 MemGovern、Mem0 与 TencentDB Agent Memory 三套系统四个配置。
结果是:任务成功率 72.65%–73.35%,无记忆基线 72.95%,差异最多 0.4 个百分点,所有 95% 区间都包含 0。但每集成本从 0.0045 美元涨到 0.0049 美元(+8.8%),最贵的配置涨到 0.0178 美元(+293.2%)。
数据卡片|MemUse:终点指标看不出机制差异 任务成功率差异 ≤0.40pp,全部 95% 区间含 0;差异小于基线自身四次运行的波动(71.8–75.0%) 成本:+8.8%(MemGovern)~ +293.2%(TencentDB) 23.2%(89/383)有「有益记忆使用」的 episode 最终仍失败;5/16(31.3%)有「有害使用」的反而成功 口径:arXiv:2611.01718 官方摘要与全文;单一基准(软件修复),成本含记忆系统用量,部分 token 为估算
0.4 个百分点,和近三倍的账单。只看终点会得出"记忆可有可无",只看账单会得出"记忆纯属浪费"——两个都不对:终点指标把一整条机制压成了一个数字,压掉的恰是记忆存在的理由。
04 送达不等于使用
把镜头推到使用点,画面就清楚了:
- 平均每个片段里,71.5%–98.6% 的送达条目与当前任务无关;
- 在相关条目里,51.3%–79.7% 被 Agent 晾在一边,既没据此行动,也没被选择或引用;
- 真正 acted on 的,只占一个片段条目的 0.40%–4.08%;
- Mem0 有 78.2%、TencentDB 有 88.4% 的送达,只是在复述模型眼前还能看见的内容;光 Mem0 里这类"可见副本"就吃掉 68.1% 的送达 tokens。
714 条被真正采纳的条目里,421 条判为有益、16 条有害、64 条没有可观察效果,还有 213 条(29.8%)后果无法确定。有益条目只出现在 3.65%–7.05% 的 episode 里。
账单涨在送达,价值卡在使用。
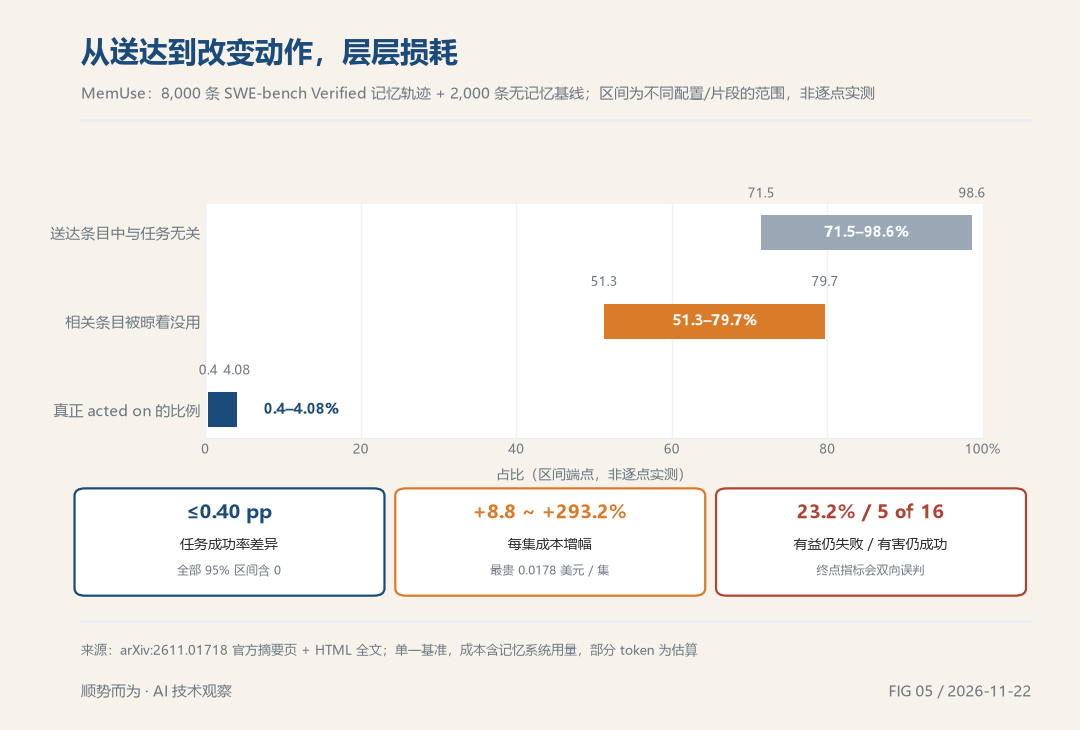
图 5 MemUse 使用漏斗:从送达到真正改变动作的层层损耗
这组数字还有个容易被忽略的推论:任务成败会双向骗人。23.2% 的 episode 里记忆确实帮了忙,任务照样失败;5/16 的记忆起了反作用,任务照样成功。所以"上线后成功率没掉"既不能证明记忆有用,也不能证明它无害。你需要看过程,而不只是看结果。
05 检索到了,为什么没照做
BRIDGE 团队接着做了一件更狠的事:设计五个对抗探针,每个 20 个场景,规则或模式只藏在历史里,当前请求绝口不提,而任务只有用上它才能解。评分针对生成的工作产物,不是关于历史的问答。
- RA+ / RA-(规则应用):历史里顺口说过"所有对外端点都要限流"或"事故后禁用 eval",新请求只说"加一个找回密码的端点";
- PI-S / PI-P(模式归纳):历史里从没明说规范,只在 4–6 次会话里演示过代码风格或事故处理步骤;
- DM(动态多轮):规则说过一次,五轮对话后最后一轮还用不用。
最关键的诊断出现在 RA+:规则所在那一块,在全部 20 个场景里都被检索到了;13 次失败中,有 12 次规则是以原文形式到达 reader 的。
也就是说,检索完全成功,失败发生在更后面——规则只是"十块笔记里的一句闲话",模型看见了,没当回事。
于是他们加了一次调用,把 BRIDGE 已经检索到的笔记里的常设规则抽出来,贴到上下文顶部一个带标签的区块里。存什么、取什么都没变,只改呈现方式:原始探针通过率从 52.6% 涨到 94.7%(对照 LangMem 80.0%、Oracle 90.0%),最难一档从 42.1% 到 78.9%。
数据卡片|只改呈现,不改检索 原始探针:BRIDGE 52.6 → 94.7(把 standing rules 置于上下文顶部) 最难档:42.1 → 78.9;对照组「泛化摘要」同样多花一次调用,原始探针反而降到 40.0 口径:arXiv:2611.22179 全文 Table 4;作者明确标注这是 diagnostic rather than a method,且最难档的摘要对照自身也恢复了大部分增益,故只声称定向呈现更优
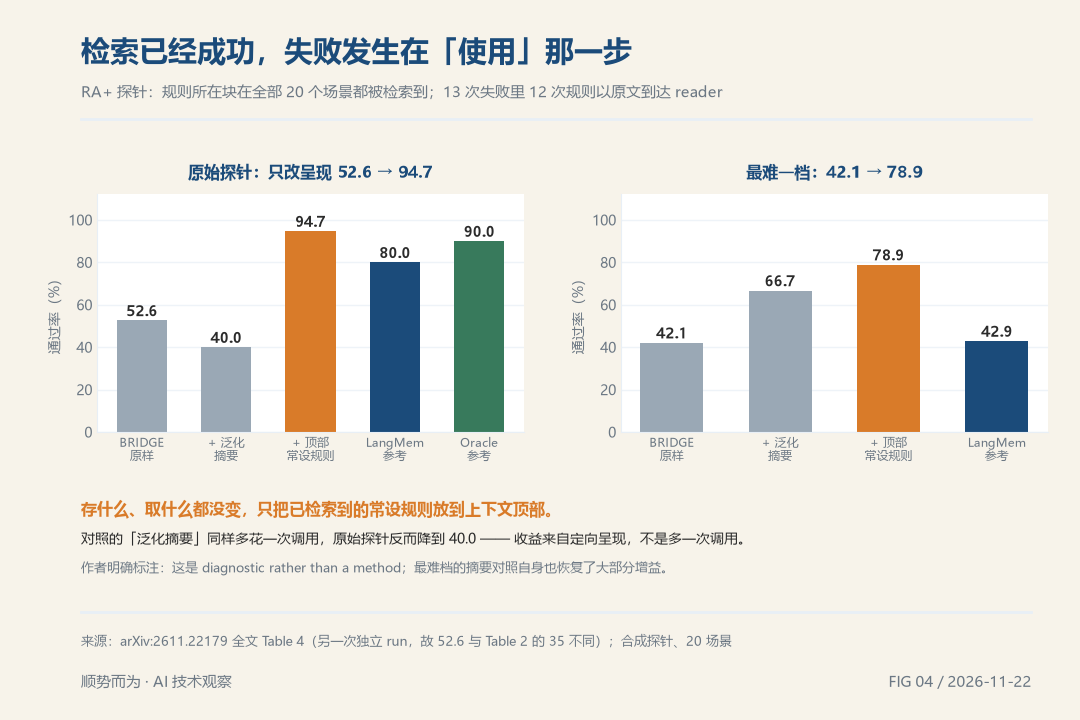
图 4 检索已成功、使用却失败:一次只改呈现方式的诊断实验
作者明说这是诊断而非方法。但它足以改掉一个归因习惯:下次记忆"没生效",先别急着换检索器,先确认那条规则有没有被放在模型无法忽略的位置。
06 没有架构全胜
如果故事停在"简单就好",那就太便宜了。五个探针给出的答案恰恰相反:
探针 | Mem0 | LangMem | Graphiti | BRIDGE | Oracle |
|---|---|---|---|---|---|
RA+ 规则应用 | 40% | 80% | 70% | 35% | 90% |
RA- 禁令应用 | 75% | 90% | 65% | 55% | 95% |
PI-S 风格归纳 | 46% | 47% | 76% | 81% | 95% |
PI-P 流程归纳 | 50% | 55% | 49% | 88% | 84% |
DM 多轮保持 | 55% | 75% | 70% | 40% | 95% |
LangMem 拿下两条规则应用和多轮保持,BRIDGE 拿下两条模式归纳,Mem0 与 Graphiti 一项未赢。RA+ 上 BRIDGE 输 45 分,PI-P 上它赢 33 分。
机制也不难懂:原子事实抽取把明说过的规则存成独立条目,所以规则应用强;但它丢掉了"演示的形状",而模式归纳恰恰要从形式里学。块级摘要保留了形状,却把规则埋进十条笔记里。作者换过四个领域(追加 87 个场景)、三个评委(81%–86% 判定一致)、三个 reader 家族,方向都保持。
有人会想:那就按请求分路,规则题给 LangMem、模式题给 BRIDGE。理论上限很诱人——完美路由 82.8%,最好的单系统 69.2%,差 13.6 分。可只读请求文本的分类器只有 49%–61%,不比永远猜多数类(60%)好。原因很朴素:请求里根本不提它依赖的那条记忆。
记忆的难点从来不是"存没存下",而是"该出手时,它自己会不会站出来"。
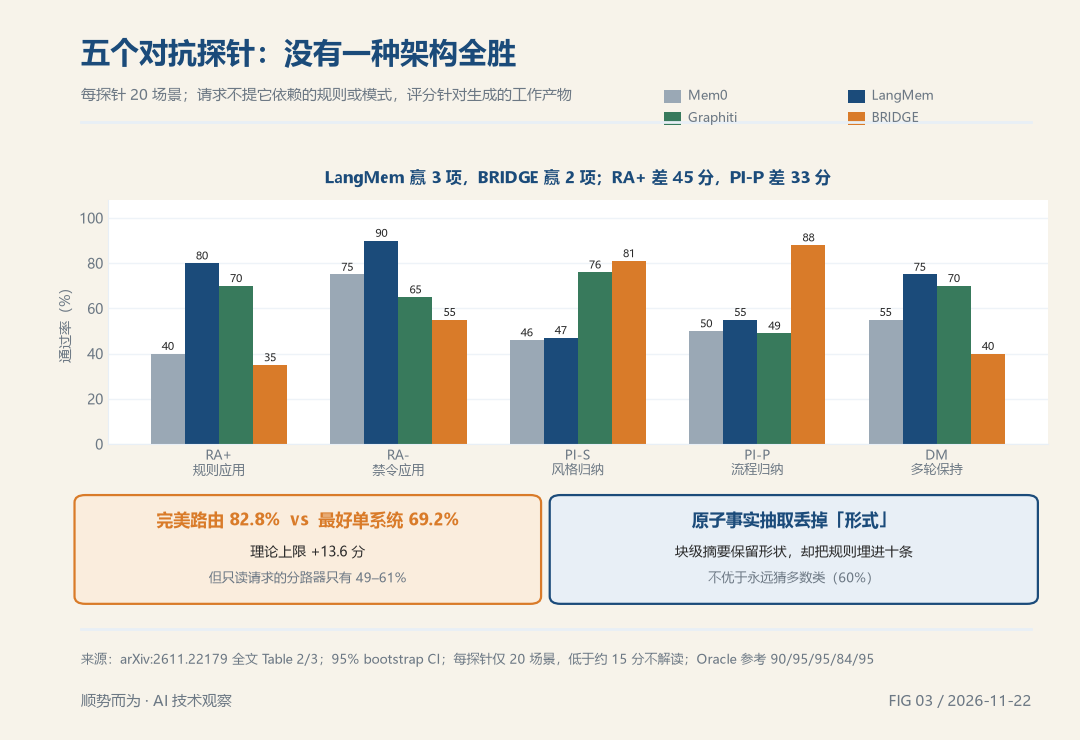
图 3 五个对抗探针的通过率:没有一种架构在所有任务上胜出
边界必须写清楚:每探针仅 20 场景,一个场景就能移动 5 分,作者明确说低于约 15 分不解读;场景为合成数据;裁判只查被记住的约束;DM 只跑一次;且都是固定输入输出测试,不是带工具、长期部署的活系统。
07 钱花错了地方
第三篇一手论文给了一个更实用的答案。arXiv:2611.17068(MAPE,2026-11-12)不再让人手写记忆架构,而是把记忆系统拆成 build / retrieve / compose / answer 四阶段,让 proposer 与诊断 agent 从"什么都不存"的最小种子开始演化整个程序。在 LoCoMo 与 LongMemEval 上,演化出的程序相对人工设计基线绝对准确率最高提升 12%,服务成本却只占 35%。
更值钱的是它从结果里反推出来的两条模式:
- 保留原始对话作为可检索证据——抽取出的原子笔记会漏掉细节,原文补得回来;
- 按查询意图编排检索到的证据(Query-Routed Scaffolding)——不是把 top-K 一股脑塞进去,而是先按问题类型组织好,再交给模型。
把第二条移植到 5 个已有的记忆系统里,只改证据怎么编排、不动各自的写入与检索,五个全部提升。还有一条容易被忽略:一旦把服务成本也写进搜索目标,计算会自动从"写入时让 LLM 慢慢建记忆"迁移到"查询时做选择性处理",准确率还守得住。
这和 arXiv:2610.34073《Memory Tax》(UIUC,2026-10-25)对上了。那篇论文把记忆相对直接检索原始历史的净值拆成 memory benefit 与 memory tax:加工本来是为了让证据更好用,但重组事实、蒸馏偏好的过程,也可能移除或遮蔽证据——这是双刃的偏离。中文社区流传的"11 个系统、99 组实验、90 组输给朴素 RAG"等具体组数来自二次转述,未在官方摘要中给出,本文不拿它当结论依据。
国内工程实践也在往同一方向收敛:稀土掘金一篇 mem0 生产总结写,图模式 p95 延迟 2.6 秒(向量模式 0.2 秒)、token 成本翻倍,还须部署图数据库,"说不出需要时序推理的具体场景,就不要启用"。社区经验,仅作定性参照。
把三篇放一起,顺序就反过来了:先保住原文(双通道)→ 再按意图编排证据 → 然后才考虑更复杂的写入架构。绝大多数团队的顺序恰好相反。
08 把验收挪到行动后果,别急着判死刑
基准本身太偏?有人已经把尺子换掉了。
arXiv:2611.16590《AstroMemBench》(2026-11-12)用确定性环境直接给动作打分:任务完成、状态变化、安全、资源使用,共 16 个记忆子挑战、140 个模板、2,240 个实例、9 类任务。结论很有层次:同一次会话内,Mem0、Chain-of-Memory、LightMem、RAG 都比原生 Agent 强,但三种记忆系统相对朴素 RAG 没有明显优势;会话重启之后,Mem0 才反超 RAG 12.25 分。收益集中在"指令保留、结果复用",而不是"持续状态跟踪、能量预留"。
再看反例:arXiv:2611.12068《MIRIX-2.0》(11-09)用六个分类型记忆 agent 加溯源超图与后台合并,5 个 QA 基准里 4 个最准,LoCoMo 91.4%、LongMemEval-S 72.6%,领先最强基线 14.3 分。作者自报、非独立复现,但足以说明:复杂架构不是没用,是它赢在哪些条件下必须说得出来。
所以本文的结论不是"别做记忆层",而是三句更窄的话:
- BRIDGE 自己在规则应用上输 45 分,说明"极简"不是万能;
- MAPE 用更复杂的搜索反而找到了更省更好的设计,说明"简单"也不是目的;
- 标准基准的口径分歧本身就很大(中文社区有复现指出裁判一收紧,几套系统分数普降 15–22 分——二次转述,未独立核验),所以别拿任何一个榜单分数当采购依据。
加上前述所有边界:多为预印本、单一基准、合成探针、20 场景、静态测试。任何"从此不用做记忆"或"记忆层已死"的推论,都超出了这些数据能支撑的范围。
09 落到企业:历史邮件不是记忆,能改变动作的才是
把这套尺子平移到最熟悉的场景:一家做庭院门开门机的制造企业,产品说明书、回复模板、历史售后邮件攒了一堆,每天几十到上百封英文邮件,客服团队十来位技术工程师,新人要半年才能独立回信。正在搭的 RAG 知识库和售后智能体,本质上就是一套跨会话记忆系统。
按三段链路,有三条纪律值得先落地:
第一,原文与摘要双通道,别在写入侧把证据压没。 客户那句"上次低温限位失灵,换过控制板"压成"客户投诉过质量问题",形式就没了。BRIDGE 取回 10 块里固定给 3 块原文,MAPE 要求保留原始对话轮次——Memory Tax 就产生在这一步。
第二,按意图编排,而不是把 top-K 倒进提示词。 把查询先分到"故障诊断 / 订单库存 / 保修条款 / 情感安抚"等意图,各配一个证据模板与固定的常设规则区。这里可以沿用一条老纪律——模型提议、确定性代码裁决——但轴不同:11-14 那篇管的是"允许做什么",这里管的是"证据该怎么摆"。
第三,把验收集写成"查询里不提规则"的题。 这是最容易被跳过、也最值钱的一步。示意如下(示意代码,非论文方法):
# 行动级验收集:题目不提规则,只判产物有没有改变
case = {
    "history": "客户曾在会话中要求:欧洲订单回复一律附 CE 声明",
    "query":   "给我这单的英文回复草稿",          # 不出现 CE / 声明 / 上次要求
    "score":   lambda draft: "CE" in draft,        # 评分点是产物,不是召回
}
把历史邮件转成这类回归题,比只统计"检索命中率"有用得多:它直接考第二道闸门。配套还要记三段埋点——送达了什么、有没有被使用、使用后动作和后果是什么;成本按会话或任务记账,而不是按月看一张总账单。
最后一个风险来自 BRIDGE 作者的 broader impact 提醒:会不请自来地应用规则的记忆,也会不请自来地应用过期或错误的规则。所以记忆要看得见、删得掉;产品换版后,旧规则须有明确的失效路径。
10 明天上班做什么
给个人开发者:
- 挑 20 条真实历史请求,改写成"查询里不提规则"的题,跑一遍现有记忆系统;
- 加一条原文通道,和摘要一起召回、联合重排,先别动模型;
- 把常设规则放到上下文顶部的带标签区块,在自有集上验一次再决定要不要留。
给技术负责人:
- 把"检索命中率 / QA 准确率"从唯一 KPI 里拿掉,补上"动作改变率"与"每任务记忆成本";
- 埋点拆成送达、使用、后果三段,能定位到底卡在哪一道闸门;
- 上图谱、上反思、上后台合并之前,先写清楚它要赢的具体条件(会话重启?时序失效?程序性复用?),并给出验收题;
- 给记忆加可见、可删、可过期的治理面,别让错误规则静默地一直生效。
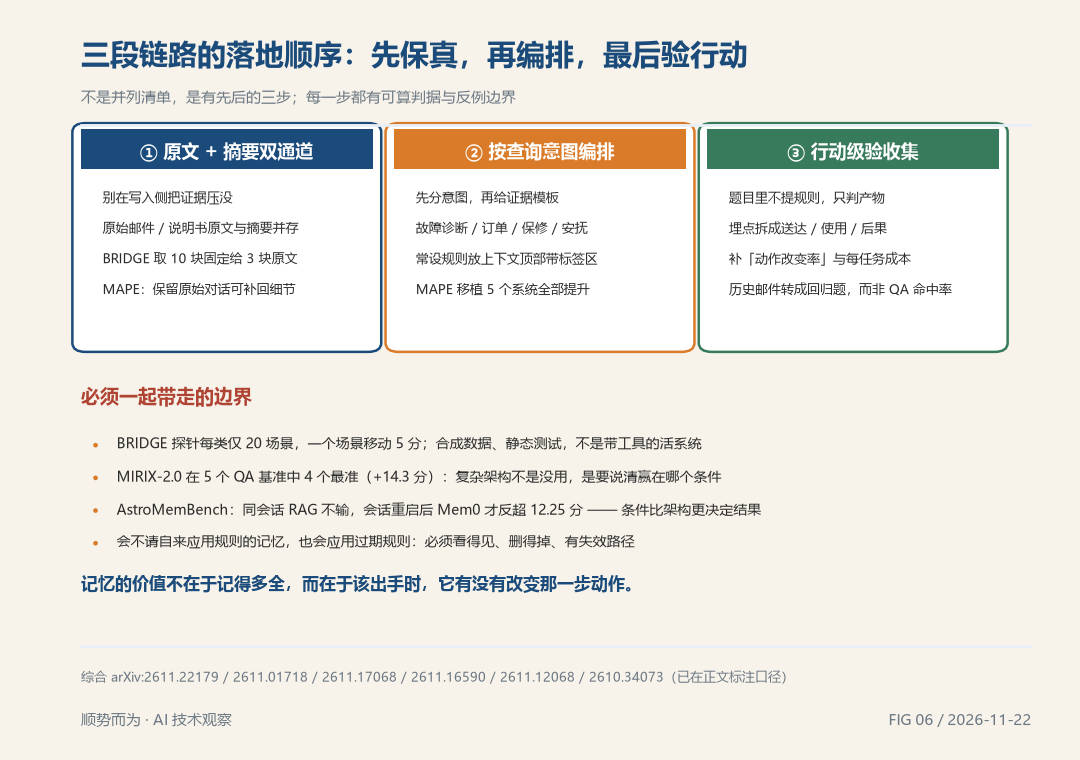
图 6 三段链路的落地顺序与必须一起带走的边界
记忆的价值不在于它记得多全,而在于它有没有在该出手的时候,改变那一步动作。
你的验收集里,有几道题是"查询里不提规则"的?
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号