1. 使用场景
适用对象:希望在 CodeBuddy / Cursor / Claude Desktop 等 AI 客户端中,用自然语言直接查询 WeData 元数据、执行数据探索 SQL 的同学。
协议:MCP(Model Context Protocol),传输方式 Streamable HTTP,服务由 WeData 平台托管,无需本地安装。
目前,WeData MCP Server 把 WeData 的元数据查询 和 数据探索(SQL 执行) 能力封装成一组标准 MCP 工具。配置完成后,你只需要在 AI 客户端里用自然语言提问,模型会自动编排工具调用,典型链路:
查项目 → 查数据源 → 查库 → 查表 → 查字段 → 提交 SQL → 轮询结果
适用场景举例:
「我有哪些 WeData 项目?这个项目下有哪些数据源?」
「某数据源的某张表有哪些字段、哪些是分区字段?」
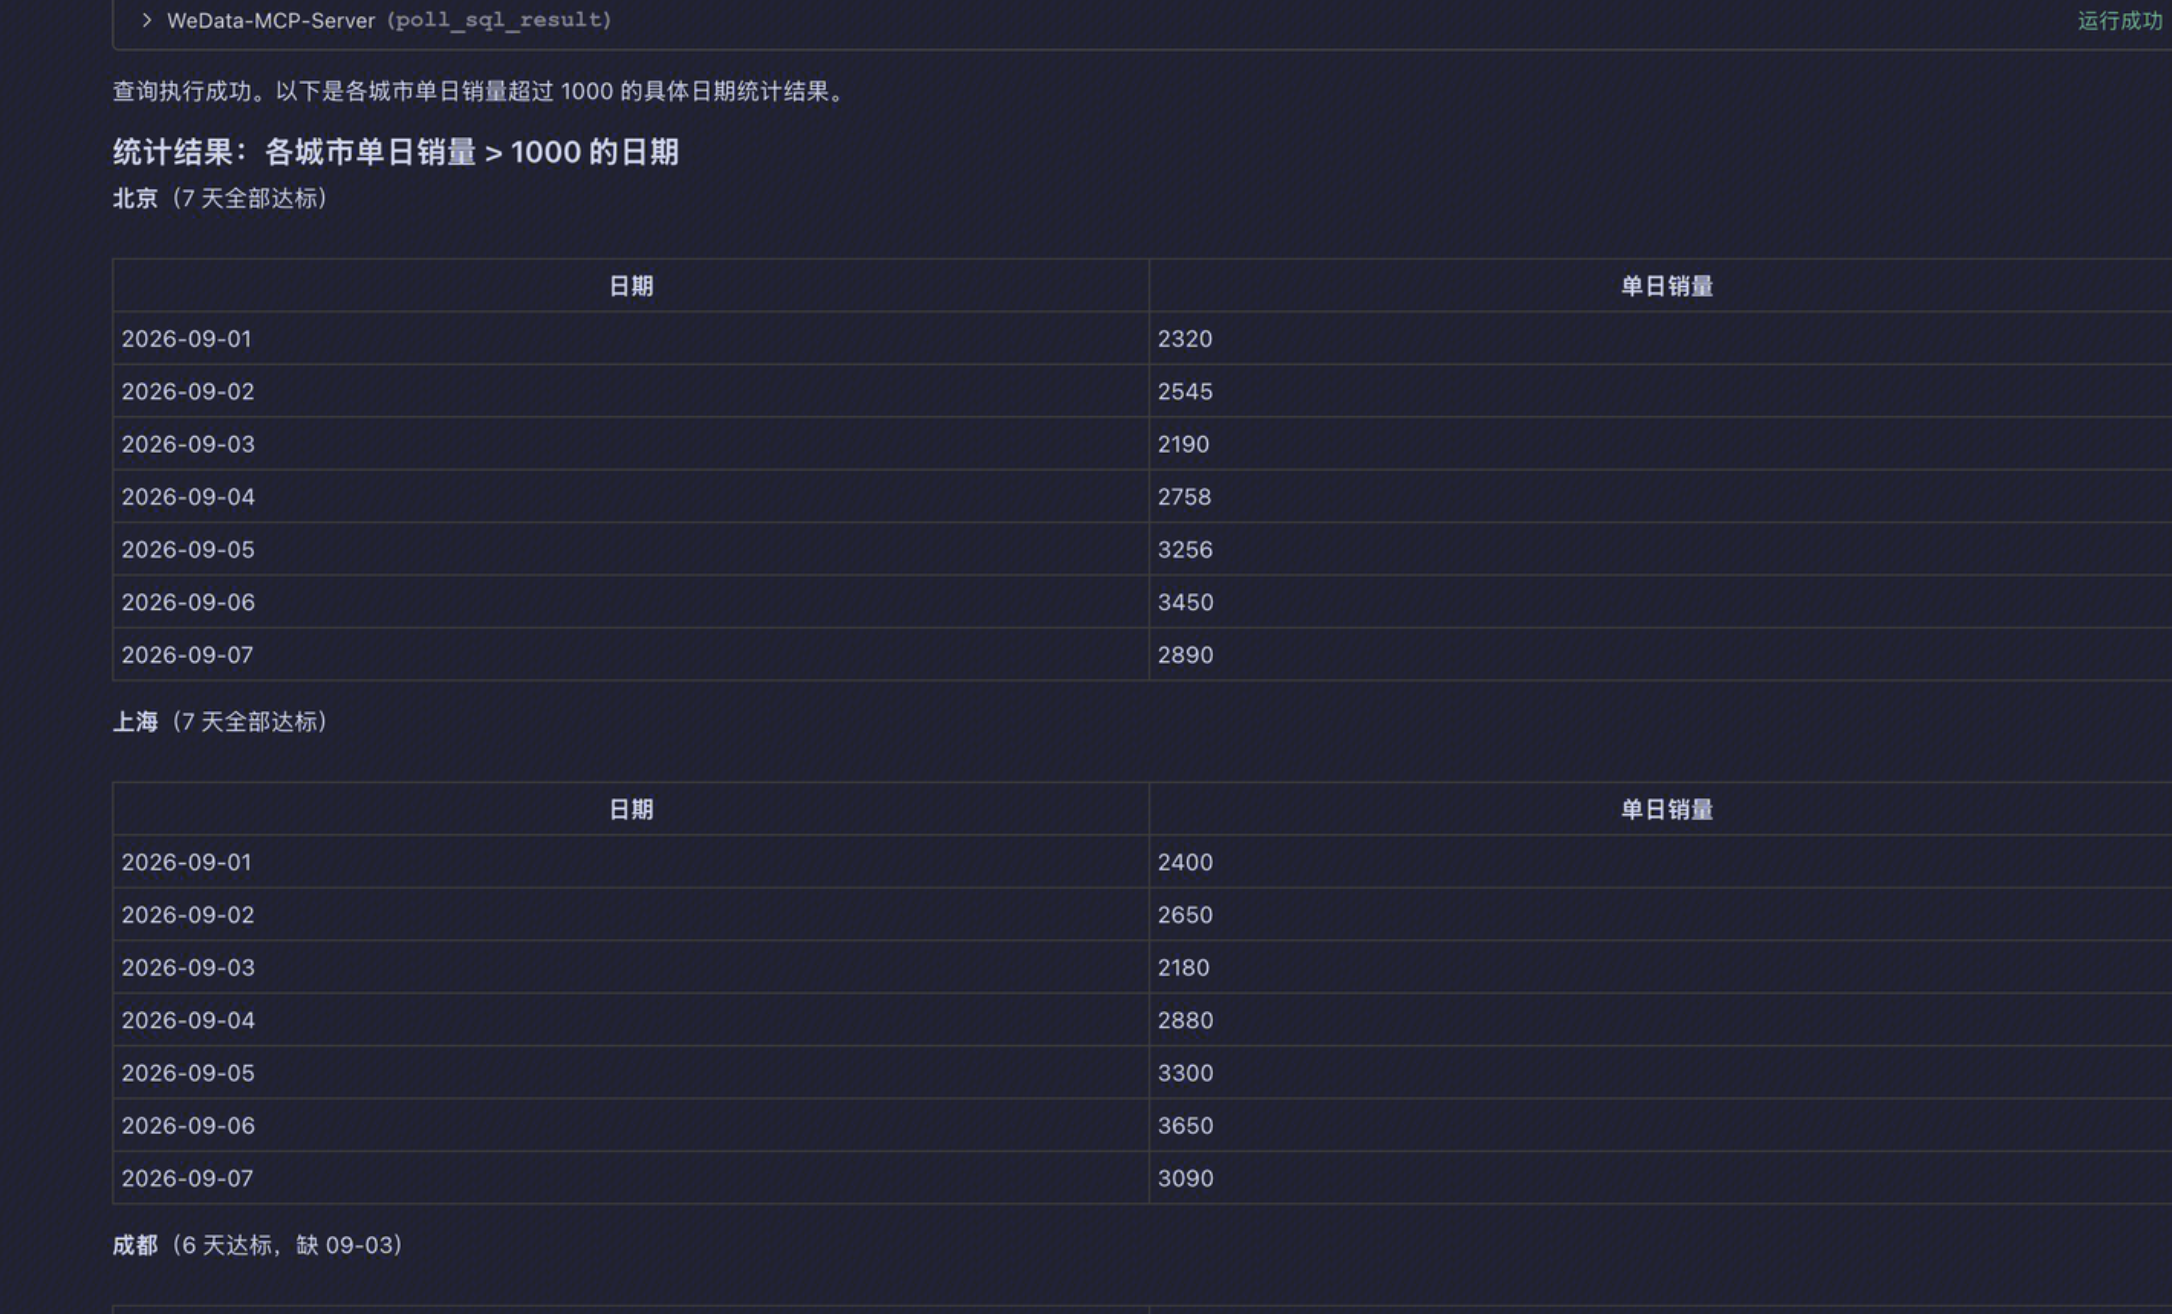
「帮我跑一条 SQL,统计每个城市单日销量超过 1000 的日期」
「先建库建表,再插几条数据,然后统计一下」
2. 前置条件
项目 | 要求 |
MCP 客户端 | 支持 streamable-http 传输的客户端(CodeBuddy、Cursor、Claude Desktop 等) |
凭证 | 腾讯云 API 密钥 SecretId / SecretKey,且该账号在 WeData 中具备相应项目/数据权限 |
地域 | 与 WeData 所在地域保持一致,如 ap-guangzhou、ap-singapore |
网络 | 可访问公网 *.wedata.cloud.tencent.com |
3. 安装步骤
3.1 获取密钥
有两种密钥获取方式,用户可以根据自己的场景选择其中某一种:
3.1.1 长期 AKSK 方式
在腾讯云 CAM 控制台创建 API 密钥,得到
SecretId 与 SecretKey。注意:
安全提示:密钥等同于你的账号身份,只保存在本地
mcp.json 或环境变量中,不要写入代码仓库、不要粘贴到对话/文档/工单中。3.1.2 entraId 方式
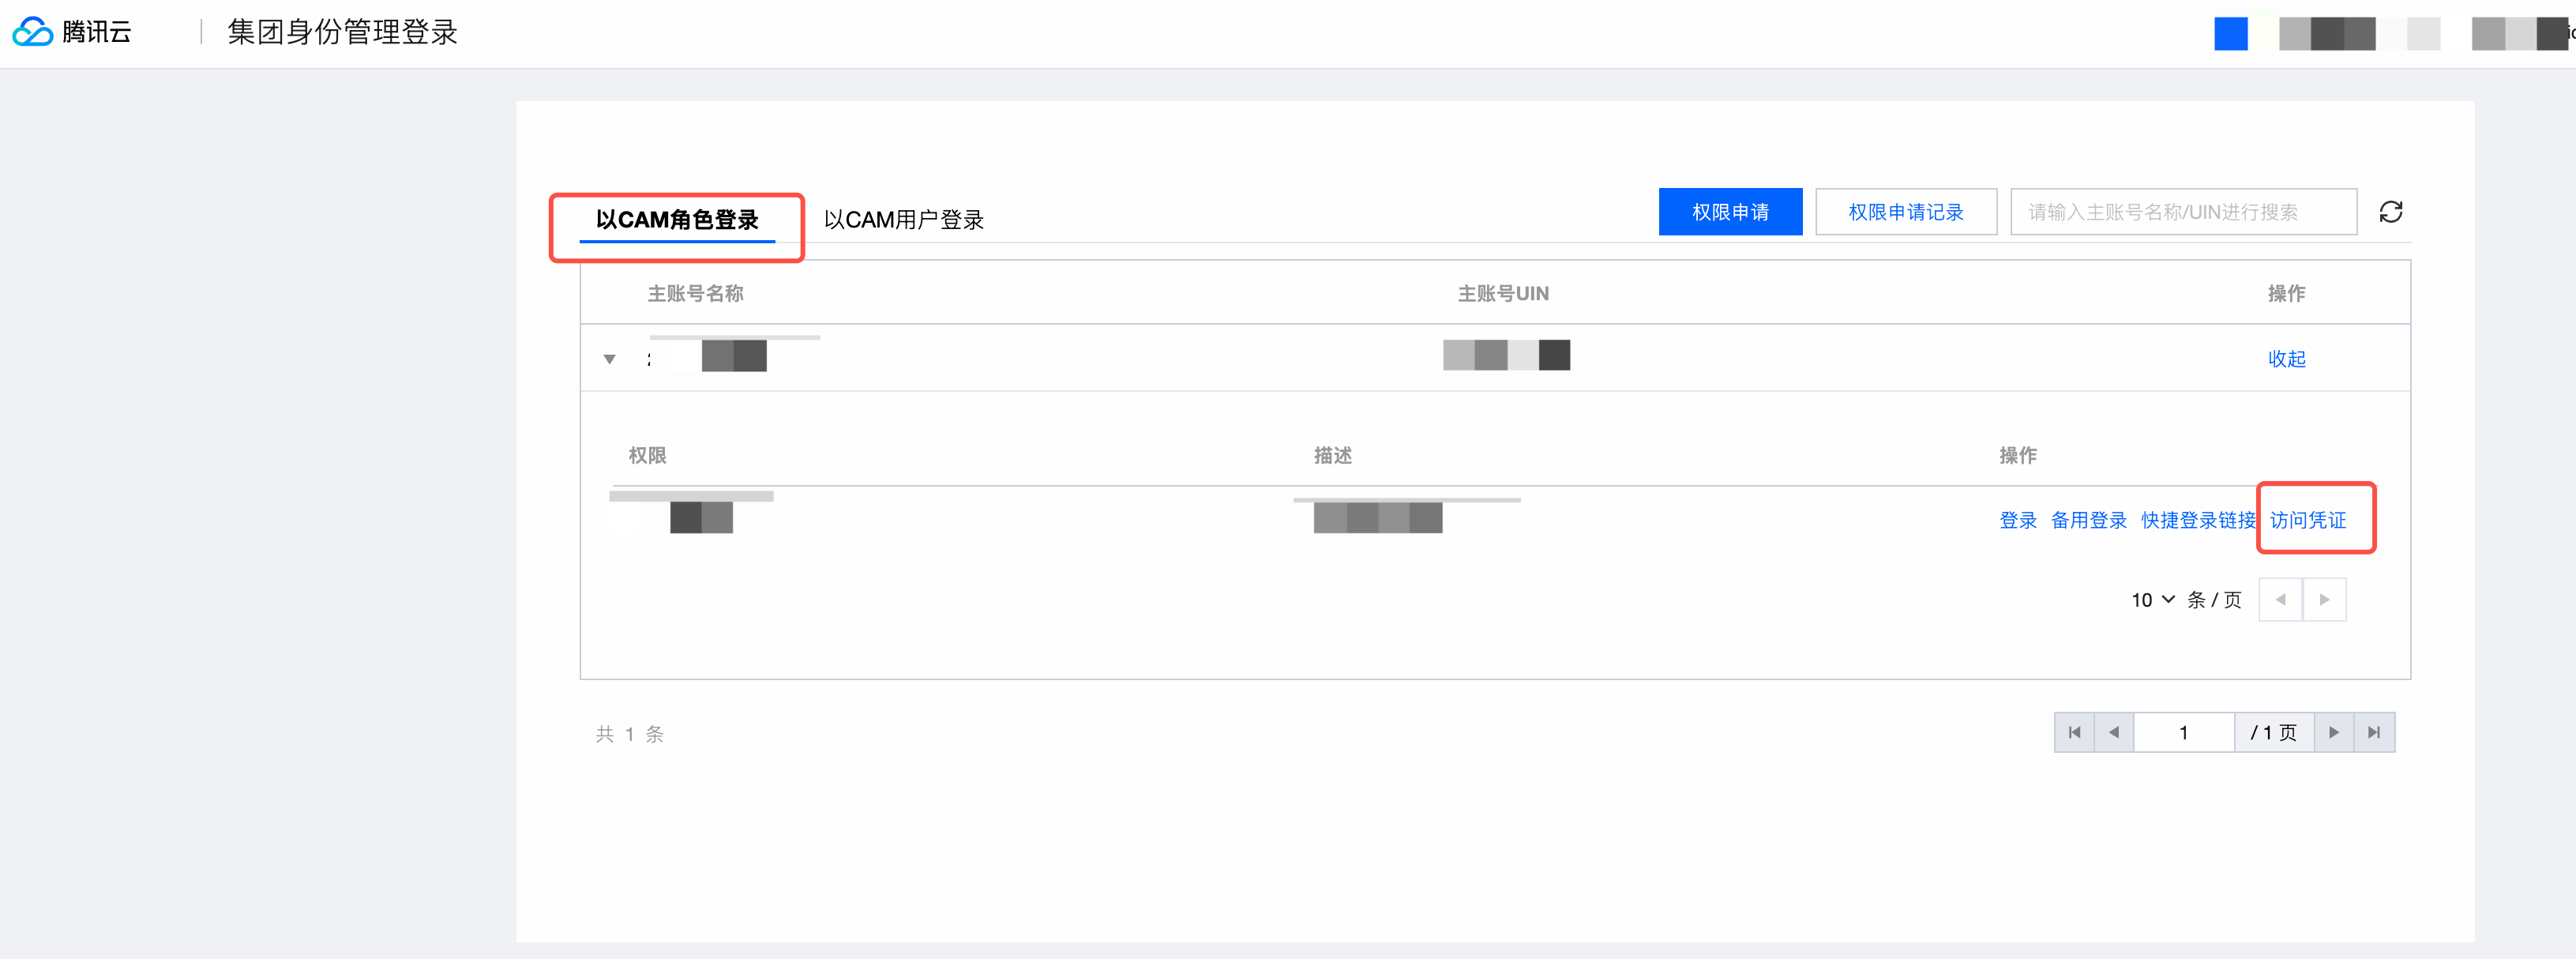
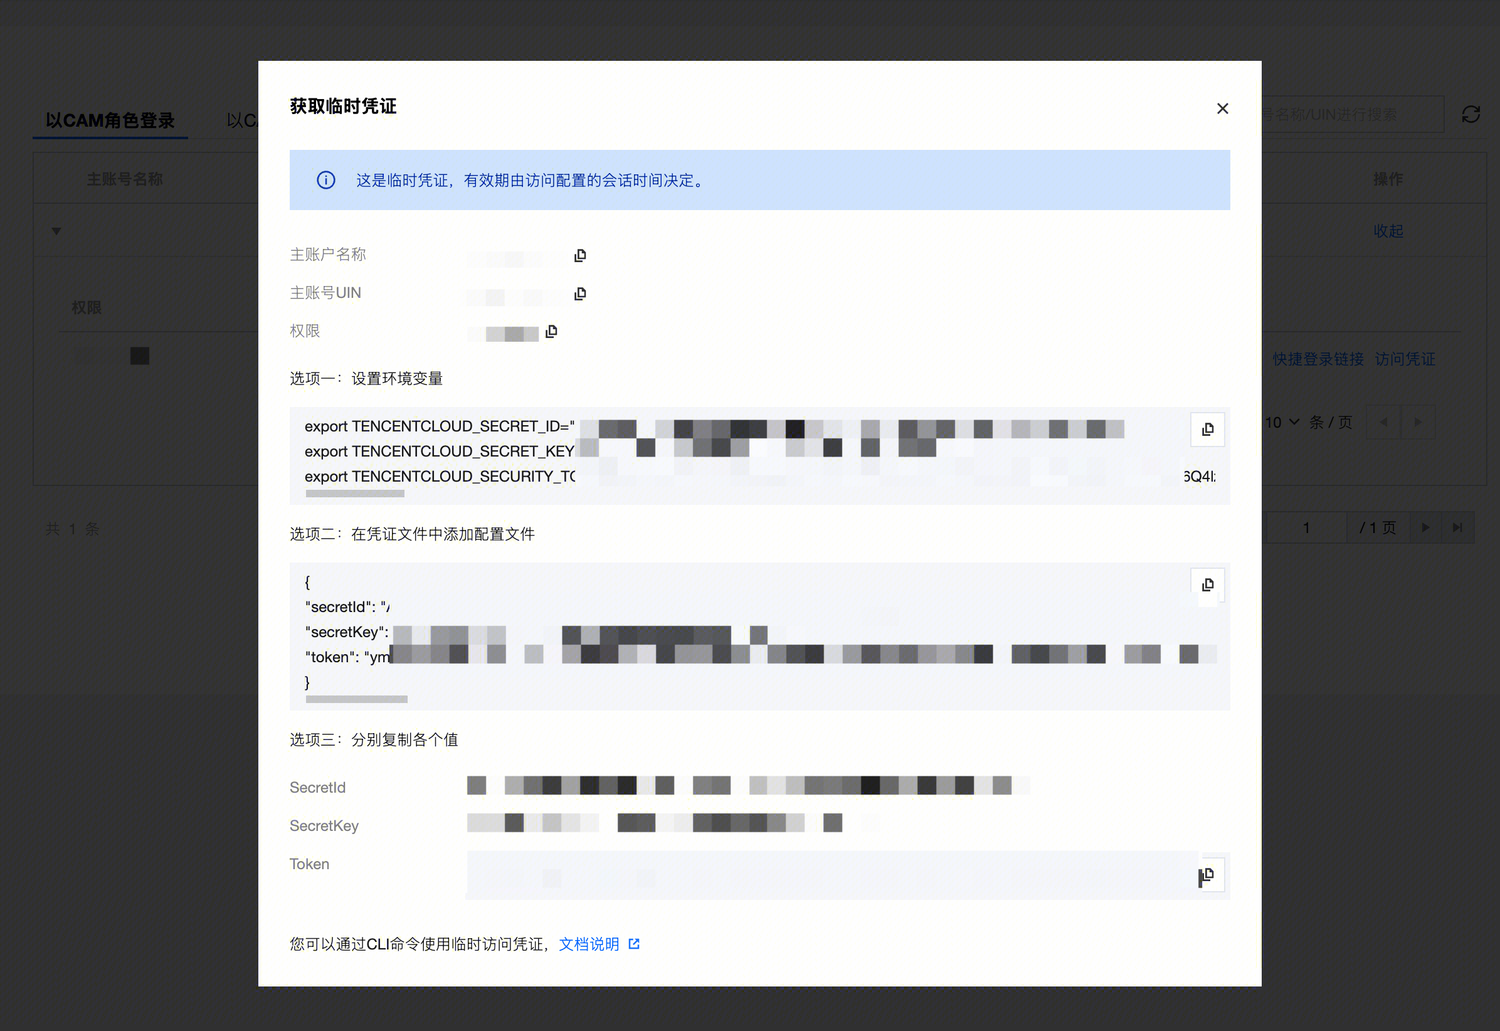
通过 entraId 登录后,在如下页面获取访问凭证:
3.2 在客户端添加 MCP 配置
打开客户端的 MCP 配置文件(CodeBuddy 中通过「配置 → MCP 设置 → 配置 MCP」打开
mcp.json),加入以下内容:{"mcpServers": {"WeData-MCP-Server": {"url": "https://mcp.wedata.cloud.tencent.com/mcp/wedata/v1/all","timeout": 20000,"transportType": "streamable-http","headers": {"TENCENTCLOUD-SECRET-ID": "<你的 SecretId>","TENCENTCLOUD-SECRET-KEY": "<你的 SecretKey>","TOKEN": "<只有entraId方式需要配置,获取方式见3.1.2>","TENCENTCLOUD-REGION": "ap-guangzhou"},"disabled": false}}}
字段说明:
字段 | 必填 | 说明 |
url | 是 | MCP 服务端点 国内环境: https://mcp.wedata.cloud.tencent.com/mcp/wedata/v1/all海外环境: https://mcp.wedata.tencentcloud.com/mcp/wedata/v1/all |
TENCENTCLOUD-SECRET-ID | 是 | 腾讯云 API 密钥 SecretId |
TENCENTCLOUD-SECRET-KEY | 是 | 腾讯云 API 密钥 SecretKey |
TOKEN | 否 | |
TENCENTCLOUD-REGION | 是 | 地域,需替换为实际地域 |
timeout | 否 | 单位毫秒,工具执行较慢时可适当调大 |
TOOL-SCOPE | 否 |
3.3 用 TOOL-SCOPE 控制工具范围(可选)
在
headers 中增加 TOOL-SCOPE 可只加载需要的工具,减少模型选择干扰:"TOOL-SCOPE": "data_assets"
多个范围用英文逗号分隔:
"TOOL-SCOPE": "data_assets, data_analysis"
注意:
取值范围以服务端当前支持的能力域为准(已见
data_assets、data_analysis 等),填错或拼写不一致会导致工具无法加载。若不确定,建议先不配置,默认加载全部工具。3.4 验证连接
保存配置后回到客户端,看到
WeData-MCP-Server 状态为已连接、并能列出工具清单,即配置成功。随后直接对话即可:帮我查一下我有哪些 wedata 项目4. 支持工具
工具 | 用途 | 关键入参 | 备注 |
list_projects | 分页列出租户下的 WeData 项目 | PageNumber、PageSize;可选 ProjectName、ProjectIds、ProjectModel、Status | Status:0=已停用,1=已启用;ProjectModel:SIMPLE/STANDARD |
list_data_sources | 列出某项目下的数据源 | ProjectId(必填);可选 Name、DisplayName、Type、Creator、PageNumber、PageSize | Type 取值如 MYSQL、HIVE、ICEBERG、DLC、StarRocks、SuperSQL 等 |
list_database | 列出库(资产) | PageNumber、PageSize(必填);可选 DatasourceId、Keyword、CatalogName | 返回库名、Catalog、存储大小、所属数据源等 |
list_table | 列出某库下的表 | PageNumber、PageSize(必填);可选 DatabaseName、DatasourceId、Keyword、CatalogName、SchemaName | 返回表名、类型、负责人、存储大小、更新时间等 |
get_table_columns | 查询表的字段列表 | TableGuid(必填) | 返回字段名、类型、描述、长度、序号、是否分区字段;TableGuid 由 list_table 获得 |
list_resource_groups | 列出执行资源组 | PageNumber、PageSize(必填);可选 Type、ProjectIds、Id、Name | Type:Schedule(调度)/ Integration(集成)/ DataService(数据服务);跑 SQL 需要 Schedule 类型 |
execute_sql | 提交 SQL 到数据探索异步执行 | ProjectId、ScriptContent、ScriptConfig(含 DatasourceId、ExecutorGroupId) | 只提交任务,立即返回 JobId,此时状态通常为 QUEUED |
poll_sql_result | 查询 SQL 执行结果与状态 | ProjectId、JobId;可选 JobExecutionId | 未终态时返回 QUEUED/RUNNING 且结果为空,需轮询 |
5. 典型用法
5.1 元数据探索
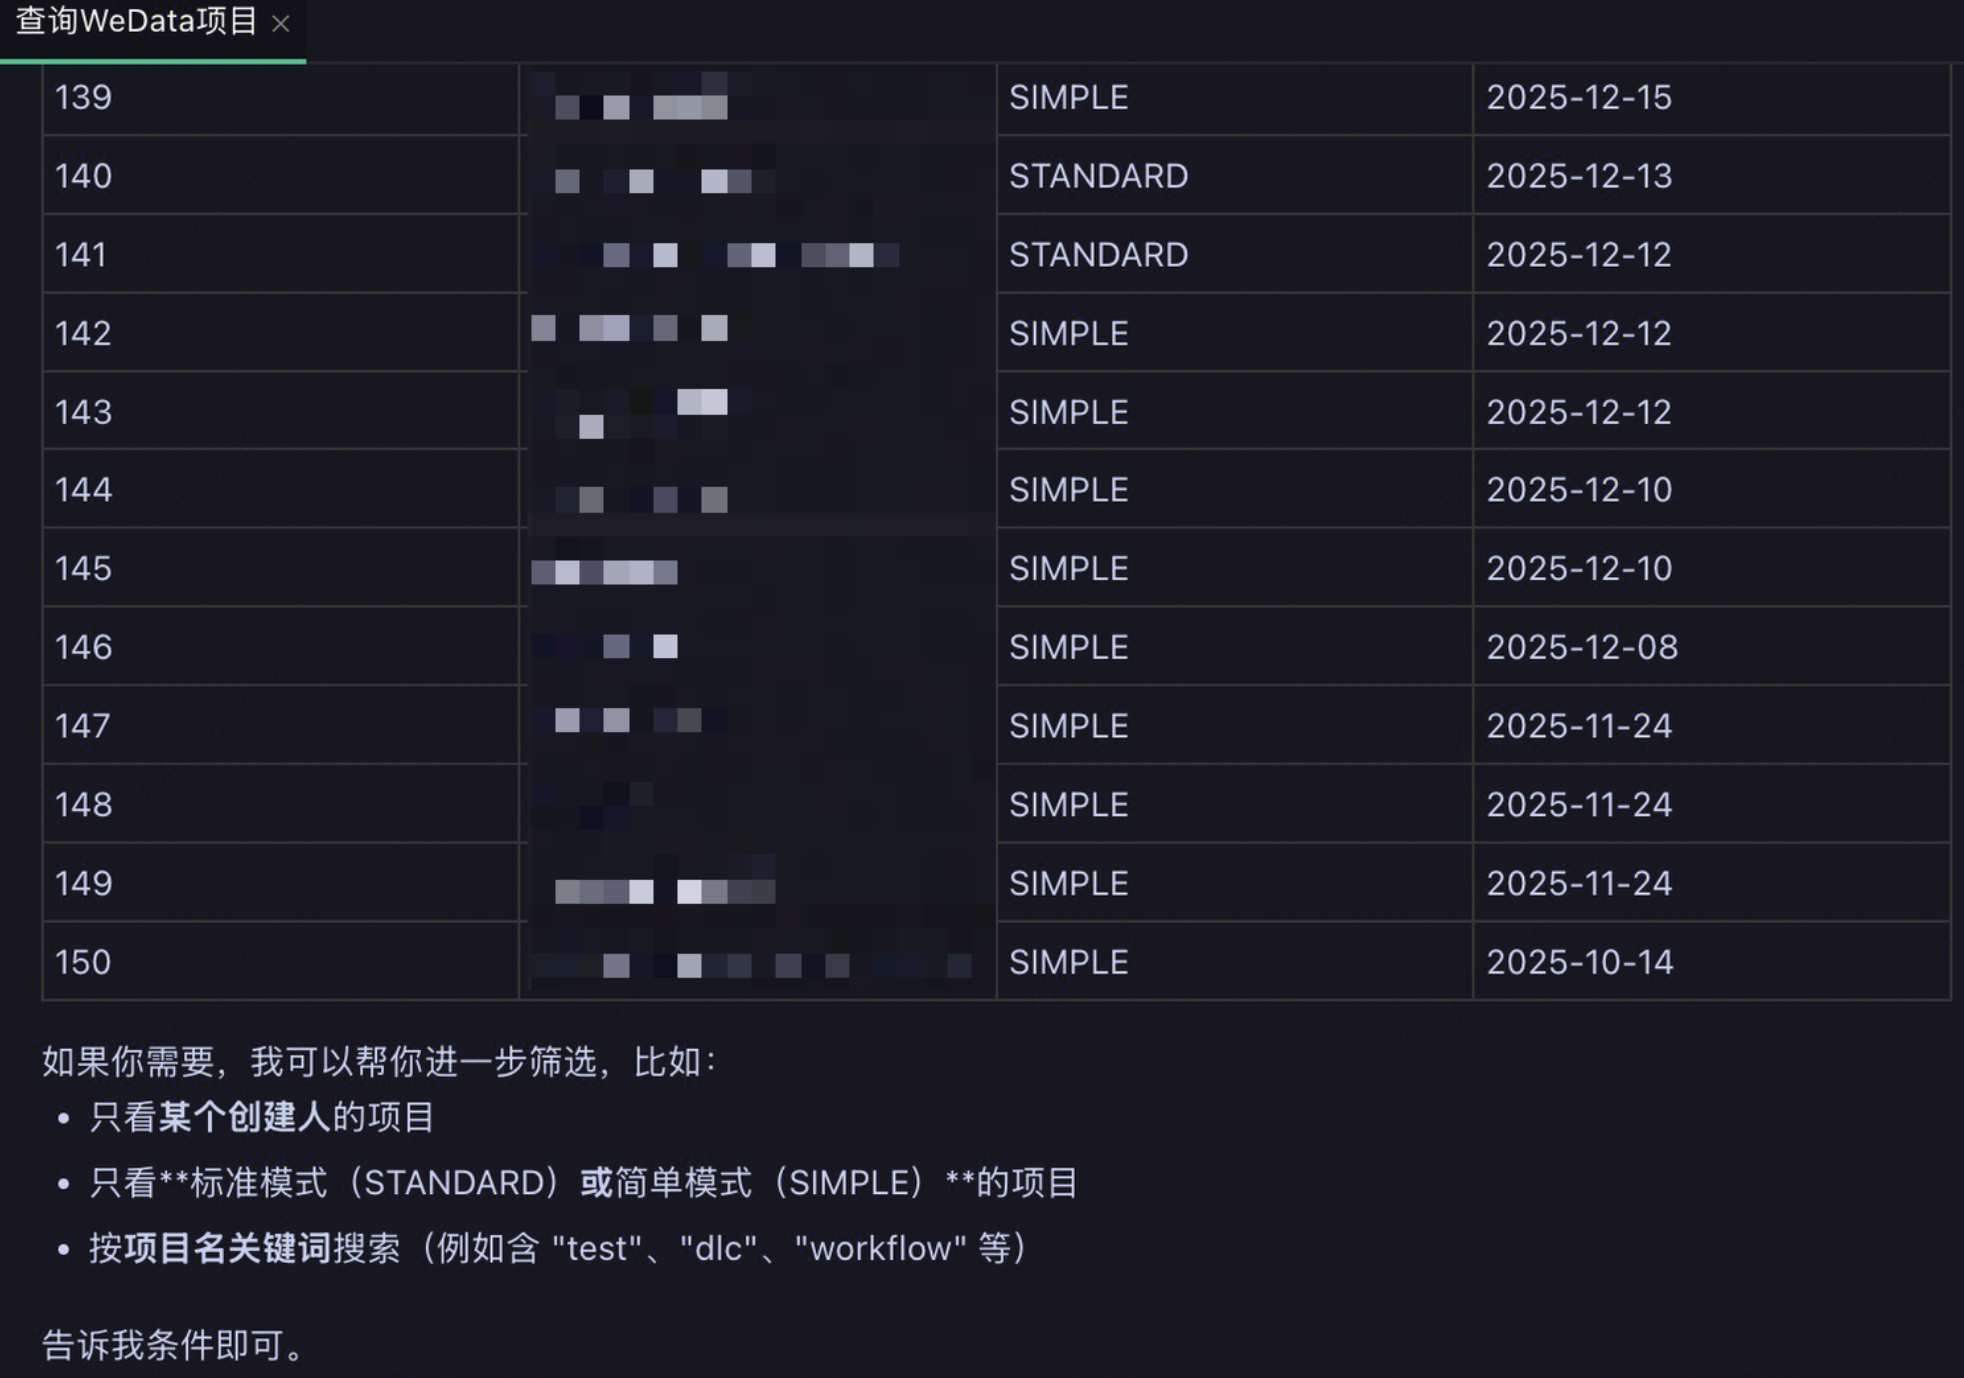
prompt:帮我查一下我有哪些 wedata 项目:
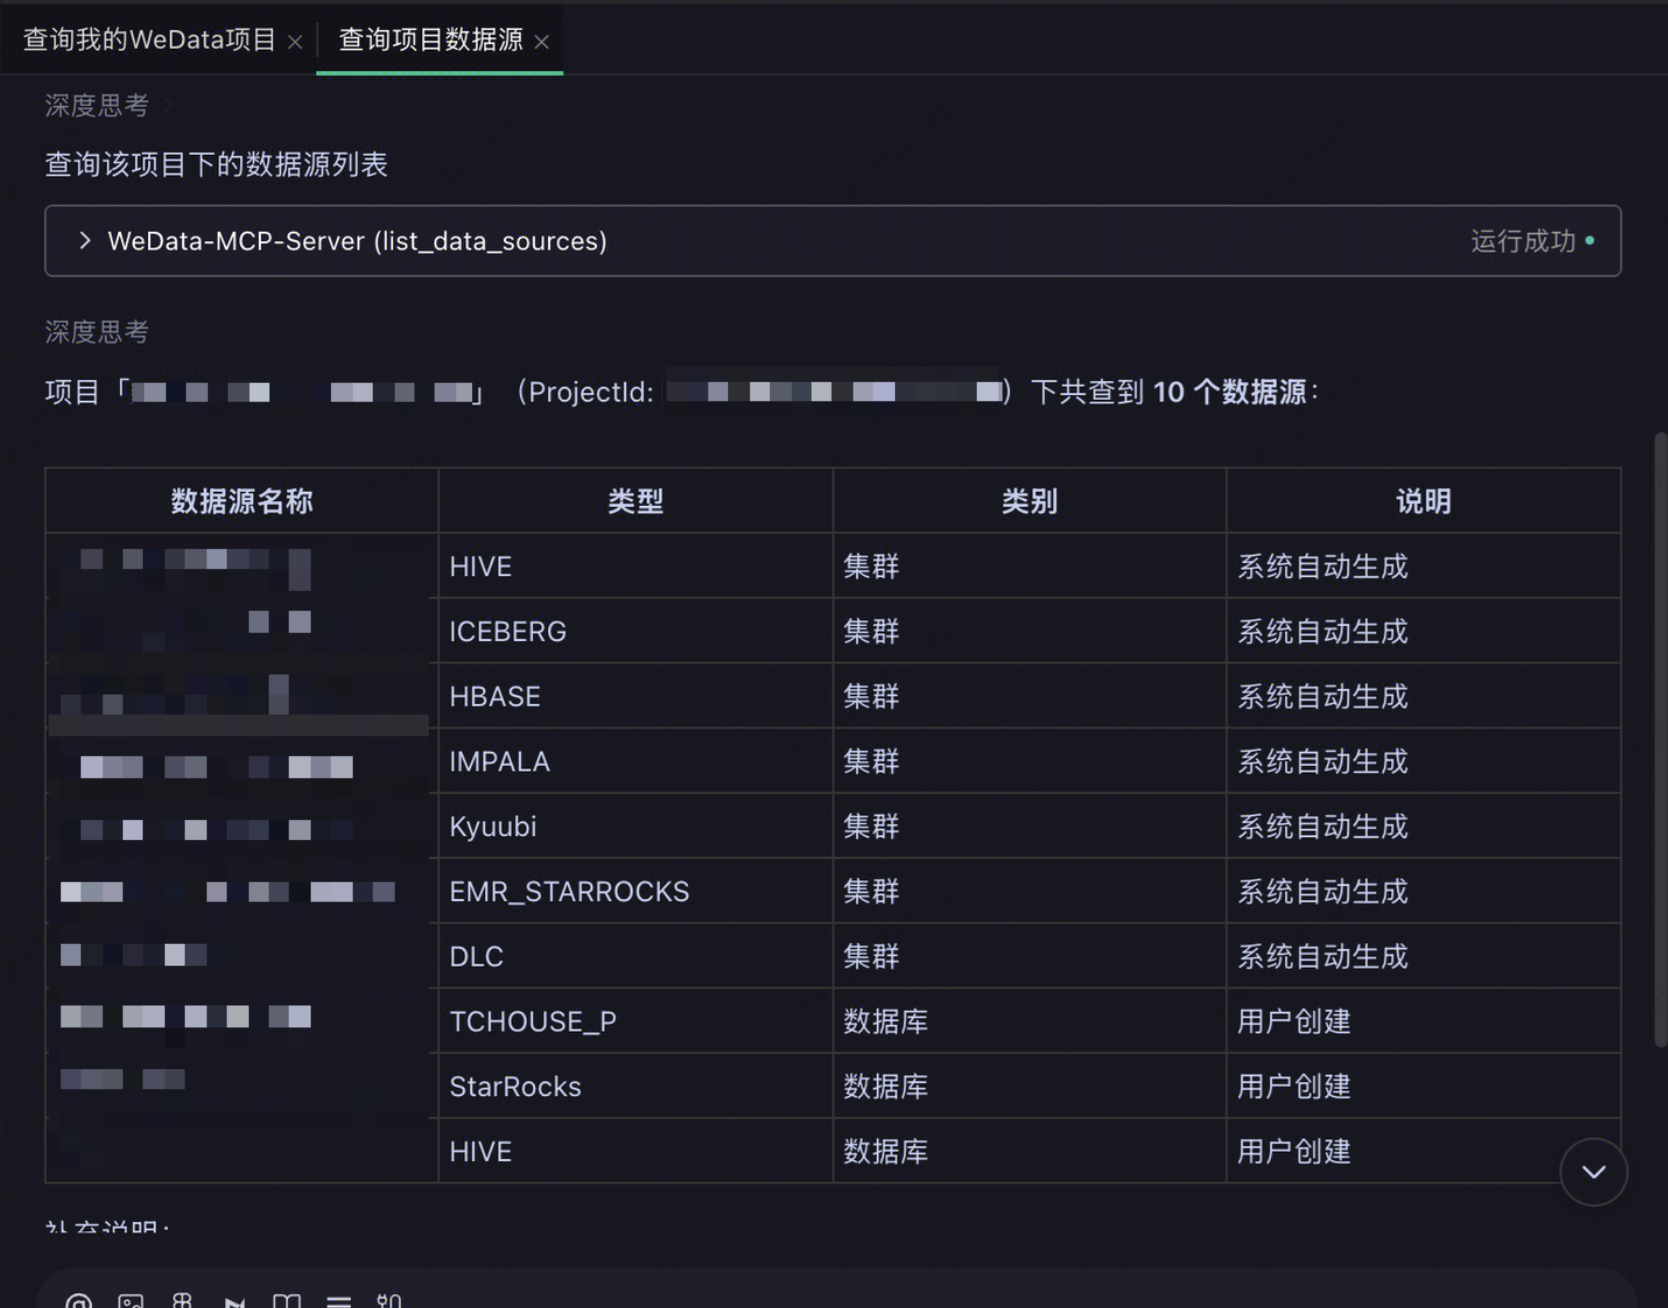
prompt:帮我看下「项目名称」项目下我有哪些 wedata 数据源:
prompt:帮我查询下「项目名称」项目下,「数据源名称」 这个数据源下面有哪些表:
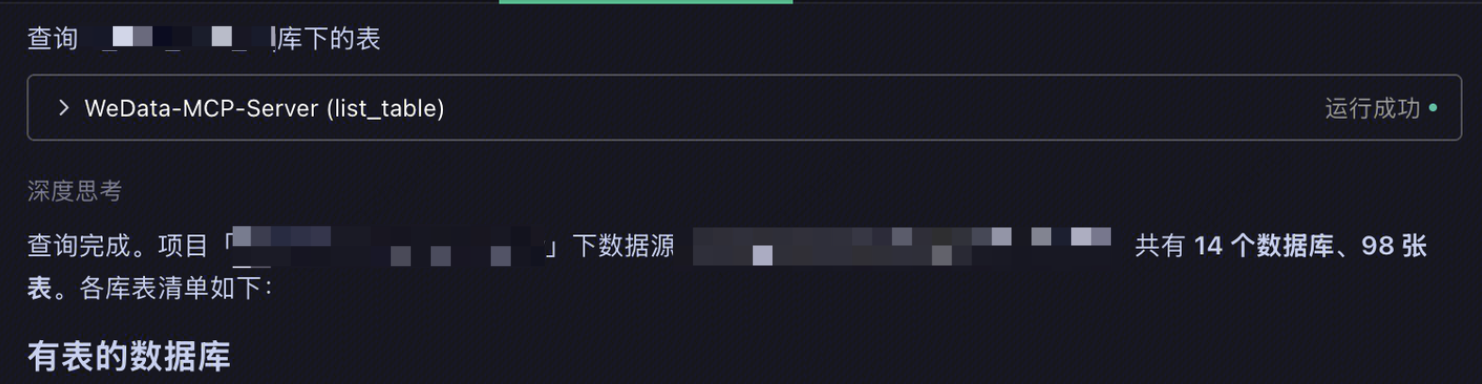
5.2 执行一条 SQL
1. 先让模型拿到必要参数(也可由你直接给出):
prompt:帮我查一下项目 「项目名称」 下有哪些调度资源组。
2. 提交 SQL:
prompt:
参数如下,帮我执行一下这个 SQL:show databases
ProjectId:「项目 ID」
DatasourceId:「数据源 ID」
ExecutorGroupId:「调度资源组 ID」
3. 拿结果:模型会用返回的
JobId 调用 poll_sql_result 轮询,直到状态变为 SUCCESS,再把结果整理给你。若模型没有自动轮询,可以追问:prompt:
查询任务 「JobId」 的执行结果。
关键参数示例:
{"ProjectId": "项目ID","ScriptContent": "show databases;","ScriptConfig": {"DatasourceId": "数据源ID","ExecutorGroupId": "调度资源组ID",}}
5.3 端到端场景
prompt:
在 「数据源名称」 这个数据源下面帮我创建一个商品销售的库,并在库下面创建 3 张表,
分别是成都、北京、上海三个城市每天销售商品数量和收入:
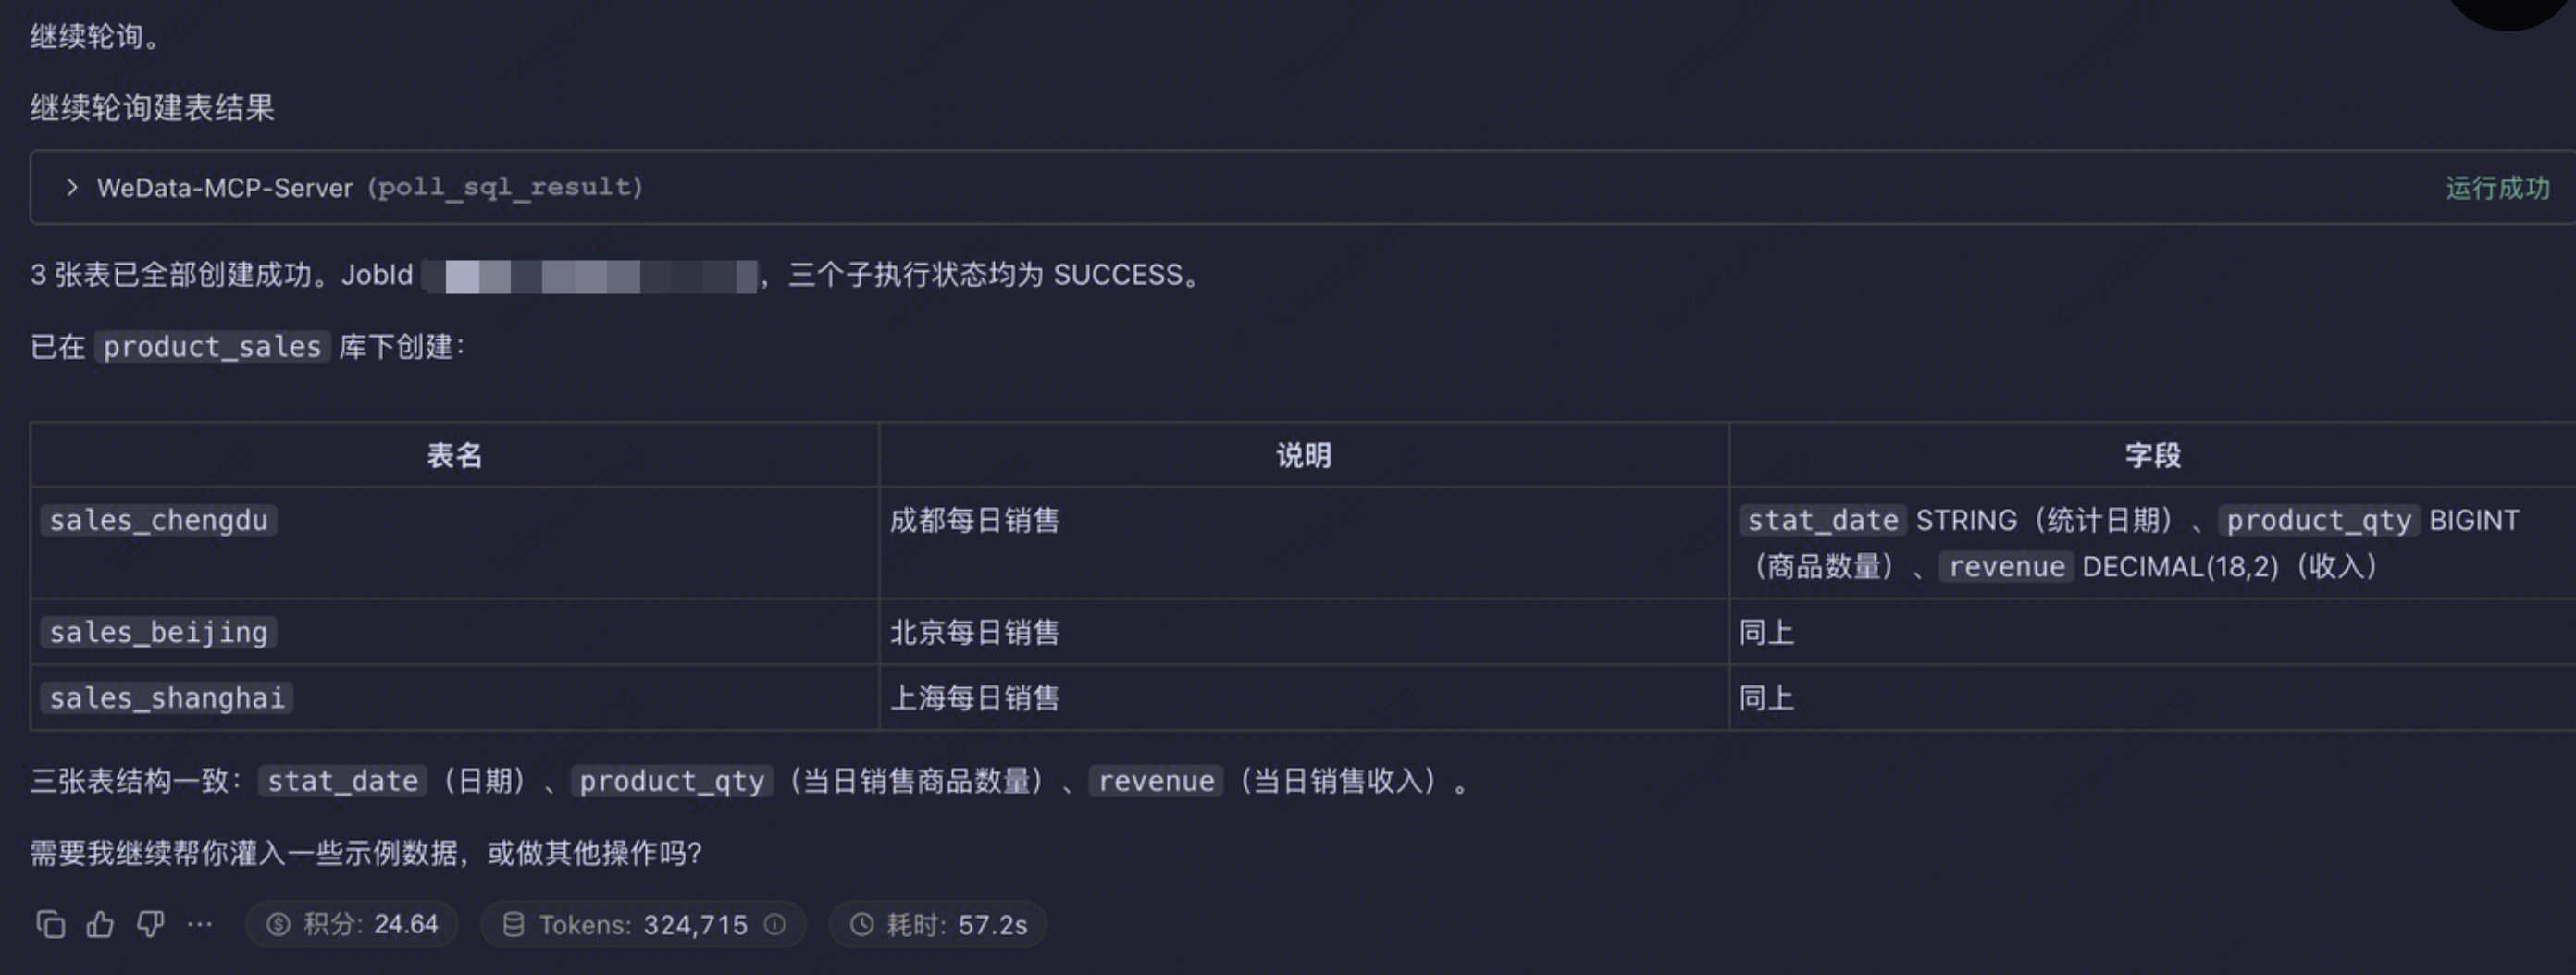
prompt:向这三张表里各插入几条测试数据:
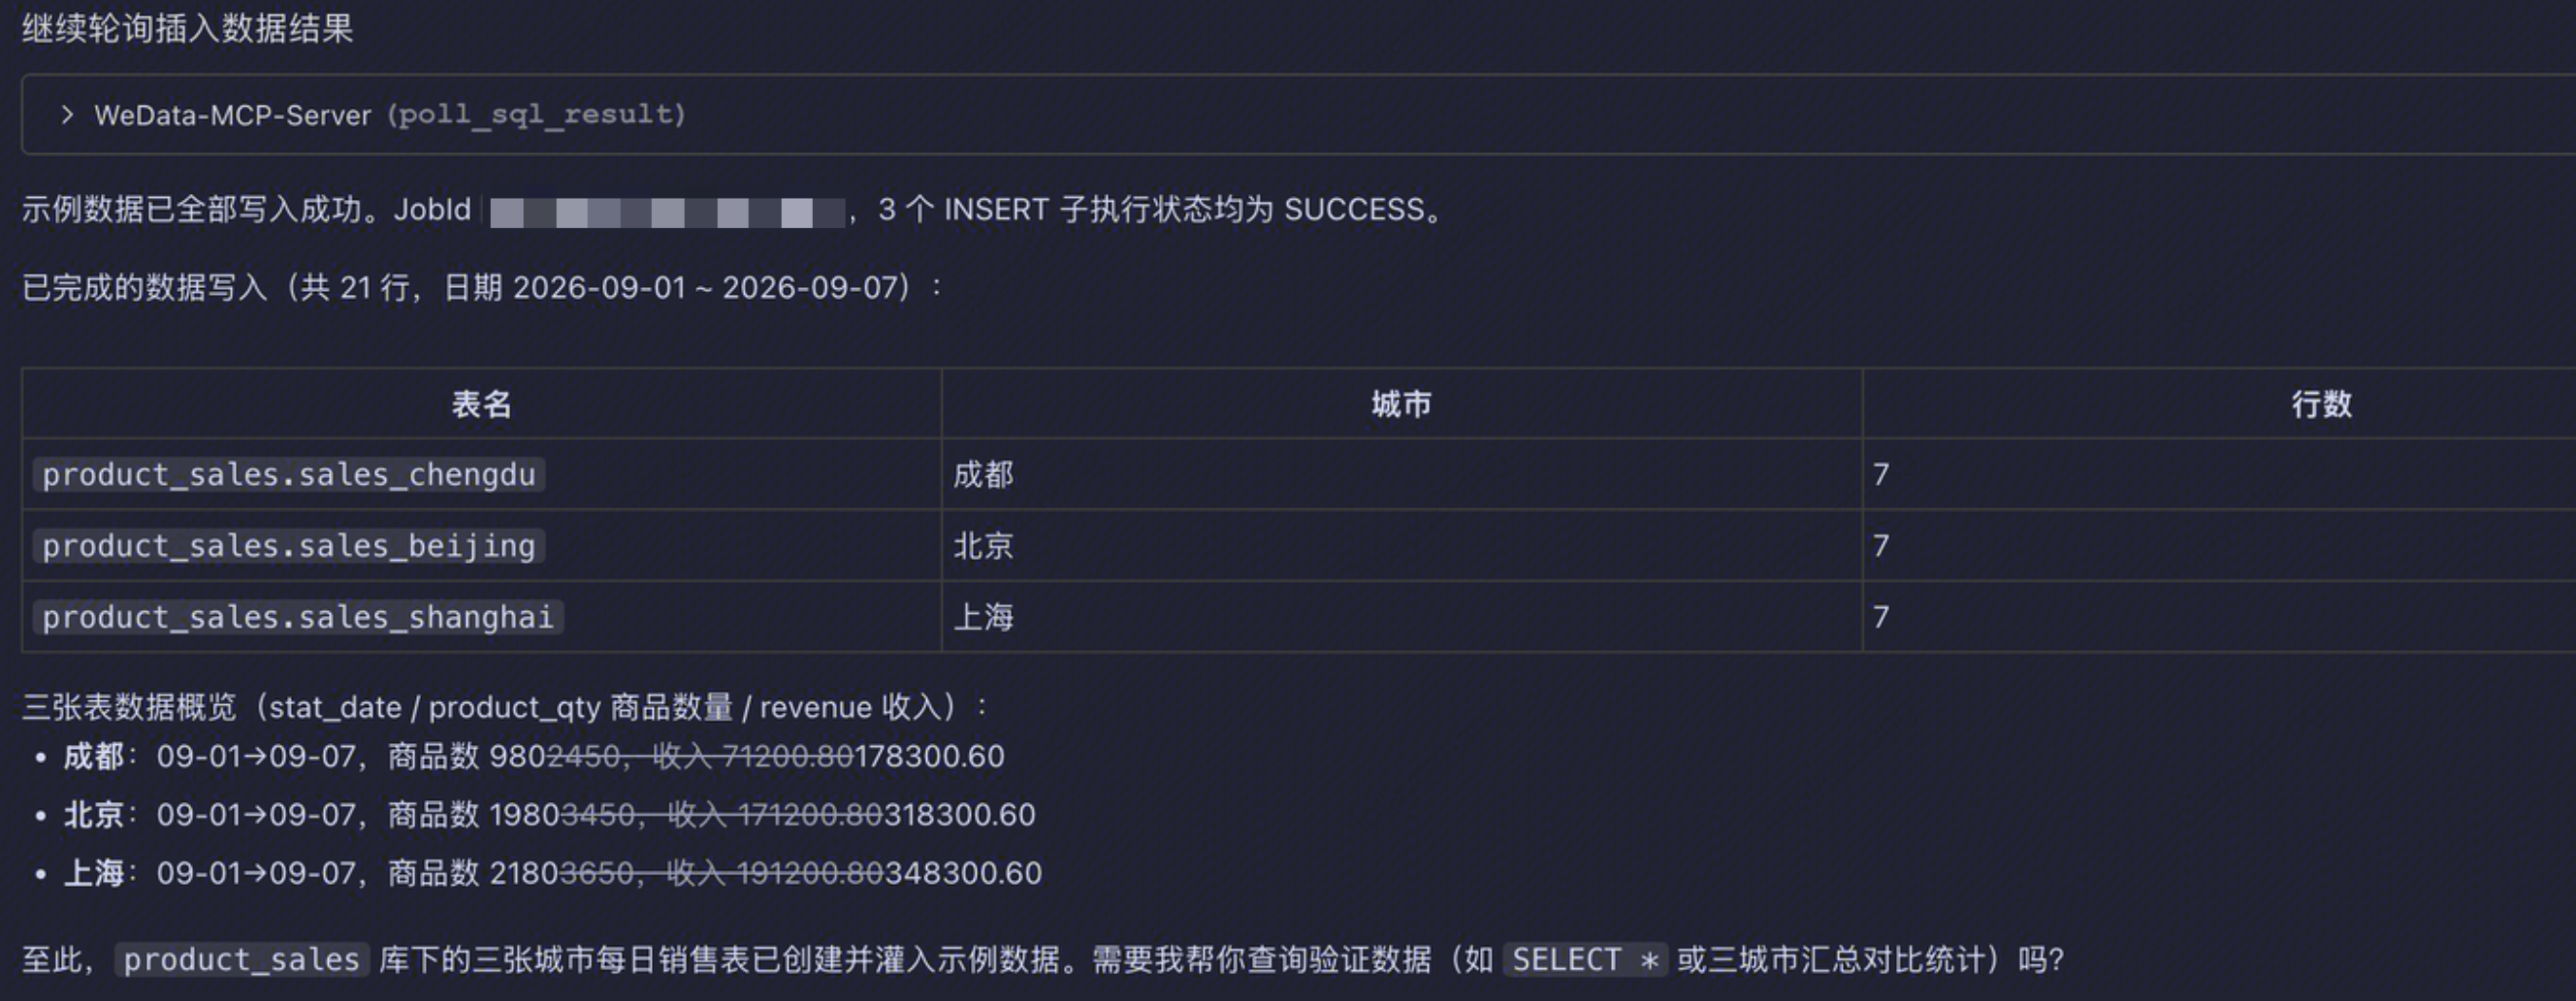
prompt:
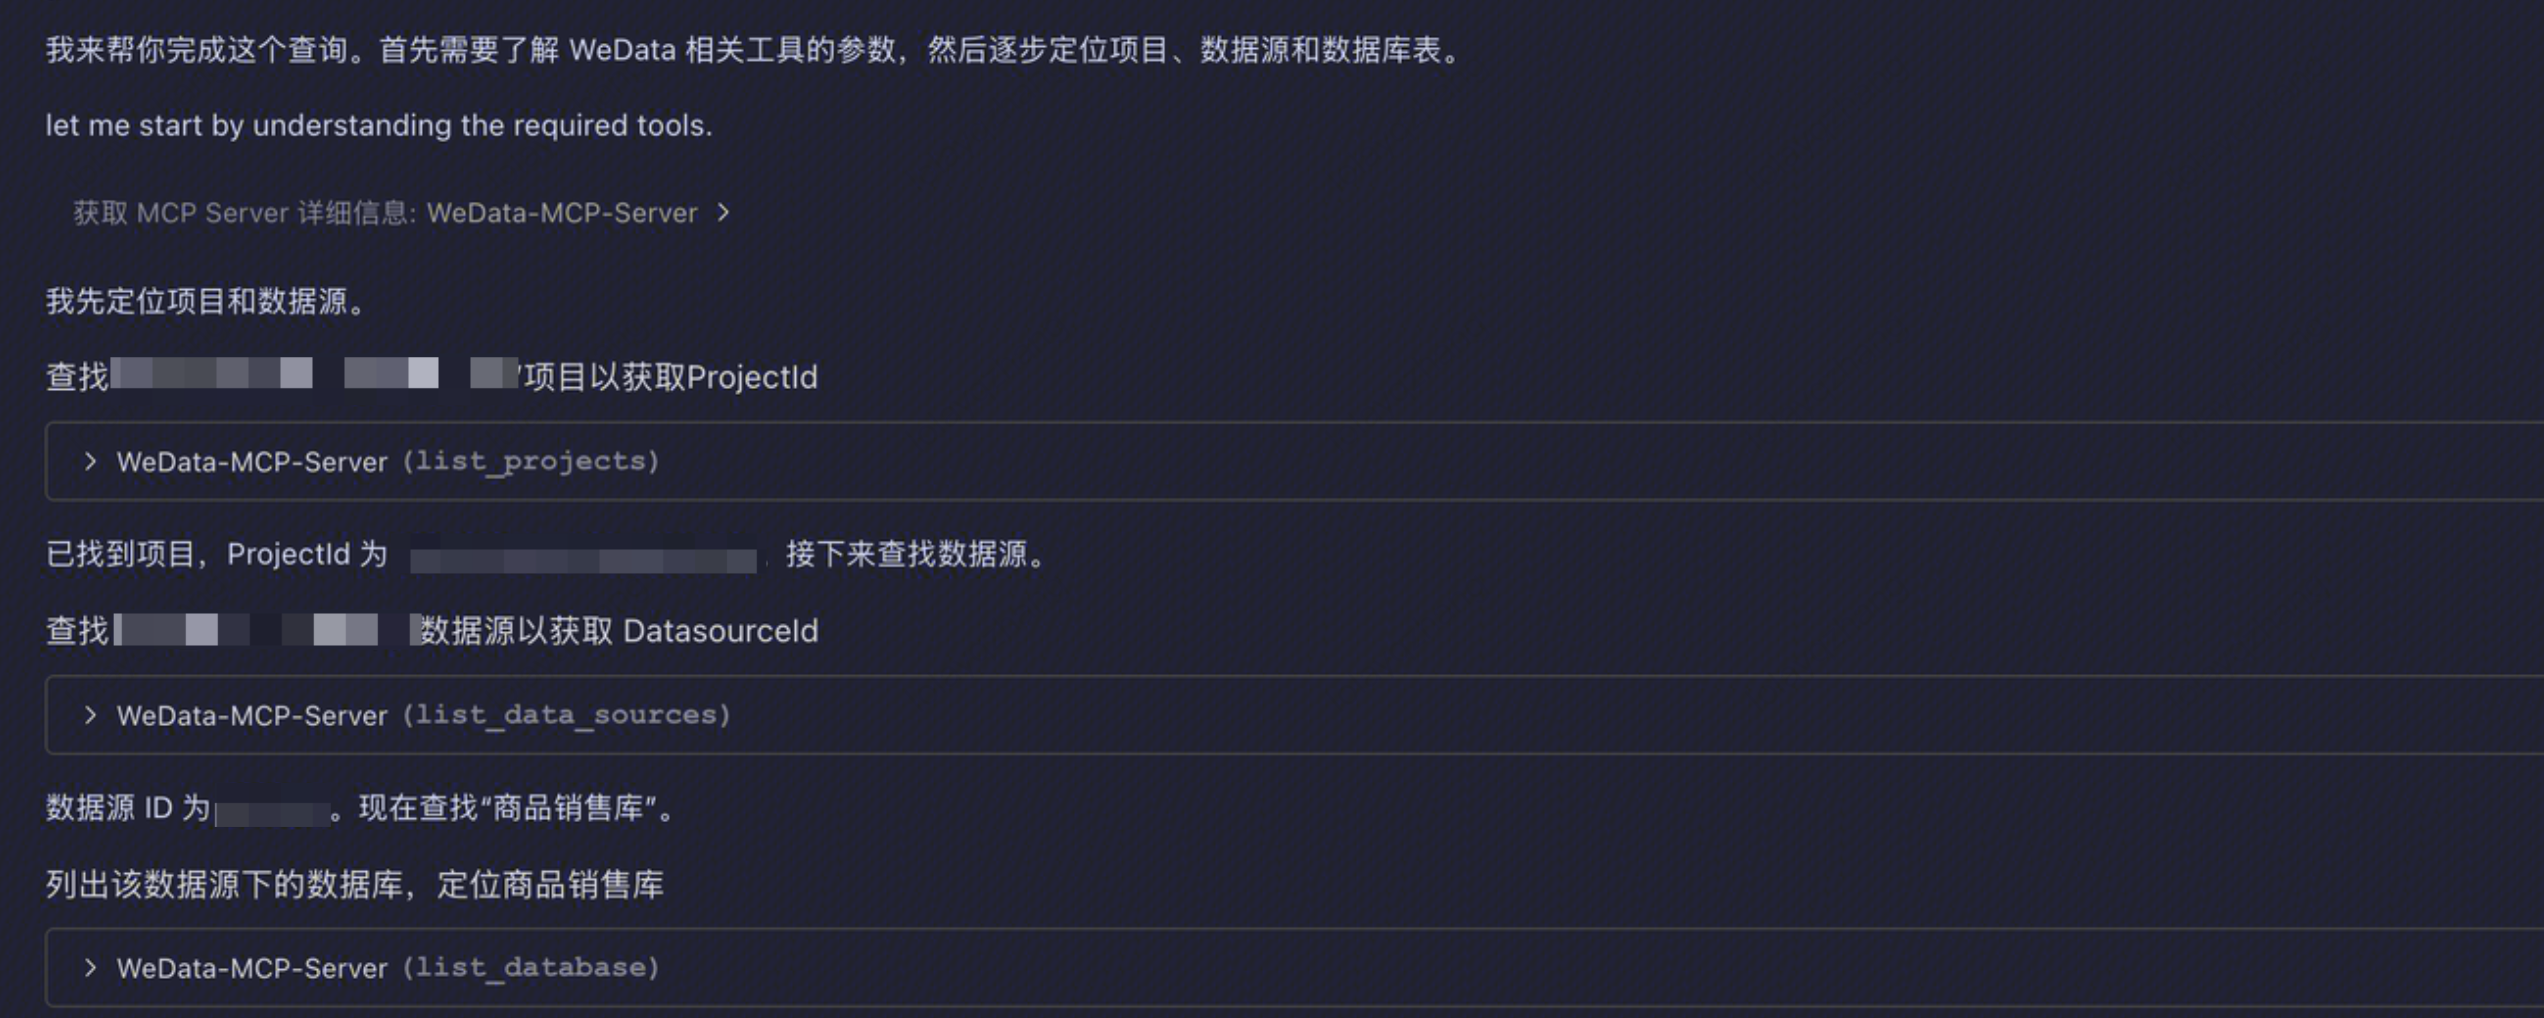
在「项目名称」项目下的 「数据源名称」数据源下,用 「计算资源名称」 计算资源、
ExecutorGroupId 「调度资源组 ID」,统计商品销售库中每个城市单日销量超过 1000 的具体日期。
6. 注意事项
1. SQL 是异步执行的:
execute_sql 只负责提交,返回 JobId;提交后用 poll_sql_result 轮询,直到状态为 SUCCESS / FAILED / TERMINATED / CANCELED。2. 多语句会拆成多个子执行:SQL 用
; 分隔时,每条语句产生一个子执行;poll_sql_result 不传 JobExecutionId 会按顺序返回全部子执行结果,传了则只返回指定子执行。3. 结果有截断与时效:预览行数受「项目管理 - 数据分析配置 - 预览行数限制」约束,总量不超过 10MB,超出时
Truncated=true;结果只保留有限时间,过期会返回 ResourceNotFound.ResultExpired,需要重跑 SQL。4. 返回值均为字符串:预览结果底层是 CSV,无类型信息。
5. 参数必须配套:
DatasourceId 必须属于传入的 ProjectId,否则报 InvalidParameter;ExecutorGroupId 必须是该项目下可用的 Schedule 类型资源组(可用 list_resource_groups 查询)。6. 权限:你只能访问该密钥对应账号有权限的项目、数据源和表;看不到某张表通常是权限或元数据可见范围问题,请先在数据地图/数据安全侧确认权限。
7. 写操作需谨慎:建库建表、插入数据属于变更操作,建议让模型先打印将要执行的 SQL,确认无误后再执行。
7. 常见问题排查
现象 | 可能原因与处理 |
客户端一直显示「连接中」或连接失败 | 检查 URL、TENCENTCLOUD-REGION 是否与 WeData 地域一致;检查网络能否访问公网端点;适当调大 timeout |
工具列表为空 / 工具数量明显偏少 | 检查 TOOL-SCOPE 取值拼写;不确定时先删除该 Header 全量加载 |
调用报鉴权失败 | 密钥错误、被禁用或无 WeData 访问权限;重新生成密钥并更新配置 |
execute_sql 报 InvalidParameter | DatasourceId 不属于该 ProjectId,或 ExecutorGroupId 不是该项目下的调度资源组 |
一直返回 QUEUED/RUNNING | 正常现象,继续轮询;资源组排队时等待较久,可换用较空闲的资源组 |
结果为空或只有部分数据 | 查看返回中的 Truncated 字段;或子执行较多时指定 JobExecutionId 逐个查看 |
提示结果已过期 | 结果 retention 已到,重新执行 SQL 即可 |
想查的表查不到 | 确认账号是否具备该表权限,以及项目是否设置了元数据可见范围 |


