Hyper Kernel 是腾讯云推出的、支持多硬件后端的 AI 算子自动优化平台,面向需要在 GPU 或国产芯片上进行算子性能优化与迁移适配的开发者和工程团队。它将原本依赖资深工程师、单个算子往往耗时数天的优化工作,转化为由 AI 自动执行的标准化流程,帮助您在更短时间内获得经过实测验证的高性能算子实现。
本文面向开发者与接入对接方,介绍平台的典型使用场景、接入方式、实测效果,以及背后的架构与工作原理,帮助您判断平台是否适用于自身的算子优化需求,并了解如何将其接入实际工作流程。CUDA 算子优化是一项高门槛的工作,需要资深 CUDA 工程师投入大量时间,单项算子优化通常耗时数天。随着国产芯片的普及,尤其在部分非 GPGPU 架构(如部分国产 AI 加速卡)中,算子优化任务更加复杂和艰巨。
说明:
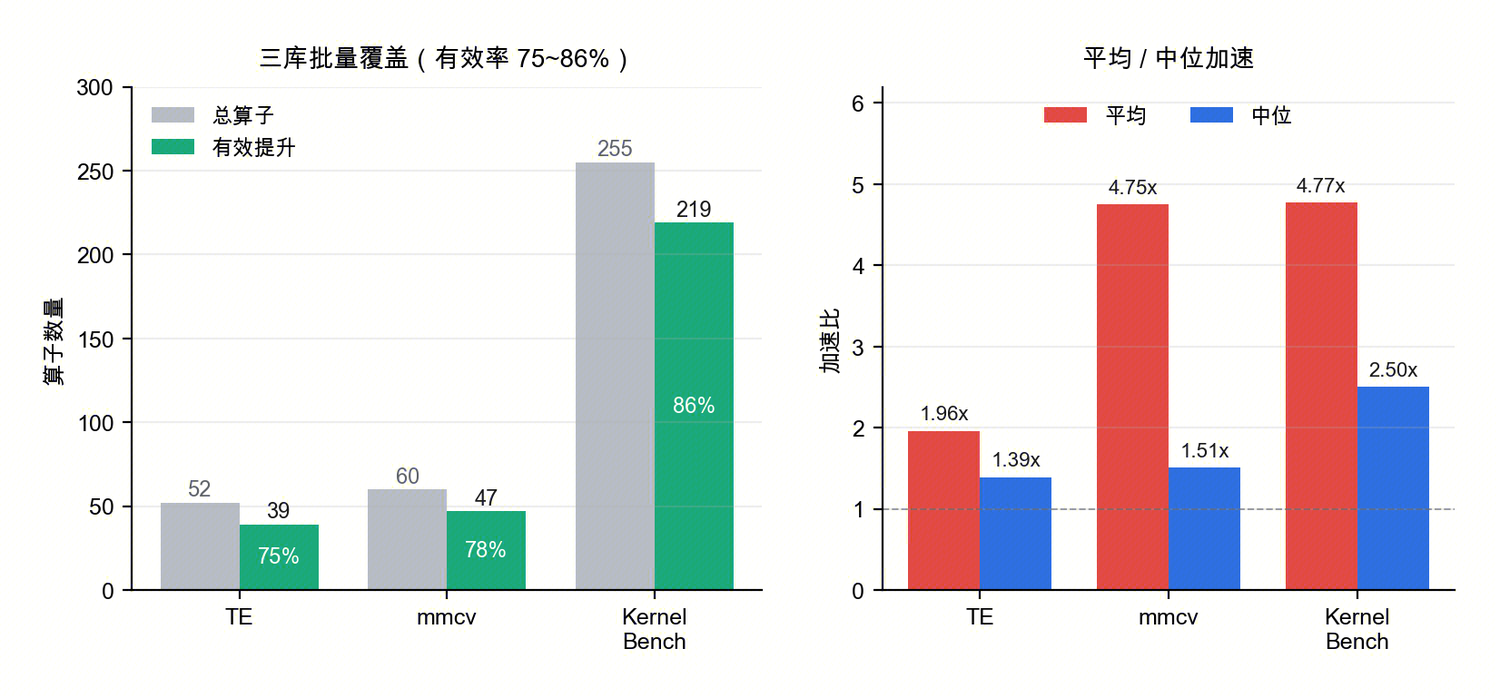
为提升算子优化效率,腾讯云推出支持多硬件后端的算子优化平台 Hyper Kernel。该平台基于“Agent + Skill + Orchestrator”范式,将领域专家经验凝练为结构化 Skill,将算子迭代优化过程沉淀为多 Agent 协同工作流程,实现 AI 算子优化的零人工干预执行。基于前沿模型,在本文列示的 Transformer Engine、mmcv 和 KernelBench 测试集中,获得有效提升的算子占比分别为 75%、78% 和 86%;平均加速比分别为 1.96 倍、4.75 倍和 4.77 倍。结果仅反映相应测试集和测试环境下的情况。
说明:
上述测试结果仅反映相应测试集和测试环境下的情况。
Transformer Engine、mmcv 和 KernelBench 分别在各自固定的代码版本内进行测试,同一测试集内采用统一的原始实现作为比较基线,各测试集之间不作横向性能比较。
国产硬件迁移挑战
跨平台迁移难点
不同硬件平台在执行模型、内存层级、API 兼容性及工具链方面存在差异,既有优化经验无法直接迁移,需要结合目标硬件的软件栈、开发文档和实际测试结果重新适配。API 名称变化仅是表面,底层的线程模型、内存层级、指令行为均存在差异,任何一个未适配的点都可能导致结果出错或性能下降。
跨平台迁移的难点还在于底层硬件抽象的差异——同一段 GPU 代码在不同厂商芯片上,并行模型、内存层次、同步机制各不相同。这些差异无法通过简单的 API 替换解决,需要对每个算子的并行逻辑重新审视。
核心挑战
以迁移到某款国产芯片为例,面临以下四个方面的核心挑战:
底层并行模型不同:该国产芯片的执行单元与 NVIDIA GPU 的 Warp 存在核心区别。两者均遵循 SIMT(单指令多线程)编程模型,但底层最关键的执行单元大小和实现机制不同,直接导致性能特性和优化策略的差异。
API 表面相似但行为不同:该芯片通过自定义接口对接 CUDA 生态,大部分 API 可一一映射,但部分高级特性(如计算图捕获、流同步等)行为不同或不支持。表面上的字符串替换可能埋下运行时的隐性缺陷。
代码与框架深度耦合:部分算子并非独立 kernel,而是深度依赖 PyTorch 内部基础实现(如随机数状态管理、张量元信息描述等),这些内部接口在国产芯片端没有对应物,需要将核心计算逻辑提取后独立重写。
缺乏国产芯片调优经验:国产芯片公开资料较少,资料相对少于类似 NVIDIA Nsight 的全套工具链。优化策略需从架构白皮书或编程手册逐项推导,试错成本高,且不同算子的最优策略可能截然不同。
使用场景
Hyper Kernel 适用于以下几类典型的算子优化与迁移场景。以下场景描述了平台在实际工作中的应用方式,具体案例与数据请结合实际情况补充。
场景一:国产芯片算子适配
当团队需要将算子迁移适配到国产芯片,但缺乏对应的调优经验、公开资料有限时,可将待适配算子提交平台,由平台结合已沉淀的硬件 Skill 自动完成优化,产出经过精度校验和性能验证的实现,降低从零摸索的试错成本。
场景二:存量算子批量提效
当团队已有一批算子需要统一做性能优化时,可通过关联代码仓库或批量上传的方式一次性提交,平台按可用硬件资源并行执行优化任务,并汇总每个算子的提升情况,适合规模化的性能提效工作。
场景三:框架/库移植后的性能补齐
当框架或算子库移植到新硬件后,机械转译得到的实现往往存在明显的性能缺口。此时可将这些实现提交平台做进一步优化,在保证精度的前提下补齐性能基线,减少人工逐个调优的投入。
典型算子优化实测
一套具备可信度的方法论,需基于规模化算子集开展验证,不应仅选取少量典型样例佐证结论。我们依托三套开源库完成批量实测.
Transformer Engine & mmcv & KernelBench
在 Transformer Engine(TE)、mmcv 和 KernelBench 三个库上的测试结果进一步验证了覆盖面:
测试库 | 算子总数 | 有效提升数 | 有效提升率 | 平均加速倍数 |
Transformer Engine | 52 | 39 | 75% | 1.96 倍 |
mmcv | 60 | 47 | 78% | 4.75 倍 |
KernelBench | 255 | 219 | 86% | 4.77 倍 |
下图展现的是 Kernel Engine 在 TE & mmcv & KernelBench 三个库的优化表现:
说明:
硬件型号及数量: DCU HCCPD1;驱动/运行时版本: 6.3.31-V1.5.1;操作系统: Ubuntu 22.04.5;编译器: dcc 25.10.0-0;框架: PyTorch 2.9.0 ;DTK 版本: dtk26.04 。
模型/算子版本:由开源库直接拉取,具体版本及地址如下:
输入 Shape、数据精度:以测试用例为准。
有效提升指优化方案通过误差阈值校验,且相较统一基线的加速比大于1。测试结果取平均值;平均加速比采用算术平均计算,并不包含未提升及失败样本。结果仅反映相应代码版本、输入 Shape、数据精度和软硬件环境下的表现。
结论表明,Transformer Engine 的52个算子中有39个获得有效提升,平均加速1.96倍。mmcv 60 个算子中 47 个获得有效提升,平均加速 4.75 倍,其中
active_rotated_filter 算子最高加速达数十倍。KernelBench 是斯坦福发布的用于评测 LLM 生成 kernel 能力的标准 benchmark,255 个算子中 219 个获得有效提升(86%),中位加速 2.5 倍,平均加速 4.77 倍。注意:
文中涉及的第三方产品、软件、框架、模型及商标名称归其各自权利人所有,仅用于说明 Hyper Kernel 的适配或使用场景,不构成任何认可、合作、担保或背书。
各类算子加速汇总
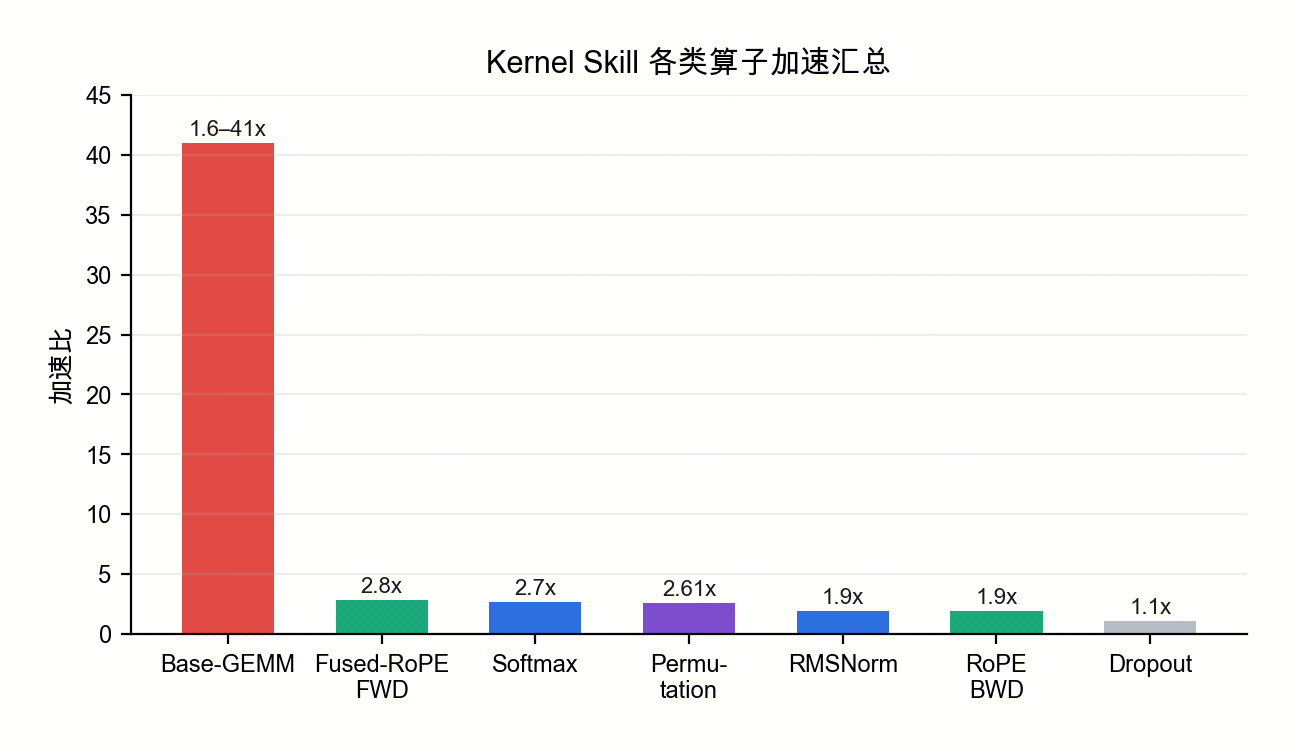
Kernel Skill 在不同类型算子上的加速效果如下:
算子类型 | 加速倍数 |
GEMM | 1.6 - 41 倍 |
Softmax | 2.7 倍 |
Fused-RoPE FWD | 2.8 倍 |
Fused-RoPE BWD | 1.9 倍 |
基于证据的 HIP Kernel 迭代优化流程
Skill 优化的核心是将各项硬规则串联为一条可迭代、可审计的完整流程。资深工程师优化算子时遵循严谨的方法论:先通过 profiling 分析性能瓶颈,判断算子属于算力受限还是访存受限;尝试优化方案后,与前一版本对比测试;最终保留更优结果。平台让 AI 严格遵循这一流程执行,确保每一步优化决策均有数据支撑,每一项变更均可追溯其优化依据。HIP Kernel 迭代优化流程如下:
HIP Kernel 优化采用迭代式流程,整体分为四个阶段:环境预检、结构性预分析、迭代优化循环和交付写回。迭代优化循环是核心环节,通过反复执行 Profile、Roofline 分类、策略选择、候选生成、择优、验证和状态更新,逐步逼近性能最优解。
迭代优化循环的每一轮包含以下四个关键步骤:
Profile 量化瓶颈:通过 Profiler 工具采集真实性能数据,获取算子的实际运行指标,而非依赖经验估算。
Roofline 定位方向:判断当前瓶颈属于算力受限还是带宽受限,将优化资源分配至瓶颈所在维度。当性能接近理论极限时,自动触发早停机制。
选择方法并择优:Agent 从知识库中匹配与瓶颈类型对应的优化手段,生成多路候选方案,通过基准测试对比后选择最优结果。
证据验收:使用 Profiler 数据和 ISA 层级证据验证性能收益,确保优化效果可度量、可复现。缺乏证据支持的优化结果不予采纳。
持续迭代
平台支持优化结果的不断升级:
算子本身不变,优化结果以可更新的快照形式保存。
每轮优化完成后,自动对比性能,保留更优版本。
所有历史记录形成版本链,可回溯、可分析。
优化数据直接用于升级 Skill 规则,形成持续闭环。
行业价值
平台为国产芯片生态构建“加速器”与“连接器”,体现在以下三个方面:
降低生态门槛,实现经验资产化:平台将稀缺的硬件调优经验结构化、代码化为可复用的 Skill 库,降低经验复用门槛。
缩短部署周期,提升国产硬件吸引力:通过自动化优化,并复用已验证的优化策略和硬件 Skill,减少重复迁移和调试工作,提升国产硬件适配效率。同时可以保障性能基线,降低国产硬件的适配成本。
牵引软硬协同与工具链成熟:平台在抽象多硬件差异、沉淀优化模式的过程中,形成的最佳实践和性能模型可与硬件厂商共建更高效、更统一的软硬件接口与工具链,助力构建健康、自主的算力生态。
展望
Skill 知识库持续进化:覆盖多种国产硬件的架构差异、API 映射和优化策略,每次实战的经验自动回流,持续提升准确度。
多平台扩展:Skill 按硬件平台分层组织,新增硬件平台时,可复用现有调度、验证和迭代框架,并结合目标硬件补充相应的硬件 Skill 和适配验证。
小结
从 Skill 迭代生成框架,到跨硬件后端的领域知识沉淀,再到 Harness Engineering 的工程底座,Hyper Kernel 构建了一个三层闭环系统:
Skill 提供 Agent 决策的先验知识。
Harness 提供将决策转化为可信实测结果的确定性基础设施。
实测结果反过来驱动 Skill 演进。
该架构的核心思路,是将大模型生成高性能 CUDA Kernel 这一高度非确定性问题,纳入确定性闭环控制系统进行约束,以此满足生产环境在可靠性、可观测性与可迭代性方面的严苛要求。在已完成硬件 Skill 构建和适配验证的场景中,平台可自动执行算子优化任务;当前支持范围以已验证硬件、软件版本及算子清单为准。
平台的价值不止于提升算子优化效率,更关键的是借助 AI 原生工程范式,面向持续迭代的新一代 AI 硬件搭建自适应、可持续演进的底层算力适配层。从长期视角来看,该体系能够降低 AI 产业对单一硬件生态的依附程度。


