前提条件
开始之前,请确认已具备以下条件:
已获得平台访问权限:可正常登录并进入优化任务界面。
准备好待优化的算子代码:可以是单个算子源码,也可以是包含依赖头文件、配置及测试用例的完整工程。
明确目标硬件:已确认要优化到的目标芯片,且该芯片在平台当前支持范围内(如不确定,请参见 使用限制)。
注意:
文中涉及的第三方产品、软件、框架、模型及商标名称归其各自权利人所有,仅用于说明 Hyper Kernel 的适配或使用场景,不构成任何认可、合作、担保或背书。
操作步骤
此处以优化单个算子为例,介绍从提交代码到查看结果的完整操作流程。
第 1 步:进入平台,创建优化任务
登录平台后,单击顶部创建任务,进入单算子优化页面。页面结构如下:
左侧为提交算子代码区,用于配置和提交待优化算子
右侧为执行区,实时展示优化进度与结果。
第 2 步:选择目标芯片与优化模型
在左侧顶部的两个下拉框中,分别选择本次优化的目标芯片(算子将在该硬件上编译、运行与评测)和优化所用模型。
说明:
请确保所选芯片在平台当前已支持的范围内(目前仅支持 DCU、Nvidia)。
第 3 步:填写任务名称(可选)
在任务名称输入框中填写便于识别的任务名称(例如按算子名或优化目标命名)。该项为可选,留空时平台会自动生成默认名称(如
RoPE FWD 优化)。填写后便于后续在任务列表中检索和区分。第 4 步:提交算子代码
平台为您提供以下三种算子提交方式,可使用标签页切换:
粘贴代码:直接将 HIP/CUDA 算子代码粘贴到输入框,适合快速验证单个算子。可将完整算子代码、测试用例及编译脚本(例如 Makefile、CMakeLists)一并粘贴,平台将自动识别代码结构并进行优化。
上传文件:上传算子源码及其依赖文件(支持
.h、.hpp、.cu、.cuh、.cpp、.hip、.py、.json、.xml、.yaml 等类型),文件夹上传时保留原有目录结构。示例代码:如仅需快速体验操作流程,可直接加载平台内置的示例代码。
说明:
为确保优化效果与精度校验结果的准确性,建议将算子依赖的头文件、配置及测试用例一并提交,避免因上下文缺失导致校验偏差。
第 5 步:开始优化并查看进度
确认配置无误后,单击开始优化提交任务。右侧执行区会按照初始化 > 基准 > 优化 > 精度 > 验证 > 报告的阶段实时展示进度。整个过程自动执行,无需人工干预。您可随时查看当前所处阶段,或在必要时中途终止任务。
第 6 步:查看优化报告与结果
优化完成后,右侧会生成优化报告,包含性能对比(加速比、优化前后耗时与带宽)、精度校验结果,以及优化后代码及其与原始代码的 diff。确认结果符合预期后,可下载优化后的代码。所有任务均可在任务列表中查看状态(运行中/已完成/已停止)、重入查看或复盘。
批量优化
当需要一次性优化多个算子时,单击顶部批量优化,通过关联代码仓库或批量上传的方式提交算子,并统一选择目标芯片、优化模型与全局优化 Prompt。平台将根据可用硬件资源并行执行各子任务,并在批量任务报告中汇总每个算子的优化情况。
输入
平台支持多种方式提交待优化的算子代码,您可以根据自身工程习惯选择:
直接粘贴代码:适合快速验证单个算子。
上传文件或文件夹:支持算子源码及其依赖的头文件、配置文件等常见类型(如
.h、.hpp、.cu、.cuh、.cpp、.hip、.py、.json、.xml、.yaml),文件夹上传时保留原有相对路径结构。关联代码仓库:提供代码仓库地址,由平台拉取待优化算子,适合对接已有工程。
提交时可选择目标硬件后端与优化所用模型,并可填写任务名称、全局优化 Prompt 等可选项,用于对同一批任务做统一约束。
执行流程
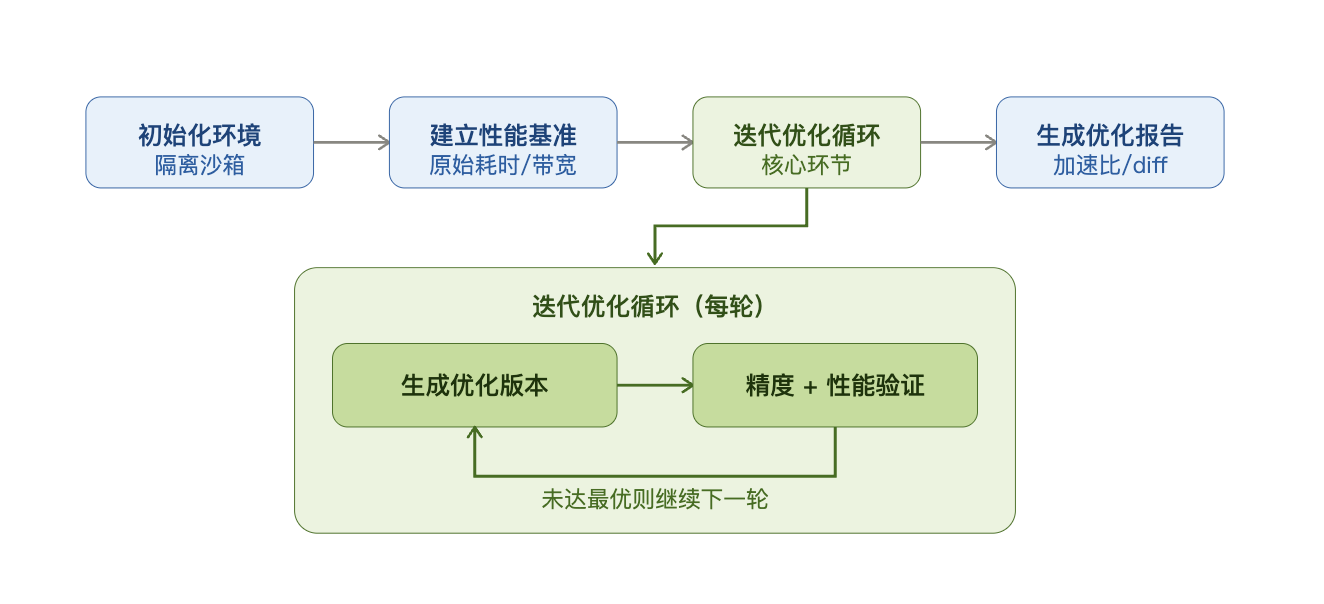
提交算子后,平台以 Episode 为单位完成单个算子的优化循环,全程无需人工干预。一次完整优化通常经历以下阶段:初始化环境、建立性能基准、迭代优化、精度校验、性能验证,最终生成优化报告。其中,迭代优化环节由 Kernel Optimizer Skill 生成优化版本,在隔离环境中完成编译与 Benchmark,再由 Oracle 验证正确性并评测性能。您可在任务列表中实时查看每个任务的运行状态(运行中/已完成/已停止),随时重入查看进度,或中途终止任务。
输出
优化完成后,平台生成一份可查看、可下载的优化报告,主要包含:
性能对比:优化前后的耗时与带宽、加速比等关键指标,直观反映优化收益。
精度校验结果:标明优化后算子是否通过精度验证,确保正确性。
优化后代码:可查看优化前后的代码 diff,支持保留多个优化版本并下载。
所有任务及其历史记录均可在任务列表中回溯,便于对比不同版本、复盘优化过程。
使用限制
平台架构预留 GPU/NPU 等后端扩展能力。当前已验证的硬件型号、驱动、运行时和算子范围以交付清单为准;其他硬件平台的适配能力需以实际验证结果为准。接入前请先确认目标硬件与算子是否在当前支持范围内(目前仅支持 DCU、Nvidia)。
常见问题
Q:提交代码后一直没有开始优化怎么办?
请先确认所选目标芯片在平台支持范围内,且提交的代码结构完整(含必要的依赖文件)。若使用关联代码仓库方式,请确认仓库地址可访问。
Q:优化后的算子精度没通过校验,说明什么?
说明该轮优化生成的实现未满足精度阈值要求,平台不会将其作为有效结果采纳。您可以查看报告中的精度校验详情,必要时补充更完整的测试用例后重新提交。
Q:一次能优化多少个算子?
单任务针对单个算子;如需批量处理,请使用批量优化,平台将按照可用硬件资源并行执行多个子任务。
Q:优化结果可以回溯吗?
可以。每个任务的优化结果以版本形式保存,可在任务列表中查看历史记录、对比不同版本,并下载所需版本的代码。
使用建议
为帮助您更高效地使用平台并获得可靠的优化结果,结合平台的工作方式,给出以下实践建议:
首先确认硬件与算子在支持范围内:接入前核对目标硬件后端和算子类型是否已被平台验证支持。对于尚在扩展中的硬件,建议先做小批量试跑,再决定是否规模化投入。
从单算子试跑起步,再转批量:首次使用时,建议先通过粘贴代码的方式,对单个代表性算子进行一次完整优化,以熟悉基准 > 优化 > 精度 > 验证 > 报告各阶段的产出形态。确认效果符合预期后,再通过关联代码仓库或批量上传,将优化范围扩展至批量算子。
提交完整的依赖上下文:部分算子深度依赖框架内部实现或头文件、配置。上传时,建议保留目录结构,将相关依赖文件一并提交,避免因上下文缺失影响优化和精度校验。
善用全局优化 Prompt 统一约束:批量优化时,可通过全局 Prompt 对精度阈值、优化偏好等参数进行统一设置,使同一批任务遵循相同标准,便于横向对比优化效果。
以报告数据为准做决策:平台的加速比、精度校验、耗时与带宽等指标均基于实测数据。是否采纳某一优化版本,应以报告中的性能收益和精度结果为依据,而非仅凭预期。优化效果会因算子类型、起始版本、硬件环境和优化配置而有所差异。
利用版本链复盘与回溯:优化结果以可更新的快照形式保存并形成版本链。当某次优化不理想时,可回溯历史版本对比分析,也可将失败尝试作为后续优化的经验参照。


