接口描述
本接口用于对 60 秒之内的短音频文件进行识别。
音频格式支持 wav、pcm、ogg-opus、mp3、m4a。
请求方法为 HTTP POST,
Content-Type 为 "application/json; charset=utf-8"。说明:
接口要求
集成一句话识别 API 时,需按照以下要求。
内容 | 说明 |
语言种类 | 支持中文普通话、中文方言、英语,以及日语、韩语、法语等小语种。 |
支持行业 | 通用。 |
音频属性 | 采样率:16000Hz(pcm 格式例外,可通过 InputSampleRate 参数支持 8000Hz,详见 输入参数 说明); 采样精度:16bits; 声道:单声道(mono)。 |
音频格式 | wav、pcm、ogg-opus、mp3、m4a。 |
请求协议 | https 协议。 |
请求地址 | https://域名/v1/SentenceRecognition?\\{请求参数\\}。 |
响应格式 | JSON。 |
数据发送 | 支持本地语音文件上传和语音 URL 上传两种请求方式,音频时长不能超过 60s,音频文件大小不能超过 3MB。 |
并发限制 | 默认单账号限制并发数为 30 次每秒。 |
说明:
同一 SDKAppID 下,直接接入 ASR、AI 对话、AI 转录/翻译等所有实时语音识别场景共享该并发池,即各类型的并发路数合计不超过账号上限。一句话识别与录音文件识别独立计算,不占用实时识别并发额度。如您有更多并发需求,请 联系我们。
业务流程图
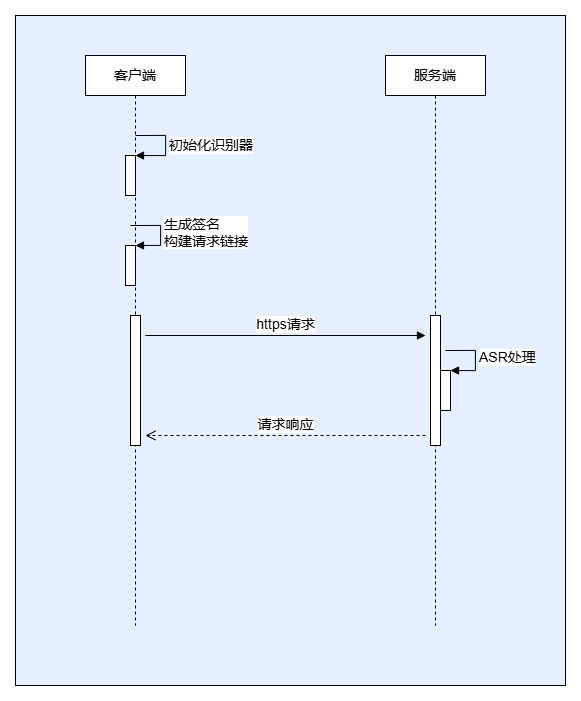
接口调用流程
请求格式
客户端发起 HTTP POST 请求,请求 URL 格式为:
正式环境:
https://asr.cloud-rtc.com/v1/SentenceRecognition?\\{请求参数\\}在请求 header 中填写以下字段:
请求参数
请求参数格式为:
AppId=value1&RequestId=value2参数说明:
参数名 | 必填 | 类型 | 描述 |
AppId | 是 | String | |
RequestId | 是 | String | 全局请求唯一 ID(uuid),该参数用来生成请求 UserSig。 |
输入参数
一句话识别的请求消息体,格式为 json。
参数说明:
参数名 | 必填 | 类型 | 描述 |
EngSerViceType | 是 | String | 语音识别2.0(推荐) bigmodel:大模型引擎,支持实时说话人分离。 语音识别1.0 基础版引擎:8k_zh; 标准版引擎:可配置8k_zh_large、16k_zh_large 或 16k_zh_en; 高级版引擎:小语种 ASR 引擎,传参是“16k_具体语种 code”,例如 16k_vi(越南语)。 |
Language | 否 | String | 语音识别2.0 (推荐) bigmodel 支持 zh(中文普通话、中文方言和中英混)、en(英语)、yue(粤语)和小语种。 中文方言:安徽、东北、福建、甘肃、贵州、河北、河南、湖北、湖南、江西、宁夏、山东、陕西、山西、四川、天津、云南、浙江、粤语(香港口音)、粤语(广东口音)、吴语、闽南语 小语种:ar(阿拉伯语)、de(德语)、fr(法语)、es(西班牙语)、pt(葡萄牙语)、id(印尼语)、it(意大利语)、ko(韩语)、ru(俄语)、th(泰语)、vi(越南语)、ja(日语)、tr(土耳其语)、hi(印地语)、ms(马来语)、nl(荷兰语)、sv(瑞典语)、da(丹麦语)、fi(芬兰语)、pl(波兰语)、cs(捷克语)、fa(波斯语)、el(希腊语)、ro(罗马尼亚语)、hu(匈牙利语)、mk(马其顿语)。 说明: 当 EngSerViceType 配置为 bigmodel,不填写 Language 字段时,模型会自动识别语种。 语音识别1.0 基础版 8k_zh 支持中文普通话和中文方言。 标准版 8k_zh_large 支持中文普通话和中文方言; 16k_zh_large 支持中文普通话和中文方言; 16k_zh_en 支持中文普通话、中文方言、英语和中英混。 高级版 vi(越南语)、ja(日语)、ko(韩语)、id(印度尼西亚语)、th(泰语)、pt(葡萄牙语)、tr(土耳其语)、ar(阿拉伯语)、es(西班牙语)、hi(印地语)、fr(法语)、ms(马来语)、fil(菲律宾语)、de(德语)、it(意大利语)、ru(俄语)、sv(瑞典语)、da(丹麦语)、no(挪威语) |
NoiseThreshold | 否 | float | 噪音参数阈值,默认为2.0,取值范围:[0.0,4.0],对于一些音频片段,取值越大,判定为噪音情况越大;取值越小,判定为人声情况越大。 |
SourceType | 是 | Integer | 语音数据来源: 0:语音 URL; 1:语音数据(post body)。 |
VoiceFormat | 是 | String | 识别音频的音频格式,支持 wav、pcm、ogg-opus、mp3、m4a。 |
Url | 否 | String | 语音的 URL 地址,需要公网环境浏览器可下载。当 SourceType 值为 0 时须填写该字段,为 1 时不填。音频时长不能超过 60s,音频文件大小不能超过 3MB。 |
Data | 否 | String | 语音数据,当 SourceType 值为 1(本地语音数据上传)时必须填写,当 SourceType 值为 0(语音 URL 上传)可不写。必须使用 Base64 编码(采用 Python 语言时注意读取文件应该为 string 而不是 byte,以 byte 格式读取后要 decode()。编码后的数据不可带有回车换行符)。音频时长不能超过 60s,音频文件大小不能超过 3MB(Base64 编码后)。 |
DataLen | 否 | Integer | 数据长度,单位为字节。当 SourceType 值为 1(本地语音数据上传)时必须填写,当 SourceType 值为 0(语音 URL 上传)可不写(此数据长度为数据未进行 Base64 编码时的数据长度) |
WordInfo | 否 | Integer | 是否显示词级别时间戳: 0:不显示; 1:显示,不包含标点时间戳; 2:显示,包含标点时间戳。 默认值为 0。 |
FilterDirty | 否 | Integer | 是否过滤脏词(中文普通话): 0:不过滤脏词; 1:过滤脏词; 2:将脏词替换为 \\*。 默认值为 0。 |
FilterModal | 否 | Integer | 是否过滤语气词(中文普通话): 0:不过滤语气词; 1:部分过滤; 2:严格过滤。 默认值为 0。 |
FilterPunc | 否 | Integer | 是否过滤标点符号(中文普通话): 0:不过滤; 1:过滤句末标点; 2:过滤所有标点。 默认值为 0。 |
ConvertNumMode | 否 | Integer | 是否进行阿拉伯数字智能转换: 0:不转换,直接输出中文数字; 1:根据场景智能转换为阿拉伯数字。 默认值为 0。 |
HotwordList | 否 | String | 临时热词表:该参数用于提升识别准确率。 单个热词限制: “热词|权重”,单个热词不超过 30 个字符(最多 10 个汉字),权重 1-11 或者 100,例如:“热词|5” 或 “ASR|11”;临时热词表限制:多个热词用英文逗号分割,最多支持 128 个热词,例如: “热词|10,语音识别|5,ASR|11”。注意: 热词权重设置为 11 时,当前热词将升级为超级热词,建议仅将重要且必须生效的热词设置到 11,设置过多权重为 11 的热词将影响整体字准率。 热词权重设置为 100 时,当前热词开启热词增强同音替换功能(仅支持 8k_zh, 16k_zh)。举例:热词配置 “蜜制|100”时,与“蜜制”同拼音(mizhi)的“秘制”的识别结果会被强制替换成“蜜制”。 |
InputSampleRate | 否 | Integer | 支持 pcm 格式的 8000 音频在与引擎采样率不匹配的情况下升采样到 16000 后识别,能有效提升识别准确率。仅支持:8000。如:传入 8000,则 pcm 音频采样率为 8000,当引擎选用 16k_zh,那么该 8000 采样率的 pcm 音频可以在 16k_zh 引擎下正常识别。 注意: 此参数仅适用于 pcm 格式音频,不传入值将维持默认状态,即默认调用的引擎采样率等于 pcm 音频采样率。 |
响应格式
响应消息为 json 格式,所有返回字段都位于顶层 Response 对象之内。
参数说明:
参数名 | 类型 | 描述 |
Response | Object | 顶层响应对象,包含以下字段。 |
Response.Result | String | 识别结果。 |
Response.AudioDuration | Integer | 请求的音频时长,单位为 ms。 |
Response.WordSize | Integer | 词时间戳列表的长度。 注意: 此字段可能返回 null,表示取不到有效值。 |
Response.WordList | Array of SentenceWord | 词时间戳列表。 注意: 此字段可能返回 null,表示取不到有效值。 |
Response.RequestId | String | 请求的 RequestId,定位问题时需要提供该次请求的 RequestId。 |
SentenceWord 定义为:
名称 | 类型 | 描述 |
Word | String | 词结果。 |
StartTime | Integer | 词在音频中的开始时间。 |
EndTime | Integer | 词在音频中的结束时间。 |
示例
用户通过 SourceType=1 请求一句话识别,请求如下:
请求网址:
https://asr.cloud-rtc.com/v1/SentenceRecognition?AppId=12345&RequestId=2f5e8263-a23b-4e65-be22-6b7c19bd4064
输入参数:
{"EngSerViceType": "16k_zh_en","SourceType": 1,"VoiceFormat": "wav","Data": "xxxxxxxx","DataLen": 8}
响应结果:
{"Response": {"Result": "我们能接受的范围内。","RequestId": "2f5e8263-a23b-4e65-be22-6b7c19bd4064","AudioDuration": 1840}}
开发者资源
SDK
Tencent-RTC SDK for go:Github
Tencent-RTC SDK for python:Github
Tencent-RTC SDK for nodejs:Github
Tencent-RTC SDK for java:Github
Tencent-RTC SDK for rust:Github
Tencent-RTC SDK for cpp:Github
SDK 调用示例
Java 示例
Rust 示例
CPP 示例
错误码
数值 | 说明 |
400 | 音频发送失败。 |
413 | 音频超限。 |
400 | 音频为空。 |
400 | 请求消息体格式错误。 |
4002 | 鉴权失败。 |
4003 | AppID 服务未开通,请在控制台开通服务。 |
4004 | 资源包耗尽,请开通后付费或者购买资源包。 |
4005 | 账户欠费停止服务,请及时充值。 |
4006 | 账号当前调用并发超限。 |
4007 | 音频解码失败,请检查上传音频数据格式是否与调用参数一致。 |
5000 | 因机器负载过高、网络抖动等导致失败,请重新发起新识别。 注意: 该问题通常为偶发,少量出现可忽略,发起新识别即可。 |
5001 | 因机器负载过高、网络抖动等导致失败,请重新发起新识别。 注意: 该问题通常为偶发,少量出现可忽略,发起新识别即可。 |
5002 | 因机器负载过高、网络抖动等导致失败,请重新发起新识别。 注意: 该问题通常为偶发,少量出现可忽略,发起新识别即可。 |


