Don't Look Twice :更快的视频 Transformers与游程长度记号化 !

Don't Look Twice :更快的视频 Transformers与游程长度记号化 !
未来先知
发布于 2024-12-09 14:30:50
发布于 2024-12-09 14:30:50
Transformer 在训练视频时速度较慢,因为输入 Token 的数量极大,尽管许多视频 Token 在一段时间内会重复。 现有方法要么具有较大的开销,抵消了任何速度提升,要么需要针对不同的数据集和示例进行调整。作者提出了一种名为Run-Length Tokenization(RLT)的简单方法,受数据压缩中的Run-Length编码启发,可加速视频 Transformer 的训练。 RLT在模型推理之前高效地找到并删除随着时间的推移重复的'块',然后用一个块和一个位置编码来表示新 Token 的长度。作者的方法具有_内容感知性_的特点,无需针对不同的数据集进行调整,且_快速_,开销可以忽略不计。 RLT在训练中取得了巨大的加速效果,将视频 Transformer 微调的墙时时间减少了30%,同时保持了 Baseline 模型性能。RLT在不需要任何训练的情况下,将模型吞吐量提高了35%,准确率仅降低了0.1%。 RLT在30 FPS的训练速度上提高了超过100%,在更长的视频数据集中, Token 数量最多可减少80%。 作者的项目页面位于https://rccchoudhury.github.io/projects/rlt/。
1 Introduction
视觉 Transformer [11]因具有扩展特性和微小的归纳偏差而在建模图像和视频中取得了巨大成功。然而,将这些模型应用于视频,其通常具有比图像大得多的 Token ,训练起来要显著昂贵得多。一个导致这种现象的因素是,视频 Transformer 将视频分割成大小相等的时空块[2; 3],然后将其嵌入潜在 Token 空间。因此, Token 数量仅取决于视频的长度和分辨率。因此,研究行人被迫使用非常短的视频(<10秒),并将其显著降低为每秒低帧数(FPS)和低空间分辨率。
减少输入 Token 数可能是解决此问题的一个有前景的解决方案。与语言输入相比,视频的信息密度要显著低得多;许多工作观察到视频主要由冗余或无信息 Token 组成。然而,旨在减少输入 Token 数以使视觉 Transformer 生效的方法现有采用有限。学习剪枝方法减少了模型复杂度(以GFLOPS衡量),但要么在训练过程中产生大量开销,要么需要填充以处理 Token 数的变化,从而抵消了训练过程中的加速效果。随机 Mask [1; 27]虽然速度快,但会降低准确性,因此需要更多的训练时间才能达到性能匹配。此外,尽管随机 Mask 和 Token 合并[5]等方法确实可以实现墙时速度提升,但它们并不是内容 Aware 的:它们只移除每个视频固定数量的 Token ,而从高速、高动作剪辑移除的 Token 数与从反复多次的静止图像中移除的 Token 数相同。
作者认为,内容 Aware 可以更有效地减少输入 Token 的数量。例如,想象一个长达一小时的讲座视频。在时间上,大多数帧都是相同的,只显示一个幻灯片。现有方法从这两个视频中产生的 Token 数量将与一个小时的动作丰富的GoPro视频产生的 Token 数量相同,尽管这两个视频的内容量有显著差异。另一方面,视频压缩器,如H.264和H.265[46, 41],明确地具有内容 Aware :而不是独立编码帧,它们在连续帧之间编码像素差异,在没有变化的情况下,可以大大减少视频大小。
作者提出了Run-Length Tokenization (RLT),将这个简单版本的思路与经典的长序列编码相结合,用于对视频进行分词。作者的洞察力在于,作者可以高效地识别输入 Patch 在时间上的重复“runs”,从而根据视频内容减少 Token 数量。在分词过程中,作者比较连续的时间段内的 Patch ,并将具有足够小差异的 Patch 分组在一起。然后删除“重复”的 Patch ,并将剩余的 Token 视为具有可变长度的 Token 。类似于字符串“aaaabb”可以被编码为“a4b2”,作者可以在每个 Token 中添加长度信息,而无需增加额外的开销,同时保留从删除冗余 Token 中丢失的信息。尽管它很简单,但RLT的工作效果非常好 - 利用它,作者可以在基准ViTs的40%更快的计算时间下微调视频 Transformer ,同时保持性能。
作者贡献如下:
(1)作者提出了一种名为RLT的视频分词方法,该方法可以用于为视觉 Transformer (vision transformers)进行分词。
(2)作者对该方法进行了详细的性能比较,并与先前的方法进行了比较,发现RLT在速度上有显著的改进。
(3)作者在高帧率(high-FPS)和更长的视频上评估了RLT的性能。
(4)作者分析了RLT的设计选择,并对其输出进行了定性可视化。
作者认为RLT可以成为显著加速并进一步扩展视频理解的关键一步。
2 Related Work
视频 Transformer 。 视觉 Transformer 已成功应用于视频,但通常在相对较短的视频片段(<10s)上进行训练和评估,这些片段帧数较少。为了高效处理视频,许多工作在其架构中引入了针对视频的特定归纳偏差,例如内存[49, 35],压缩线索[48]或修改注意机制[30, 53]。其他方法,尤其是在视频生成中,将视频映射到较小的潜在空间[20],然后将其分割成块。作者采用标准的ViT公式,但应用不同的分词方案,将输入 Token 数量减少,从而提高速度,同时保持性能。
视频分词。 在视觉 Transformer 出现之前,视频架构被设计为接受固定大小的输入 [14, 40, 55]。然而, Transformer 可以处理任意数量的输入 Token [44],在语言建模中 [23],使用可变大小的输入进行训练是标准做法;这已经被用于训练具有可变分辨率的视觉 Transformer [4, 10]。然而,视频 Transformer 仍然通常使用在 [2, 3] 中引入的时空patch Token 方案,该方案是内容无关的: Token 的数量仅取决于视频的长度和分辨率。一些工作试图通过将视频压缩到潜在空间然后 Token 来减少输入大小 [12, 33, 6],但 Token 的数量仍然严格取决于输入视频的尺寸。另一方面,标准的视频压缩器,如HEVC [41] 和 AVC [46],是内容 Aware 的:它们积极考虑连续帧之间的差异以实现更有效的压缩。作者的工作将这一思想应用于视频 Transformer ,通过压缩静态 Token 并跟踪它们的长度。
更快的学习速度:许多工作尝试通过学习模块或注意力分数等方式识别无信息 Token ,并在每一层修剪它们。尽管 Transformer 可以处理不同大小的输入,但这些方法需要填充,因为 Token 数量会随着每一层的变化而无法预测地改变。其他一些工作将 Token 组合在一起而不是修剪它们。这些大多数工作都需要为修剪或合并模型进行训练,除了[5]的 Token 合并,它展示了在推理时的强大结果。受的 Mask 预训练[17, 45, 43, 15]的成功启发,另一条线的工作使用随机 Mask 来加速训练。尽管 Mask 在相同数量的批处理后会导致更糟糕的性能,但巨大的加速效果使得在更短的时间内训练更多周期。
相比之下,作者的方法与具有相同数据量的基本模型匹配性能,并在更短的时间内实现更大的速度提升,可以与随机 Mask 堆叠以获得更大的速度优势。与作者的方法紧密相关的是EVEREST[18]和STA[36],两者都利用时间相似性识别冗余 Token 。然而,与[5]一样,这两种工作都需要为每个视频设置一个恒定的 Token 数量来删除,而RLT可以根据视频内容删除不同数量的 Token 。
3 Method
考虑一个视觉 Transformer ,它将输入视频 。标准的分词方案将 分成一组大小均匀、非重叠的 P 个 Patch ,每个 Patch 大小为 ,其中 称为管状大小。这些 Patch 通过 MLP 映射到较低维度的 ,从而得到 个 Token ,每个 Token 对应一个不同的时空位置。这使得具有相同大小的任何输入视频具有相同的 Token 数量。
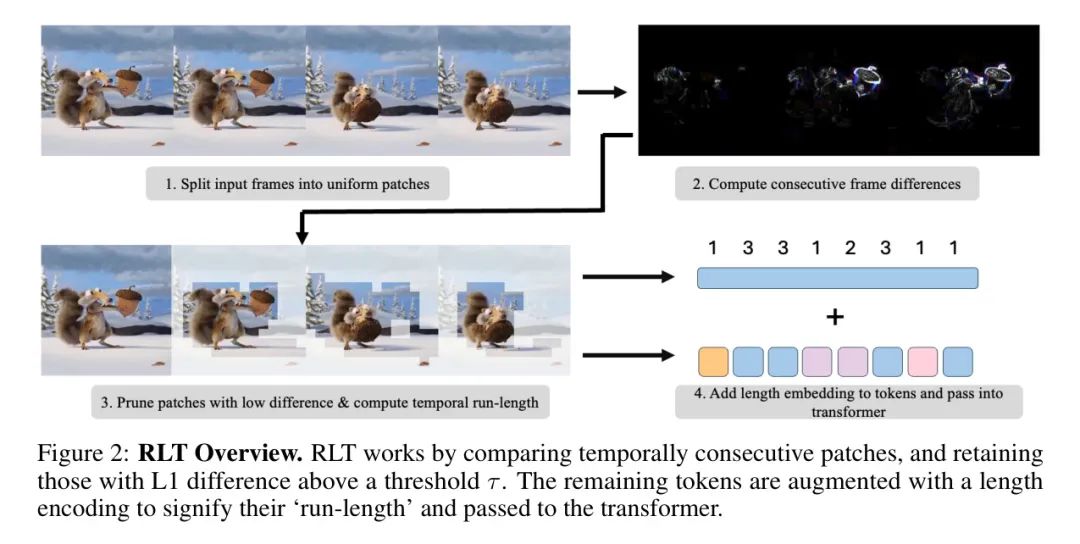
相比之下,作者的目标是识别出输入块中极相似的部分,然后压缩这些冗余的块,从而提高吞吐量并减少训练时间。作者的方法如图2所示。特别地,作者关注的是“时间连续”的块,它们具有相同的位置,仅相差一个时间步长。这些“静态块”对应的是在时间上不变或移动的视觉内容,这些 Token 可以很容易地被压缩。
Removing Static Patches
相似度对齐。与先前的作品不同,作者的目标是通过比较 Patch 而不是 Token 来减少总的输入 Token 数量。通过操作 Patch ,作者无需运行 Patch 嵌入 或模型的任何层。因此,作者无需冻结模型的某些部分或通过剪枝操作传播梯度,这需要填充并抵消潜在的加速。这与先前的作品不同,它们在 Transformer 中的每一层之后逐步剪枝或组合 Token 。此外,通过识别冗余 Patch ,作者可以预先计算各种数据集和示例大小的 Token 分布,从而可以使用像示例打包 [23] 等技术。最后,操作视觉 Patch 更具解释性,类似于视频编码器 [41, 46] 使用的启发式。
作者接下来定义一个确定连续两帧是否为静止的标准。考虑两个时间上连续的帧 和 ,它们对应空间位置 和时间位置 ,其中 。对于轮径大于1的轮式大小,每个帧包括多个帧裁剪,因此 。给定一个阈值 ,如果 和 的差值小于等于 ,则认为它们是静止的。
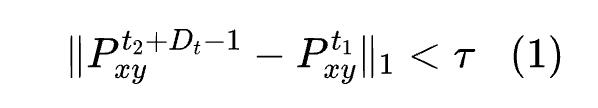
在中,和分别表示时间最后一个空间裁剪。该操作将的“开始”与的“结束”进行比较,理念是如果的第一个 Token 与的最后一个 Token 匹配,那么中间的 Token Patch 很可能也匹配。值得注意的是,是一个超参数,需要调整,但与数据集无关;它仅仅编码了在 Patch 之间允许发生多少变化,然后才认为它们是不同的。
控制速度与精确度的权衡;较高的值会显著减少更多的 Token ,但会将明显不同的 Token 视为相同的,从而降低精确度。作者使用,因为可能出现不可见的人工制品,并遵循标准程序,在比较 Patch 之前对ImageNet进行归一化。作者通常使用,并在第4.3节和附录B中提供其影响的实验和可视化。
剪枝过程如下:为了识别所有静态 Token ,作者对中的所有时间相邻的块进行先前比较,获得它们的差异,并只保留差异小于的块。由于不存在可以与第一帧进行比较的前一块,因此作者始终包括第一帧的完整内容。这导致了一个二进制 Mask ,作者可以然后用它来应用。
使用了 包含 个 Token , 包括 个 Token 。请注意, 始终成立;在 RLT 中,作者永远无法拥有比标准 Token 分割过程更多的 Token ,因此最坏情况下的性能与标准视觉 Transformer 相同。RLT 还几乎不产生开销,因为整个过程都可以通过在 GPU 上执行可并行的 PyTorch [32] 操作来实现,因此训练和推理速度严格更快。
深度学习的简单性是一个主要优势:与其他方法相比,作者可以利用 Transformer 处理可变输入大小的能力,无需提供任何额外的填充。由于作者没有改变模型本身,使用RDL的 Transformer 视频可以利用硬件优化,如Flash Attention [8, 9]和内存高效的核 [25]。
值得注意的是,剪枝过程是“内容感知”的:一些静态内容较多的视频会导致输入 Token 数量显著减少,而与摄像机或主体运动有关的视频则输入 Token 数量较多。
Run-length Positional Encoding
尽管作者减少了输入块的数量,但作者知道每个块都代表了一个静态块的“运行”,其长度为1对应没有静态内容,长度为对应输入时间维度的长度。如果没有关于静态块“运行”长度信息, Transformer 可能无法在剪枝过程中补偿删除的信息。
为解决这个问题,Bolya等人[5]提出了比例注意力(Proportional Attention),每个 Token 都被每个组中的 Token 数量加权。然而,作者选择让模型自己学习这些信息:作者假设每个 Token 的长度是可变的,作者可以通过一个新的位置编码来传递。具体而言,作者使用Dehghani等人[10]描述的因子化编码,其中一种编码包含位置信息,另一种对应于长度。
作者使用一个可学习的长度偏置,它由一个大小为的单参数组成。对于给定的“运行”重复的块,作者始终保留初始块,因此可以计算新的长度,即从到中最近的一个1条目在轴上的距离。具体而言,对于
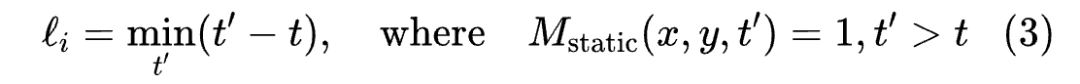
此操作还可以有效地在GPU上实现,无需增加开销。然后,完整的位置编码变为
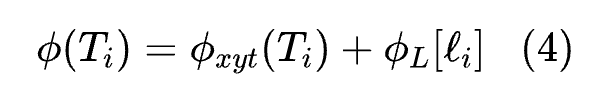
在中,表示索引运算符。在运行patch embedding网络之后,作者将位置编码添加到每个 Token 之后。与剪枝过程不同,由于作者使用可学习的长度编码,作者可以将梯度传播到位置编码,使模型在微调过程中学习如何最优地编码变长 Token 。
Handling Dynamic Input Sizes
由于RLT具有内容感知能力,每个示例中的 Token 数量存在显著差异。尽管 Transformer 可以原生处理任意输入大小[44],但先前的方法如DynamicViT[34]或A-ViT[52]在每一层产生的 Token 数量不同;这需要填充或注意力 Mask 来处理批量推理训练过程中的层间计算。在作者这里,输入 Token 数量是可变的,但整个网络中的 Token 数量保持不变,更接近NaViT[10]的设置。此外,由于在运行网络之前已知输入大小,作者可以采用_示例打包_[23]的思想,这是来自语言模型的一种方法,其中具有不同大小的多个输入被打包在一起,单个示例的 Token 只关注彼此。
在训练时间, Transformer 的输入由一组分词视频组成,分别为,每个视频的大小为。而不是将输入传递给网络,作者将视频张量连接在一起,得到,这样输入大小变为。
然后作者构建一个块对角注意力 Mask ,使得每个 Token 只关注来自同一视频的其他 Token ,作者在注意力操作期间添加它。由于中的每个 Token 只关注来自同一示例的 Token ,这不会减少吞吐量,并且也兼容于现有的硬件高效的注意力实现。为了在动作识别中计算类别预测,作者将每个示例拆分开来,并计算其预测作为每个示例 Token 的平均值,如[43]所示。然后将其投影到维度,得到大小为的输出,作者可以在训练期间将其应用标准交叉熵损失。
作者注意到,通常的例子打包结果是一个恒定的输入 Token 数量,而输入示例数量则有变化。RLT与Dehghani等人[10]之间的一个关键区别在于,数据增强技术如RandAugment[7]可以改变输入视频的视觉内容和 Token 数量,这使得在加载数据时,贪心的例子打包策略变得不适用。作者选择在单个GPU上使用恒定的示例数量,足够大的批处理量可以显著降低输入尺寸的方差。
4 Experimental Results
为了分析RLT在性能和速度方面的影响,作者在标准动作识别任务上进行了多次实验。作者在第4.1节中测量了在多个尺度上的模型训练速度提升,并在第4.2节中衡量RLT在推理时的滴入效果。作者在第4.3节中进行消融实验,然后在第4.4节中评估RLT在更高FPS视频和长视频数据集上的效果。最后,作者在第4.5节中提供定性视觉化。
Training
在表1中,作者评估了RLT在训练视频 Transformer 性能方面的影响以及其带来的加速效果。作者从预训练的VideoMAE[43; 45]预训练权重中微调ViT-B和ViT-L,并将其速度和性能与标准分词、随机 Mask 和RLT进行比较。作者通过移除k个 Token 符来评估随机 Mask ,其中k是RLT在给定数据集上剪枝的平均 Token 符数量。
为了进行最公平的速度比较,所有评估模型都使用混合精度、内存高效的注意力和可能使用的8xH100节点,以及来自AVION[54]的优化数据加载器,以避免数据加载 Bottleneck 。作者使用标准的视觉 Transformer 而不是更复杂的架构,如TimesFormer[3]或MViT[26]; 作者发现它显著更简单、更高效,与Ryali等人[38]的观察一致。由于计算限制,作者将分析限制在微调阶段。作者将与 Baseline 视觉 Transformer 、Token Merging和STA[36]进行比较。作者还包括一个随机 Mask Baseline ,其中 Mask 比例设置为RLT平均移除的 Token 符数量,这比使用固定标准比例(如0.5)的 Baseline 更强的 Baseline 。
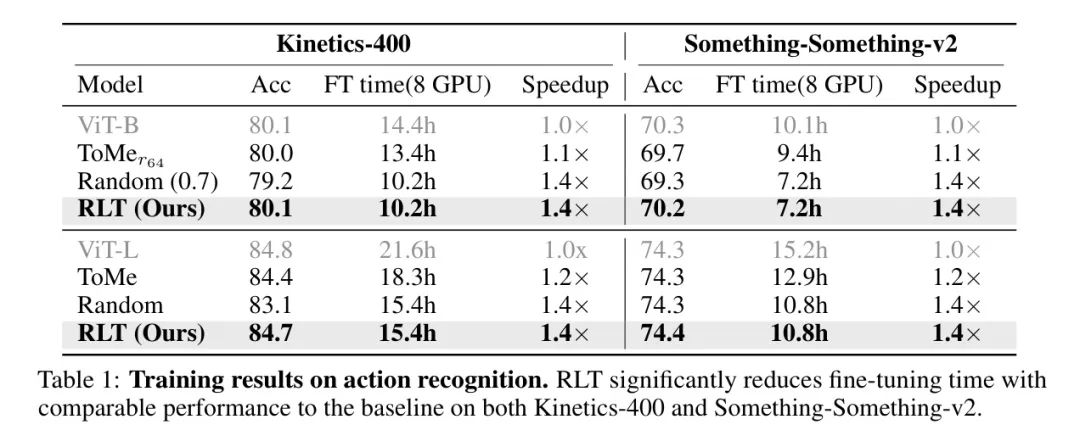
与标准分词相比,RLT实现了最高40%的加速,即使经过高度优化的实现也是如此。RLT在性能和速度之间实现了最佳平衡,其性能优于随机 Mask ,同时实现了相同的加速。这表明选择哪些 Token 符要删除,这是一个非同小可的差异,正确识别冗余 Token 符非常重要。
与标准分词相比,RLT 实现了最高 40% 的加速,即使经过 heavily 优化的实现也是如此。RLT 在性能和速度之间实现了最佳权衡,在随机 Mask 的性能之上,同时实现了相同的加速。特别地,由于 RLT 兼容硬件优化的实现,如 Flash-Attention [8, 9],因此训练速度比 Token Merging 更快。与随机 Mask 不同,RLT 在相同数量的训练批次后,性能与基准 ViT 相当,而随机 Mask 则需要显著更多的周期才能达到这一水平。RLT 在多个尺度上实现了基准性能,表明 RLT 在显著加速训练的同时,并未降低性能。
Inference-Time Results
尽管RLT旨在加快训练速度,但它可以作为标准分词的即插即用替换,类似于Token Merging[5]。在表2中,作者将RLT与标准分词和Token Merging[5]的Top-1准确率、GFLOPs和吞吐量进行了比较。作者还与仅用于训练时间的随机 Mask 进行了比较,尽管它实际上只用于训练时间[27]。
为了进行最公平的比较,作者对每个示例随机 Mask P个 Token ,其中P是RLT使用的 Token 的平均数量;对于Kinetics-400和SSv2,P=0.72。由于这些模型仅在单个剪辑上运行,因此作者没有将其与像A-ViT[52]这样的学习剪枝方法进行比较,因为这些方法仅在图像上呈现结果。作者在每秒片段数(clips-per-second)中测量吞吐量,每个模型在单个剪辑上运行。在实际中,视频模型在多个时间和平行裁剪上进行评估;遵循VideoMAE[43]的方法,作者在单个剪辑上测量GFLOPs,并在4个时间和3个空间裁剪上测量准确率。
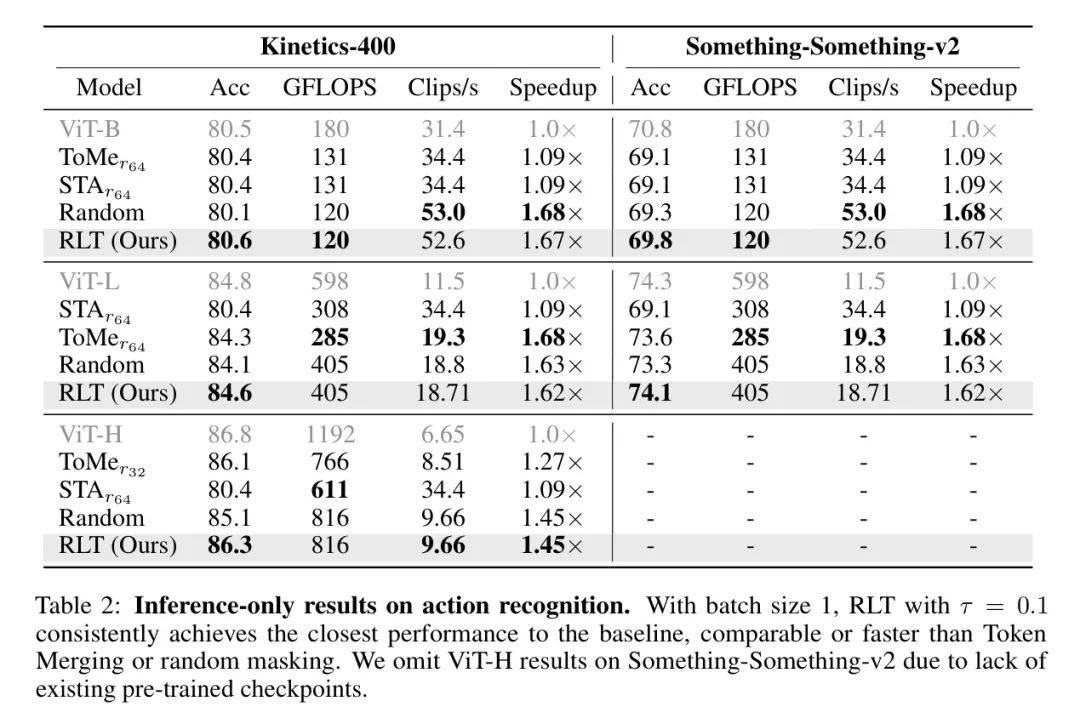
随着模型大小的增加,RLT在速度和准确率之间的权衡始终表现最好。在更大的参数数量下,注意力操作开始主导计算,这使得RLT的优势更加明显。与 Baseline 相比,RLT在速度上明显快于Token Merging,并且在准确率上超越了所有 Baseline 。由于依赖于加权注意力操作,Token Merging无法利用Flash Attention等优化,因此在相比之下速度较慢。
尽管在准确率上略低于RLT,随机 Mask 的表现相当惊人,这可能是因为视频中的大多数 Token 都是冗余的。随机 Mask 还可以与RLT结合使用,以进一步获得速度优势,其结果性能差距小于[27]中的情况。然而,要实现随机 Mask 的最优性能-吞吐量权衡需要针对每个数据集进行调整,而RLT天生具有内容感知能力,在相似的速度下无需调整即可实现更高的准确率。同样,Token Merging [5]需要根据模型大小调整参数,且不具备内容感知能力,限制了它在高度静态视频中速度的提升。
Ablations
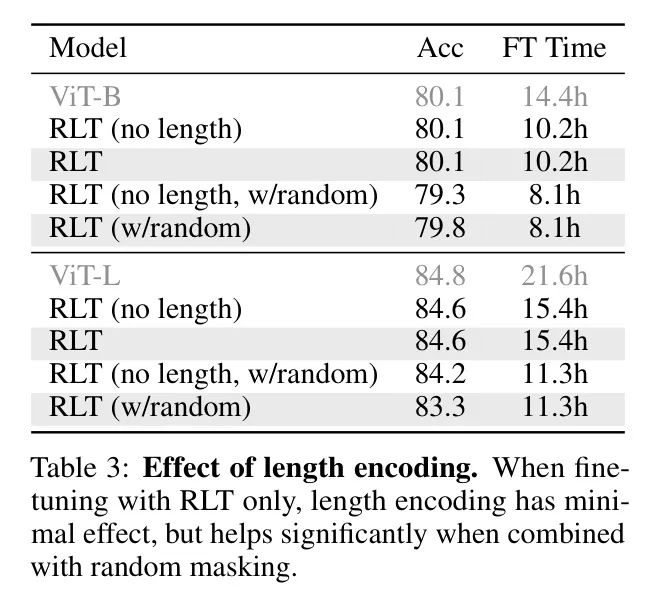
作者在图3和表3中分析了在训练过程中,在多个模型尺度上,差阈值和长度编码设计选择的影响。
阈值差异。在RLT中,唯一可调整的超参数是阈值,它控制了时间连续 Token 之间的变化敏感性。的较低值表示更高的变化敏感性。作者变化,并比较了在多个配置(训练和推理)下,最终动作识别准确率与吞吐量以及墙时对比,结果如图3所示。作者发现,使用在速度和性能方面提供了最佳折衷:它匹配了 Baseline 性能,同时在训练中实现了的速度提升。较低的值会导致类似性能,但速度提升较小,而较高的值会在牺牲性能的同时提供较大的速度提升。作者将这一现象归因于存在一个“差异截止值”:在某个时刻, Token 之间的差异过大,无法分组,因此产生的 Token 不再遵循RLT所做出的假设。作者还注意到,是_数据集无关的_:它仅描述了需要多少像素差异才能将两个16x16的 Patch 视为不同,相同值在不同数据集上根据视频内容产生不同的降维。
长度编码。作者在表3中消融了作者的长度编码机制的效果。当仅使用RLT时,长度编码几乎没有影响。然而,当将RLT与随机 Mask 相结合时,作者观察到明显的改进。由于RLT的结构和可预测的剪枝,长度编码可能是不必要的:通过关联的空间位置编码,Transformer能够很大程度上理解各种 Token 的长度。然而,一旦引入随机 Mask ,结构被移除,长度编码提供了关键信息。由于包括长度编码提供了更多信息且没有负面影响,作者默认包括它。
Longer Videos and Higher FPS
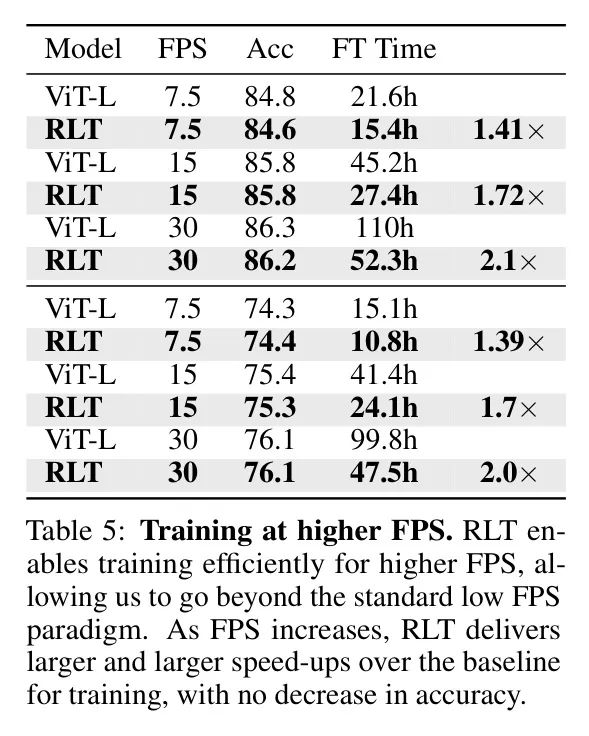
标准行为识别数据集包括具有降采样FPS的短片段;一个输入示例通常涵盖2秒钟。RLT的一个潜在优势在于,通过减少总的 Token 数,训练对于更长视频和高FPS变得更加可行。作者在表5中评估了在具有更高FPS的行为识别数据集上使用RLT的训练效果,以及它们的训练时间。与表1一样,作者从VideoMAE的预训练预训练权重中微调这些模型。尽管这些预训练权重是在7.5 FPS上预训练的,但作者仍然可以与 Baseline 性能进行比较,以观察训练时间或质量的差异。与表1的结果类似,作者发现使用RLT训练的ViTs可以匹配性能,但训练速度显著更快,速度提升与FPS成正比。
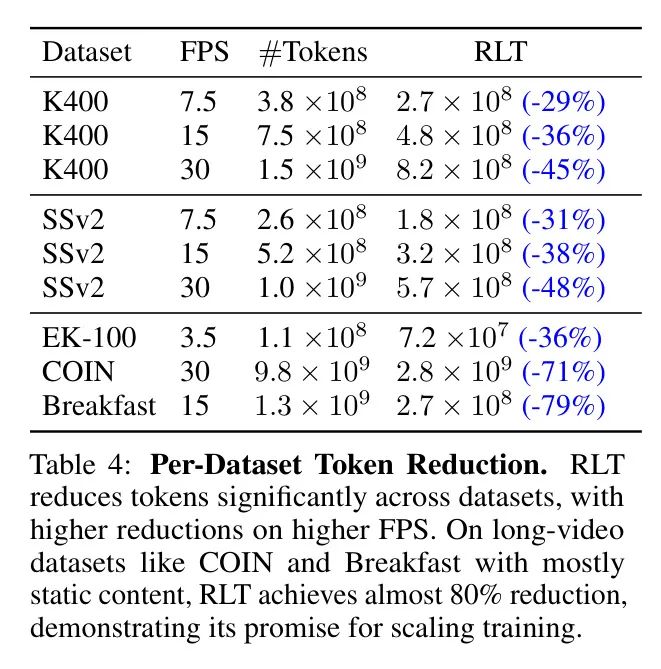
接下来,作者在表4中的几个视频数据集(包括具有更长视频和更高FPS的数据集)上分析RLT与 Baseline 的总词元数量。与表5的结果相匹配,在更高FPS下,RLT始终将词元数量减少得更多。这与作者的直觉相符,因为在较低FPS下,两个冗余词元之间的词元很可能相似且也会被删除。此外,在更长的视频数据集上,RLT可以通过显著更大的差距减少词元数量,在COIN和Breakfast数据集上甚至可以达到80%的减少。这些数据集尤其由固定摄像机拍摄且背景大部分静止,这证明了RLT在这些类型的视频中可以极大地加速 Transformer 。尽管在实际中,由于学术集群中视频解码成本高昂,研究行人通常不会在原始视频(具有大量帧数)上进行训练,但RLT提供了一种有效的方法,可以在此类视频上按比例进行大规模训练。
Visualizations
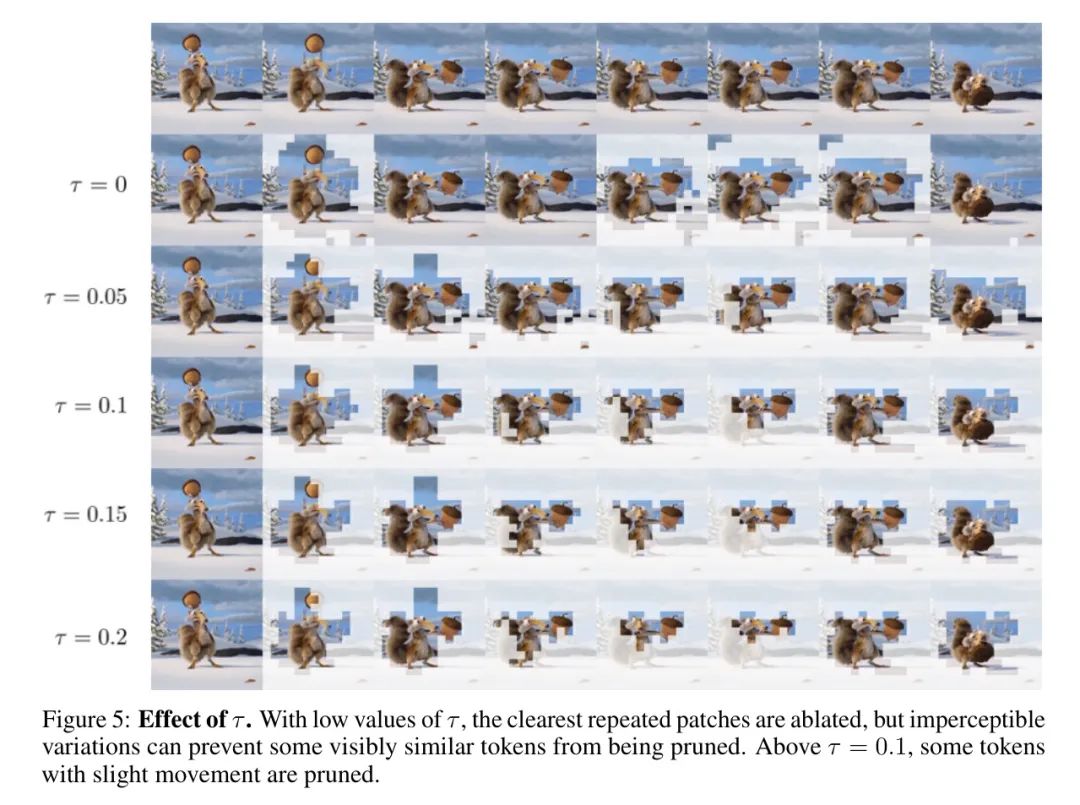
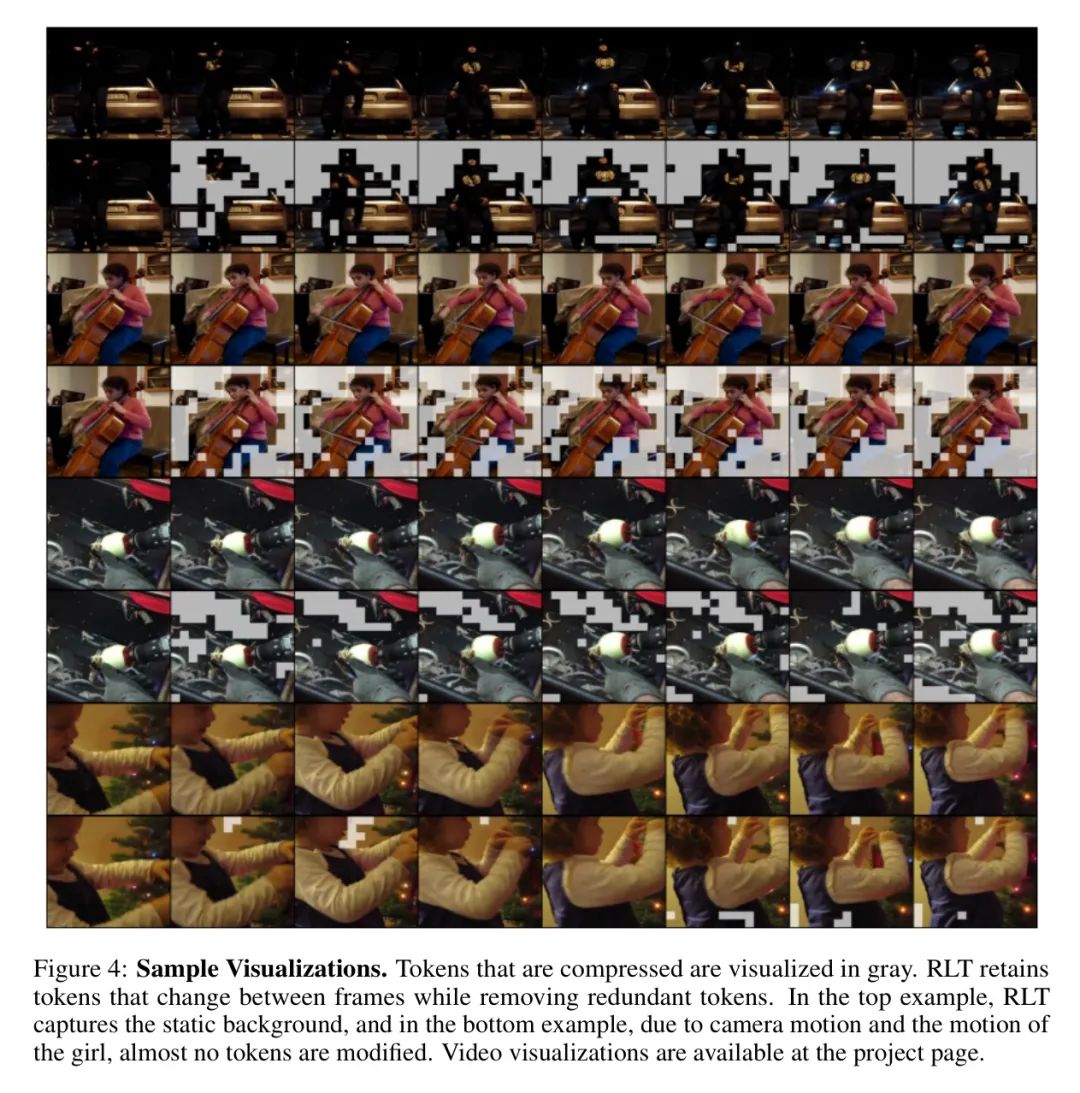
作者在图4中提供了一些定性视觉化的例子,展示了RLT移除的 Token 。如所希望,随着时间的推移,重复的输入块被RLT修剪。这直观地反映了人类往往随着时间的推移对静态 Token 给予的关注较少。在第一个示例中,大部分背景为黑色,前景有些动作。RLT能够移除始终为黑色的部分,极大地减少了 Token 数量。在第二个示例中,RLT确保包含动作的 Token (如男孩的手和工具)不被修改,但修剪静态背景。在图5的底部两个示例中,使用钻头的人和前景中的女孩移动显著,减少了可以压缩的 Token 数量。在这些情况下,当有显著的主题或摄像机运动时,RLT移除的 Token 较少,导致与标准 Token 数量相似。然而,RLT对微小扰动和运动的敏感性完全取决于超参数τ。作者在附录B中提供更多示例视觉化,并在作者的项目页面上可视化不同值τ的影响。在图5中,作者展示了τ超参数对输入 Token 的影响。作者可以看到,随着τ的增加,越来越多的块被包括在内,而当τ=0.1时,其中一些有变化的块被错误修剪。另一方面,当τ=0时,包括了许多几乎不可察觉变化的块,这也是不希望的。
5 Conclusion
作者提出了Run-Length Tokenization (RLT),这是标准视频分词的一种简单替代方案,用于视频 Transformer ,它用可变长度的单一 Token 替换时间冗余 Token 。RLT将 Transformer 训练和推理的时钟时间减少了40%,实现了比先前的作品更好的速度-准确性权衡,并且易于实现和与其他方法结合。RLT在微调阶段取得了强大的结果,尤其是在更高的FPS下,甚至在没有进行训练的模型上也能很好地工作。
尽管RLT(Relative Location Transformer)在效果上表现良好,但它依赖于一个启发式方法来比较时间连续的 Token ,这可能包括 Transformer 未使用的额外 Token 。
尽管RLT显著加速了视频 Transformer ,但无法用于需要与输入 Token 相同数量的输出 Token 的密集视觉任务,如点跟踪或视频生成;RLT在运行模型之前减少 Token ,并未替换它们。此外,RLT处理摄像机运动能力有限:在具有恒定摄像机运动的视频中, Token 将被删除,导致无速度提升。未来需要进行更多的工作来克服这些限制,并希望RLT能激发对高效视频 Transformer 的研究。
参考文献
[0]. Don't Look Twice: Faster Video Transformers with Run-Length Tokenization.
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2024-12-08,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号