方法梳理---SMI空间平台数据分析
原创
方法梳理---SMI空间平台数据分析
原创
追风少年i
修改于 2025-03-25 10:34:16
修改于 2025-03-25 10:34:16
作者,Evil Genius
今天偷个懒,分享一下关于SMI的数据分析流程。
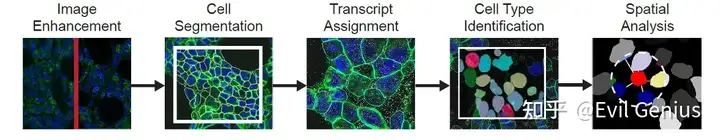
前面样本的实验处理我们就不谈了(主要我也不懂)。
第一步,组织染色
在成像的5个通道中,只有2个用于细胞分割:DAPI用于核分割,CD298/B2M用于膜分割。为了创建更清晰的图像以供图像注释,一般使用Huygens Professional版本(荷兰科学体积成像)对DAPI和CD298/B2M通道进行反图像卷积。此时检测细胞边界更容易检测,但核变暗,将反卷积的DAPI通道与原始DAPI通道叠加。接下来,对反卷积的CD298/B2M通道和混合原始/反卷积的核通道进行clipped,使其灰度值范围介于原始灰度值的5%和99.99%之间,然后将每个蛋白质通道映射到其RGB颜色通道(DAPI为蓝色,CD298/B2为绿色)。
第二步,图像分割(目前常用的stardist或者cellpose)
使用Cellpose的自行训练模型功能来训练2个模型:一个用于细胞核分割,一个用于细胞膜分割(使用B2M/CD298膜标记)。首先生成真实核的标记。一旦有足够数量的核被注释以训练模型,就切换到半自动注释方法。使用训练的nucleus模型来预测nucleus masks并手动校正。使用相同的方法来生成膜预测模型,获取真实的细胞细胞分割状态。
第三步,训练模型的运用
为了得到一个代表每个细胞(包括细胞核和细胞膜)的mask,将所有视野中与同一细胞对应的细胞核和细胞膜合并。在评估训练模型的输出与真实值之间的比较时,使用以下公式计算F1分数:
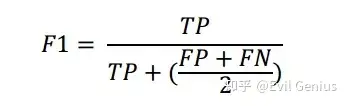
其中TP为真阳性数,FP为假阳性数,FN为假阴性数。假阴性数量。为了计算这个指标,使用了0.7的IOU值,这意味着为了将单个细胞标记视为真正的阳性,它必须与ground truth重叠。重叠度达到或超过70%。任何重叠度低于70%的标签都会被算作假阳性。
第四步,细胞注释
去除低质量的细胞(<20个转录本分配给细胞)。
借助10x单细胞实验中识别的细胞类型包括在受监督的细胞分型pipeline中,并根据先前的知识和差异表达列表选择标记基因以创建参考图谱。由于来自不同样本的数据是异质性的,因此在每个样本内执行了以下细胞类型注释步骤以确保样本变异性不会影响注释结果。提取了所有细胞类型标记基因的表达矩阵,并计算了每个细胞的每种细胞类型的平均表达。第一轮分析确定了广泛的细胞类型然后进行第二轮创建参考和计算后验概率,以确定细胞亚型。使用热图比较最终细胞类型的标记基因的平均表达,以确认每个群体的基因表达谱的准确性。
第五步,空间距离度量
首先是距离的确定,空间数据包含每个FOV内所有转录本的局部坐标。然而,每个细胞被表示为一个多边形,通过计算每个视野内每对细胞边缘之间的最小距离来找到细胞之间的距离。
第六步,空间niche分析
这部分讲过很多了,大家可以参考文章内容汇总----空间转录组的生态位(niche)分析
脚本更新---高精度平台的Recurrent cellular neighborhoods (RCNs) 分析
第七步,Ligand-Receptor Analysis
首先计算与其最近的细胞之间的距离(最好先确定目标细胞)。
两组细胞提取出来进行分析,最小距离小于或等于5微米(close group),另一组最小距离大于或等于30微米(far group)。
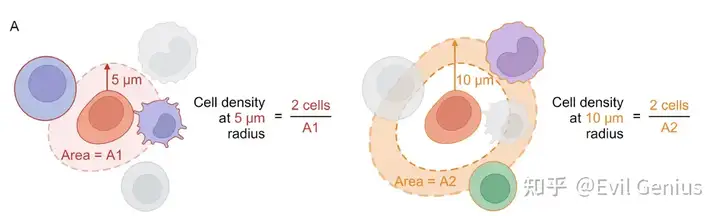
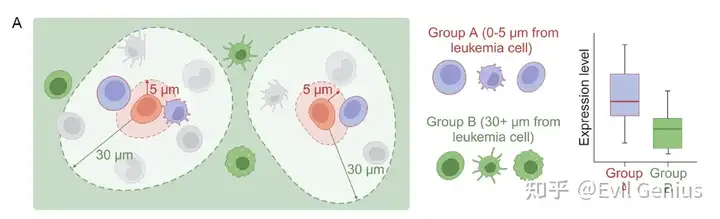
通过计算配对细胞的平均表达来确定通讯强度(配受体对可以采用Cellchat)。
这里面需要很多的分析内容,一时半会是做不完的
最后我们来分享一下分析配受体的代码
library(dplyr)
library(stringr)
setwd("/LigandReceptor_analysis")
lr = read.csv('Ligand_receptor_input.csv', row.names = 1)
lr = lr[lr$group != '', ]
lrpair = read.table('lr_pair.txt')
# lrpair = lrpair[, c("V2", 'V1')]
pall = c(51:53, 56:58)

meta = lr[, c('patients', 'FOV', 'Timepoint')]
meta = meta[!duplicated(meta), ]
rownames(meta) = paste0('P', pall[as.numeric(gsub('p', '', meta$patients))], '_FOV', ifelse(meta$FOV < 10, paste0('0', meta$FOV), meta$FOV))

outall_list = data.frame()

for (p in 1:6){
  load(paste0('/data/guig2/2203_ZhaoCollab/round3/P', pall[p], '_raw.RData'))
  print(paste0('P', pall[p]))
  mat = mat[, -grep('Neg', colnames(mat))]
  lrp = lr[lr$patients == paste0('p', p), ]
  rownames(lrp) = paste0('P', pall[p], "_FOV", ifelse(lrp$FOV < 10, paste0('0', lrp$FOV), lrp$FOV), '_cell_', lrp$cell_id)
  mat = cbind(mat[rownames(lrp), unique(c(lrpair[,1], lrpair[,2]))], lrp[, c('Timepoint', 'celltype_detail', 'group', 'FOV')])
  outall = data.frame()
  for (gene in 1:(ncol(mat)-4)){
    out = eval(parse(text = paste0('mat %>% group_by(Timepoint, celltype_detail, group, FOV) %>% summarise(mean = mean(', colnames(mat)[gene], '))'))) %>% as.data.frame
    out$gene = colnames(mat)[gene]
    outall = rbind(outall, out)
  }
  result = data.frame()
  for (gene in 1:(ncol(mat)-4)){
    out = outall[outall$gene == unique(outall$gene)[gene], ]
    for (Timepoint in LETTERS[1:3]){
      for (celltype in unique(outall$celltype_detail)){
        a1 = out[out$Timepoint == Timepoint & out$celltype_detail == celltype & out$group == '0-5 um', 'mean']
        a2 = out[out$Timepoint == Timepoint & out$celltype_detail == celltype & out$group == '30+ um', 'mean']
        if (length(a1) > 3 & length(a2) > 3){
          if (sum(a1 > 0) > 3 & sum(a2 > 0) > 3){
            a = wilcox.test(a1, a2)
            result = rbind(result, data.frame(gene = unique(outall$gene)[gene], Timepoint = Timepoint, celltype = celltype, p = a$p.value, group0 = median(a1), group1 = median(a2)))
          }
        }
      }
    }
  }
  resultshort = result[result$p < 0.01, ]
  mat = countall[, -grep('Neg', colnames(countall))]
  all_sub = data.frame(Timepoint = meta[str_split(rownames(mat), pattern = fixed('_cell'), simplify = T)[,1], 'Timepoint'], FOV = as.numeric(gsub('FOV', '', str_split(rownames(mat), pattern = fixed('_'), simplify = T)[,2])), celltype_detail = celltypeall)
  rownames(all_sub) = rownames(mat)
  all_sub = all_sub[all_sub$celltype_detail %in% setdiff(all_sub$celltype_detail, c('Unknown', 'SmallCell', 'RBC', 'NoCellAssigned')), ]
  mat = cbind(mat[rownames(all_sub), unique(c(lrpair[,1], lrpair[,2]))], all_sub)
  outall = data.frame()
  for (gene in 1:(ncol(mat)-3)){
    out = eval(parse(text = paste0('mat %>% group_by(Timepoint, celltype_detail, FOV) %>% summarise(mean = mean(', colnames(mat)[gene], '))'))) %>% as.data.frame
    out$gene = colnames(mat)[gene]
    outall = rbind(outall, out)
  }
  medgene = outall %>% group_by(Timepoint, gene, celltype_detail) %>% summarise(med = median(mean)) %>% as.data.frame
  a = medgene %>% group_by(gene, Timepoint) %>% summarise(sd = sd(med), mean = median(med)) %>% as.data.frame
  a$malignant = medgene[medgene$celltype_detail == 'LeukemiaCell', 'med']
  lrmalig = a[a$malignant > a$mean + 2*a$sd, ]
  lrpairnew = lrpair[lrpair[,1] %in% lrmalig$gene | lrpair[,2] %in% lrmalig$gene, ]
  outall = data.frame()
  for (li in 1:nrow(lrpairnew)){
    if (lrpair[li, 1] %in% lrmalig$gene){
      genetime = lrmalig[lrmalig$gene == lrpair[li, 1], ]
      for (ti in 1:length(unique(genetime$Timepoint))){
        idall = resultshort$Timepoint == unique(genetime$Timepoint)[ti] & resultshort$gene == lrpair[li, 2]
        if (sum(idall) > 0){
          out = resultshort[idall, ]
          out$ligand_gene_malignant = lrpair[li, 1]
          outall = rbind(outall, out)
        }
      }
    }
  }
  outall$patient = p
  outall_list = rbind(outall_list, outall)
}
write.csv(outall_list, file = 'LR_result1.csv')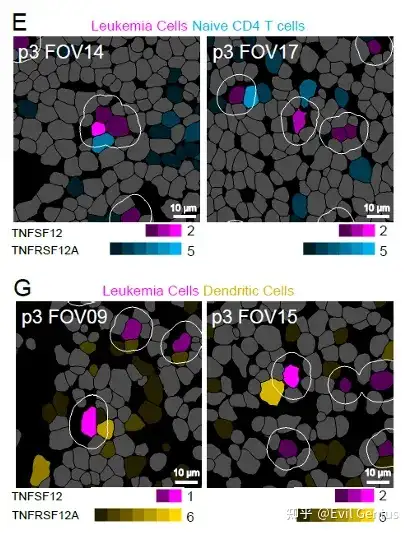
生活很好,有你更好。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号