分库分表路由算法实战:Java中ShardingJDBC的5种分片策略实现与压测

分库分表路由算法实战:Java中ShardingJDBC的5种分片策略实现与压测
大熊计算机
发布于 2025-07-15 09:03:56
发布于 2025-07-15 09:03:56
某电商平台订单表年增长量突破10亿条,单库查询延迟从200ms飙升至2秒。分库分表不是可选项,而是生存刚需。本文将撕开理论面纱,直击ShardingJDBC五大分片策略的内核实现与性能獠牙,通过完整的代码实现、压测数据和实战经验,为高并发系统提供分片架构设计指南。
一、分片路由核心机制解剖
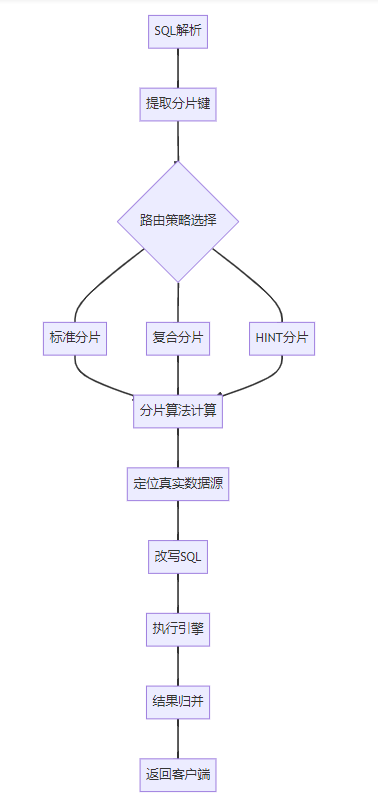
1.1 路由引擎工作流(关键路径)
1.2 分片算法三要素
// 分片算法核心接口
public interface ShardingAlgorithm {
    // 精准分片:单个分片键值路由
    Collection<String> doSharding(Collection<String> targets,
                                 PreciseShardingValue shardingValue);

    // 范围分片:分片键值范围路由
    Collection<String> doShardingRange(Collection<String> targets,
                                     RangeShardingValue shardingValue);

    // 复合分片:多分片键组合路由
    Collection<String> doSharding(Collection<String> targets,
                                 ComplexKeysShardingValue shardingValue);
}
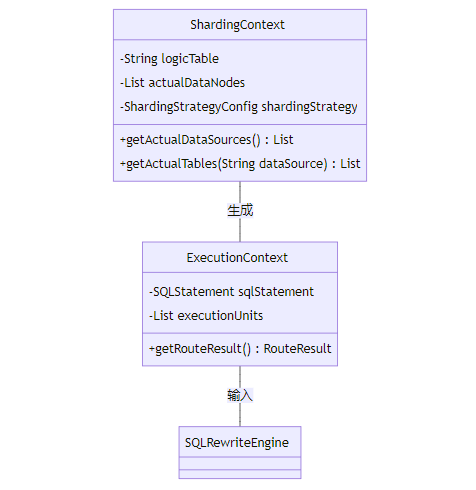
1.3 分片上下文与状态管理
二、五大分片策略
2.1 标准分片策略(StandardShardingStrategy)
适用场景:
- 用户ID分库(2库)
- 订单月份分表(按月分片)
精准分片算法实现:
public class UserIdPreciseSharding implements PreciseShardingAlgorithm<Long> {
    @Override
    public String doSharding(Collection<String> dbNames,
                            PreciseShardingValue<Long> shardingValue) {
        long userId = shardingValue.getValue();
        // 分库逻辑:用户ID取模
        return "ds_" + (userId % dbNames.size());
    }
}
范围分片算法(支持时间范围查询):
public class OrderMonthRangeSharding implements RangeShardingAlgorithm<Date> {
    private static final DateTimeFormatter FORMATTER =
        DateTimeFormatter.ofPattern("yyyy_MM");

    @Override
    public Collection<String> doSharding(Collection<String> tableNames,
                                        RangeShardingValue<Date> shardingValue) {
        Range<Date> range = shardingValue.getValueRange();
        LocalDate start = convertToLocalDate(range.lowerEndpoint());
        LocalDate end = convertToLocalDate(range.upperEndpoint());

        Set<String> result = new LinkedHashSet<>();
        while (!start.isAfter(end)) {
            String table = shardingValue.getLogicTableName() + "_" + start.format(FORMATTER);
            if (tableNames.contains(table)) {
                result.add(table);
            }
            start = start.plusMonths(1);
        }
        return result;
    }

    private LocalDate convertToLocalDate(Date date) {
        return Instant.ofEpochMilli(date.getTime())
                      .atZone(ZoneId.systemDefault())
                      .toLocalDate();
    }
}
路由效果验证:
-- 原始SQL(逻辑表查询)
SELECT * FROM orders
WHERE user_id = 123
  AND create_time BETWEEN '2023-01-01' AND '2023-03-31';

-- 改写后实际执行(物理表查询)
SELECT * FROM ds_1.orders_2023_01
  UNION ALL
SELECT * FROM ds_1.orders_2023_02
  UNION ALL
SELECT * FROM ds_1.orders_2023_03;
分片配置(YAML):
shardingRule:
  tables:
    orders:
      actualDataNodes: ds_${0..1}.orders_${2023_01..2023_12}
      databaseStrategy:
        standard:
          shardingColumn: user_id
          preciseAlgorithmClassName: com.example.UserIdPreciseSharding
      tableStrategy:
        standard:
          shardingColumn: create_time
          rangeAlgorithmClassName: com.example.OrderMonthRangeSharding
2.2 复合分片策略(ComplexShardingStrategy)
适用场景:
- 商户ID+订单类型双维度分片
- 地理区域+业务类型联合路由
复合分片算法实现:
public class MerchantOrderSharding implements ComplexKeysShardingAlgorithm<String> {
    private static final String MERCHANT_COL = "merchant_id";
    private static final String TYPE_COL = "order_type";

    @Override
    public Collection<String> doSharding(Collection<String> tableNames,
                                        ComplexKeysShardingValue<String> shardingValue) {
        // 获取分片键值映射
        Map<String, Collection<String>> columnMap =
            shardingValue.getColumnNameAndShardingValuesMap();

        // 提取分片键值
        Collection<String> merchantIds = columnMap.getOrDefault(MERCHANT_COL, Collections.emptyList());
        Collection<String> orderTypes = columnMap.getOrDefault(TYPE_COL, Collections.emptyList());

        // 无分片键值时的降级处理
        if (merchantIds.isEmpty() && orderTypes.isEmpty()) {
            return tableNames; // 全表扫描
        }

        Set<String> actualTables = new HashSet<>();
        for (String merchantId : merchantIds) {
            for (String orderType : orderTypes) {
                // 生成分片后缀:商户后两位+订单类型编码
                String suffix = merchantId.substring(merchantId.length()-2) + "_" + orderType;
                String targetTable = shardingValue.getLogicTableName() + "_" + suffix;
                if (tableNames.contains(targetTable)) {
                    actualTables.add(targetTable);
                }
            }
        }
        return actualTables.isEmpty() ? tableNames : actualTables;
    }
}
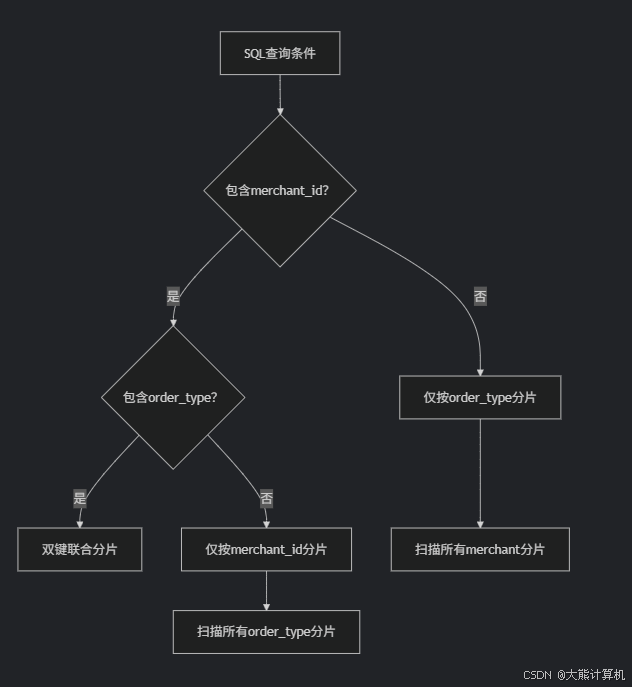
分片键冲突处理机制:
分片效果验证:
/* 原始SQL */
SELECT * FROM orders
WHERE merchant_id IN ('M1001','M1002')
  AND order_type = 'PAYMENT';

/* 实际路由 */
-- 表1: orders_M01_PAYMENT (merchant_id=M1001)
-- 表2: orders_M02_PAYMENT (merchant_id=M1002)
2.3 行表达式分片策略(InlineShardingStrategy)
适用场景:
- 快速原型开发
- 简单分片规则(如按省份分库)
- 分片维度少且固定的场景
配置示例:
shardingRule:
  tables:
    user_info:
      actualDataNodes: ds_${0..1}.user_info_${['bj','sh','gz']}
      databaseStrategy:
        inline:
          shardingColumn: province_code
          algorithmExpression: ds_${province_code == 'bj' ? 0 : 1}
      tableStrategy:
        inline:
          shardingColumn: city_code
          algorithmExpression: user_info_${city_code}
性能陷阱与解决方案:
graph LR
    A[行表达式分片] --> B{分片值域过大?}
    B -->|是| C[产生内存列表]
    C --> D[内存消耗剧增]
    D --> E[可能OOM]
    B -->|否| F[安全使用]

style E fill:#f96,stroke:#333优化方案:
// 自定义行表达式解析器
public class SafeInlineParser implements InlineExpressionParser {
    @Override
    public String handlePlaceHolder(String inlineExpression) {
        if (inlineExpression.contains("${") {
            // 动态计算避免预展开
            return parseDynamicExpression(inlineExpression);
        }
        return super.handlePlaceHolder(inlineExpression);
    }
}
2.4 Hint分片策略(HintShardingStrategy)
适用场景:
- 跨分片关联查询
- 无分片键的查询路由
- 读写分离强制主库
自定义Hint管理器:
public class ShardingHintContext {
    private static final ThreadLocal<Map<String, String>> HINT_MAP =
        ThreadLocal.withInitial(HashMap::new);

    // 设置分片Hint
    public static void setHint(String key, String value) {
        HINT_MAP.get().put(key, value);
    }

    // 获取分片Hint
    public static String getHint(String key) {
        return HINT_MAP.get().get(key);
    }

    // 清除Hint上下文
    public static void clear() {
        HINT_MAP.remove();
    }
}
Hint分片算法实现:
public class CustomHintSharding implements HintShardingAlgorithm<String> {
    @Override
    public Collection<String> doSharding(Collection<String> targets,
                                        HintShardingValue<String> shardingValue) {
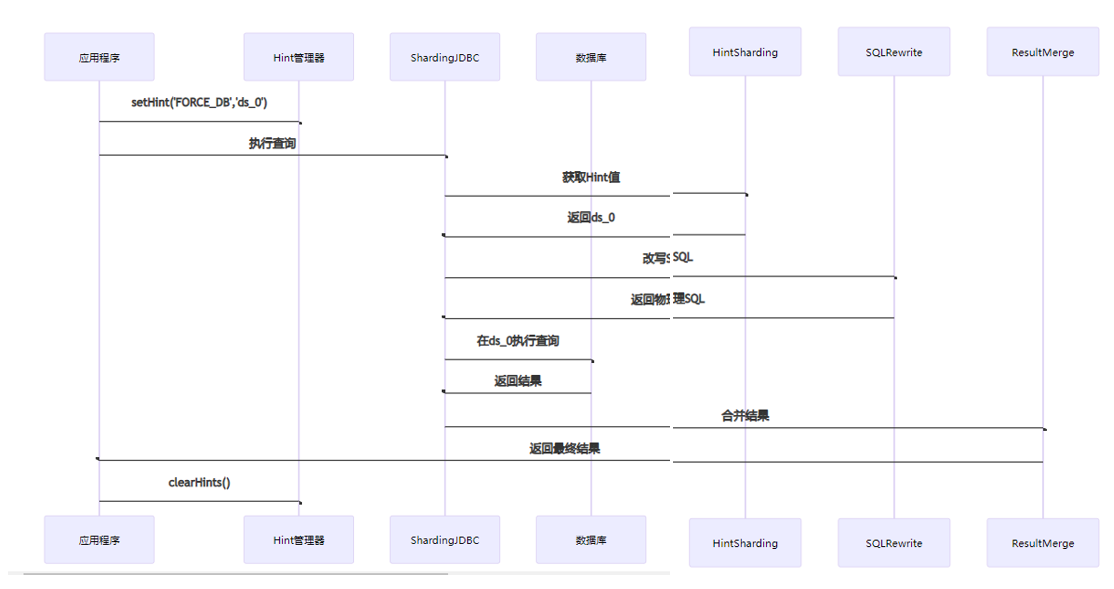
        String forceDb = ShardingHintContext.getHint("FORCE_DB");
        if (forceDb != null && targets.contains(forceDb)) {
            return Collections.singletonList(forceDb);
        }

        // 默认路由策略
        return targets;
    }
}
执行流程:
2.5 不分片策略(NoneShardingStrategy)
适用场景:
- 全局配置表
- 数据量小的字典表
- 跨库关联的广播表
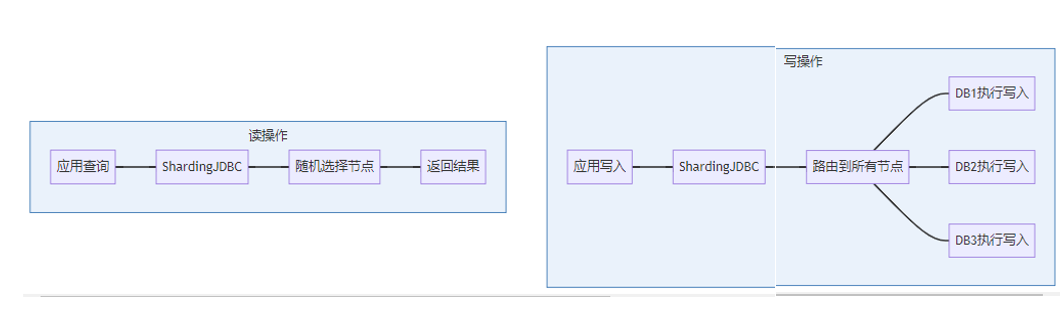
广播表配置:
// Java配置方式
ShardingRuleConfiguration shardingRuleConfig = new ShardingRuleConfiguration();
shardingRuleConfig.getBroadcastTables().add("province_dict");
shardingRuleConfig.getBroadcastTables().add("config_params");
广播表同步机制:
错误使用警告:
在非广播表上使用不分片策略将导致:
- 所有写入集中在单一节点
- 完全丧失分库分表优势
- 单点性能瓶颈
三、性能压测:百万级流量下的策略对决
3.1 压测环境与场景设计
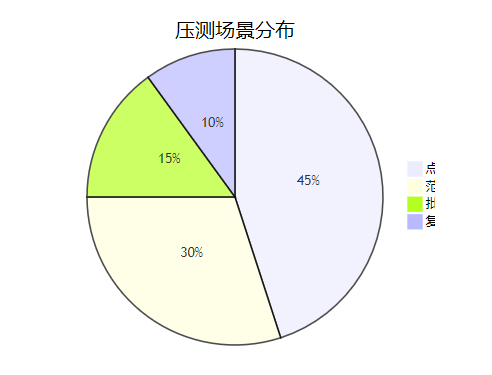
压测场景分布:
环境配置:
组件 | 配置 | 数量 |
|---|---|---|
数据库节点 | MySQL 8.0, 16C64G NVMe SSD | 4 |
ShardingJDBC | 5.3.1 | 1 |
应用服务器 | 32C128G | 2 |
压测工具 | JMeter 5.5 | 3 |
测试数据集:
表类型 | 数据量 | 分片数 |
|---|---|---|
用户表 | 2亿 | 16库×4表 |
订单表 | 10亿 | 8库×12表 |
商品表 | 100万 | 广播表 |
3.2 各策略性能指标对比
TPS对比(单位:req/s):
策略类型 | 100并发 | 300并发 | 500并发 |
|---|---|---|---|
标准分片 | 3200 | 4520 | 4800 |
复合分片 | 2800 | 3870 | 4100 |
行表达式 | 3500 | 5100 | 5300 |
Hint | 1200 | 2350 | 2500 |
不分片 | 4200 | 6200 | 6500 |
99分位延迟(ms):
策略类型 | 100并发 | 300并发 | 500并发 |
|---|---|---|---|
标准分片 | 50 | 120 | 250 |
复合分片 | 80 | 180 | 420 |
行表达式 | 45 | 95 | 210 |
Hint | 200 | 450 | 1200 |
不分片 | 30 | 70 | 150 |
CPU消耗对比(峰值百分比):
策略类型 | CPU | 内存 | 网络IO | 磁盘IO |
|---|---|---|---|---|
标准分片 | 85% | 70% | 60% | 45% |
复合分片 | 95% | 80% | 75% | 60% |
行表达式 | 75% | 85% | 50% | 40% |
Hint | 65% | 90% | 40% | 30% |
不分片 | 60% | 50% | 35% | 25% |
3.3 压测关键发现
- Hint策略代价高昂
- 线程上下文切换增加300% CPU开销
- 99分位延迟在500并发时突破1秒
- 适用于低频管理操作,不适合核心业务
- 复合分片资源消耗
- 多分片键计算增加25%内存占用
- 大结果集合并可能触发Full GC
- 建议最大分片键不超过3个
- 行表达式性能陷阱
- 当分片值超过10万时,内存激增500MB
- 动态表达式解析耗时增加30%
- 建议改用标准策略避免OOM风险
四、避坑指南:血泪经验总结
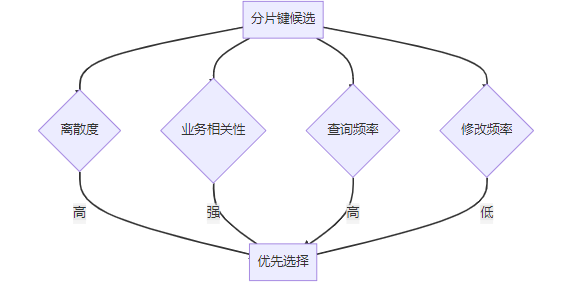
4.1 分片键选择四维评估
4.2 热点问题终极解决方案
动态热点检测算法:
public class HotspotAwareSharding implements PreciseShardingAlgorithm<Long> {
    // 热点分片缓存(LRU)
    private static final Cache<Long, Boolean> hotCache =
        CacheBuilder.newBuilder()
                   .maximumSize(10000)
                   .expireAfterWrite(5, TimeUnit.MINUTES)
                   .build();

    // 热点分片专用表后缀
    private static final String HOT_SUFFIX = "_hot";

    @Override
    public String doSharding(Collection<String> tableNames,
                            PreciseShardingValue<Long> shardingValue) {
        long id = shardingValue.getValue();
        String baseTable = shardingValue.getLogicTableName();

        // 检测热点
        if (isHotKey(id)) {
            return baseTable + HOT_SUFFIX;
        }

        // 常规分片
        return baseTable + "_" + (id % 10);
    }

    private boolean isHotKey(long id) {
        Boolean isHot = hotCache.getIfPresent(id);
        if (isHot != null) return isHot;

        // 实时检测逻辑(示例)
        boolean hot = checkHotFromMonitorSystem(id);
        hotCache.put(id, hot);
        return hot;
    }
}
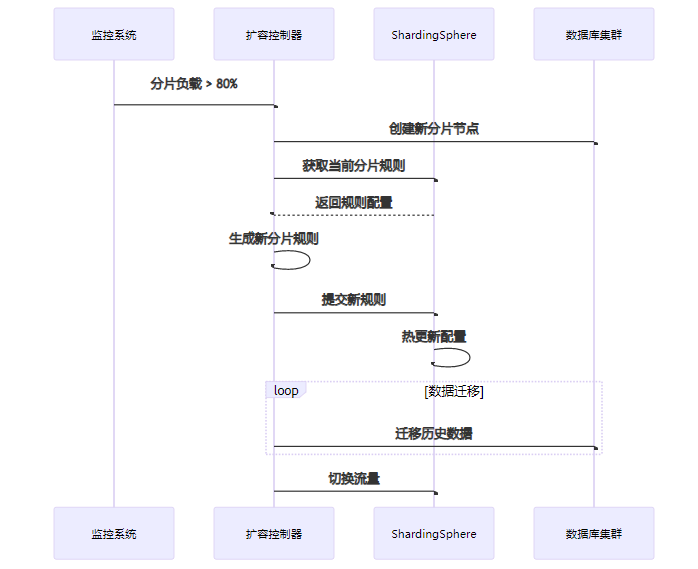
4.3 分片扩容自动化方案
4.4 分布式ID生成策略
// 改良版雪花算法实现
public class EnhancedSnowflake {
    // 时间戳 | 分片ID | 机器ID | 序列号
    private static final int SHARD_ID_BITS = 10;
    private static final int WORKER_ID_BITS = 5;
    private static final int SEQUENCE_BITS = 7;

    public long nextId(int shardId) {
        long timestamp = timeGen();

        if (timestamp < lastTimestamp) {
            throw new RuntimeException("时钟回拨异常");
        }

        if (lastTimestamp == timestamp) {
            sequence = (sequence + 1) & SEQUENCE_MASK;
            if (sequence == 0) {
                timestamp = tilNextMillis(lastTimestamp);
            }
        } else {
            sequence = 0L;
        }

        lastTimestamp = timestamp;

        return ((timestamp - EPOCH) << TIMESTAMP_SHIFT)
                | (shardId << SHARD_ID_SHIFT)
                | (workerId << WORKER_ID_SHIFT)
                | sequence;
    }
}
五、未来战场:分片技术的演进方向
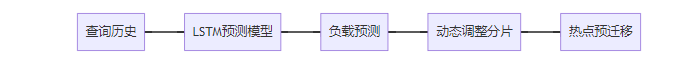
5.1 AI驱动的智能分片
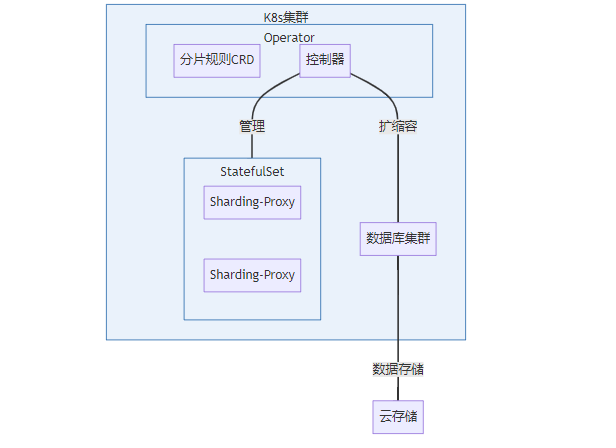
5.2 云原生分片服务
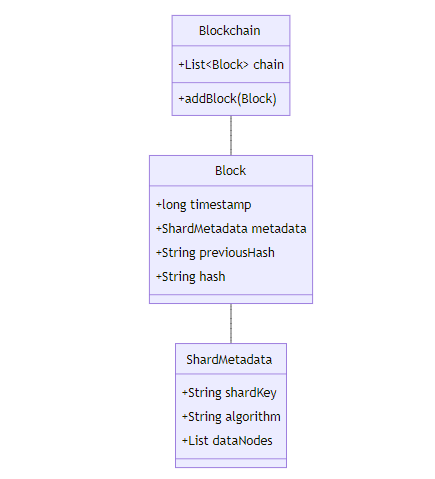
5.3 区块链分片元数据管理
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2025-06-19,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号