Claude Opus 4.6发布:ARC-AGI得分68%

Claude Opus 4.6发布:ARC-AGI得分68%
用户11563501
发布于 2026-06-23 11:48:05
发布于 2026-06-23 11:48:05
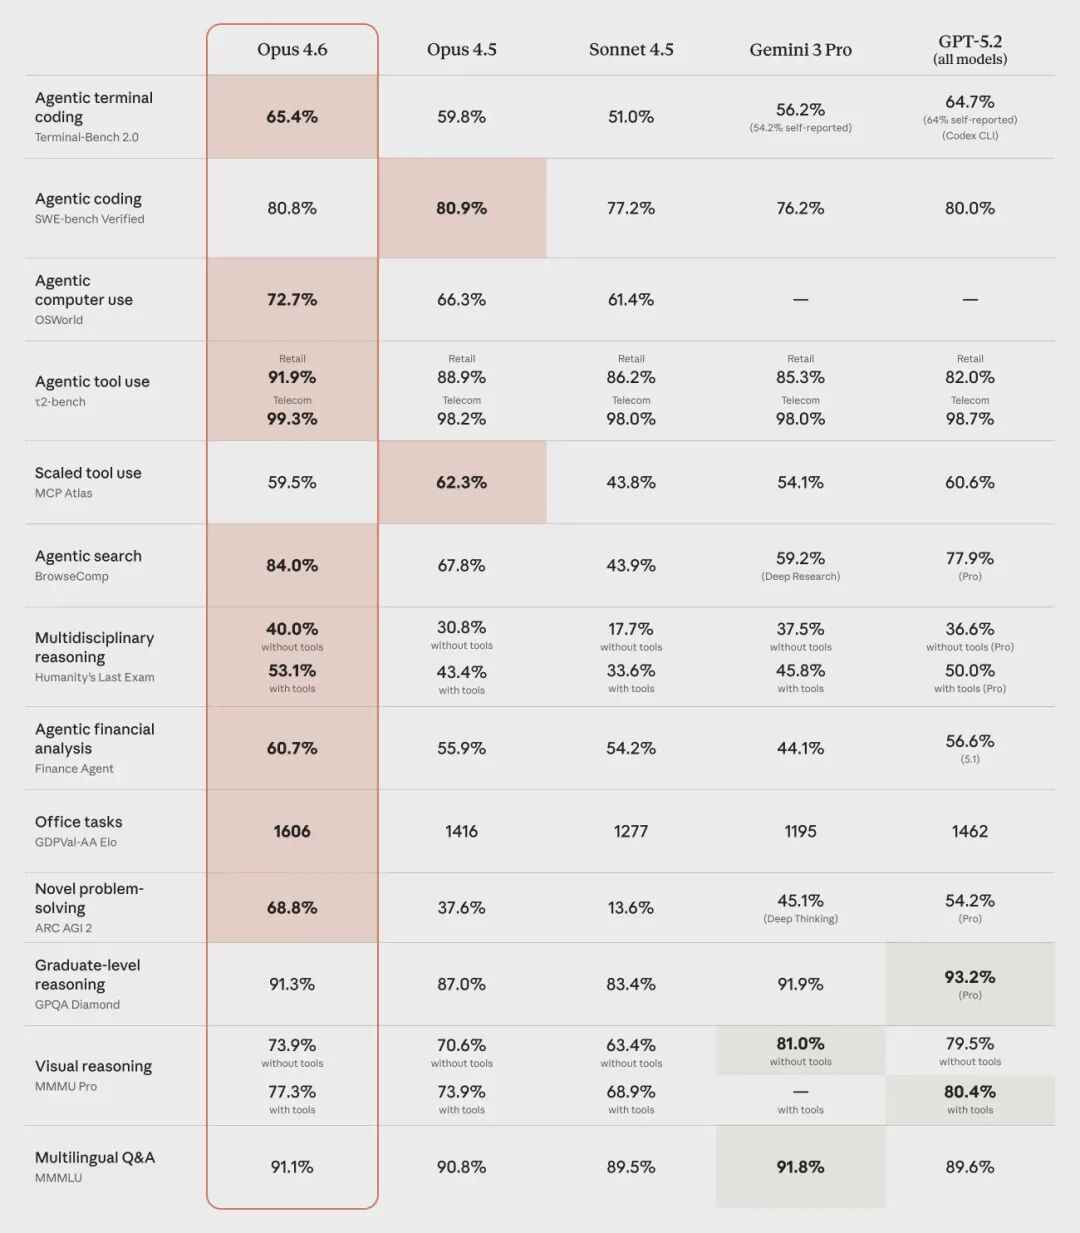
Anthropic刚刚发布了Claude Opus 4.6,这是其最智能模型的一次重要升级。新模型在多个关键基准测试中表现出色,特别是在ARC-AGI 2测试中取得了68%的成绩,远超其他主流模型。
核心能力提升
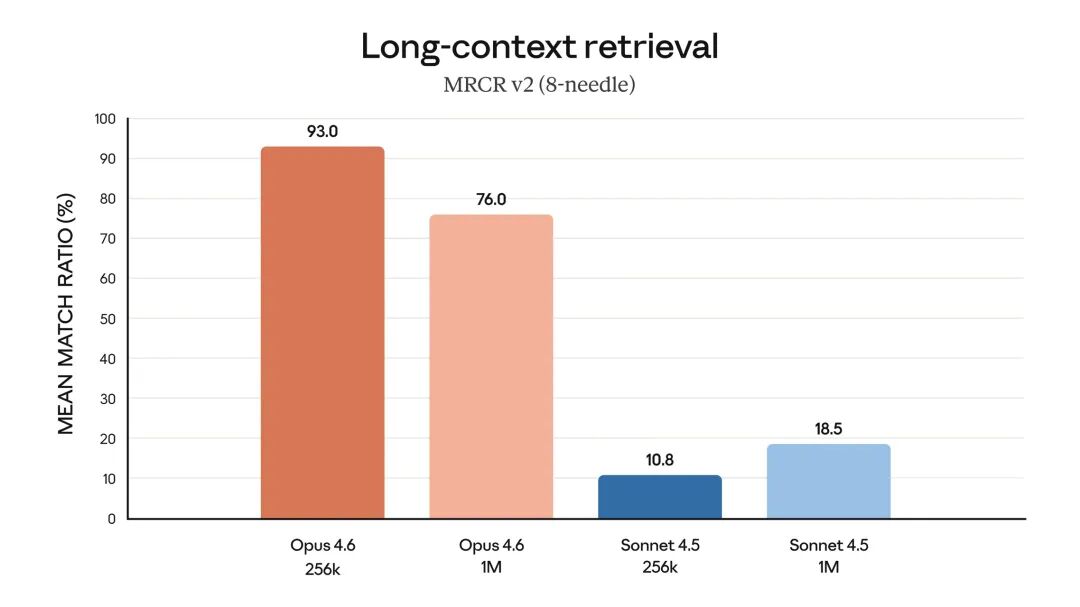
Opus 4.6在编程能力上有了明显进步,能够更仔细地规划任务,在大型代码库中更可靠地操作,并具备更好的代码审查和调试技能。这是Opus系列首个支持100万token上下文窗口的模型(测试版)。
在日常办公任务方面,新模型可以运行财务分析、进行研究,以及使用和创建文档、电子表格和演示文稿。在Cowork环境中,Opus 4.6可以自主运用这些技能为用户服务。
基准测试表现
除了ARC-AGI的突出表现外,Opus 4.6在多个评估中均达到行业领先水平:
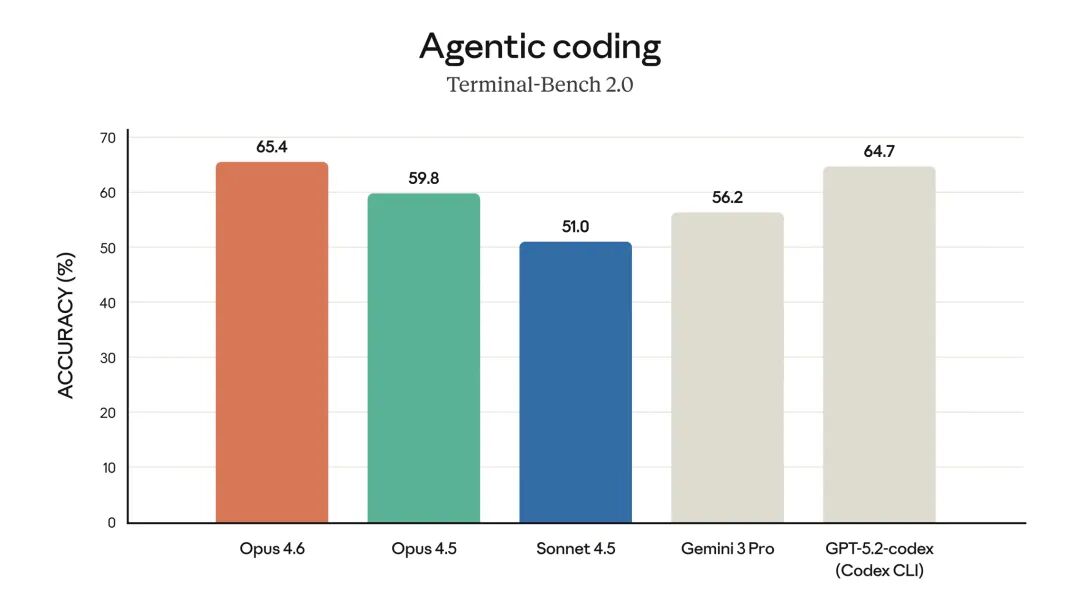
- 在Terminal-Bench 2.0代理编码评估中取得最高分
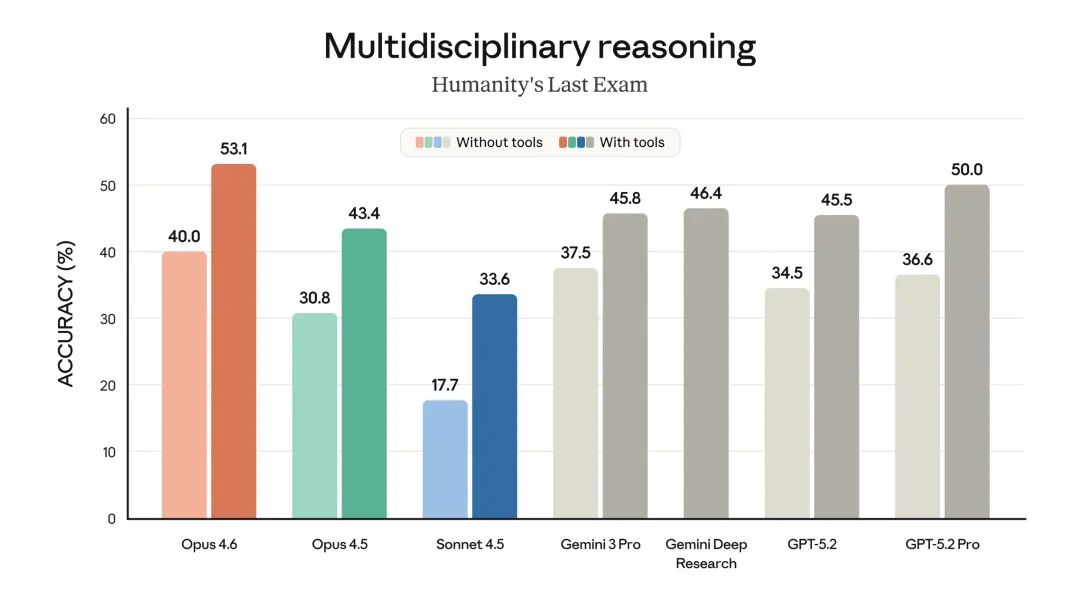
- 在Humanity's Last Exam复杂多学科推理测试中领先所有其他前沿模型
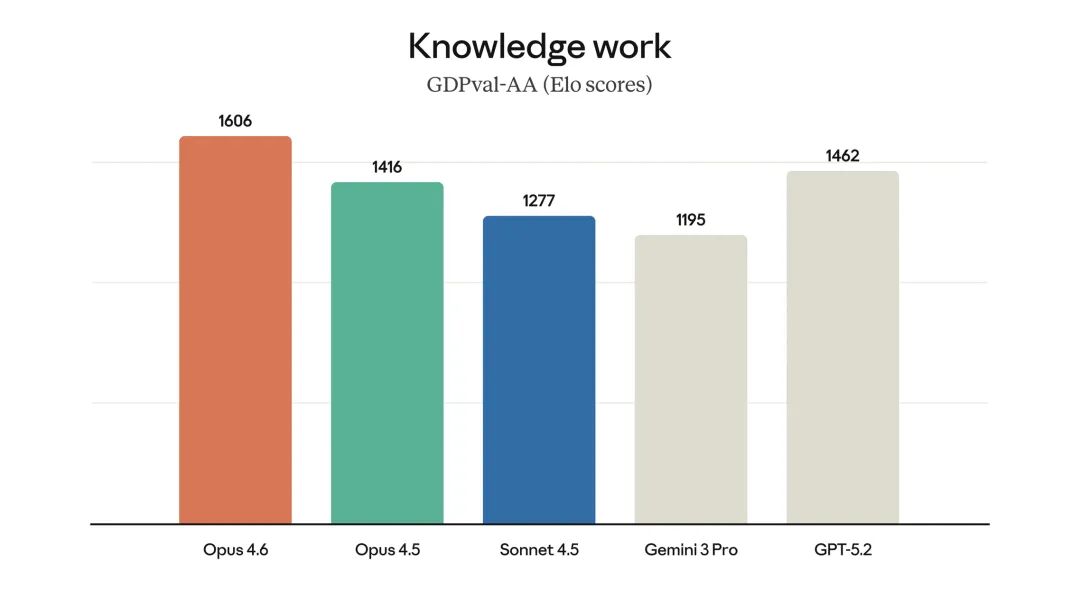
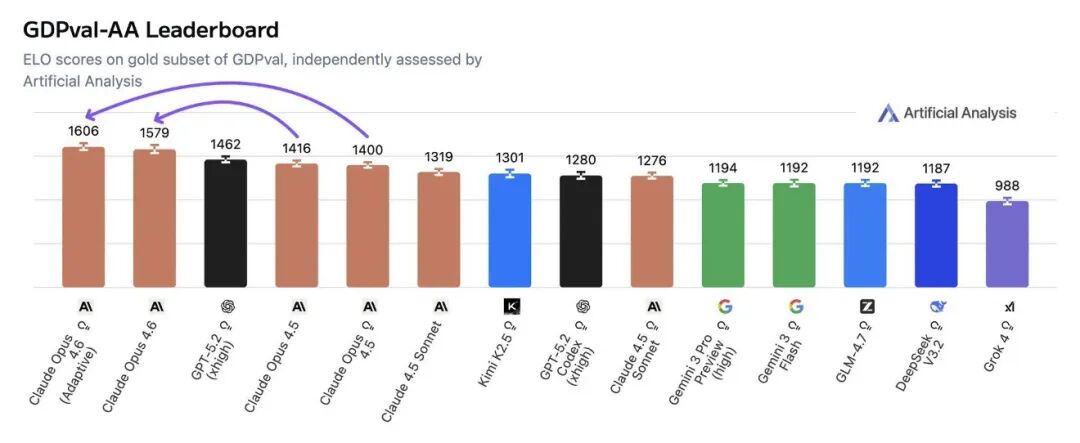
- 在GDPval-AA经济价值工作任务评估中,比行业次优模型(OpenAI GPT-5.2)高出约144个Elo点
有网友评论称:“ARC-AGI 2的得分太疯狂了,几个月内这个领域就会饱和。”但也有人质疑这些基准测试是否真的能衡量有意义的能力。
实际应用反馈
早期测试合作伙伴对Opus 4.6的评价积极。Notion表示这是“Anthropic发布的最强模型”,GitHub指出它在“复杂的多步骤编码工作”上表现出色,Replit则认为在代理规划方面是“巨大飞跃”。
定价保持不变
尽管性能提升显著,但定价维持不变:每百万token输入5美元,输出25美元。这让一些期待降价或提速的用户感到些许失望。
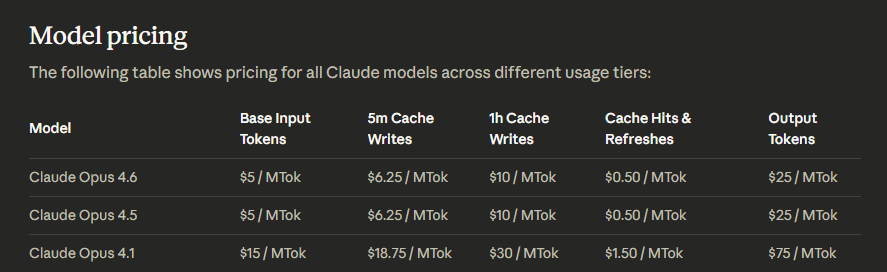
定价信息
安全性能
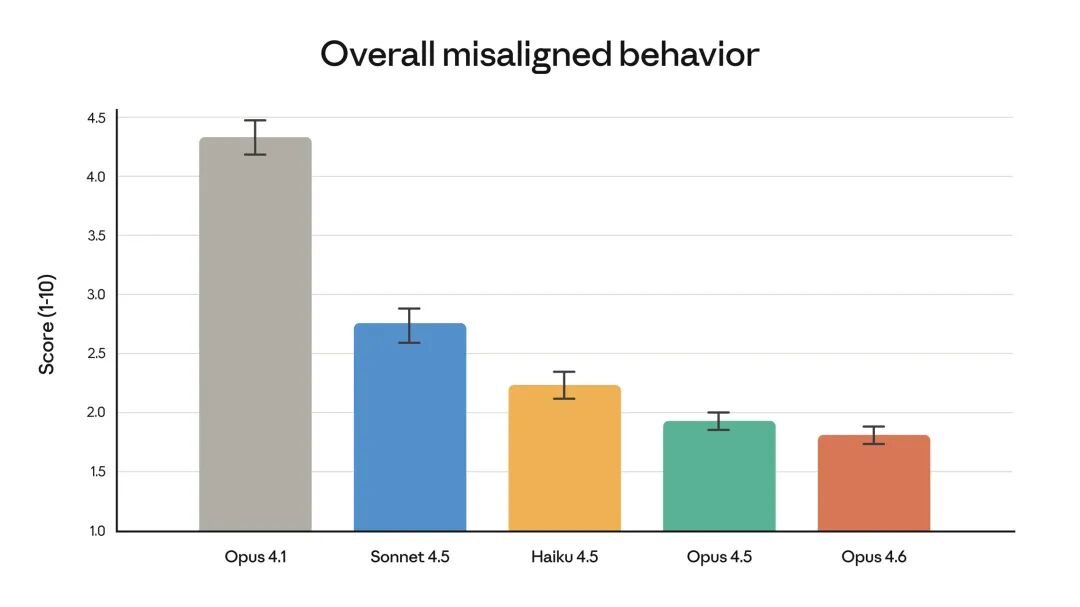
Anthropic强调,这些智能提升并未以安全为代价。在自动行为审计中,Opus 4.6显示出较低的错误对齐行为率,如欺骗、奉承、鼓励用户妄想和合作滥用等。
开发者新功能
API方面引入了多项新功能:
- 自适应思考:模型可以自行决定何时需要深度推理
- 努力控制:四个可调节的智能水平选项
- 上下文压缩:自动总结和替换较旧的上下文
- 128k输出token支持
Claude Opus 4.6现已通过claude.ai、API和所有主要云平台提供。对于需要处理复杂任务和长期代理工作的用户来说,这次升级值得关注。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-02-06,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号