GPT-4训练花了1亿美元,DeepSeek只花了560万——AI模型的'参数军备竞赛'结束了

GPT-4训练花了1亿美元,DeepSeek只花了560万——AI模型的'参数军备竞赛'结束了
老周聊架构
发布于 2026-06-25 16:04:28
发布于 2026-06-25 16:04:28
2023年3月,GPT-4发布,API定价每百万Token输出$1.10。性能?几乎打平。价格?差了55倍。训练成本?GPT-4花了超过1亿美元,DeepSeek-V3花了560万美元。差了18倍。
如果这还不够震撼,看看最新的LMArena排行榜:
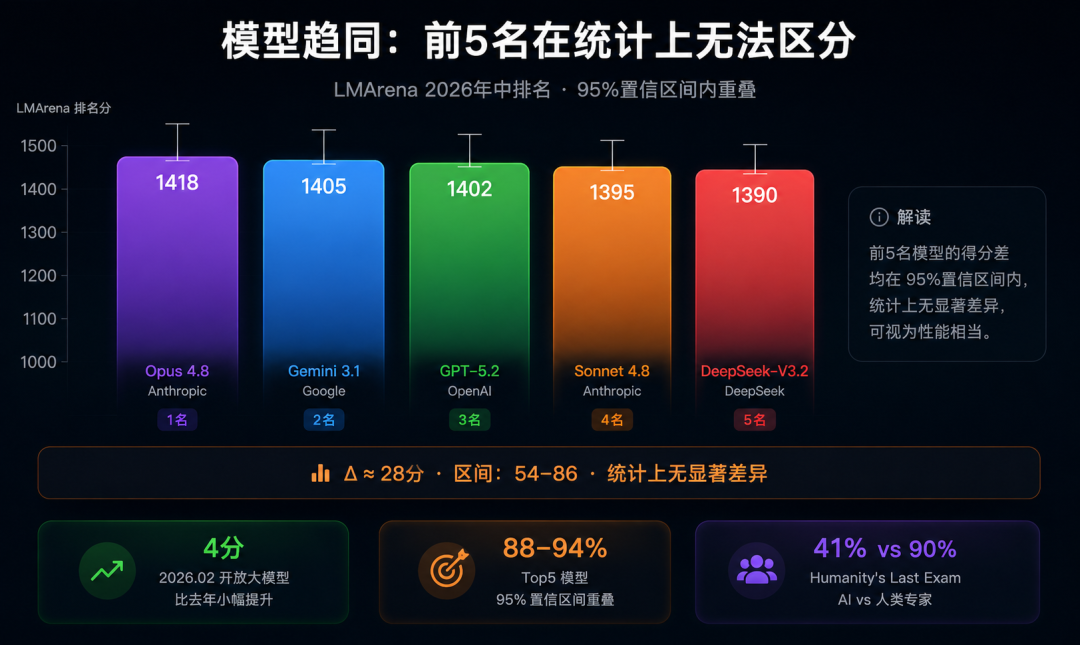
前5名模型的Elo分差不到25分——在95%置信区间内,它们统计上无法区分。
"谁更聪明"这个问题,在2026年已经没有意义了。
新的问题是:谁更便宜、谁更快、谁更适合我的场景。
今天这篇文章,把大模型从"参数军备竞赛"到"成本效益竞赛"的范式转移讲透。
一、模型趋同:前5名打成了平手
1.1 Elo分数说明一切
LMArena(前身Chatbot Arena)是目前最权威的大模型实力排行榜,基于真人盲测投票打分。看看2026年中的排名:
排名 | 模型 | Elo(文本) | 厂商 |
|---|---|---|---|
1 | Claude Opus 4.6 | 1418 | Anthropic |
2 | Gemini 3.1 Pro | 1406 | |
3 | GPT-5.2 | 1402 | OpenAI |
4 | Claude Sonnet 4.6 | ~1395 | Anthropic |
5 | DeepSeek-V3.2 | ~1390 | DeepSeek |
第1名到第5名的差距:大约28分。
这是什么概念?在Elo评分体系中,两个选手分差25分以内意味着胜率接近54:46——也就是说,打100盘棋,领先者只多赢8盘。
用人话说:你让这5个模型做同一道题,差不多5次有3次答案一样。 差异小到用户体感几乎无法分辨。
1.2 开源追上来了
更有意思的是开源模型和闭源模型的差距变化:
时间 | 开源vs闭源Elo差距 | 代表开源模型 |
|---|---|---|
2024年初 | 100-150分 | Llama 2, Mixtral |
2025年2月 | 4分(历史最低) | DeepSeek-V3 |
2026年中 | 25-55分 | Qwen3.5, DeepSeek-V3.2, Kimi K2.6 |
2025年2月,开源模型和闭源模型的差距一度缩小到仅4分。虽然后来闭源模型通过推理能力拉开了一些差距,但趋势非常明确:开源正在无限逼近闭源的天花板。
1.3 基准测试的"通货膨胀"
传统基准测试已经失去了区分度:
基准测试 | 当前头部模型得分 | 状态 |
|---|---|---|
MMLU | 88-94% | 饱和,无法区分 |
MMLU-Pro | ~90% | 接近饱和,前5名挤在6分带内 |
MATH-500 | 97%+ | 几乎满分 |
HumanEval | 95%+ | 饱和 |
现在能拉开差距的只剩下几个"变态级"测试:
新基准 | 最佳AI得分 | 人类专家得分 | 差距 |
|---|---|---|---|
Humanity's Last Exam | 41% | ~90% | 49分 |
ARC-AGI-2 | 低 | 高 | 巨大 |
SWE-Bench Pro | 58.6%(Kimi K2.6) | — | 仍有提升空间 |
老周的观点:模型趋同不是"AI停滞"的信号,而是"基础能力已经够用"的信号。 就像2010年以后,CPU单核性能增长放缓了,但我们并没有觉得电脑变慢了——因为瓶颈已经不在CPU上了。
二、价格雪崩:3年暴跌280倍
2.1 一张图看懂价格崩塌
GPT-3.5级别的能力,API价格变化:
时间 | 模型 | 输出价格($/百万Token) | 相对GPT-3.5 |
|---|---|---|---|
2022.11 | GPT-3.5 | $20.00 | 1x |
2023.03 | GPT-4 | $60.00 | 更贵了 |
2023.11 | GPT-4 Turbo | $30.00 | -50% |
2024.05 | GPT-4o | $15.00 | -75% |
2024.07 | GPT-4o-mini | $0.60 | -97% |
2024.12 | DeepSeek-V3 | $1.10 | -94.5% |
2025-2026 | Gemini Flash Lite | $0.40 | -98% |
2025-2026 | DeepSeek V3.2 Flash | $0.28 | -98.6% |
2.2 中国市场更极端
如果你觉得美国市场的降价已经很疯了,看看中国:
- 字节跳动把豆包Pro-32K降到0.8元/百万Token(降价99.3%)
- 中国电信推出Token月卡:9.9元/月,含1000万Token
- RAND 2026报告:中国模型的运行成本大约是美国同类模型的1/6到1/4
用人话说:美国的大模型API从"五星级酒店"降到了"快捷酒店",中国直接降到了"青年旅社"。
2.3 这是可持续的吗?
有一个重要的反面观点:
Google最近在涨价。Gemini 2.5 Flash输入价0.3,Gemini 3.5 Flash是1.5
——5倍。
有分析师指出:
"那些让你觉得产品可行的低价,从来不是实验室的真实定价。它们是风投补贴的获客折扣,现在正在被收回。"
老周的判断:短期降价趋势不可逆,但"race to zero"不可能真的到零。 最终会形成一个分层定价体系——就像云计算从"按需付费"演化出了Reserved Instance、Spot Instance、Savings Plan一样。
三、MoE:用671B参数的知识,付37B参数的账单
3.1 MoE到底是什么?
MoE(Mixture of Experts,混合专家)是当前最重要的模型架构创新。
一句话解释: 模型有很多"专家"(子网络),但每次只激活其中几个,其他的"休息"。
传统Transformer:每个Token过所有参数。 MoE Transformer:每个Token只过一小部分参数。
1  传统模型(Dense):
2    Token → [所有671B参数] → 输出
3    速度:慢  成本:高  知识:671B
4
5  MoE模型:
6    Token → 路由器 → [选择8个专家,共37B参数] → 输出
7    速度:快  成本:低  知识:671B(全部专家的总知识量)
关键洞察:总参数量决定"知识容量",激活参数量决定"计算成本"。 MoE让你用小模型的成本,获得大模型的知识。
3.2 主流MoE模型参数对比
模型 | 总参数 | 激活参数 | 专家数 | 每Token激活 | 训练成本 |
|---|---|---|---|---|---|
Mixtral 8x7B | 46.7B | 12.9B | 8 | 2 | — |
DeepSeek-V3 | 671B | 37B | 256 | 8 | $560万 |
Qwen3-235B | 235B | 22B | 128 | 8 | — |
Llama 4 Maverick | 400B | 17B | — | — | — |
Llama 4 Behemoth | 2T | 288B | — | — | — |
Kimi K2 | 1T | 32B | 384 | 8+1共享 | — |
GLM-5 | 744B | MoE | — | — | — |
DeepSeek-V3的数据最能说明问题:671B的知识量,37B的计算成本。 推理速度由激活参数决定(37B),而不是总参数(671B)。这意味着它的推理速度接近一个37B的Dense模型,但知识储备是671B级别的。
3.3 DeepSeek-V3的训练成本解剖
DeepSeek-V3的训练报告公开了令人震惊的数据:
指标 | 数值 |
|---|---|
GPU型号 | NVIDIA H800(H100的出口管制版) |
GPU小时数 | 2,788,000小时 |
训练数据量 | 14.8万亿Token |
估算训练成本 | $5,576,000(约560万美元) |
对比一下:
模型 | 训练成本 | 硬件 |
|---|---|---|
GPT-4 | $1亿+(Altman亲口确认) | 25,000张A100,约100天 |
Llama 3.1 405B | 约$5亿 | 16,000张H100 |
DeepSeek-V3 | $560万 | H800 |
GPT-4是DeepSeek-V3训练成本的18倍。Llama 3.1是90倍。
而DeepSeek-V3的性能?跟GPT-4基本持平。
这就是为什么DeepSeek被称为AI行业的"Sputnik Moment"——它证明了:不是谁钱多谁就能赢,算法创新可以打败暴力堆算力。
3.4 MoE的三大关键技术创新
DeepSeek-V3为什么能这么便宜?三个关键技术:
技术 | 作用 |
|---|---|
Multi-head Latent Attention (MLA) | 压缩KV缓存,减少显存占用 |
无辅助损失的负载均衡 | 让专家被均匀利用,不需要额外的正则化损失 |
Multi-Token Prediction | 一次预测多个Token,提高训练效率 |
用老周的话说:DeepSeek不是在更便宜的硬件上做了同样的事,而是发明了更聪明的训练方法。 这就像F1赛车——不是只靠引擎马力大,还要靠空气动力学设计。
四、中国开源军团:五大模型全面开花
4.1 格局一览
模型 | 公司 | 总参数 | 亮点 | 许可证 |
|---|---|---|---|---|
DeepSeek-V3/R1 | DeepSeek | 671B | 性价比之王,Nature封面 | MIT |
Qwen3.5 | 阿里 | 397B/17B | HuggingFace下载量第一,201种语言 | Apache 2.0 |
Kimi K2.6 | 月之暗面 | 1T/32B | SWE-Bench Pro第一,300子Agent协同 | MIT(修改版) |
GLM-5 | 智谱AI | 744B | 港交所上市第一家AI公司 | MIT |
Seed 2.0 | 字节跳动 | — | 驱动豆包App,1.55亿周活 | 开源 |
4.2 Qwen:HuggingFace的新霸主
一组数据让人侧目:
- 2025年9月,Qwen系列在HuggingFace的累计下载量超越了Llama(3.254亿 vs 3.237亿)
- 到2026年3月,Qwen累计下载量达到9.421亿
- 衍生模型数量:11.3万个
- 标记为Qwen的模型总数:20万+
Qwen3-235B的技术参数:
- 94层Transformer,128个专家,每Token激活8个
- 在36万亿Token上预训练(是Qwen2.5的2倍)
- AIME 2024得分:85.7%
- 许可证:Apache 2.0(最宽松的开源许可)
4.3 DeepSeek:200人团队的奇迹
数据点 | 数值 |
|---|---|
创始人 | 梁文锋(High-Flyer量化基金联合创始人) |
员工数 | 约200人 |
成立时间 | 2023年7月 |
首轮外部融资 | 2026年5月,估值73.5亿 |
投资方 | 国家AI产业投资基金(国家级$88亿基金) |
200人的团队,做出了跟数千人团队水平相当的模型。 梁文锋之前是量化交易出身,High-Flyer管理的资产规模让他可以自掏腰包买GPU,不需要外部融资。直到2026年5月才进行第一轮外部融资,估值直接到了$450-500亿。
4.4 一个值得关注的指标
HuggingFace的下载数据揭示了一个大趋势:
- 中国开发者贡献了top开源模型下载量的45%以上
- 2025年7月底,中国超越美国成为HuggingFace累计下载量第一的国家(2026年3月:11.5亿 vs 7.23亿)
用人话说:开源模型的重心正在向中国倾斜。
五、闭源 vs 开源:一场不对称战争
5.1 成本对比
维度 | 闭源旗舰 | 开源模型 | 差距 |
|---|---|---|---|
平均API价格 | $1.86/百万Token | $0.23/百万Token | 8倍 |
训练成本 | $1亿+ | $560万 | 18倍 |
推理成本(自部署) | 不可自部署 | 可自部署,高量级更省 | 视规模而定 |
5.2 但用户仍然选择闭源
一个有意思的数据:80%的用户选择闭源模型,尽管它们贵了87%。
为什么?
- 懒:API调一下就行,不用管部署
- 稳:SLA保障、安全合规、技术支持
- 快:不用等GPU交付
- 新:闭源模型通常比开源快3-6个月发布新能力
5.3 什么时候该用开源?
场景 | 推荐 | 原因 |
|---|---|---|
日Token量 < 50M | 闭源API | 自部署TCO更高 |
日Token量 > 100M | 开源自部署 | 年省5000万 |
数据敏感(金融/医疗) | 开源自部署 | 数据不出域 |
需要最新能力 | 闭源API | 开源滞后3-6个月 |
需要定制微调 | 开源 | 闭源不开放权重 |
预算有限 | 开源 + 托管API | Together.ai/Fireworks,1/3-1/10闭源价格 |
5.4 最聪明的策略:混合部署
Deloitte 2026报告显示:最成功的企业采用分层模型策略:
1  80%的请求 → 便宜模型(Haiku/Flash/开源7B)   成本:极低
2  15%的请求 → 中档模型(Sonnet/Pro/开源70B)    成本:中等
3  5%的请求 → 旗舰模型(Opus/GPT-5/o3)        成本:高
关键洞察:大多数请求根本不需要旗舰模型。 一个写得好的路由层,可以把总成本降低60-80%。
六、推理优化:不只是模型便宜,跑模型也在变便宜
6.1 四大优化技术
模型价格下降只是一半的故事。另一半是:推理效率也在指数级提升。
技术 | 效果 | 原理 |
|---|---|---|
量化(Quantization) | 内存减少2-4x | FP16→INT4,精度损失极小 |
蒸馏(Distillation) | 小模型替代80-90%大模型请求 | 大模型教小模型 |
投机解码(Speculative Decoding) | 吞吐提升2-3x | 小模型草拟,大模型一次验证 |
连续批处理(Continuous Batching) | 推理效率提升5x | vLLM/TensorRT-LLM |
组合使用这些技术,可以将推理成本降低60-80%,能耗降低73%。
6.2 一个具体例子
DeepSeek R1的蒸馏版本(Distill-Qwen-32B)在多个基准上超越了OpenAI o1-mini。
你没看错:一个32B的蒸馏模型,干掉了OpenAI的闭源推理模型。
这就是蒸馏的威力——大模型的"智慧"可以被压缩进小模型里。
七、对架构师的实践建议
7.1 模型选型决策树
1  你的场景需要什么?
2  ├── 最强推理能力 → Claude Opus / o3(贵但强)
3  ├── 性价比最优 → DeepSeek R1(o1能力的3.6%价格)
4  ├── 高量级推理 → Qwen3-235B 自部署(开源+MoE)
5  ├── 简单任务/分类 → Haiku / Flash Lite / 开源7B
6  ├── 数据不能出域 → 开源模型自部署
7  └── 不确定 → 先用API试,跑出数据再决策
7.2 成本优化四步法
第一步:分层路由 用一个简单的分类器,把请求按复杂度分到不同模型。80%的请求用便宜模型处理。
第二步:缓存策略 DeepSeek R1的缓存命中价格只有$0.14/M tokens(正常价的25%)。相同的System Prompt不要重复付费。
第三步:批处理 OpenAI Batch API和Anthropic Message Batches都提供50%折扣。不急的任务攒起来一起跑。
第四步:自部署评估 日均Token量超过1亿时,认真评估开源模型自部署。长期ROI可能是API的10倍以上。
写在最后
2026年的AI行业,正在经历一场从"谁更聪明"到"谁更高效"的范式转移。
回想2023年,大家都在比"参数谁多"、"训练谁烧钱多"、"基准谁高"。到了2026年,前5名模型的Elo分差压缩到25分以内,MMLU饱和在90%附近,API价格3年暴跌280倍。
"军备竞赛"结束了,"效率竞赛"开始了。
DeepSeek用200人的团队、560万美元的训练成本,证明了算法创新可以打败暴力堆算力。Qwen用36万亿Token的预训练和Apache 2.0许可证,在HuggingFace上超越了Llama成为下载量第一。MoE架构让1万亿参数的模型只需要32B的计算成本就能跑起来。
这对架构师意味着什么?
意味着你选模型的维度变了。以前是"选最强的",现在是"选最合适的"。一个写得好的路由层+分层模型策略,可以把AI成本降低80%,而用户体验几乎不变。
一句话总结:AI的"摩尔定律"不在参数上,而在每美元的智能产出上。2026年,同样1美元能买到的AI能力,是2023年的280倍。
我是老周,一个在架构领域摸爬滚打多年的技术人。如果这篇文章对你有帮助,欢迎点赞、在看、转发三连。关注「老周聊架构」,每周深度解读AI和架构的最新趋势。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-06-18,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号