课前准备--3D-QSAR与药物结构优化
原创
课前准备--3D-QSAR与药物结构优化
原创
追风少年i
发布于 2026-09-06 08:53:06
发布于 2026-09-06 08:53:06
作者,Evil Genius
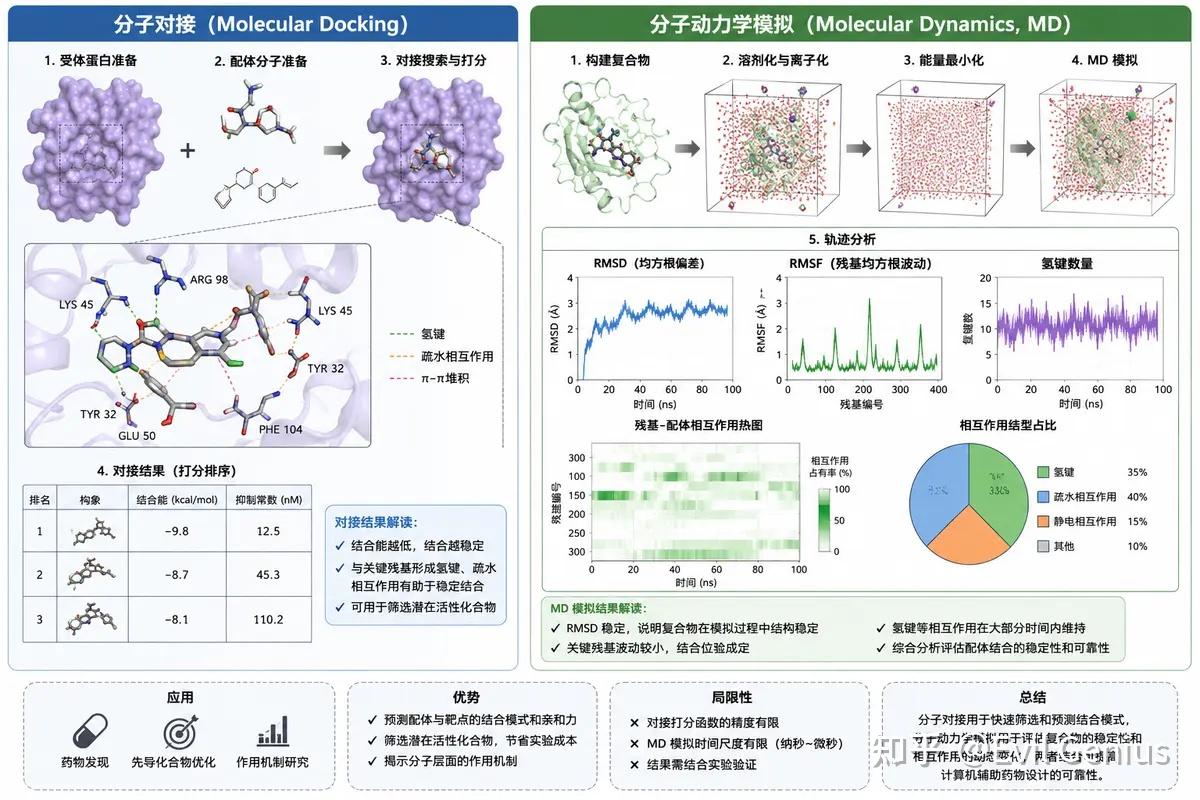
今天我们补充3D-QSAR 与药物结构优化
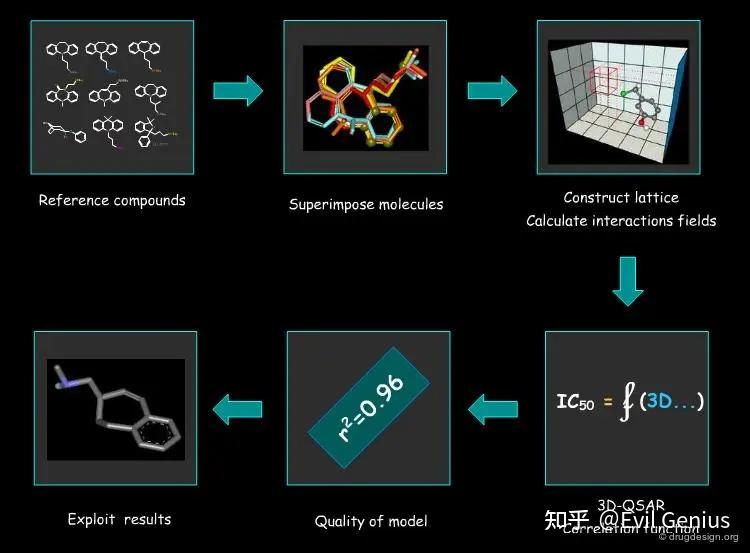
3D-QSAR(Three-Dimensional Quantitative Structure–Activity Relationship,三维定量构效关系)的核心思想,是把一系列具有相似作用机制的活性化合物放到统一的三维空间中,分析分子不同空间位置的立体场、静电场等性质与生物活性之间的定量关系,再利用模型预测新化合物活性,从而指导药物结构优化。
简单理解:
已知化合物结构 + 已知活性 → 建立3D-QSAR模型 → 找到“什么位置应该增加/减少什么性质” → 设计新分子 → 预测活性 → 合成验证 → 进一步优化。
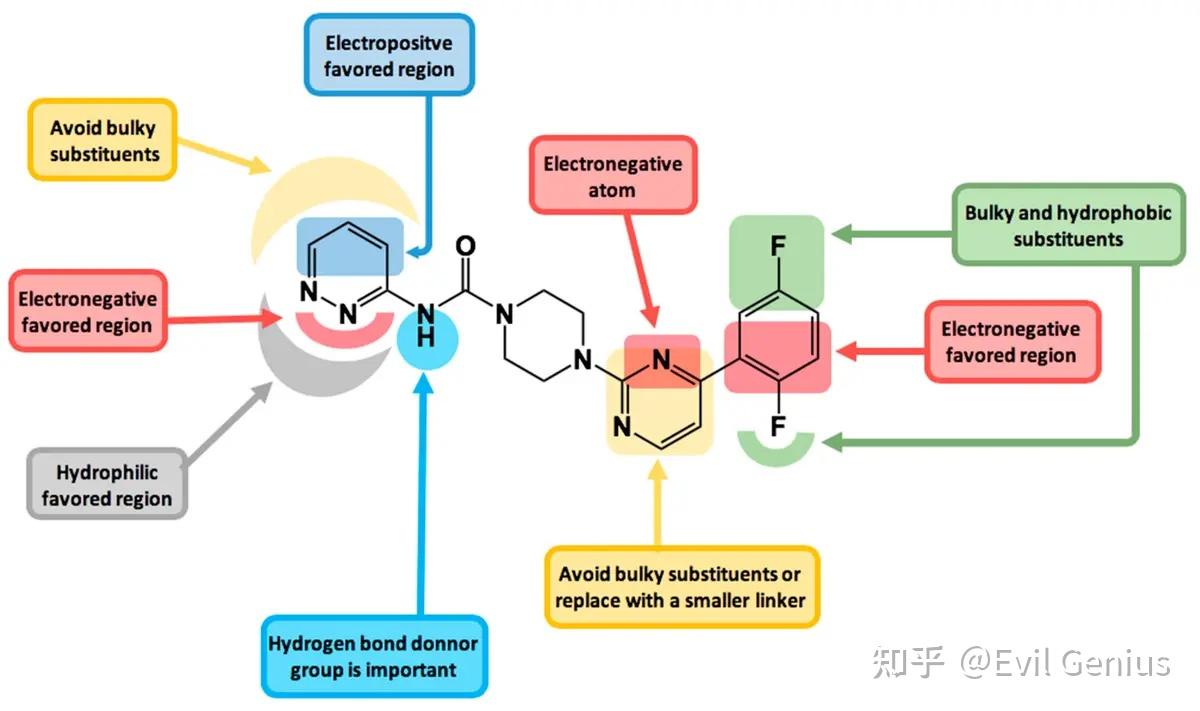
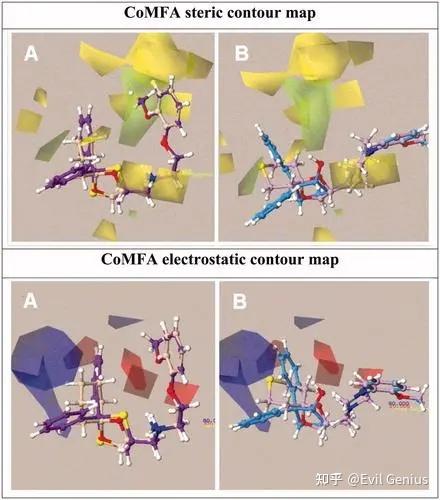
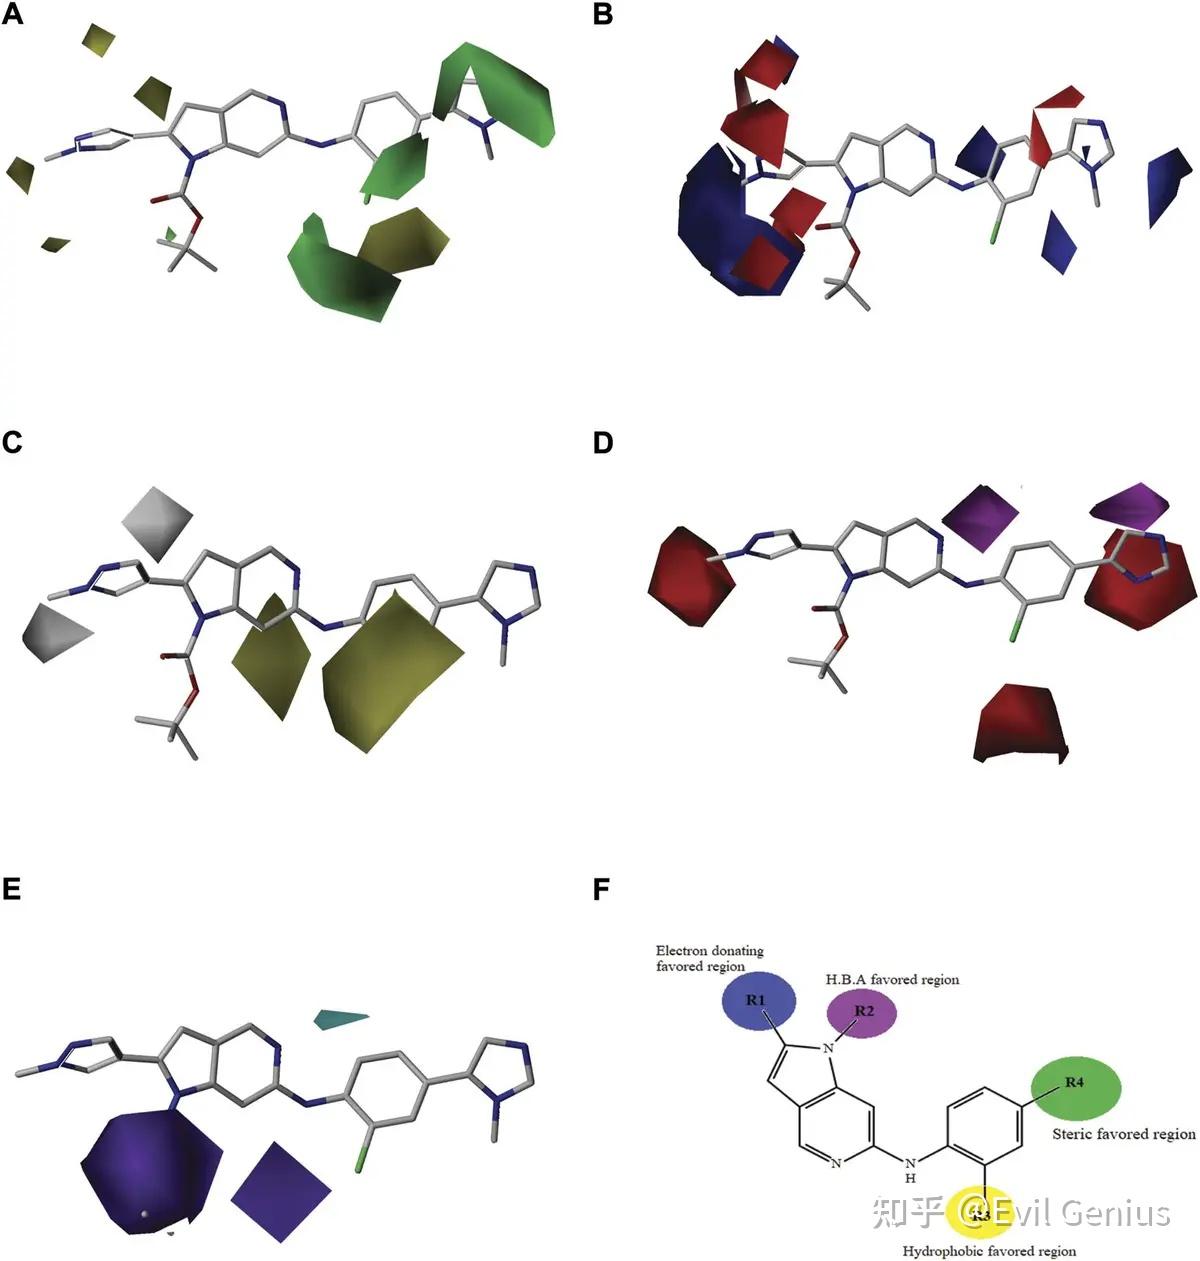
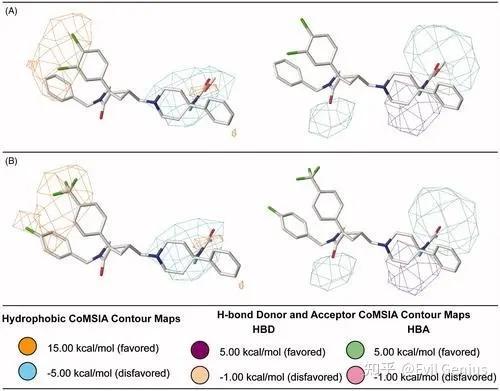
一、3D-QSAR到底解决什么问题?
传统SAR往往是:
苯环 → 换成甲基 → 活性提高 苯环 → 换成氟 → 活性下降
它能够告诉我们“改了什么以后活性发生变化”,但是不一定能解释:
为什么这个位置适合加大基团,而另一个位置不能加?
3D-QSAR进一步考虑分子的三维空间性质。
例如一个蛋白结合口袋:
疏水区域
                   ↓
        ┌──────────────────┐
        │      ▓▓▓▓        │
        │   配体分子        │
        │      ●────●      │
        │        │         │
        │     ●───●        │
        └──────────────────┘
             ↑
           极性区域
3D-QSAR可以进一步告诉我们:
- 哪个位置需要更大的基团?
- 哪个位置需要更小的基团?
- 哪个位置适合增加正电性?
- 哪个位置适合增加负电性?
- 哪个位置需要疏水基团?
- 哪个位置增加极性可能导致活性下降?
这就是它对药物结构优化最有价值的地方。
二、3D-QSAR的完整分析流程
整个过程可以概括为:
化合物库
   ↓
结构标准化
   ↓
活性数据整理
   ↓
三维结构生成
   ↓
分子构象优化
   ↓
分子叠合 Alignment
   ↓
计算三维分子场
   ↓
CoMFA / CoMSIA
   ↓
建立QSAR模型
   ↓
交叉验证
   ↓
外部验证
   ↓
Contour Map
   ↓
结构优化
   ↓
新化合物设计
   ↓
活性预测
   ↓
分子对接
   ↓
MD模拟
   ↓
实验验证
其中真正的核心是:
Alignment → Molecular Field → Statistical Model → Contour Map → Structure Optimization
三、第一步:准备化合物和活性数据
首先需要一批结构相似、作用机制相近的化合物。
例如有20~100个化合物:
Compound | IC₅₀ |
|---|---|
C01 | 12.5 nM |
C02 | 45.3 nM |
C03 | 110.2 nM |
C04 | 8.6 nM |
C05 | 320 nM |
... | ... |
通常把活性转换为:
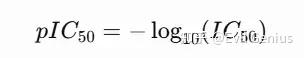
例如:
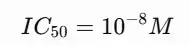
则:
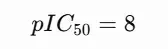
这样处理以后:
pIC₅₀越高 → 活性越强
四、第二步:结构标准化
需要对所有化合物进行统一处理。
主要包括:
1. 去除无关结构
例如:
- 溶剂
- counter ion
- 盐
- 不必要的小分子
2. 统一质子化状态
例如:
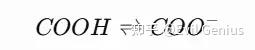
不同pH条件下的质子化状态可能影响:
- 电荷
- 氢键
- 静电场
- 分子构象
3. 统一立体化学
尤其需要注意:
- R/S
- E/Z
- 手性中心
因为3D-QSAR高度依赖三维结构。
五、第三步:建立三维结构
3D-QSAR与普通2D-QSAR最大的区别之一,就是需要三维坐标。
例如:
2D结构
   ↓
3D构象
   ↓
能量最小化
   ↓
合理构象
常见工具包括:
- RDKit
- Open Babel
- Schrödinger
- MOE
- Discovery Studio
- OpenEye
- Gaussian等
通常需要进行:Conformer generation
然后:Energy minimization
得到合理的三维构象。
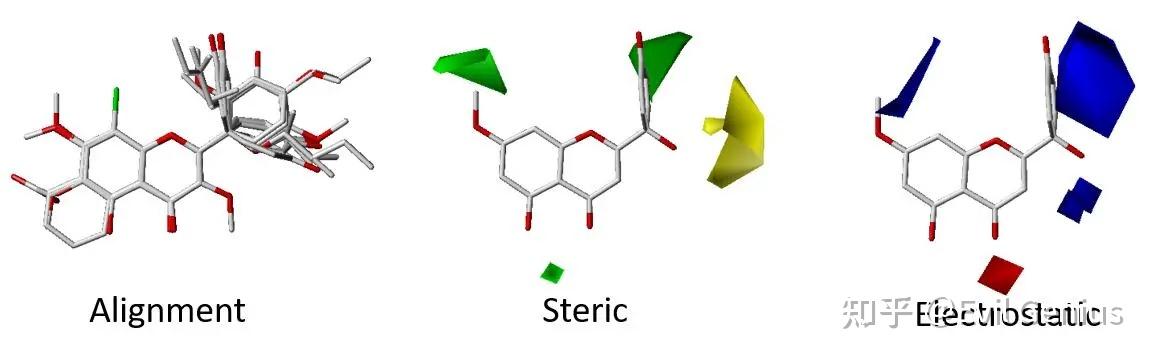
六、第四步:最关键的一步——分子叠合 Alignment
这是3D-QSAR中非常重要、同时也是最容易影响结果的一步。
假设有三个化合物:
Compound 1       Compound 2       Compound 3

    ●                ●                ●
   / \              / \              / \
  ●   ●            ●   ●            ●   ●
      \                \                \
       ●                ●                ●
必须把它们放到一个统一坐标系中。
例如:
Compound 1
             ↓
        ───────────
          Compound 2
             ↓
        ───────────
          Compound 3
             ↓
        ───────────

       统一空间坐标
这样才能比较:
空间中同一个位置的物理化学性质是否与活性相关。
七、为什么Alignment如此重要?
假设真实情况是:
蛋白结合口袋
   ┌───────────────┐
   │   疏水区域     │
   │       ↓       │
   │     [R]       │
   │               │
   │   [配体核心]   │
   └───────────────┘
如果配体叠合正确:
Ligand 1
Ligand 2
Ligand 3
Ligand 4
   ↓
核心结构高度重合
3D-QSAR才能准确分析。
如果叠合错误:
Ligand 1      Ligand 2
    ●             ●
       Ligand 3
           ●

空间位置错乱
      ↓
错误的3D场
      ↓
错误的QSAR模型
      ↓
错误的结构优化建议
因此:
Alignment质量往往直接决定3D-QSAR模型的可信度。
八、第五步:计算三维分子场
这是3D-QSAR的核心。
最经典的是:
CoMFA
Comparative Molecular Field Analysis
主要分析:
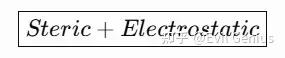
① Steric field
即:
立体场
通常使用探针原子在空间网格中扫描分子。
回答:
这个位置需要“大一点”还是“小一点”?
② Electrostatic field
即:
静电场
回答:
这个位置更适合正电性还是负电性?
因此CoMFA最经典的两个描述符:
九、CoMSIA
另一个经典方法是:
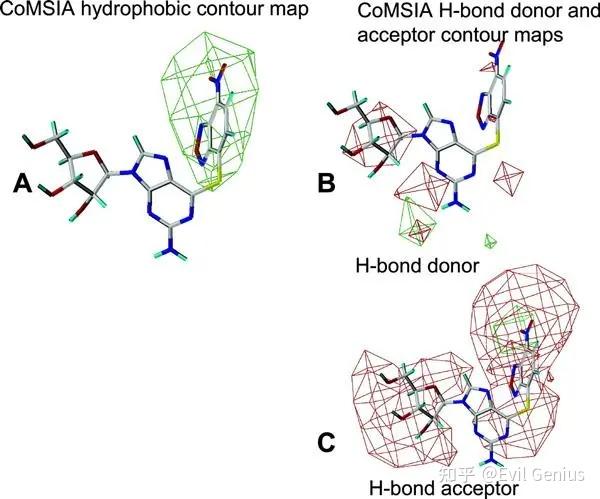
CoMSIA
Comparative Molecular Similarity Indices Analysis
可以同时分析:
- Steric
- Electrostatic
- Hydrophobic
- H-bond donor
- H-bond acceptor
因此:
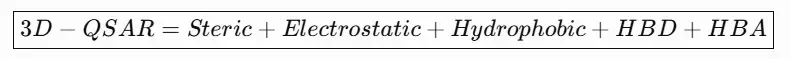
具体采用哪些场取决于研究体系。
十、为什么需要建立三维网格?
可以想象在分子周围建立一个巨大的三维“空间网格”:
Z
             ↑
             │
        ┌───────────┐
       /│          /│
      / │         / │
     ┌───────────┐  │
     │  • • • •  │  │
     │  • 配体 •  │  │
     │  • • • •  │ /
     │           │/
     └───────────┘────→ X
    /
   ↓
   Y
每个网格点都会记录:
- 立体能
- 静电能
- 疏水性
- 氢键性质等
最终形成一个非常大的矩阵:
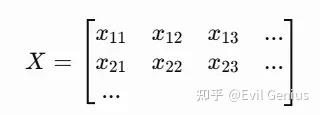
而实验活性:
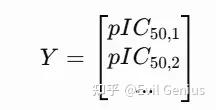
十一、第六步:建立统计模型
最经典的方法是:
PLS
Partial Least Squares,偏最小二乘回归
建立:
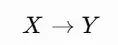
也就是:
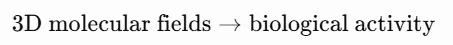
最终得到:
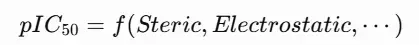
十二、第七步:模型验证
这一部分非常重要。
不能只看:R2
因为模型可能发生过拟合。
需要至少考虑:
① R2
训练集拟合能力。
② Q2
交叉验证能力。
通常:Q2 > 0.5
可以作为一个较常见的经验性参考,但不能把0.5当成绝对合格线。
③ RMSE
预测误差:
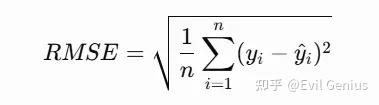
越小越好。
④ 外部验证
把数据分成:
Training set
      ↓
建立模型

Test set
      ↓
完全不参与建模
      ↓
预测
      ↓
比较预测值和实验值
这是评价3D-QSAR真正预测能力的重要方式。
十三、第八步——最重要的结果:Contour Map
3D-QSAR最有价值的输出之一就是:
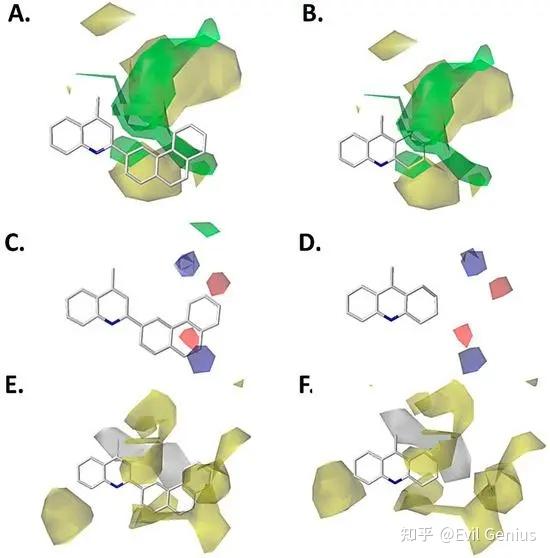
三维等高线图(Contour Map)
它能够直接告诉药物化学家:
“这个位置加什么基团可能更好?”
例如经典CoMFA:
Steric contour
绿色区域:
适合较大的基团
黄色区域:
不适合较大的基团
因此:
Green
           ↓
       [大基团]
           |
    ┌──────┴──────┐
    │    配体      │
    └─────────────┘
           ↑
        Yellow
      避免大基团
十四、Electrostatic contour
通常可以看到不同颜色区域分别代表:
正电性/负电性更有利或更不利的空间区域
例如:
电性有利区域
            ↓

       ┌───────┐
       │ Ligand│
       └───────┘

            ↑
另一种电性具体颜色含义必须以软件生成图例为准,不能脱离软件图例直接把某种颜色固定解释成“正电”或“负电”。
十五、从Contour Map进入药物结构优化
这才是3D-QSAR真正用于药物研发的地方。
假设原始分子:
R
        |
    ┌───────┐
    │ Core  │
    └───────┘
3D-QSAR发现:
         ↓
      适合大基团

        R
        |
    ┌───────┐
    │ Core  │
└───────┘那么可以设计:R = CH3
→ R = Et → R=iPr → R= Ph
然后分别预测活性。
十六、结构优化实际上是一个“迭代过程”
不是:
做一次3D-QSAR → 得到最终药物
而是:
已知活性化合物
             ↓
          3D-QSAR
             ↓
        Contour Map
             ↓
       结构改造设计
             ↓
       新化合物预测
             ↓
          分子对接
             ↓
        MD模拟验证
             ↓
         化合物合成
             ↓
          生物实验
             ↓
       新一轮SAR数据
             ↓
        更新3D-QSAR
             ↓
          再优化
这实际上是:
计算设计 → 实验验证 → 数据反馈 → 再设计
的循环。
十七、3D-QSAR + 分子对接 + MD是非常好的组合
分子对接、GROMACS分子动力学以及药物设计,把三种方法串起来。
它们解决的问题不同:
方法 | 核心问题 |
|---|---|
2D-QSAR | 什么结构特征影响活性? |
3D-QSAR | 三维空间什么性质影响活性? |
分子对接 | 配体可能如何结合蛋白? |
MD | 这个结合构象在动态环境下是否稳定? |
MM/PBSA | 结合自由能大致如何? |
形成:
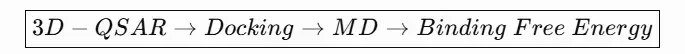
十八、一个非常典型的药物优化案例思路
假设研究一个蛋白靶点:
Protein
   │
   ├── Compound 1   IC50 = 100 nM
   ├── Compound 2   IC50 = 30 nM
   ├── Compound 3   IC50 = 10 nM
   ├── Compound 4   IC50 = 3 nM
   └── Compound 5   IC50 = 1 nM
首先:
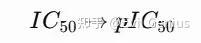
然后:
化合物3D结构
      ↓
结构叠合
      ↓
CoMFA / CoMSIA
      ↓
建立模型
      ↓
Contour Map
发现:
疏水有利区域
              ↓
          ┌──────┐
          │      │
     ┌────┴──────┴───┐
     │    Ligand     │
     └───────────────┘
             ↑
        H-bond有利区域
于是提出:
在R1位置增加疏水基团,在R2位置引入氢键受体。
设计:
Lead compound
      ↓
   R1优化
      ↓
   R2优化
      ↓
Compound A
Compound B
Compound C
Compound D
随后进行:
Docking
检查:
- 是否进入binding pocket
- 是否形成关键氢键
- 是否存在π-π stacking
- 疏水相互作用是否合理
- 是否出现空间冲突
再进行:
MD
例如:
- RMSD
- RMSF
- Radius of gyration
- Hydrogen bonds
- SASA
- Protein-ligand contacts
- MM/PBSA或MM/GBSA
最终筛选:

十九、3D-QSAR与药物结构优化的核心逻辑
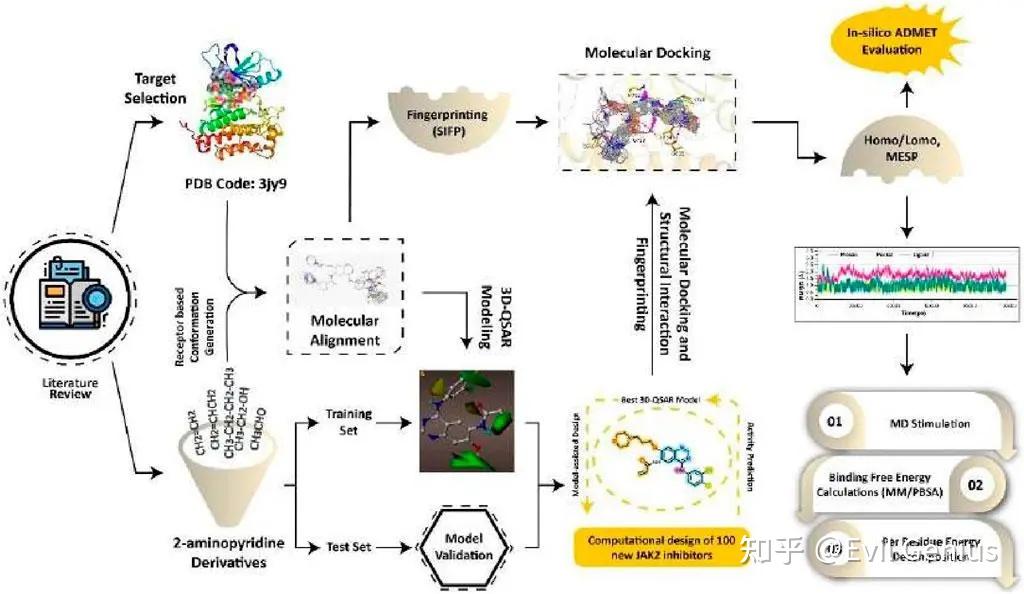
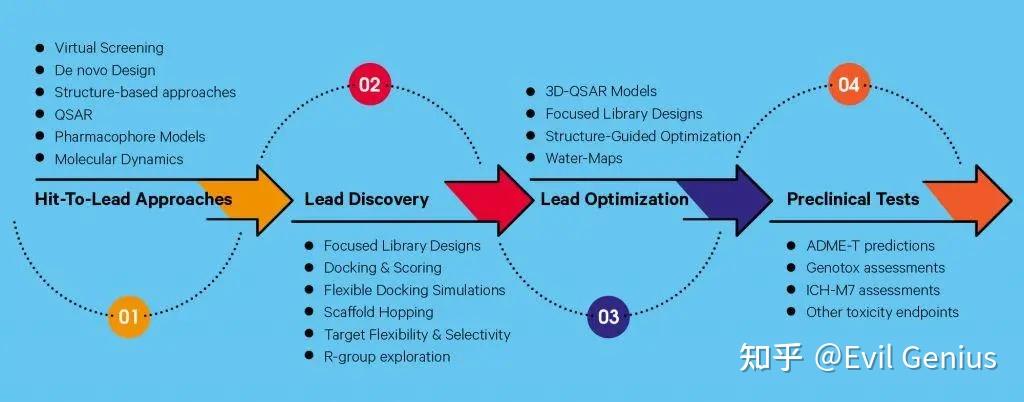
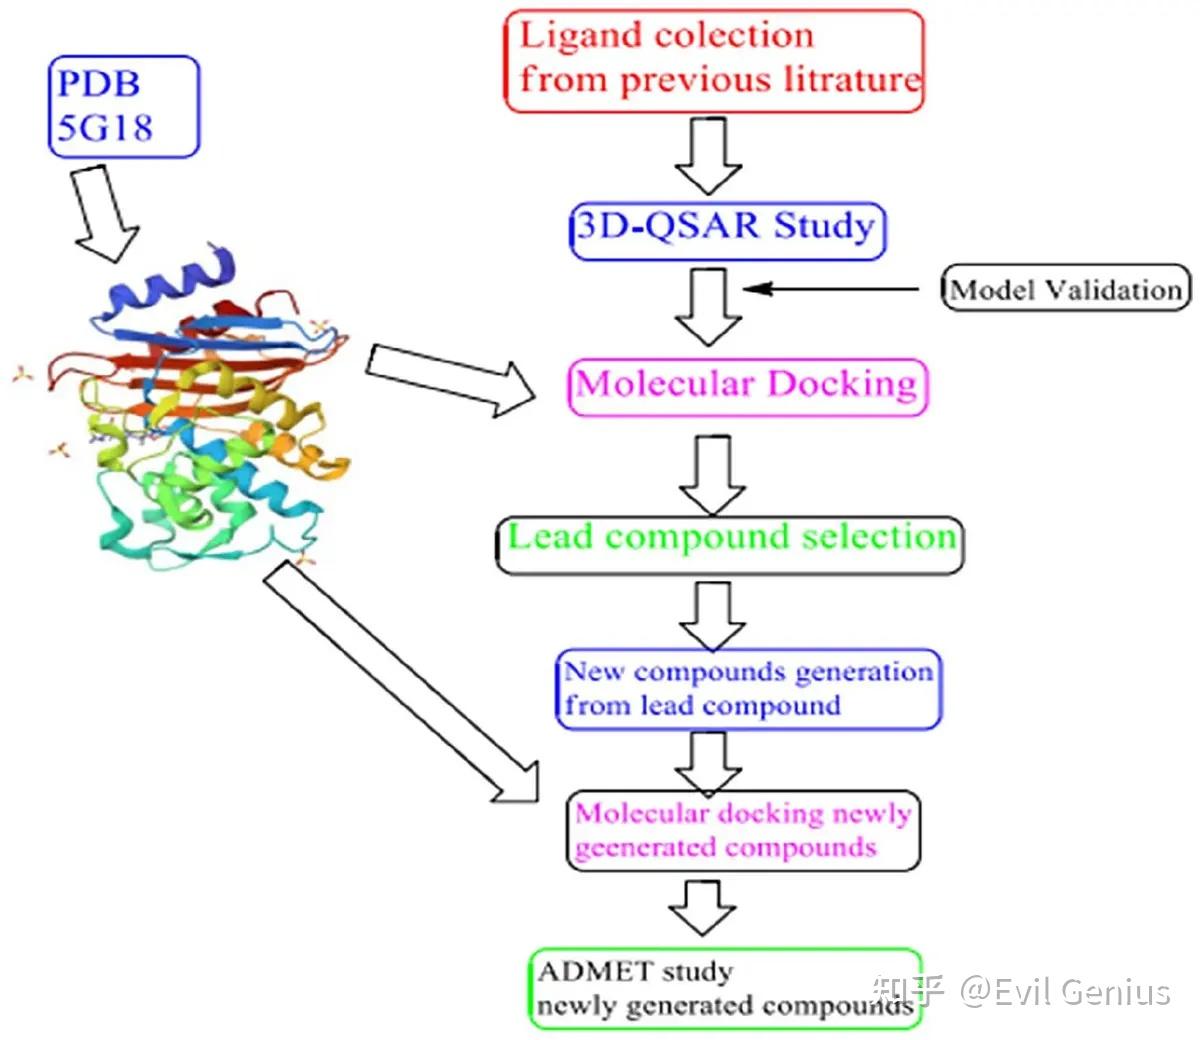
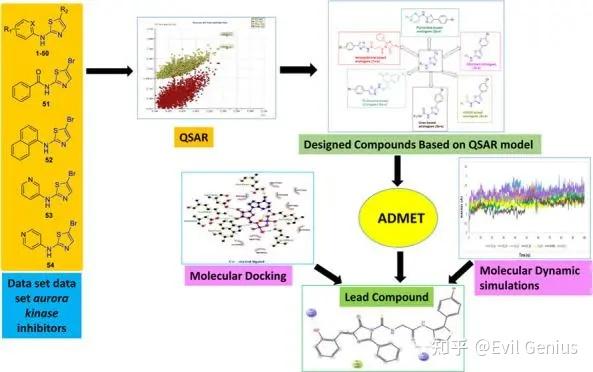
可以把整个过程浓缩成下面这张“科研思维图”:
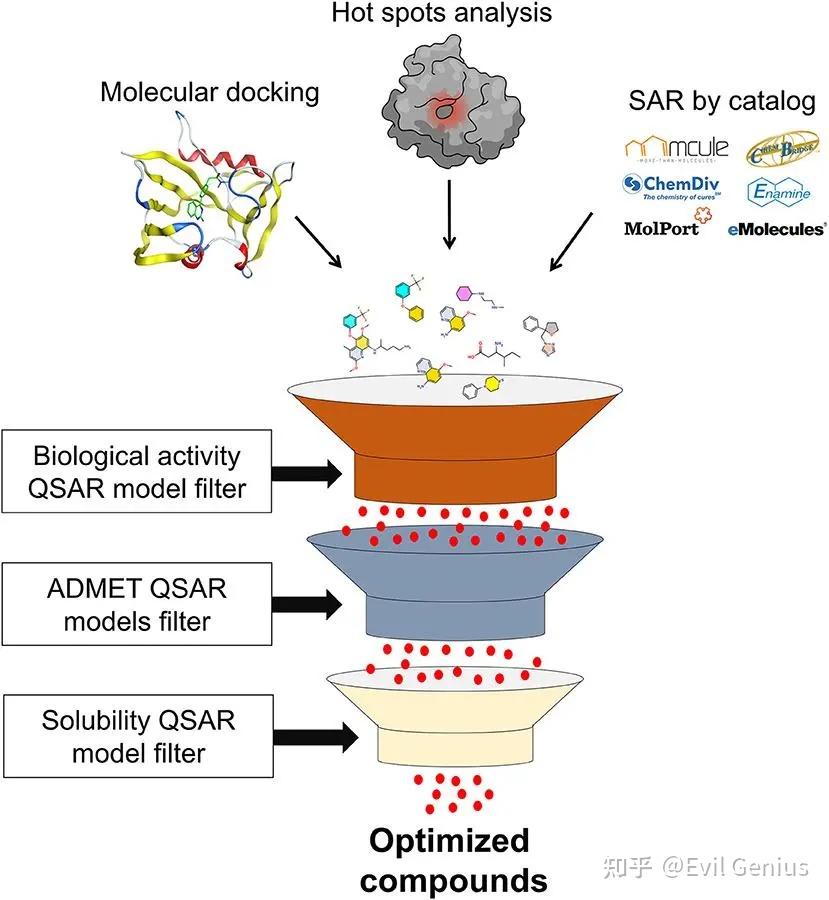
已知活性化合物
                       │
                       ↓
                三维结构准备
                       │
                       ↓
                 分子叠合
                       │
                       ↓
            ┌──────────────────┐
            │   3D Molecular   │
            │      Fields      │
            └──────────────────┘
                       │
                       ↓
                CoMFA / CoMSIA
                       │
                       ↓
                 PLS建模
                       │
                       ↓
              模型验证 R²/Q²
                       │
                       ↓
                Contour Map
                       │
              ┌────────┴────────┐
              ↓                 ↓
        有利区域             不利区域
              ↓                 ↓
       增加相应基团          避免相应基团
              └────────┬────────┘
                       ↓
                 新分子设计
                       ↓
                 活性预测
                       ↓
                    Docking
                       ↓
                     MD
                       ↓
                  实验验证
                       ↓
                  Lead优化
二十、3D-QSAR最需要注意的几个问题
1. 化合物不能太杂
如果化合物:
- 作用机制不同
- 结合位点不同
- 构象差异巨大
- 活性测定体系不同
那么建立一个3D-QSAR模型往往没有意义。
2. Alignment非常关键
错误Alignment:

3. 不要只看R²
一个: R²=0.95
的模型并不一定好。
必须进一步看: Q²
以及:
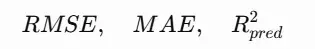
和独立外部测试集表现。
4. 3D-QSAR不是结合机制证明
这是非常重要的一点。
3D-QSAR告诉你:
某个空间区域的某种物理化学性质与活性存在统计关联。
但它并不能单独证明:
配体一定以某种姿势结合蛋白。
所以最好结合:
3D-QSAR + Docking + MD + 实验
进行综合判断。
二十一、如果用于实际科研,推荐的完整技术路线
如果目标是做一套比较完整的计算药物设计/论文分析流程,可以采用:
化合物数据库
                   ↓
             PubChem / ChEMBL
                   ↓
              结构标准化
                   ↓
            IC50 / Ki / EC50
                   ↓
               pIC50
                   ↓
          3D构象生成与优化
                   ↓
            Molecular Alignment
                   ↓
          ┌────────┴────────┐
          ↓                 ↓
        CoMFA             CoMSIA
          ↓                 ↓
          └────────┬────────┘
                   ↓
                PLS
                   ↓
             QSAR模型验证
                   ↓
             3D Contour Map
                   ↓
             Lead结构优化
                   ↓
              新分子设计
                   ↓
              活性预测
                   ↓
            ┌──────┴──────┐
            ↓             ↓
         Docking          ADMET
            ↓
           MD
            ↓
     RMSD/RMSF/H-bond/SASA
            ↓
       MM/PBSA / MM/GBSA
            ↓
          候选化合物
            ↓
          实验验证
总结yixia :
3D-QSAR负责回答“分子三维空间中哪里应该增加/减少什么性质”,分子对接负责回答“它可能怎样结合靶蛋白”,分子动力学负责回答“这种结合在动态环境中是否稳定”,三者结合可以形成从SAR规律发现 → 结构优化 → 结合模式验证 → 动力学稳定性评价的一套完整计算药物设计流程。
生活很好,有你更好。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号