2.5万颗星,这个项目治好了AI编程代理的"失忆症"——95.2%召回率,年成本$0

2.5万颗星,这个项目治好了AI编程代理的"失忆症"——95.2%召回率,年成本$0
豆芽菜小萌
发布于 2026-09-08 19:58:06
发布于 2026-09-08 19:58:06
大家好呀,我是开源先驱~
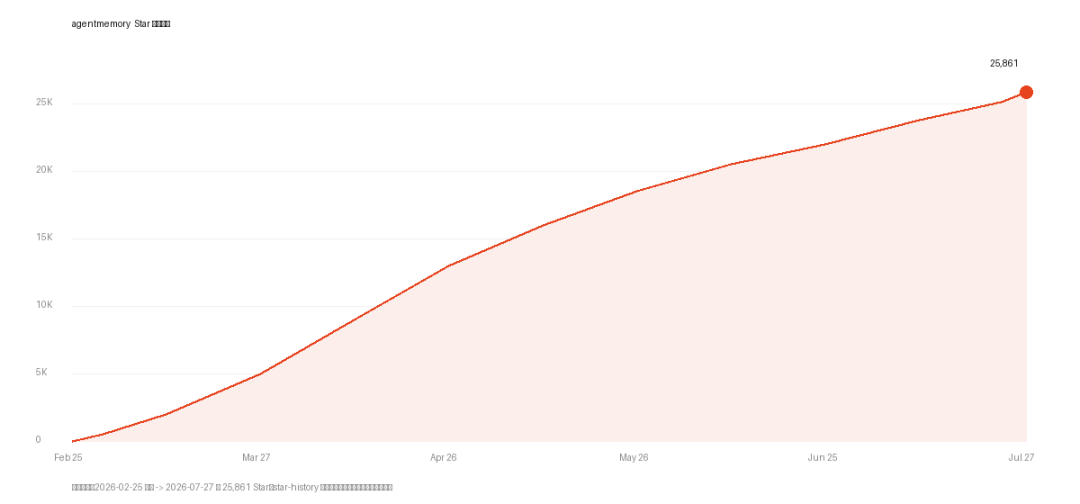
几个数先放这儿:25,861 颗星,2,152 个 fork,466 次提交。53 个 MCP 工具,12 个自动钩子,1,428 个测试。2026 年 2 月 25 日开的坑,今天 7 月 27 日——还在推代码,今天早上刚 push。
干的事情一句话能说清楚:给你的 AI 编程代理装上持久记忆。Claude Code、Codex、Cursor、Copilot——这些工具你天天用,但每次开新会话,代理把上一轮聊的忘得干干净净。你每个会话前五分钟都在重复解释:技术栈是什么、文件结构长啥样、上次为啥选了 jose 而不是 jsonwebtoken。agentmemory 在后台跑着,自动捕获代理的每次工具调用,压缩成可搜索的记忆,下次会话开始时把正确的上下文注入进去。
关键数据:LongMemEval 基准测试召回率 95.2%,token 消耗比粘贴完整上下文 省 92%,用本地嵌入模型跑——年成本 $0。
agentmemory Star 增长曲线
Star 增长趋势(数据锚点:2026-02-25 创建 -> 2026-07-27 达 25,861;star-history 限流,曲线为基于增长趋势的示意)
agentmemory 到底是什么?
一句话:一个给 AI 编码代理用的持久记忆引擎,自动捕获每次工具调用,压缩成结构化记忆,下次会话自动注入正确上下文。零外部依赖,自托管,数据在你手里。
工作流是一条管线:你在 Claude Code 里干活,PostToolUse 钩子触发 -> SHA-256 去重(5 分钟窗口) -> 隐私过滤(剥离密钥和 API key) -> 存储原始观察 -> LLM 压缩成结构化事实 + 概念 + 叙述 -> 向量嵌入 -> 在 BM25 和向量索引中建索引。会话结束时做摘要。下次会话开始时,SessionStart 钩子加载项目档案,混合搜索(BM25 + 向量 + 知识图谱),按 token 预算渲染上下文,注入对话。
举个具体场景。会话 1:你说"给 API 加认证",代理写代码、跑测试、修 bug,agentmemory 在后台静默捕获每次工具调用,会话结束后压缩成结构化记忆。会话 2:你说"现在加速率限制",代理已经知道——认证用的是 JWT 中间件在 src/middleware/auth.ts,测试在 test/auth.test.ts 覆盖了 token 验证,你为 Edge 兼容性选了 jose 而非 jsonwebtoken。不用你重复解释一遍。
几个让人"哇"的设计细节
一、零外部依赖,三个原语替代整个传统技术栈
同类记忆系统大多要 Postgres + pgvector,或者 Qdrant、Redis。agentmemory 啥都不要——SQLite 加 iii-engine 引擎就够了。iii-engine 的设计哲学是三个原语组合一切:worker、function、trigger。Express.js 被 iii HTTP Triggers 替代,Postgres 被 iii KV State 替代,Socket.io 被 iii Streams 替代,pm2/systemd 被 engine worker 监督替代,Prometheus/Grafana 被 iii OTEL 替代。175 个源文件、39,200 行代码、261 个函数、52 个 KV scope——全部基于这三个原语。想扩展?一条命令 iii worker add iii-pubsub 就能加上多实例记忆同步。
二、12 个钩子全自动,零手动操作
大部分记忆库你得手动调 memory.add() 存东西。agentmemory 不一样——Claude Code 支持 12 个生命周期钩子,从 SessionStart 到 SessionEnd,PreToolUse、PostToolUse、PostToolUseFailure、PreCompact、SubagentStart/Stop、Stop、SessionEnd,全程静默捕获。你不需要做任何特殊操作,正常用代理就行。Codex CLI 支持 6 个钩子,OpenCode 支持 22 个。用户提示也会被捕获(经过隐私过滤后存储)。
三、三流混合检索,95.2% 召回率 检索不是单一手段。BM25 做词干关键词匹配加同义词扩展,始终开启;向量做密集嵌入的余弦相似度;知识图谱在查询中检测到实体时做 BFS 遍历。三个流用 Reciprocal Rank Fusion(k=60)融合,会话多样化——每会话最多 3 个结果。LongMemEval 基准测试上 R@5 达到 95.2%,R@10 达到 98.6%,MRR 88.2%。作为对比,纯 BM25 fallback 的 R@5 只有 86.2%。在内部 coding-agent-life-v1 语料库上,混合检索的 R@5 达到 1.000——15 个查询全部命中黄金会话,而 grep 在多会话时间查询中漏掉了一半。
四、四层记忆整合,灵感来自人脑 不是所有记忆都一样重要。agentmemory 把记忆分四层:工作记忆(工具使用的原始观察,类比短期记忆)、情景记忆(压缩的会话摘要,"发生了什么")、语义记忆(提取的事实和模式,"我知道什么")、程序记忆(工作流和决策模式,"如何做")。记忆随时间衰减——按艾宾浩斯曲线,频繁访问的记忆增强,过时的自动淘汰,矛盾的会被检测和解决。这个设计灵感来自 Karpathy 的 LLM Wiki 模式,作者加了置信度评分、生命周期管理、知识图谱和混合搜索。设计文档以 Gist 形式发布,拿了 1.3K 星和 182 个 fork。
五、竞品对比表相当硬核
README 里有一张竞品对比表,横向比较了 9 个同类项目。agentmemory 的 R@5 是 95.2%(自己的测量),mem0 的 R@5 是 68.5%(LoCoMo 数据集),Letta/MemGPT 是 83.2%(LoCoMo 数据集),MemPalace 自报 ~96.6% 但未独立复现,supermemory 自报未给数据,oracleagentmemory 自报 94.4% 需 Oracle Database。作者很诚实地标注了:mem0 和 Letta 的数据来自不同数据集,不是同一个基准上的对比。其他几个是厂商自报告。自动捕获方面,agentmemory 是 12 个钩子零手动,mem0 要手动调 add(),Letta 靠代理自己编辑,Khoj 手动,supermemory 在 API 侧提取。外部依赖方面,agentmemory 是零,mem0 要 Qdrant/pgvector,Letta 要 Postgres + 向量数据库。
六、成本对比:从 500/年降到 0/年这张表值得单独拿出来说。粘贴完整上下文:19.5M+ tokens/年,超出窗口,不可能。LLM 摘要:约 650K tokens/年,约 500/年。agentmemory:约 170K tokens/年,约 10/年。agentmemory 加本地嵌入(all-MiniLM-L6-v2):约 170K tokens/年,0/年。为什么能这么便宜?因为压缩和摘要是短任务——小于 2K 输入、小于 500 输出,7B 指令模型就够用。作者推荐用 DeepSeek V4 Pro 做压缩,35 小时活跃使用成本约 0.46,是 Sonnet 的十分之一。高端模型留给用户直接阅读的查询。
技术栈速查
维度 | agentmemory | mem0 (58K Star) | Letta/MemGPT (23K) |
|---|---|---|---|
检索 R@5 | 95.2% | 68.5% | 83.2% |
自动捕获 | 12 钩子零手动 | 手动 add() | 代理自编辑 |
搜索方式 | BM25+向量+图谱 | 向量+图谱 | 向量归档 |
外部依赖 | 零(SQLite+iii) | Qdrant/pgvector | Postgres+向量库 |
框架锁定 | 无(任何 MCP 客户端) | 无 | 高(必须用 Letta) |
自托管 | 是(默认) | 可选 | 可选 |
注:agentmemory 的 R@5 为自有测量结果;mem0 和 Letta 的数据来自各自发布的 LoCoMo 数据集,非同一基准。
快速上手
前提:Node.js >= 20。支持 macOS、Linux、Windows。
30 秒跑通:
# 终端 1:启动记忆服务器(端口 3111)
npx @agentmemory/agentmemory
# 终端 2:种子示例数据 + 验证召回
npx @agentmemory/agentmemory demo
# 或者一条命令搞定(不用开第二个终端)
npx @agentmemory/agentmemory demo --serve
接上你的代理:
# Claude Code
agentmemory connect claude-code
# Codex CLI
agentmemory connect codex
# Cursor / Gemini CLI / Copilot CLI / Warp ... 都支持
agentmemory connect cursor
全局安装(推荐):
npm install -g @agentmemory/agentmemory
agentmemory                    # 启动
agentmemory stop               # 停止
agentmemory doctor             # 交互式诊断
agentmemory remove             # 卸载所有数据
装完之后打开 http://localhost:3113,实时查看器会显示代理记住了什么——观察流、会话浏览器、记忆浏览器、知识图谱可视化、健康仪表板,一个不少。
想省钱?本地嵌入模型 all-MiniLM-L6-v2 开箱即用,离线跑,免费。压缩用 DeepSeek V4 Pro 或本地 Ollama(qwen2.5-coder:7b 效果不错,约 4.7GB),35 小时活跃使用成本不到 1 美元。
小结
2.5 万颗星不是给一个"记忆插件"。市面上打着"AI 记忆"旗号的项目不少,但大多数要么要你手动存东西,要么绑一个外部数据库,要么是云托管数据不在你手里。agentmemory 的差异在于把"自动捕获"和"零依赖"同时做到了——12 个钩子全自动,SQLite 加 iii-engine 就跑,自托管默认开启。
95.2% 的召回率、92% 的 token 节省、$0/年的运行成本——这三个数凑在一起,说明作者不只是做了个能用的东西,而是认真做了基准测试,跟竞品拉出来比了。竞品对比表里诚实标注了"哪些是我们测的、哪些是厂商自报的、哪些是不同数据集的",这个态度比数字本身更值钱。
如果你天天用 Claude Code 或 Codex 写代码,反复给代理解释项目背景已经让你烦了,装一个试试。Apache-2.0 协议,32+ 代理平台支持,11 种语言 README。作者 rohitg00 今天还在 push 代码,v0.9.28,迭代很快。
唯一的注意点:iii-engine 当前锁定在 v0.11.2,v0.11.6 引入了新的沙盒模型,agentmemory 还没适配。如果你已经跑了别的 iii engine 实例,会冲突。等作者升级就好。
开源地址:https://github.com/rohitg00/agentmemory
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-08-15,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号