建议收藏-从知识工程到本体建模-开源一些项目供大家参考和学习

建议收藏-从知识工程到本体建模-开源一些项目供大家参考和学习
人月聊IT
发布于 2026-09-10 08:33:11
发布于 2026-09-10 08:33:11
大家好,我是人月聊IT。前面不少朋友留言,还是希望我能够开源和分享一些我AI赋能知识管理,本体建模方面的演示项目源代码。因此最近整理下这些项目进行开源发布。希望这些开源项目对大家有所帮助,也欢迎大家fork或star。
一组围绕AI赋能知识库、EA企业架构、本体建模、源代码项目逆向和 AI 原生应用构建,本体驱动智能数据分析的开源项目
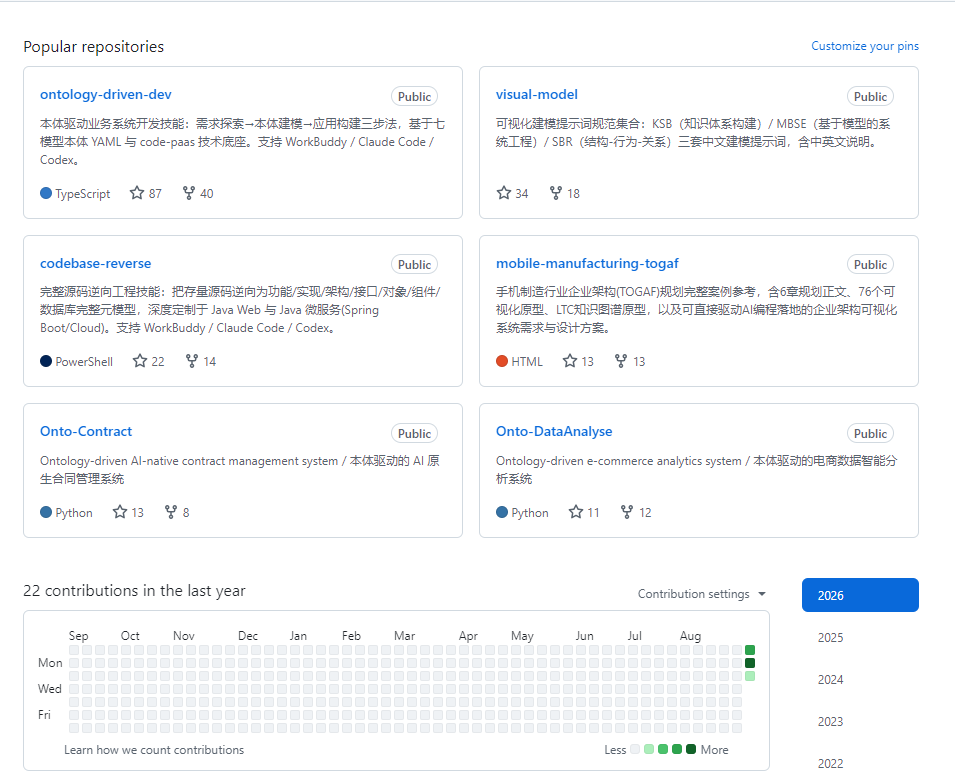
GitHub 主页:https://github.com/sharptoolbox
截至目前,sharptoolbox 公开了 9 个相互关联的项目。它们共同关注一个问题:如何把分散在需求文档、业务规则、源码、数据库、架构图和行业资料中的知识,整理成机器可以理解、人工可以审查、系统可以运行的结构化资产。
这些项目的价值并不只在于“用了大模型”。更重要的是,它们尝试建立一条完整链路:先沉淀知识,再抽取语义;先明确业务对象和规则,再建立本体;先进行源码和架构追踪,再生成应用;最后把本体真正落到数据库、页面、查询和可视化系统中。对于企业架构师、产品经理、研发团队、AI 编程实践者和知识工程研究者来说,这是一组具有连续性的实验与参考实现。
本文将逐一介绍全部公开项目,并说明每个项目的定位、核心功能、适用场景和项目地址。
一、项目全景:九个仓库组成一条演进路线
从整体上看,sharptoolbox 的项目可以分为四个层次:
- 知识资产层:
LLM-knowledgeBase负责把原始文章整理成可追溯的知识库。 - 架构与模型层:
mobile-manufacturing-togaf、Onto-Model和ontology-driven-dev分别覆盖企业架构案例、本体模型维护和本体驱动系统建设方法。 - 领域应用层:
Onto-Contract、Onto-DataAnalyse、Onto-SupplyChain是三个可运行的 AI 原生领域应用示例。 - 工程自动化层:
codebase-reverse用于从既有源码建立完整元模型,WorkBuddy-AppBuilderSkill则进一步把需求和本体转化为可安装的 WorkBuddy 领域技能。
这条路线可以概括为:
原始资料
  → 知识萃取与来源约束
  → 企业架构 / 业务对象 / 本体模型
  → 源码、数据库和实现链追踪
  → 领域应用与智能分析
  → 需求驱动的应用技能生成
二、LLM-knowledgeBase:面向大语言模型的知识库方法论
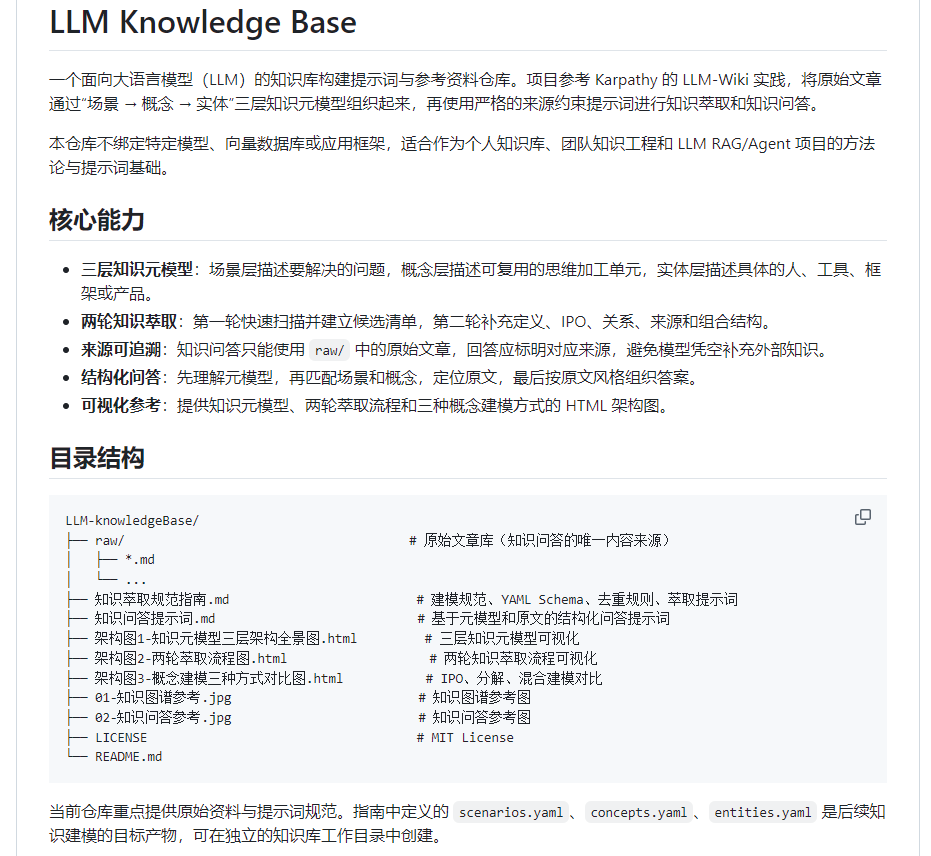
项目地址:https://github.com/sharptoolbox/LLM-knowledgeBase
LLM-knowledgeBase 是整个项目体系中的知识资产基础。它不是某一个具体的 RAG 产品,也不绑定向量数据库、模型供应商或应用框架,而是一套可以迁移到不同 LLM 工具中的知识库构建提示词、元模型和参考资料。
项目最核心的设计是“场景—概念—实体”三层知识元模型。场景回答“要解决什么问题”,概念表示可复用的思维加工单元,实体则表示具体的人、工具、框架、产品或其他可指认对象。三层结构把“问题背景”“推理方法”和“事实对象”分开,避免把文章简单切片后直接交给模型。
仓库采用两轮知识萃取流程。第一轮快速扫描原始文章,建立候选场景、概念、实体以及来源清单;第二轮再逐项补充定义、IPO(输入—处理—输出)、关系、层级和引用来源。所有问答都要求回到 raw/ 原始资料中寻找依据,并在回答中保留来源路径,从机制上降低模型凭空补充和混淆作者观点的风险。
仓库还提供知识萃取规范指南、知识问答提示词、三张离线 HTML 架构图和参考图片。使用者可以把自己的文章放入 raw/,按规范创建 scenarios.yaml、concepts.yaml 和 entities.yaml,再将问答提示词接入 OpenAI 兼容服务、本地模型或其他 Agent 平台。
这个项目适合个人知识管理、团队知识工程、企业内部知识库、RAG 原型和 Agent 工作流设计。它强调的不是“让模型知道更多”,而是让模型知道每个结论来自哪里、适用于什么场景,以及哪些内容不能被擅自推断。
三、mobile-manufacturing-togaf:手机制造行业企业架构完整案例
项目地址:
https://github.com/sharptoolbox/mobile-manufacturing-togaf
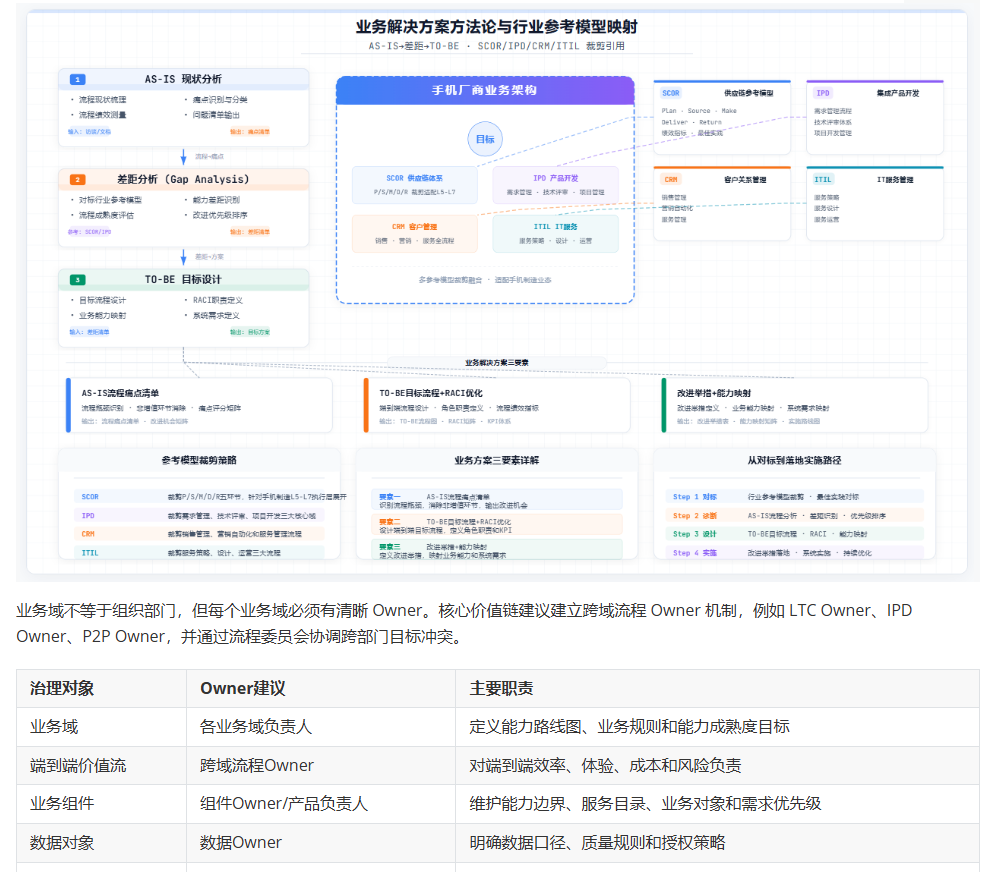
这是一个面向手机制造行业的企业架构规划案例,覆盖 TOGAF 体系中的业务架构、数据架构、应用架构和技术架构,同时补充企业战略与实施规划。仓库以手机制造企业为背景,展示如何把战略目标逐层分解为业务能力、价值流、数据对象、应用组合、技术平台和实施路线图。
项目的主线是 LTC,即从线索到回款的端到端业务流程。通过这条主线,战略、业务、数据、应用和技术不再是彼此独立的章节,而是形成了可以穿透的架构关系。内容包括 PEST 分析、战略屋、战略地图、KPI、业务能力地图、价值流、RACI、主题域、主数据、应用组合、API、微服务拆分、云平台、部署、安全容灾、迁移波次和治理机制。
仓库还包含一份“架构可视化浏览系统需求与设计方案”。这份文档不仅描述产品想法,还明确了后端技术栈、数据库表、API 分组、前端模块、页面布局和可视化库,因此可以直接作为 AI 编程的工程蓝图。仓库中的 html/ 目录提供 76 个 ECharts / D3 交互式 HTML 原型,ea-ltc-demo/ 提供可运行的 LTC 知识图谱原型,附件/ 保存了用于支撑规划的 Excel、Word 等原始资料。
它适合企业架构学习、制造业数字化转型、咨询方案编制、架构资产可视化产品设计,以及希望用 AI Coding 快速生成架构平台的团队。需要注意的是,仓库包含较多图片和 Office 附件,整体体量较大。
四、Onto-Model:本体模型可视化、编辑与校验工具
图片
项目地址:https://github.com/sharptoolbox/Onto-Model
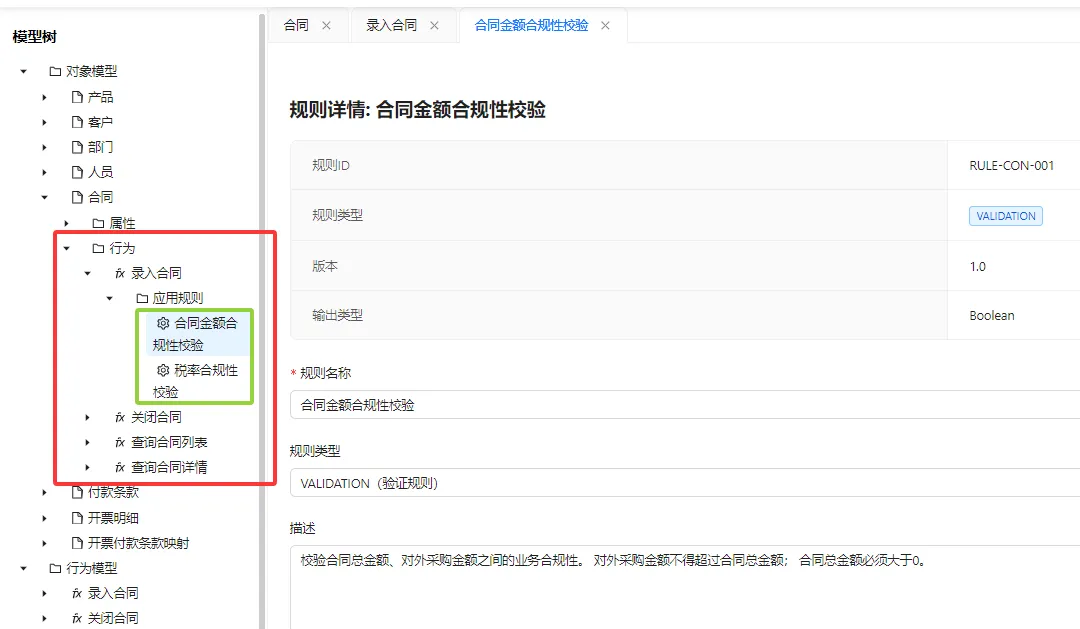
Onto-Model 是一款本地运行的本体模型维护工具。它提供 Flask + React 的 Web 编辑器,用来打开一组 YAML 本体文件,浏览模型树、查看定义与引用关系、绘制知识图谱、执行跨文件校验,并将修改保存回原有 YAML 文件。
项目支持对象、聚合、属性、关系、约束、行为、规则、事件、场景和主体等模型元素。它特别强调“定义节点”和“引用节点”的区分:一个模型元素只在定义处维护,其他文件通过 ID 引用,从而降低重复编辑和引用漂移的风险。系统还支持查找引用关系、分析删除影响、保留未知扩展字段,并在保存前执行实体 ID、行为归属、规则引用、事件链和主体权限等跨文件校验。
知识图谱使用 D3.js Canvas 绘制,支持节点分类筛选、缩放、拖拽和关系连线。后端工作区服务以 YAML 文件本身作为持久化载体,不依赖数据库或云端存储。项目内置 sample 示例模型,并提供后端 API、前端组件、架构文档和知识图谱说明。
它适合本体建模人员、领域分析师和研发团队使用,也可以作为后续领域应用生成的模型审查工具。与纯文本编辑器相比,它把模型浏览、引用分析、校验和可视化集中在一个工作区中。
五、ontology-driven-dev:需求到应用的本体驱动开发技能
图片
图片
项目地址:https://github.com/sharptoolbox/ontology-driven-dev
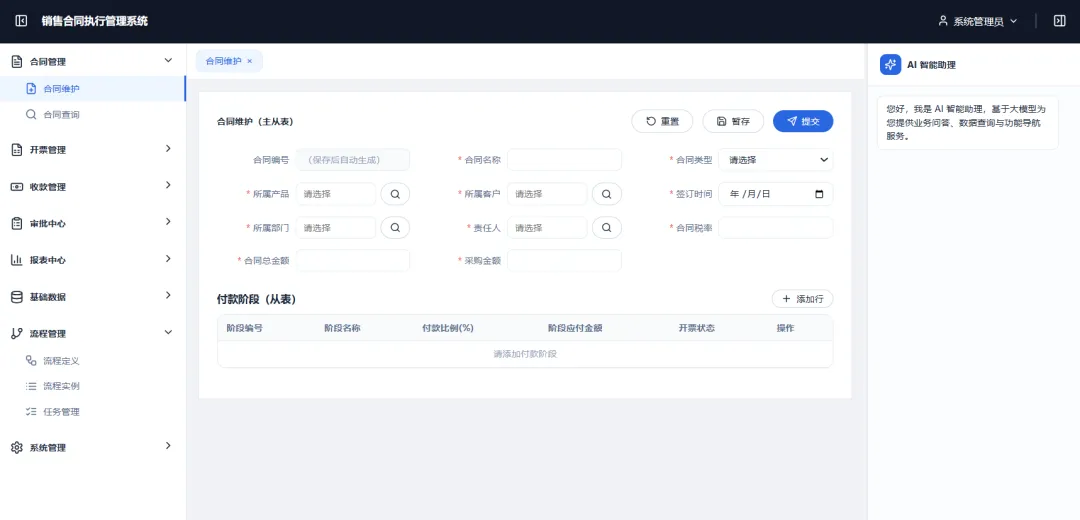
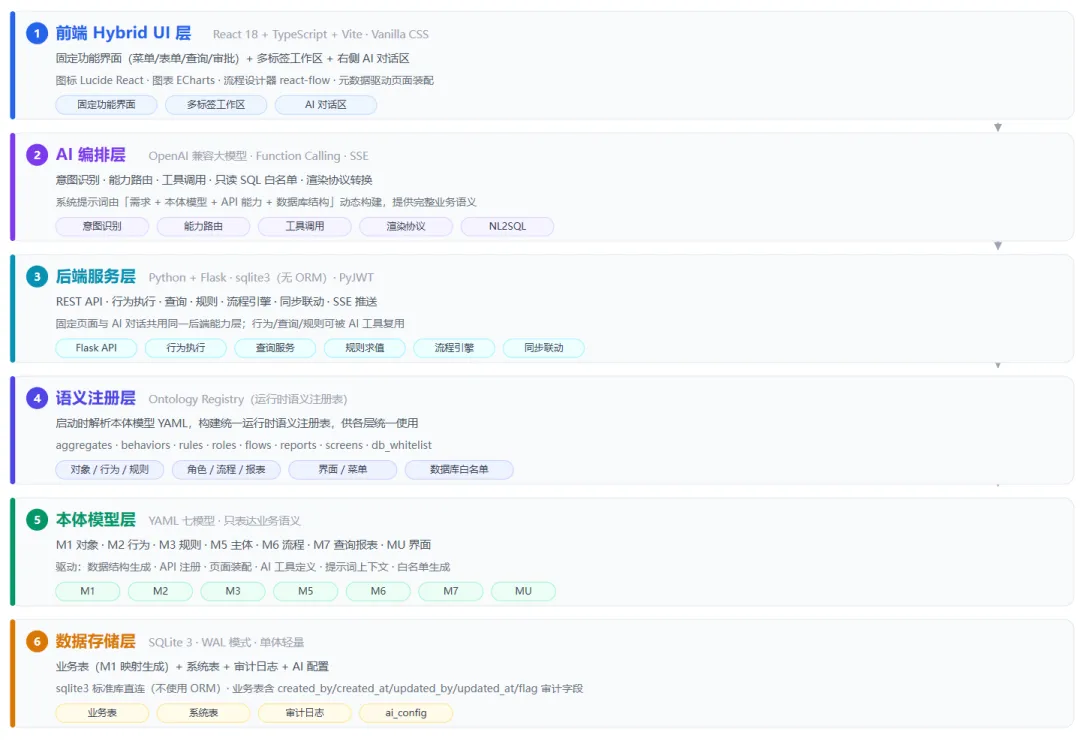
ontology-driven-dev 是一套可复用的 Agent 技能,目标是把一段业务需求转化为可运行的浏览器前后端管理系统。它采用“需求探索 → 本体建模 → 应用构建”三阶段流程,基于七模型本体 YAML,并配套一个 code-paas 技术底座。
这个项目的关键原则是模型作为语义单一来源。需求文档中的功能、本体 YAML 中的对象和规则、生成代码中的数据库表、API、菜单、权限和流程,都需要保持一致。需求探索阶段设置了不可跳过的人工确认门禁,每一阶段完成后都必须等待用户确认,防止 Agent 在业务含义尚未明确时直接生成代码。
技术底座采用 Flask、SQLite、React、TypeScript 和 Vite,内含系统管理、流程引擎、工作台和本体注册表等能力。生成的系统还设计了右侧 AI 对话区,通过本体注册表注入、工具调用、SSE 流式输出和只读 SQL 边界,为业务用户提供对话式查询入口。
该项目可以安装到 WorkBuddy、Claude Code,也可以通过 AGENTS.md、codex.md、.cursorrules 等方式接入 Codex、Cursor、Cline、Aider 等工具。它更像一套“AI 原生业务系统开发纪律”和可扩展技术底座,适合研究如何让需求、模型和代码在 Agent 生成过程中保持可追溯。
六、codebase-reverse:完整源码逆向工程技能
项目地址:https://github.com/sharptoolbox/codebase-reverse
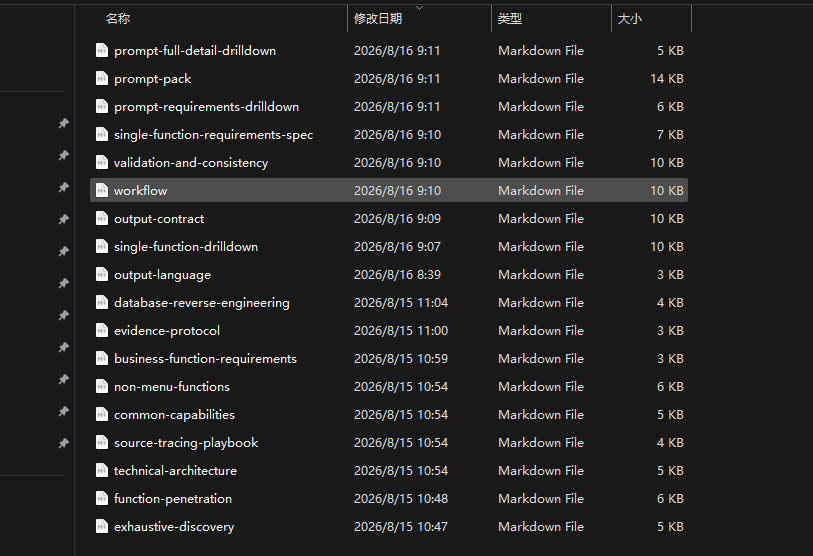
codebase-reverse 解决的是存量系统理解问题。它将一个已有源码项目逆向为完整、可追溯、可以继续钻取的项目元模型,覆盖业务功能、实现链、技术架构、接口、对象、组件、配置、数据库以及它们之间的关系。
技能默认对 Java Web、Spring Boot 和 Spring Cloud 做了深度定制,能够识别 Controller、路由、定时任务、消息监听、CDC、补偿任务、MyBatis Mapper XML、JPA、DAO、Repository 等典型资产。同时,它也支持将方法推广到 C#、TypeScript、Python、Go、PHP 和 Ruby 项目,只需按源码实际情况校准入口和命名约定。
它提供两种细粒度模式:F-FULL 对单个功能进行业务与技术实现全集深挖,把页面控件、接口、类方法、规则、对象和数据库串成主链;F-REQ 输出与具体实现无关的需求规格,只保留业务界面、功能、规则、状态、验收条件和数据库对象模型。
全量基线模式会产出源码资产台账、业务功能需求、功能链索引、数据库清单与访问矩阵、覆盖报告、一致性报告,以及逐功能的钻取文档。PowerShell 校验脚本会检查文档中登记的源码文件是否真实存在、是否有资产未被归属,并要求自动检查与人工 Pass A-O 检查共同通过。
这个项目适合遗留系统接手、系统重构、需求补齐、技术尽调、架构治理和 AI 辅助开发。它的核心价值是把“读懂源码”从一次性的个人经验,变成一套有资产清单、有证据协议、有覆盖对账和有完成门禁的方法。
七、Onto-Contract:本体驱动的 AI 原生合同管理示例
项目地址:https://github.com/sharptoolbox/Onto-Contract
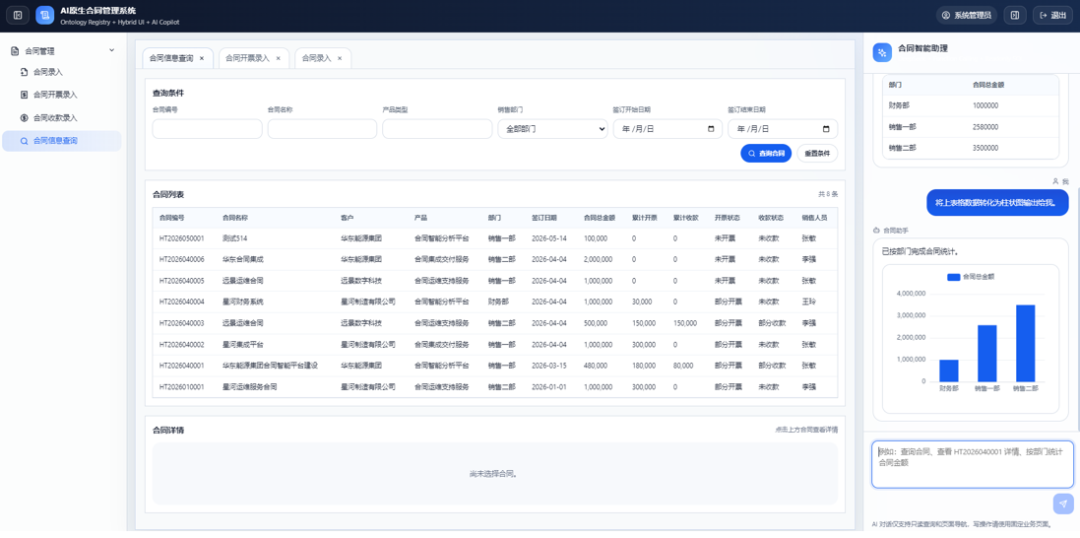
Onto-Contract 是一个可本地运行的合同管理应用示例,展示如何把合同领域的对象、行为、规则、事件、场景和 UI 元数据统一放入 YAML 本体模型,并由后端加载这些语义,为业务页面、查询接口和 AI 对话提供一致上下文。
主要功能包括合同录入、合同查询、合同详情、开票登记和收款登记。后端使用 Python、Flask、SQLite、PyYAML 和 Requests,前端使用 React、TypeScript、Vite、ECharts、Framer Motion 和 Lucide。项目提供 DeepSeek Function Calling 与 SSE 流式 AI 对话,同时对动态 SQL 施加严格只读限制,包括表白名单、字段白名单、返回行数和连接数控制。
仓库包含 SQLite 示例数据库和默认演示数据,也提供后端服务、前端应用、本体模型、技术架构文档、配置示例以及语义查询和 LLM 编排的冒烟测试。它适合作为“本体如何进入真实业务应用”的入门案例,也适合研究 AI 对话、业务查询和结构化领域上下文的结合方式。
八、Onto-DataAnalyse:本体驱动的电商数据智能分析
项目地址:https://github.com/sharptoolbox/Onto-DataAnalyse
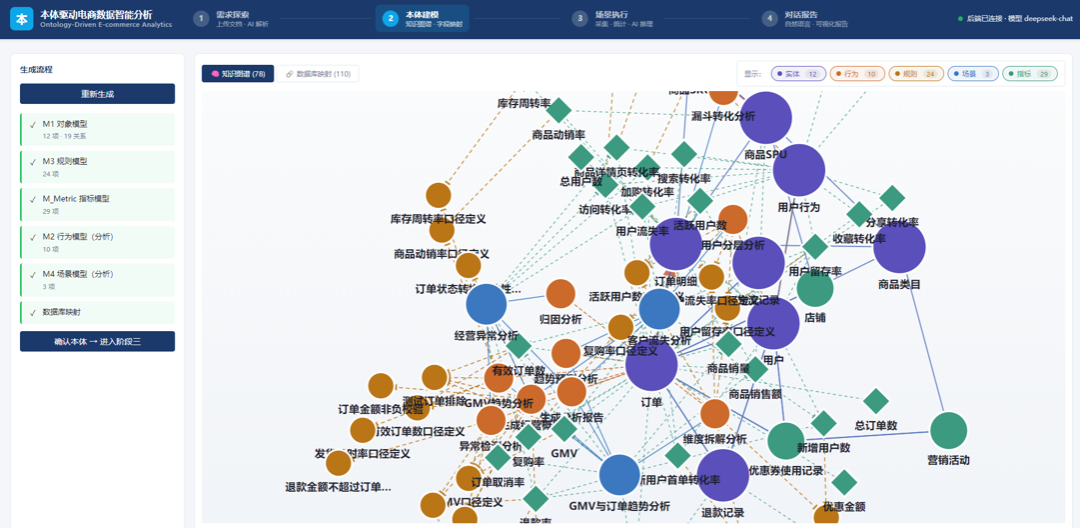
Onto-DataAnalyse 将本体方法应用到电商经营分析。它把“需求文档 + 数据库 Schema”作为输入,经过需求探索、本体建模与字段映射,执行预设分析场景,最后输出包含推理过程、图表和数据溯源的分析报告。
项目展示了本体作为业务语义中间层的完整闭环:阶段一识别分析目标、业务对象和指标;阶段二生成 M1 对象、M2 行为、M3 规则、M4 场景和指标模型,并建立本体属性到现有数据库字段的映射;阶段三执行经营异常、GMV、客户流失三个预设场景;阶段四提供自然语言对话和可视化报告。
系统不会修改业务数据库,而是通过字段级映射读取数据。SQL 层只允许只读查询,并限制关键字、返回行数和执行重试。项目使用 DeepSeek 的 OpenAI 兼容接口;当 API 不可用时,会明确报错,不伪造 AI 结果。这个边界非常适合用于演示企业如何在保留既有数据系统的前提下,引入本体和大模型分析能力。
九、Onto-SupplyChain:制造业供应链 ATP 分析与推理
项目地址:https://github.com/sharptoolbox/Onto-SupplyChain
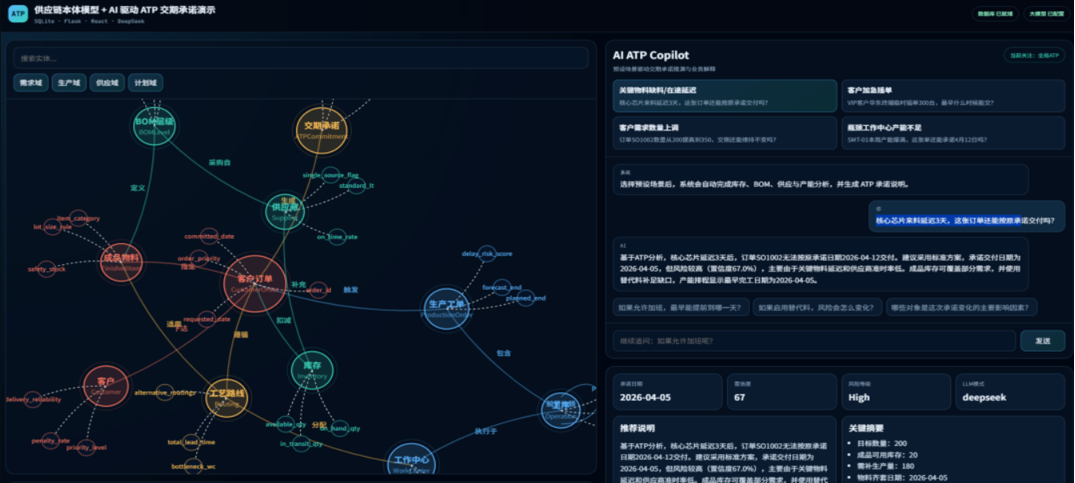
Onto-SupplyChain 面向制造业供应链场景,聚焦 ATP,即 Available to Promise,可承诺量与可承诺交期分析。项目以供应链本体作为业务语义基础,将客户订单、库存、BOM、供应商、工艺路线、生产工单、工序和工作中心等对象连接起来,通过结构化规则推理订单是否能够按期承诺。
它的核心能力包括供应链本体建模、库存覆盖分析、BOM 缺口判断、物料齐套检查、供应风险识别、产能负荷分析、订单插单和需求变更推理。系统输出承诺日期、置信度、风险等级、原因链、影响对象和备选方案,帮助使用者理解“为什么能承诺”或“为什么不能承诺”。
项目提供 D3 力导向知识图谱、四个预设演示场景和 SQLite 模拟数据库,也可以选择接入 DeepSeek 生成业务解释;未配置 API Key 时使用本地规则解释。仓库明确声明当前不是完整生产级 APS,不包含多工厂全局优化、MILP/CP-SAT 求解器或真实 SAP/MES 集成,因此更适合作为本体驱动供应链推理的可运行演示和扩展起点。
十、WorkBuddy-AppBuilderSkill:自动生成领域技能的本体驱动构建器
图片
图片
项目地址:
https://github.com/sharptoolbox/WorkBuddy-AppBuilderSkill
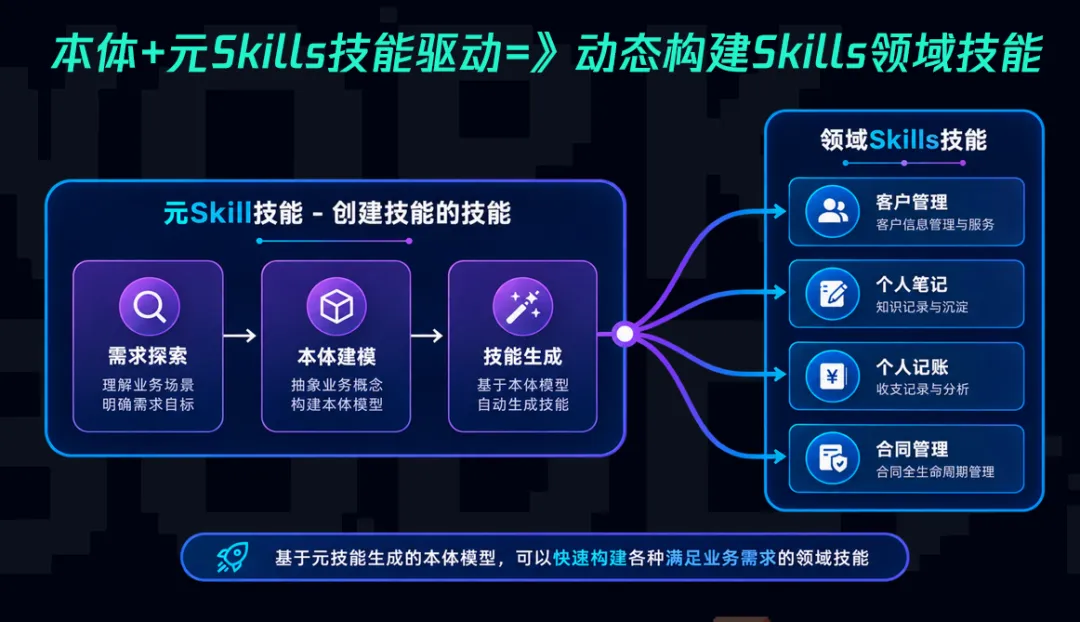
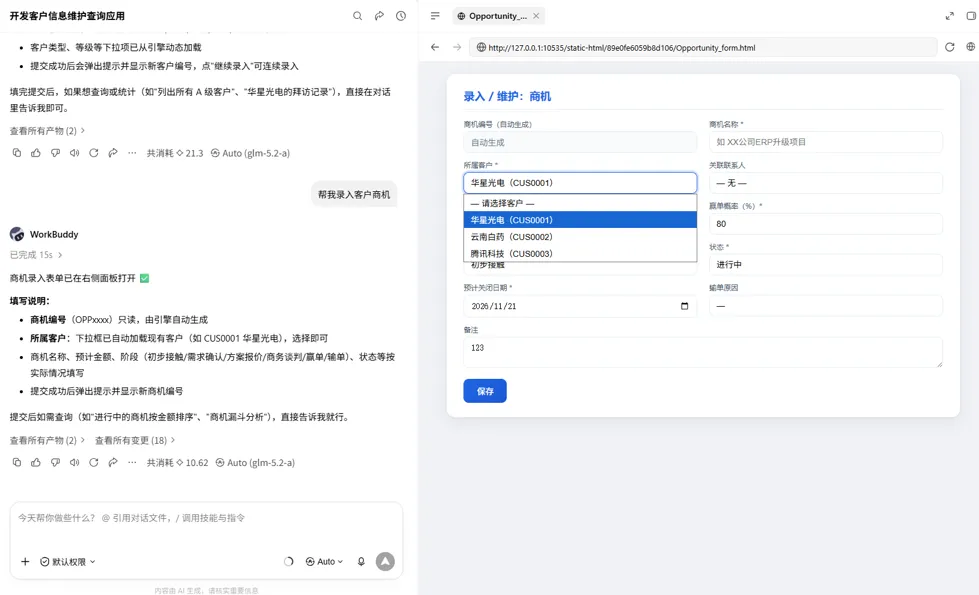
WorkBuddy-AppBuilderSkill 是目前这组项目中最偏向“生成器”的一项。它面向 WorkBuddy,把业务需求或需求文档转换为一套新的、可安装、可运行、自包含的领域技能。
它严格执行三段式流程。第一段按九个阶段进行需求探索,逐批提问并附带 AI 建议、理由和备选答案,所有结论写入带确认状态的需求文档。第二段依据本体建模规范生成 M1~M7、ME、MU、MM、MI 十一类 YAML,并转换出运行期 JSON,同时生成离线知识图谱。第三段复制运行引擎、内嵌本体、打包需求文档,为每个聚合根生成独立 HTML 录入表单,最后完成最小 CRUD、主从数据和查询自测。
生成的领域技能包含 SQLite 自动建库、REST API、对象 CRUD、数据字典和对象引用下拉框、自动编号、逻辑作废、自然语言查询和离线知识图谱。运行时只依赖 Python 标准库和 SQLite,PyYAML 只在构建期用于 YAML 转 JSON 和图谱生成。
这个项目体现了整套开源工作的最终落点:让需求探索、本体建模、数据库结构、页面录入和对话式查询形成一个可安装的交付物。它适合快速构建内部管理工具、验证领域建模方案,或者作为 WorkBuddy 技能开发的模板。
十一、项目之间的关系:一套逐步收敛的工程体系
如果把九个仓库放在一起看,可以看到几条很清晰的关系。
第一条是“资料到知识”。LLM-knowledgeBase 解决原始文章如何萃取为场景、概念和实体,并坚持来源可追溯。
第二条是“知识到模型”。Onto-Model 提供模型浏览、编辑、引用校验和知识图谱,ontology-driven-dev 则把模型进一步纳入需求、代码、数据库和 AI 对话的生成流程。
第三条是“模型到应用”。Onto-Contract、Onto-DataAnalyse 和 Onto-SupplyChain 分别在合同、电商分析和制造供应链中验证本体驱动应用的不同形态:业务管理、经营分析和规则推理。
第四条是“存量系统到模型”。codebase-reverse 从源码和数据库反向建立元模型,解决遗留系统无法被完整理解和追踪的问题。
第五条是“架构资产到可视化系统”。mobile-manufacturing-togaf 提供了一个行业级企业架构规划案例,并通过大量 HTML 原型和 AI 编程设计文档,把架构知识进一步转化为可浏览、可分析的平台。
最终,WorkBuddy-AppBuilderSkill 把需求探索、本体建模和领域技能生成串成可重复执行的工作流,成为上述方法论向自动化交付延伸的一步。
十二、适合哪些读者
- 企业架构师和数字化负责人:可重点阅读
mobile-manufacturing-togaf,理解战略、业务、数据、应用和技术之间的穿透关系。 - 领域建模和产品设计人员:可使用
Onto-Model、ontology-driven-dev和WorkBuddy-AppBuilderSkill,建立可审查、可落地的业务模型。 - 遗留系统维护和重构团队:可使用
codebase-reverse,建立源码资产、功能链和数据库之间的完整对账。 - AI 应用和 RAG 实践者:可参考
LLM-knowledgeBase的来源约束,也可研究三个 Onto 领域应用中的对话、推理和查询边界。 - 制造业和供应链团队:可从
Onto-SupplyChain的 ATP 场景入手,理解本体、规则和可解释推理如何结合。 - 希望快速做业务原型的开发者:可使用
Onto-Contract、Onto-DataAnalyse和WorkBuddy-AppBuilderSkill作为可运行参考。
十三、开源说明与使用建议
目前公开项目普遍采用 MIT License,具体以各仓库的 LICENSE 文件为准。MIT 允许使用、修改、复制、发布和商业化,但使用者仍需注意三类边界:第一,仓库中的第三方文章、图片、Office 附件和示例资料可能具有独立版权;第二,涉及 DeepSeek 或其他模型服务时,应通过环境变量或密钥管理服务注入 API Key,不要写入代码、提示词或 Git 历史;第三,本地 Demo 中的 HTTP 服务、SQLite 数据库和只读 SQL 保护不等同于生产级安全方案。
建议的阅读顺序是:先看 LLM-knowledgeBase 理解知识工程,再看 Onto-Model 理解模型维护,接着阅读 ontology-driven-dev 和 codebase-reverse 理解 AI 驱动开发与源码逆向,之后运行 Onto-Contract、Onto-DataAnalyse、Onto-SupplyChain 观察领域应用,最后使用 WorkBuddy-AppBuilderSkill 尝试从自己的需求生成新技能。若关注企业架构,则可以并行阅读 mobile-manufacturing-togaf。
结语
sharptoolbox 的这些开源项目共同表达了一种实践方向:大模型要真正进入企业软件开发,不能只依赖更长的提示词,还需要更清晰的知识结构、更严格的来源约束、更可审查的业务模型、更完整的源码追踪和更明确的人工确认机制。
从知识库到本体,从本体到应用,从应用到可解释分析,再到自动生成领域技能,这九个仓库构成了一套仍在持续演进的实验性工程体系。它们既可以单独使用,也可以组合起来,成为企业知识工程、AI Coding、领域驱动设计和本体驱动应用建设的参考底座。
欢迎访问 GitHub 主页了解全部项目,欢迎Fork和Star。
https://github.com/sharptoolbox。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-09-01,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号