大模型Skills与Toolchain深度拆解:吃透插件化工具链架构,掌握大模型函数注册原理22.4
原创
大模型Skills与Toolchain深度拆解:吃透插件化工具链架构,掌握大模型函数注册原理22.4
原创
未闻花名
发布于 2026-09-13 10:29:35
发布于 2026-09-13 10:29:35
一、前言
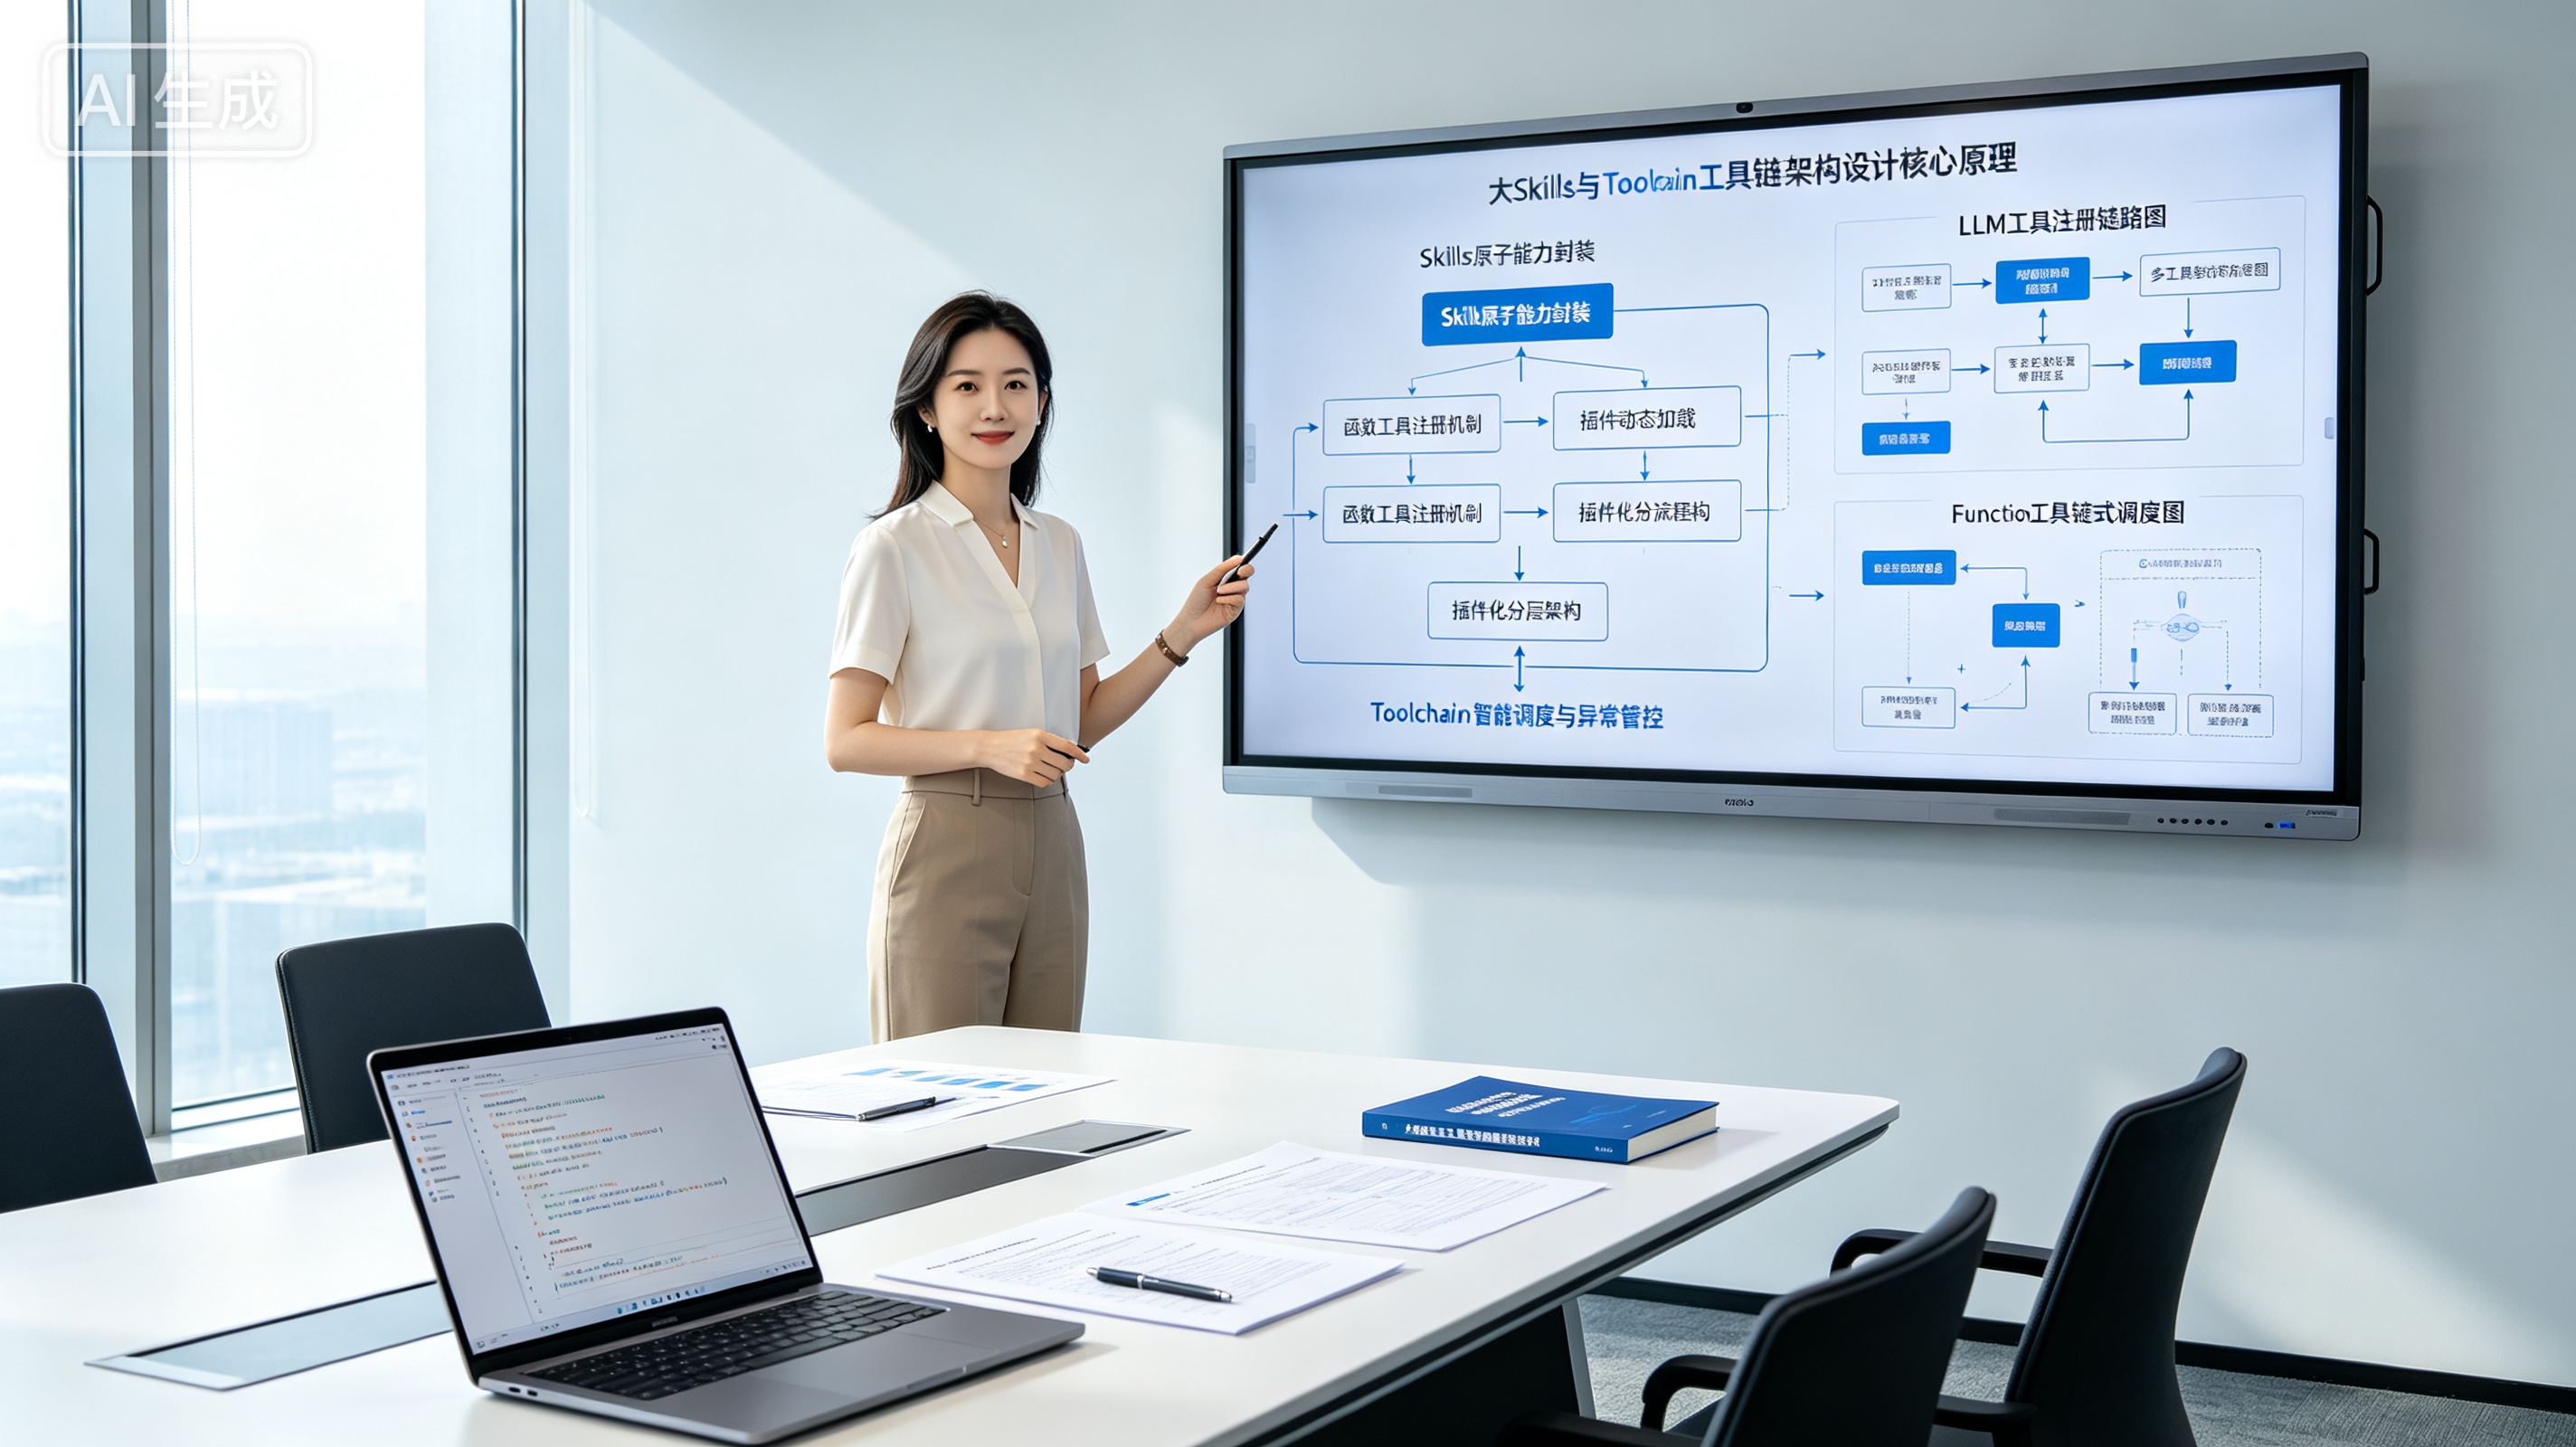
现阶段,基座大模型的文本生成、语义理解等基础能力已趋于成熟,但纯原生模型存在明显能力短板,仅能依托训练数据完成静态文本应答,无法对接外部真实场景,不具备实时查询、数据处理、接口调用等实操能力,难以满足产业落地需求。想要实现大模型从“对话演示”到“工程落地”的进阶,核心突破口就是搭建标准化的Skills原子能力 + Toolchain工具链体系。
Skills为大模型赋予各类独立、可复用的外部实操技能,补齐原生能力短板;Toolchain则承担工具注册、智能调度、参数校验、异常管控、结果闭环的全流程管控工作。依托插件化设计思想,可实现工具的动态插拔、灵活拓展,彻底解耦模型与业务逻辑。 今天我们结合工程实战经验,通俗易懂地拆解大模型Skills与Toolchain的核心原理、架构设计与落地方法。
二、核心基础认知
1. 什么是Skills能力
首先我们要搞懂最基础的问题:大模型的Skills到底是什么?通俗来讲,大模型Skills就是大模型具备的外部任务处理能力,是脱离模型原生文本生成能力之外的所有拓展技能的统称。我们可以通过分层解读,清晰理解这项核心能力:
- 原生大模型能力局限:原生大模型核心能力仅有文本生成,依靠训练权重输出内容,不具备实时信息获取、外部设备操作、数据精准计算的能力,所有输出内容都局限于训练数据集,无法执行实操类业务动作,只能被动完成问答交互。
- Skills能力核心价值:专门弥补原生大模型的能力短板,让AI从单纯的“文本问答工具”,升级为可落地、可执行的“业务处理工具”,彻底打破训练数据的场景限制。
- 常见Skills能力场景:日常使用的大模型拓展功能均属于标准化Skills,包括联网搜索、代码运行、Excel数据处理、图片生成、语音播报、第三方接口调用、数据库查询等,每一项能力独立可复用、职责单一。
合格的大模型Skills并非随意封装的功能,必须满足三大核心技术特性,也是开发落地的核心标准:
- 原子性:每个Skill都是最小独立执行单元,无需依赖其他技能即可独立完成任务。例如天气查询Skill无需依托代码运行Skill,可单独响应对应业务需求,无功能耦合。
- 可复用性:同一套Skill逻辑可多次调用、适配不同对话场景、服务不同用户请求,无需重复开发迭代,大幅降低开发成本。
- 可描述性:所有Skill的功能用途、入参出参、适用场景均可通过标准化文本定义,让大模型能够自主识别、智能判断是否需要调用该技能,实现自动化调度。
通常我们很容易混淆大模型Skills和普通业务接口,二者存在本质区别,核心差异集中在调用逻辑层面:
- 普通接口:属于被动调用模式,必须由开发者手动编写调用代码、传参触发,模型无法自主感知和使用,不具备智能化能力。
- 大模型Skills:支持模型自主感知、自主决策、自主调用,模型可根据用户自然语言需求,自动匹配、触发、执行对应技能,无需人工干预,这也是工具链设计的核心价值。
2. 什么是Toolchain工具链
搞懂了Skills,再理解Toolchain就非常简单。如果说Skills是大模型零散的“单独技能”,那Toolchain就是调度、管理、串联所有技能的完整工具流水线,是支撑所有Skill正常注册、调用、执行、回收的底层架构体系。具体可以从定位、作用、模块三个维度拆解:
2.1 核心定位
零散的Skill如同各类独立工具,无规范、无调度、无管理,无法高效落地业务。而Toolchain为所有工具建立标准化管理体系,解决工具注册、模型识别、调用时机、异常处理、多工具串联的全流程问题。
2.2 核心基础模块
- 工具注册模块:核心负责自定义函数、第三方接口、插件能力的系统录入,让大模型实时感知新增技能,是工具接入的唯一入口。
- 工具解析模块:负责解析用户自然语言需求,精准匹配对应工具并提取、校验所需参数,实现语义到工具指令的转化。
- 调度执行模块:管控工具调用全流程,处理同步、异步执行逻辑,控制调用顺序和频次,保障任务有序执行。
- 结果回传模块:清洗、整理工具原始执行结果,标准化后反馈给大模型,为模型生成最终答案提供数据支撑。
- 异常管控模块:统一处理参数错误、调用超时、接口报错、权限不足等各类异常,保障系统稳定运行。
2.3 核心设计目标
- 解耦:实现大模型本体与外部工具完全分离,模型仅负责需求理解与调用决策,工具仅负责任务执行,互不干扰、各司其职。
- 灵活拓展:支持无限制新增、删除、更新工具,无需修改大模型底层权重,实现能力快速迭代。
2.4 应用场景举例
当用户提出“查今天北京天气,生成天气简报”需求时,Toolchain会完成全套自动化流程:

解析需求→匹配天气查询工具→调用工具获取实时数据→回传数据至模型→模型整合数据生成简报,全程无需人工介入。
3. Skills与Toolchain关系
在大模型外部能力拓展体系中,Skills与Toolchain是相辅相成、缺一不可的绑定关系,二者分工明确、层级清晰,共同构成完整的大模型工具赋能体系:
核心定位互补:
- Skills是可执行的原子能力本体,是大模型各类实操技能的内容与能力载体,解决“AI能做什么”的问题;
- Toolchain是管控、承载、运行所有Skills的工程平台与流水线体系,解决“AI怎么智能、稳定、规模化地做”的问题。
依存共生关系:二者相互依托、缺一不可。
- 没有Skills,Toolchain只是无实际业务能力的空架构,无法落地任何实操任务;
- 没有Toolchain,零散的Skills只能作为普通接口被动调用,无法被大模型智能识别、自主调度、自动化执行,彻底丧失AI工具化的核心价值。
落地运行依托:
- 所有标准化Skills的落地运行,全程依赖Toolchain体系支撑。
- 依托Toolchain的注册模块完成技能系统录入,借助解析、调度、校验、执行、回传全链路能力,实现技能的自动化调用与闭环运行;
- 同时依托插件化架构实现Skills的动态插拔、迭代拓展。
最终赋能效果:
- 二者深度配合,彻底打破原生大模型仅能文本生成的局限,让静态的模型文本能力,升级为具备主动实操、外部联动、业务落地能力的智能化AI体系,是大模型工程化赋能的核心基础。
4. 插件化核心优势
在Skills和Toolchain体系中,插件化是核心设计思想,也是企业级大模型落地的关键技术。所谓能力插件化,就是将所有外部工具、自定义技能,封装为独立插件单元,支持即插即用、动态加载、按需启用。我们可以通过新旧方案对比,直观体现其核心优势:
1. 传统能力拓展方案弊端
传统开发采用硬编码模式,需要新增功能就直接修改模型核心服务代码,存在明显短板:每次迭代功能都需改动底层代码、重启服务,开发效率极低,极易引发系统bug,稳定性差,无法适配业务快速迭代场景。
2. 插件化设计四大核心优势
- 低侵入性:所有插件独立封装,新增、修改、删除插件无需改动大模型核心代码,不影响系统原有功能,最大程度保障服务稳定性。
- 高灵活性:支持服务不重启前提下,动态加载、卸载、更新插件,可快速适配临时场景、专属业务需求。
- 模块化解耦:单插件对应单一技能,代码完全隔离、职责清晰,问题排查、迭代优化仅需针对单个插件,大幅降低维护成本。
- 可规模化拓展:可搭建统一插件市场,沉淀通用工具能力,支持多项目、多场景复用,适配个人开发与企业私有化部署。
3. 核心逻辑总结
插件化是大模型Skills/Toolchain的最佳落地形态,函数工具注册是插件化的核心实现手段,三者相辅相成,共同构成大模型外部能力拓展的完整技术体系,是大模型工程化落地的核心关键。
三、核心技术原理
1. 函数工具注册机制
函数工具注册是整个工具链体系最基础、最核心的操作,所有插件化能力最终都依赖该机制实现。通俗来说,函数工具注册就是把自定义执行函数,按照大模型认可的标准化格式登记备案,让模型能够读懂函数功能、使用方式与参数要求,进而实现自主调用。具体核心逻辑、要素、流程如下:
1.1 函数注册的必要性
大模型仅能识别文本信息,无法直接解析代码函数、接口逻辑。必须通过标准化元数据描述,将代码逻辑转化为模型可理解的文本信息,完成登记后,模型才能感知并调用工具。
1.2 函数注册四大核心要素
- 函数基础信息:包含函数名称、唯一标识、功能简介,名称简洁直观,简介需清晰界定工具用途与适用场景,方便模型快速匹配用户需求。
- 参数结构体:明确定义入参名称、数据类型、是否必填、参数描述、取值范围,细化参数规则,避免模型传参错误。
- 返回值定义:规范函数执行成功后的返回数据格式、核心字段含义,让模型清晰知晓调用工具可获取的信息,支撑后续答案生成。
- 调用约束条件:明确适用场景、禁用场景、操作权限、超时规则,规避模型滥用、误调用工具的问题。
1.3 标准化注册三步流程
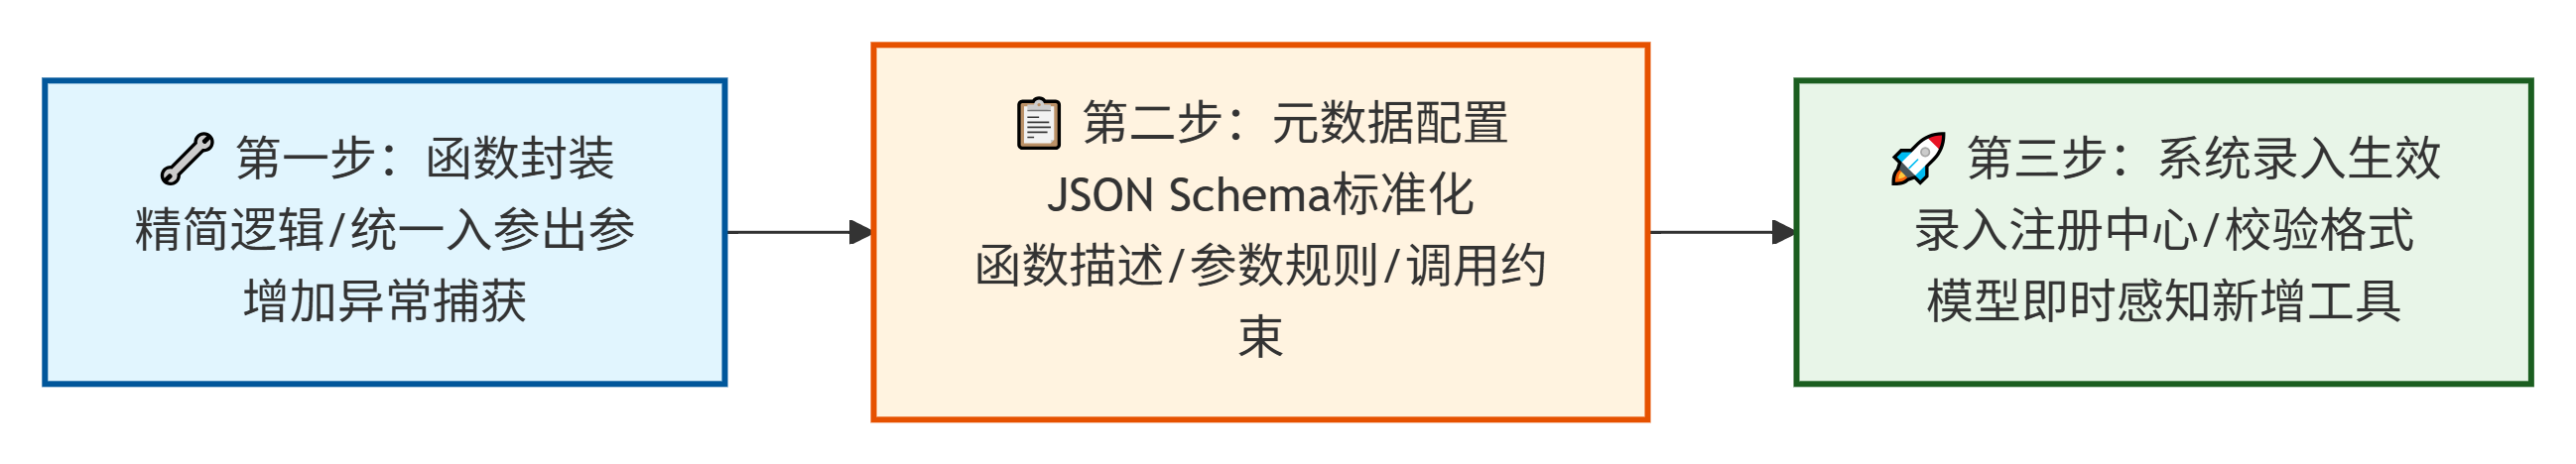
- 第一步:函数封装:对Python、Java等原生函数进行精简,去除冗余逻辑,保留核心执行功能,统一入参出参格式,增加基础异常捕获。
- 第二步:元数据配置:遵循JSON Schema标准,填写函数描述、参数规则、调用约束等信息,生成模型可识别的标准化配置文件。
- 第三步:系统录入生效:将配置文件与函数执行入口录入工具链注册中心,系统自动校验格式,校验通过后实时生效,模型可即时感知新增工具。
1.4 函数注册核心要点
- 函数注册的核心不是代码上传,而是让模型精准理解工具。
- 参数描述模糊、场景界定混乱,会直接导致模型不调用、误调用、重复调用工具。
- 例如仅标注“城市:必填”会引发调用失败,需细化为“城市:字符串,必填,需填写中文城市全称,如北京市、上海市”。
2. 插件化分层架构拆解
函数注册是插件化的基础,而完整的插件化能力是一套分层、标准化的成熟体系,并非单一功能封装。所有大模型插件均遵循四层分层架构,从底层执行到上层应用层层联动、各司其职,具体拆解:
2.1 插件执行层(底层核心)
- 作为最底层的执行单元,包含所有注册的自定义函数、第三方API接口、本地脚本工具。
- 该层级仅负责纯粹的任务执行,不参与需求理解、逻辑判断,接收标准化参数后直接执行任务,并返回原始执行结果。
- 例如代码运行插件仅负责接收、运行代码、返回结果,无需理解业务需求。
2.2 插件适配层(核心衔接)
- 是插件化设计的关键层级,主要解决异构工具统一适配问题。
- 各类工具来源杂乱,本地函数、第三方接口、企业内部系统接口的请求格式、参数规范、返回格式差异极大。
- 适配层可完成全量工具的格式统一,将异构工具的输入输出标准化为大模型工具链通用格式,实现“多工具归一化”。
2.3 插件调度层(中枢大脑)
负责插件全生命周期管理与智能调度,是串联多工具、处理复杂任务的核心。核心能力包含:
- 插件动态管理:支持插件加载、卸载、启用、禁用、权限管控、优先级配置;
- 多工具链式调度:针对复杂需求,自动拆解任务、排序调用顺序、分步执行流水线作业;
- 自主调度决策:无需人工干预,根据用户需求自动匹配最优工具组合。
2.4 插件应用层(业务入口)
- 面向用户与业务的展示配置层,核心职责为插件场景绑定、权限配置、结果展示、异常提示。
- 普通用户使用插件功能、开发者配置插件规则、业务场景绑定工具组合,均在该层级完成,是插件能力落地业务的最终载体。
2.5 插件化两大设计原则
- 单一职责原则:一个插件仅实现一类核心能力,不堆砌冗余功能,保证插件轻量化、高可用、易维护。
- 开闭原则:对能力拓展开放,对原有代码修改关闭,新增业务能力通过新增插件实现,不改动原有插件代码,保障系统稳定。
3. 工具注册详细流程
结合理论原理,我们以“实时天气查询工具”为例,落地完整的函数工具注册实战流程,步骤清晰、可直接复用,从零实现插件注册与模型自动调用:
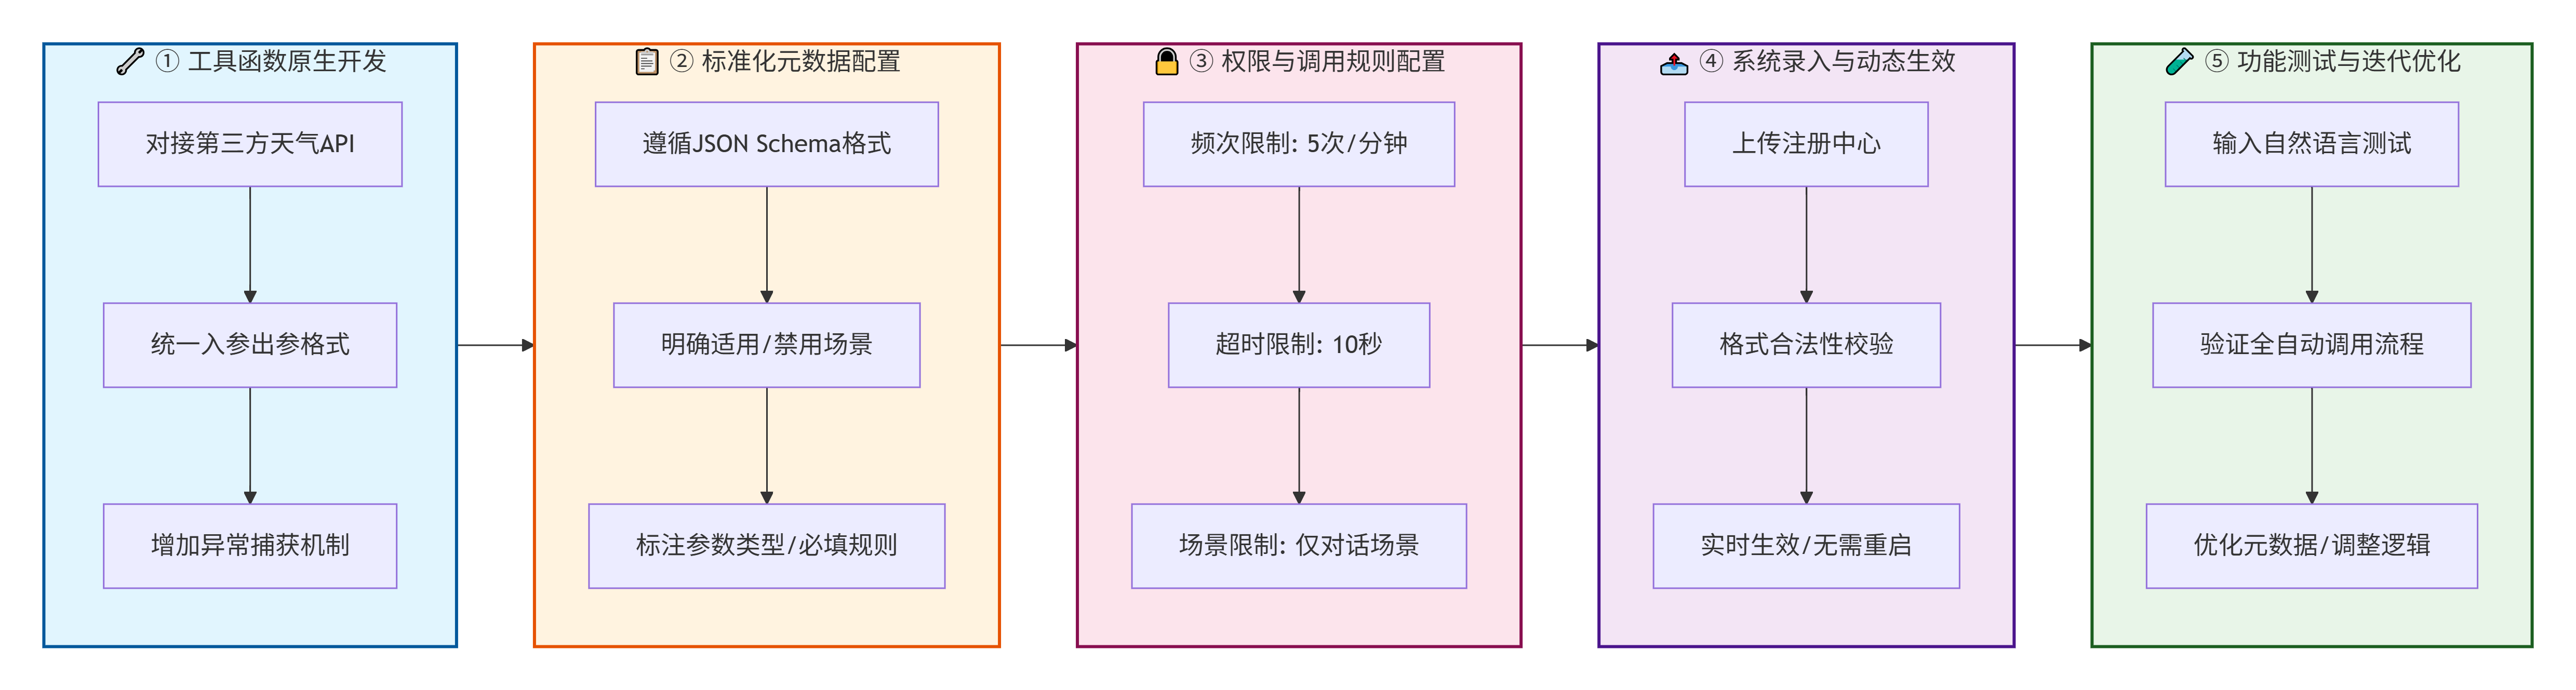
第一步:工具函数原生开发
- 核心目标:对接第三方天气API,实现指定城市实时天气查询功能;
- 开发规范:遵循轻量化原则,仅保留核心查询逻辑,统一入参出参格式;
- 容错处理:增加异常捕获机制,避免单函数报错导致整体工具链崩溃;
- 字段设计:入参仅保留必填的“城市名称”,出参包含温度、天气状况、风力、更新时间等核心有效字段。
第二步:标准化元数据配置
- 配置规范:严格遵循JSON Schema格式,是模型识别工具的唯一依据;
- 场景界定:明确标注适用场景(国内城市实时天气查询)、禁用场景(历史天气、海外城市查询);
- 参数细化:标注参数类型、必填规则、输入示例,杜绝模糊描述;
- 结果说明:清晰定义返回字段含义,方便模型解析数据、生成回答。
第三步:工具权限与调用规则配置
为避免接口滥用、服务异常,需提前配置约束规则:
- 频次限制:设置单用户每分钟最多调用5次;
- 超时限制:统一超时时间10秒,避免接口阻塞;
- 场景限制:仅支持对话场景调用,禁止批量调用、后台静默调用。
第四步:系统录入与动态生效
- 将开发完成的函数代码与标准化配置文件,上传录入工具链注册中心;
- 系统自动完成格式合法性校验,校验通过后工具状态更新为“已启用”;
- 无需重启服务,模型可实时感知新增工具能力。
第五步:功能测试与迭代优化
- 测试方式:输入自然语言需求“帮我查今天广州的天气”,验证全流程;
- 合格标准:模型自动识别工具、自主传参、成功获取数据、生成合规回答;
- 问题优化:针对调用失败、参数错误、回答不准等问题,优先优化元数据描述,其次调整函数逻辑。
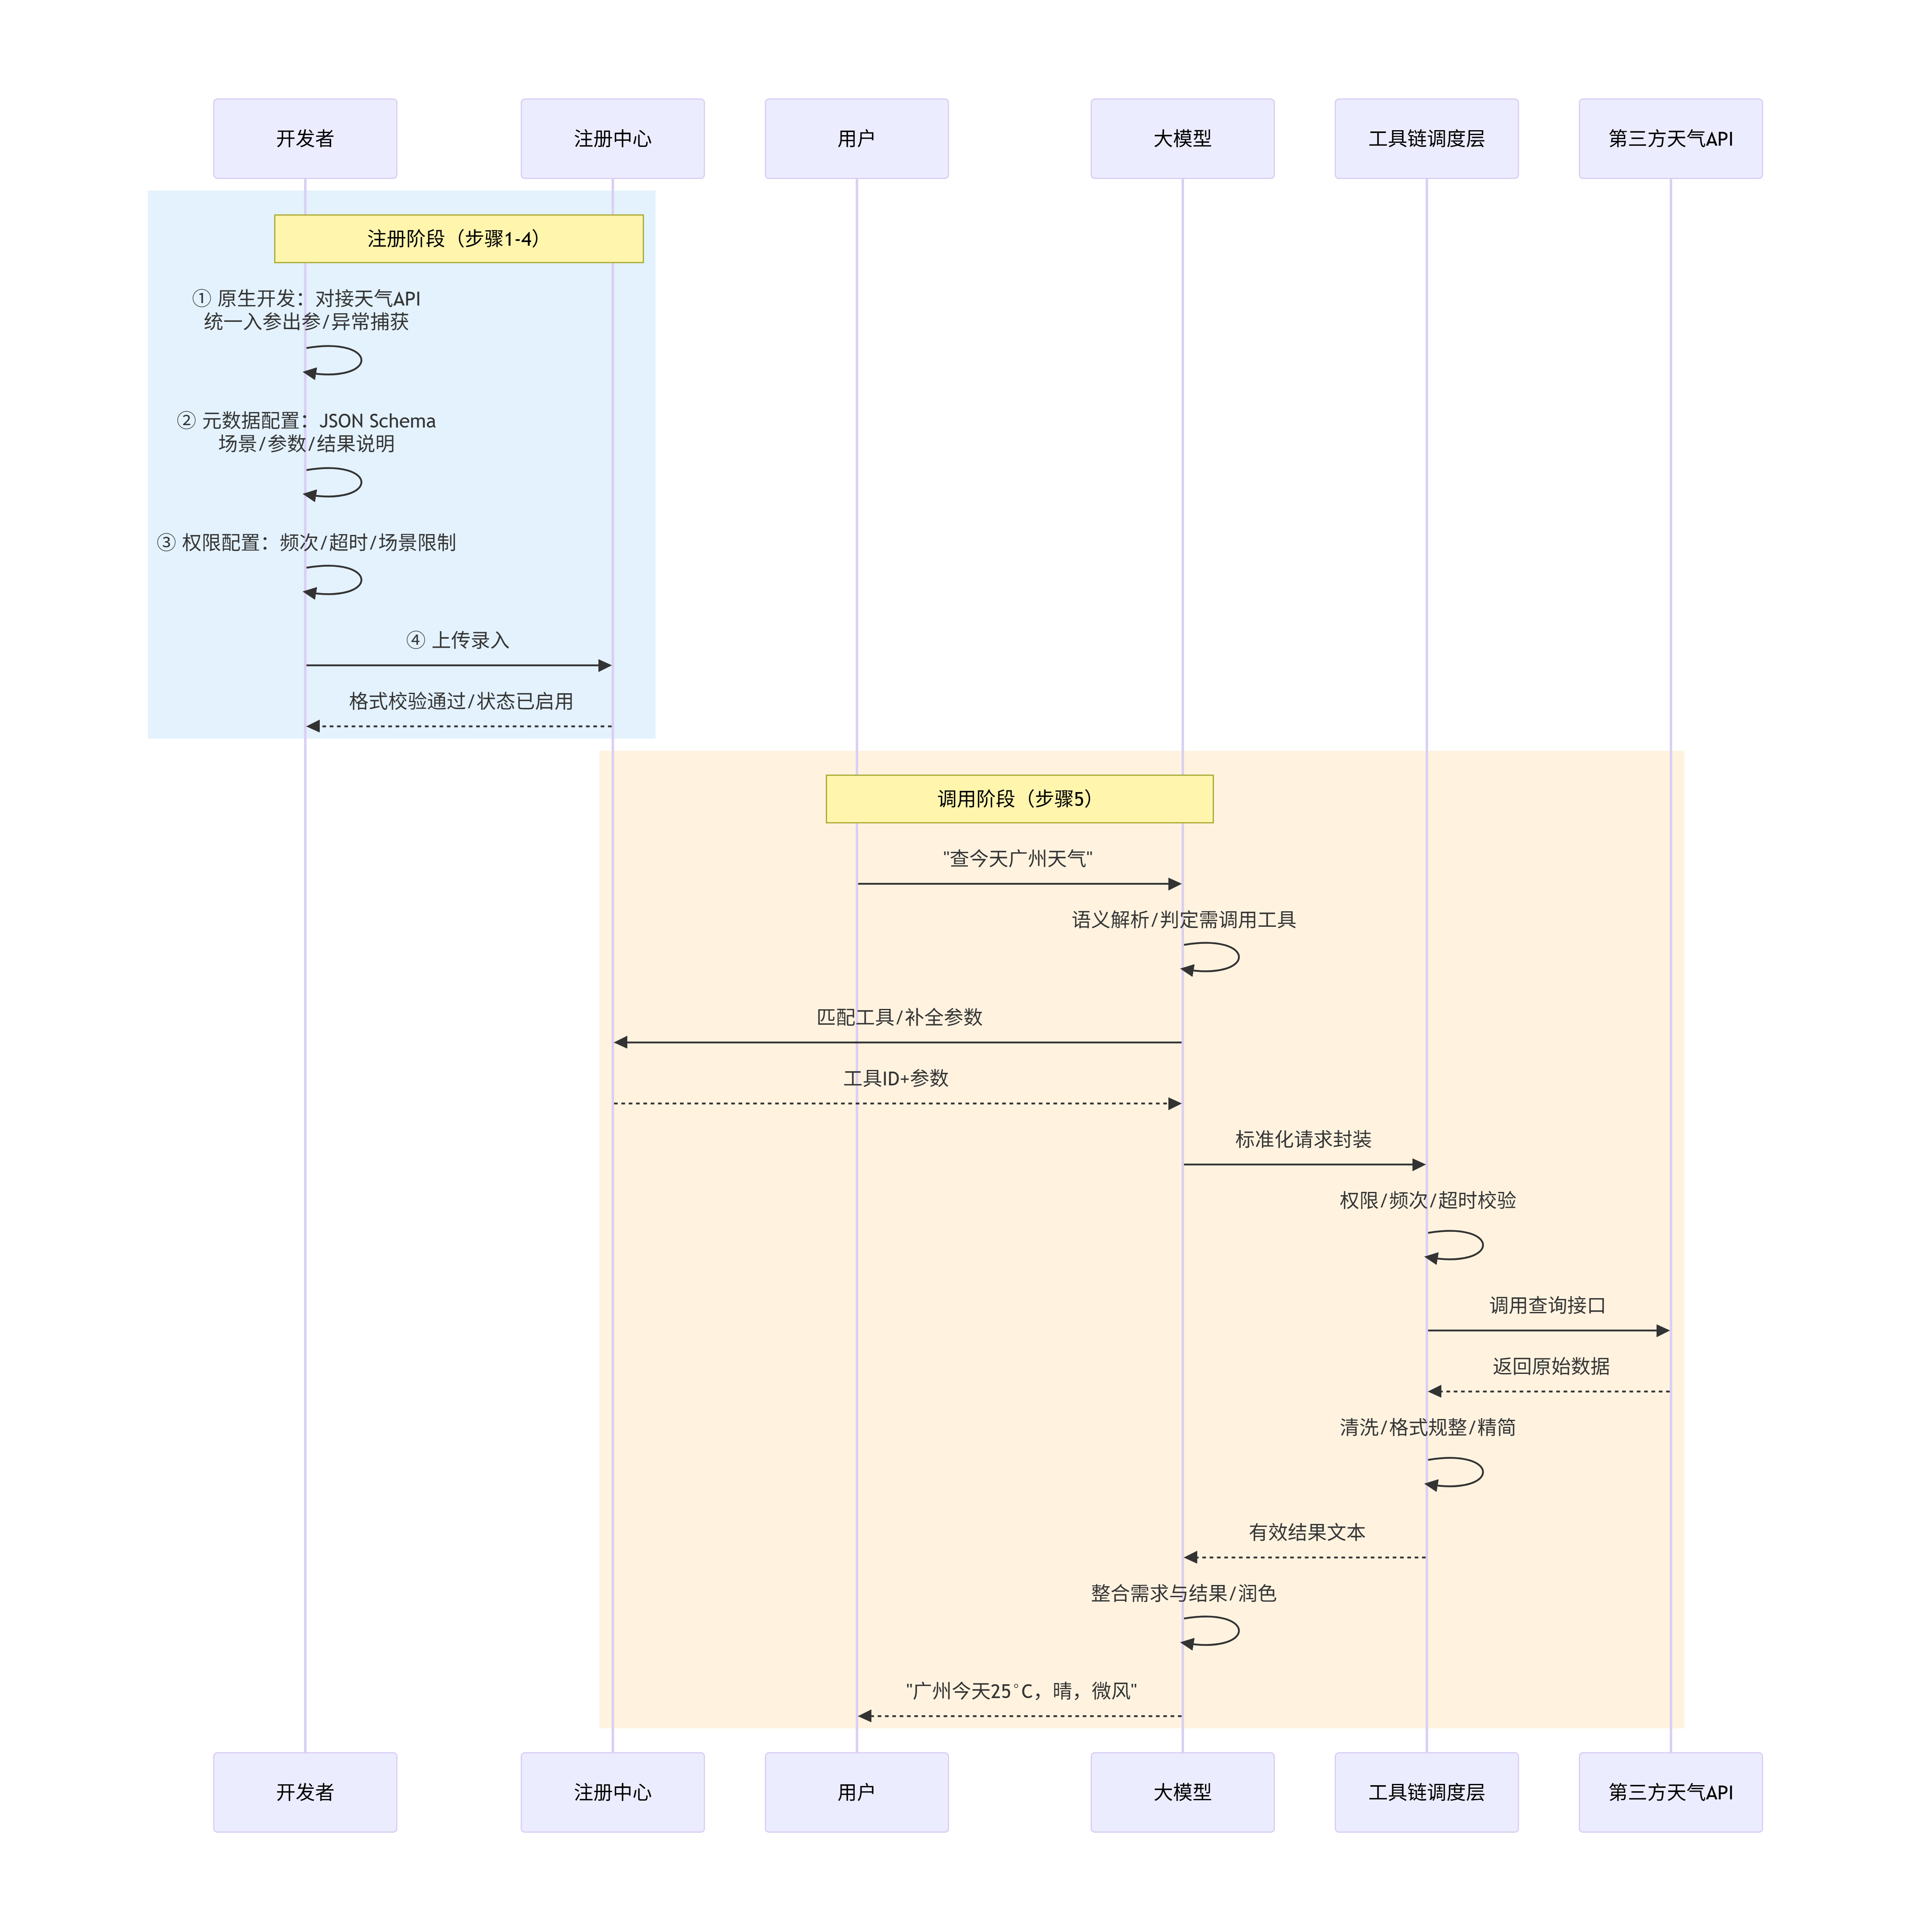
4. 工具调用完整链路
我们不仅要了解注册工具、开发插件的过程,更需要熟悉工具或插件的完整调用链路,避免调用异常时无法快速排查。下面拆解大模型工具链全闭环调用流程,从用户提问到最终答案输出,共六大标准化步骤,逻辑清晰、可追溯排查:

第一步:需求解析与工具判定
- 用户输入自然语言后,大模型先完成语义理解,结合已注册的所有工具场景描述,智能判定是否需要调用外部工具。
- 纯文本、无外部数据需求的问题直接作答;
- 需要实时数据、复杂计算、外部操作的需求,自动触发工具调用流程。
第二步:工具匹配与参数补全
- 模型根据需求语义,精准匹配对应插件工具,同时自动提取用户提问中的有效参数。
- 若出现参数缺失、参数格式错误,模型会主动反问用户补齐信息,不会直接调用失败,保障交互智能化。
第三步:标准化请求封装
- 模型将匹配的工具ID、校验完成的参数、当前调用场景,按照系统统一协议封装为标准工具调用请求,传递至工具链调度层,完成语义理解到可执行指令的转化。
第四步:插件校验与任务执行
- 调度层接收请求后,依次校验插件权限、调用频次、超时规则,校验通过后触发对应插件执行函数,完成具体业务任务,执行完毕后返回原始数据结果。
第五步:结果清洗与二次输入
- 工具返回的原始数据通常格式杂乱、存在冗余信息,工具链自动完成数据清洗、格式规整、内容精简,生成有效简洁的结果文本,重新输入大模型。
第六步:整合生成最终答案
- 大模型结合用户原始需求、工具标准化执行结果,进行语义整合、逻辑梳理、语言润色,生成通顺、精准、贴合需求的最终回答,完成全流程闭环。
全流程分工明确:
- 大模型全程负责需求理解、调用决策、答案生成;
- 工具全程负责任务执行、数据获取。
5. Toolchain架构搭建
完成单个工具注册后,可搭建企业级轻量化插件化Toolchain架构,适配多工具、多复杂业务场景。整套架构采用解耦设计,分为四大独立模块,各司其职、可拓展性极强,具体模块拆解如下:
5.1 插件管理层(统一管控中心)
作为所有插件的总管控入口,核心能力覆盖插件全生命周期管理:
- 基础管理:支持插件注册、动态加载、启用禁用、删除、版本迭代;
- 标识管理:为每一个新增插件生成唯一ID,实现工具精准区分;
- 分类归档:支持按查询类、计算类、生成类对插件分组,方便场景化调度与权限管控。
5.2 调度核心层(架构中枢)
负责智能工具调度,是处理复杂业务需求的核心,包含两大核心能力:
- 单工具智能匹配:根据用户语义需求,快速筛选最优适配工具,避免无效调用;
- 多工具链式调度:自动拆解复杂任务,按照业务逻辑排序工具调用顺序,完成流水线执行。例如“查询汇率+换算人民币”需求,可自动分步调用两个工具完成操作。
5.3 执行适配层(异构统一)
专门解决多类型工具适配难题,屏蔽底层工具差异:
- 适配范围:覆盖本地自定义函数、HTTP接口、脚本工具、数据库操作等各类工具;
- 统一协议:封装通用请求、响应适配器,让所有异构工具遵循同一套调用标准;
- 智能适配:自动完成参数校验、格式转换,大幅降低人工适配成本。
5.4 异常监控层(稳定保障)
为工具链稳定运行提供兜底保障,核心功能如下:
- 实时监控:统计插件调用状态、响应耗时、报错率,实时感知异常;
- 异常兜底:针对超时、参数错误、接口失效、权限不足等问题,配置重试、提示、兜底数据等策略;
- 日志留存:记录全量调用日志,方便问题排查、性能优化与迭代复盘。
架构核心优势:
整套架构实现完全解耦、动态拓展,后续新增任意工具能力,仅需开发对应插件并完成注册,无需修改架构核心代码,完美适配业务快速迭代,是目前主流大模型工具系统的标准架构方案。
四、应用实践分析
1. Skills与Toolchain联动示例
该示例展示了Skills与Toolchain的联动架构:将加/减法定义为独立原子Skill,通过Toolchain注册中心统一收纳,由调度引擎完成意图匹配、任务分发与结果封装,实现零散能力的智能编排调用。
from typing import Dict, Callable

# ==============================================
# 一、定义多个原子 Skills(独立、可复用、单一职责)
# 所有 Skill 只负责执行具体业务,不做任何调度逻辑
# ==============================================
def calc_add(a: float, b: float) -> Dict:
    """加法计算Skill:独立原子能力"""
    return {"code": 200, "res": a + b, "desc": "加法计算完成"}

def calc_sub(a: float, b: float) -> Dict:
    """减法计算Skill:独立原子能力"""
    return {"code": 200, "res": a - b, "desc": "减法计算完成"}

# ==============================================
# 二、Toolchain 工具注册中心(统一收纳所有Skills)
# Toolchain 负责管理、描述、收纳零散的Skill能力
# ==============================================
SKILL_TOOLCHAIN_REGISTRY = [
    {
        "skill_name": "calc_add",
        "skill_desc": "用于两个数字的加法运算,适用于数值求和场景",
        "params": {
            "a": {"type": "float", "desc": "第一个数字,必填"},
            "b": {"type": "float", "desc": "第二个数字,必填"}
        },
        "func": calc_add
    },
    {
        "skill_name": "calc_sub",
        "skill_desc": "用于两个数字的减法运算,适用于数值求差场景",
        "params": {
            "a": {"type": "float", "desc": "被减数,必填"},
            "b": {"type": "float", "desc": "减数,必填"}
        },
        "func": calc_sub
    }
]

# ==============================================
# 三、Toolchain 核心调度引擎(管控所有Skills运行)
# 负责:能力匹配、参数校验、任务执行、结果返回
# 解决零散Skill无法智能自动调用的问题
# ==============================================
class SkillToolchain:
    def __init__(self):
        # 工具链加载所有注册的原子Skill能力
        self.skill_map = {item["skill_name"]: item for item in SKILL_TOOLCHAIN_REGISTRY}

    # 智能匹配Skill
    def match_skill(self, user_query: str) -> str | None:
        if "加" in user_query or "+" in user_query:
            return "calc_add"
        elif "减" in user_query or "-" in user_query:
            return "calc_sub"
        return None

    # 统一执行入口
    def run(self, user_query: str, param: dict) -> str:
        # 1.工具链匹配技能
        skill_name = self.match_skill(user_query)
        print(f"[步骤1] 意图解析: 用户输入\"{user_query}\" → 匹配技能 \"{skill_name}\"")
        if not skill_name or skill_name not in self.skill_map:
            return "未匹配到可用的Skills能力"

        # 2.调用对应原子Skill执行任务
        skill_func: Callable = self.skill_map[skill_name]["func"]
        skill_desc = self.skill_map[skill_name]["skill_desc"]
        print(f"[步骤2] 任务调度: 调用原子Skill \"{skill_name}\"({skill_desc}),参数 {param}")
        result = skill_func(**param)

        # 3.工具链统一封装结果返回
        if result["code"] == 200:
            print(f"[步骤3] 结果封装: Skill返回 code=200,计算结果={result['res']}")
            return f"技能执行成功:{result['desc']},计算结果为:{result['res']}"
        return "技能执行失败"

# ==============================================
# 四、模拟业务调用:完整联动演示
# ==============================================
if __name__ == "__main__":
    # 初始化工具链平台
    toolchain = SkillToolchain()

    # 场景1:调用加法Skill
    print(toolchain.run("帮我计算 12.5 + 7.5", {"a": 12.5, "b": 7.5}))

    # 场景2:调用减法Skill
    print(toolchain.run("帮我计算 50 - 18.6", {"a": 50, "b": 18.6}))
重点说明:
- Skills是原子能力本体:加法、减法函数是独立、单一职责的Skill,只负责具体任务执行,无调度、无管理,对应Skills解决AI能做什么。
- Toolchain是能力承载平台:注册中心统一收纳所有零散Skills,调度引擎负责智能匹配、参数管控、统一执行,解决技能如何智能、规模化调用。
- 依存共生关系直观体现:脱离Toolchain,Skills只是普通函数,无法根据用户语义自动调用;脱离Skills,Toolchain只是空调度框架,无任何业务能力。
- 插件化拓展特性:后续新增乘法、除法Skill,只需在注册中心新增配置,无需修改Toolchain核心逻辑,完美体现解耦、可拓展特性。
运行结果:
[步骤1] 意图解析: 用户输入"帮我计算 12.5 + 7.5" → 匹配技能 "calc_add" [步骤2] 任务调度: 调用原子Skill "calc_add"(用于两个数字的加法运算,适用于数值求和场景),参数 {'a': 12.5, 'b': 7.5} [步骤3] 结果封装: Skill返回 code=200,计算结果=20.0 技能执行成功:加法计算完成,计算结果为:20.0 [步骤1] 意图解析: 用户输入"帮我计算 50 - 18.6" → 匹配技能 "calc_sub" [步骤2] 任务调度: 调用原子Skill "calc_sub"(用于两个数字的减法运算,适用于数值求差场景),参数 {'a': 50, 'b': 18.6} [步骤3] 结果封装: Skill返回 code=200,计算结果=31.4 技能执行成功:减法计算完成,计算结果为:31.4
2. 天气插件全流程示例
为贴合前文讲解的函数工具注册、插件化封装、大模型自动调用链路,本节提供一套轻量化、可直接运行的 Python 示例代码。无需复杂框架、无需额外部署,完整复刻"工具定义→标准化注册→模型解析参数→工具执行→结果回传"全流程,完美对应上文工具链核心原理与实战流程。
本次示例以实时城市天气查询插件为载体,严格遵循 JSON Schema 注册规范、插件独立封装原则,完全匹配前文工程落地标准,同时精简冗余逻辑,聚焦工具链核心运行机制。
import json
from typing import Dict, Optional, Callable

# ===================== 核心1:插件化工具实体(原子能力封装) =====================
# 模拟第三方天气API能力,独立插件、单一职责、可复用
def weather_query(city: str) -> Dict:
    """
    天气查询原子工具
    :param city: 中文城市全称
    :return: 标准化天气结果
    """
    # 模拟第三方接口返回数据
    mock_weather_data = {
        "北京市": {"temp": "26℃", "weather": "晴", "wind": "南风3级", "update_time": "2026-07-23"},
        "广州市": {"temp": "32℃", "weather": "多云", "wind": "东风2级", "update_time": "2026-07-23"},
        "上海市": {"temp": "28℃", "weather": "阴", "wind": "东北风2级", "update_time": "2026-07-23"}
    }

    if city not in mock_weather_data:
        return {"code": 400, "msg": "暂不支持该城市查询", "data": None}
    return {"code": 200, "msg": "查询成功", "data": mock_weather_data[city]}

# ===================== 核心2:函数工具注册(标准化元数据) =====================
# 严格遵循JSON Schema,让大模型可识别、可解析、可调用
TOOL_REGISTRY = [
    {
        "tool_name": "weather_query",
        "tool_desc": "用于查询国内主流城市实时天气,仅支持北京市、广州市、上海市,输入必须为中文城市全称",
        "parameters": {
            "type": "object",
            "properties": {
                "city": {
                    "type": "string",
                    "description": "查询城市,必填,仅支持:北京市、广州市、上海市",
                    "example": "北京市"
                }
            },
            "required": ["city"]
        },
        "function": weather_query  # 绑定执行函数
    }
]

# ===================== 核心3:简易工具链调度引擎 =====================
class ToolChainEngine:
    def __init__(self):
        # 加载所有注册工具
        self.tools = {tool["tool_name"]: tool for tool in TOOL_REGISTRY}

    def parse_user_query(self, user_text: str) -> Optional[Dict]:
        """
        模拟大模型语义解析:匹配工具、提取参数
        """
        # 简单语义匹配(生产环境由大模型自主解析)
        if "天气" in user_text:
            for city in ["北京市", "广州市", "上海市"]:
                if city in user_text:
                    return {
                        "call_tool": "weather_query",
                        "params": {"city": city}
                    }
        return None

    def exec_tool(self, tool_call_info: Dict) -> Dict:
        """
        执行工具调用:参数校验+函数执行
        """
        tool_name = tool_call_info["call_tool"]
        params = tool_call_info["params"]

        # 工具权限与存在性校验
        if tool_name not in self.tools:
            return {"code": 500, "msg": "工具不存在", "data": None}

        # 执行原子函数
        func: Callable = self.tools[tool_name]["function"]
        return func(**params)

    def run(self, user_query: str) -> str:
        """
        完整工具链闭环:解析-调用-结果整合
        """
        print(f"{'='*50}")
        print(f"[输入] 用户问题: \"{user_query}\"")

        # 1.需求解析与工具判定
        tool_call = self.parse_user_query(user_query)
        if not tool_call:
            print("[步骤1] 语义解析: 未命中工具 → 直接回复")
            return "无需调用工具,直接文本回答:当前问题无需外部工具查询"
        print(f"[步骤1] 语义解析: 命中工具 \"{tool_call['call_tool']}\",提取参数 {tool_call['params']}")

        # 2.工具执行
        tool_result = self.exec_tool(tool_call)
        print(f"[步骤2] 工具执行: 调用 weather_query 完成,返回 code={tool_result['code']}")

        # 3.结果清洗+模型整合回答
        if tool_result["code"] != 200:
            print(f"[步骤3] 结果整合: 查询失败 → {tool_result['msg']}")
            return f"工具查询失败:{tool_result['msg']}"

        data = tool_result["data"]
        print(f"[步骤3] 结果整合: 提取天气数据 → {data['weather']} / {data['temp']} / {data['wind']}")
        return f"【实时天气简报】\n温度:{data['temp']}\n天气状况:{data['weather']}\n风力:{data['wind']}\n更新时间:{data['update_time']}"

# ===================== 核心4:模拟业务调用 =====================
if __name__ == "__main__":
    engine = ToolChainEngine()

    # 场景1:正常天气查询
    res1 = engine.run("帮我查一下广州市今天的天气")
    print(f"[输出] {res1}\n")

    # 场景2:不支持的查询(展示工具链拒绝流程)
    res2 = engine.run("今天心情怎么样")
    print(f"[输出] {res2}\n")

    # 场景3:北京天气查询
    res3 = engine.run("北京天气如何")
    print(f"[输出] {res3}")
重点说明:
- 原子Skill插件封装:weather_query函数遵循单一职责原则,独立实现天气查询能力,无业务耦合,可单独复用、随时插拔,对应插件化核心优势。
- 标准化函数注册:通过TOOL_REGISTRY完成工具登记,包含工具描述、参数结构体、入参示例,完全贴合前文四大注册要素,是模型识别工具的核心依据。
- 轻量化Toolchain调度:ToolChainEngine复刻生产级工具链核心能力,包含语义解析、工具匹配、参数校验、任务执行、结果回传,完整复现六大调用链路。
- 异常与规范管控:内置工具合法性校验、城市参数拦截、执行结果状态码区分,对应前文异常管控、参数预校验的优化方案。
运行结果
================================================== [输入] 用户问题: "帮我查一下广州市今天的天气" [步骤1] 语义解析: 命中工具 "weather_query",提取参数 {'city': '广州市'} [步骤2] 工具执行: 调用 weather_query 完成,返回 code=200 [步骤3] 结果整合: 提取天气数据 → 多云 / 32℃ / 东风2级 [输出] 【实时天气简报】 温度:32℃ 天气状况:多云 风力:东风2级 更新时间:2026-07-23 ================================================== [输入] 用户问题: "今天心情怎么样" [步骤1] 语义解析: 未命中工具 → 直接回复 [输出] 无需调用工具,直接文本回答:当前问题无需外部工具查询 ================================================== [输入] 用户问题: "北京天气如何" [步骤1] 语义解析: 未命中工具 → 直接回复 [输出] 无需调用工具,直接文本回答:当前问题无需外部工具查询
五、Function Call与Toolchain对比
在大模型工具开发中,通常很容易混淆大模型原生Function Call和Skills/Toolchain插件化工具链,甚至认为二者完全等同。事实上,二者是“模型基础能力”与“工程落地架构”的本质差异,简单来说:
- Function Call只是工具调用的底层推理能力,是能力单元;
- Toolchain是可落地、可生产、可规模化的完整工具运维体系,是平台架构。
1. 核心定位差异
原生 Function Call:
- 属于大模型内置的底层推理能力,核心作用只有三点,解析用户语义、判断是否需要调用工具、输出标准化结构化调用参数。
- 它仅停留在“思考决策”层面,不参与工具执行、无流程管控、无工程容错,仅适用于单次工具调用场景,无法适配复杂业务。
Toolchain 插件化体系:
- 属于上层工程架构,是一套完整的工具全生命周期管理平台。
- 覆盖工具注册、动态插拔、智能调度、参数校验、异常重试、多工具编排、结果清洗、日志监控全链路;
- 弥补了原生Function Call的所有工程短板,是企业级AI应用落地的核心架构。
2. 多维度差异对比
能力范围不同:
- Function Call 仅负责语义解析与调用参数生成;
- Toolchain覆盖工具从注册、调用、执行到复盘的全流程闭环能力。
插件化支持不同:
- Function Call无插件概念,工具配置硬编码,无法热更新、动态拓展;
- Toolchain原生支持插件即插即用,无需重启服务,可快速迭代工具能力。
任务编排能力不同:
- Function Call仅支持单次单工具调用,无法拆解复杂任务;
- Toolchain支持自动任务拆分、多工具串行/并行调度,适配复杂业务场景。
工程稳定性不同:
- Function Call无超时、限流、重试、参数校验机制,极易调用失败;
- Toolchain配套完整的异常管控、容错兜底、频次限制策略,满足生产级稳定要求。
解耦程度不同:
- Function Call业务逻辑与模型请求强耦合,迭代维护成本高;
- Toolchain实现模型、工具、业务三层解耦,各司其职,便于长期维护迭代。
适用场景不同:
- Function Call适用于个人测试、简单原型开发;
- Toolchain适用于企业私有化部署、智能体开发、规模化工具生态搭建。
3. 对比总结
所有企业级大模型工具应用、智能体系统、插件市场,均是基于Function Call 能力 + 自研 Toolchain架构搭建:
- 原生Function Call是基础能力底座,决定大模型会不会识别工具;
- Toolchain插件化架构是工程赋能上层,决定工具能力能不能规模化、稳定化落地。
在生产落地中,两套体系并非对立关系,而是互补嵌套的协作模式。完整的大模型工具调用链路为:
- Toolchain 完成工具注册、配置与场景封装,将标准化工具信息传递给大模型,依托 Function Call 能力完成语义决策与参数生成;再由Toolchain 承接后续的校验、执行、容错、结果整合等工程流程。

六、总结
总的来说,Skills是大模型的拓展能力单体,插件化是能力的封装形态,函数注册是能力的录入方式,Toolchain是管控所有能力的底层架构,四者相互配合,让大模型突破原生能力限制,从文本生成模型升级为可落地、可执行、可对接业务的智能体核心。
当下大模型的竞争,早已不是模型参数、基础算力的竞争,而是工具链生态、插件能力、工程落地能力的竞争。未来大模型的工程化迭代,会持续朝着插件轻量化、调度智能化、生态标准化方向演进。掌握Skills能力封装与Toolchain工具链搭建,是从单纯调用模型API,进阶到自主搭建AI智能体、定制企业级工具生态的关键一步。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号