课前准备--两个多聚体蛋白(四级结构)如何进行分子对接
原创
课前准备--两个多聚体蛋白(四级结构)如何进行分子对接
原创
追风少年i
发布于 2026-09-14 08:48:27
发布于 2026-09-14 08:48:27
作者,Evil Genius
很多组学,大家如果选择学习,就好好学,不要流于表面,真正深入到组学的核心内容。
这一篇我们来补充一下两个多聚体蛋白(四级结构)如何进行分子对接。
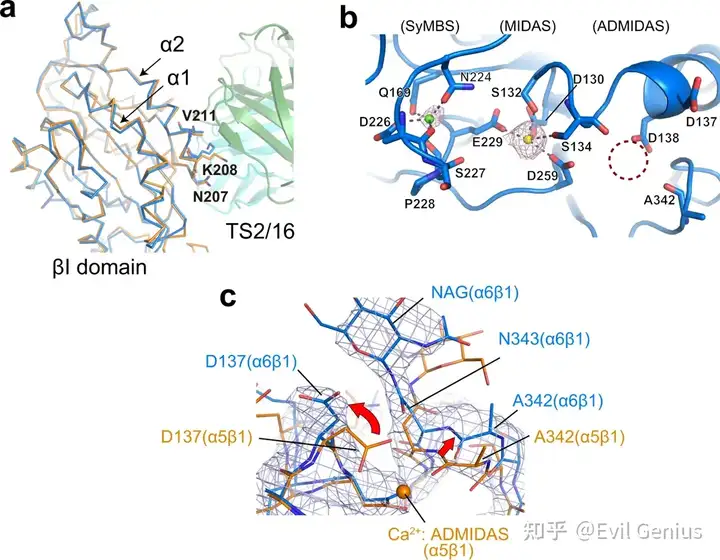
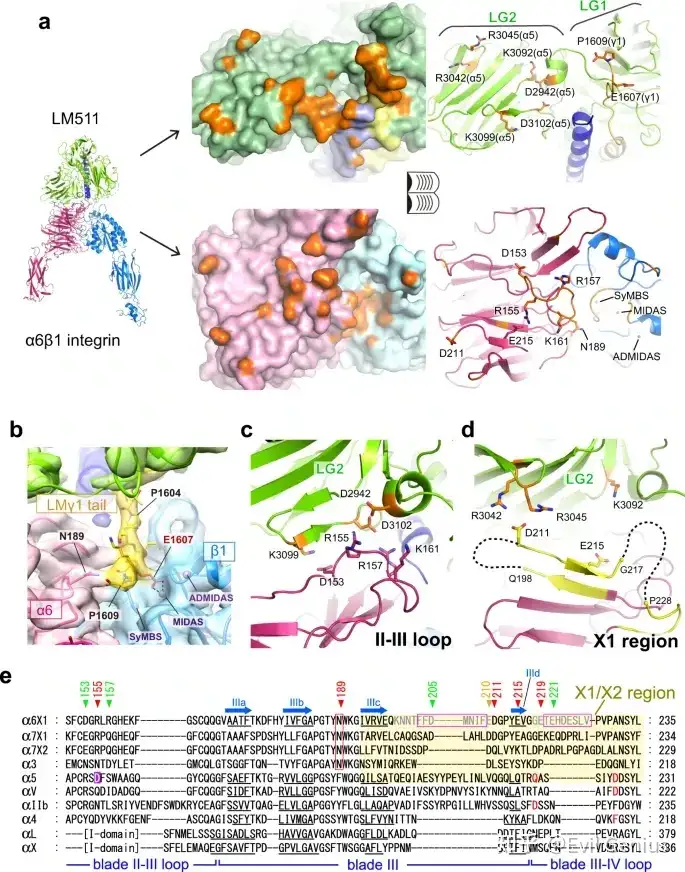
两个多聚体蛋白之间的对接,和普通“小分子–蛋白”对接完全不同。核心问题不是“配体进入口袋”,而是:
两个已经具有四级结构/多聚体结构的蛋白复合物,如何寻找它们彼此结合时最合理的界面和空间构象。
例如:
- 蛋白 A:四聚体
A1-A2-A3-A4 - 蛋白 B:二聚体
B1-B2 - 最终研究的是 A₄ + B₂ → A₄B₂
而不是把 A、B 拆成单链后简单地做一次普通蛋白-蛋白对接。
一、两个多聚体蛋白对接的总体流程
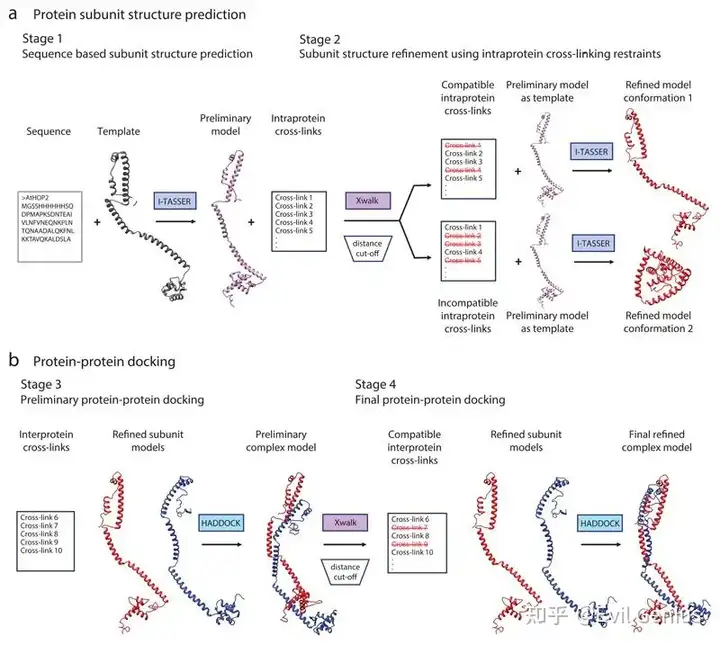
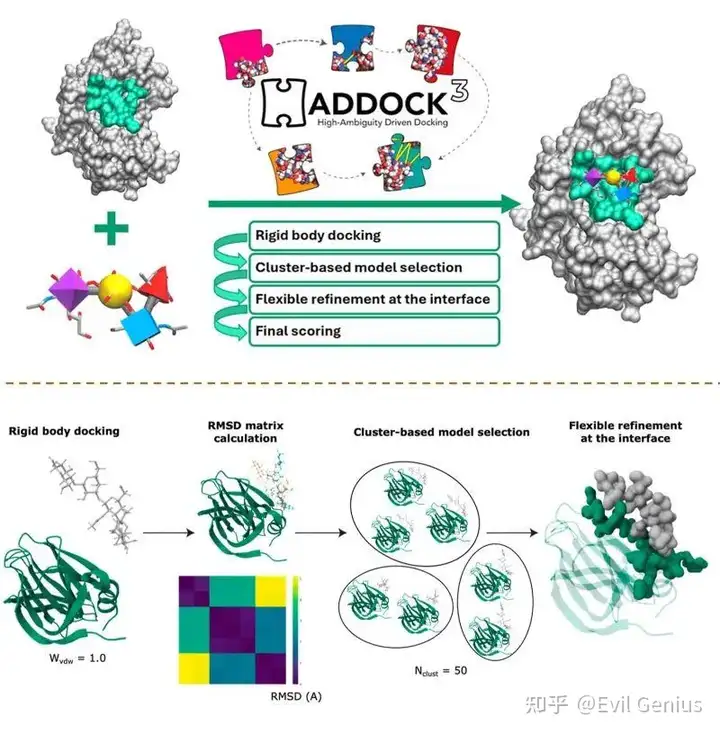
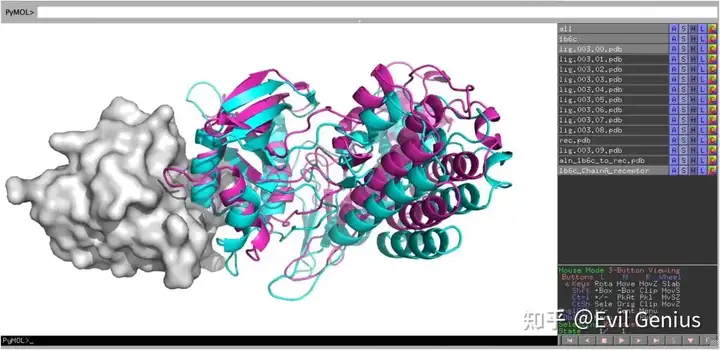
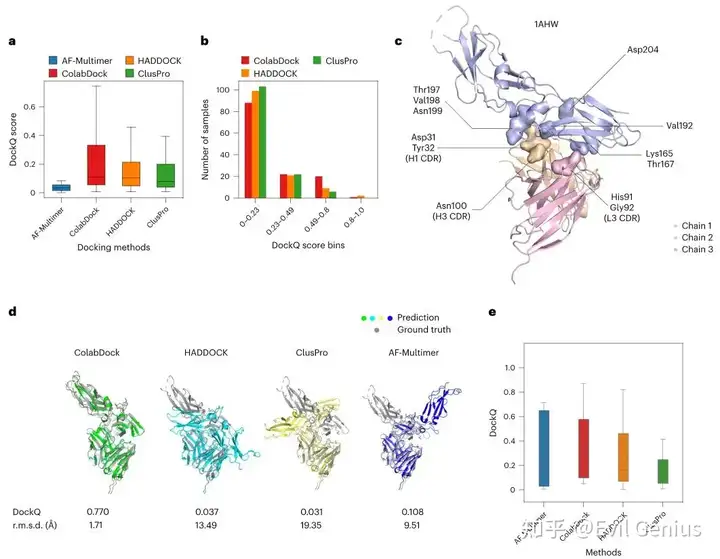
整个过程分成 7 个阶段:
多聚体蛋白A                     多聚体蛋白B
     │                                │
     ↓                                ↓
确定A的四级结构                  确定B的四级结构
     │                                │
     └──────────┬─────────────────────┘
                ↓
        结构预处理 / 质控
                ↓
        判断可能的结合界面
                ↓
       ┌────────┴────────┐
       ↓                 ↓
   ClusPro/HDOCK      HADDOCK
   无约束搜索          有约束搜索
       │                 │
       └────────┬────────┘
                ↓
          大规模构象采样
                ↓
             聚类
                ↓
        界面柔性优化/refinement
                ↓
      能量、界面、稳定性评价
                ↓
        MD模拟进一步验证
目前比较常用的思路是 ClusPro/HDOCK 做初步搜索 + HADDOCK/MD 做进一步精修和验证。ClusPro本身就是针对蛋白–蛋白对接设计的,能够进行刚体采样、聚类并输出代表性模型;HADDOCK则特别适合有实验界面信息的情况。
二、第一步:首先确定“多聚体”到底是什么
这是最容易出问题的地方。
假设蛋白 A 的 PDB:
A.pdb

ATOM ... chain A
ATOM ... chain B
ATOM ... chain C
ATOM ... chain D
那么它可能是:
A1
      /  \
    A2----A3
      \  /
       A4
即一个 A₄四聚体。
蛋白 B:
B.pdb

chain E
chain F
可能是:
B1 ===== B2即 B₂二聚体。
这时候真正的对接应该是:
Protein A
          ┌──────────────┐
          │ A1 A2 A3 A4  │
          └──────────────┘
                  +
          ┌──────────────┐
          │    B1 B2     │
          └──────────────┘
             Protein B

                  ↓

          ┌────────────────┐
          │   A1 A2 A3 A4  │
          │       ││       │
          │      B1B2      │
          └────────────────┘
而不是:
A1 + B1
A2 + B2
A3 + B1
A4 + B2
分别做几个单链 docking。
三、如果两个多聚体已经有实验结构
这是最理想的情况。
例如:
Protein A
PDB: XXXX
Chains: A B C D

Protein B
PDB: YYYY
Chains: E F
首先检查:
1. 多聚体是否是真实生物学组装?
不能单纯看到 PDB 有 4 条链,就直接认为它是四聚体。
需要确认:
- Biological Assembly
- PDB Assembly
- 晶体接触
- 对称性
- 文献报道
- PISA分析
- 是否存在稳定的链间界面
尤其是晶体结构中经常存在:
生物学多聚体
        ≠
晶体堆积产生的多聚体
四、第二步:蛋白结构预处理
建议先进行:
PDB
 │
 ├── 删除水
 ├── 删除不需要的buffer分子
 ├── 删除无关配体
 ├── 检查缺失残基
 ├── 检查alternate location
 ├── 检查occupancy
 ├── 检查链ID
 ├── 检查原子名称
 └── 检查多聚体完整性
例如:
grep "^ATOM" A.pdb | awk '{print $5}' | sort | uniq检查 A 有哪些链。
再检查 B:
grep "^ATOM" B.pdb | awk '{print $5}' | sort | uniq五、如果蛋白是 AlphaFold 预测结构
这个情况要更加谨慎。
例如得到:
Protein A
AlphaFold monomer
        ↓
A1

Protein B
AlphaFold monomer
        ↓
B1
但实际上:
A = A4
B = B2
那么不能简单地:
A1 + B1然后认为得到了:
A4B2应该先确定:
A1 → A4
B1 → B2
再研究:
A4 + B2对于多链复合物,也可以直接采用 AlphaFold-Multimer/ColabFold 类方法进行复合物预测。AlphaFold-Multimer就是针对多链蛋白复合物预测开发的,并且可以通过不同随机种子获得不同复合物构象。
六、第三步:确定两个多聚体之间可能的结合界面
这是蛋白–蛋白 docking 中非常重要的一步。
假设:
Protein A
        ┌───────────────┐
        │               │
        │       ●●●●    │ ← 可能结合区域
        │               │
        └───────────────┘

Protein B
        ┌───────────────┐
        │    ●●●        │ ← 可能结合区域
        │               │
        └───────────────┘
如果已经知道:
- 突变位点
- Co-IP
- Pull-down
- Cross-linking/MS
- HDX-MS
- NMR chemical shift perturbation
- Alanine scanning
- 已知结合残基
就可以把这些信息作为 docking restraints。
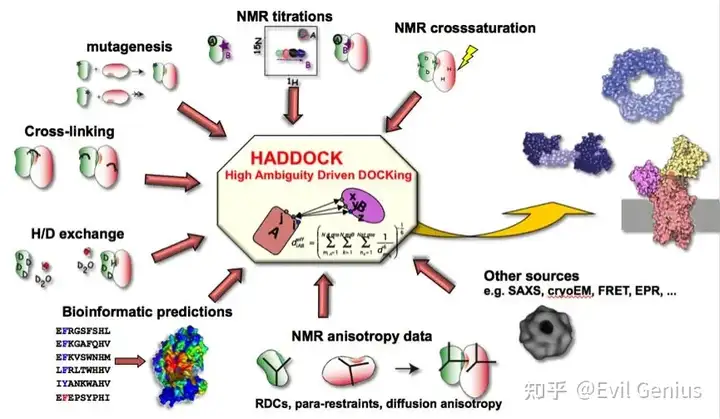
这时候 HADDOCK尤其合适,因为它可以把实验界面信息转化为 active/passive residues 和距离约束。HADDOCK的典型蛋白–蛋白流程包括刚体对接、界面柔性优化、进一步精修和聚类。
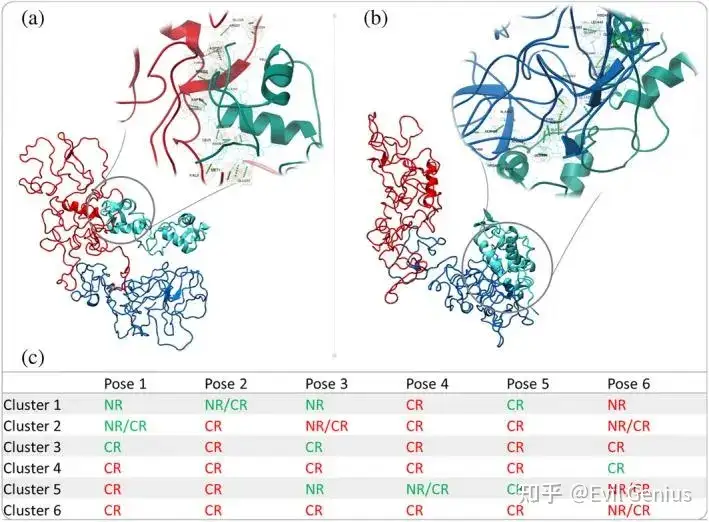
七、如果完全不知道结合界面怎么办?
如果:
两个蛋白之间的结合界面完全未知
那么应该首先进行:
Blind protein-protein docking
例如:
A4
+
B2
 ↓
大量空间取向
 ↓
筛选
 ↓
cluster
 ↓
得到若干候选界面
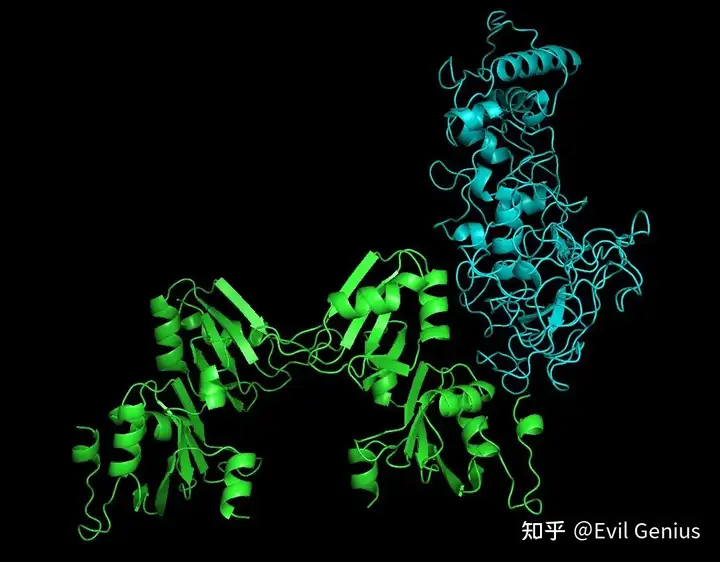
ClusPro就是非常适合这一阶段的工具之一。其基本思想是产生大量蛋白–蛋白相对取向,然后按照能量和结构相似性进行聚类,最终保留代表性模型。
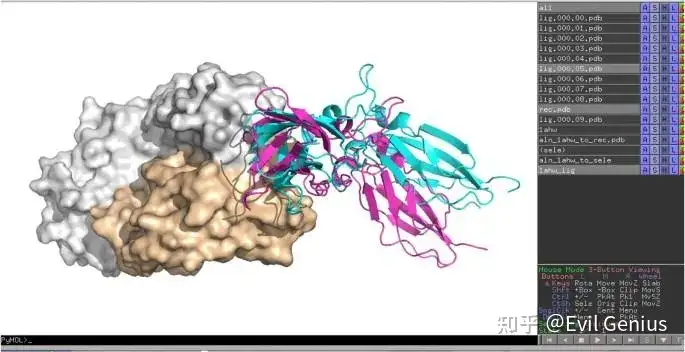
八、第四步:刚体蛋白–蛋白对接
和 AutoDock Vina 有一个非常重要的区别:
小分子 docking
蛋白
  │
  └──── 固定/半柔性

配体
  │
  ├── translation
  ├── rotation
  └── torsion
而蛋白–蛋白 docking 通常首先考虑:
Protein A
    │
    ├── translation
    └── rotation

Protein B
    │
    ├── translation
    └── rotation
也就是说首先大量搜索:
两个蛋白整体之间的相对位置和方向。
ClusPro的FFT-based docking就是典型的这种大规模刚体采样思路;其物理评分考虑范德华、静电以及知识库势等因素。
九、第五步:为什么不能只看 docking score?
这是多聚体蛋白 docking 最重要的问题之一。
假设得到:
Model | Score | Cluster size |
|---|---|---|
Model 1 | -850 | 42 |
Model 2 | -920 | 8 |
Model 3 | -790 | 105 |
Model 4 | -880 | 63 |
Model 5 | -950 | 3 |
不能简单认为:
-950最好因为:
Score
+
Cluster size
+
Interface quality
+
Steric clash
+
Electrostatics
+
Hydrogen bonds
+
Salt bridges
+
Buried surface area
应该综合判断。
ClusPro的结果本身就强调 cluster,而不是单纯依据一个最低能量模型;其输出模型是低能量构象聚类后的代表结构。
十、第六步:多聚体体系尤其要看“界面”
例如:
Protein A
        ███████████
       █████████████
      ███████
             ╲
              ╲
               █████████
               █ Protein B
               █████████
真正需要分析的是:
A的界面残基
        ↓
Axxx
Axxx
Axxx
        ↕
Bxxx
Bxxx
Bxxx
        ↓
B的界面残基
重点分析:
1. 接触残基
例如:
A:ASP125
      │
      │ 3.2 Å
      ↓
B:ARG78
2. 氢键
A:SER120 ───── B:ASP843. 盐桥
A:ASP125(-)
       │
       │
B:ARG78(+)
4. 疏水相互作用
A:PHE
A:LEU
A:VAL
       ↓
     接触
       ↑
B:ILE
B:LEU
B:MET
5. buried surface area
也就是:
两个蛋白结合以后,有多少表面积被埋藏。
通常一个合理的蛋白–蛋白界面应该具有比较明显的 buried surface area,而不是只有几个孤立接触点。
十一、第七步:界面柔性优化
刚体 docking 得到:
A
████████

        B
        ████████
但真实蛋白结合时:
A
████████
   ↓ 局部构象变化
████████
       ╲
        ╲
         B
        ████████
所以一般需要:
Rigid-body docking
        ↓
Interface refinement
        ↓
Flexible side-chain optimization
        ↓
Energy minimization
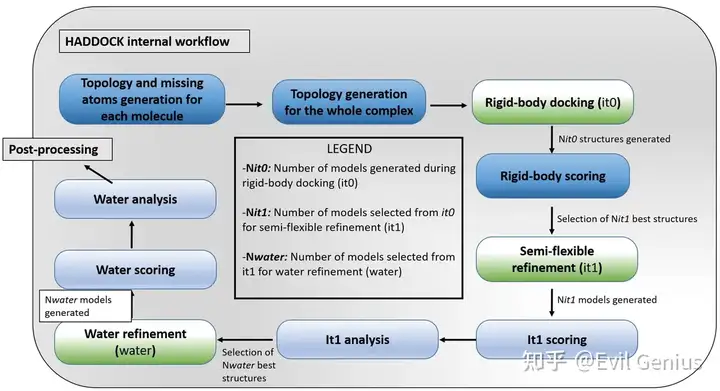
HADDOCK的典型流程就是:
Rigid-body
    ↓
Semi-flexible refinement
    ↓
Explicit-solvent refinement
    ↓
Clustering
HADDOCK3目前也提供在刚体采样后进行聚类、柔性 refinement 和进一步能量/MD精修的流程。
十二、对于“两个多聚体”推荐的方案
如果情况是:
Protein A = A4
Protein B = B2
建议:
路线一:完全不知道界面
A4
│
├── ClusPro
│
├── HDOCK
│
└── AlphaFold-Multimer
        ↓
候选复合物
        ↓
Cluster
        ↓
筛选共同出现的界面
        ↓
HADDOCK refinement
        ↓
MD
这是比较稳妥的方案。
路线二:知道部分结合残基
例如实验已经发现:
A:
ASP120
GLU125
ARG128

B:
LYS75
ARG80
TYR83
那么:
A4
+
B2
 ↓
HADDOCK
 ↓
Active residues
Passive residues
 ↓
Rigid-body docking
 ↓
Flexible refinement
 ↓
MD
这种情况下通常比完全 blind docking 更有针对性。
十三、如果两个多聚体本身也存在对称性
这个情况特别重要。
比如:
A4:

       A1
     /    \
   A2      A4
     \    /
       A3
它可能存在:
C4 symmetry而 B₂可能是:
B1 —— B2

C2 symmetry
那么:
A4 + B2理论上可能产生很多不同的结合方式:
方案1       方案2       方案3

 A4          A4          A4
██████      ██████      ██████
  BB          B           BB
BB所以不能只看一个 docking pose。
应该重点看:
是否有多个独立 docking 方法都支持相似的 interface。
十四、AlphaFold-Multimer 可以作为重要的独立证据
如果两个蛋白的序列比较可靠,而且有足够的MSA信息,可以直接:
Protein A sequence
        +
Protein B sequence
        ↓
AlphaFold-Multimer
        ↓
A-B complex
如果是:
A4 + B2则需要按照实际 stoichiometry 构建多链输入:
A A A A B B而不是:
A B这样才能让模型尝试预测完整的多聚体组装。
不过,AlphaFold-Multimer结果不能简单等同于实验结构。尤其需要查看:
- pTM
- ipTM
- PAE
- interface PAE
- interface contacts
- 不同seed是否得到相似构象
AlphaFold-Multimer的研究和后续评估表明,多链复合物预测虽然明显提升了界面预测能力,但不同体系的可靠程度仍然存在差异。
十五、最后一定要进行 MD 验证
如果目标是做比较完整的计算结构生物学分析,建议最终:
A4
           +
           B2
           │
      Protein docking
           │
      ┌────┼─────┐
      ↓    ↓     ↓
   ClusPro HADDOCK AF-Multimer
      │    │     │
      └────┼─────┘
           ↓
       Consensus
           ↓
      最佳复合物
           ↓
       GROMACS
           ↓
 ┌─────────┼─────────┐
 ↓         ↓         ↓
RMSD      Rg       H-bond
 ↓         ↓         ↓
Interface stability
           ↓
       MM-PBSA
最终可以分析:
分析 | 主要回答的问题 |
|---|---|
RMSD | 复合物是否稳定 |
RMSF | 哪些残基运动明显 |
Rg | 整体是否发生明显松散 |
H-bond | 界面氢键是否稳定 |
Salt bridge | 盐桥是否保持 |
Contact map | 界面接触是否保持 |
SASA | 结合后表面积变化 |
Interface ΔSASA | 界面埋藏程度 |
MM/PBSA | 结合自由能趋势 |
Per-residue decomposition | 哪些残基贡献最大 |
十六、最终可以形成一张非常漂亮的分析图
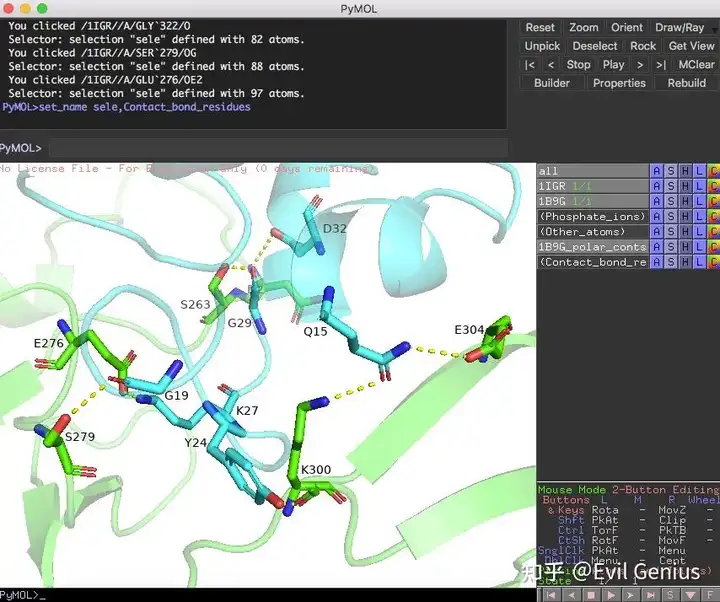
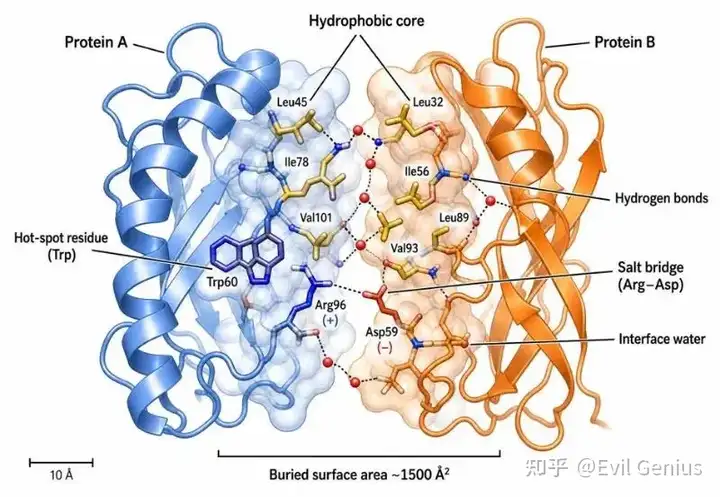
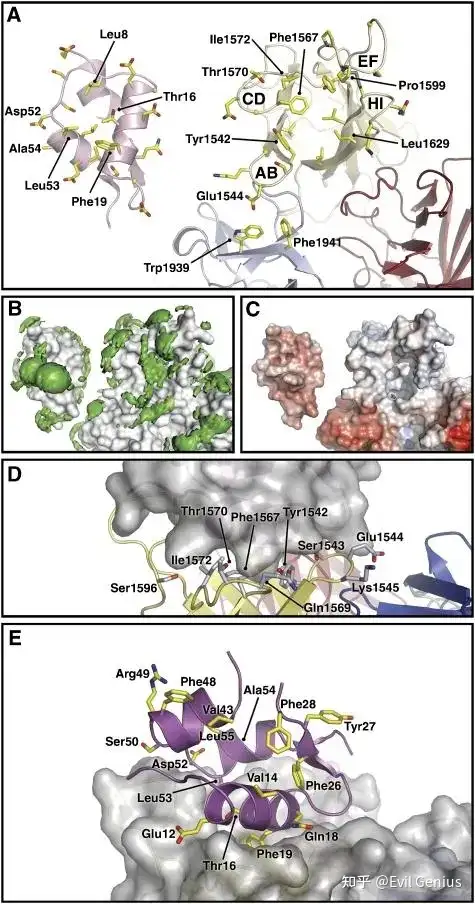
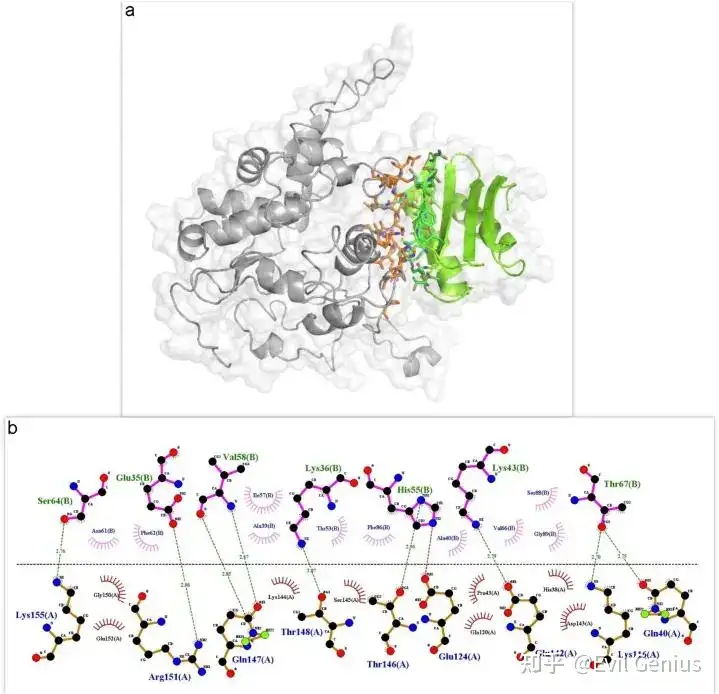
做成:
Protein A4
      ┌─────────────┐
      │             │
      │   Interface │
      │     ████    │
      └──────┬──────┘
             │
        3.2 Å H-bond
             │
      ┌──────┴──────┐
      │   Interface │
      │             │
      └─────────────┘
        Protein B2

        ↓

Interface residues
        ↓
H-bonds
Salt bridges
Hydrophobic contacts
        ↓
Docking score
Cluster size
        ↓
MD stability
        ↓
MM/PBSA
多聚体蛋白对接和普通蛋白–配体 docking 最大的区别
可以简单记住:
项目 | 小分子-蛋白 | 蛋白-蛋白 | 多聚体-多聚体 |
|---|---|---|---|
对象 | 蛋白+小分子 | 蛋白+蛋白 | 蛋白复合物+蛋白复合物 |
主要运动 | 配体平移/旋转/扭转 | 两个蛋白相对运动 | 两个多聚体整体相对运动 |
是否考虑界面 | 是 | 非常重要 | 核心问题 |
刚体搜索 | 有 | 有 | 非常重要 |
柔性 | 配体为主 | 蛋白界面 | 多聚体界面 |
Cluster | 次要 | 重要 | 非常重要 |
实验约束 | 较少 | 很有价值 | 非常有价值 |
MD | 可选/常用 | 推荐 | 强烈推荐 |
典型工具 | Vina | HADDOCK/ClusPro | HADDOCK/ClusPro + AF-Multimer + MD |
特别提醒:如果两个蛋白已经分别是多聚体,千万不要默认把每条链拆开分别 docking。应先确定 biological assembly 和 stoichiometry,再把整个 Aₙ 和 Bₘ 作为两个 docking partner。
生活很好,有你更好。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号