我们是怎样将 PromQL 集成到 Elasticsearch 的
原创
我们是怎样将 PromQL 集成到 Elasticsearch 的
原创
点火三周
发布于 2026-09-14 10:32:47
发布于 2026-09-14 10:32:47
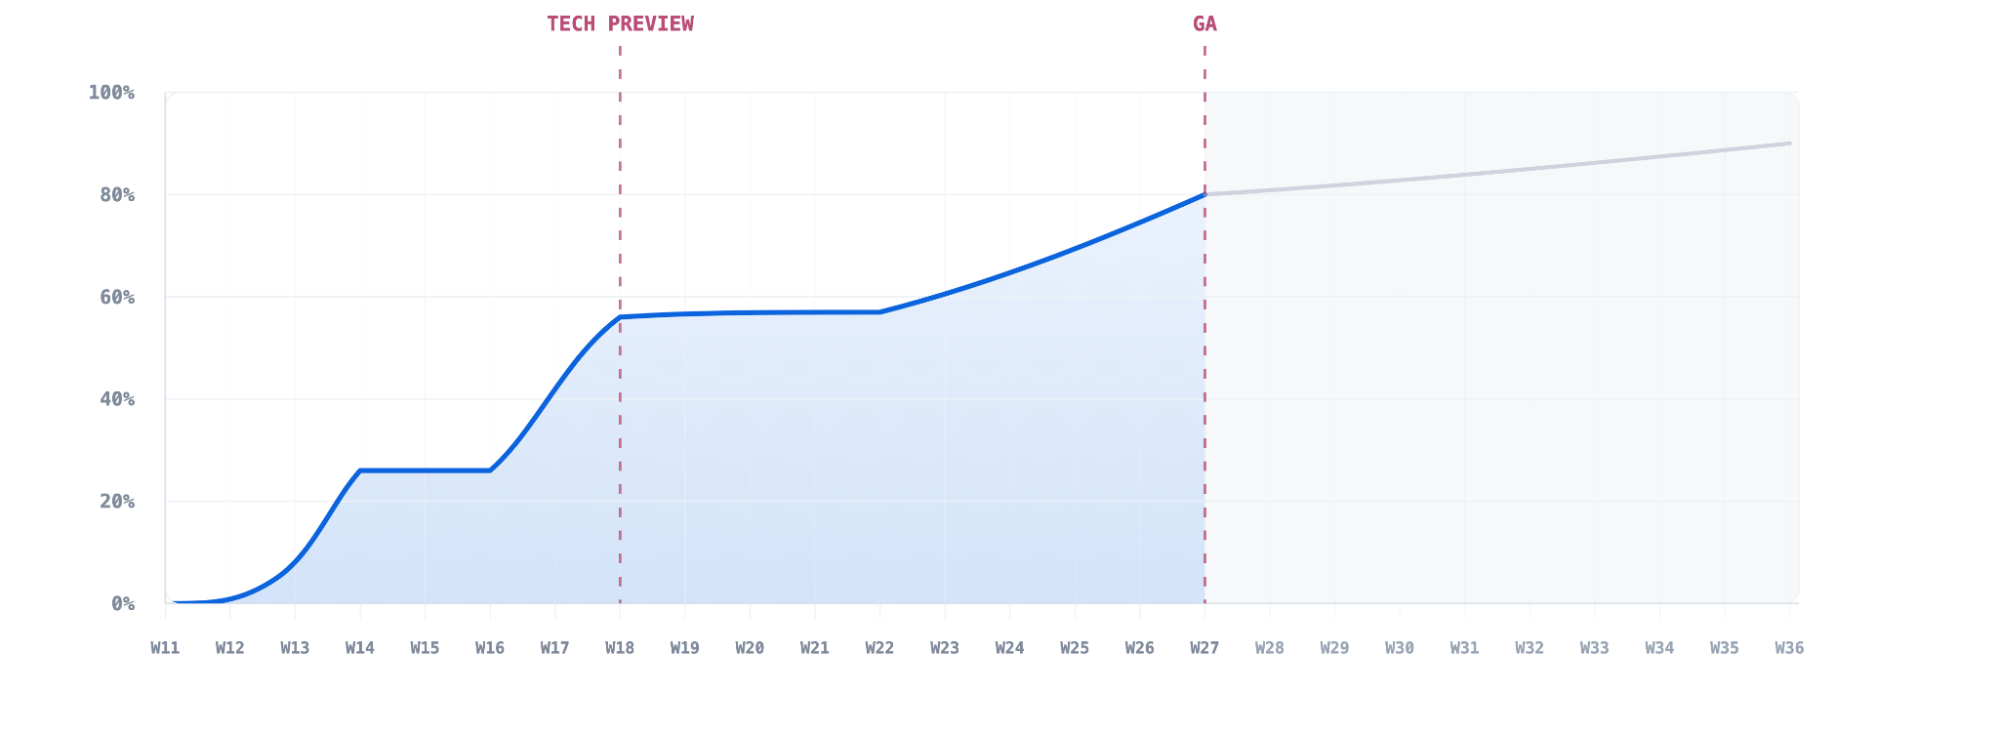
我们实际语料库中超过 80% 的 PromQL 查询可以在 Elasticsearch 上不加修改地运行。Elasticsearch 9.5 将 PromQL 及 Prometheus 兼容 API 正式发布(GA),因此你可以通过 remote write 采集 Prometheus 指标,并通过 Prometheus HTTP APIs 或 Elasticsearch 查询语言 (ES|QL) 中的 PROMQL 命令进行查询。
PromQL 编译为与 ES|QL 相同的计算引擎,并继承了其规划器、分布式执行以及发布流程。我们没有为此构建第二个引擎,也无需安装任何插件。
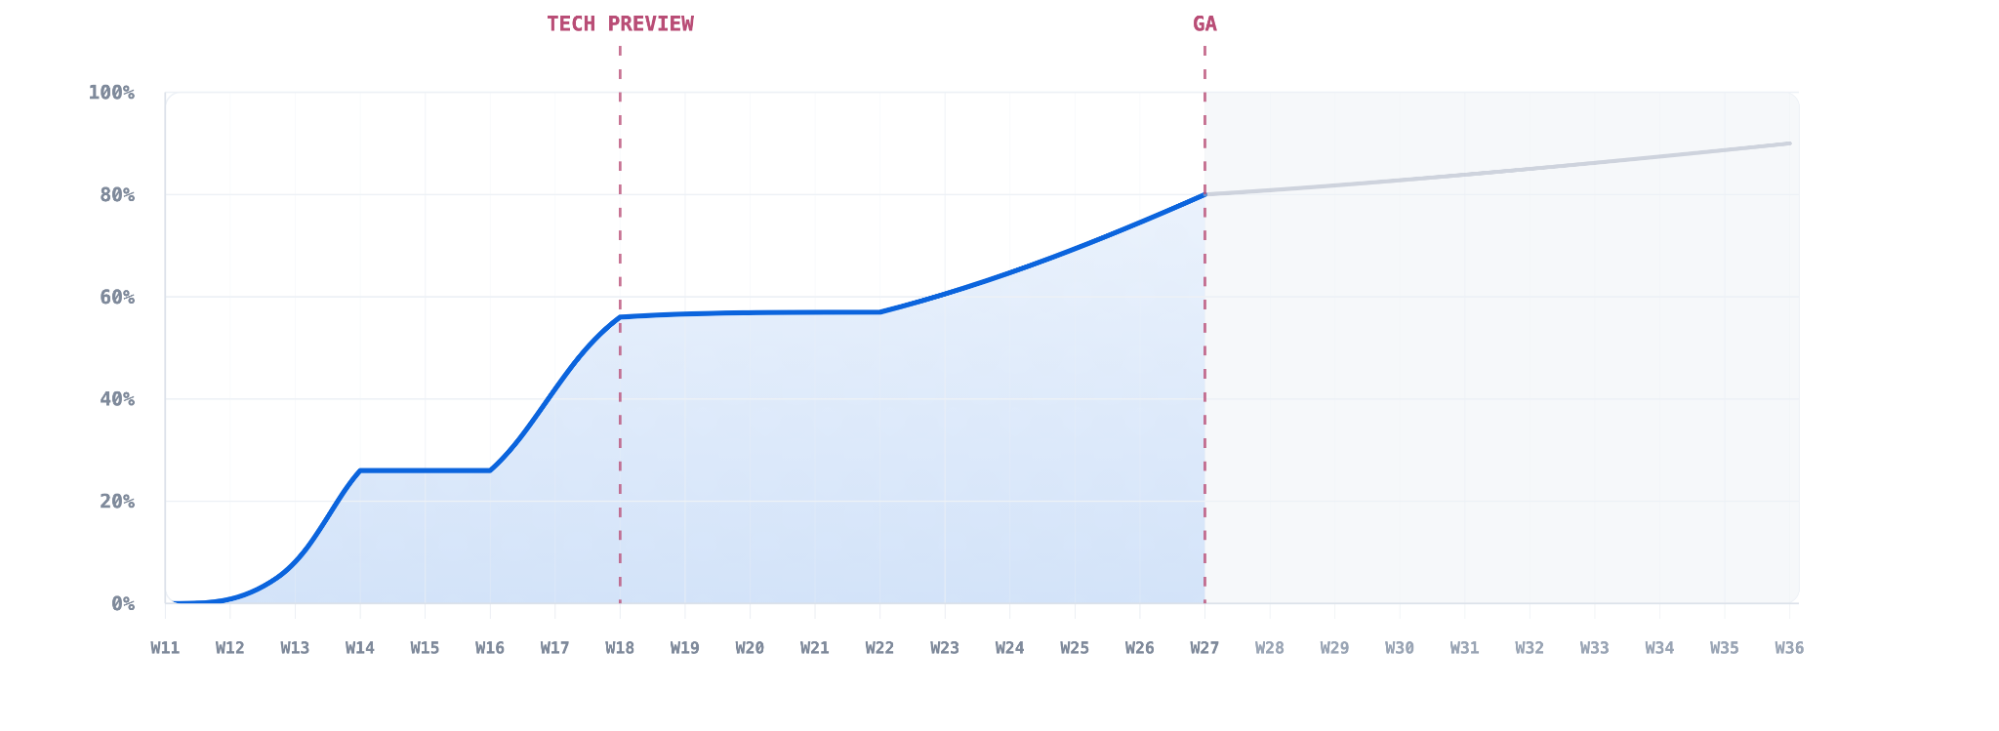
PromQL compatibility in Elasticsearch rising from zero to 80% between 9.4 Tech Preview and 9.5 GA
本文介绍我们是如何构建它的。
要点概述:
- 单一引擎: 该实现将 Elasticsearch 成熟的分布式规划、存储和测试基础设施与较新的计算引擎(提供列式执行运行时)结合在一起。这使得 PromQL 可以重用经过验证的 Elasticsearch 能力,同时通过现代、原生的向量化管道执行,而不是引入单独的运行时。
- 单一服务器: Elasticsearch 直接实现了 Prometheus remote write 和查询 API,因此 Prometheus 兼容的采集和查询无需任何额外插件即可运行。
- 为效率而设计: 支持 PromQL 需要新的引擎原语,用于范围对齐的评估网格、向后看的窗口、动态标签分组、管道结果重塑以及紧凑的宽聚合键。这些原语使得 PromQL 查询能够端到端高效执行,相关的语义直接在计算引擎中实现,而不是通过外部后处理。
- 以实际使用衡量的兼容性: 除了 Prometheus 合规测试外,我们还构建了一个差异测试和质量控制管道,使用了从公共存储库收集的超过 2000 个 PromQL 查询。
更多阅读:
- 在 Elasticsearch 中使用 PromQL 查询 Prometheus 指标
- 通过 Remote Write 将 Prometheus 指标发送到 Elasticsearch
- 将 Fire 引入 Elasticsearch:添加原生 Prometheus API
为什么要在 Elasticsearch 上运行 PromQL
许多团队已经在 Elasticsearch 中存储日志和跟踪,同时在 Prometheus 或其他专用指标后端中运行指标。
Prometheus 及其生态系统强大且被广泛采用,但大规模部署也可能带来运维分散和扩展挑战,以及有限的保留期。
因此,我们着手将 Elastic 高度优化的时序数据库 (TSDB) 与一流的指标生态系统结合起来。结果是一个更小的可观测性栈,需要运维的系统更少,指标存储可以水平扩展并支持长期保留。
单一引擎:PromQL 和 ES|QL 共享同一个计算引擎
我们在早期架构决策中决定不在 Elasticsearch 旁边运行单独的 PromQL 引擎。
相反,PromQL 是 Elasticsearch 计算引擎的另一个前端。
这使得 PromQL 处于正常的 Elasticsearch 开发生命周期中。它使用与 Elasticsearch 本身相同的规划器、分布式执行引擎、测试基础设施和发布流程。
要了解更多关于 Elasticsearch 查询引擎的信息,请查看 我们的博客。
与使用 TS 源命令的 ES|QL 时序查询类似,PromQL 被翻译成高度优化的查询计划并在集群中执行。节点通过向量化运算符处理列式批次,部分结果在交换阶段传递,直到最终结果组装完成。
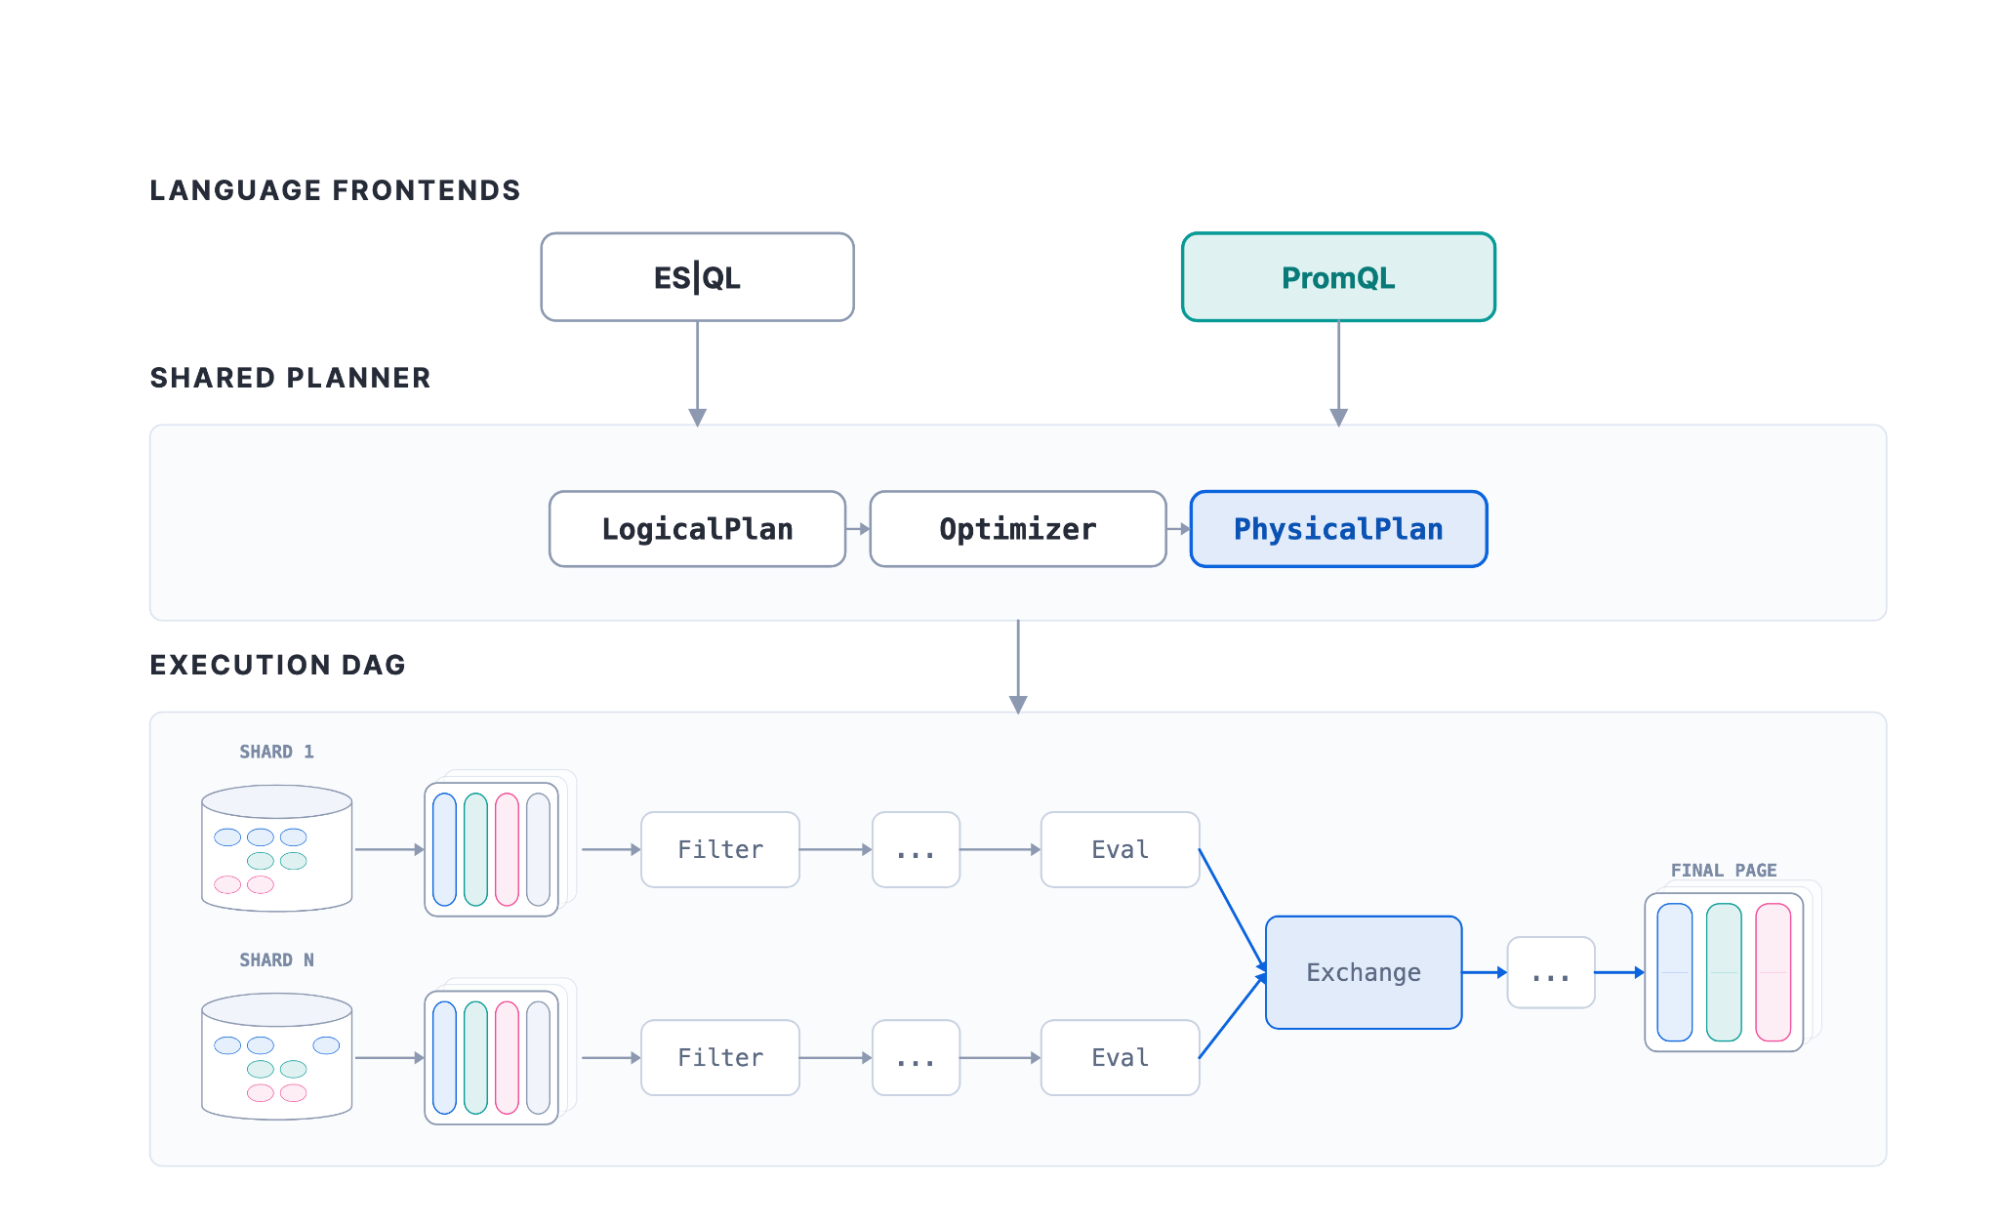
PromQL and ES|QL frontends feed one shared Elasticsearch planner and columnar execution DAG across shards
这也意味着 PromQL 和 ES|QL 在相同的执行引擎和时序数据上运行。ES|QL 还可以通过 PromQL 不支持的后期处理(如查找连接和内联聚合)来扩展 PromQL 计算。
例如,假设 Prometheus 请求计数器存储在 metrics-* 中,并以 service 标签为键。一个查找索引 service_registry 将每个实例映射到其所属团队、环境和服务层级:
PROMQL index=metrics-* error_rate=( sum by (service) ( rate(http_requests_total{status=~"5.."}[5m]) ) )| LOOKUP JOIN service_registry ON service| WHERE error_rate > 0.15| SORT error_rate DESC这种架构要求执行引擎原生且高效地支持 PromQL 语义,而不仅仅是 ES|QL 的语法糖。以下部分介绍了我们为实现这一目标而引入的更改和新执行原语。
单一服务器:Elasticsearch 内置 Prometheus remote write 和 HTTP API
查询执行只是故事的一半。Prometheus 生态系统还期望熟悉的采集和查询 API。
Prometheus 协议几乎是每个团队可观测性栈中所有指标的事实标准。因此,我们直接在 Elasticsearch 服务器中构建了 HTTP API,从而消除了对第三方组件的需求,并加强了集成的稳定性和性能。
在采集方面,我们 添加 了 Prometheus remote write 协议的端点。它接受 Snappy 压缩的 Protocol Buffer 消息,将标签映射到 TSDS 维度,将指标名称/值映射到指标字段,推断计数器与计量的映射,并直接写入 TSDS。内置模板是动态的,因此用户无需预先声明每个 Prometheus 标签或指标。
在查询方面,Elasticsearch 暴露 了 Prometheus 查询 API。请求通过 Prometheus 端点进入,并在计算引擎中执行。
在列式引擎中高效运行 PromQL
共享执行引擎并不意味着将 PromQL 视为 ES|QL 的语法糖。PromQL 具有不同的时间、分组和响应语义,以及在大规模下重要的工作负载特征。高效地支持它需要扩展计算引擎,而不是在 API 层进行补偿。
PromQL 时间网格:使用 TSTEP 对齐评估步长
时序查询引擎针对按时间分组进行了优化。
Elasticsearch 通常使用 TBUCKET(...) 对时间戳进行分组,该函数将每个时间戳截断到固定的间隔边界。截断成本低,并产生确定的桶边界。它还使中间结果更易于重用。
Prometheus 以不同方式定义评估点。对于范围查询,时间戳被布局为固定步长,锚定到查询范围,而不是通过截断每个样本时间戳得出。因此,具有相同步长但不同范围边界的两个查询可能产生不同的评估网格。
为了保留这些语义,我们引入了 TSTEP(...),它从查询范围和步长中导出其分组网格,而不是将时间戳截断到全局对齐的边界。
PromQL 内部使用 TSTEP(...),既保留了 Prometheus 时间戳语义,又将操作降低为原生 Elasticsearch 执行原语。
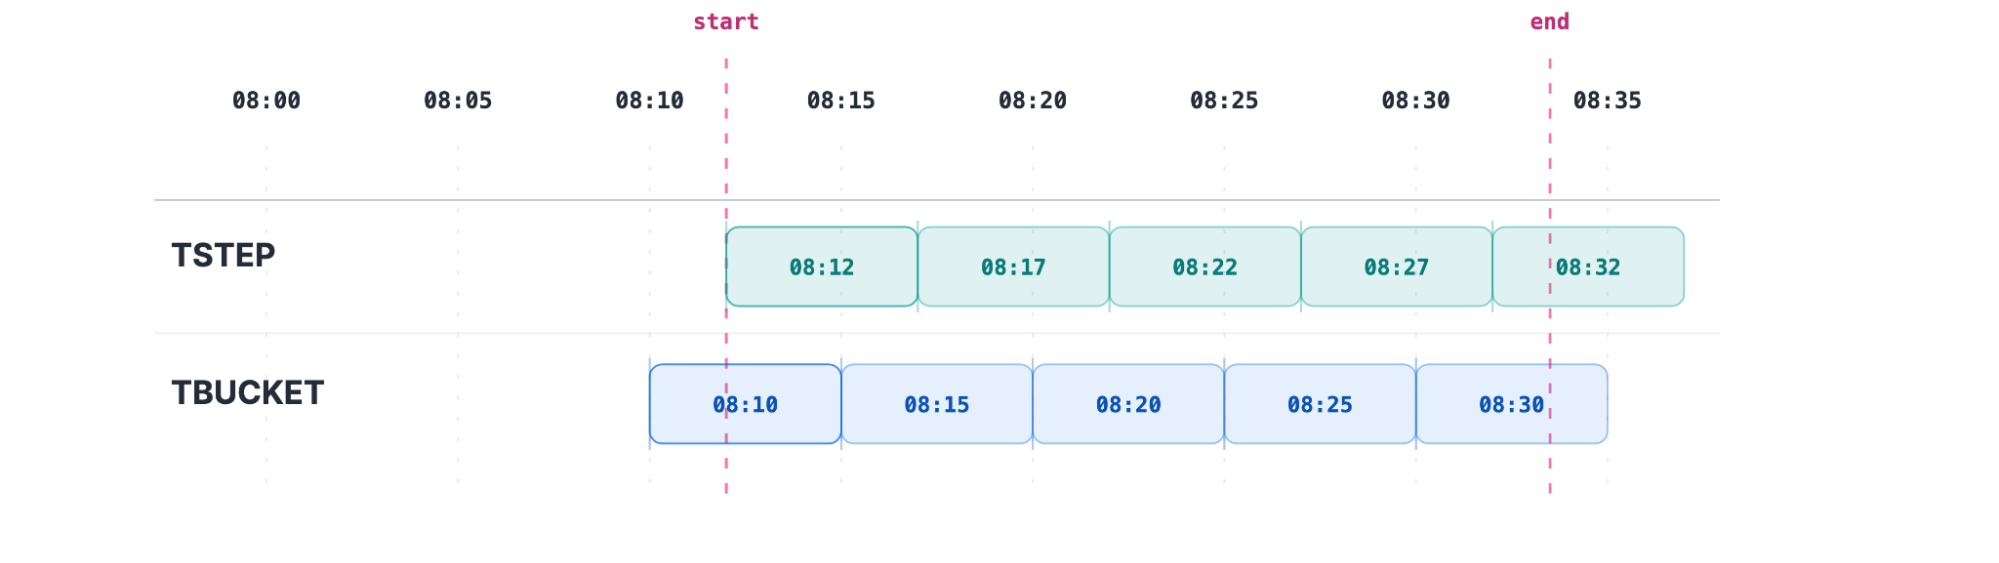
TSTEP vs TBUCKET in Elasticsearch: PromQL step grid anchored to query start, TBUCKET to fixed boundaries
有些人可能认为这是一个简单的问题,但细节很重要。
例如,考虑一个查询,它找到指标的 5 分钟滚动平均值:
avg_over_time(http_request_duration_seconds[5m])在评估时间 T,结果表示前五分钟范围的平均值:
(T - 5m, T]
当查询以五分钟步长执行时,每个输出值都用其对应五分钟窗口的上端点标记。
Elasticsearch 以前缺少这种语义,只支持前瞻窗口聚合函数:
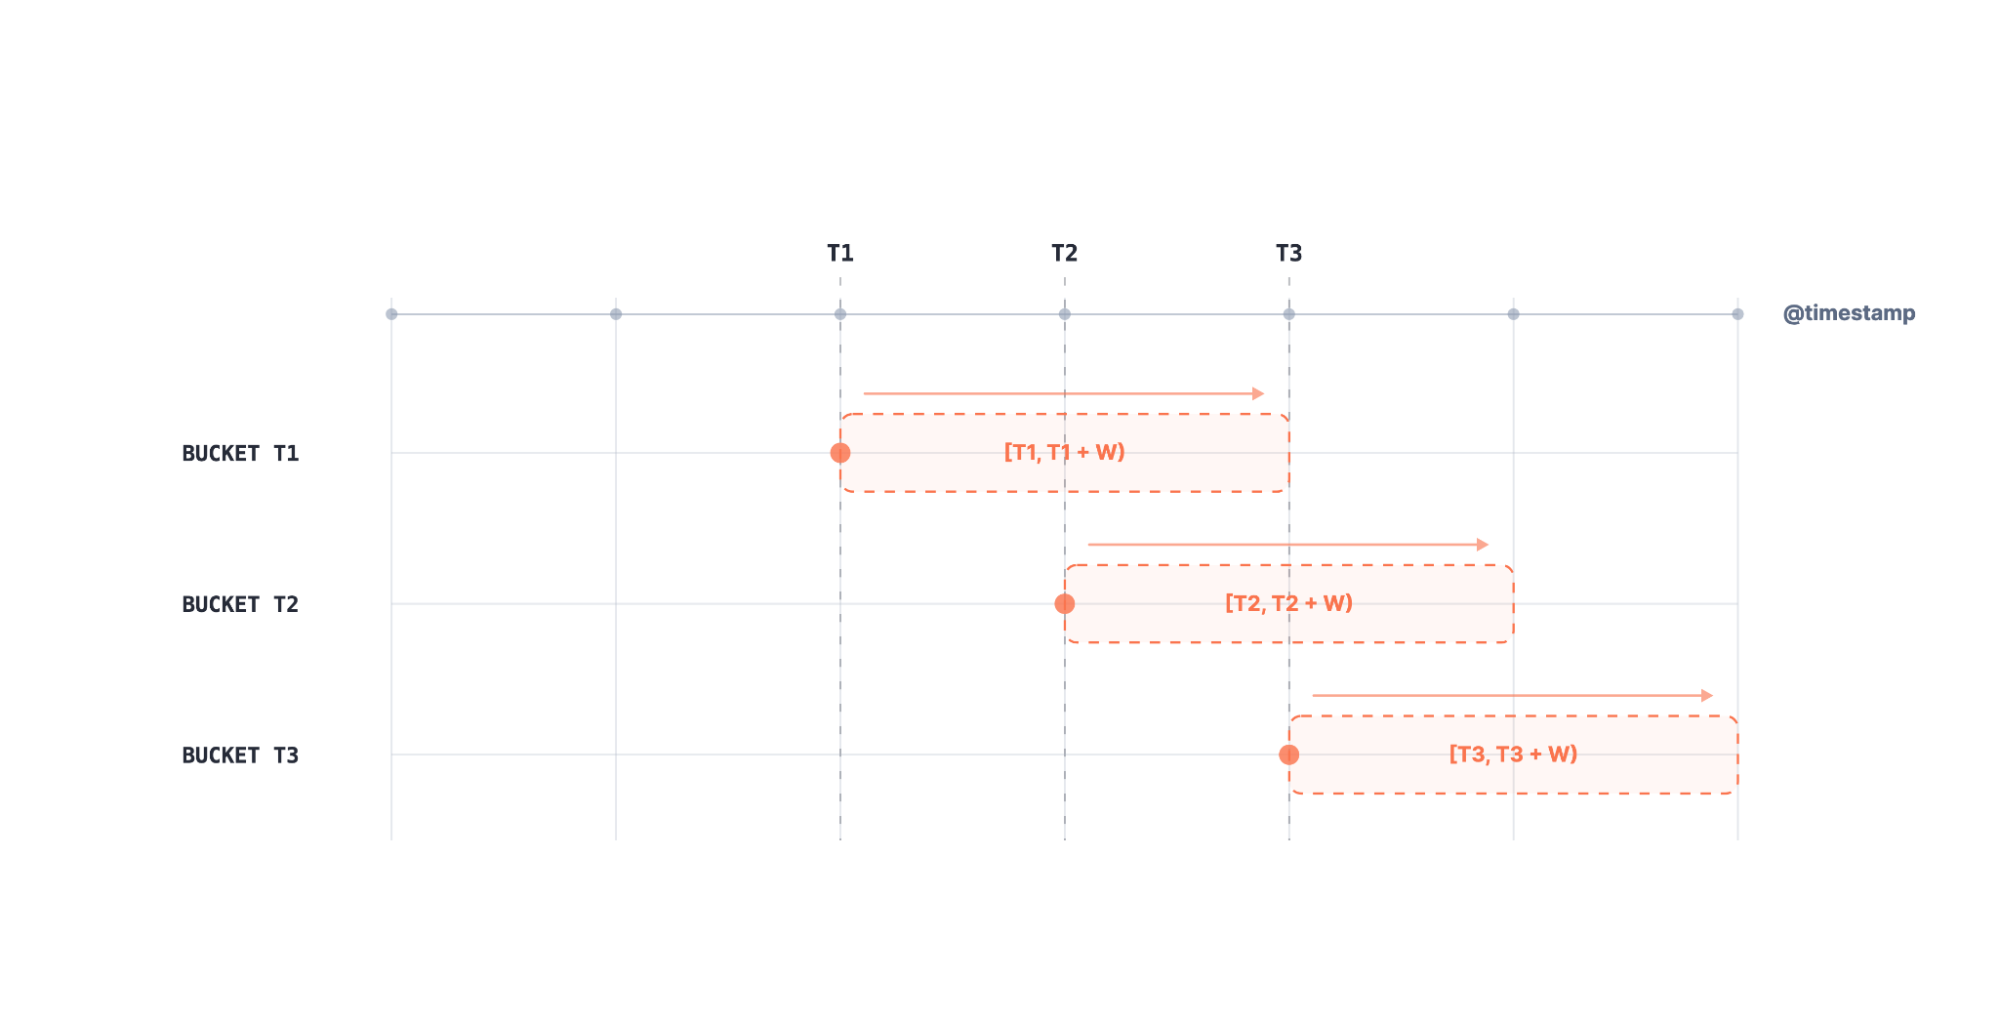
Forward-looking window aggregation where each bucket covers the interval from timestamp T to T plus W
我们重写了窗口评估路径,使得 ES|QL 和 PromQL 都使用通用的后瞻窗口实现
TSTEP(...) 和后瞻窗口共同保留了 PromQL 范围评估所需的两类时间语义。
动态标签分组:PromQL without() 如何在运行时解析
时间网格决定了 PromQL 表达式何时被评估。聚合则决定了哪些输入序列被组合,以及哪些标签标识每个输出序列。
对于大多数分析查询引擎,该标识在查询规划时已知。规划器可以分配分组列并选择聚合策略。它还会在执行管道中携带固定键。
ES|QL 就是这样工作的:
STATS sum(x) BY cluster, namespace输出序列按显式键 (cluster, namespace) 分组。
PromQL 可以以相反方向表达相同操作:
sum without(instance, pod) (http_requests_total)现在我们知道了哪些维度 不 使用。我们不一定知道完整的分组键,直到查询执行。这是一个小的语言差异,但带来了重要的执行后果。
一种可能的实现是发现该指标使用的每个标签,减去 instance 和 pod,然后将表达式重写为普通的 by(...) 聚合。这会在规划之前增加一个 发现阶段。对于高维指标,其中只有所有可能维度的一个子集在特定序列中可能具有有用值,这也会变得低效。大多数查询只需要可用维度的一小部分,因此将整个维度宇宙作为聚合键携带会浪费内存并增加记账开销。
我们转而扩展了时序执行路径,引入了动态分组列。引擎在读取序列时加载维度,并按时间序列应用排除。这避免将分组模式作为规划的前提条件,也避免在聚合中携带大量稀疏的分组列集。
维度打包:保持宽 PromQL 分组键的低成本
编写 PromQL 聚合的 惯用 方式大量使用 without(...) 而非 by(...):
sum without(instance, pod) (http_requests_total)排除标签而不是显式列出它们使得仪表盘和警报能够适应模式演变。如果向指标添加了新标签,除非显式排除,否则查询会继续保留它。
引擎的后果是有效的分组键可能很宽。其中许多标签通常基数较低,但每个标签仍然参与每个聚合阶段。
在列式引擎中,每个分组列通常表示为单独的向量。因此,十个分组标签意味着十个向量流过每个聚合运算符:
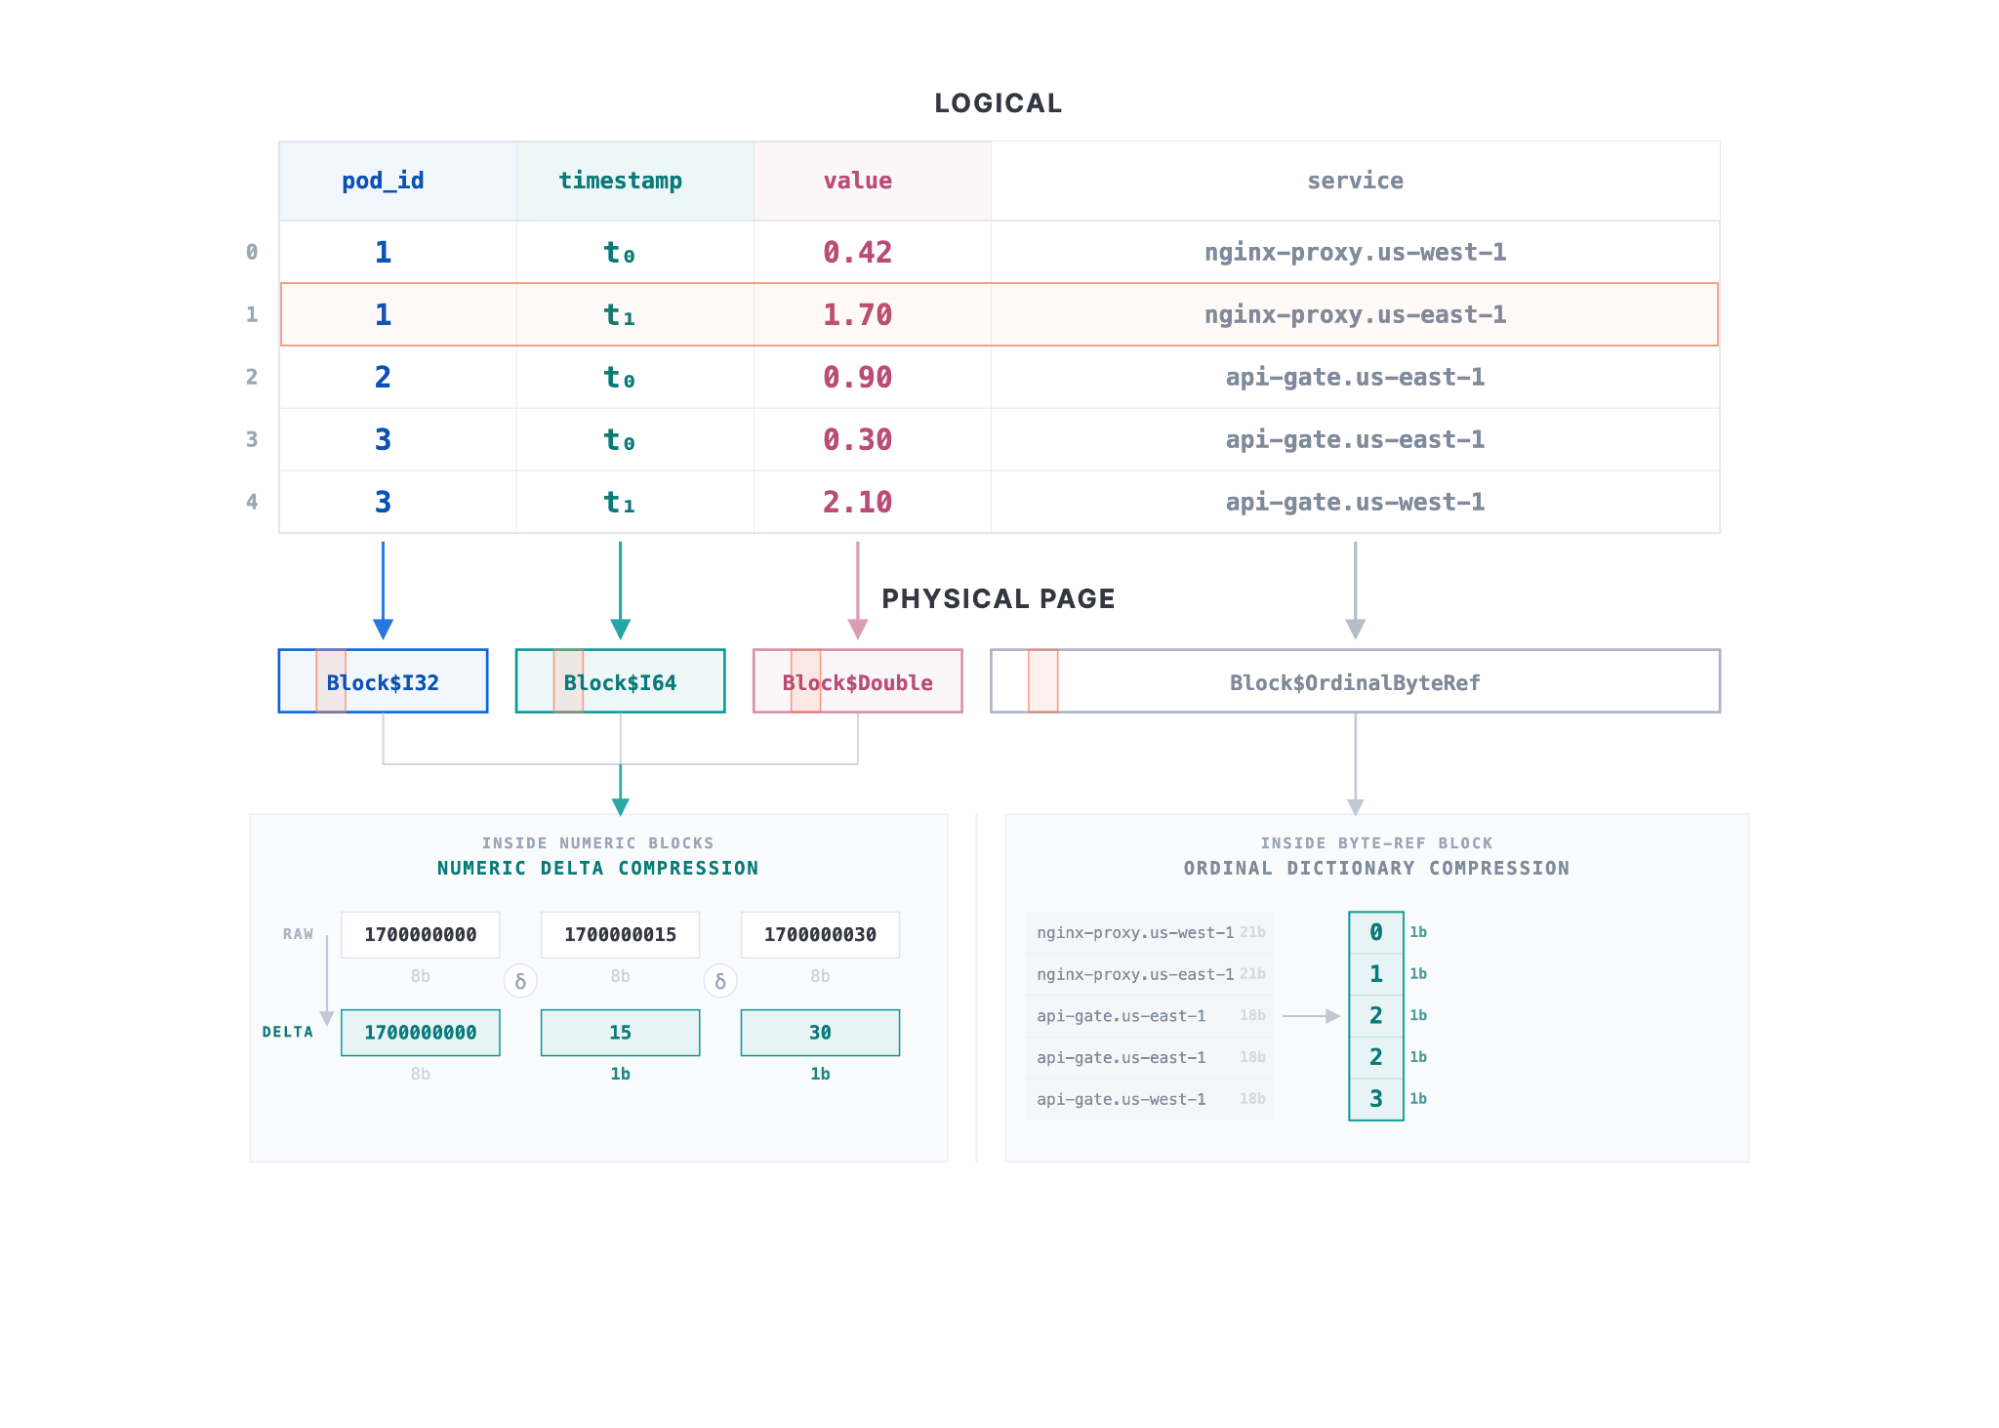
Elasticsearch columnar page: rows split into typed blocks with delta and ordinal dictionary compression
维度字段在索引映射中声明;规划器预先知道模式,分组键保持狭窄且可预测。
在列式引擎中,每个分组标签作为单独的向量或块携带。因此,具有 10 个标签的键需要读取、哈希、比较并保留 10 个向量供聚合运算符使用。随着键宽度增长,必须在管道中移动的数据量和记账量也会增加:
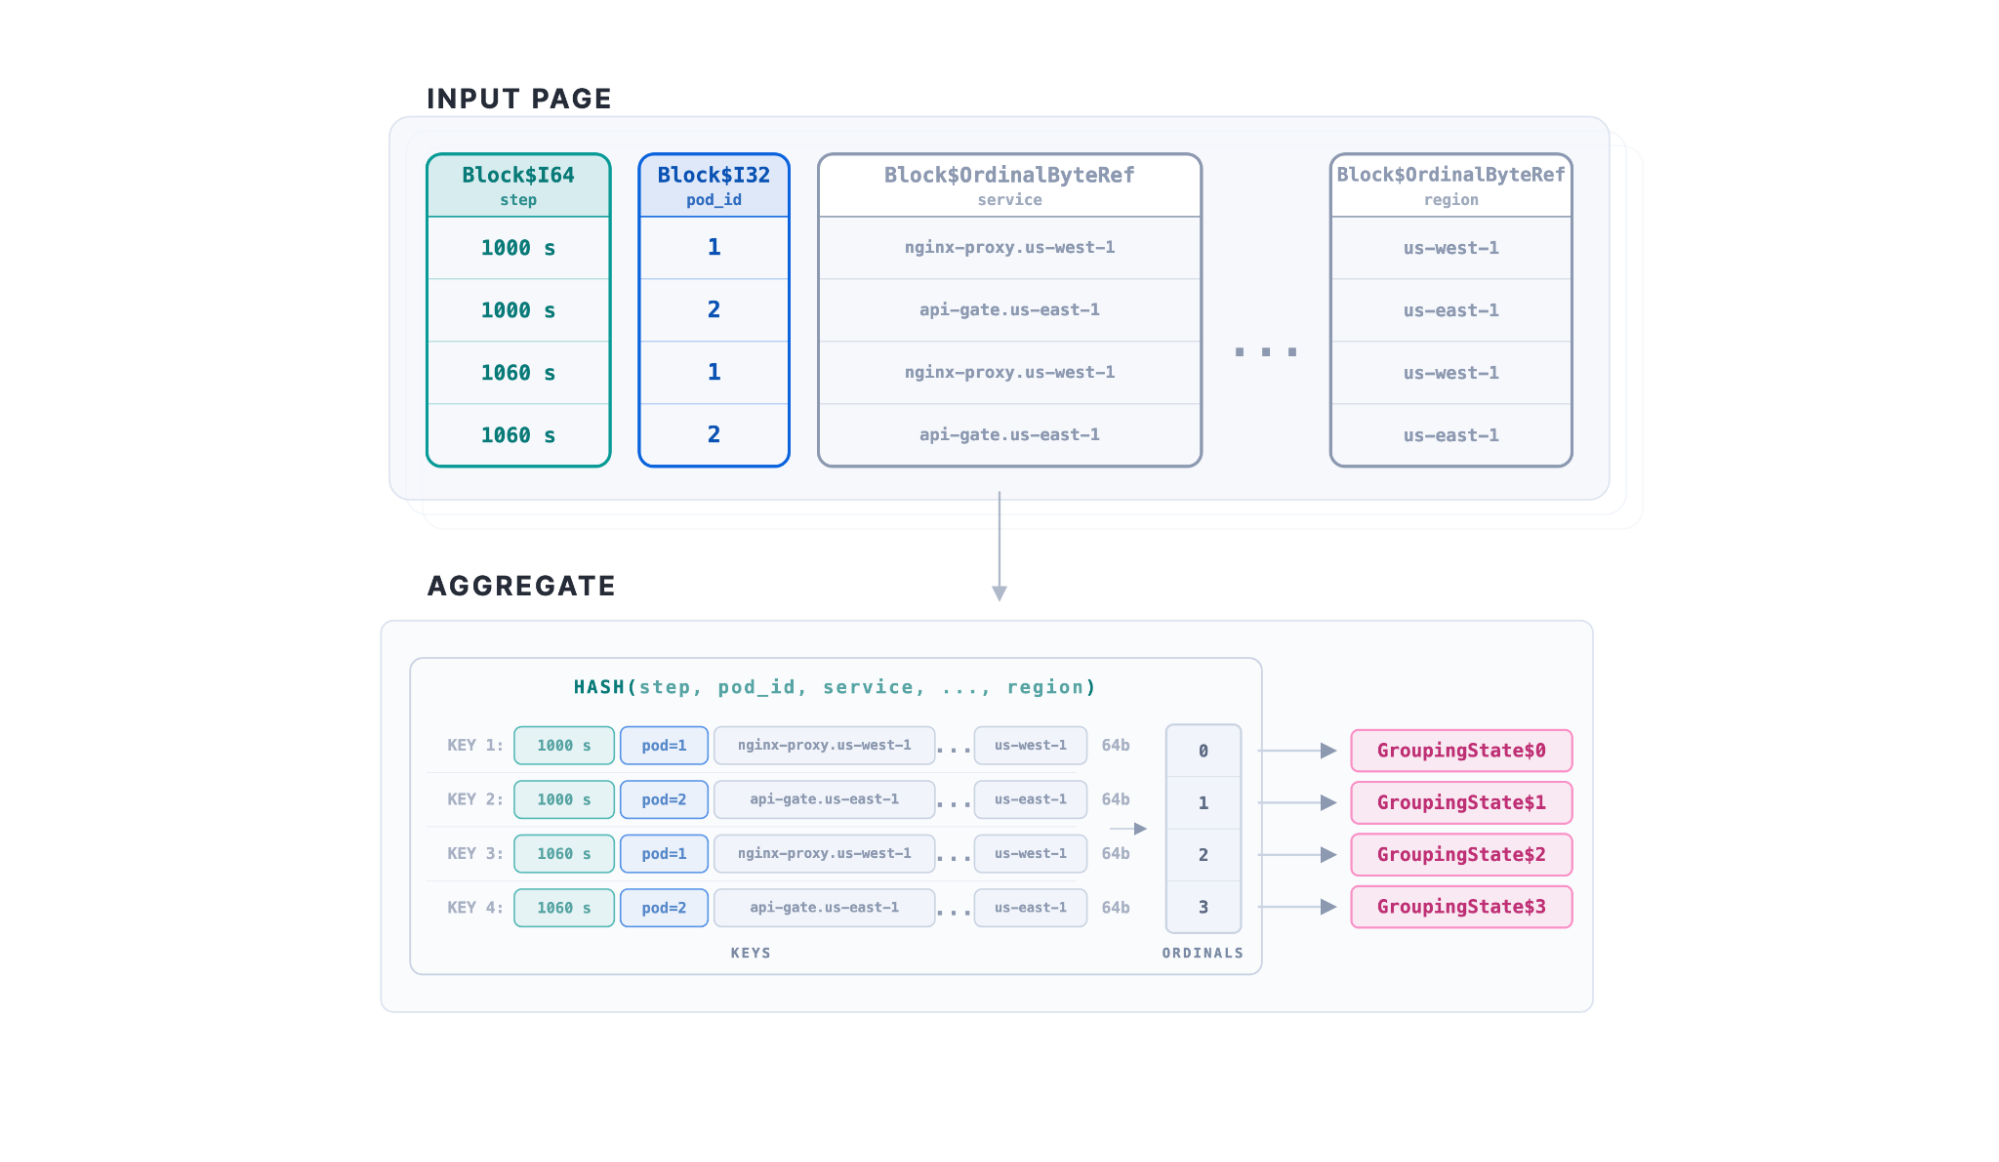
PromQL aggregation without packing: each grouping label hashed as a separate block into 64-byte keys
为了避免为每个额外标签支付这种按列成本,我们引入了维度打包。在聚合开始之前,引擎将完整的分组键编码为单个紧凑表示。哈希和比较操作在打包键上运行,而不是在每个块上独立运行:
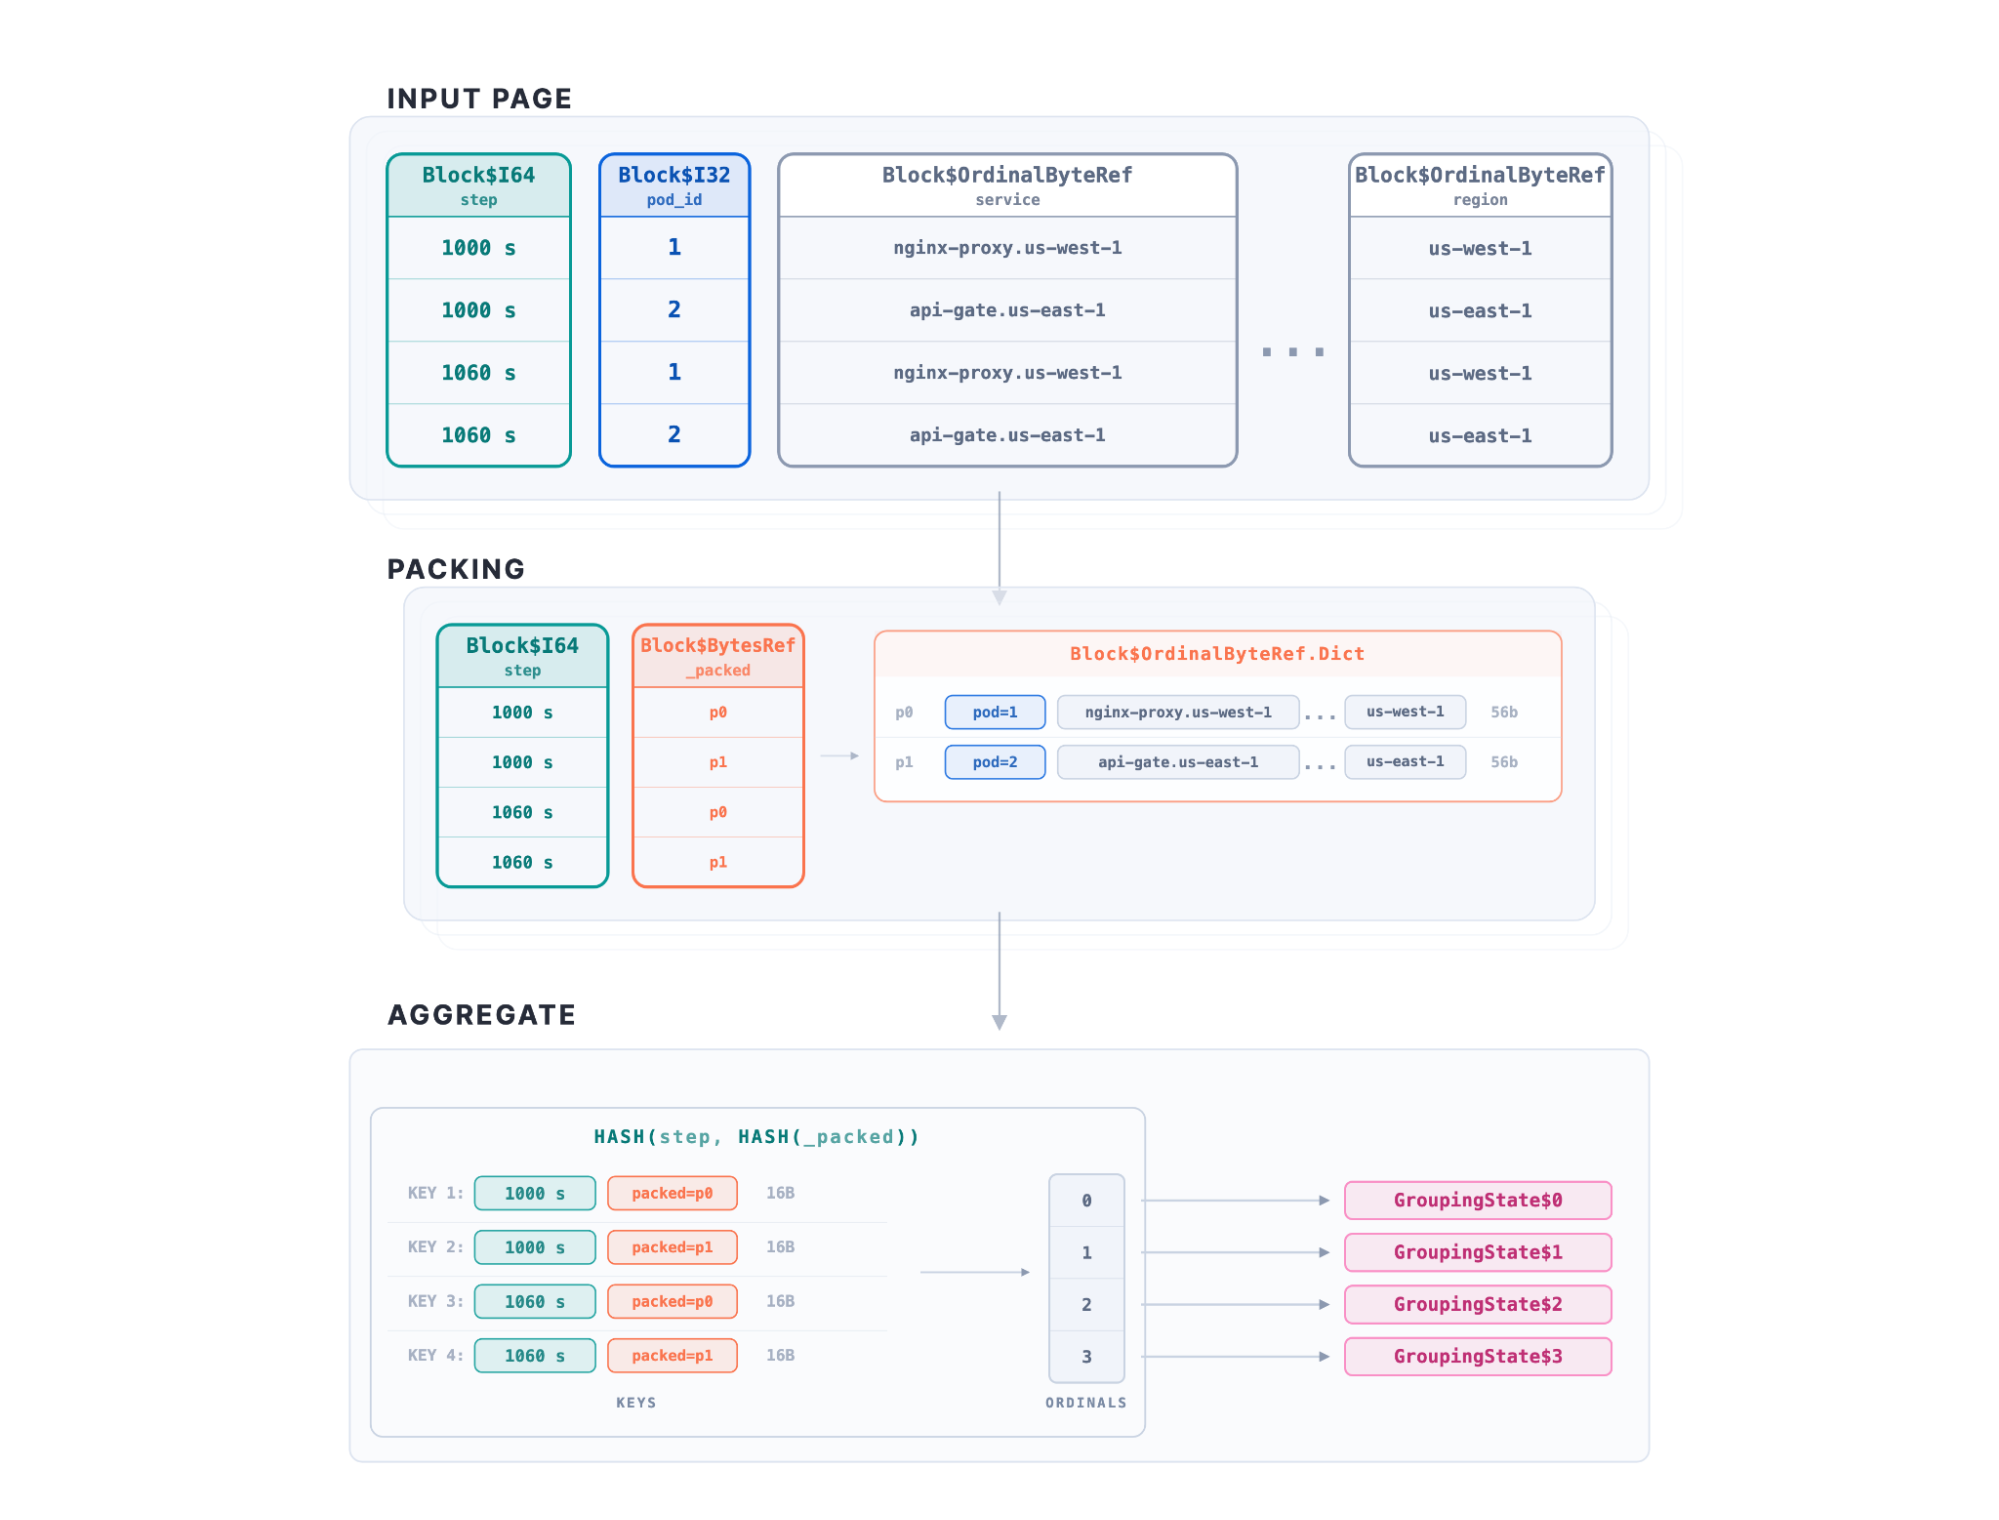
Dimension packing in Elasticsearch encodes PromQL grouping labels into one 16-byte key before hashing
打包使得哈希和比较可以操作单个紧凑键,而不是不断增加的分组块,从而使聚合开销对键宽度不那么敏感。因为引擎是共享的,ES|QL 时序查询也将受益于这一优化。
在管道内构建 Prometheus HTTP API 响应
与 Elasticsearch 的 ES|QL 列式响应格式不同,Prometheus 响应是行式的。Prometheus API 为每个时间序列返回一行结果,其样本表示为时间戳-值对。
为了支持兼容的 API 层,我们不得不在 HTTP 层进行重新分组,将列式结果转换为装箱的行对象,并在映射和列表结构中累积,直到可以生成完整的 Prometheus 响应。
我们用一个名为 TimeSeriesCollapse 的计算运算符替换了它。它将行按序列分组,并将样本对齐到查询的固定步长网格。它输出重塑后的结果作为普通的列式页面,每页包含每个序列一行,带有对齐的多值时间戳和值块。它还在整个管道中保持紧凑的向量化块表示:
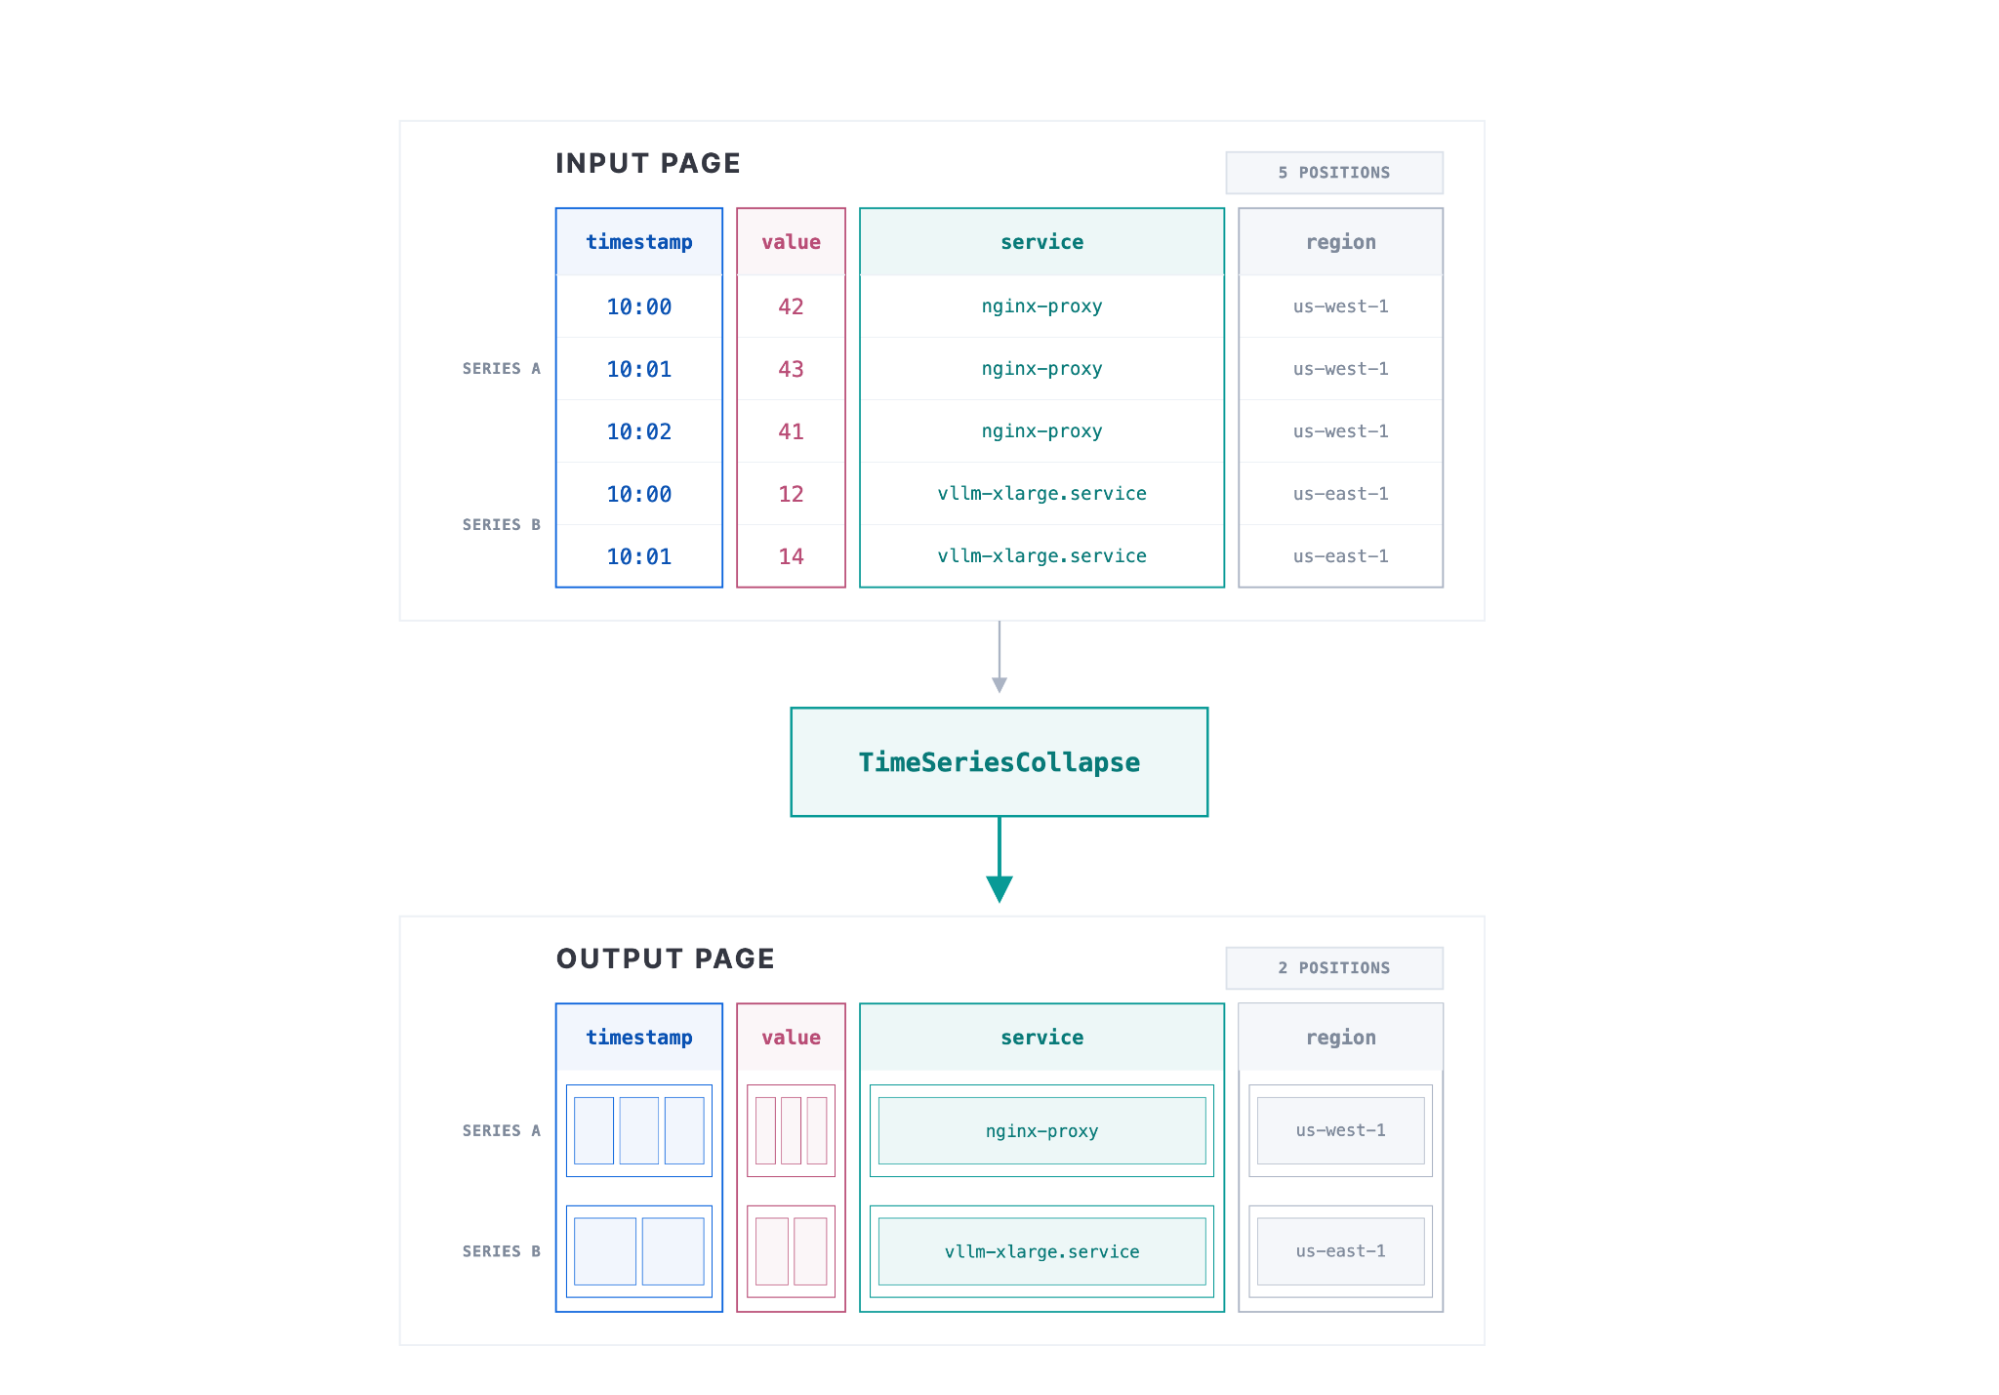
TimeSeriesCollapse operator reshapes five columnar rows into two Prometheus time series per output page
HTTP 层现在可以直接序列化这些块,避免了早期实现所需的映射、列表、装箱对象及相关分配。
针对 2000 个真实查询测试 PromQL 兼容性
Prometheus 合规测试 是我们的起点。
尽管它们为我们提供了强大的基线,但并未告诉我们各个 PromQL 特性在实际工作负载中出现的频率。为了补充该基线,我们从公共存储库收集了超过 2000 个 PromQL 查询,构建了第二个测试语料库。
然后,我们根据这些查询所使用的语言特性和表达式模式对其进行分类:
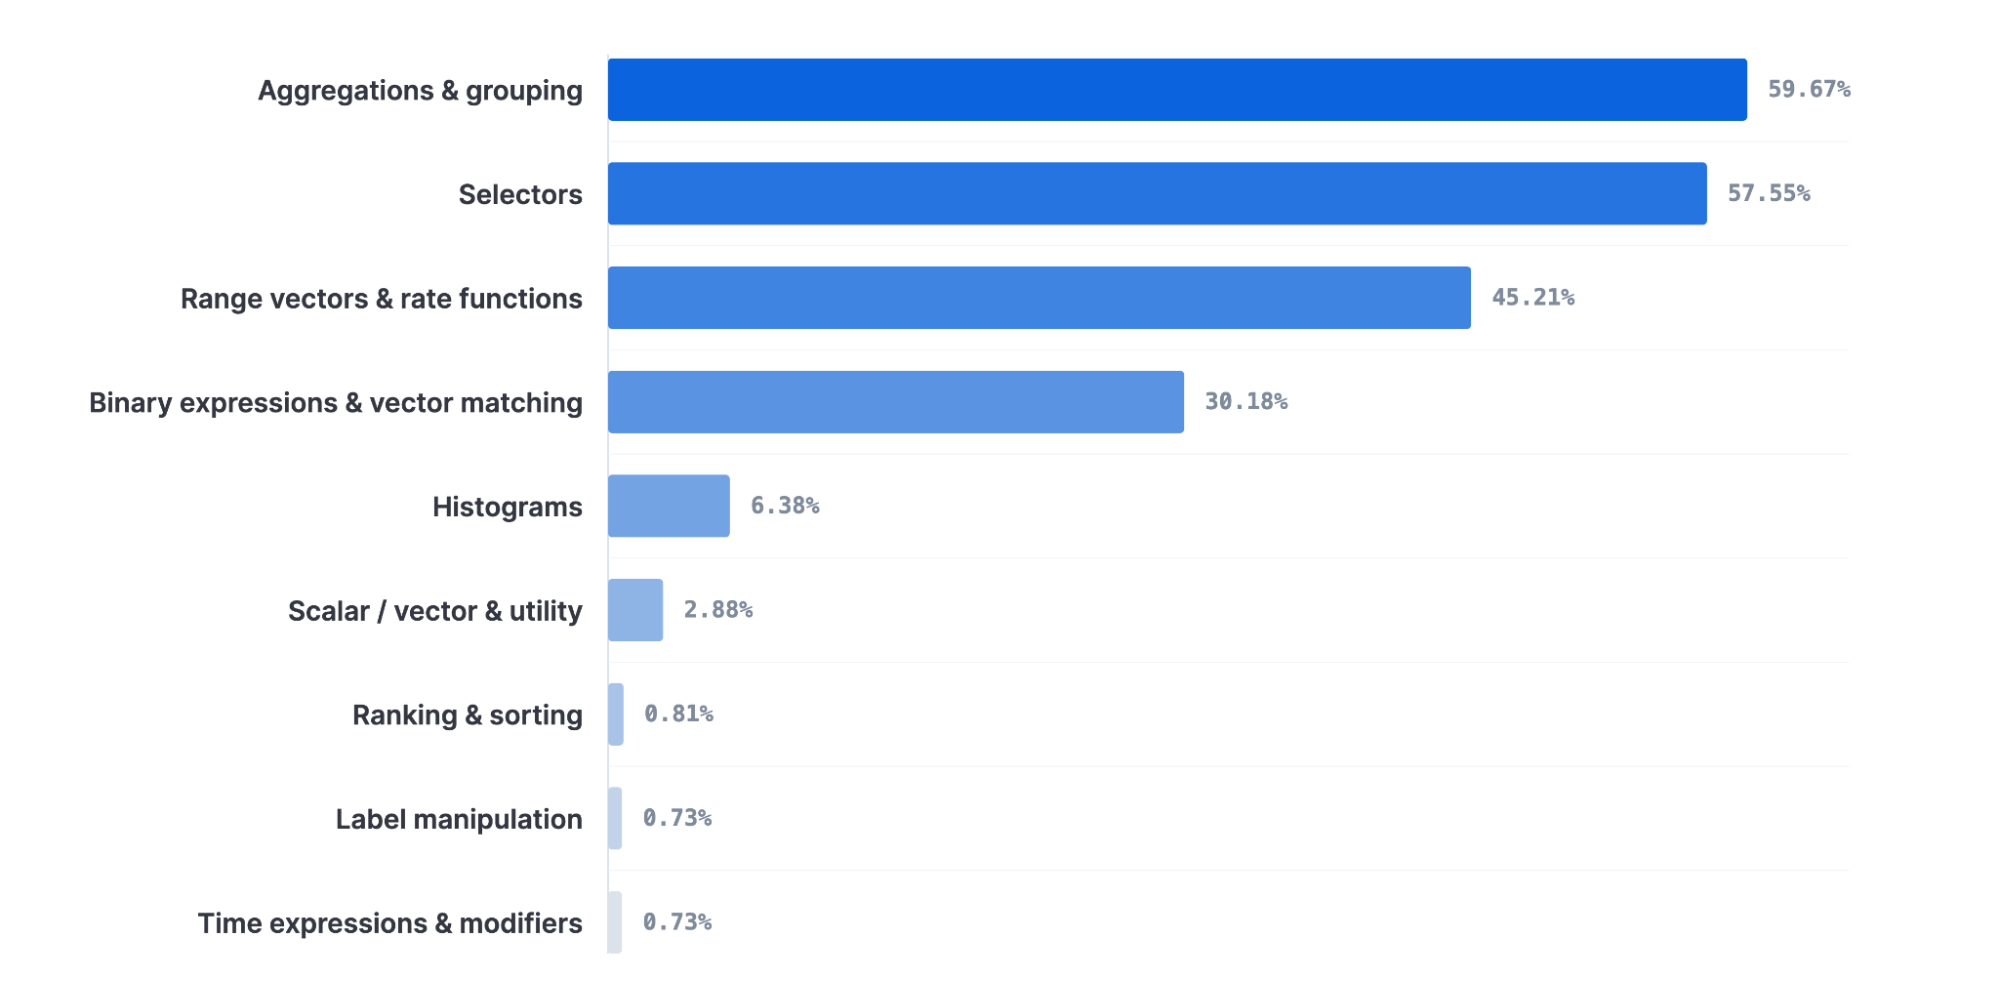
PromQL feature use across 2,000 real queries: aggregations 59.67%, selectors 57.55%, rate functions 45.21%
对于每种兼容的查询形状,我们在 Elasticsearch 和 Prometheus 上运行相同的查询并比较结果。
除此之外,我们还积极依赖 模糊测试,它可以捕获仅靠单元测试不太可能暴露的问题,包括时间戳对齐、标签保留、聚合行为、范围向量评估和响应编码方面的差异。
9.5 版本支持哪些 PromQL 函数和 API
自 9.4(技术预览版)以来,Elasticsearch 中的 PromQL 支持已大幅扩展。在 Elasticsearch 9.5 中,ES|QL 中的 PROMQL 命令和 Prometheus HTTP APIs 均已正式发布(GA),我们实际语料库中超过 80% 的 PromQL 工作流现在无需修改即可运行:
PromQL compatibility in Elasticsearch rising from zero to 80% between 9.4 Tech Preview and 9.5 GA
自技术预览版以来的主要新增功能如下:
特性 | 示例 | 状态 |
|---|---|---|
Prometheus remote write 采集 | POST /_prometheus/api/v1/write | 9.5 GA |
范围查询 | /api/v1/query_range | 9.5 GA |
即时查询 | /api/v1/query | 9.5 GA |
指标元数据和构建信息 | /api/v1/metadata, /api/v1/status/buildinfo | 9.5 GA |
原生直方图函数 | histogram_quantile, histogram_count, histogram_sum | 9.5 GA |
每个选择器的偏移修饰符 | 5m offset 1h | 9.5 GA |
顶级 or 运算符 | rate(a5m) or rate(b5m) | 9.5 GA,最多八个操作数 |
Prometheus remote write 采集
Elasticsearch 接受 Prometheus remote write (v1) 消息:
POST /_prometheus/api/v1/writeContent-Type:
application/x-protobufContent-Encoding: snappy
Snappy 压缩的 Protocol Buffer 消息被解码,标签映射到 TSDS 维度。指标名称和值写入时间序列索引。内置模板是动态的,因此用户无需预先声明每个 Prometheus 标签或指标。
通过 Prometheus HTTP API 进行范围查询和即时查询
范围查询和即时查询端点均已 可用:
GET /_prometheus/api/v1/query_range?query=...&start=...&end=...&step=15sGET /_prometheus/api/v1/query?query=up&time=...范围查询返回在时间窗口上评估的矩阵,即时查询返回在单个时间戳上评估的向量。这些端点可以被 Kibana、Grafana 或 Prometheus 兼容的告警工具以及自定义仪表盘使用。
指标元数据和构建信息端点
Elasticsearch 暴露 有关可用指标的元数据以及构建信息端点:
GET /_prometheus/api/v1/metadataGET /_prometheus/api/v1/status/buildinfo元数据端点返回指标类型和帮助文本,构建信息端点返回 Prometheus 兼容的服务器版本。Grafana 和其他工具使用这些端点进行特性检测和 UI 行为。
原生直方图函数:histogram_quantile, count, sum
Elasticsearch 支持原生直方图的主要 PromQL 操作:
histogram_quantile(0.95, http_request_duration_seconds)histogram_count(http_request_duration_seconds)histogram_sum(http_request_duration_seconds)原生直方图会根据数据调整其桶布局,在广泛的值范围内提供有用的精度,而无需用户预先配置每个桶边界。经典直方图仍可与原生直方图一起使用。
PromQL 中的每个选择器偏移修饰符
偏移修饰符将选择器的时间窗口向后移动:
rate(http_requests_total[5m] offset 1h)此查询返回一小时前的请求速率。每个选择器的偏移通常用于将当前流量、延迟或资源使用与早期基准(例如一周前的同一时间段)进行比较。
PromQL 中的顶级 or 运算符
Elasticsearch 支持顶级 PromQL or 运算符:
rate(http_requests_total[5m]) or rate(http_requests_legacy[5m])在 PromQL 中,or 不是布尔操作。它执行两组时间序列的并集。左侧的结果被保留;只有当右侧序列的标签集与左侧已返回的序列不匹配时,才会添加该序列。这在迁移期间很有用,因为同一逻辑指标可能同时存在于旧名称和新名称下。
该实现遵循 Prometheus 的左侧优先级规则,并保留 __name__ 标签。支持最多八个操作数的顶级链。
Elasticsearch 尚未支持的 PromQL 特性
GA 并不意味着完全的 PromQL 兼容性。一些不太常见且更复杂的 PromQL 部分仍不受支持。这些差距现在定义了下一阶段的工作:
特性 | 示例 | 状态 |
|---|---|---|
高级向量匹配 | on(instance) group_left | 计划中 |
排序和排名 | topk, bottomk, limitk, sort, sort_desc | 计划中 |
标签操作 | label_replace, label_join | 计划中 |
绝对时间修饰符 | @ 1710000000 | 计划中 |
混合偏移复合表达式 | rate(...) - rate(... offset 1h) | 计划中 |
告警和目标端点 | /api/v1/alerts, /api/v1/targets | 超出范围 |
带有 on() 和 group_left 的高级向量匹配
一些需要 Prometheus 向量匹配的二元操作尚未包含在 GA 中。
例如,以下查询将每个实例的请求速率除以每个实例的容量指标:
rate(http_requests_total[5m]) / on(instance) group_left machine_cpu_coreson(instance) 子句指定哪些标签标识匹配的序列。group_left 允许许多请求速率序列匹配单个每实例容量序列,同时保留来自高基数左侧的标签。
这些表达式在将详细指标与元数据或较低基数的容量指标连接时很常见。基础的二元操作在适用时受支持,而剩余的向量匹配形式是计划中的工作。
排序和排名:**topk**, bottomk******,**** sort**
Prometheus 排序和排名函数也尚未包含在 GA 中:
topk(10, sum by (service) (rate(http_requests_total[5m])))此查询返回请求速率最高的 10 个服务。类似的查询广泛用于流量、延迟、错误和资源消耗的“首要违规者”仪表盘。
其余函数包括:
topk(10, ...)bottomk(10, ...)limitk(10, ...)sort(...)sort_desc(...)使用 label_replace 和 label_join 进行标签操作
PromQL 可以在查询评估期间构造或重写标签。这些函数在仪表盘变量、命名约定或标签模式不完全匹配时特别有用:
label_replace( up, "environment", "$1", "cluster", "^(prod|staging)-.*$")这会从 cluster 标签创建 environment 标签。
另一个常见示例将现有标签组合成面向显示的标签:
label_join( up, "target", "/", "namespace", "pod")这会生成一个 target 标签,例如 payments/api-7f6d9。label_replace(...) 和 label_join(...) 尚未包含在 GA 中。
高级时间修饰符:**@** 修饰符和混合偏移
几种高级时间修饰符和表达式形式仍在 GA 范围之外。
例如,绝对 @ 修饰符在固定的 Unix 时间戳处评估选择器,而不是在查询的正常评估时间:
rate(http_requests_total[5m] @ 1710000000)这对于与固定历史点进行比较很有用。
PromQL 还允许表达式中两侧使用不同的偏移:
rate(http_requests_total[5m]) - rate(http_requests_total[5m] offset 1h)这将当前流量与一小时前的流量进行比较。每个选择器的 offset 在 GA 中可用,但并非所有偏移和复合表达式的组合都在 GA 中。
尚未实现的 Prometheus API 端点
此外,Prometheus HTTP API 表面尚未完全完成。值得注意的是:
通过以下方式获取告警元数据:
/api/v1/alerts由检查活动告警状态的工具使用。
通过以下方式发现目标:
/api/v1/targets用于检查抓取目标、健康状态和标签。
这些端点涉及 Prometheus 服务器和抓取目标状态,而不是查询存储在 Elasticsearch 中的指标。
有关限制的完整列表,请参阅 PromQL 限制 页面。
在 Elasticsearch 9.5 中尝试 PromQL
要在 Elasticsearch 9.5 或 Serverless 中查询 Prometheus 指标,请参阅 PromQL 文档 和 Prometheus HTTP API 参考。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号