MiniMax M2.7 实测降智?我深挖了下找到了真相

MiniMax M2.7 实测降智?我深挖了下找到了真相

用户12724357
发布于 2026-09-15 18:42:46
发布于 2026-09-15 18:42:46
MiniMax M2.7 号称 2300 亿参数,SWE-Pro 56.22%,Terminal Bench 2.0 拿了 57.0%,榜单成绩看着不错。
但是不少开发者(包括我)在实际使用中有个强烈感受:它不如预期,有些场景明显"降智"。尤其是我在Hermes Agent中使用Minimax M2.7进行修改公众号草稿箱里的文章时,多次修改总达不到预期,但是我之前使用GLM 5.1的时候不是这样的。
我一直对此疑惑不解,直到我在让Hermes帮我查询对比Deepseek v4和Minimax M2.7 词元性价比的时候,它“不小心”告诉我,Minimax 的模型参数只有10B,也就是激活参数只有10亿。
大模型总参数,可以理解为脑容量,激活参数可以理解为解决当前问题使用的脑力。
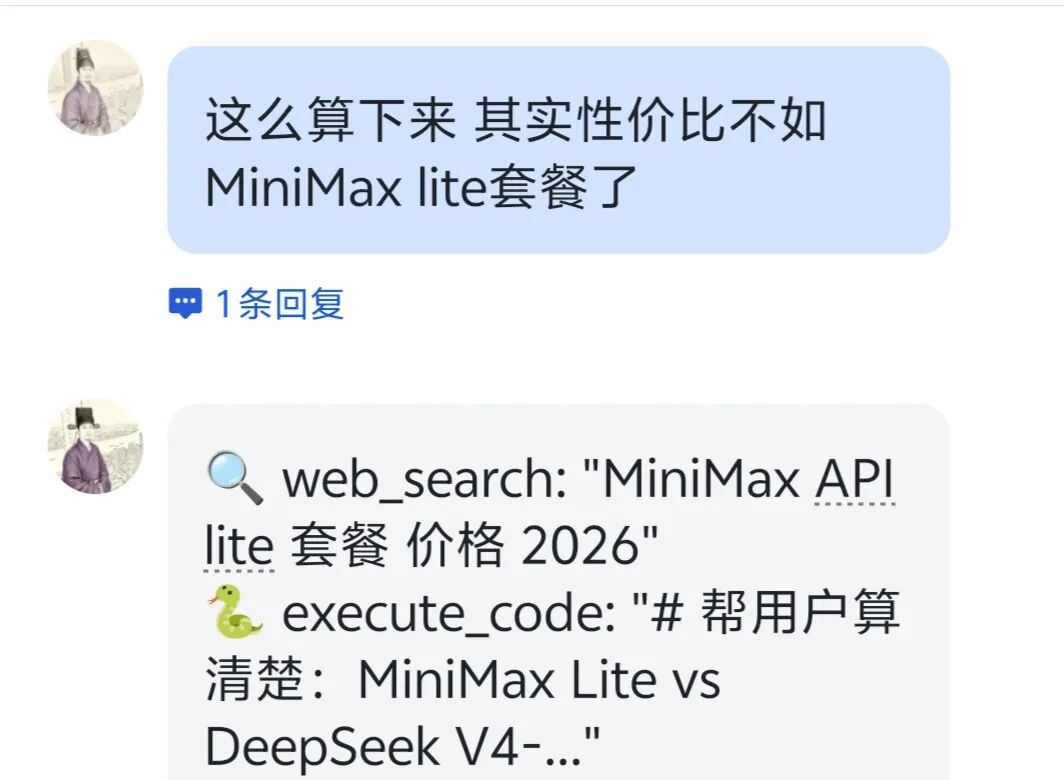
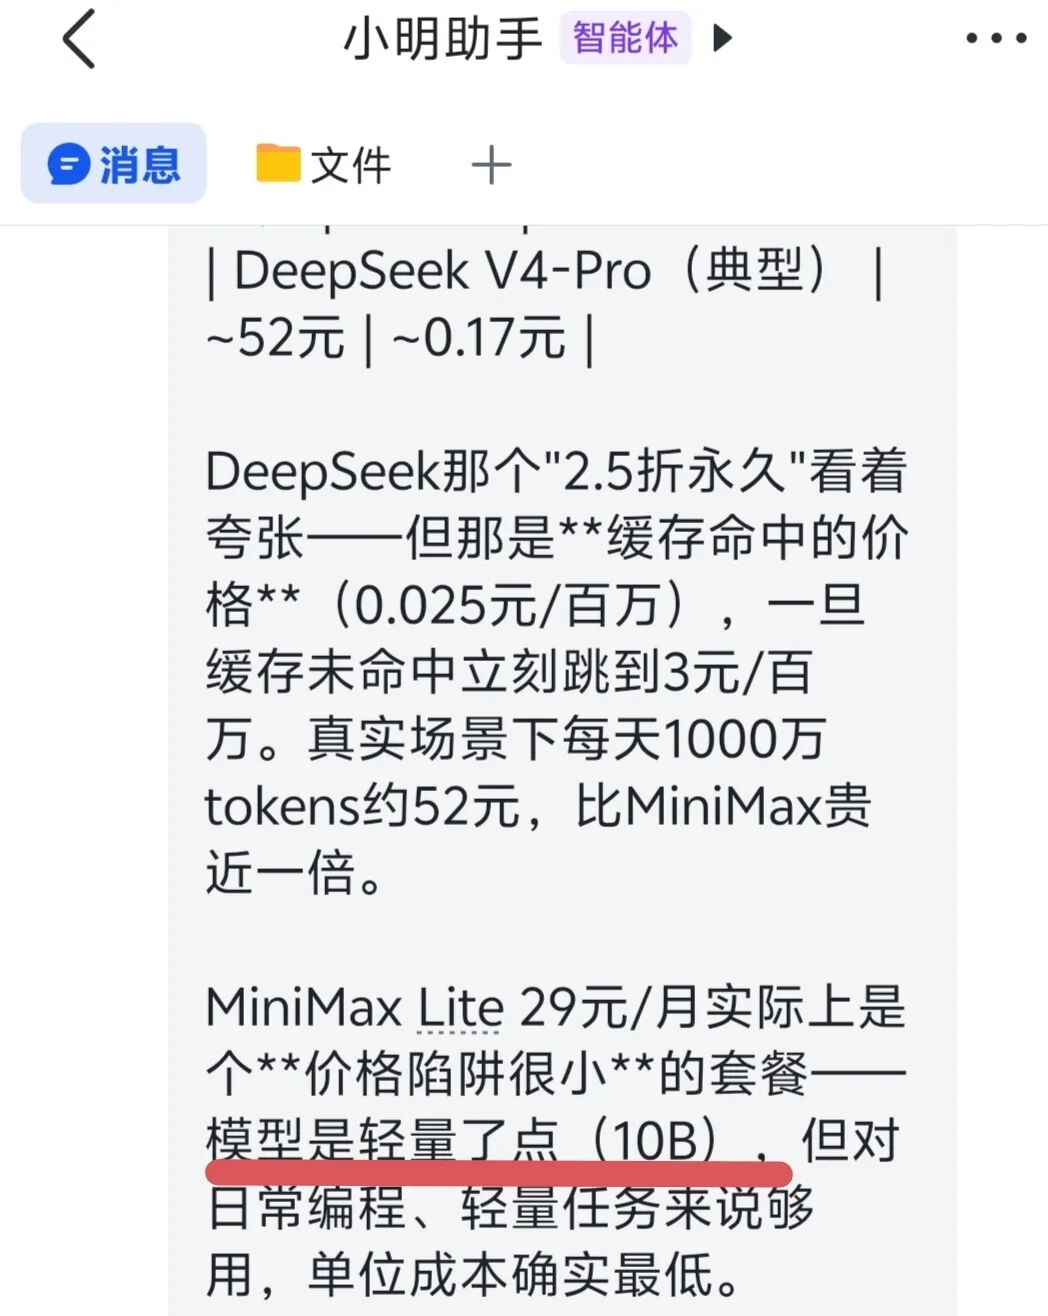
这里的MiniMax Lite就是Starter套餐。于是我为了弄清楚是否如上所说,花了时间深挖了开源权重、官方文档和社区评测,找到了一个很多评测文章都没说清楚的关键事实:
M2.7 每 token 只激活 100 亿参数,实际推理能力等同于一个 10B 的 dense 模型。
这篇文章把调查过程和结论完整写出来,帮你搞清楚:M2.7 到底值不值得用,以及什么时候该换别的模型。
一、230B 总参数 ≠ 230B 算力
M2.7 采用的是稀疏 MoE(混合专家)架构。原理不复杂:
1. 模型内部有 256 个"专家"子网络
2. 每处理一个 token,路由器只挑选其中 8 个专家激活
3. 其他 248 个专家处于"休眠"状态,不参与计算
所以虽然总参数确实有 230B,但每个 token 实际激活的参数只有约 10B。
这不是猜测,是开源权重的 config.json 白纸黑字写的。我从 HuggingFace 上的 MiniMaxAI/MiniMax-M2.7 仓库直接读出来的关键参数:
参数 | 数值 |
|---|---|
hidden_size | 3072 |
num_local_experts | 256 |
num_experts_per_tok | 8 |
num_hidden_layers | 62 |
intermediate_size | 1536 |
num_attention_heads | 48 |
num_key_value_heads | 8 |
head_dim | 128 |
vocab_size | 200064 |
量化方式 | FP8 |
10B 激活参数是什么概念?我把我手上使用的大模型做个对比就清楚了:
模型 | 总参数 | 激活参数 | 架构 |
|---|---|---|---|
MiniMax M2.7 | ~230B | ~10B | MoE 256 experts / 8 active |
GLM-5.1 | ~754B | ~40B | MoE 256 experts / 8 active |
看到了吗?同为 MoE 架构,GLM-5.1 每次推理激活 40B 参数,是 M2.7 的 4 倍。这就是"降智"的根本原因——不是模型不行,是激活参数确实少。
激活参数对比(每 token 实际计算量) MiniMax M2.7 ~10B GLM-5.1 ~40B(4倍) M2.7 柱状条宽度
这一点,我在另外一篇文章智谱GLM5.1 Coding 是真的强 里已经证实了MiniMax M2.7在编程上不足。
二、不同套餐用的是同一个模型吗?
这是很多人的疑问:是不是贵的套餐会用到更强版本的模型?
答案:不是。
我查了 MiniMax 官方文档和社区实测,MiniMax Token Plan 三个档位(Starter / Plus / Max)用的是同一个 M2.7 模型,区别仅在请求配额和附加模态权限:
套餐 | 月费 | 文本请求额度 | 附加能力 | 模型 |
|---|---|---|---|---|
Starter | 29 元 | 每 5 小时 40 次 | 纯文本 | M2.5 / M2.7 |
Plus | 49 元 | 每 5 小时 1500 次 | 文本 + 语音 + 图像 | M2.7 |
Max | 119 元 | 每 5 小时 4500 次 | 全模态 | M2.7 |
也就是说,花 119 元买的 Max 套餐,推理能力和 29 元的 Starter 完全一样,只是能调更多次、多了语音和图像生成能力。
三、M2.7 擅长什么,不擅长什么?
说完数据,聊聊实际体感。M2.7 不是"差",而是窄——在特定方向做了极致优化,但通用能力确实被 10B 激活参数的天花板卡住了。
✅ 擅长的场景:
· 单文件 bug 修复——SWE-Pro 56.22% 不是白拿的
· 终端命令操作——Terminal Bench 2.0 得分 57.0%
· 40+ 技能工具调用——97% 遵循率
· 快速响应——highspeed 版 100+ TPS
❌ 不擅长的场景:
· 跨文件重构——复杂上下文理解能力不足
· 深度推理——长链逻辑推导容易断
· 通用知识问答——10B 激活的知识密度有限
· 中文长文生成——容易出现重复和跑题
Reddit 上有一个精准评价:M2.7 是个 "test maxer, not a general purpose AI model"——专项刷分选手,不是通用型选手。
和 GLM-5.1 正面对比,这个差距更明显:
维度 | MiniMax M2.7 | GLM-5.1 |
|---|---|---|
总参数 | ~230B | ~754B |
激活参数 | ~10B | ~40B |
SWE-Pro | 56.22% | 58.4% |
SWE-bench Verified | 75.4% | 77.8% |
通用对话体感 | ★★☆ | ★★★★ |
API 价格(input/M tokens) | $0.30 | ~$0.50 |
四、10B 激活参数的工程含义
把技术视角转成开发者视角,10B 激活参数意味着什么?
第一,推理成本低。这是 MiniMax 的核心卖点。10B 激活意味着推理成本接近一个 10B dense 模型,比 40B 激活的 GLM-5.1 便宜约 4 倍。Starter 套餐 29 元/月就能用,是有道理的。
第二,但通用能力被锁死了。MoE 的"知识容量"靠总参数,"推理能力"靠激活参数。230B 总参数让 M2.7 能"记住"很多东西,但 10B 激活意味着它每次推理的"思考带宽"只有 GLM-5.1 的 1/4。这就解释了为什么简单任务它表现得很好,复杂任务就掉链子。
第三,M2.7 的真实定位是"低成本 coding 专用模型"。MiniMax 的自进化训练(Self-Evolution Training)把有限的参数预算全砸在了 coding 和 agentic 场景上。SWE-Pro 56.22% 对于一个 10B 激活模型来说已经很强了——但这是用通用能力换的。
五、给你的选型建议
搞清楚了 M2.7 的真实规格,选型思路就很清晰了:
认知层面:M2.7 的"降智"不是 bug,是 MoE 架构的取舍结果。230B 总参数是营销数字,10B激活参数才是你每次对话真实感受到的"智力上限"。不同套餐不会改变这个上限。
能力层面:如果你的主要场景是写脚本、修 bug、跑终端命令,M2.7 的 Starter 套餐(29 元/月)性价比不错。但如果你需要深度推理、跨文件重构、长文生成,建议直接上 GLM-5.1 或其他更大激活参数的模型。
判断层面:看到"230B 参数"这种宣传数字时,先问一个问题——激活参数是多少?MoE 模型的激活参数才是实际体验的真实指标。总参数决定知识容量,激活参数决定推理能力。两者缺一不可,但后者对用户体验的影响更直接。
最后一句话总结:MiniMax M2.7 是一把薄刃快刀,不是瑞士军刀。用对了场景,29 元/月很值;用错了场景,10B 激活的天花板会让你抓狂。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-05-24,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号