Graphify 在 SAN 项目中的实战:用知识图谱开发实时上下文用量状态栏

Graphify 在 SAN 项目中的实战:用知识图谱开发实时上下文用量状态栏

用户12724357
发布于 2026-09-15 19:01:21
发布于 2026-09-15 19:01:21
一、Graphify 在 SAN 项目中的实际应用
我在之前的一篇文章里介绍了开源项目SAN:用Graphify图形化知识图谱,加速开发效率,这篇文章是我在这个项目中实践了 Graphify,主要用它来解决一个具体问题:实现实时上下文用量状态栏。
1.1 问题场景
我要在 SAN 的状态栏里显示 token 使用情况。这个项目有 487 个 Go 文件,分布在渲染、状态管理、LLM 提供者、流处理四个子系统里。
用传统方法,我需要:
· 在 487 个文件中 grep "status"
· 逐个阅读相关文件
· 猜测哪些文件有关联
· 再 grep 另一个关键词,再来一轮
1.2 Graphify 的解法
我先运行 /graphify . 构建了整个项目的知识图谱(7,123 个节点、13,775 条边、487 个社区),然后在Claude Code 终端窗口里用自然语言告诉它
Read@
notes/completed/status-bar-context-usage-plan.md
, Implement the feature using the tool graphify
status-bar-context-usage-plan.md是我正式开发前,用superpowers skill做的一个关于实时显示上下文用量状态栏的开发计划。
它会自己查询:
/graphify query "status bar rendering flow"图谱直接告诉我:RenderModeStatus()、renderModelWithTokens、OperationModeParams 这几个节点都在图里,关键入口在 internal/app/conv/message.go:45。
不需要 grep 486 个文件,图谱直接指路。
再追踪 token 流转路径:
/graphify path "InferResponse" "RenderModeStatus"图谱给出完整链路:StreamChatCompletions → State.UpdateUsage → InferResponse.InputTokens → OnTokenUsage → env.InputTokens → RenderModeStatus
1.3 实际改动
最终这个状态栏功能涉及 13 个文件、695 行新增代码,横跨 4 个子系统:
渲染层:4 级颜色编码(正常/警告/紧张/超限)
状态管理:token 压缩徽章
LLM 提供者:token 分配器
流处理:实时用量更新
最终开发出来的效果如下:
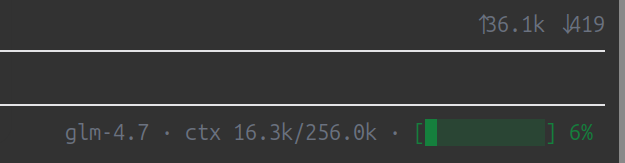
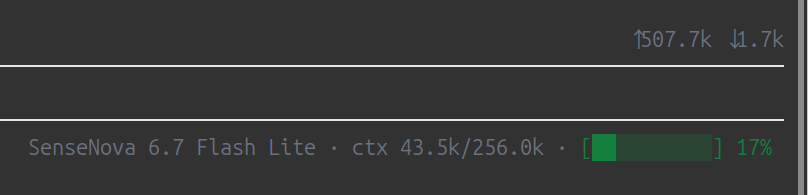
二、Token 经济账:省了多少上下文
这是最直观的数据。下面是传统 grep+Read 模式和 Graphify 查询模式的对比:
导航任务 | grep+Read 轮次 | 上下文 Token | Graphify 查询 | 上下文 Token |
|---|---|---|---|---|
找到渲染入口 | 3–4 轮 | ~8k | 1 次查询 | ~2k |
追踪 token 流 | 5–6 轮 | ~12k | 1 次查询 | ~2k |
找到所有 compact site | 4–5 轮 | ~10k | 1 次查询 | ~2k |
合计 | ~12 轮 | ~30k | 3 次查询 | ~8k |
光导航环节就省了 ~22k token,差不多抵消了一次完整的 LLM 推理轮次的纯搜索开销。
而且这个图是一次构建、多次使用的——建好之后每次查询都复用同一个图数据,不需要每次都重新读文件。
三、PR #181 为什么没被合并
我把 Graphify 的图谱数据和状态栏功能一起提了 PR #181(https://github.com/genai-io/san/pull/181) 到 SAN 项目,但最终没有被合并。原因很有代表性:
3.1 放弃合并理由
外部依赖:Graphify 是 Python 工具,SAN 是纯 Go 项目,引入外部依赖增加摩擦
仓库膨胀:230K+ 行的生成 JSON/HTML 文件,这些是构建产物,不是源代码
维护负担:图谱很快会过时。没有 CI 集成,每次代码变更都需要手动重新提取
工具 vs 产品:它是个人开发效率工具,不是面向用户的功能
语言噪音:中英双语文档在一个英文优先的项目里显得多余
3.2 个人建议
保留 docs/graphify-usage 分支作为个人参考
从 GRAPH_REPORT.md 中提取架构(核心节点、社区结构、依赖模式),融入现有文档
在 .gitignore 中忽略 graphify-out/ 目录
四、我的取舍与建议
经过这次实践,我对 Graphify 在真实项目中的使用有以下体会:
什么时候该用
大型代码库首次上手:项目超过1000个文件,第一次看源码时,Graphify 的图谱能快速帮你建立全局认知
跨模块调试:当一个功能涉及多个子系统的代码,传统 grep 像大海捞针时,图谱能直接给出调用链
架构理解:想知道"谁调用了谁"、"核心模块有哪些"、"代码是怎么组织的",图谱一目了然
AI编程助手的上下文优化:如果你的AI编程工具(Claude Code、 Codex、Opencode 等)上下文窗口有限,用 Graphify 构建一次图谱,之后每次查询都省大量 token
什么时候不该用
小型项目:几百个文件的项目,直接 grep 更快
频繁变动的代码库:如果一天内代码结构大变,图谱可能刚建好就过时了
需要提交到仓库的产物:生成的图谱文件不应该纳入版本控制(PR #181 被拒的核心原因之一)
最佳实践
1.本地使用,不入仓库:把 graphify-out/ 加入 .gitignore,图谱是个人生产力工具,不是项目交付物
2.定期重建:大改代码后重新跑一次 /graphify .
3.善用 QUERY 和 PATH 命令:自然语言查询比 grep 高效得多,路径查询能精确定位两个模块间的调用链
4.结合 GRAPH_REPORT.md:分析报告里的"上帝节点"和"意外连接"经常能揭示你没预料到的架构事实
五、知道这些,对你有什么用?
认知层面:AI 编程工具最大的瓶颈不是模型不够聪明,而是上下文窗口太小。Graphify 的本质是把"让 AI 读遍所有文件"变成了"让 AI 查一张地图"——这是一个范式转变。
能力层面:如果你在用 Claude Code、Codex、OpenCode 或 Hermes Agent 编程,花 2 分钟装一下 Graphify:
uv tool install graphifyy
graphify install
/graphify .
然后试试 /graphify query "你的问题",你会发现以后不再需要 grep 整个项目了。
判断层面:Graphify 是个人工具,不是项目功能。它适合放在本地 workflow 里用,不适合提交到仓库里当交付物。理解了这一点,你就知道什么时候该用、怎么用好它。
就像你不需要把地图打印出来贴在墙上——知道地图在那里,用的时候查一下就够了。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-06-16,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号