Hermes MoA实测:三个弱模型组团,能打赢一个强模型吗?

Hermes MoA实测:三个弱模型组团,能打赢一个强模型吗?

用户12724357
发布于 2026-09-15 19:08:13
发布于 2026-09-15 19:08:13
三个臭皮匠,能顶个诸葛亮吗?
最近 Hermes Agent 更新了一个新功能——Mixture of Agents(MoA,混合智能体)。
简单说就是:让多个 AI 模型先各自独立思考,再由一个"汇总模型"把它们的回答综合成最终答案。
我一听介绍,这个好啊,思路直觉上很合理——多几个脑袋总比一个强。但实际效果到底怎么样?我用自己的 Hermes Agent 环境做了三轮实验,用了三种测试题、多组模型组合,直接对比 MoA 和单模型的真实差距。
结论先说:有些场景确实有提升,但坑也不少。
下面从"好在哪、坑在哪、适用边界"三个角度拆解。
先说实验怎么做的
MoA 的机制很简单:你问一个问题,Hermes 先把问题同时发给 N 个"参考模型"(reference models),它们各自独立思考、给出自己的分析和答案。然后一个"汇总模型"(aggregator)拿到所有参考回答,综合出最终结果。
为了全面测试 MoA 的能力边界,我设计了三道测试题,每道题考察不同维度:
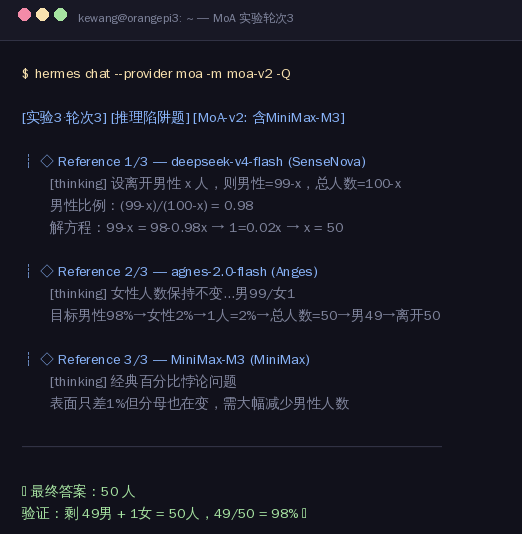
推理陷阱题:"房间100人,99%是男性,要让男性比例变成98%,需要多少人离开?"——正确答案是50,但直觉上会以为是1。考察纯逻辑推理和抗干扰能力。
算法编码题:用 Python 实现 LRU Cache,要求 get 和 put 操作都是 O(1) 时间复杂度。考察代码正确性、测试覆盖、复杂度分析。
行业分析题:分析2025年上半年中国AI大模型三大趋势,每个趋势给出标志性事件。考察知识储备和事实准确性——这道题是检验模型知识天花板的试金石。
然后做了三轮实验。
第一轮快速验证 MoA 功能是否正常,用一个简单乘法题跑通流程。
第二轮用纯弱模型组合(SenseNova 的 deepseek-v4-flash + Anges 的 agnes-2.0-flash),对照组是 GLM 5.2 和 MiniMax M3 单独运行。
第三轮加入 MiniMax 进参考池,aggregator 换成 GLM 5.2,看看"加了强模型进参考池"和"强模型单独跑"到底差多少。
好在哪:过滤错误 + 视角多元
第一个好处是自动过滤错误答案。
第二轮推理陷阱题里,Anges 模型答错了——它说"不需要任何人离开房间"。但 aggregator 成功识别并丢弃了这个错误参考,最终给出了正确答案 50。这说明 MoA 的汇总模型确实有"纠错"能力,不是简单地把所有参考答案拼在一起。
第二个好处是视角多元。编码题里,deepseek-v4-flash 偏好手写双向链表,agnes 给了带哑节点的方案,MiniMax 则推荐了 OrderedDict 简洁写法。aggregator 把三种思路综合后,O(1) 复杂度的解释比任何单个模型都全面——它从"为什么不用单向链表"到"为什么需要哨兵节点"都覆盖了。
第三个发现更有意思:在第三轮实验中,加入 MiniMax 进参考池后,弱模型的知识盲区被修复了。第二轮纯弱模型组合时,行业分析题的标志性事件全部是编造的——两个弱模型都不知道 2025 年 1 月 DeepSeek R1 的发布。加入 MiniMax 后,这个关键事件被准确捕获,而弱模型编造的那些假事件("百度 VidGen""手机内置千亿参数模型")被 aggregator 全部过滤掉了。
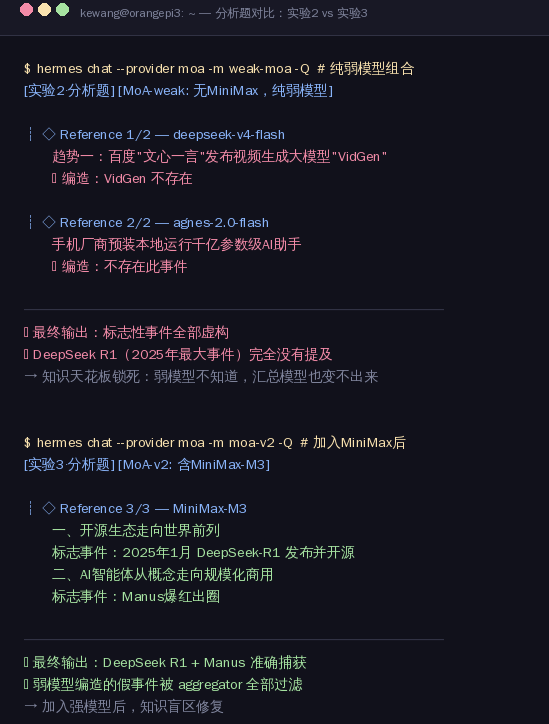
这就是 MoA 最有价值的时刻:多个模型交叉验证,正确的信息被保留,错误的被淘汰。
坑在哪:三个硬伤
第一个坑:知识天花板锁死。
MoA 的知识上限等于参考池里最强模型的知识上限。第二轮纯弱模型组合中,两个弱模型都不知道 DeepSeek R1,aggregator 也变不出来——你不能指望三个不知道答案的人讨论出一个正确答案。加入 MiniMax 后问题才解决,但这时候你已经在用强模型了,MoA 的意义就打折扣了。
第二个坑:延迟爆炸。
每个问题要等 N 个参考模型全部跑完,aggregator 才能开始工作。3 个 reference 的 MoA 延迟大约是单模型的 3-4 倍。在 Agent 框架里更严重——如果任务需要多轮对话迭代,每轮都要跑一遍 reference,延迟成倍放大。第二轮的编码题甚至因为反复调用参考模型而直接卡死超时。
第三个坑:成本和收益不对等。
第三轮实验中,MoA(reference 含 MiniMax M3,aggregator 用 GLM 5.2)对比 GLM 5.2 单独运行:推理题和编码题质量持平,分析题 GLM 5.2 单独的数据反而更精确(日期到天、金额到万)。但 MoA 的 token 消耗是单模型的 4-5 倍。花 5 倍的钱,买不到明显更好的结果。
适用边界:什么时候值得用
基于这三轮实验,MoA 真正有价值的场景很窄:
值得用的场景:纯推理和逻辑题(不依赖知识储备),用多个不同厂商的强模型互为参考,捕获各自盲区。比如 GLM 擅长中文、DeepSeek 擅长代码,组合后可能覆盖更多角度。但前提是参考池里要有强模型——纯弱模型组合意义不大。
不值得用的场景:需要事实性知识的任务(行业分析、新闻解读),因为知识天花板锁死;需要多轮迭代的 Agent 任务,因为延迟会成倍放大;日常简单问答,因为成本完全不值。
一句话总结:MoA 不是"三个臭皮匠顶个诸葛亮",更像是"诸葛亮带上几个参谋"——参谋得够强才行,而且诸葛亮一个人也够用了。如果你手里已经有了 GLM 5.2 或 MiniMax M3 这个级别的模型,直接用就好,MoA 的增量价值目前不值得 5 倍的成本。
写在最后
MoA 是一个设计思路很好的功能——多模型协作、交叉验证、视角整合,这些方向都没错。但在当前模型能力分布下,它的价值窗口很窄。
如果你手头只有弱模型,MoA 能帮你在纯推理题上提升一点鲁棒性,但解决不了知识盲区。如果你手头有强模型,直接用就好。
真正值得期待的是未来:当不同厂商的强模型各有所长(比如 GLM 的中文理解、DeepSeek 的代码能力、MiniMax 的多模态),MoA 可能成为"取各家之长"的有效手段。但那需要参考池里每个模型都足够强,而不是用弱模型凑数。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-07-06,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号