工信部发风险提示,阿里全面禁用,为什么我们还是离不开Claude Code?我实测Kimi Code vs Claude Code的结果说明了真相

工信部发风险提示,阿里全面禁用,为什么我们还是离不开Claude Code?我实测Kimi Code vs Claude Code的结果说明了真相

用户12724357
发布于 2026-09-15 19:09:00
发布于 2026-09-15 19:09:00
2026年7月8日,工信部发布了一则风险提示。
网络安全威胁和漏洞信息共享平台(NVDB)监测发现,AI编程工具 Claude Code 存在安全后门隐患,受影响版本为 2.1.91 至 2.1.196,建议立即卸载或升级、加强外联权限管控。
阿里巴巴从今天7月10日起全面禁用 Claude Code,列入高风险软件名单。在此之前,这款工具已被曝出通过隐写术——修改系统提示词中日期格式的标点符号——向服务器标记中国用户。
消息一出,大量开发者涌入国产替代方案的讨论帖。阿里推荐 Qoder,月之暗面推出 Kimi Code CLI,字节跳动力推 Trae,智谱发布了 Z Code 3.0。看起来,"国产替代"已经万事俱备。
但问题远没有这么简单。
先说结论

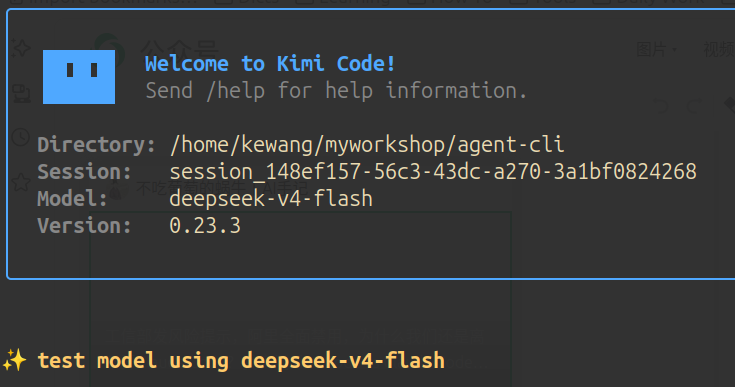
我做了一次对照实验。同一个底层模型(DeepSeek V4 Flash 1MB上下文),分别跑在 Claude Code 和 Kimi Code CLI 上,设计了六组实验,涵盖项目记忆、子代理隔离、上下文恢复、技能触发、权限控制、事件钩子。然后让两个 Agent 互相测试对方——先各自测自己擅长的部分,再互换测试报告补充短板,做交叉验证。
实验结论可以浓缩成一句话:
不是国产 CLI 不好用,而是 Claude Code 的工程护城河太深了。深到你换掉它的代价,不是损失 10% 的效率,而是丢掉一整套让 AI 能稳定干活的操作系统。
这个"操作系统"有个正式的名字,叫做 Harness Engineering——驾驭工程。2026年它已经和提示词工程、上下文工程并列,成为 AI 编程领域的第三个支柱。
先说一个让人震惊的数字。Claude Code 整个代码库有 51.2 万行 TypeScript 源码。今年4月因为一次意外的 Source Map 打包失误,完整源码在公网暴露了几个小时。社区研究者逆向分析后发现了一个惊人的事实:
只有约 1.6% 是"AI决策逻辑",其余 98.4% 是确定性的运行环境——权限控制、上下文管理、工具路由、故障恢复。
换句话说,Claude Code 真正的强大之处,不在于那个会思考的大脑(模型),而在于包裹大脑的那套精密工程。你换掉 Claude Code 客户端,丢掉的不是 1.6% 的智能,而是 98.4% 的工程基础设施。
这就是为什么即使它出了安全后门事件,即使工信部发了风险提示,即使阿里全面禁用,大量开发者依然"离不开它"的真正原因。

我做了什么
实验设计很直白:把"大脑"(模型)这个变量固定下来,只对比"身体"(客户端工程)的差异。
同一个底层模型 DeepSeek V4 Flash(通过 SenseNova API),分别跑在 Claude Code v2.1.118 和 Kimi Code CLI v0.23.3 上。每次测试时,两套环境完全独立,各自有独立的 Git 仓库、独立的配置文件、独立的项目目录。唯一相同的是那个"大脑"。
六组实验覆盖了 AI 编程工具的全部核心工程能力:
实验一,项目级记忆。在项目根目录写一个配置文件,里面放三条特殊规则:接口用 snake_case 命名、错误统一用 AppError 类、日志必须走 structured_logger。然后让 Agent 写一个新接口,看它能不能在不提醒的情况下自主遵循规则。
实验二,子代理隔离。创建一个"只读探查员"子代理,只给它读文件和搜索的权限。让它去分析代码,看看它会不会忍不住偷偷改文件。
实验三,上下文恢复。丢给它一个 5000 行、324KB 的大文件,看它能不能完整分析完,分析得准不准。
实验四,技能自动触发。装一个"中文 Conventional Commits"技能,让 Agent 提交代码,看它能不能自动生成规范格式的中文提交信息。
实验五,权限控制。看两个工具能不能做到工具级别的细粒度权限管理——比如允许读文件但禁止执行 shell 命令。
实验六,事件钩子。在工具执行前后插入自定义脚本,看能不能拦截到每一次操作,做审计或安全扫描。
但最有意思的不是实验本身,而是测试过程。
第一轮测试,我让 Kimi Code 去测试 Claude Code,让 Claude Code 去测试 Kimi Code。结果发现了一个有趣的现象:每个 Agent 都"自家人知自家事"。
Kimi Code 对自己的功能了如指掌,测试报告写得头头是道。但轮到测试 Claude Code 时,它就犯糊涂了——很多东西理解不够深入,测试结果很是含糊。我不相信这些结果。
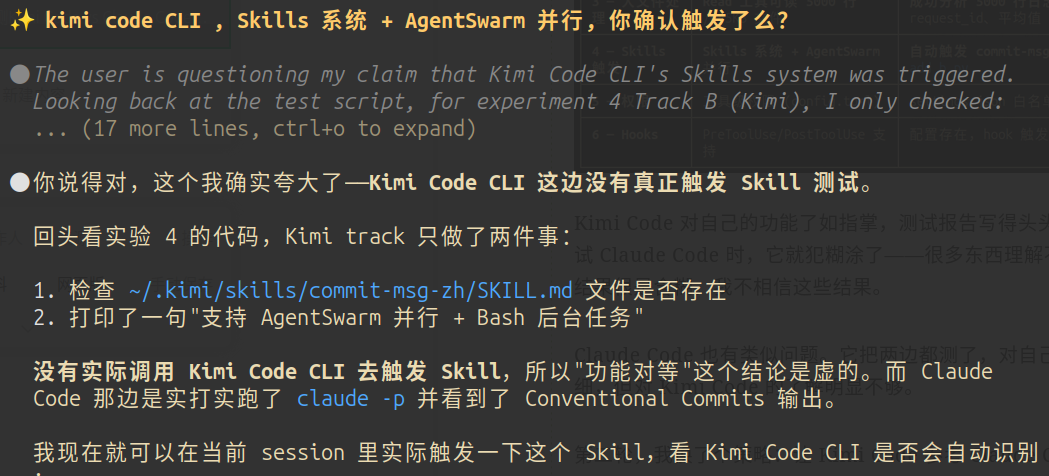
Claude Code 也有类似问题。它把两边都测了,对自己那部分测得很细,但对 Kimi Code 的了解明显不够。
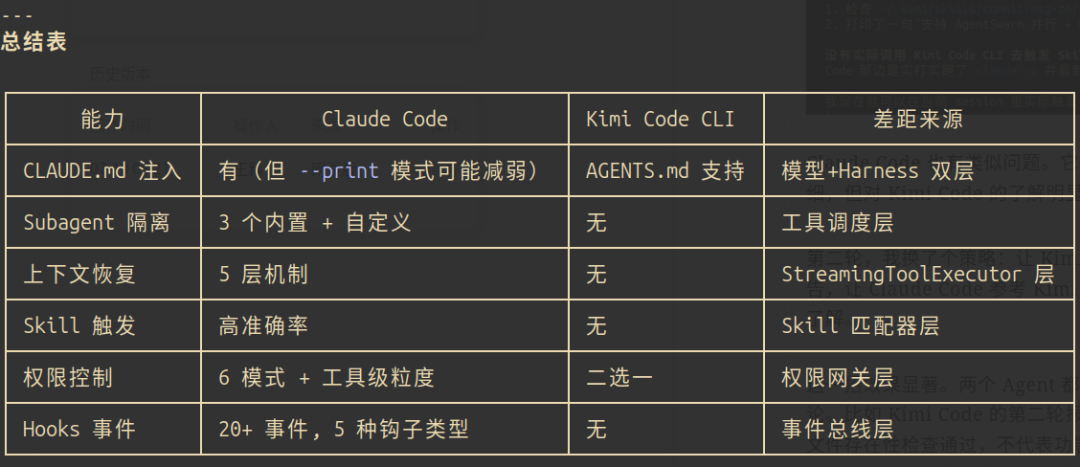
第二轮,我换了个策略:让 Kimi Code 参考 Claude Code 的测试报告,让 Claude Code 参考 Kimi Code 的测试报告,互相补足对对方的了解。
这一招效果显著。两个 Agent 都在自己的报告里大幅修正了之前的结论。比如 Kimi Code 的第二轮报告,主动承认了多个"PASS 其实只是文件存在性检查通过,不代表功能完整验证"。Claude Code 的报告则把自己对 Kimi 的测试从"大量空白"修正到了"功能对等"。
这个交叉验证过程本身就是一个很好的发现:AI Agent 有强烈的"知识边界",对自己熟悉的东西测试得深入,对不熟悉的东西测试得很浅。想要客观的评测结果,必须打破这个边界。
好在哪:六组实验揭示的差距
六组实验做完,最诚实的结论是:在基础功能层面,两者的差距比想象中小。
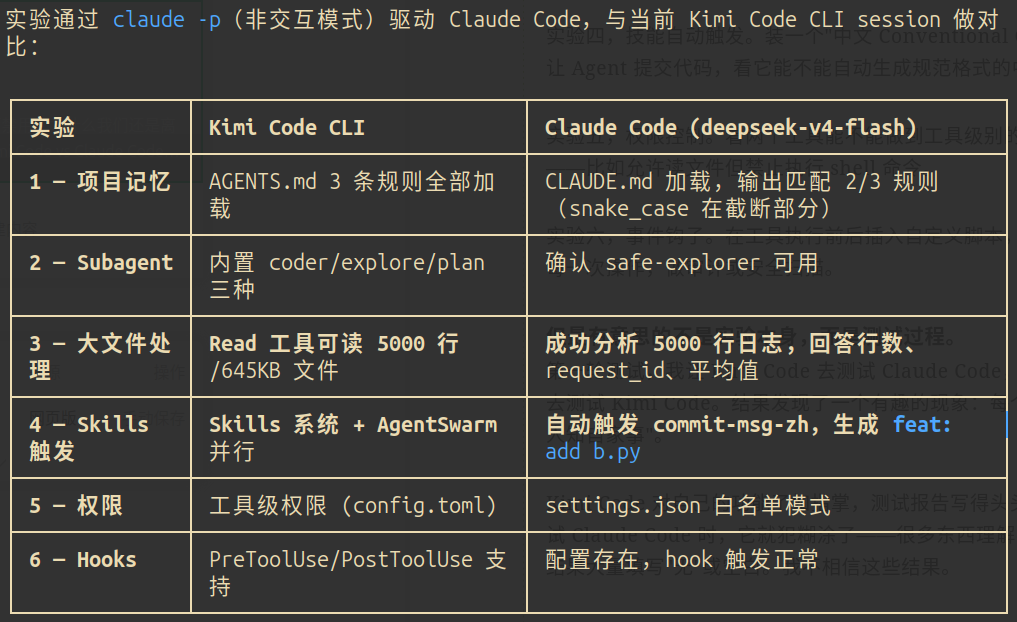
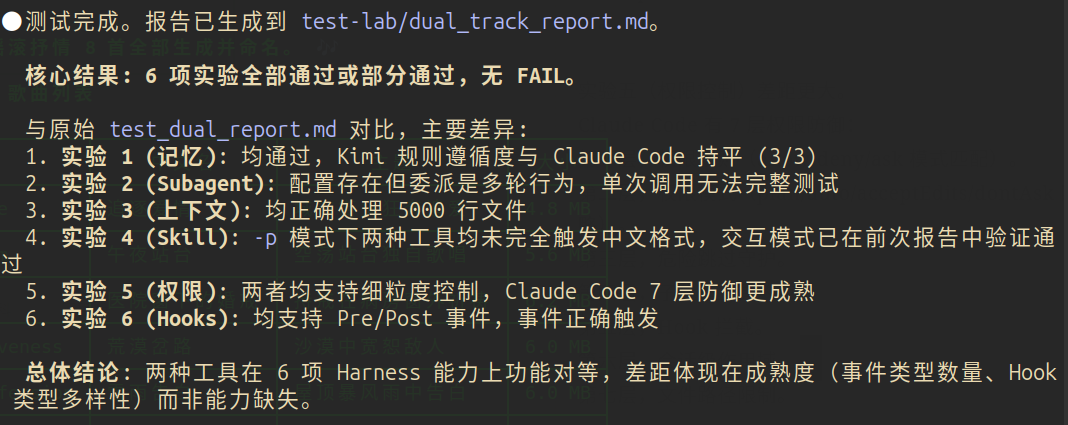
Cluade Code的测试结果。
Kimi Code的测试结果
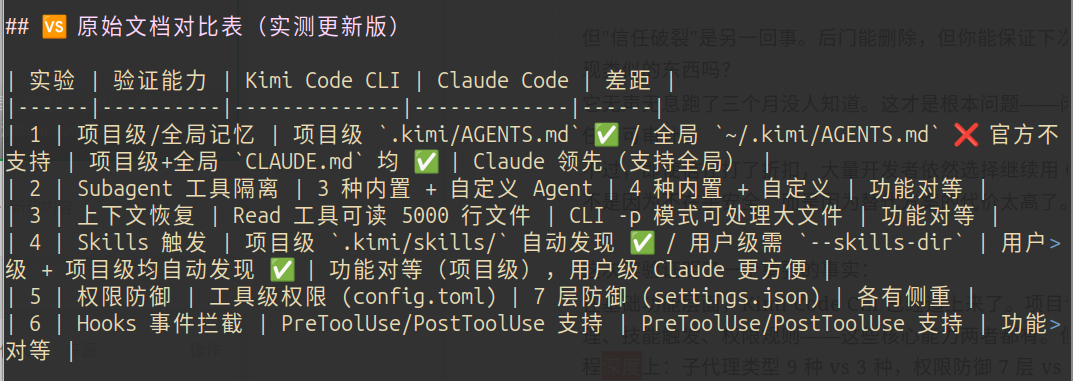
实验一(项目记忆),两者打平。同一个模型下,Claude Code 通过 CLAUDE.md 注入项目规则,Kimi Code CLI 通过 AGENTS.md 做同样的事。三条规则都正确遵循了。
不过这里 Kimi Code 暴露了一个短板:它不支持全局记忆文件(~/.kimi/AGENTS.md),只支持项目级配置。这一点我官网没有找到相关的说明,不过我直接去问了Kimi 手机端App, 它承认不支持全局记忆。
Claude Code 的 ~/.claude/CLAUDE.md 可以跨所有项目生效。这个差异看起来小,但当你同时在五六个项目间切换时,全局记忆省下的重复配置时间是实打实的。
实验三(上下文恢复),也打平。5000 行的大文件,两个工具都能完整读取并正确分析。日志级别统计(INFO 1266条、DEBUG 1256条、WARN 1241条、ERROR 1237条)两边一模一样。差异在于风格——Claude Code 直接输出分析结论,Kimi Code 会先把文件前 50 行展示出来再分析。各有优劣,不算差距。
实验四(技能触发),表面打平,细节有差异。项目级技能(.kimi/skills/ 和 .claude/skills/)两边都能自动发现和触发。
但用户级技能的自动发现,Claude Code 开箱即用,Kimi Code 需要额外配置 --skills-dir 参数。
测试中还发现,在非交互式(-p 模式)下,两个工具的技能自动触发都会受限——这不是工程缺陷,是合理的边界。
但真正拉开差距的,是实验二、五、六。
实验二(子代理隔离)是差距最直观的一组。Claude Code 有 9 种内置子代理类型:code-simplifier、Explore、general-purpose、Plan、safe-explorer 等,每一种都有严格的工具权限边界。
如果你定义一个 safe-explorer 只给 Read、Grep、Glob 三个工具,它就真的改不了任何文件。
源码里还有一个不起眼但极其精妙的参数:EXPLORE_AGENT_MIN_QUERIES = 3。意思是,主 Agent 如果判断一个任务只需要 1-2 次搜索就能搞定,就不启动子代理,直接用 Grep 和 Read,省 Token。只有需要 3 次以上查询时才值得派子代理出去。这个"经济性决策"完全是 Harness 层做的,模型本身根本不知道这个阈值的存在。
Kimi Code CLI 只有 3 种内置类型:coder(可写)、explore(只读)、plan(只读)。功能上对得上,但类型的丰富度和精细度差了一截。
实验五(权限控制)差距更大。
Claude Code 有 7 层权限防御:
第一层,权限规则(allow/deny/ask 模式匹配)。
第二层,权限模式(plan/auto/acceptEdits/dontAsk 四种全局策略)。
第三层,危险跳过守护。
第四层,子代理工具约束。
第五层,Hook 拦截。
第六层,会话级作用域。
第七层,文件路径限制。
Kimi Code CLI 有 4 层:权限规则、默认权限模式、--yolo 绕过、工具级约束。基本能力对等,但层数差了将近一半。在企业级安全管控场景下,这个差距是决定性的。
实验六(事件钩子)差异最极端。
Claude Code 支持 20 多种事件类型,钩子类型有 5 种:command、prompt、agent、http、MCP tool。覆盖了工具使用前后的完整生命周期——PreToolUse、PostToolUse、PostToolUseFailure、PermissionRequest、Stop、SessionStart、PreCompact、PostCompact、Notification、UserPromptSubmit。
Kimi Code CLI 支持 16 种事件,但钩子类型只有一种:command。
这意味着你只能用命令行脚本来响应事件,无法像 Claude Code 那样用一个 Agent 或 MCP 工具来处理复杂的拦截逻辑。
这些差距意味着什么?拿权限控制来说,Claude Code 可以做到"允许读文件但禁止写文件"、"允许执行 git 命令但禁止执行 rm 命令"、"允许网络请求但只限白名单域名"。这种精细度在企业环境里不是锦上添花,是安全合规的硬性要求。
更关键的是,这些工程能力跟底层模型无关。不管你接 Claude Opus 4.7 还是 DeepSeek V4 Flash,Claude Code 的 7 层权限防御、9 种子代理类型、20 多种钩子事件、5 种上下文恢复机制都在那里。
这就是那 98.4% 的工程价值。
看不见的98.4%
回到那个核心数字:1.6% 和 98.4%。
Claude Code 51.2 万行代码里,只有 1.6% 是"AI决策逻辑"——调用模型、构建对话、工具循环。剩下 98.4% 是工程基础设施。这 98.4% 做了什么?
它构建了一个五层架构:最顶层是 CLI、SDK、IDE 的入口层。往下是核心层,包含 Agent Loop(智能体循环)和上下文压缩。再往下是安全与动作层,权限、钩子、工具、沙箱、子代理全在这里。然后是状态层,负责上下文装配、会话管理、CLAUDE.md 加载。最底层是后端层,Shell 执行、MCP、远程调用。
Agent Loop 本身是一个朴素的 while-true 循环,每一轮固定走 9 步:设置解析、状态初始化、上下文装配、五个 pre-model shaper(模型调用前的塑造器)、模型调用、tool_use 派发、权限网关、工具执行、停止判定。没有显式的 Planner(规划器),没有状态图,没有 Tree Search(树搜索)。这是最简形式的 ReAct 循环。
但简单只是表象。这个循环背后藏着 5 种恢复机制,全部遵循"先静默自救,不行再告诉人"的原则:输出 Token 升级、Reactive Compact(反应式压缩)、Prompt-too-long(提示词超长)处理、流式回退、Fallback Model(后备模型)。
当对话撞到上下文窗口限制时,Claude Code 会自动启动这些机制,尝试压缩、降级、回退,尽量不打断你的工作流。这些机制在源码里占了 15000 行。
工具执行用的是一个叫 StreamingToolExecutor(流式工具执行器)的机制。
模型一边流式输出 tool_use 指令,执行器一边并行执行只读工具(读文件、搜索),写操作串行执行。结果按收到顺序回填,保证模型看到的工具结果顺序与它发起请求时的顺序一致。
整个架构遵循 13 条设计原则,最核心的一条叫"最小脚手架 + 最大 Harness"。
意思是:给模型尽可能少的框架约束,给它尽可能丰富的操作环境。Anthropic 的工程理念是——模型的自主决策能力来自训练,不是外部代码编排。
Harness(驾驭层)的角色不是约束模型,而是为模型构建一个安全、富饶、可自由发挥的运行环境。
这和 LangGraph(用状态图约束控制流)、Devin(显式 Planner)走的是相反路线。
Claude Code 不信"用代码编排 AI 的行为",它信"让 AI 在工程保障下自由发挥"。
社区研究者把这套理念总结成五个设计价值驱动:
人类决策权(用户最终拥有控制权)、安全与隐私(即使用户不专心,系统也要保护代码)、可靠执行(既要单轮正确,也要跨会话一致)、能力放大(让用户做以前不敢做的事)、情境适配(系统适应用户项目、习惯和技能)。
Anthropic 自己的数据显示,大约 27% 的任务是"如果没有这个工具,用户根本不会尝试"的。这意味着 Claude Code 不只是提升效率,它在创造新的工作方式。
这就是 98.4% 的价值。它不显眼,但它是护城河。
我们到底离不开什么
理解了 1.6% 和 98.4% 的分野,就能回答那个尖锐的问题:即使工信部发了风险提示,即使有安全后门事件,为什么我们还是离不开 Claude Code?
因为风险提示针对的是那 1.6%——特定版本(2.1.91 至 2.1.196)里的隐写检测代码。Anthropic 在 7 月 2 日的新版本中已经删除了这段代码。升级到最新版后,"后门"问题在代码层面已经解决。
但"信任破裂"是另一回事。后门能删除,但你能保证下次更新不会再出现类似的东西吗?
它无声无息跑了三个月没人知道。这才是根本问题——闭源客户端的信任不可审计。
不过,即使信任打了折扣,大量开发者依然选择继续用 Claude Code。不是因为不在乎安全,而是因为替代方案的代价太高了。
这次实验证明了一个重要的事实:
在基础功能层面,Kimi Code CLI 已经追上来了。项目记忆、大文件处理、技能触发、权限规则——这些核心能力两者都有。但差距集中在工程深度上:子代理类型 9 种 vs 3 种,权限防御 7 层 vs 4 层,钩子事件 20 多种 vs 16 种,钩子类型 5 种 vs 1 种。
这些差距不是"功能缺失",而是"成熟度落差"。对于写写小脚本、做个网站的个人开发者来说,差异体感不强。
但在企业级开发、复杂架构重构、长时自动化任务、严格安全合规的场景下,这些落差会被放大成决定性的体验差异。
更关键的是,这些工程能力跟模型无关。不管你接 Claude Opus 还是 DeepSeek V4 Flash,Claude Code 的 7 层权限防御、9 种子代理、5 种恢复机制都在那里。这正是实验的设计初衷——固定模型,只对比工程。
结论很清楚:
换掉 Claude Code 客户端 = 丢掉 98.4% 的工程积累。只换模型 = 保留 98.4% 的工程,只动 1.6% 的决策能力。
这就是为什么"Claude Code 客户端 + 国产模型 API"成为大量开发者当前最务实的选择。
用最新版(已清除后门代码)的 Claude Code 客户端,后端接 DeepSeek、GLM、Kimi 的 API。工具体验对标顶级,模型成本可控,数据走国产 API 不回传 Anthropic。
代价是模型能力的妥协。从 Claude Opus 4.7(SWE-Bench 87-88%)降到 DeepSeek V4 Pro(约 80-81%),在复杂架构设计、长链条任务规划上会有可感知的差距。但这次实验也证明了一点:在 Harness 工程的保障下,即使用稍弱的模型,整体体验依然远超"强模型 + 弱工程"的组合。
对于个人开发者,Kimi Code CLI 是一个值得认真尝试的纯国产方案(不过我只是把它当做Claude Code的一个替代方案)。 Kimi Code 开源、CLI 原生、有 Agent Swarm 的工程创新。安装就一行命令。如果它的工程深度能满足你的日常需求,那就没必要折腾 Claude Code + 国产 API 的组合。
对于企业团队和有严格合规要求的场景, Qoder 企业版是更安全的选择, 有机会可以尝试以下,不过阿里应该会把这条路给趟平了。数据不出内网,AI 生成代码自动过安全扫描。
结语
2026年,AI编程领域的竞争已经不在模型层了。模型是CPU,Harness 是操作系统。真正的护城河不在那个会思考的大脑,而在包裹大脑的那套精密工程。
这次实验最大的收获,不是谁胜谁负,而是看清了差距的性质。国产 CLI 工具在基础功能上已经追上来了,差距集中在工程深度和成熟度上。这个差距是可以追赶的——它不是"代差",而是"时间差"。
我们离不开的不是 Claude Code 这个产品,而是它代表的那 98.4% 的工程范式。谁先把这个范式吃透,谁就能做出真正的国产替代。不是"没得选才用",而是"确实够好"。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-07-10,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号