课前准备--蛋白蛋白分子对接的位点搜索逻辑(一)
原创
课前准备--蛋白蛋白分子对接的位点搜索逻辑(一)
原创
追风少年i
发布于 2026-09-16 08:19:08
发布于 2026-09-16 08:19:08
作者,Evil Genius
这一篇我们分享一下蛋白蛋白分子对接的位点搜索逻辑,为我们抗体设计做一些准备。
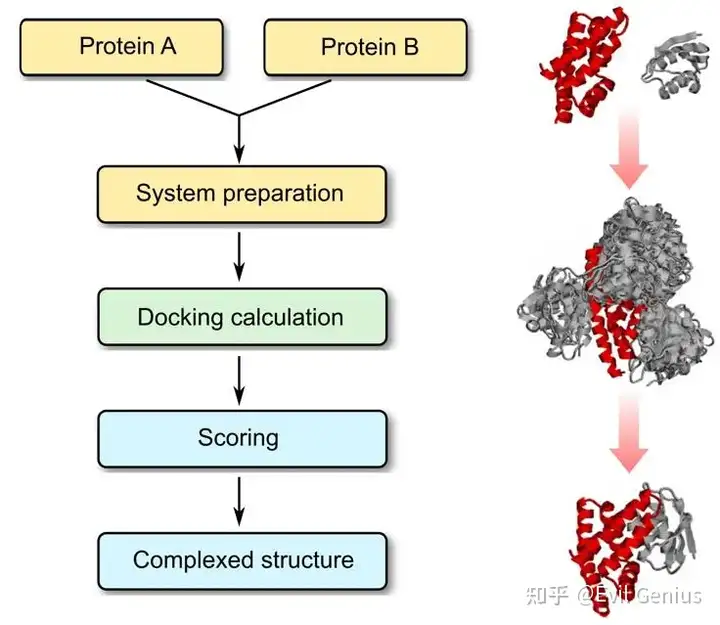
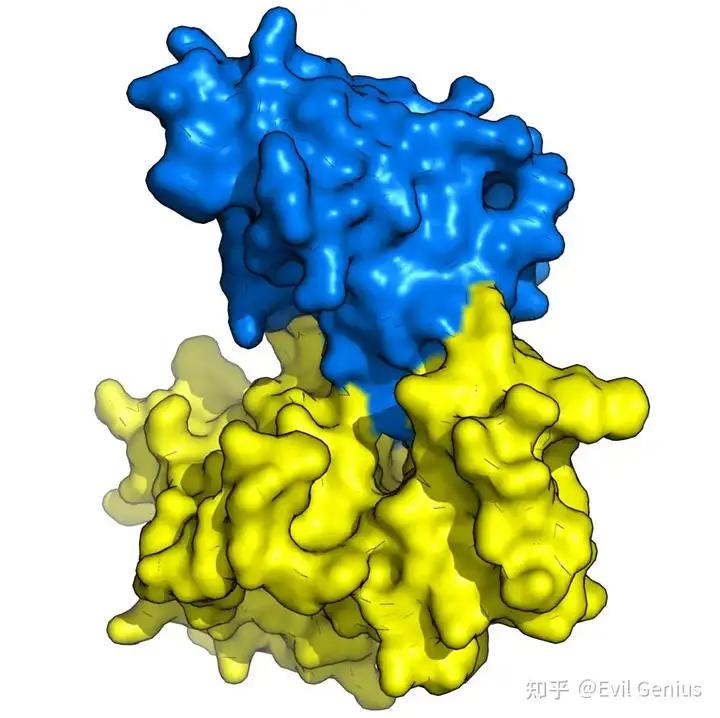
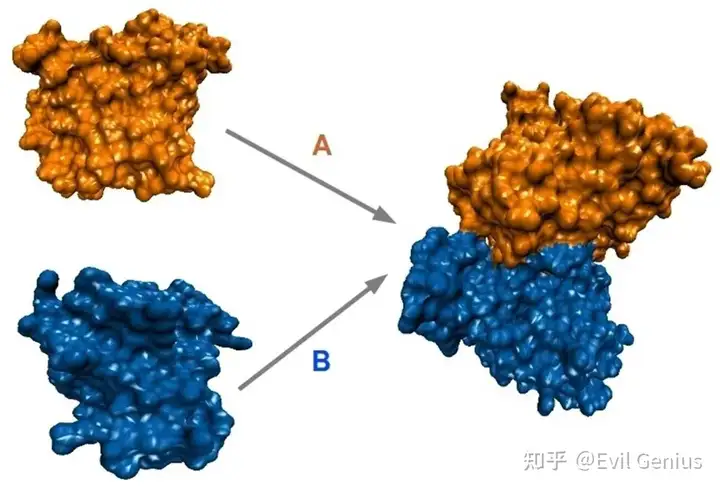
蛋白–蛋白分子对接(protein–protein docking)的位点搜索逻辑,和蛋白–小分子对接最大的区别是:通常不是先定义一个固定的“小口袋”,而是要在两个蛋白的大面积表面上寻找可能形成稳定蛋白–蛋白界面(PPI interface)的区域。
可以把整个过程理解成:
表面搜索 → 候选界面生成 → 几何匹配 → 物理化学打分 → 聚类 → 精细化 → 界面残基验证
一、蛋白–蛋白对接到底在搜索什么?
假设:
- Protein A:受体
- Protein B:配体
并不知道两者结合在哪里。
那么对接程序实际上要回答三个问题:
① A 的哪个表面区域可能结合 B?
② B 的哪个表面区域与 A 匹配?
③ A+B 怎样旋转、平移以后,可以形成合理界面?
所以不是简单地:
“在蛋白 A 上找一个口袋。”
而是:
在两个蛋白的整个表面寻找能够互补的区域。
例如:
Protein A                         Protein B

      ______                         ______
   __/      \__                   __/      \__
  /            \                 /            \
 |              |               |              |
 |   Surface    |               |   Surface    |
 |      ●───────|───────────────|──────●       |
 |              |               |              |
  \____________/                 \____________/

        ↑                              ↑
    候选界面                     候选界面
二、第一步:先确定“可能的结合位点”
蛋白–蛋白对接一般有三种情况。
情况 | 位点信息 | 对接方式 |
|---|---|---|
已知结合位点 | 已知 interface residues | 限定区域对接 |
部分知道 | 知道几个关键残基 | 约束/半限制对接 |
完全不知道 | 没有任何位点信息 | Blind docking |
这三个层次非常重要。
三、完全不知道位点时:Blind Protein–Protein Docking
这是最典型的:
未知蛋白–蛋白结合位点搜索
程序不会直接认为某个地方是 binding pocket。
而是:
Step 1:计算蛋白表面
首先识别蛋白表面的可接触区域。
例如:
Protein A

           ┌───────────┐
        ┌──┘           └──┐
       /                   \
      |                     |
      |       Protein       |
      |                     |
       \                   /
        └─────────────────┘
程序关注的是:
- solvent accessible surface
- surface curvature
- electrostatics
- hydrophobicity
- shape
- residue accessibility
四、第二步:寻找两个蛋白的“形状互补”
这是蛋白–蛋白 docking 最核心的逻辑之一。
例如:
Protein A

       凹槽
        ↓
      ______
    /        \____
   |              \
   |               |
    \______________/


Protein B

        凸起
         ↓
       ______
     /        \
    |          \
     \__________/
如果:
Protein A 凹槽
        ↓

      \______/
          ↑
          │
      ______
     /      \
Protein B 凸起
能够很好地匹配,那么这个位置就是一个候选 interface。
所以第一层筛选通常是:
Shape complementarity(形状互补)
五、第三步:不仅看形状,还要看电荷
蛋白表面有不同的电荷区域。
例如:
Protein A                     Protein B

  + + +                         - - -
 +     +                       -     -
+       +                     -       -
如果:
A:正电区域  + + +

B:负电区域  - - -
那么可能存在:
electrostatic complementarity
即:
静电互补。
例如:
- Lys
- Arg
通常带正电。
而:
- Asp
- Glu
通常带负电。
因此:
A蛋白                     B蛋白

 Lys/Arg +  ───────────────  Asp/Glu -

          electrostatic
           attraction
会提高某个界面构象的合理性。
六、第四步:疏水区域也很重要
蛋白–蛋白界面并不是全部靠盐桥。
很多 PPI interface 中都有明显的:
hydrophobic patches
例如:
Protein A              Protein B

  Phe                       Leu
  Val      ←──────→         Ile
  Leu                       Phe
这些疏水残基进入界面后,可以形成稳定的疏水核心。
因此 docking scoring 通常会综合:
形状互补
   +
静电互补
   +
疏水作用
   +
氢键
   +
范德华作用
   +
溶剂效应
七、第五步:寻找界面残基
最终程序会产生大量:
Protein A + Protein B 的可能相对位置
例如:
Pose 1
Pose 2
Pose 3
Pose 4
...
Pose 1000
每一个 pose 都意味着:
A
 \
  \________
           \ B
然后计算哪些残基真正进入 interface。
例如:
Protein A | Protein B | 距离 |
|---|---|---|
Lys72 | Asp103 | 3.2 Å |
Arg75 | Glu145 | 3.5 Å |
Tyr81 | Phe109 | 4.1 Å |
Phe90 | Leu112 | 3.8 Å |
于是得到:
predicted interface residues
八、这里有一个非常关键的概念:界面 ≠ 单个位点
小分子 docking 经常说:
binding site
但是 PPI 更准确的说法是:
binding interface
因为蛋白–蛋白结合往往涉及:
Protein A
 ┌───────────────────┐
 │                   │
 │   ● ● ● ● ●       │
 │    ● ● ● ●        │ ← interface
 │   ● ● ● ● ●       │
 │                   │
 └───────────────────┘
          ↑
          │
      Protein B
一个 interface 可能涉及:
10–30 个甚至更多残基。
所以不要把蛋白–蛋白 docking 理解成:
“寻找一个中心坐标。”
更准确的是:
寻找一片能够与另一个蛋白形成互补接触的表面区域。
九、为什么很多蛋白–蛋白 docking 程序会产生很多结果?
例如可能看到:
Cluster 1    150 poses
Cluster 2     87 poses
Cluster 3     63 poses
Cluster 4     41 poses
Cluster 5     30 poses
这不是说:
有 5 个真实结合位点。
而是说:
大量候选构象经过 RMSD/界面相似性聚类后,形成了几个主要构象家族。
例如:
1000 docking poses
                         │
             ┌───────────┴───────────┐
             ↓                       ↓
        相似构象聚类              不同构象
             │
       ┌─────┼─────┬─────┐
       ↓     ↓     ↓     ↓
      C1    C2    C3    C4
因此:
Cluster size 本身就是非常重要的证据。
如果一个界面:
- score 较好
- cluster 很大
- 多个独立 docking pose 都集中到这里
那么这个界面通常比一个只出现一次的 pose 更值得关注。
十、真正的“位点搜索逻辑”可以概括成四层
这是你做蛋白–蛋白 docking 时最值得记住的框架:
第一层:几何
Surface
 ↓
Shape complementarity
 ↓
是否能够物理贴合?
第二层:物理化学
Shape
 ↓
Electrostatics
Hydrophobicity
H-bonds
van der Waals
 ↓
是否具有合理相互作用?
第三层:统计
大量 docking poses
 ↓
Clustering
 ↓
哪些界面反复出现?
第四层:生物学
Docking interface
 ↓
结合实验 / 文献 / 保守性 / 突变
 ↓
是否符合真实生物学?
十一、如果已知几个关键残基,逻辑会发生变化
比如已经知道:
Protein A 的 Lys100、Arg103 是实验确定的 interface residues。
那么就不应该完全 blind docking。
可以变成:
Protein A

        ┌───────────────┐
        │               │
        │    ★ ★        │
        │   Lys100      │
        │   Arg103      │
        │               │
        └───────────────┘
              ↑
        限定interface
然后要求 Protein B 靠近:
Protein A
     ★ ★
      \
       \________
                \ Protein B
这叫:
restrained / information-driven docking
通常比完全 blind docking 更可靠。
十二、如果只有一个已知残基怎么办?
这时候非常适合使用:
Ambiguous restraints / active residues
例如:
Protein A

      Lys100 ★
             │
             │
             ↓
      ─────────────
       interface
告诉 docking:
Lys100 很可能参与结合,但不知道 B 蛋白的哪个残基与它结合。
程序就可以:
A:Lys100
     ↓
寻找
     ↓
B蛋白表面所有可能匹配区域
这比直接指定:
A:Lys100 ↔ B:Asp150
要合理得多。
十三、不同软件的“位点搜索”思想略有不同
常见的蛋白–蛋白 docking:
软件 | 核心特点 |
|---|---|
HADDOCK | 可以利用实验/生物学信息进行约束 |
ClusPro | 大规模刚体 docking + 聚类 |
ZDOCK | 重点进行全表面几何/物理匹配搜索 |
HDOCK | 模板 + docking,支持蛋白–蛋白 |
RosettaDock | 更强调精细采样和能量优化 |
LightDock | swarm-based docking |
ATTRACT | coarse-grained docking |
所以你如果问:
“蛋白–蛋白 docking 的位点搜索究竟是怎么搜索的?”
最核心的答案就是:
不是像 AutoDock Vina 那样先在一个 box 里面寻找小分子位置,而是在两个蛋白的表面上,对大量相对旋转/平移构象进行采样,然后利用形状互补、静电、疏水、氢键、范德华等评分筛选,并通过 clustering 找出稳定、反复出现的候选 interface。
十四、和蛋白–小分子 docking 对比一下
蛋白–小分子 | 蛋白–蛋白 | |
|---|---|---|
搜索对象 | 小分子 | 整个蛋白 |
搜索空间 | binding pocket | 蛋白表面 |
主要问题 | ligand 放哪里 | 两个蛋白怎么接触 |
位点大小 | 通常较小 | 通常较大 |
核心几何 | pocket fitting | surface complementarity |
电荷 | 重要 | 非常重要 |
疏水作用 | 重要 | 非常重要 |
Cluster | 辅助 | 非常重要 |
实验约束 | 可用 | 非常有价值 |
Blind docking | 可做 | 非常常见 |
十五、实际做一个未知 PPI,建议如下流程
Protein A
              │
              │
          Protein B
              │
              ▼
      ┌────────────────┐
      │ Surface search │
      └───────┬────────┘
              ↓
       Shape complementarity
              ↓
       Electrostatic matching
              ↓
       Hydrophobic matching
              ↓
       Generate thousands
       of docking poses
              ↓
           Scoring
              ↓
          Clustering
              ↓
       ┌──────┴───────┐
       ↓              ↓
   Cluster 1      Cluster 2...
       ↓
   interface residues
       ↓
   biological validation
       ↓
      MD simulation
       ↓
   binding/interface analysis
最后特别注意
Docking 得到的“最佳位点”不能简单等同于真实结合位点。
尤其是两个蛋白都存在明显构象变化时,blind docking 很容易出现:
- 假阳性界面
- 过度依赖静态结构
- 错误的电荷/质子化状态
- 柔性 loop 没有正确调整
- 隐藏 interface 无法暴露
- 大界面蛋白出现多个竞争性 pose
因此,如果最终目的是发表级别的 PPI 结构机制,通常应该是:
Docking → interface residue 分析 → 多构象/多算法验证 → MD → 界面稳定性 → MM/GBSA 或其他结合自由能分析 → 实验突变验证
而不是只拿 docking score 最低的一个结构作为结论。
生活很好,生活很好。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号