用AI实现一个想法自动适配18个内容平台
原创
用AI实现一个想法自动适配18个内容平台
原创
轻松悠悠
修改于 2026-09-16 16:06:37
修改于 2026-09-16 16:06:37
文前声明,以下仅为个人实操步骤,供大家参考,大家可以根据自己需要自行选择平台。
一、摘要
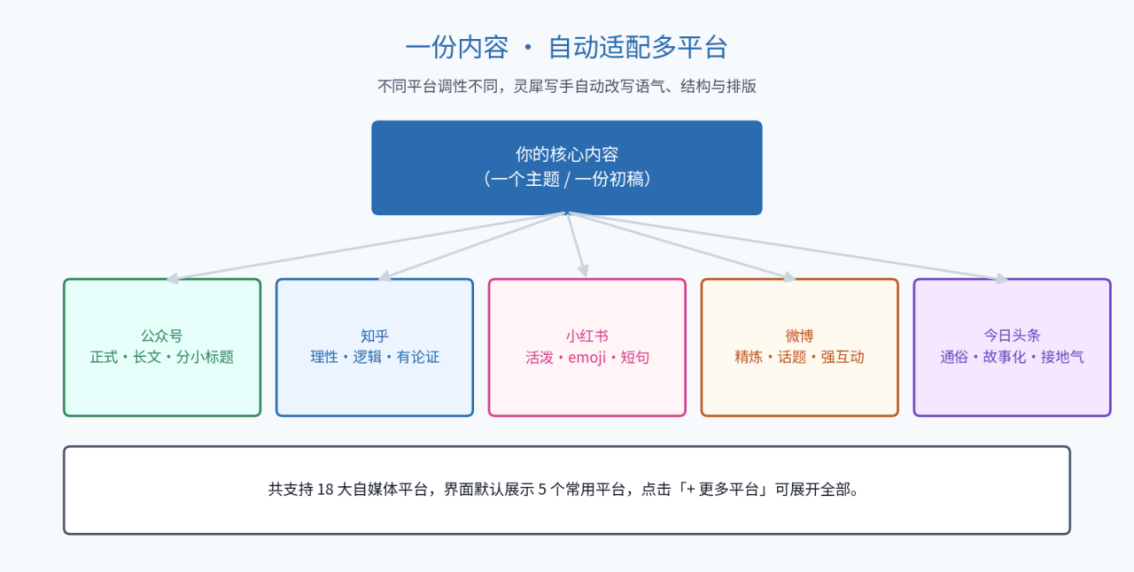
自媒体内容生产的真实瓶颈,从来不是"写不出来",而是"同一份观点要按 N 个平台的调性重写 N 遍"——公众号要正式、知乎要讲逻辑、小红书要短而活泼。
我基于成本和安全的考虑用的AiPy,你们可以根据自己情况选择平台
文章给出完整的方案选型对比、流水线架构说明、五步操作流程、配置即代码示例、质量校验脚本、7 个高频踩坑与最佳实践,并明确划出 AI 辅助创作的责任边界:工具省掉的是"从 0 到 1"和"从 1 到 N 个平台"的重复劳动,省不掉的是事实核对与观点判断。
二、背景:内容分发的"最后一公里"成本
多平台运营的团队都熟悉这个循环:
一个选题 → 写初稿 → 改公众号版 → 改知乎版 → 改小红书版 → 改头条版 → 改百家号版 → 发布 |
|---|
其中真正产生价值的只有第一步(观点、经历、判断),后面全是格式与语气的转换成本。这类成本有三个特征:
• 重复性高:每篇都要重来一遍,无法沉淀;
• 规则性强:每个平台的篇幅、语气、结构偏好基本固定,本质是"约束条件下的重写";
• 可自动化:既然是约束驱动的转换,就适合交给参数化的生成流水线。
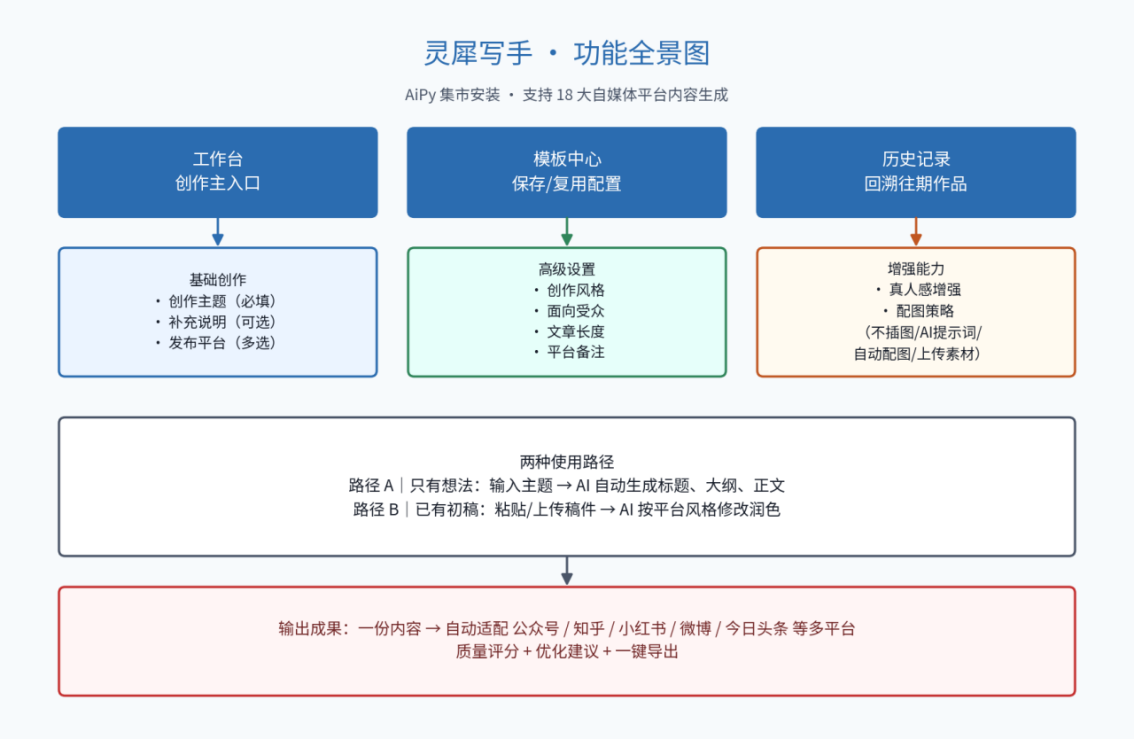
三、问题:为什么"自己写 + 手动改"难以规模化
维度 | 手工模式 | 问题本质 |
|---|---|---|
输入 | 脑子里一个模糊念头 | 缺乏结构化输入,只能产出通用稿 |
约束 | 靠记忆切换平台风格 | 约束未显式化,无法复用 |
复用 | 每次重新设置风格/受众/长度 | 配置无持久化,重复劳动 |
输出 | 一份稿子硬套多平台 | 缺少"一对多适配"机制 |
质量 | 凭感觉判断 | 无评分、无校验、无人工复核节点 |
风险 | 直接发布 AI 稿 | 事实偏差、AI 腔、版权不明的配图 |
四、方案选型:三条路径的取舍
方案 | 代表做法 | 优点 | 缺点 | 适用 |
|---|---|---|---|---|
A. 纯手工 | 人写人改 | 质量上限最高 | 无法规模化,成本线性增长 | 单篇精品、深度长文 |
B. 通用大模型 + 自建 Prompt | 自己写 Prompt 调 API | 完全可控、可集成 CI | 需自建平台适配规则库、模板管理、导出链路 | 有工程团队、需深度定制 |
C. 垂直应用(本文路径) | AiPy 集市「灵犀写手」 | 开箱即用、平台适配/模板/配图/导出已内置 | 定制自由度受产品能力边界限制 | 内容团队、个人创作者、快速验证 |
本文选 C 作为落地载体,B 作为扩展方向:先用垂直应用把流程跑通、把"平台调性"这类隐性知识显性化,再考虑把配置沉淀成可版本化的资产。
五、操作步骤:五步跑通第一篇
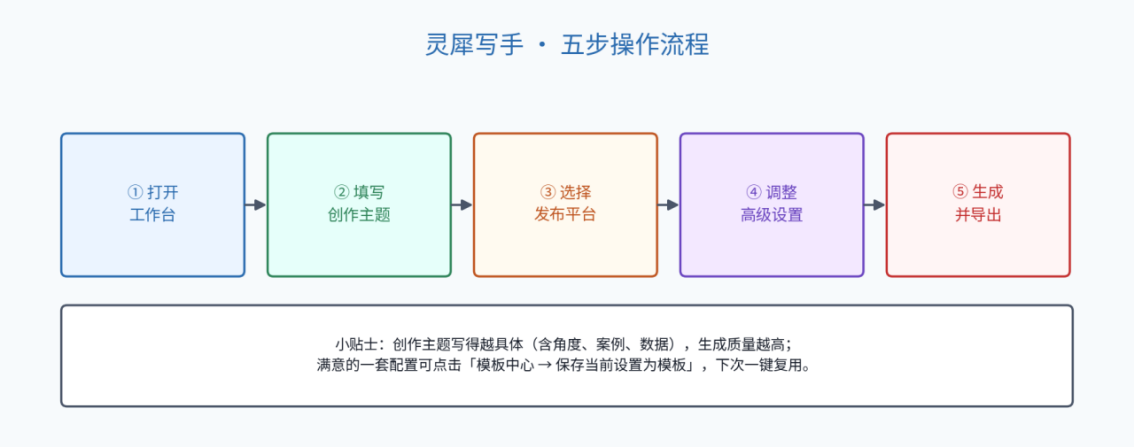
第 1 步 · 打开工作台
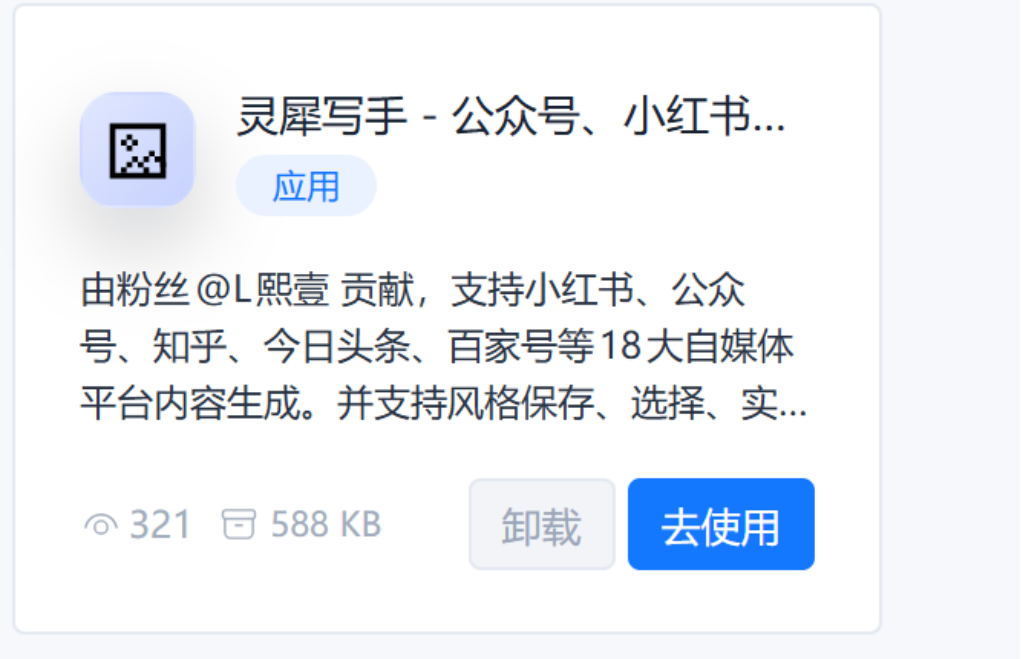
在 AiPy 集市点击「去使用」,或从顶部导航栏点击「工作台」,进入创作主界面。
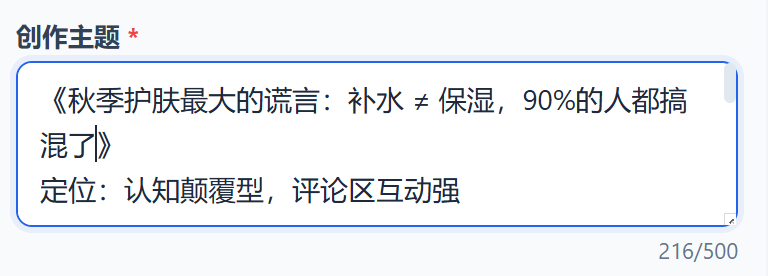
第 2 步 · 填写创作主题
在「创作主题」输入框写下文章主题或核心观点,最多 500 字。原文给的写法建议:
• 说清"写给谁看"——如"写给刚入职的应届生";
• 说清"想表达什么观点"——如"第一份工作不要只看工资";
• 能补上"案例或数据"更好——如"用我自己跳槽涨薪 40% 的经历";
• 反例:"写一篇职场文章"——太笼统,只能得到四平八稳的通用稿。
「补充说明」用于强调特定角度、案例或数据。
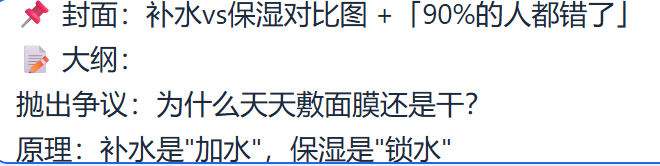
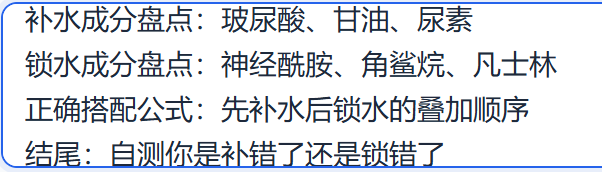
我拿我的举例:
第 3 步 · 选择发布平台
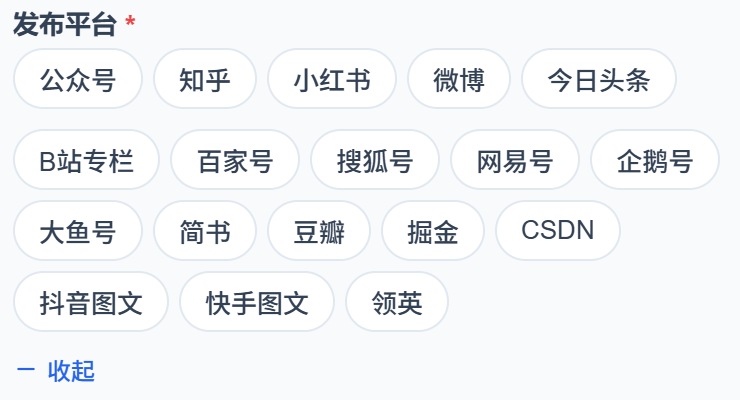
在「发布平台」中点击目标平台(公众号 / 知乎 / 小红书 / 微博 / 今日头条),可多选;需要更多平台时点击「+ 更多平台」。
第 4 步 · 调整高级设置
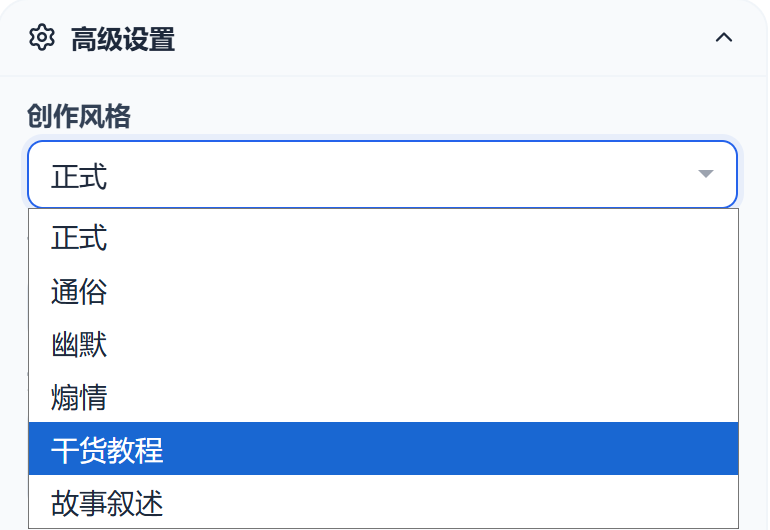
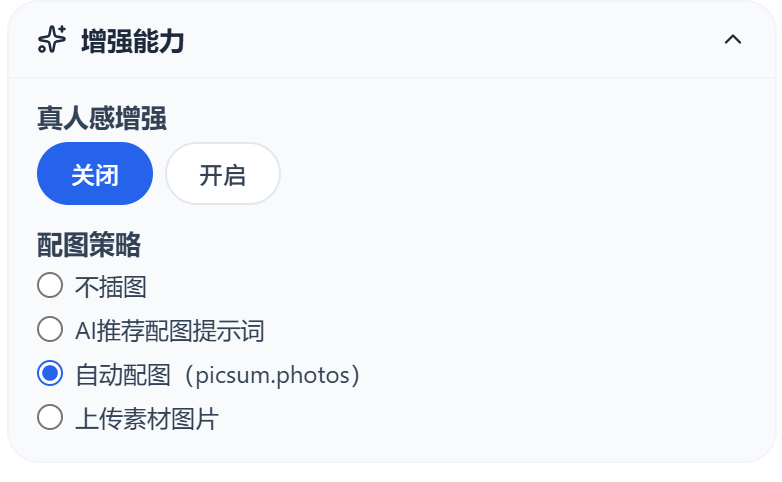
按需设置创作风格、面向受众、文章长度;需要更自然的文字就打开「真人感增强」,需要配图就选择配图策略。
第 5 步 · 生成并导出
点击生成,右侧输出文章;满意后直接导出,或复制到对应平台发布。
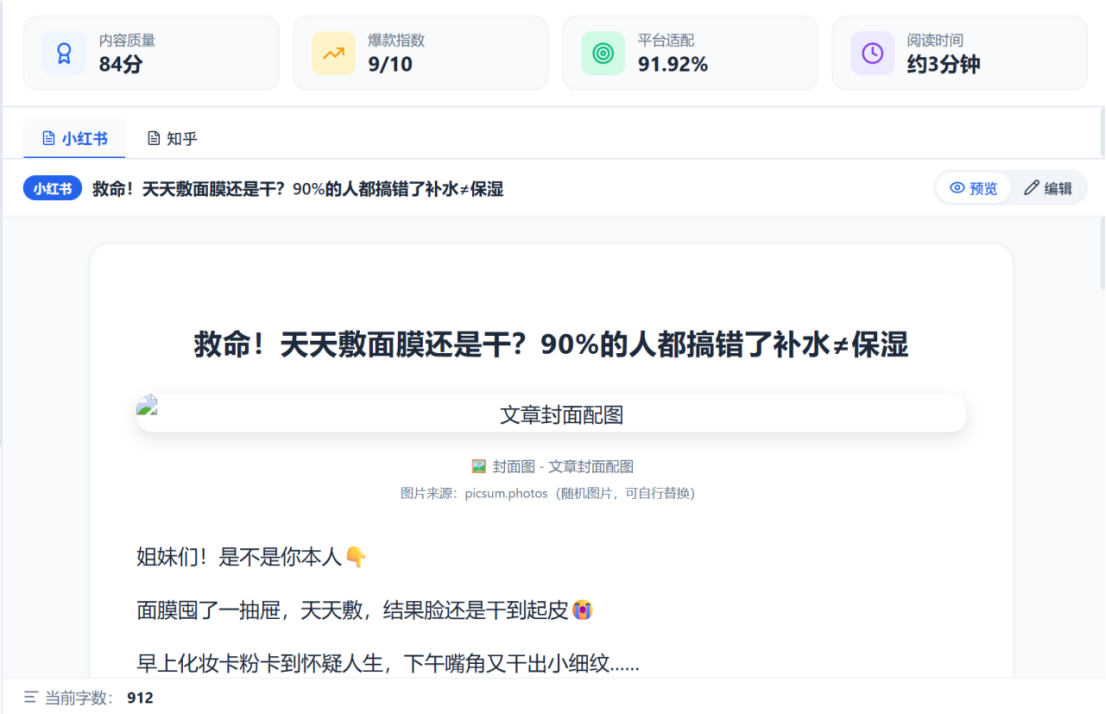
⬇️小红书版本
⬇️知乎版本
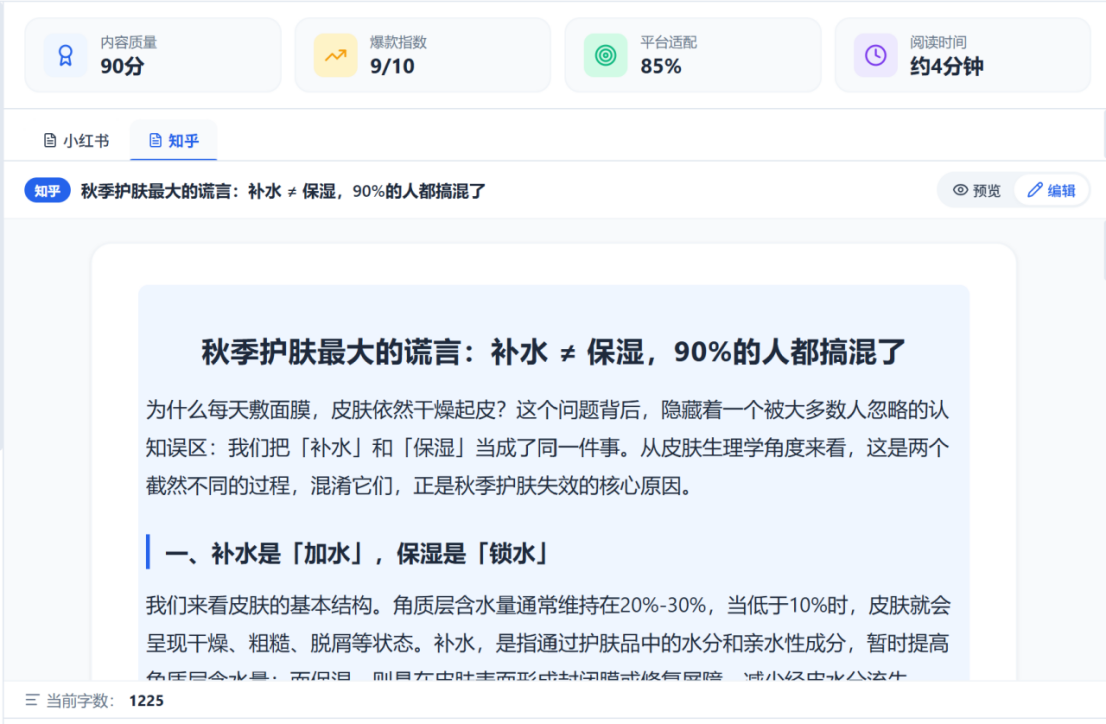
两种典型使用路径(原文):
• 路径 A(只有想法):写下想法 → 选平台、设风格/受众/长度 → 生成标题/大纲/正文 → 右侧审阅,不满意调参重生成。
• 路径 B(已有稿子):粘贴初稿 → 选目标平台(决定改写方向)→ 打开「真人感增强」→ 生成后对比原稿,保留满意部分。
七、代码 / 命令:把手工流程工程化
⚠️ 重要声明:没有任何 API、CLI 或配置文件。以下代码是工程化扩展示例,用于演示"如果要把这套流程接入团队工作流,可以怎么做"。它们不调用任何未公开接口,只做配置管理、模板版本化、批量任务编排、输出质量校验这类通用工程动作。请勿把它们当作官方 API 使用。
7.1 配置即代码:把"平台调性"写成可版本化的参数集
# config/platform_profiles.yaml# 平台调性配置(工程化示例:把隐性的"平台风格"显性化、可评审、可版本化)# 字段含义与「灵犀写手」高级设置一一对应version: 1profiles: wechat_mp: # 公众号 style: 正式 audience: 行业从业者 length: 中篇 # 短篇≈800 / 中篇≈1500 / 长篇≈2500 humanize: false # 正式文体建议关闭真人感增强 image_policy: ai_prompt notes: "结构清晰、有小标题、避免口语化" zhihu: # 知乎 style: 理性 audience: 技术决策者 length: 长篇 humanize: false image_policy: ai_prompt notes: "逻辑链完整、有论据、可长" xiaohongshu: # 小红书 style: 活泼 audience: 泛用户 length: 短篇 humanize: true image_policy: upload notes: "短句、多emoji、强情绪开头" toutiao: # 今日头条 style: 通俗 audience: 大众读者 length: 中篇 humanize: true image_policy: public notes: "开头抓人、信息密度高" |
|---|
7.2 模板版本化:把「模板中心」的配置纳入 Git 管理
# scripts/template_guard.pyfrom pathlib import Pathimport hashlibimport systry: import yamlexcept ImportError: print("请先安装 pyyaml: uv pip install pyyaml") sys.exit(1) REQUIRED = {"style", "audience", "length", "humanize", "image_policy"}VALID_LENGTH = {"短篇", "中篇", "长篇"} def load_profiles(path: Path) -> dict: with path.open(encoding="utf-8") as f: return yaml.safe_load(f) def validate(cfg: dict) -> list: errors = [] for name, p in (cfg.get("profiles") or {}).items(): missing = REQUIRED - set(p or {}) if missing: errors.append(f"[{name}] 缺少字段: {sorted(missing)}") if p and p.get("length") not in VALID_LENGTH: errors.append(f"[{name}] length 非法: {p.get('length')},应为 {VALID_LENGTH}") return errors def fingerprint(path: Path) -> str: return hashlib.sha256(path.read_bytes()).hexdigest()[:12] if __name__ == "__main__": cfg_path = Path(__file__).resolve().parent.parent / "config" / "platform_profiles.yaml" cfg = load_profiles(cfg_path) errs = validate(cfg) if errs: print("配置校验失败:") for e in errs: print(" -", e) sys.exit(1) print(f"配置校验通过,共 {len(cfg['profiles'])} 个平台档案") print(f"配置指纹(sha256[:12]): {fingerprint(cfg_path)}") print("建议将此指纹记录到发布日志,便于回溯'某篇文章用的是哪版配置'") |
|---|
7.3 批量任务编排:一次输入,多平台产出清单
# scripts/batch_plan.pyimport jsonfrom pathlib import Pathimport yaml TOPIC = "第一份工作不要只看工资" # 对应「创作主题」SUPPLEMENT = "用我自己跳槽涨薪 40% 的经历" # 对应「补充说明」 base = Path(__file__).resolve().parent.parentcfg = yaml.safe_load((base / "config" / "platform_profiles.yaml").read_text(encoding="utf-8"))targets = ["wechat_mp", "zhihu", "xiaohongshu", "toutiao"] plan = { "topic": TOPIC, "supplement": SUPPLEMENT, "tasks": [ { "platform": t, "params": cfg["profiles"][t], "status": "pending", # pending -> generated -> reviewed -> published "reviewer": None, # 人工复核人,必填后才可 published } for t in targets ],}out = base / "plan.json"out.write_text(json.dumps(plan, ensure_ascii=False, indent=2), encoding="utf-8")print(f"已生成任务清单 {out},共 {len(plan['tasks'])} 个平台任务")for t in plan["tasks"]: print(f" - {t['platform']:12s} 风格={t['params']['style']:<4s} 长度={t['params']['length']}") |
|---|
7.4 发布前质量校验:把"人工通读"变成可执行清单
# scripts/preflight_check.pyimport refrom pathlib import Path PATTERNS = { "数字/百分比": r"\d+(?:\.\d+)?\s*(?:%|%|倍|万|亿)", "金额": r"[¥¥$]\s?\d[\d,\.]*", "疑似人名": r"(?:张|王|李|赵|刘|陈|杨|黄|周|吴)[\u4e00-\u9fa5]{1,2}(?=[,。、:;\s])", "绝对化表述": r"(?:第一|最|唯一|100%|绝对|必然)", "AI腔模板句": r"(?:综上所述|总而言之|在当今|随着.{0,6}的发展|不难看出)",} def check(text: str) -> dict: hits = {} for name, pat in PATTERNS.items(): found = re.findall(pat, text) if found: hits[name] = found return hits if __name__ == "__main__": draft = Path(__file__).resolve().parent.parent / "draft.md" if not draft.exists(): print("请把待发布草稿保存为 draft.md 后重试") raise SystemExit(1) text = draft.read_text(encoding="utf-8") hits = check(text) if not hits: print("未命中高风险模式(仍需人工通读确认事实)") else: print("以下内容需人工逐条核对:") for k, v in hits.items(): print(f" [{k}] 共 {len(v)} 处 -> {v[:10]}") print("\n提醒:脚本只做定位,事实/数据/人名必须人工核实后方可发布。") |
|---|
7.5 运行方式
# 依赖uv pip install pyyaml # 1) 校验平台调性配置python scripts/template_guard.py # 2) 生成多平台任务清单python scripts/batch_plan.py # 3) 在「灵犀写手」工作台按 plan.json 逐平台生成,导出后存为 draft.md # 4) 发布前预检python scripts/preflight_check.py |
|---|
八、验证结果:怎么判断"这稿能不能发"
原文没有给出量化指标,所以这里只用原文可验证的事实作为验收标准,不编造数据:
验收项 | 依据(原文) | 判定方式 |
|---|---|---|
平台适配是否生效 | "小红书版本更短更活泼,知乎版本更长更讲逻辑" | 对比同一主题下各平台版本,短篇/长篇差异可见 |
长度是否符合预期 | 短篇≈800 / 中篇≈1500 / 长篇≈2500 字 | 按字数统计核对 |
配置是否可复用 | "从模板中心直接调用,一键恢复全部参数" | 二次创作时参数是否自动带出 |
真人感是否生效 | "减少模板化句式,增加口语化表达和节奏变化" | 对比开关前后文本,模板句密度下降 |
是否可安全发布 | "发布前务必人工通读,核对事实、数据、人名" | preflight_check.py 命中项全部人工确认 |
九、踩坑:7 个高频问题与应对
以下 Q1–Q7 均来自原文 FAQ,应对建议为工程化补充。
# | 坑 | 原文结论 | 工程化应对 |
|---|---|---|---|
1 | 生成稿直接发布 | 建议不要直接发,可能有事实偏差或表达生硬 | 引入 preflight_check.py + 人工复核人字段,未复核不可置为 published |
2 | 内容千篇一律 | "创作主题"写得太笼统是主因 | 主题模板强制包含"写给谁 + 什么观点 + 案例/数据"三要素 |
3 | 一次选太多平台 | 平台越多适配工作越多,建议聚焦少量核心平台 | batch_plan.py 默认只排 3–4 个核心平台 |
4 | 真人感增强乱开 | 正式文体(公文、报告)建议保持关闭 | 在 platform_profiles.yaml 里按平台固化 humanize 开关 |
5 | 自动配图商用风险 | 公共图片源版权状态不确定,商用建议改用 AI 提示词或上传素材 | 配置中 image_policy 对商用场景强制 ai_prompt / upload |
6 | 模板丢失 | 模板存应用内,建议同时用文字记下来 | 配置入 Git(platform_profiles.yaml)+ 指纹记录 |
7 | 字数不可控 | 长度分三档:短篇≈800 / 中篇≈1500 / 长篇≈2500 | 生成后按字数统计核对,超限则调档重生成 |
另外四条"避坑提醒"(原文原话):
1. 不要直接发布未经审核的 AI 稿:事实、数据、人名必须人工核对;
2. 不要让 AI 编造经历:涉及个人经历、案例时务必提供真实素材;
3. 不要忽视平台规则:各平台对 AI 生成内容有不同要求,发布前了解清楚;
4. 不要把工具当万能:灵犀写手是效率工具,观点和判断还得靠你自己。
十、最佳实践
1. 输入结构化:主题按"受众 + 观点 + 案例/数据"三段式写,这是提升生成质量性价比最高的一步。
2. 约束显性化:把风格/受众/长度/配图策略从"脑子里的感觉"变成配置文件,才能评审、复用、追溯。
3. 模板按平台拆分:原文建议——"可以按平台分别存模板,比如『公众号-正式-中篇』『小红书-活泼-短篇』"。
4. 一次聚焦少数平台:质量优先于数量,多平台适配是乘法成本。
5. 保留人工复核节点:把"通读一遍"固化为流程步骤,而不是靠自觉。
6. 配图先解决授权:商用场景一律走 AI 提示词或自有素材,规避版权不确定性。
7. 配置入版本控制:模板是资产,资产要能回滚、能 diff、能追责。
十一、总结
「灵犀写手」的价值可以精确地表述为:它省下的是"从 0 到 1"和"从 1 到 5 个平台"的那部分重复劳动,省不下的是你的观点、你的经历、你的判断。
从工程视角看,它把内容生产中最难标准化的部分(平台调性、语气、篇幅)做成了参数,把最耗时的部分(多版本重写)做成了流水线。而一旦这些参数可以被显式表达,它们就能被版本化、被校验、被纳入 CI——这正是内容生产从"手艺"走向"工程"的路径。
落地建议:先用垂直应用跑通流程、沉淀平台调性配置;当配置稳定、量级上来后,再评估是否需要自建(方案 B)。顺序别反——先跑通,再优化。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号