选国产还是进口?我让Seed-2.1-pro啃了42种疫苗说明书,做了个婴幼儿接种查询工具

选国产还是进口?我让Seed-2.1-pro啃了42种疫苗说明书,做了个婴幼儿接种查询工具
Onegun
发布于 2026-09-20 12:32:14
发布于 2026-09-20 12:32:14
有娃以后各个社交平台,非常精准的开始给我传播“婴幼儿疫苗不良反应”的焦虑。
国产还是进口?
为什么同一种疫苗不同厂商价格差这么多?
临床试验到底有什么区别?
拒绝被焦虑传染的我意识到,与其被各种信息牵着走,不如先把疫苗这件事系统地搞清楚。
对于我来讲,需要的不是另一个“告诉我该打什么”的疫苗日历工具,而是一个能把分散在说明书、疾控文件、药企官网里的信息整理到一起的查询工具。
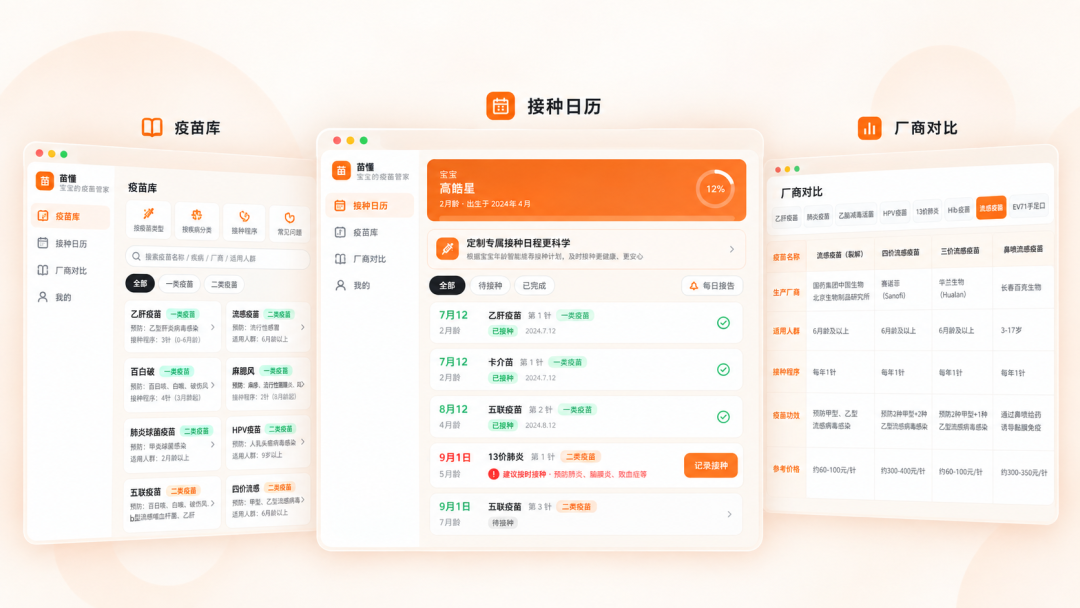
于是,我干脆把这个问题交给了刚升级的 Seed-2.1-pro-0915:整理18类、42 种婴幼儿疫苗的信息,再把它做成一个真正能用的 Web 查询工具——“苗懂”。
工具的选择
根据官方介绍,Seed-2.1-pro-0915 主要围绕Coding、Agent、多模态领域进行升级强化,更懂复杂代码仓库和业务,在多模态 Coding&Agent 能力上有更为突出的表现。
非常适合这次的疫苗信息查询工具开发,因为项目本身就需要调研及处理庞大的疫苗数据信息,特别是大量的疫苗说明书的信息录入整合,对于模型本身的视觉理解能力、信息深度检索和 Agent 工具的调用可靠性都有较强的考验。
使用工具 | Claude Code、豆包工作 |
|---|---|
使用模型 | Seed-2.1-pro-0915 |
开发项目 | <苗懂 Miodon>,婴幼儿疫苗信息360°查询助手 |
数据规模 | 18 类、42 种疫苗 |
产品形态 | Web 应用 |
复杂需求理解及方案规划
首先把需求丢到 Claude Code 里面后一切都非常顺利,在 Seed-2.1-pro的加持下,大概一轮跑下来产品就可以初步成型。
初版的成果符合基本需求,但还缺乏疫苗临床数据、没有方案制定逻辑,如果只止步于此就不是这个项目的初衷,我更希望能够有所有疫苗信息的横向对比结果,只有在充分了解疫苗信息的情况下才能做出适合的疫苗接种方案。
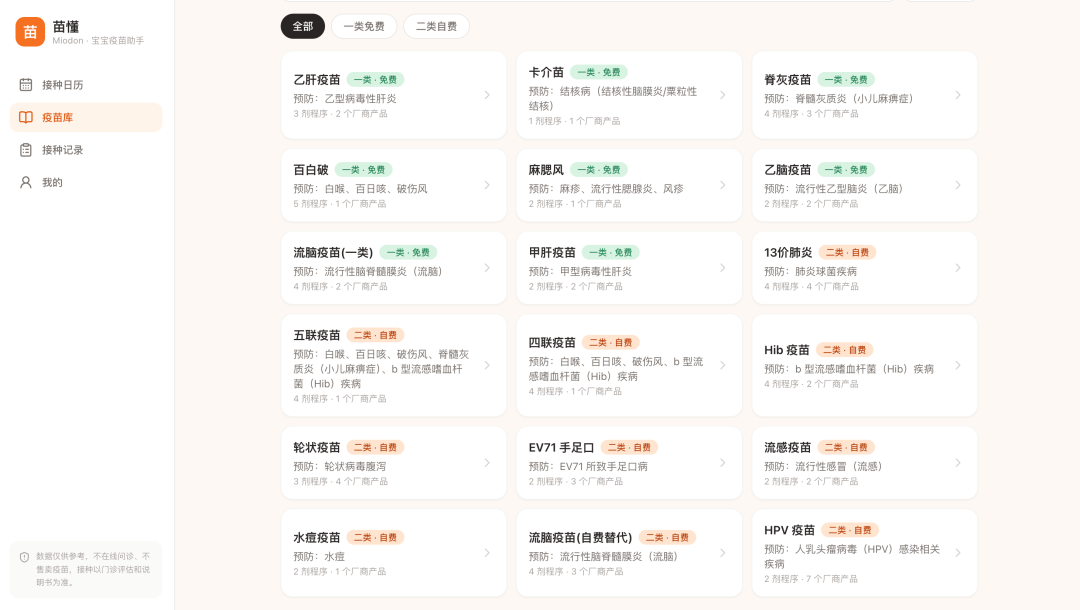
于是,接下来项目进入更复杂的数据处理、疫苗方案规划阶段,也更考验模型的各项能力。
把疫苗信息的横向对比需求继续发给 Seed-2.1-pro 后,它对于需求的理解能力还是比较强,在复杂问题的描述不够详细清晰的情况下,最终给出的解决思路和方案是高于我预期的。
以疫苗对比为例,在我只想到了一类VS二类对比时,它还自动给我给到了各个厂商的对比方案。
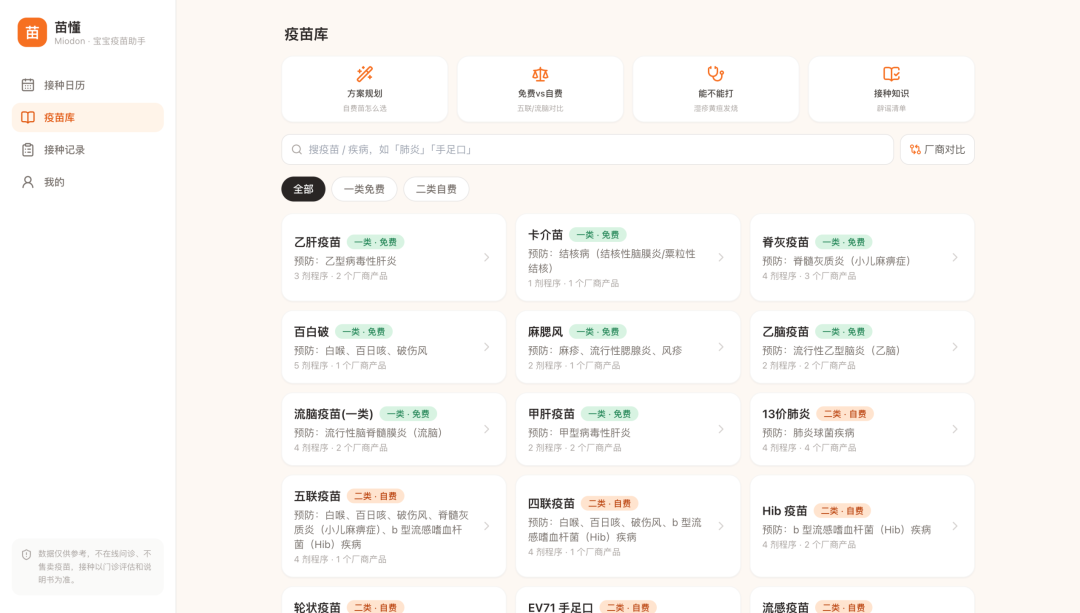
在疫苗方案规划设定上也足够周全,方案没有让用户自己一个个疫苗去勾选,而是首先基于国家卫健委的免疫计划给到三个大的方案建议,在此基础上让用户进行微调,这个操作方式就非常符合用户的真实需求。
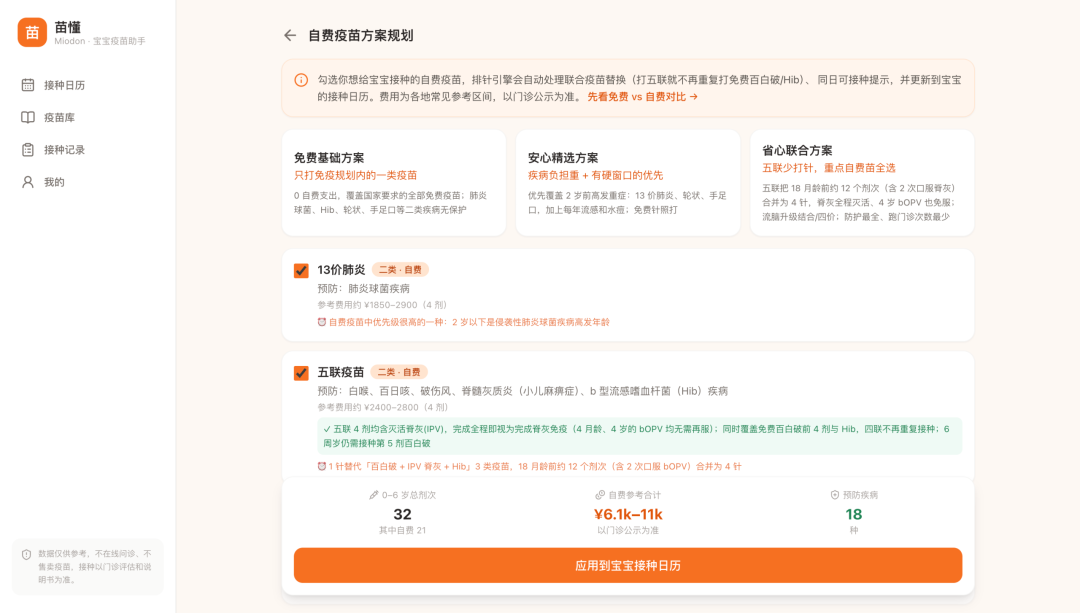
这一轮下来我认为模型自身在复杂业务处理上和逻辑思考方面下了功夫,能清晰理解需求并把零散的功能点组合形成完整的业务流程,所以让我明显感受到 Seed-2.1-pro 够聪明。
上强度的数据核验处理
初版 Demo 几个小时就能出来,但我很快发现,这个项目真正上强度的困难部分才刚开始。
对于这种严重依赖于数据的产品,数据的可靠性基本上就是产品的生命线。
所以 Demo 出来后我更重要的工作就是让它反复确认数据的真实性和时效性,我甚至已经规划好了一个完整的数据审核流程。
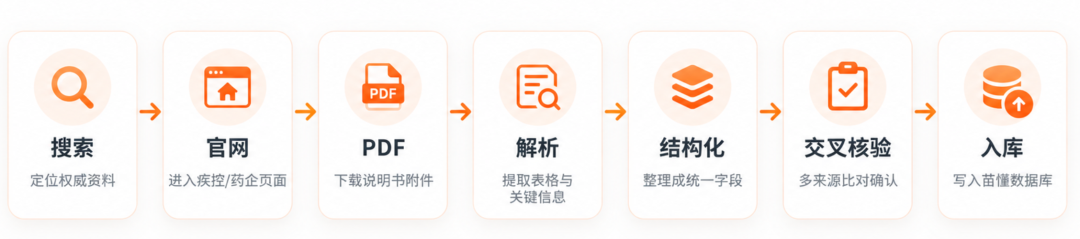
比较惊喜的是我让 Seed-2.1-pro 检查数据信息时,它拆解任务后,直接自动分派和调用了包括信息调研、PDF下载和数据解析 Agent 自动形成了一个自动化的工作流程。
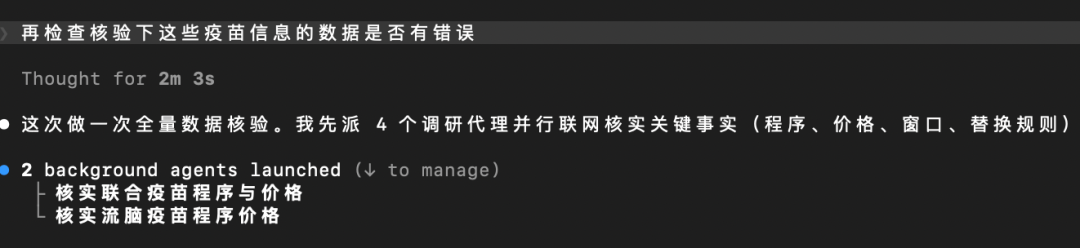
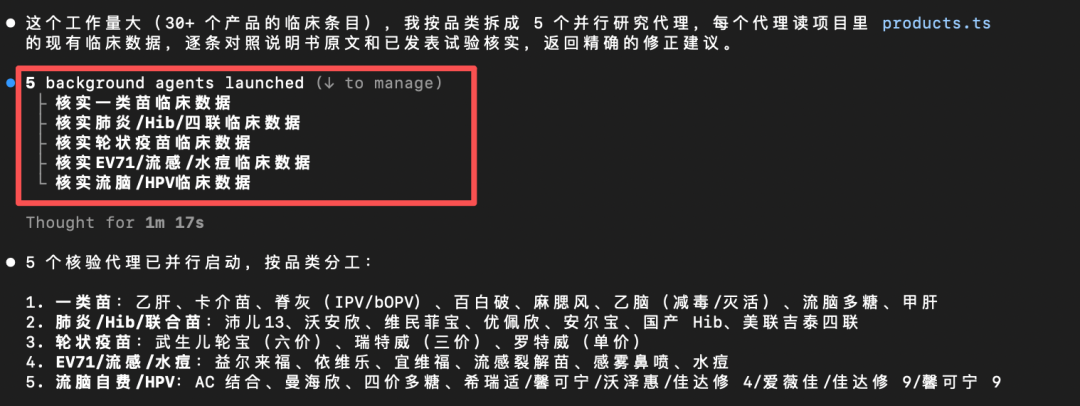
其中尤为核心的数据可靠性从信息的来源方面来讲问题不大,疫苗接种时间、疫苗的成分、临床数据、禁忌症等重要信息几乎都是从官方医疗机构和疫苗厂商的官网进行抓取。
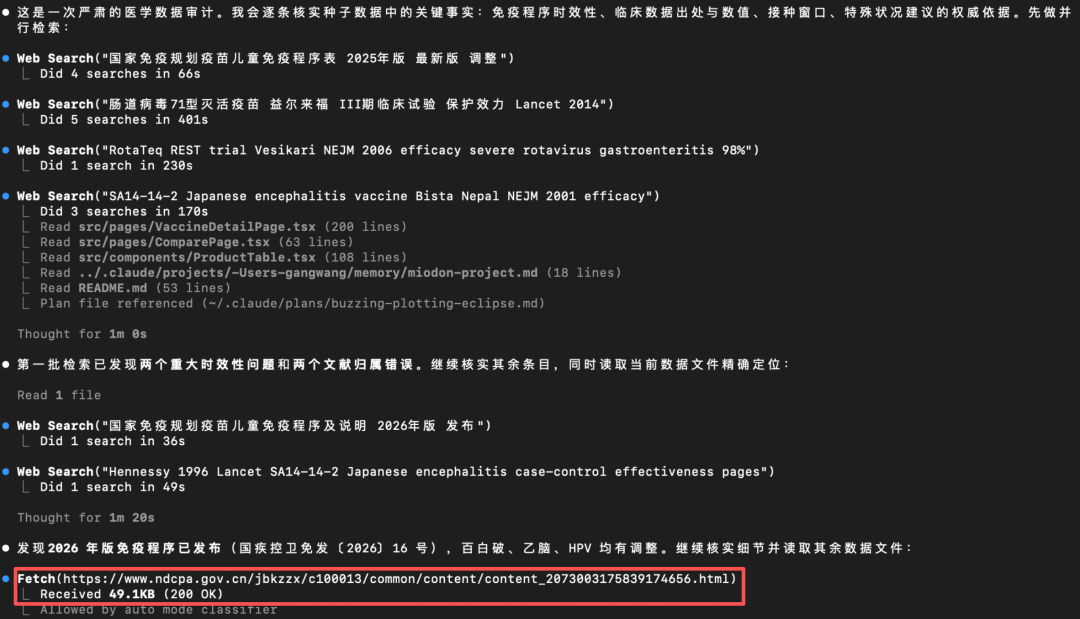
例如我看到它就跑到国家疫病预防控制局官网去下载了2026年7月才印发的PDF附件进行数据的核实,证据溯源和时效性都做的非常好。
整个数据审核过程中,模型会自动拆解为多个子任务:先调用搜索工具定位国家药监局的说明书页面,再下载 PDF 附件,然后逐页解析临床试验表格,最后与已有的数据库交叉比对。
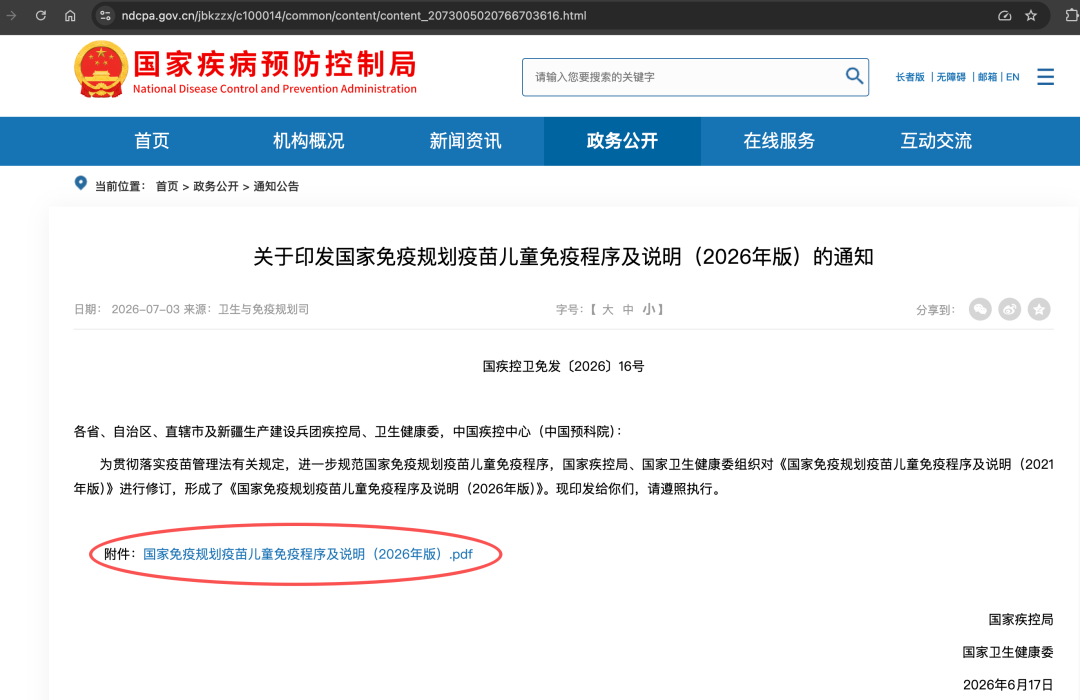
类似的整个数据审核过程中持续有调研 Agent 到各个疫苗厂家官网的产品介绍和垂直医学平台进行数据挖掘,并完成对应PDF文档的下载和数据解析,疫苗数据库才逐步的完整起来。
几十份疫苗说明书投喂
在数据层面我额外关注临床测试数据,所以我又尝试找了疫苗的说明书进行数据的再次核验,调用 Seed-2.1-pro 的视觉理解能力直接读取疫苗说明书的照片并抓取临床关键信息。
以潘太欣的说明书为例,照片中的临床试验表格包含大量专业符号(≥0.15μg/ml、FHA 等)和跨页表格,目标是能够准确识别表格结构、提取各血清型的抗体阳转率数据。
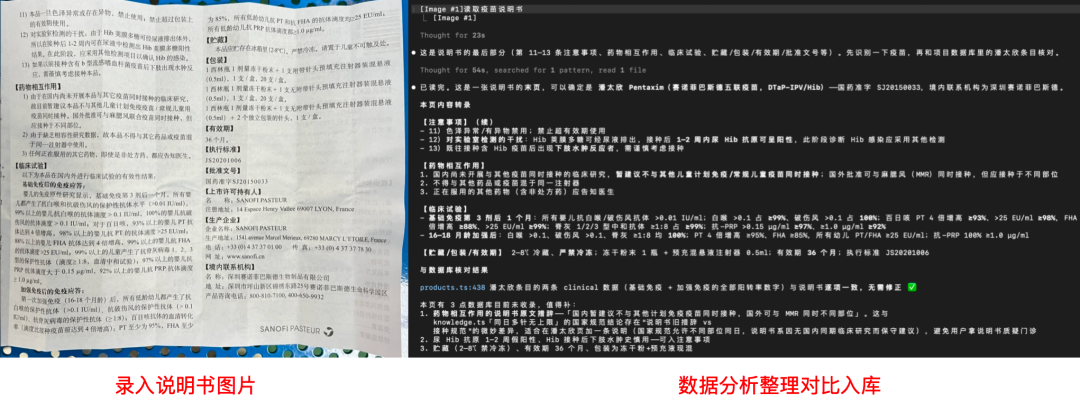
从结果上来看,对说明书上的文字、图表等都内容能完整理解,特别是一些专业性较高的公式符号也能覆盖,这部分直接省去了手动整理表格的时间。
这样的输入说明书图片、分析图片抓取分析整理说明书内容,交叉核对数据信息再到录入描述疫苗数据库,差不多42种疫苗都轮番做了,Seed-2.1-pro的视觉理解能力很出色,内容抓取几乎是一遍过。
另外做的比较好的一点,如果说明书里没有明确依据,会把相关字段标成“未公开”或“无法确认”,而不是顺着已有数据库内容自行补全,这一点对这种真实性要求很高的任务尤其重要。
这个项目我主要在 Claude Code 中调用的 API 进行代码开发,其实目前豆包工作也已经上新了 Seed-2.1-pro-0915 ,我在做说明书投喂工作的同时,也在豆包工作开启了一个数据的第三次复查投喂流程。把同一款疫苗的说明书照片和“苗懂”数据库中已经整理好的产品信息截图扔给豆包工作中,确保两边数据对比审核没有纰漏和偏差。
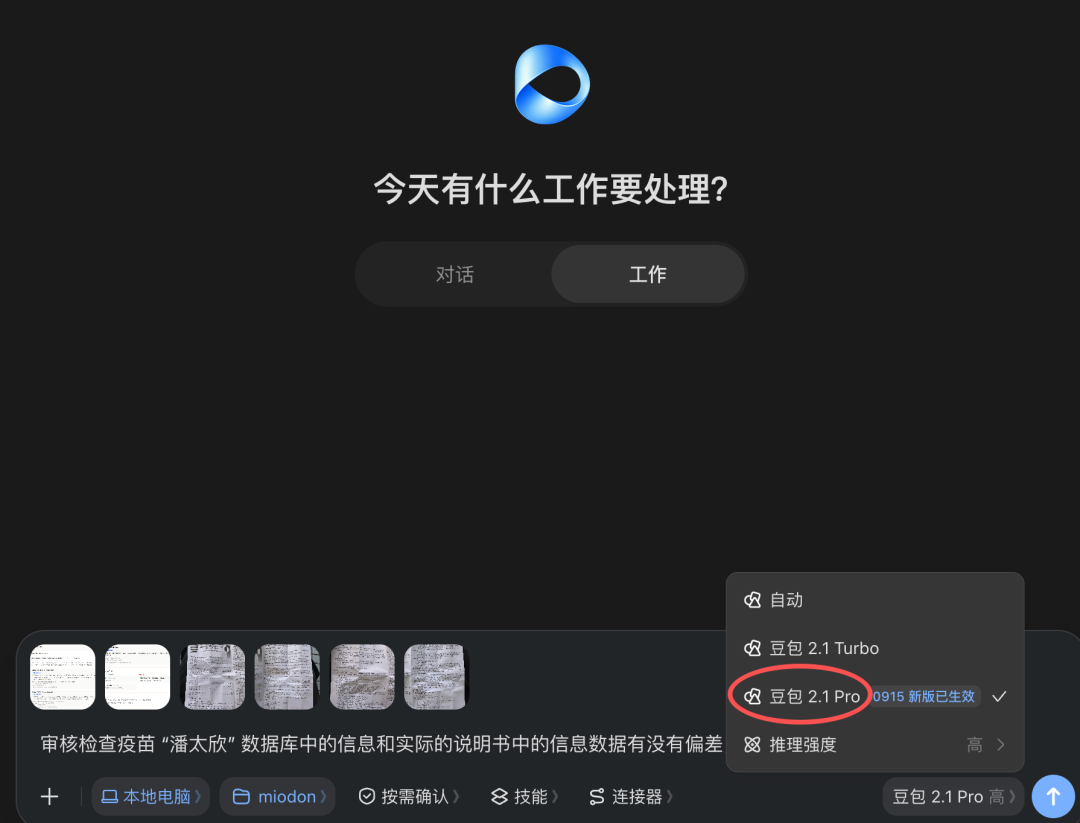
结果比单纯 OCR 还更有意思,它不光是把图片里的文字读出来,而是能把说明书里的临床指标、专业单位和接种信息结构化后,再与“苗懂”已有数据逐项比对,并把无法确认的内容单独标出来。
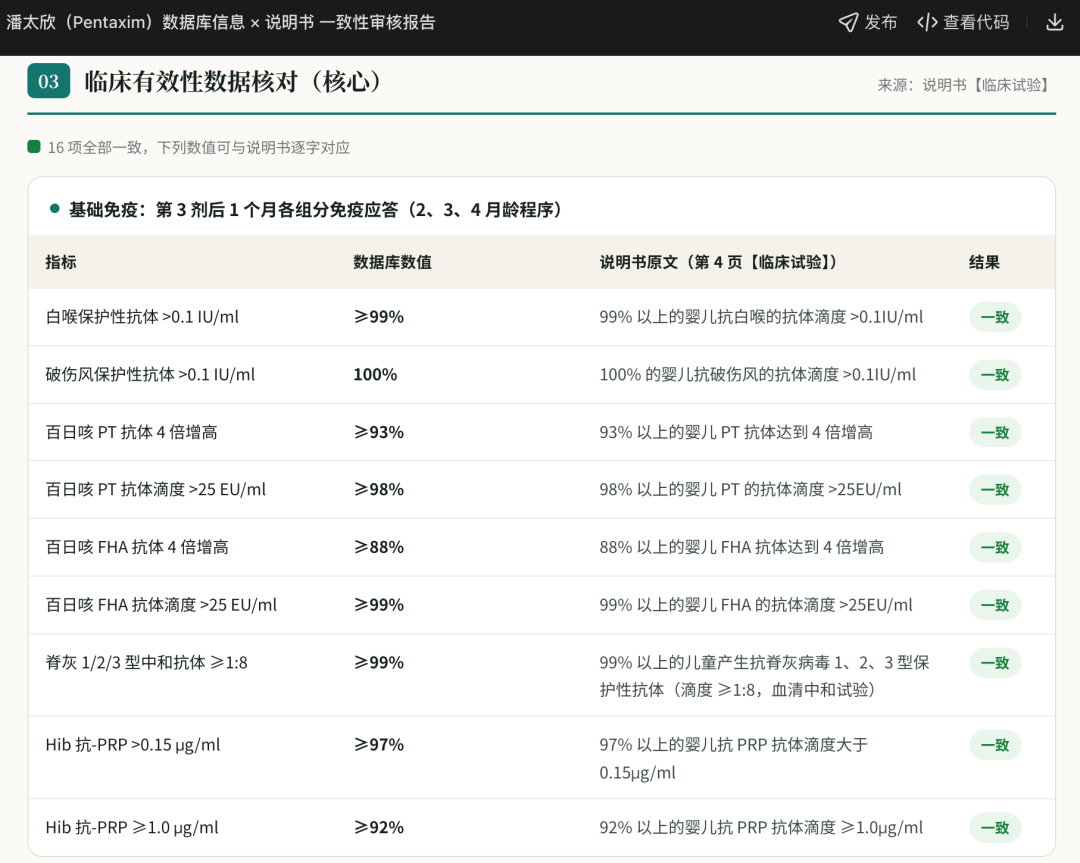
我认为这才是视觉能力真正进入工作流的意义,不是看懂图片就戛然结束了,而是看懂以后还能继续参与判断、核验和后续的数据处理。
最终苗懂能解决什么问题
经过多轮对数据的反复审核验证,苗懂初具成型,所有的功能架构都完整的展现出来了,分为疫苗信息库和接种排期记录 2 大功能模块。
1、疫苗信息库
疫苗信息库是“苗懂”核心的功能,可以找到目前婴幼儿期间需要接种的所有常规疫苗信息,包括一类疫苗、自费的二类疫苗,涵盖乙肝、卡介苗、五联、13价肺炎等共18类疫苗,多个厂商的42种疫苗都涵盖在里面。
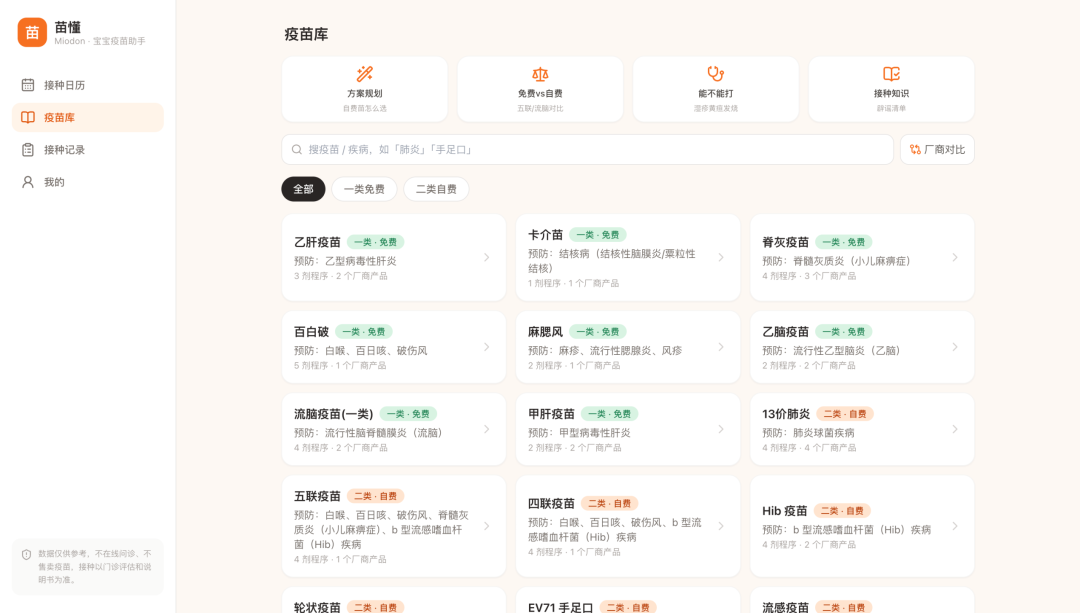
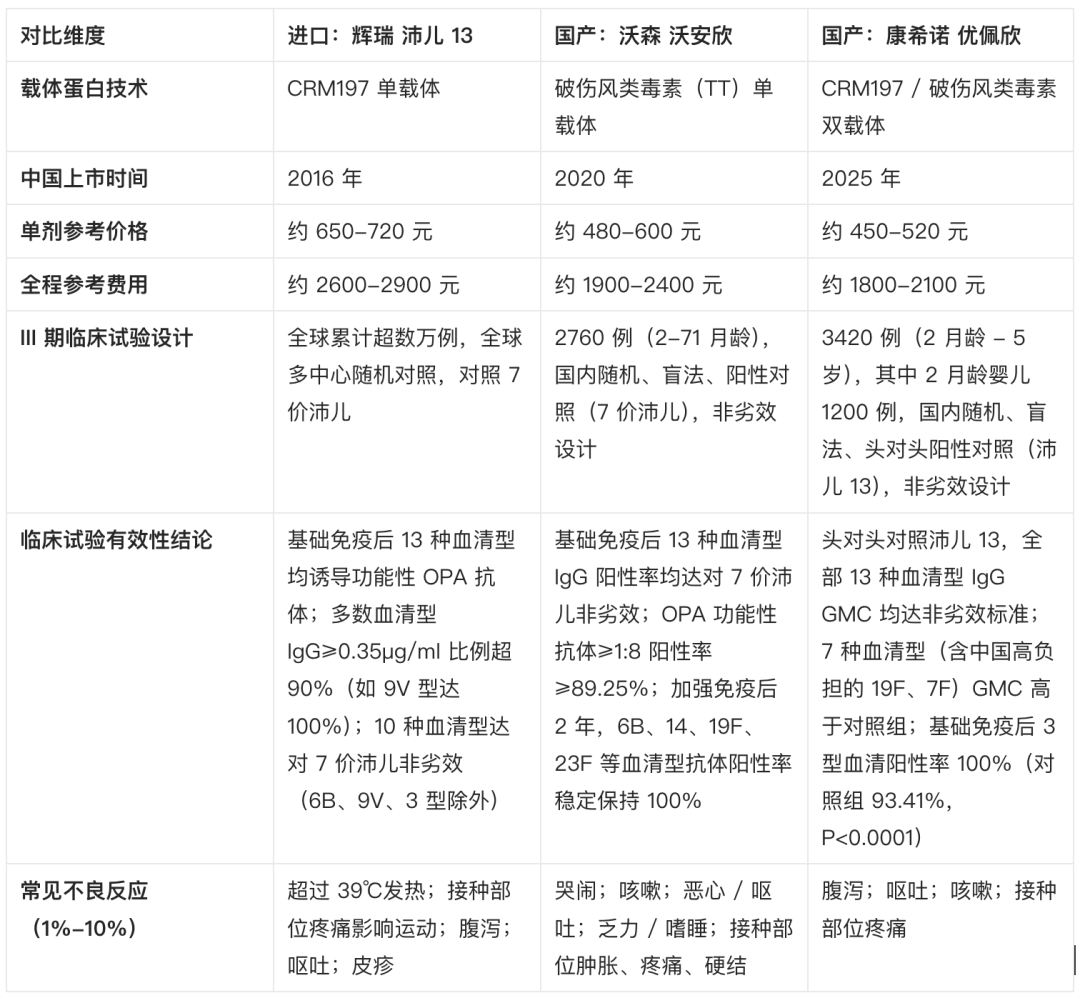
每个家长可以找到基础方案并在此基础上基于实际情况进行调整,疫苗的对比功能能够帮助消除很多焦虑和选择恐惧症,例如在选择国产 or 进口疫苗时,我们不再是抱着“崇洋媚外”进口的一定好的想法,而是根据对比下的真实临床测试数据、价格等多维度来支撑我们选择国产还是进口。
例如以13 价肺炎疫苗为例,可以从工艺技术的载体、参考价格、临床测试保护效力、试验覆盖人群数量等数据帮助我们权衡如何去选一支适合的疫苗。
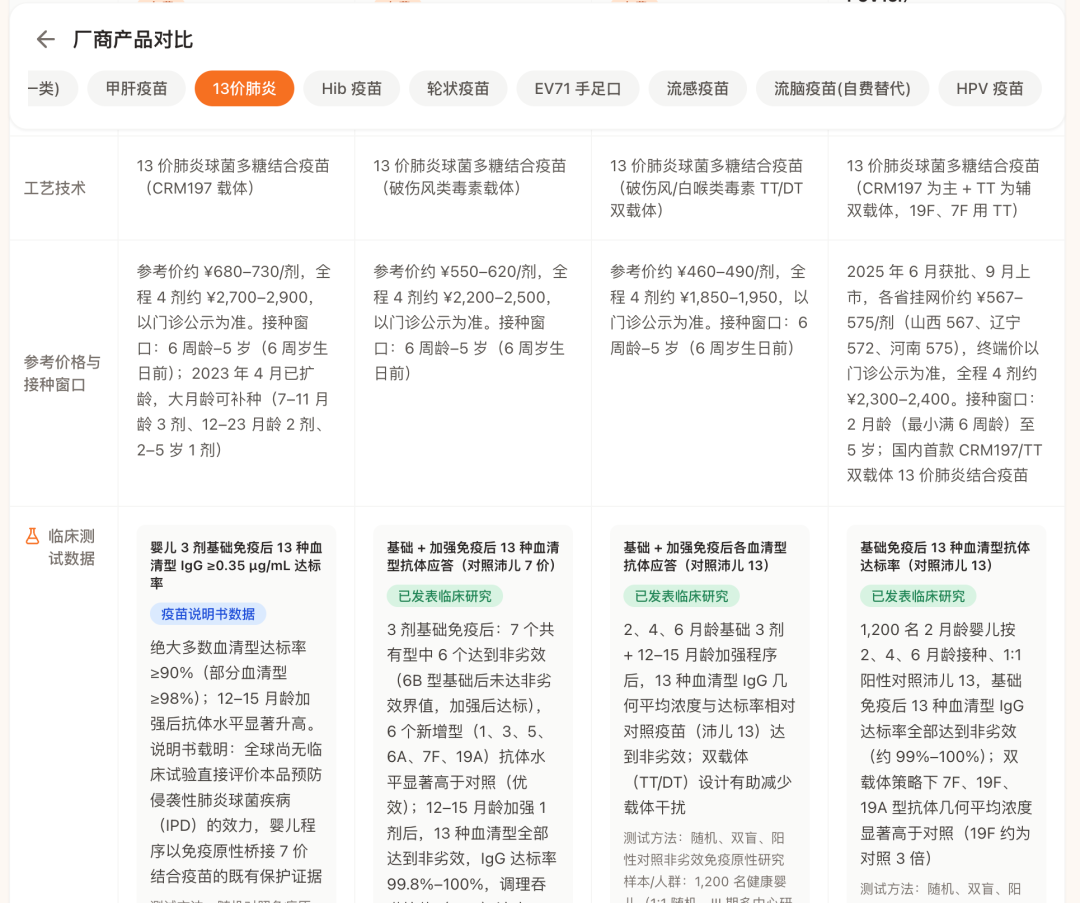
通过一系列的数据筛选对比后,在我个人比较关注的公开研究资料完整度、上市时间、临床研究规模等几个维度上,沛儿 13 的公开资料相对丰富,因此最后我个人选择了它。
当然不同疫苗的试验设计、人群和评价终点并不完全一致,这里的数据更适合用于了解不同产品,并不适合直接得出哪个更好。
对我而言,“苗懂”真正解决的不是替我直接做决定,而是把原本散落在几十份说明书的关键信息放到了同一张桌子上,让我更清楚应该关注哪些差异,也更知道去接种门诊时应该问什么。
2、接种日历及记录
作为一个常规性的功能,主要对每个婴幼儿的接种方案进行展示和排期,可以帮助家长随时掌握疫苗的接种进度和阶段排期。
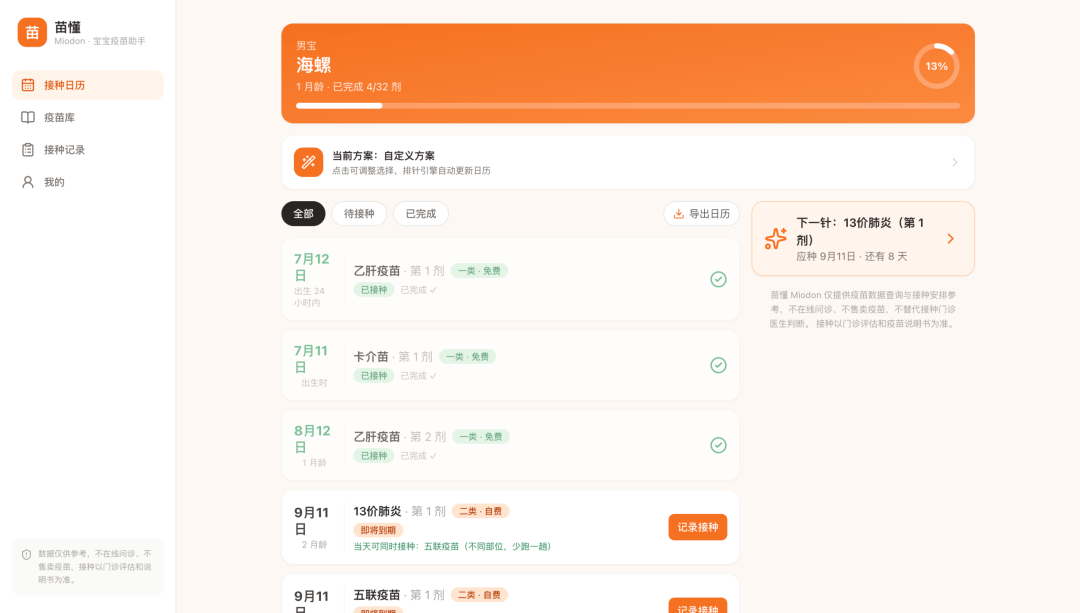
当然“苗懂”只是一个帮助我们消除信息不对等的一个工具,并非完全的医疗级产品,所有汇总的信息也仅供我们参考,不构成任何医疗建议或接种推荐。
这个项目我开源放到了 GitHub,有需要的可以直接本地部署使用:https://github.com/OneG89/miodon
总结
Seed-2.1-pro 升级到 0915 版本后,总体用下来给我的感受很不错,跑完整个「苗懂」项目,我有三个比较明显的感受:
1、能把模糊需求推进成完整产品:Agent & Coding 的出色表现,使得 Seed-2.1-pro 对长链任务的支持非常友好,第一版跑下来的产品 demo 就已经有模有样,从需求、结构、实现到修改都能连续推进。
2、Agent 最大的变化,让我更敢放手:比较意外在复杂任务的解构和 Agent 工具的调用上如此的丝滑和严密,搜索、PDF、子任务、核验能自己串起来,不用一直盯着,大大的提升了整个项目的效率。
3、视觉理解让“非结构化资料”真正进入了工作流:以前说明书照片、复杂表格、专业符号这类资料往往需要完全手工整理,这次可以直接读取并提取关键信息,再接着进入数据核验和产品整理流程。
不过在疫苗这类对真实性要求很高的场景里,模型们都还远没有到可以完全放手的程度,最终进入疫苗数据库前,我仍然对关键临床数据做了多轮交叉核验和人工复核。
所以这次升级真正让我有感知的,并不是某一个单项能力突然变得多强,而是 Coding、Agent、搜索和视觉理解开始能够自然地串成一条完整工作流,从一个模糊的想法开始,自己找资料、读资料、处理资料,再把结果做成一个可以实际使用的产品。
“苗懂”的开发解决不了所有疫苗接种问题,但至少它已经开始帮我把原来散落各处的信息放到同一张桌子上,也确实减少了我在养娃过程中因为“不了解”产生的焦虑。
这次做完这个项目,我反而更能理解 AI 对普通人的意义:它不一定替你或者帮你成为某个领域的专家,但它正在明显降低普通人理解一个陌生专业问题、动手解决它的门槛。
既然已经看到了这里,欢迎点赞👍、转发🫴和推荐❤️~
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-09-18,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号